檢索、RAG 與證據基礎
20 篇精讀筆記
探索多模態檢索、GraphRAG、重排、證據發現與可追溯回答的工程取捨。
讀者問題
如何讓系統在更大的資料與更多工具下,仍找得到可驗證的證據?
READING LIBRARY
深入讀這個議題
目前收錄在這個研究議題下的所有論文精讀。
-
Predicting Partial Answer Quality:讓 Agentic RAG 在下一輪以前知道是否值得繼續
進階深讀 Predicting Partial Answer Quality and Utility in Agentic Retrieval-Augmented Generation:把每輪中間答案的 quality、utility 與 trajectory signals 變成 early-stopping controller,並檢查節省迭代的證據與轉移邊界。
90 秒掌握這篇論文
- 問題
- Agentic RAG 在多輪 query、retrieve、read、reasoning 之後才產生最終答案;如果每個 instance 都跑到自然停止,可能在答案已經足夠後繼續花成本,也可能在已經失敗時反覆搜尋。論文問的是:能不能在每一輪的 partial answer 出現時預測它的 quality 與 utility?
- 核心洞見
- partial quality 與 incremental utility 是兩個不同 target。Quality 問「現在的 answer 有多接近 ground truth」,utility 問「從上一輪到現在增加了多少」;前者較可預測,後者的正負方向更受 trajectory、retrieval noise 與 task 影響。
- 最強證據
- 作者在 Search-R1 與 R1-Searcher 的 HotpotQA、2WikiMultiHopQA、MuSiQue 上測試 supervised 與 unsupervised predictors。Search-R1 的 quality Pearson 最高約 0.438、utility 最高約 0.321;controller 在 thetaP=0.3、thetaU=0.2 時將平均 iterations 由 3.21 降至 2.86,減少 10.89%,保留 97.60% 的自然停止品質。
- 主要邊界
- partial answer 以 F1 against gold answer probe;它不等於 open-ended answer quality,也不代表 threshold 能直接轉移到新的 retriever、model、corpus、答案型態或 controller。probing 本身還需要 generation cost。
-
RAGSieve:用自我參照的局部對比,找出 RAG 知識投毒的排名推升
進階深讀 RAGSieve:以同一個檢索事件的 retrieval tail 與同一個語料鄰域作為局部對照,在 query-time 與 corpus-time 找出可疑的排名推升;同時釐清投毒偵測不是事實查核。
90 秒掌握這篇論文
- 問題
- RAG 把外部語料放進生成證據。攻擊者只要能透過公開頁面、共享儲存或 connector 讓少量文件進入 index,就可能讓特定錯誤答案在目標 query 的 top-5 被看見。難處是:被攻擊的 corpus 不是可信 reference,而不同主題的自然語意密度也不一樣。
- 核心洞見
- 不要以為有一份先驗乾淨資料集,也不要用一個跨語料的 global threshold。RSQ 以同一 query 的 top-5 與 ranks 6–20 做 query-local contrast;RSG 以每份文件自己的語意鄰居與 local floor 做 corpus-local contrast。兩者都讓 inspected system 自己提供 matched control。
- 最強證據
- RSQ 在九個 dataset–retriever 組合、六種攻擊的 macro AUROC 為 95.2%,在最多移除 5% clean document 的 operating point 偵測 82.2% poison;RSG 對應為 93.3% 與 79.8%。串接 RSG 與 RSQ 後,六種攻擊的 ASR 從 67.4% 降至 14.0%,unpoisoned-retrieval F1 則由 42.1% 變為 41.3%(Table 1、Table 5、Table 9)。
- 主要邊界
- 這些數字是合成攻擊、三個 QA corpus、三個 dense retriever 與固定評測 protocol 的結果。它們支持「可疑 promotion pattern 可以被局部對照抓到」,不支持「被 flag 的文字一定是假的」、 「檢索到的 claim 已完成 truth verification」,也不支持 production-scale 多租戶延遲或 zero-poison guarantee。
-
失敗一旦傳播,還能找出起點嗎?Agentic RAG 的因果失敗歸因
進階深讀 When Failures Propagate:用介入式 benchmark、三跳 MuSiQue 與 certified content corruption,拆開 Agentic RAG 的失敗偵測、因果歸因、傳播與恢復。
90 秒掌握這篇論文
- 問題
- Agentic RAG 把 retrieval、reasoning 與回答拆成多個 hop。早期拿到錯誤 evidence,可能在後面變成 query drift、錯誤 bridge 或 wrong answer;但後續 retrieval 也可能把它修回來。只看 final answer 或最後一個 trace,無法直接知道最早哪一跳造成失敗。
- 核心洞見
- AgenticRAG-FP 在指定 hop $h$ 先注入一個可認證的 fault,再從被改過的 prefix 重新執行 suffix。診斷器不是對一條靜態錯誤 trace 猜原因,而是拿預先知道的 injectedathop 檢驗 exact-hop attribution。
- 最強證據
- strict dense Claude Haiku 4.5 sweep 取 80 題三跳 MuSiQue;在仍然失敗的案例中,coverage-based diagnosis 的 exact-hop accuracy 為 hop 1:0.91 [0.81, 0.98]、hop 2:0.00 [0.00, 0.00]、hop 3:0.00 [0.00, 0.00],分母分別是 43、36、21(Table 2,Section 7.1)。
- 主要邊界
- 這個結果支持「在這組 strict intervention 與後綴重跑裡,coverage 的 hop-level signal 會在較深 hop 消失」,不支持「所有自然發生的 Agentic RAG 失敗都不可歸因」。content study 的 hop 2 只有 18 個 failed cases,hop 3 只有 3 個,因此 method ranking 不能外推。
-
REVA:把 RAG 壓縮搬到可重用的 evidence view,而不是每次請求重新付費
進階精讀 Nguyen 等人的 REVA(arXiv 2609.11209 v1):用 generator attention 的歷史軌跡建立 document-keyed score store,在離線評分與線上渲染之間切開 RAG 壓縮成本,並檢查 unseen-document fallback、local/global budget、品質與延遲邊界。
90 秒掌握這篇論文
- 問題
- post-retrieval compressor 如果在每個 request 上另外呼叫 model、做 token scoring 或生成式 rewriting,縮短 context 的收益可能被 compression latency 抵消;model-agnostic 的 selector 也可能保留模型本來就知道的內容,反而刪掉真正需要的 evidence。
- 核心直覺
- 歷史 RAG request 已經留下 generator 如何使用文件的訊號。把 query 與可用的 answer/response 對文件 token 的 attention 映射到可讀的 word units,再跨重複 document access 平均,就能得到一份可重用的 evidence prior。它不是 query-specific answer,而是文件層級的 retention tendency。
- 最強證據
- 在固定 top-10 retrieval cache、四個 QA benchmark 與三個 generator 上,B=512 full-split Table I 的 REVA-local 在 NQ、TriviaQA、HotpotQA、2Wiki 都比 Trunc-local 高;Table II 的 12 個 generator–dataset 設定平均為 37.83 F1、26.98 EM、27.5 ms online overhead。all-seen Table III 的 120 個 budget cells 則讓 REVA-global 達 43.72 F1、32.75 EM、49 ms。
- 主要邊界
- all-seen 只保留所有 top-K 文件都有分數的 held-out query,不能代表正式環境 coverage;full-split 才含 prefix fallback。attention 也只是 evidence importance proxy,不是 citation correctness 的驗證器;報告的 online overhead 排除 score-store 建置與更新。
-
VikingRAG:讓結構化文件的 Agentic RAG 少走幾輪、少吃幾千 token
進階深讀 VikingRAG:把文件階層保留在 URI 可定位的外部 storage,以 Search、List、Grep、Read 支援 evidence-gap retrieval,再用 experience edges 與 adaptive escalation 降低重複探索的 token 與延遲。
90 秒掌握這篇論文
- 問題
- 企業手冊、課程 syllabus、論文、合約與財報不是一袋互不相干的 chunks。答案常需要先定位哪一份文件,再沿著 chapter、section 或 subsection 找到分散的事實。若把所有 directory 都序列化進 prompt,結構線索會很貴;若只做一次 flat top-k,又可能在第一輪就漏掉跨 section 的依賴。
- 核心洞見
- 把 hierarchy 從 prompt 移到可查詢的外部 semantic storage。每個 directory node、chunk 與多層 abstract 都有 URI,且 URI prefix 保留 ancestor–descendant 關係;向量結果因此不只是文字片段,也是一個可以繼續 List、Grep、Read 的 navigation handle(論文 Section 2.2、3.1)。
- 最強證據
- 六個結構化文件資料集、八個 baseline、固定的 K=10、L=1,000、B=15 設定下,作者以 end-to-end accuracy、latency、LLM token、ingestion 與 deletion 評估。Figure 3/Table 3 報告 VikingRAG 的 token ratio 為 11.6%–51.9%,VikingRAG-E+ 為 5.1%–32.5%;Figure 7 也在 VersionQA 上換用 GPT-5.5、Seed-2.0 與 GLM-4.7 做 robustness check。
- 主要邊界
- accuracy 是 LLM-as-a-judge 加 expert verification 的 semantic consistency proxy,不是 retrieval recall 或獨立人工重做的 correctness proof。Experience edges 用同一文件語料產生的 1,000 個 synthetic historical questions warm up;evidence checker 的 false-no-escalation 在 QASPER 仍為 14.4%,FinanceBench 為 6.7%(Table 7)。
-
RAG:把檢索接上生成,但不能把 2020 的 RAG 當成 Production RAG 平台
中階 理解檢索、記憶與 Production RAG精讀 Lewis et al. NeurIPS 2020:把 BART 接到 Wikipedia 的 dense retriever,用 RAG-Sequence/RAG-Token 讓取回的段落條件化生成。NQ 上 RAG-Seq Exact Match 44.5;這仍是 2020 的方法論文,不是 2025 的 Production RAG 平台,也不是 agent 迴圈。
90 秒掌握這篇論文
- 問題
- 大型預訓練模型把事實塞進參數裡,知識密集任務仍落後專用架構;參數記憶難更新、難追溯,也容易胡謅。
- 核心洞見
- 把預訓練的 seq2seq 生成器(BART)接到預訓練的 dense retriever(DPR 初始化)與 Wikipedia 索引。決策點從「只靠參數答」改成「先取回段落,再條件化生成」。RAG-Sequence 整段共用一份文件;RAG-Token 可按 token 換文件。
- 最強證據
- Table 1 的開放域 QA:NQ 上 RAG-Seq 44.5、RAG-Token 44.1,高於 DPR 41.5、REALM 40.4、T5-11B+SSM 36.6。Table 2 的生成與分類:Open MS-MARCO 上 RAG-Seq 相對 BART 各 +2.6 Bleu/Rouge-L;FEVER-3 72.5,距當時 pipeline SOTA 76.8 差 4.3 個百分點,且沒有 retrieval 中間監督。
- 主要邊界
- 記憶是 2018 年 12 月 Wikipedia 切成 21M 個 100 詞塊,不是私有語料;檢索是 dense MIPS,不是 production hybrid;沒有 agent 的 search/read/final,也沒有 2026 企業意義上的 citation faithfulness。
-
DPR:把開放域 QA 改成 dense 段落檢索,但不能把雙編碼器當成 Production RAG
中階 理解檢索、記憶與 Production RAG精讀 Karpukhin et al. EMNLP 2020:用 question/passage 雙編碼器 BERT 與 in-batch negatives 學 dense 檢索,在 Wikipedia 段落上用 MIPS 取代 BM25。NQ top-20 檢索 78.4% 對 BM25 59.1%;端到端 Exact Match 41.5。這是 RAG 用的 retriever,不是生成平台。
90 秒掌握這篇論文
- 問題
- 開放域 QA 依賴高效段落檢索;實務上幾乎都用 TF-IDF/BM25 這類稀疏倒排。稀疏表示難處理同義與改寫,也無法用問句–段落對直接學任務特定空間。
- 核心洞見
- 把檢索改成兩個獨立 BERT-base 編碼器:passage encoder 離線把 Wikipedia 切成的段落編成 768 維向量並建 FAISS 索引;question encoder 在線編碼問題,用點積做 MIPS。訓練用 gold 正例+in-batch negatives(再加 BM25 hard negatives),不必像 ORQA/REALM 那樣做昂貴的額外預訓練或週期重建索引。
- 最強證據
- Table 2 的 top-20/top-100 檢索準確率——NQ 上 Single DPR 78.4%/85.4%,BM25 59.1%/73.7%(約 +19.3 個百分點的 top-20);摘要寫 9%–19% absolute。Table 4 端到端 Exact Match:NQ 上 DPR 41.5,高於 ORQA 33.3 與 REALMNews 40.4。Figure 1:只用 1,000 個訓練例的 DPR 已勝過 BM25。
- 主要邊界
- 記憶是 2018-12-20 English Wikipedia 切成約 2,101 萬個 100-word 段落;評測是英語開放域/抽取式 QA;相似度是雙編碼器點積,沒有 late interaction;不是 production hybrid、不是 citation faithfulness、不是 agentic search/read/final。
-
Self-RAG:讓模型決定何時檢索,但不能把反思 token 當成 Production RAG 閘門
中階 理解檢索、記憶與 Production RAG精讀 Asai et al. ICLR 2024:用 reflection tokens(Retrieve/Relevant/Supported/Useful)訓練 LM 按需檢索並自我批判。PopQA 上 Self-RAG 7B 54.9、13B 55.8;這是 when-to-retrieve 的方法論文,不是 Production RAG 平台,也不是 agent 工具迴圈。
90 秒掌握這篇論文
- 問題
- 標準 RAG 不問需不需要,一律取回固定篇數;無關段落會拖累生成,也傷害指令遵循的通用性。取回之後,模型也不保證會跟著段落走。
- 核心洞見
- 訓練一個任意 LM,讓它在生成過程中穿插 reflection tokens:Retrieve 決定要不要檢索;ISREL/ISSUP/ISUSE 分別批判相關性、支持度與效用。檢索變成決策,而不是管線預設階段。
- 最強證據
- Table 2 六任務總表——Self-RAG 7B/13B 在 PopQA 54.9/55.8、TriviaQA 66.4/69.3、PubHealth 72.4/74.5、ARC 67.3/73.1;biography FactScore 81.2/80.2;ASQA citation precision/recall 66.9/67.8 與 70.3/71.3。Table 3a:相對 Self-RAG(50k)45.5,No Critic 的 PopQA 42.6、ASQA em 18.1;Retrieve top1 的 PopQA 41.8。
- 主要邊界
- critic 先靠 GPT-4 銀標再蒸餾;reflection tokens 仍可能錯;索引與評測是 Wikipedia/公開 QA,不是企業 ACL 與 citation 產品;也不是帶工具的 agent 迴圈。
-
REALM:預訓練時就把檢索接進 LM,但不能把聯合訓練當成現成的 RAG 堆疊
中階 理解檢索、記憶與 Production RAG精讀 Guu et al. ICML 2020:用 MLM 訊號預訓練可微的知識檢索器,異步刷新 MIPS 索引,並在開放域 QA 上微調。CC-News/Wikipedia 設定下 NQ Exact Match 40.4,勝過 ORQA 與 T5-11B;這是昂貴的檢索增強預訓練祖先,不是 Lewis RAG 生成,也不是 DPR 的便宜雙編碼器配方。
90 秒掌握這篇論文
- 問題
- 預訓練 LM 把世界知識壓進參數;要覆蓋更多事實就得把網路做得更大,而且知識難定位、難更新。
- 核心洞見
- 預訓練時加入可學習的知識檢索器,從 Wikipedia 等語料取回文件 $z$,用遮罩語言模型訊號反傳通過檢索(把 $z$ 當潛變數),並用異步 MIPS 刷新處理「索引會過期」的計算難題。
- 最強證據
- ICML Table 1 開放域 QA Exact Match——REALM($X$=CC-News,$Z$=Wikipedia)NQ 40.4、WQ 40.7、CT 42.9;同參數量級的 ORQA 為 33.3/36.4/30.1;T5-11B(約 11318M)NQ 只有 34.5。Table 2:30× stale MIPS 把 NQ dev Exact Match 打到 28.7。
- 主要邊界
- 記憶是 2018-12-20 English Wikipedia(約 1,300 萬個 ≤288 wordpiece 塊);評測是英語 Open-QA/抽取式 span;訓練要 64 TPU 預訓練與週期重建索引;不是 production RAG,不是生成式 RAG,也不是 when-to-retrieve。
-
DocMemo:讓長文件 RAG 在找錯證據後仍能回頭
進階 理解檢索、記憶與 Production RAG深讀 DocMemo:用 document schema、page belief 與 question episodic memory 保存跨回合 retrieval state,再以 Bayesian update、Thompson sampling 與 adaptive granularity 找回遺漏證據。
90 秒掌握這篇論文
- 問題
- 長文件的答案可能分散在數十頁、表格、圖與跨頁線索中。static retrieval 一開始就固定 top-k pages;若第一輪漏掉 evidence,後續 reasoner 沒有狀態可以解釋「哪一頁可能有用、哪些頁面已被排除、還缺什麼」。
- 核心直覺
- 把 retrieval 做成 dynamic evidence exploration。Document Schema Memory 保存文件結構,Page Belief Memory 更新頁面相關性信念,Question Episodic Memory 記住當前問題的發現與 query refinement。
- 最強證據
- 在 MMLongBench-Doc、LongDocURL、PaperTab 三個 long-document DocVQA benchmark 上,DocMemo 的 accuracy 為 71.3、81.1、80.4,平均 77.6;Table 4 的 ablation 也顯示移除 memory 或 Bayesian update 會使 MMLongBench-Doc accuracy 從 71.3 降到 68.5 或 68.8。
- 主要邊界
- 評估依賴 GPT-4.1 binary judge、PDF rendering、Qwen3.5-VL-9B、ColQwen2.5、MinerU 與三個 benchmark 的 annotation;它沒有證明任意企業 corpus 的 citation faithfulness、access-control correctness、freshness 或總成本。
-
FinRank:金融文件 RAG 的 hard-negative 檢索評測
中階 理解檢索、記憶與 Production RAG精讀 FinRank:用公司、年度與披露邊界構造金融文件檢索測試,說明為什麼 pooled corpus、hard negatives 與 metadata filter 會改變企業 RAG 的結論。
90 秒掌握這篇論文
- 問題
- 金融文件問答的錯誤不只來自「找不到相似文字」。同一個詞可能出現在不同公司、不同申報年度、不同 Note,metadata filter 也可能把真正的 supporting passage 一起裁掉。FinRank 要測的是:檢索器能否在這些近似但不正確的段落中保住正確證據。
- 核心想法
- 建立 1,185 筆人工撰寫的金融 QA、5,230 段 pooled corpus 與 6,021 個 curated hard negatives,再用多種資料切分測試跨年份、跨公司與查詢改寫的泛化。
- 最重要證據
- 在 pooled corpus 的 Recall@10 表中,e5-mistral-7b-instruct 為 44.8、BM25 為 32.1;metadata-filtered BM25 為 55.0,但 Section 7.1 說明 filter 可能因 first-occurrence metadata 把 gold passage 排除。Section 7.3 的 hard-negative 對比又讓 pairwise accuracy 比 random negatives 低 13.0–20.5 個百分點。
- 主要邊界
- 論文沒有測 answer generation、citation correctness 或 faithfulness;資料主要來自 2024–2025 的美國 10-K/10-Q,且標註與資料分布仍有版本不一致。因此它是 retrieval evaluation 的好起點,不是金融 RAG 上線安全證明。
-
AskChem:把文獻檢索單位改成帶來源的 claim
進階 理解檢索、記憶與 Production RAG精讀 AskChem 如何以帶有 DOI、原文引句與 evidence locator 的 atomic claim 取代 paper/chunk 作為檢索單位,並檢查它在 30 題 AskChem-Bench 上改善了什麼、沒有證明什麼。
90 秒掌握這篇論文
- 問題
- paper/chunk retrieval 讓讀者或 agent 自己找證據句、判斷 claim 是否可定位、再跨 paper 合成。
- 核心想法
- AskChem 將帶 DOI、quote/evidence locator 與類型的 atomic claim 作為檢索單位,接上 taxonomy、evidence graph 與同一組 REST/SDK/MCP interface。
- 最強證據
- 2.4M claims、147K papers 的系統,在 30 個 chemistry synthesis questions 上報告 AskChem-grounded answer 的 DOI resolvability 100%,LLM-only 為 88.3%(Section 7、Table 1)。
- 邊界
- DOI 可解析與 citation density 是 provenance proxy,不是 claim 事實正確、完整文獻覆蓋或化學結論可用性的證明。
-
BM25 在大規模語料中勝出:RAG 範式的擴展研究
中階 理解檢索、記憶與 Production RAG深讀 Wang 等人的 arXiv v3 研究:在固定問題、證據與對抗文件的 28 層企業型語料梯度上,BM25 如何跨過約 1,000 萬語料 token 的交叉點,以及為什麼 agent 應該接在全域候選排序之後。
90 秒掌握這篇論文
- 問題
- RAG paradigm 常只在單一 corpus size 比較,無法看見 accuracy、construction cost、query cost 與 latency 如何一起隨資料量變化。
- 核心想法
- 以 28 個 nested corpus tiers(1,144 到 511,959 documents)固定 reader/judge 與 adversarial bedrock,比較 lexical、dense、graph、file-system agency;再以 retrieval-swap control 隔離 access substrate。
- 最強證據
- 在 shared large tiers,作者報告 BM25 約在 10M corpus tokens 超過 raw file-system agency;matched 150-question resweep 中 Agent+BM25 69.4、raw-file agency 36.9(Section 5.1、Figure 4、Table 4)。
- 邊界
- EnterpriseRAG-Bench 是 fictional enterprise-shaped corpus、500 questions 和一個主 reader/judge;公開 executable benchmark/data artifact 未確認,不能轉寫成普遍「BM25 永遠贏」。
-
推理之前就可能失敗:Agentic RAG 的證據前程序性失敗
進階 理解檢索、記憶與 Production RAG精讀 Before Reasoning Can Fail 如何把『搜尋後沒有讀證據就回答』拆成可觀測的軌跡失敗,並檢驗 Read-Gate 是否真的改善多跳問答。
90 秒掌握這篇論文
- 問題
- agentic RAG 可 search 到 snippets 卻在 read 前 final;這是 evidence-conditioned reasoning 開始前的程序失敗,不應與讀過 gold evidence 後仍答錯混為一談。
- 核心想法
- 以 saved tool traces、retrieved/read passages 和 final answer 定義 discipline 與 post-gold-read failure;Read-Gate 強制「search 後、final 前至少 read 一段」,不改模型、retriever 或 reasoning budget。
- 最強證據
- 12,000 個 paired trajectories 跨 HotpotQA、2WikiMultiHopQA、MuSiQue;zero-read subset forced reading 的 LLM-Acc 增加 14.9–19.9 points,完整 minimal-reasoning cells 增加 3.2–9.4(Table 1、Section 5.2)。
- 邊界
- 適用於可觀察 search/read/final action 的 multi-hop QA;read 不保證已讀對或推理正確,MuSiQue 缺完整 gold chunk annotation 也限制 post-gold-read 分析。
-
RubricRanker 論文精讀:RAG 需要的不是最相關文件,而是對的文件集合
進階 理解檢索、記憶與 Production RAG拆解 RubricRanker 如何用 query-specific search rubrics、SFT 與 GRPO 訓練文件 reranker,並檢查它在 deep research 與 RAG benchmark 上真正改善了什麼。
90 秒掌握這篇論文
- 問題
- 傳統 reranker 逐份文件評 relevance,卻不保證 top-k 合起來完整、精簡、一致且權威。
- 核心洞見
- 把輸出目標從「文件排名」改成「共同支撐答案的 evidence set」,並用 query-specific rubrics 產生集合標籤與 reward。
- 最強證據
- Table 1--3 顯示下游分數提升,且 ablation 指向 rubric labels 與 cold-start SFT,而不是 RL 單獨創造效果。
- 主要邊界
- 最終答案仍由 Agent 與 LLM judge 評分;較好的 evidence set 不等於引用、推理或事實都正確。
-
Beyond RAG for Agent Memory:xMemory 詳細筆記
中階 理解檢索、記憶與 Production RAG依 arXiv:2602.02007 解讀 xMemory 四層階層、sparsity–semantics 目標、兩階段 top-down 檢索,以及 LoCoMo/PerLTQA 實證。
90 秒掌握這篇論文
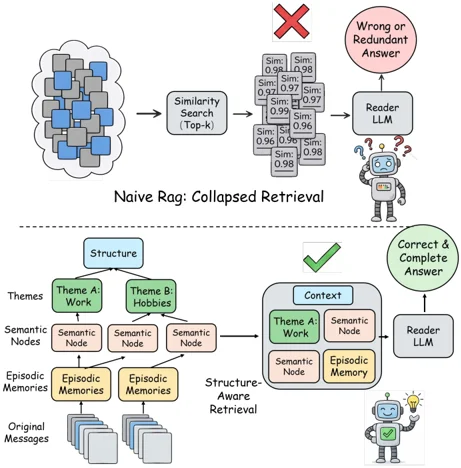
- 問題
- agent memory 是有時間連續性、近重複且高度相關的互動流;固定 top-k chunks 容易集中在同一局部,pruning 又可能切斷時間依賴。
- 核心想法
- xMemory 將 raw messages decouple 再 aggregation 成 message、episode、semantic、theme 四層,以 sparsity–semantics objective 指導 split/merge,並 top-down 逐層縮小到需要的細節。
- 最強證據
- 論文在 LoCoMo、PerLTQA 與長對話設定比較 memory baseline;Table 1、Figure 2、Figure 3 與 Appendix ablation 分別支援層級、檢索與效率論述。
- 邊界
- 階層品質依賴 segmentation、embedding 與 token budget;benchmark QA 分數不直接證明真實 agent 能安全地更新或治理長期記憶。
-
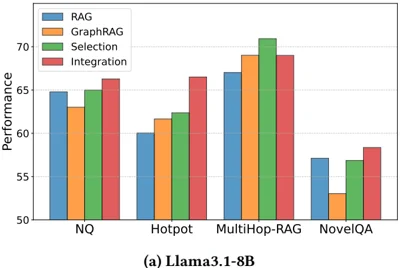
RAG vs GraphRAG:系統性對照與混合策略(詳細筆記)
中階 理解檢索、記憶與 Production RAG依 arXiv:2502.11371 解讀統一評估協議、四類 GraphRAG、Table 1–5 數字、效率 trade-off 與 Selection/Integration 混合策略。
90 秒掌握這篇論文
- 問題
- 不同 GraphRAG 系統同時改變圖建構、檢索、context budget 與生成流程,單看個別論文很難回答何時值得付圖的成本。
- 核心想法
- 在統一 preprocessing、retrieval budget 與 generation script 下,將 RAG 與 KG-based、community-based、text-centric、hierarchical GraphRAG 分開測,並提出 Selection/Integration hybrid。
- 最強證據
- QA 與 query-based summarization 的比較用 Table 1–5、Section 4–5 與效率分析顯示優勢依 query type、global context 與建圖成本而變。
- 邊界
- 受測系統、語料、Llama-3.1-8B-Instruct 與固定預算限制外推;benchmark win 不等於圖會在你的文件或 SLA 下有 ROI。
-
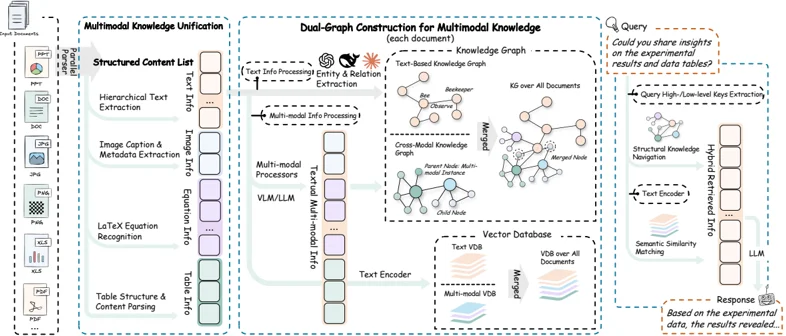
RAG-Anything:多模態文件檢索不只是把圖片轉成文字
中階 理解檢索、記憶與 Production RAG以論文、附錄與官方程式庫為據,拆解 RAG-Anything 的雙圖索引、實驗證據、失敗案例與工程採用邊界。
90 秒掌握這篇論文
- 問題
- 傳統方法把圖片與表格壓成 caption 後,常遺失 cell、panel、axis 與跨頁關係。
- 核心洞見
- 用文字代理負責檢索,但保留可回指的原始圖表;再讓顯式圖關係與 dense similarity 共同找證據。
- 最強證據
- Table 2--4 與 Figure 2 顯示完整系統整體領先,主要收益來自 graph construction,長文件切面差距更明顯。
- 主要邊界
- 拒答、parser 錯誤、entity alignment、成本與 latency 都沒有被總體 accuracy 解決。
-
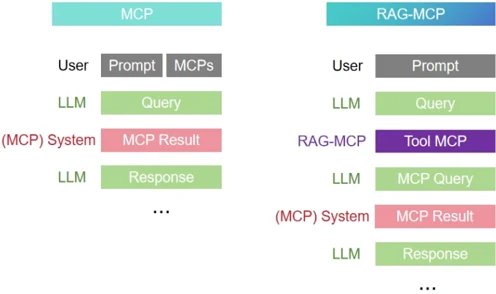
RAG-MCP:用檢索縮小工具發現,但不能忽略路由失敗
中階 理解檢索、記憶與 Production RAG以論文證據檢視 RAG-MCP 的工具路由流程、11,100 候選壓力測試、MCPBench 結果、規模退化與未釋出 artifact。
90 秒掌握這篇論文
- 問題
- 把大量 MCP tool schema 全塞進 prompt,會增加 token、distractor 與錯誤選 tool 的機會。
- 核心想法
- 先將 MCP metadata 建索引,query 時 retrieve top-k candidate schema,再讓 executor 在小候選集內 validate 與 invoke;retrieval 是 candidate generation,不是授權決策。
- 最強證據
- MCPBench web-search 設定中,論文報告 RAG-MCP 的 ground-truth MCP top-1 accuracy 43.13%,對 keyword pre-filter 18.20%、all-schema prompting 13.62%(Section 4.2、Table 1)。
- 邊界
- v1 的 retriever metadata、embedding/version、schema drift、permission、p95 latency 與真實 invocation success 未完整公開;top-1 route 不是 task success。
-
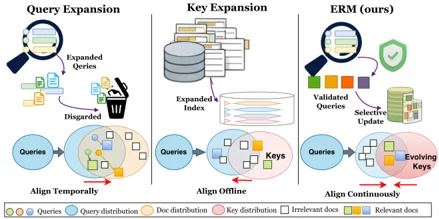
RAG without Forgetting:把成功的 Query Expansion 寫回索引,但不要把錯誤也寫進去
中階 理解檢索、記憶與 Production RAG以論文證據檢視 ERM 的 correctness gate、選擇性歸因、有界 key update、BEIR/BRIGHT 結果與未釋出 artifact。
90 秒掌握這篇論文
- 問題
- query expansion 可改善 query–document mismatch,卻要每次重新生成;持久 key expansion 又容易把錯誤 feedback 寫入 index。
- 核心想法
- ERM 只接受通過 correctness gate 的 expansion unit,並把它歸因給真正提高 similarity 的 document key,再做 bounded update;它更新 key,不重訓 retriever。
- 最強證據
- 作者在 13 個 BEIR/BRIGHT domain 報告 retrieval 與 generation 結果,並在 Table 1、Table 2、Figure 3 與 Appendix B.9 分別呈現品質、延遲、budget 與 transfer。
- 邊界
- 公開論文沒有 implementation、live A/B、attack/privacy/rollback study;gate 的錯誤會把錯誤關聯變成持久 index state。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡