論文精讀
RAG-MCP 論文精讀:用檢索改善 LLM 工具選擇
原文:RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation
90 秒掌握論文 / The paper in 90 seconds
- 問題:將大量 Model Context Protocol(MCP)工具 Schema 全數塞入大型語言模型(LLM)的提示詞中,會引發嚴重的提示詞膨脹(Prompt Bloat),劇烈消耗有限的上下文窗口,並引入語意相近的干擾項(Distractors),導致模型選錯工具或無從推理。
- 核心洞見:將「工具發現(Tool Discovery)」從推論核心抽離至外部向量索引;面對查詢時,僅透過輕量檢索器取回少量相關工具候選,完成相容性驗證後,只將單一目標工具的 Schema 注入執行模型,使執行端專注於參數填寫與任務規劃。
- 最強證據:在 MCPBench 的 Web-Search 基準測試中,論文報告 RAG-MCP 的真實目標工具 Top-1 選擇準確率達到 43.13%,平均消耗 1,084 個提示詞 Token;大幅超越關鍵字預篩選(18.20%,1,646 Token)與全量提示詞注入(13.62%,2,133 Token)(Section 4.2、Table 1)。
- 主要邊界:43.13% 僅代表受控單工具網路搜尋下的 Top-1 路由命中率,而非端到端任務執行成功率;在 11,100 個候選的擴展性壓力測試中,當候選池超過約 100 個工具時,檢索精確率發生嚴重複雜退化(Section 4.1、Figure 3)。此外,作者未公開端到端程式碼、候選集快照與權限隔離機制。
當智慧代理(Agent)生態迅速擴展,系統連接的 MCP 工具伺服器動輒數十乃至數百個。若將所有工具定義一股腦注入推論上下文,模型不僅難以負荷上下文成本,更會迷失於大量相似的介面定義中。RAG-MCP 提出將檢索增強生成(RAG)範式引入工具挑選;然而,這項設計並非消除了系統失敗,而是將失敗邊界前移至檢索階段。一旦正確工具未能進入檢索器的候選名單,後續的執行模型便徹底喪失修正機會。
理解前需要知道什麼 / What to know first
在深入探討 RAG-MCP 的機制之前,必須釐清其所處的系統環境與先前的技術瓶頸:
- Model Context Protocol(MCP):Anthropic 提出的開放標準協定,讓 LLM 能夠透過統一的 JSON-RPC 介面與外部資料源及工具伺服器通訊。每個 MCP 伺服器會暴露具備名稱、文字描述與 JSON Schema 參數定義的工具清單。
- 提示詞膨脹(Prompt Bloat)與上下文飢餓:現有 Function Calling 系統普遍將所有可用工具的完備 Schema 序列化後置入 System Prompt。當工具數量擴展至數十個以上時,Schema 佔用數千 Token,直接壓縮代理進行多步規劃與自我反思的工作記憶體。
- 傳統方法的瓶頸與局限(Why prior approaches are insufficient):
- 全量提示詞注入(Blank Conditioning / All-schema Prompting):假設強大的前沿模型具備在全量 Schema 中自行挑選的能力。然而實驗證明,隨著工具總數 增加,大量語意重疊的工具成為干擾項,引發大海撈針難題,選擇準確率雪崩式跌落至 13.62%。
- 關鍵字預篩選(Keyword Pre-filtering / Actual Match):依賴使用者查詢與工具 Metadata 的字面重疊進行過濾。此法完全無法理解同義詞、抽象意圖或參數結構,準確率僅有 18.20%,且容易誤刪關鍵工具。
- 核心職責分離原則:在生產環境中,「工具挑選(Tool Selection)」、「參數結構校驗(Schema Validation)」、「執行授權(Authorization)」與「最終任務成功(Task Success)」是四個完全不同的架構層次。RAG-MCP 實質上只處理候選縮減,絕非完整的工具治理框架。
核心直覺 / Core intuition
直覺上,傳統全量提示詞的做法,如同要求維修技師隨身攜帶整座圖書館的所有設備操作手冊;而 RAG-MCP 則是在圖書館門口設立快速檢索索引,僅根據技師當前的問題,調出最可能需要的那一頁手冊。
然而,在分散式系統中引入檢索模組,本質上建構了一個連乘的條件機率鏈。設工具註冊中心為 ,使用者查詢為 。RAG-MCP 以路由函數 挑選出 Top-1 Schema 交付執行。Bloss0m 將端到端成功機率分解為以下連乘形式:
這個等式清楚揭示了系統的結構性風險:第一項的 Top-1 檢索召回率,直接成為整個代理系統成功的數學上限。若檢索器將正確的工具排在第二位,哪怕後端模型具備極強的推理能力,也完全無法扭轉全域失敗。
更關鍵的工程直覺在於:語意相似度絕非授權許可。檢索模組計算的是使用者自然語言與工具 Metadata 之間的向量距離,這僅能代表候選建議,絕對不能直接賦予呼叫副作用工具(如資料庫刪除、資金轉帳)的權利。
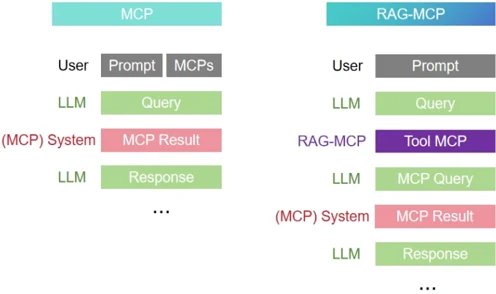
Figure 1,論文 Section 1 的推論架構對比:左側傳統 MCP 將全量工具 Schema 注入上下文引發 Prompt Bloat,右側 RAG-MCP 藉由輕量檢索器僅取回相關工具交付模型。原始 Figure 1 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

用一個例子走完整個方法 / Walk one example through the method
以下透過一個具代表性的查詢場景,走完 RAG-MCP 的端到端處理流程:
- 查詢輸入(Input): 使用者發出請求:「幫我查詢台北明日的天氣,並預訂市中心降雨機率最低的會議室。」此時註冊中心包含 5,000 個 MCP 工具,涵蓋氣象查詢、即時路況、地理編碼、飯店預訂、內部會議室管理及金流支付。
- 中間表示與向量檢索(Intermediate Representation & Retrieval):
輕量檢索器(如基於 Qwen 的編碼模組)將使用者查詢編碼為語意向量,在外部向量資料庫中比對 5,000 個 MCP 工具的 Metadata,回傳相似度最高的候選子集:
taipei_weather_service、meeting_room_booking與geocoding_api。 - 決策與相容性檢查(Decision & Validation):
系統進入驗證階段,針對排名第一的候選工具
taipei_weather_service產生測試參數,檢查其必要欄位(如location: "Taipei"、date: "2026-09-28")是否與使用者查詢相容,確認 Schema 介面可被呼叫。 - 輸出與執行(Output & Invocation):
系統將
taipei_weather_service的單一 Schema 注入執行模型(LLM)的提示詞中。執行模型順利解析出location="Taipei"與date="2026-09-28",輸出合規的 JSON 呼叫,由 MCP Client 送往目標伺服器取得氣溫與降雨預報。 - 潛在失敗點(Likely Failure Points):
- 檢索語意碰撞:若歷史氣候資料庫
historical_climate_archive的描述更冗長且向量相似度更高,排擠了即時天氣工具,執行模型將拿到錯誤 Schema,產生過時數據。 - Schema 漂移(Schema Drift):若天氣伺服器近期將參數名稱由
location升級為city_name,而外部向量索引尚未同步更新,驗證失敗或執行端將產生無效呼叫。 - 合成測試副作用風險:若驗證模組對預訂工具
meeting_room_booking執行合成測試呼叫,可能意外在真實日曆中建立無效佔位,引發非冪等操作的生產事故。
- 檢索語意碰撞:若歷史氣候資料庫
技術機制 / Technical mechanism
依據論文 Section 3.2 與架構流程說明,RAG-MCP 的核心技術架構由三個接續階段構成:
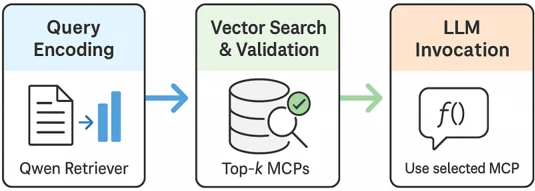
Figure 2,論文 Section 3.2 的系統執行流程:展示 (1) 使用者查詢編碼、(2) 檢索與相容性驗證 Top-k 工具 Schema、(3) 注入提示詞並執行模型調用的端到端資料流。原始 Figure 2 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

[使用者查詢 q]
      │
      ▼
┌────────────────────────────────────────┐
│ 階段 1:外部 Metadata 向量索引構建     │
│ - 將 MCP Server 與 Tool 描述向量化    │
└────────────────────────────────────────┘
      │
      ▼
┌────────────────────────────────────────┐
│ 階段 2:查詢編碼、向量檢索與候選驗證   │
│ - 輕量檢索器比對 Top-k 候選工具        │
│ - 生成 Few-shot 測試查詢做介面相容檢查 │
└────────────────────────────────────────┘
      │
      ▼
┌────────────────────────────────────────┐
│ 階段 3:執行模型注入與呼叫              │
│ - 僅將 Top-1 選中 Schema 注入 LLM 上下文│
│ - 執行模型完成參數抽取與 API 呼叫發送  │
└────────────────────────────────────────┘
1. 外部 Metadata 向量索引構建(Metadata Indexing)
將註冊中心內所有 MCP 伺服器的靜態資訊進行特徵提取。論文採用輕量 LLM(以 Qwen 為代表)作為檢索後端。然而,論文並未具體說明向量化時提取了哪些確切欄位(例如:伺服器名稱、工具名稱、文字描述、參數 JSON Schema、範例還是權限標籤),亦未載明 Embedding 模型的版本維度、分塊切分規則(Chunking)、相似度度量(餘弦相似度或內積),以及面臨服務上下線時的索引更新機制。在實際工程中,文字描述的撰寫品質直接決定了語意檢索的召回成敗。
2. 查詢編碼、語意檢索與候選驗證(Retrieval & Validation)
當使用者輸入查詢 時,檢索器先將文字轉化為向量,於索引中檢索出前 個語意最接近的候選工具 Schema。 論文提出一項值得注意的概念:對取回的候選工具,系統可自動生成 Few-shot 測試查詢,並比對其回應作為相容性完整性檢查(Sanity Check)。這構成了動態驗證層的雛形。然而,論文通篇未提供該驗證機制的通過率、假陽性(False Accept)與假陰性(False Reject)統計,亦未分析額外合成呼叫所帶來的推論延遲與 Token 開銷,更未設計防止對非唯讀工具產生副作用的防護措施。
3. 執行模型注入與工具呼叫(Execution & Invocation)
在確定候選工具後,系統最終僅將選定的 Top-1 MCP 工具描述與參數 Schema 格式化置入 LLM 的提示詞或 Function Calling API 定義中。 這正是大幅降低上下文消耗的關鍵所在:執行模型從龐大的全域探索中解脫,僅需專注於單一工具的參數填寫與邏輯規劃。但此處的邊界在於,論文實驗未涵蓋 MCP 協定規格中的進階功能,包含權限協商(Capability Negotiation)、分頁處理(Pagination)、認證握手(Authentication)與重試機制。
花花的工程筆記
把檢索器視為不可信的候選生成器(Candidate Generator)。取回候選後,仍必須先依據不可變的 Schema 版本與權限政策完成安全防護,才允許模型形成呼叫;「語意描述高度相關」絕不等於「已被授權執行」。
實驗如何讀 / How to read the evidence
論文設計了兩組核心實驗來驗證 RAG-MCP 的有效性與邊界:Section 4.1 的規模擴展壓力測試,以及 Section 4.2 基於 MCPBench 的對照評測。
1. 規模擴展壓力測試:大海撈針與退化邊界(Section 4.1)
作者建立了一套受控的壓力診斷環境:在候選池中放置 1 個能解答特定 Web-Search 任務的真實 MCP 工具,其餘則為干擾項(Distractors)。干擾項從超過 4,400 個公開 MCP 伺服器中取樣,將總候選數 從 1 逐步遞增至 11,100,共劃分 26 個數量級區間。每個配置執行 20 次搜尋任務。
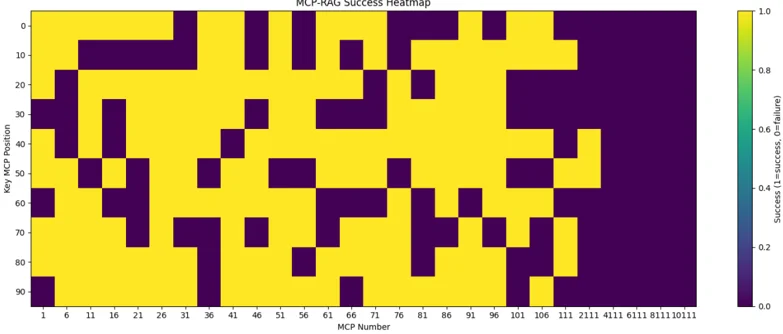
Figure 3,論文 Section 4.1 的 scale experiment:熱圖顯示 MCP schema 數量與 distractor 位置如何影響 retrieval success,正好把「候選生成」與「最終 task success」分開。見 原始 Figure 3 anchor 與 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

從 Figure 3 的熱圖(Heatmap)可清晰判讀出以下規律:
- 小規模穩定區():當工具數量較少時,系統幾乎呈現全黃色的高成功率,顯示檢索器能精準定位目標工具。
- 間歇失效過渡區():紫色失效方塊開始頻繁穿插,代表語意干擾項開始干擾向量排序。
- 大規模崩潰區():熱圖右側絕大部分被紫色失敗區域佔據,僅零星分佈少數成功孤島。
作者將此現象歸因於工具數量增加時「語意重疊度大幅提升」與「檢索精確率驟降」。這項反面證據至關重要:它直接擊碎了「只要套用向量檢索就能無限制擴大工具庫」的盲目樂觀。在數千個工具的向量空間中,唯讀與寫入、正式與測試、同 API 不同租戶之間的描述往往高度相似,純純的語意距離根本無法提供足夠的辨識能力。
2. MCPBench 受控基準評測(Section 4.2 與 Table 1)
在 Section 4.2 中,作者選用 MCPBench 的 Web-Search 子集作為評測場景。實驗基準採用 qwen-max-0125 作為基底模型,每個配置獨立執行 20 次試驗,每次試驗最多進行 10 輪工具互動。作者比較了三種路由策略:
- Blank Conditioning(全量提示詞注入):將所有候選工具的 Schema 全部置於 Prompt 中。
- Actual Match(關鍵字預篩選):以任務文字與工具 Metadata 進行字面關鍵字比對過濾後再提示。
- RAG-MCP:透過向量檢索進行全域語意排序,僅將 Top-1 工具 Schema 注入提示詞。
論文於 Table 1 報告了核心數據:
| 評測條件(Condition) | 選擇準確率(Accuracy) | 平均提示詞 Token(Avg. Prompt Tokens) | 平均生成 Token(Avg. Completion Tokens) |
|---|---|---|---|
| RAG-MCP | 43.13% | 1,084.00 | 78.14 |
| Actual Match(關鍵字匹配) | 18.20% | 1,646.00 | 23.60 |
| Blank(全量注入) | 13.62% | 2,133.84 | 162.25 |
實驗證據的精確解讀與邊界限制
細讀 Table 1 的數據與實驗設計,必須注意以下關鍵事實:
- 準確率定義的範疇:表中的 43.13% 僅是「選中真實目標 MCP 工具」的機率(Selection Accuracy),完全不等於最終任務回答正確率或端到端業務滿意度。
- Token 節省的真實帳本:相較於 Blank,RAG-MCP 的提示詞 Token 由 2,133.84 降至 1,084.00,節省幅度約 49.2%(摘要所稱「over 50%」並非 Table 1 的嚴格算術結果)。更值得注意的是,RAG-MCP 的生成 Token(78.14)明顯高於 Actual Match(23.60)。此外,計算整體成本時,必須計入外部向量資料庫查詢、Embedding 模型計算以及合成驗證的額外耗費。
- 延遲與 SLA 缺失:表格僅統計了 LLM 處理的 Token 數,完全未揭示向量比對延遲、網路往返耗時與尾端 P95/P99 延遲分佈。
- 評測裁判的不一致:論文在實驗設定段落聲稱採用
DeepSeek-V3作為自動評測器,但在指標計算段落又提及使用基於Llama的裁判模型。這種評測工具鏈的矛盾構成了顯著的可重現性缺陷。 - Top-1 瓶頸未解:實驗強制僅注入單一工具,完全未揭示 Recall@k 的分佈曲線。若目標工具落入第二名,系統便毫無容錯空間。
證據地圖 / Evidence map
為了將論文的實質貢獻與推論邊界嚴謹拆解,Bloss0m 將全篇內容劃分為四個明確層次:
- 論文直接證據(Direct paper evidence):
- Section 3.2 提出 Retrieve Validate Invoke 的三階段管線;Figure 2 繪出其架構流程。
- Section 4.1 與 Figure 3 的壓力測試證實:當候選工具池由 1 擴展至 11,100 個時,檢索成功率呈現顯著非線性退化,在超過 100 個工具後普遍陷入失敗。
- Section 4.2 與 Table 1 在 MCPBench Web-Search 子集上證明:RAG-MCP 達成 43.13% 的目標工具選中率與 1,084.00 個平均提示詞 Token,相較於全量注入的 13.62% 具備顯著優勢。
- 作者因果解讀(Author causal claim):
- 作者主張將工具發現移至外部向量索引能徹底解決提示詞膨脹問題,並允許動態掛載新工具而無需重訓模型。
- 作者認為大規模下的失敗模式主要源於工具自然語言描述的語意重疊,並提出分層檢索(Hierarchical Retrieval)與自適應檢索作為未來解方。
- 論文未證明(Unsupported claims):
- 論文未證明在多步驟複合工作流(Multi-tool Chaining)中的有效性,實驗僅限於單步 Web-Search。
- 論文未證明生產環境下的安全性:未評估提示詞注入(Prompt Injection)、惡意工具偽造 Metadata、參數污染或跨租戶存取混淆。
- 論文未證明非唯讀工具的安全性:實驗透過受控網路排除了網路超時、限流(Rate Limit)與憑證失效,且未測試具備資料庫寫入或金流交易副作用的工具。
- 論文未公開端到端程式碼倉庫、評測資料集快照與具體的 Qwen 檢索配置。
- Bloss0m 工程化整理(Bloss0m engineering synthesis):
- 工具調用必須解構為四層漏斗:檢索召回 結構相容 授權確認 執行成功;單純提高向量相似度無法跨越安全邊界。
- 強制 Top-1 路由是高風險架構;實務上必須引進明確的「拒絕路由 / 澄清分支(Abstention)」機制。
Artifact 與可重現性 / Artifacts and reproducibility
針對論文相關資源的公開狀態與可重現性進行靜態查核(截至 2026-08-24):
- 論文來源可存取:arXiv 預印本(arXiv:2505.03275 v1)與官方 HTML 全文可公開存取。
- 官方程式碼與資料集缺失:論文正文與附錄未提供官方 GitHub 儲存庫連結、模型權重 Checkpoint、MCPBench Web-Search 確切測試集下載位址,亦無可供執行的測試腳本。作者在誌謝(Acknowledgements)中提及先前的 MCP 評測報告(arXiv:2504.11094),但該報告並非 RAG-MCP 的版本鎖定複現包。
- 可重現性邊界:由於缺乏 11,100 個候選工具的具體清單、分佈排列方式、檢索模型確切超參數與驗證裁判提示詞,外界獨立研究團隊無法對論文數據進行一對一的一鍵式複現。本文評述之實驗數據均為作者報告之測試結果。
Bloss0m 工程判斷與不適用條件 / Bloss0m engineering judgment and when not to use it
基於前述架構分析與實驗邊界,Bloss0m 針對企業架構師與工程團隊提出以下選型指引:
工程決策表(Engineering Decision Matrix)
| 業務應用場景 | 推薦架構決策 | 決策核心理由 |
|---|---|---|
| 數十個穩定唯讀工具,上下文成本沉重 | 以 Shadow Mode 試行語意檢索發現 | 最符合論文驗證的情境,可在背景驗證檢索召回率而不影響現有鏈路。 |
| 多租戶環境、嚴格權限隔離架構 | 先確定性屬性過濾,再進行語意候選挑選 | 向量語意相似度絕不可跨越資料隔離與安全權限邊界。 |
| 具副作用的高風險操作(刪除、轉帳、部署) | 嚴禁將 Top-1 語意檢索作為唯一閘門 | 論文缺乏副作用防護驗證;必須由顯式狀態機與二次確認把關。 |
| 核心工具少於 30 個且語意邊界清晰 | 維持 Prompt 直接注入或靜態代碼路由 | 在小規模下引入檢索模組只會徒增延遲與新故障點,毫無收益。 |
| Schema 頻繁變動、團隊協同鬆散 | 優先建立 Schema 契約測試與版本化 | 向量索引若與 Live 伺服器產生語意漂移,將導致後續呼叫大範圍失敗。 |
| 使用者意圖模糊或資訊不足 | 主動要求澄清或執行優雅棄權(Abstain) | 強制 Top-1 路由會強行將不確定性包裝成錯誤的實際呼叫。 |
Bloss0m 推薦之多層路由工程漏斗(Multi-stage Routing Funnel)
在正式生產環境中,切勿直接採用「向量 Top-1 即呼叫」的簡化架構,應構建標準的四層漏斗防線:
- 第一層:確定性屬性過濾(Deterministic Eligibility Filter) 依據使用者身分、租戶 ID、當前環境(生產/測試)、資料敏感度與唯讀/寫入屬性,對註冊庫執行硬性規則篩選,剔除一切無權存取的工具。
- 第二層:語意候選生成(Semantic Candidate Generation) 在合規的候選池內執行向量檢索,取回 Top-(建議 )的候選工具定義,而非孤注一擲於 Top-1。
- 第三層:契約與版本校驗(Deterministic Contract Validation) 核對候選工具的不可變 Schema Hash,檢查必填參數與型別相容性,過濾掉已棄用(Deprecated)或版本漂移的伺服器。
- 第四層:模型規劃與明確棄權(Ranker & Abstention Branch) 將通過校驗的少數 Schema 交由執行模型進行決策。系統必須賦予模型「無合適工具」的棄權選項(Abstain),在證據不足時向使用者要求補充資訊,而非強行呼叫。
讀完後的三個記憶點 / Three things to remember
- 技術本質:RAG-MCP 解決的是工具清單過長時的「提示詞膨脹」與「候選縮減」問題,核心在於將發現與執行解耦,但它不是端到端的工具治理系統。
- 實驗警訊:Table 1 證實檢索優於全量注入(準確率 43.13% 對比 13.62%),但 Figure 3 鐵證指出當候選池超過約 100 個工具時,純語意檢索會因特徵碰撞發生嚴重的精確率退化。
- 落地底線:相似度不等於授權。向量檢索只能作為不可信的候選推薦;在具備副作用與安全約束的系統中,必須前置確定性過濾,並後置契約驗證與審批閘門。
延伸閱讀 / Next reading
若要探討目錄級工具檢索與微調的架構源流,可閱讀目錄級 API 呼叫先驅:
- Gorilla 深度精讀:探討當工具擴展至數千個雲端 API 時,如何在微調與推論階段同步注入檢索文件。
若關注檢索系統與外部記憶在動態更新時的抗遺忘議題,建議接續研讀:
- RAG without Forgetting 深度精讀:深入理解如何在持續寫入新知識與更新索引時,避免破壞既有知識的檢索邊界。
Primary sources
- 論文官方預印本:Gan, T., & Sun, Q. (2025). RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation. arXiv preprint arXiv:2505.03275v1,全文詳見 arXiv HTML 介面。
- 先期評測報告參考:Evaluation Report on MCP Servers. arXiv preprint arXiv:2504.11094(論文於誌謝中引用之相關先期研究)。
- 工業界協定標準:Anthropic. Model Context Protocol Specification. modelcontextprotocol.io(獨立核對之 MCP 現行架構標準規範)。