90 秒掌握論文
- 問題:Agentic RAG 在多輪 query、retrieve、read、reasoning 之後才產生最終答案;如果每個 instance 都跑到自然停止,可能在答案已經足夠後繼續花成本,也可能在已經失敗時反覆搜尋。論文問的是:能不能在每一輪的 partial answer 出現時預測它的 quality 與 utility?
- 核心洞見:partial quality 與 incremental utility 是兩個不同 target。Quality 問「現在的 answer 有多接近 ground truth」,utility 問「從上一輪到現在增加了多少」;前者較可預測,後者的正負方向更受 trajectory、retrieval noise 與 task 影響。
- 最強證據:作者在 Search-R1 與 R1-Searcher 的 HotpotQA、2WikiMultiHopQA、MuSiQue 上測試 supervised 與 unsupervised predictors。Search-R1 的 quality Pearson 最高約 0.438、utility 最高約 0.321;controller 在 thetaP=0.3、thetaU=0.2 時將平均 iterations 由 3.21 降至 2.86,減少 10.89%,保留 97.60% 的自然停止品質。
- 主要邊界:partial answer 以 F1 against gold answer probe;它不等於 open-ended answer quality,也不代表 threshold 能直接轉移到新的 retriever、model、corpus、答案型態或 controller。probing 本身還需要 generation cost。
我的 bounded verdict 是:這篇 paper 把 Agentic RAG 的 stopping decision 從固定 round cap 推向 trajectory-aware control,最有價值的不是 10.89% 這個單一節省率,而是把「目前品質」「下一輪增益」「自然停止基線」「額外 probe 成本」放在同一個可記錄的 decision contract 裡。 但它仍是 benchmark-bound 的 predictor/controller 研究,不是 production RAG 的普遍 early-stopping guarantee。
版本、來源與讀者問題
本文讀的是 Predicting Partial Answer Quality and Utility in Agentic Retrieval-Augmented Generation v1,arXiv 於 2026-09-15 提交;作者為 Fangzheng Tian、Debasis Ganguly 與 Craig Macdonald,metadata 另列 CIKM 2026 accepted full paper。本文核對了 完整 arXiv HTML、PDF、Figures 1–5、Tables 1–4、Section 3–7、limitations/future work,以及作者的 agentic_rag_predictions code repository。論文頁面標示 ACM article 的 CC BY 4.0,本文的 body figures 直接取自原始 HTML assets。
讀者問題是:對會反覆搜尋的 Agentic RAG,什麼時候「再查一輪」真的值得,什麼時候只是把已經穩定的答案再攪亂? 這個問題可以接在 VikingRAG 的結構化 evidence navigation、DocMemo 的 dynamic evidence discovery 與 EvoOntology 的 self-evolving retrieval structure 後面讀:本篇把重點從「怎麼找」移到「何時停」。
證據地圖:Paper、Evidence 與 Bloss0m judgment
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Partial quality/utility 的定義、trajectory prefix、probe scheme、supervised/unsupervised predictors、Search-R1 與 R1-Searcher setup、三個 multi-hop QA datasets、相關係數、ablation、threshold controller 與 iteration/quality trade-off。 |
| 作者主張 | Quality 比 utility 更容易預測;trajectory signals 能在自然停止前提供 early-stopping evidence;簡單 controller 可以降低平均 iterations 並保留大部分自然停止品質。 |
| 證據尚未建立 | predictor 在 open-ended long-form answer、不同 corpus、不同 LLM、不同 retriever、工具失敗或 adversarial retrieval 下的 transfer;也沒有證明 F1 probe 等於真實使用者 utility。 |
| 我的工程推論 | 把 stop decision 記成可回放的 controller event:trajectory prefix、predicted P/U、threshold version、evidence gap、probe cost、natural-stop comparator 與 human/policy override 必須一起保存。 |
Paper Essence Contract
- 它解決什麼問題? 它要在 Agentic RAG 每輪中間狀態形成時,預測 partial answer quality 與 utility,讓系統可以提早停止、避免無效的額外 retrieval。
- 為什麼既有方法不夠? 固定 iteration cap 不知道每個 instance 的 saturation point;只看最後答案又無法在下一輪以前做控制;只預測 quality 也不能回答「再做一輪是否會增加價值」。
- 核心技術想法是什麼? 從 trajectory prefix 建立 answer、retrieval、confidence、similarity 與 query-iteration alignment features,訓練 quality/utility predictors,再把預測值交給簡單的 state-based early-stopping controller。
- 一個 input 怎麼走? question → initial answer/retrieval trajectory → 每輪取得 partial answer probe → 建立 prefix features → 預測 P_i 與 U_i → 依 thetaP/thetaU 判斷 stop、rollback 或 continue → 與 natural stopping 比較 iterations 與 quality。
- 什麼證據支撐 headline claim? Table 2 的 trajectory statistics、Table 3 的 predictor correlations、Table 4 的 feature ablation、Figure 3 的 utility distribution、Figure 4 的 trajectory patterns 與 Figure 5 的 stopping trade-off。
- claim 在哪裡停止? 研究展示的是固定 models、datasets、retriever、probe 與 threshold 下的 control evidence,不是可任意轉移的 quality oracle,也沒有處理所有 open-ended、tool-use 或 production risk。
核心直覺:讓 Agent 看見「現在答案」與「下一輪價值」的差別
一般 agentic RAG loop 會把「還能不能找到更多 evidence」和「是否已經有足夠 answer」混成一個 continue heuristic。這篇 paper 先把它拆開:
- Partial quality :第 輪的 answer 對 gold answer 的品質,作者以 F1 作為 benchmark probe。
- Utility :本輪相對前一輪增加的品質,定義為 ;它可以是正、負或接近零。
- Natural stopping:原始 Search-R1 或 R1-Searcher 按自己的 agent loop 停止;這是 controller 的 quality/cost comparator,不是 oracle。
- Control decision:predictor 只看目前與過往 trajectory prefix,不能直接偷看未來 gold score;controller 用 predicted P/U 與 thresholds 做 stop、rollback 或 continue。
這個拆分讓一個常見錯誤變得可見:如果目前 answer 已很穩,quality 可能高而 utility 低,繼續 search 的 expected value 很小;如果目前 answer 很差但 utility 正,下一輪可能仍值得做;如果 quality 低且 utility 負,盲目繼續不一定能修復。真正的 controller 需要兩個 signal,且要知道 predictor uncertainty 與證據缺口,而不是只設一個 fixed cap。
Worked example:沿著 Figure 1 走一遍 Agentic RAG
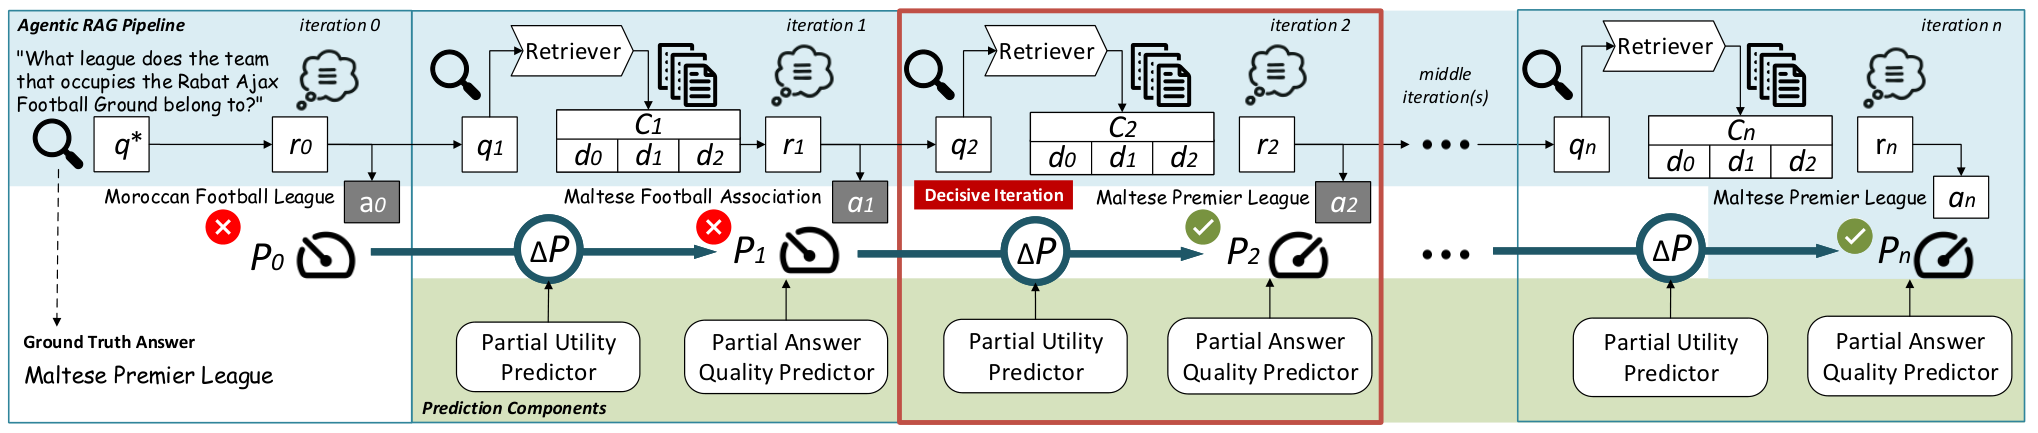
圖 1(原論文 Section 3.1,trajectory 與 in-trajectory prediction):question 先進入初始 reasoning,再反覆 query、retrieve、產生 partial answer;predictor 在每輪 prefix 上估計品質/utility,controller 再決定停止或繼續。原始圖與 caption。授權狀態:原論文頁面標示 CC BY 4.0;此處使用作者原圖,未改動內容。
用論文 Figure 1 的抽象流程來看,一個 input 不是直接走到 answer,而是形成 trajectory:
- 初始狀態:question 、初始 reasoning/retrieval state 與模型依 parametric knowledge 產生的 。 也可以沒有外部 passage,因此它不是「空答案」。
- 第 輪:agent 產生 query 、取得 context 、更新 retrieval state ,再 greedy decode 出 partial answer 。
- 形成 prefix:trajectory 可寫成 。Predictor 只能使用 prefix 內的 answer、retrieval 與 trajectory features。
- 建立 target 的離線真值:研究者用 benchmark gold answer 計算 ,再計算 。production controller 不會知道這個 gold score,所以需要學習預測。
- controller 做決策:若預測 quality 高或 predicted utility 已經低到值得停止,就結束;若曾經進入高品質狀態卻後續退化,state machine 可以 rollback 到較早的 answer;其他情況繼續 retrieval。
這個 worked example 的重點不是 Figure 1 的箭頭很漂亮,而是 decision point 被放在 partial answer 形成之後、下一輪成本發生之前。也要注意它保留了 evaluator mismatch:F1 是研究用 probe;真實使用者可能在意 citation completeness、freshness、policy compliance、解釋性或 abstention,而不是字面 token overlap。
方法與 predictor:從 trajectory prefix 取訊號
Signals 分成 answer、retrieval 與 trajectory
作者把 feature family 分成幾組。Intra-iteration features 觀察本輪 query/context 的 query performance prediction、answer confidence 與 answer state;inter-iteration features 觀察相鄰或窗口內的 answer/query/context similarity、RBO、SBERT similarity 與 confidence delta;question-iteration alignment 則問新 query 與原問題是否仍對齊。這些 signals 的目的不是宣稱某個 feature 是因果原因,而是用 prefix 的可觀測變化估計 P_i 與 U_i。
Predictor 有 supervised 與 unsupervised 兩條路。Supervised 路徑用 cross-encoder/regressor 類模型直接學 partial answer quality 或 utility;unsupervised 路徑組合 similarity、confidence、retrieval signals。部分版本用 MLP 以 window 聚合最近 、、 個 states,hidden layers 是 16 與 8。作者也比較 probing 與 non-probing:probe 可以更直接量 partial answer,但需要額外 generation;non-probing 省成本,改用已有 trajectory。
Controller 的四種 state 不是一個 threshold
Controller 以 thetaP 與 thetaU 產生 state。用 paper 的語意整理:
- State 0:predicted quality 高、predicted utility 也支持目前已足夠,停止 current trajectory。
- State 1:quality 高但 utility signal 不穩,可能停止或保守地觀察下一個 decision。
- State 2:品質尚未到門檻,或新 evidence 仍有潛在價值,繼續。
- State 3:從 state 0/1 後退化,回到最早的 high-quality state,而不是把最後一個 answer 當成最好答案。
這個整理揭示兩個 implementation risk。第一,rollback 必須保存 answer、evidence 與 trajectory pointer,而不是只重寫一個字串。第二,threshold 是 model/dataset/probe/metric specific;thetaP=0.3 不代表另一個 F1 定義、不同 answer length 或 open-ended judge 也可用。
實驗設定:兩個 agent、三個 benchmark、固定的 retrieval world
作者用 Qwen2.5-7B 的 Search-R1 與 R1-Searcher,retrieval 以 E5 對 2018 Wikipedia passage 做 top-3 retrieval,工具與 evaluation harness 使用 PyTerrier/FlashRAG 相關環境。Datasets 是 HotpotQA、2WikiMultiHopQA 與 MuSiQue;metrics 主要是 answer F1、partial quality、utility、Pearson、Kendall tau、平均 iterations 與 relative quality preservation。資料切分把多個 training splits 合併,evaluation 使用各 benchmark 的 dev/evaluation setup。
Table 2 的 trajectory statistics 提供重要 baseline。Search-R1 在 HotpotQA、2Wiki 與 MuSiQue 的 final F1 約為 0.549、0.429、0.274;delta F1 約 0.265、0.155、0.155;average utility 約 0.097、0.045、0.047;平均 iterations 約 2.730、3.463、3.337。R1-Searcher 的 final F1 約為 0.529、0.454、0.272,平均 iterations 約 2.311、2.386、2.718。這些數字提醒我們,trajectory length、quality 與 per-step gain 不是固定比例;不同 agent 的「多一輪」本來就有不同含義。
Compute、retrieval index、model checkpoint 與 generation cost 是實驗邊界的一部分。論文的 result table 不是一個可以不看 hardware、batch、provider 與 probing cost 就重算的 token budget;若把 probe 每輪都加入 production,節省的 retrieval rounds 可能被 evaluator generation 抵銷。
RQ1:partial quality 與 utility 真的可預測嗎?
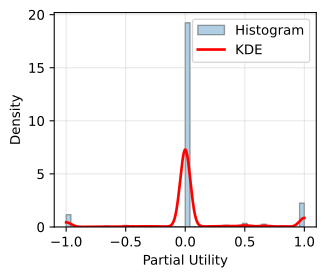
圖 3a(原論文 Section 6.1,RQ1/Search-R1):utility distribution 大多聚集在接近零的區域,兩側仍有 improvement 與 regression tail;它說明下一輪的增益不是穩定常數。原始圖與 caption。授權狀態:原論文頁面標示 CC BY 4.0;此處使用作者原圖,未改動內容。
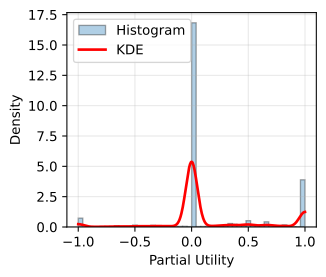
圖 3b(原論文 Section 6.1,RQ1/R1-Searcher):換一個 agent 後,utility 的零附近聚集、正負 tails 與 fluctuation 仍值得分開觀察;不能只用一個 average gain 取代 trajectory。原始圖與 caption。授權狀態:原論文頁面標示 CC BY 4.0;此處使用作者原圖,未改動內容。
Figure 3a 與 3b 的共同訊息是 distribution 集中在零附近,但仍有正、負 tail。Figure 4 的 trajectory analysis 更細分三種形狀:positive trajectories 在前幾輪改善後 plateau;negative trajectories 早期下跌且通常難以恢復;zero trajectories 上下波動,總體沒有 net improvement。這些 pattern 正是「quality high」與「utility low」可能同時出現的原因。
Table 3 的 correlation 顯示 quality 比 utility 更容易預測。Search-R1 的最佳 quality Pearson 約 0.438、Kendall tau 約 0.345;最佳 utility Pearson 約 0.321、tau 約 0.208。R1-Searcher 的 quality 也約在 0.4 附近,而 utility 最佳約 0.321。Supervised predictor 通常最強;把 all feature families 合在一起接近或達到最佳,但 probing 對相關係數的增益有限,而且要付 generation cost。這支持「trajectory prefix 有 signal」,不支持「predictor 已經是可靠 oracle」。
RQ2:哪些 feature family 真的有用?
Table 4 以 Search-R1 做 ablation。Quality predictor 的 Pearson:
- intra-iteration:window 1/3/5 約 0.323/0.351/0.347;
- inter-iteration:約 0.312/0.331/0.334;
- question-iteration alignment:約 0.306/0.326/0.330;
- all families:約 0.343/0.363/0.358,且差異達到 paper 報告的 p<.05。
這裡有兩個讀法。第一,window 3 常比 window 1 穩定,表示最近幾輪的 change pattern 比單一步驟更有資訊;window 5 沒有持續更好,說明把更長歷史塞進 predictor 不是免費提升。第二,all features 只帶來 bounded improvement,並不是每個 signal 都應被放進 production。Feature acquisition、logging、privacy、latency 與 missingness 會改變實際成本。
RQ3:early stopping 的節省與 quality trade-off
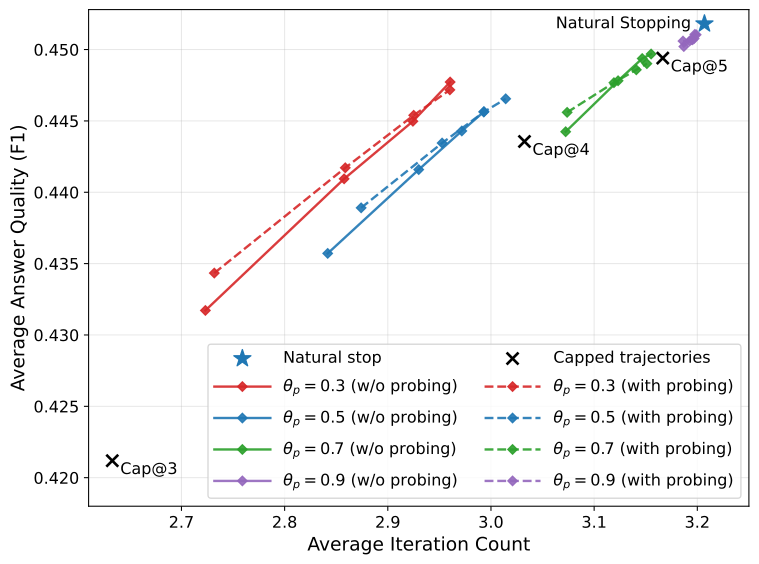
圖 5(原論文 Section 6.3,RQ3):Search-R1 的 threshold controller 在平均 iterations 與相對自然停止品質之間形成 trade-off;較激進的 stopping 可以省更多輪,但 quality preservation 會下降。原始圖與 caption。授權狀態:原論文頁面標示 CC BY 4.0;此處使用作者原圖,未改動內容。
自然停止的 Search-R1 平均 iterations 是 3.21。thetaP=0.3、thetaU=0.2 的 controller 把平均 iterations 降到 2.86,減少 10.89%,並保留自然停止 quality 的 97.60%。把 thetaU 調到 0.3,quality preservation 提升到 98.49%,但平均 iterations 增加約 0.06。這是很合理的 frontier:更嚴格地要求 utility 變差才停,節省較少但保留品質較多。
固定 iteration cap 是對照,不是同一種 controller。較 sharp 的 cap 會讓 quality drop 更明顯;probing 能提供額外 partial-answer information,但每輪都要生成 evaluator output,所以額外品質不能脫離 latency/token cost 讀。paper 的 evidence 支持 adaptive controller 在這個 harness 中優於粗糙 fixed cap,不支持一個 threshold 對所有 traffic 都最佳。
Artifact 與可重現性:公開 code,不等於完整重跑包
作者的 GitHub repository 是 public、default branch 為 master,包含 control、predictions、probing、prediction_head、tests、environment.yml 與 figures/docs 相關路徑。我獨立查看 README 與 tree:它清楚列出 probing、feature、predictor、controller 的程式碼與 lightweight tests;同時也說明需要 Python 3.11、PyTorch、FAISS、Java、model provider access、retrieval indices、data 與 checkpoints。
大型 trajectory dumps、retrieval results、dense/sparse indices、model checkpoints 與資料沒有隨 clean clone 提供;repository 也沒有明確的 open-source license file。README 的語意比較接近「可檢查 code path、可重新產生部分 checkpoint/control flow」,而不是下載後即可重現 Tables 2–4 與 Figure 5。這是可用但條件式的 artifact status:code 可讀、測試可跑,但完整 reproduction 需要外部資料、index、model 與 compute。
Paper 的 DOI 10.1145/3799682.3840904 是 CIKM 2026 record;我在 2026-09-17 以 DOI endpoint 獨立檢查時得到 HTTP 404,因此本文把它保留為 publication identifier,不把目前 endpoint 寫成可下載 artifact。它也不能替代 GitHub 上缺失的 data/checkpoint bundle。若要做可信重跑,還需要固定 Qwen2.5-7B checkpoint、retriever version、2018 Wikipedia snapshot、top-3 index、probe prompt/decode policy、threshold config、evaluation split 與 hardware/generation accounting。
Bloss0m 工程化整理:把 stopping decision 做成可回放事件
下面是本文的 engineering judgment,不是 paper claim。我會把每次 controller decision 記成不可變 event:
| Event field | 為什麼要留 | 不留會發生什麼 |
|---|---|---|
| trajectory prefix hash 與 step index | 知道 predictor 看到哪一段 history | 同一個 answer 之後無法回放 signal |
| partial answer、retrieved evidence 與 source version | 把 P_i/U_i 的 input 連回 evidence | 只能看到分數,無法判斷 evidence 是否缺失 |
| predicted P、predicted U、uncertainty 與 threshold version | 知道 stop/continue 的理由 | threshold 改版後無法解釋舊 decision |
| natural-stop comparator 與 fixed-cap counterfactual | 衡量節省和品質代價 | 10.89% 變成沒有 baseline 的 marketing number |
| probe latency、tokens、model、provider 與 cache state | 把 evaluator cost 納入 TCO | probe 可能吃掉停止節省 |
| policy override、abstention、rollback pointer | 允許高風險 query 不服從 predictor | predictor 錯時只剩最後 answer,沒有安全出口 |
這份 contract 也需要一個 explicit evidence gap。當 query 尚未覆蓋必要 entity、retriever 給出互相衝突的 passages、citation 不完整、工具回傳 unknown,controller 不能只看 predicted P;它應該把 continue、abstain、human review 或 deterministic verifier 交給 policy layer。這是從 paper evidence 推出的工程延伸,不是 paper 在 benchmark 上測過的 safety mechanism。
什麼時候值得使用?
Early stopping 值得考慮的情境是:query traffic 很大、每輪 retrieval/generation 成本可量化、任務有可計算或可校準的 partial-quality proxy、trajectory logging 完整、natural-stop baseline 穩定,而且錯誤可以被 abstain 或 downstream verifier 捕捉。它最像 adaptive compute controller,不是 answer correctness 的替代品。
什麼時候不要直接使用?
若任務是 open-ended long-form research、法律/醫療高風險建議、答案品質高度依賴 citation completeness、或 retriever/corpus 正在劇烈變動,不應直接把 F1 predictor 與 thetaP/thetaU 搬進 production。若 query 中包含 novel entity、工具失敗、跨語言資料、adversarial passage 或需要最新資料,也要先驗證 probe 與 training distribution。固定 cap 雖然粗糙,但在 predictor 未校準、trajectory 不可觀測或 stop error 代價極高時,可能比未驗證的 adaptive stopping 更容易治理。
限制、失敗模式與證據邊界
Paper 的核心限制首先是 task/metric:F1 對短答案與 multi-hop QA 有用,但不能完整描述 open-ended explanation、citation validity、freshness、policy compliance 或 user utility。其次是 model/retriever:只測 Search-R1、R1-Searcher、Qwen2.5-7B、E5 top-3、2018 Wikipedia 與三個 benchmark;不同 model size、retrieval depth、tool failure pattern、corpus drift 或 answer format 可能改變 predictor。
再來是 probe cost 與 controller simplicity。In-trajectory probing 可以取得更直接的 partial answer,但會消耗生成 latency;non-probing 降低成本,卻依賴已有 signals。Controller 是簡單 heuristic state machine,不是 uncertainty-aware optimal stopping。paper 也指出 advanced agentic RAG 與 open-ended long-form 是 future work;因此不能把 97.60% 當成品質保證,也不能把 10.89% 當成固定成本節省。
最後是 reproducibility boundary。Repository 沒有大型資料、index、checkpoint 與明確 license;沒有 confidence interval 的 headline transfer analysis 也不能由本文自行補出。即使 clean clone 能驗證 control flow,也不代表能在相同 corpus/model/hardware 重現全部 tables。這些是 artifact、成本與轉移的 diagnostics,不是對作者工作的否定。
三個記憶點
- Quality 和 utility 不是一件事:現在答案可能已經夠好,但再查一輪沒有增益;也可能目前不夠好,但下一輪仍有正 utility。
- Adaptive stopping 必須和 natural-stop baseline 一起報:Search-R1 從 3.21 降到 2.86 iterations、少 10.89%,同時保留 97.60% quality,才是一個有語境的 trade-off。
- Predictor 不是 oracle:F1 probe、固定 threshold、三個 benchmark、特定 model/retriever 與不完整 artifact 決定了 claim boundary;production 仍需要 evidence gap、abstention、logging 與 verifier。