讀法可搭配 三遍掃描法。本篇是檢索增強生成的基礎方法,不是 Agent 迴圈。RAG 使用的 retriever 見前一篇 DPR;完整方法關係見 RAG 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:大型預訓練模型把事實塞進參數裡,知識密集任務仍落後專用架構;參數記憶難更新、難追溯,也容易胡謅。
- 核心洞見:把預訓練的 seq2seq 生成器(BART)接到預訓練的 dense retriever(DPR 初始化)與 Wikipedia 索引。決策點從「只靠參數答」改成「先取回段落,再條件化生成」。RAG-Sequence 整段共用一份文件;RAG-Token 可按 token 換文件。
- 最強證據:Table 1 的開放域 QA:NQ 上 RAG-Seq 44.5、RAG-Token 44.1,高於 DPR 41.5、REALM 40.4、T5-11B+SSM 36.6。Table 2 的生成與分類:Open MS-MARCO 上 RAG-Seq 相對 BART 各 +2.6 Bleu/Rouge-L;FEVER-3 72.5,距當時 pipeline SOTA 76.8 差 4.3 個百分點,且沒有 retrieval 中間監督。
- 主要邊界:記憶是 2018 年 12 月 Wikipedia 切成 21M 個 100 詞塊,不是私有語料;檢索是 dense MIPS,不是 production hybrid;沒有 agent 的 search/read/final,也沒有 2026 企業意義上的 citation faithfulness。
我的結論是:RAG 最值得保留的貢獻,是把可檢索的非參數記憶接到生成器。這篇論文沒有定義完整的 Production RAG 平台、工具路由器,也沒有要求 agent 先讀完證據再回答。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Lewis et al., NeurIPS 2020 對應的 arXiv:2005.11401 v4,首發於 2020-05-22,最後修訂於 2021-04-12。PDF 與 arXiv HTML 標示 arXiv.org perpetual non-exclusive license;NeurIPS 正式版另受會議版權約束。
作者順序依 v4 PDF:Patrick Lewis、Ethan Perez、Aleksandra Piktus、Fabio Petroni、Vladimir Karpukhin、Naman Goyal、Heinrich Küttler、Mike Lewis、Wen-tau Yih、Tim Rocktäschel、Sebastian Riedel、Douwe Kiela。Lewis 與 Perez 是標題下通訊作者列的前兩位;Ethan Perez 標示 NYU,其餘作者分屬 FAIR 與 UCL。
除摘要外,本文核對 Section 2 的 RAG-Sequence/RAG-Token、Section 3 的任務設定、Table 1–6、Figure 1–3、Appendix A–I,以及截至 2026-08-27 的工件。
DPR(Karpukhin et al.)在此只作為 RAG 使用的 retriever。除非 RAG 論文本身報告,本文不搬用 DPR 獨有的數字,也不納入 Self-RAG、agentic RAG 排行榜或其他後續方法的結果。
這是已發表的 NeurIPS 論文,不是 preprint。
讀者真正要回答的問題
當模型要做知識密集的生成時,工程上是該繼續把世界塞進參數,還是給它一份可替換的非參數記憶、並讓取回的文件進入生成條件?Lewis et al. 的回答是:用預訓練 BART 當參數記憶、用 DPR 初始化的 dense retriever 查 Wikipedia,再端到端微調,讓 成為生成 的潛在變數。
比較精確的讀法不是「RAG 是不是現在的企業搜尋產品」。真正的問題是:把檢索接到生成這個改變,在哪些任務上真的移動分數,又在哪裡因為記憶是 Wikipedia、檢索是 dense-only、或生成不必引用而出界?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1 把 retriever 與 generator 接成端到端;Table 1 給出 NQ/TriviaQA/WebQ/CuratedTrec 的 Exact Match;Table 2 給出 Jeopardy、Open MS-MARCO、FEVER;Table 4 是 452 對 Jeopardy 人工比較;Table 6 是 BM25/凍結 retriever 消融;Figure 2 顯示 RAG-Token 可按 token 換文件;Figure 3 顯示測試時 的影響;index hot-swap 用 82 位領袖。 |
| 作者主張 | 混合參數/非參數記憶能做知識密集生成;不必 salient-span 預訓練也能強;生成式答案可勝過抽取式;索引可熱替換以更新世界知識。 |
| 論文未證明 | 私有語料上的 RAG;BM25+dense 的 production hybrid;reranker/ACL/權限過濾;citation 與答案一一對應的 faithfulness 產品;agent 的多步 search/read/final;Self-RAG 或 2025–26 agentic RAG 排行榜。 |
| Bloss0m 工程判斷 | 本篇定義的是 dense 檢索如何條件化生成。多模態文件見 RAG-Anything,工具路由見 RAG-MCP,圖譜方法見 GraphRAG vs RAG,規模化詞重疊見 BM25 at scale,先讀再答見 Before Reasoning Can Fail,動態證據見 DocMemo,證據接地見 FinRank。這些方法的問題設定與證據不能直接互換。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列,不是 2026 的排行榜。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2020 年前的兩條線寫清楚。
純參數記憶:預訓練語言模型能把事實存進權重(論文引 Petroni et al.、Roberts et al. 的 closed-book QA)。缺點也寫死了:記憶不好擴、不好改、不好指出來源,還會 hallucination。
可微檢索但停在抽取:REALM 與 ORQA 把 masked LM 接到可微 retriever,結果不錯,可是下游停在開放域抽取式 QA。生成這條 NLP 主力架構還沒接上非參數記憶。
因此舊方法不夠的地方不是「沒人想過檢索」,而是控制點被切開:要嘛只靠參數生成、把世界更新留給再訓練;要嘛檢索只服務 span extraction。RAG 改的正是生成器的條件:輸出 必須對潛在文件 邊緣化。
核心直覺 / Core intuition
先不要看表。想像閉卷考試對開卷考試。閉卷把整套 Wikipedia 壓進 BART 的權重;開卷允許先把相關段落放到桌上,再寫答案。RAG 要做的是後者——而且段落是 dense 向量找回來的,不是瀏覽器點擊,也不是人寫進 prompt 的 few-shot。
對照三種容易混在一起的下一步:
- Closed-book seq2seq(BART/T5):下一步只能是 ,條件裡沒有 。
- RAG(本篇):下一步仍是生成 ,但 的機率對取回的 Wikipedia 段落邊緣化。沒有 thought 通道,也沒有環境 observation。
- 後續方法:多模態解析、工具 schema 檢索、圖譜、動態證據與 read-before-final 都處理不同問題,其分數不屬於 2020 年的表格。
用一個例子走完整個方法 / Walk one example through the method
以下用 Figure 2 的 Jeopardy 教學例走完 RAG-Token,不是獨立實驗結果。輸入實體是 Hemingway。
- Input:只有答案實體
Hemingway。沒有 Bing、沒有 MCP、沒有私有 PDF。few-shot 不存在;這是微調過的 seq2seq,不是 prompting。 - Intermediate representation:query encoder 把輸入編成 ,對 21M 個 100 詞 Wikipedia 塊做 MIPS,取出 top-(此圖 )。Document 2 提到 The Sun Also Rises;Document 1 提到 A Farewell to Arms。文件編碼器 與索引固定。
- Model or system decision:BART 看到的是 與某個 的拼接。RAG-Token 在每個 token 上對這 份文件邊緣化,所以生成「Sun」時 Document 2 的後驗升高,生成「A Farewell to Arms」時 Document 1 升高。RAG-Sequence 則會為整段 選同一份 ,較難在一句裡把兩本書接起來。
- Output:Figure 2 的生成走勢對應一句把兩本小說接在同一作者名下的 Jeopardy 線索。Table 3 另有紙本例子:輸入
The Divine Comedy時,RAG-S 寫出分成 Inferno/Purgatorio/Paradiso 三部;BART 把 Purgatorio 寫了兩次。 - Likely failure point:若任務不太需要事實(Appendix H 的故事生成),retriever 會 collapse,反覆取回同一批文件,生成器學會忽略 ,模型退化成 BART。索引若過期,領袖問答會從約 70% 掉到 12%/4%(Section 4.5)。抽取式系統在「答案字串不在任何取回文件裡」時得 0%;RAG 在 NQ 這種情況下仍有 11.8% 正確——那是參數記憶在補,不是引用保證。
這條 Hemingway 題教的是機制怎麼走完。要看開放域 QA 分數,應回到 Table 1;要看「學檢索」是不是多餘,應看 Table 6。
技術機制 / Technical mechanism
系統有兩塊,對應 Figure 1。
Retriever 是 DPR 的雙編碼器:
越大、與 越對齊,該段落越容易進 top-。提高 等於讓更多段落進入邊緣化;Figure 3 顯示這對 RAG-Sequence 的 NQ 單調有幫助,對 RAG-Token 則在約 10 篇見頂。訓練時 。
Generator 是 BART-large(方法正文寫 400M;Appendix G 計 406M,加上兩個 BERT-base 110M,共 626M 可訓練參數)。輸入是 與 的字串拼接。這些 被稱為參數記憶。
兩種邊緣化改的是「一份文件管多長」:
RAG-Sequence 假設整段 由同一份 生成:
增加某個 ,等於把整段答案押在那一份文件上。解碼不能單次 beam:先對每份 做 beam(Thorough Decoding 還會補跑沒出現在該 beam 的假設);長輸出可改 Fast Decoding,把沒被該 生成出來的 近似為 0。
RAG-Token 允許每個 token 換文件:
這裡提高的是「下一個詞可以從另一份段落來」的彈性,也增加了把兩份證據縫成一句的機會。分類任務把標籤當成長度 1 的序列,兩種 RAG 等價。
訓練最小化 ,Adam。文件編碼器與索引不更新——作者認為不必像 REALM 那樣週期重建索引。被微調的是 與 BART。沒有對「該取回哪一篇」的直接監督。
操作約束:
- 記憶:2018 年 12 月 Wikipedia,不相交 100 詞塊,21M 篇;FAISS HNSW。Appendix G 把索引寫成 21M 個 728 維向量、15.3B 個值(論文自己的算術)。
- 解碼(Appendix A):開放域 QA 用 greedy;RAG-Token 測 15 篇、RAG-Sequence 測 50 篇並用 Thorough Decoding。MS-MARCO/Jeopardy 用 10 篇、beam 4、Fast Decoding。
- 小資料:CuratedTrec 與 WebQuestions 從 NQ 的 RAG 權重初始化,做法跟 DPR 論文對齊,但是 RAG PDF 自己寫的。
- Null document(Appendix F):加空文件機制沒幫忙,主實驗省略。
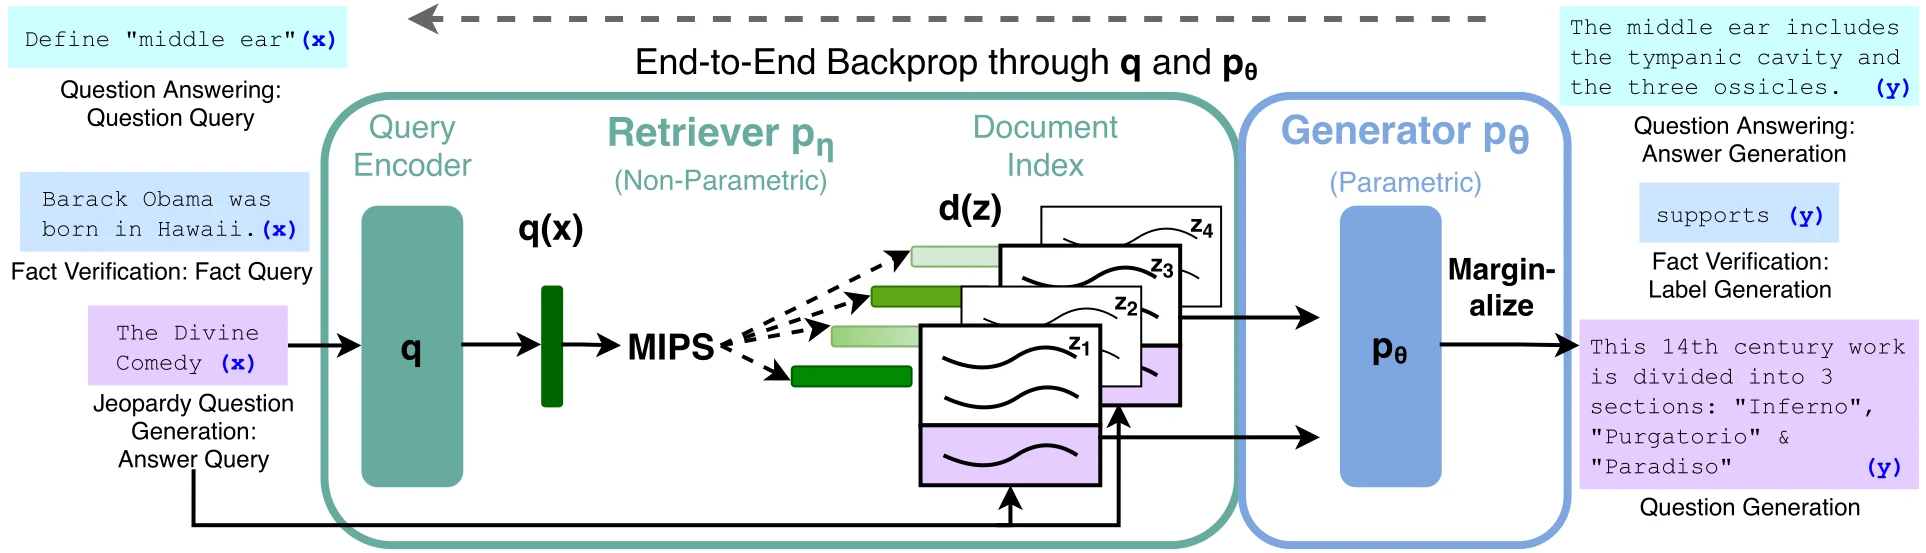
Figure 1,論文 Introduction/Section 2:左側是 QA/事實驗證/Jeopardy 三種 ,中間是 Query Encoder+Document Index 的 non-parametric retriever,右側是 parametric generator 與邊緣化後的 。原圖可定位到 Figure 1,SVG endpoint 為 RAG-Architecture.svg。取自 arXiv v4 HTML/對應圖檔;頁面標示 arXiv.org perpetual non-exclusive license,NeurIPS 2020 正式版另受會議版權約束。本文依 arXiv reuse terms 做教學引用。

實驗如何讀 / How to read the evidence
開放域 QA、抽象生成、Jeopardy 命題、FEVER 分類問的不是同一件事。QA 看短答案 Exact Match;MS-MARCO 看在不提供 gold passages時能否寫出參考句;Jeopardy 看事實性與具體性;FEVER 看沒有證據監督時的標籤準確率。索引始終是同一份 Wikipedia。
Table 1:NQ 的 44.5 是生成式 RAG,不是抽取式 DPR
這張表問:同一個知識密集 QA 設定下,閉卷生成、抽取式 open-book、以及 RAG 生成,Exact Match 差多少?控制住的是 2018 Wikipedia 與既有 train/dev/test 切分;改的是要不要檢索、以及檢索之後是抽 span 還是生成。
| 模型 | NQ | TQA(開放域 / Wiki) | WQ | CT |
|---|---|---|---|---|
| T5-11B | 34.5 | — / 50.1 | 37.4 | — |
| T5-11B+SSM | 36.6 | — / 60.5 | 44.7 | — |
| REALM | 40.4 | — / — | 40.7 | 46.8 |
| DPR | 41.5 | 57.9 / — | 41.1 | 50.6 |
| RAG-Token | 44.1 | 55.2 / 66.1 | 45.5 | 50.0 |
| RAG-Seq. | 44.5 | 56.8 / 68.0 | 45.2 | 52.2 |
觀察:NQ 上 RAG-Seq 44.5 超過 DPR 41.5 與 REALM 40.4,而且不必 salient-span masking。WebQ 與 CuratedTrec 也由 RAG 取當時表內最高。TriviaQA 要拆開讀:習慣上的開放域 test(左欄)DPR 57.9 仍高於 RAG-Seq 56.8;作者明寫「四個任務的 SOTA」對 TriviaQA 只成立在與 T5 可比的 Wiki test(右欄 68.0)。Appendix D 解釋兩套切分,不要把 68.0 寫成開放域慣例分數。
作者解釋生成為何能贏抽取:文件裡沒有 verbatim span 仍可貢獻;NQ 上答案不在任何取回文件時,RAG 仍有 11.8% 正確,抽取式為 0%。這支持「生成能用參數記憶補洞」;它不支持「答案都有出處」。
這張表不能支持 2026 的開放域 QA 排行榜,也不能把 DPR 左欄 57.9 讀沒有。DPR 在本表是 retrieve-and-extract 基線,不是本篇要精讀的論文。
Table 2/Table 4:生成比 BART 更具體,但不保證贏過看 gold 的 SOTA
Table 2 問:沒有 gold passage 時,RAG 的生成與分類相對純 BART 與當時 SOTA 如何?
| 模型 | Jeopardy B-1 | QB-1 | MS-MARCO R-L | B-1 | FEVER-3 | FEVER-2 |
|---|---|---|---|---|---|---|
| SotA | — | — | 49.8* | 49.9* | 76.8 | 92.2* |
| BART | 15.1 | 19.7 | 38.2 | 41.6 | 64.0 | 81.1 |
| RAG-Tok. | 17.3 | 22.2 | 40.1 | 41.5 | 72.5 | 89.5 |
| RAG-Seq. | 14.7 | 21.4 | 40.8 | 44.2 | 72.5 | 89.5 |
星號列使用 gold context/evidence。Open MS-MARCO 上 RAG-Seq 相對 BART 各 +2.6 Rouge-L 與 Bleu-1(40.8−38.2、44.2−41.6),仍低於看 gold 的 49.8*/49.9*。論文自己舉「What is the weather in Volcano, CA?」:沒有 gold 段落就對不上參考答案,而且有些題 Wikipedia 根本答不了。
Jeopardy 上,RAG-Token 的 Q-BLEU-1 22.2 高於 RAG-Seq 21.4 與 BART 19.7;但 RAG-Seq 的 BLEU-1 14.7 低於 BART 15.1。作者將 Token 的優勢歸因於一句線索常包含兩件事實,因此可能需要跨文件生成。
Table 4 比較 452 對 BART 與 RAG-Token 輸出。事實性評估中,RAG better 42.7%、BART better 7.1%、Both good 11.7%、Both poor 17.7%、No majority 20.8%。正文另稱「雙方都符合事實」約 17%,與 Both good 11.7% 不一致;本文以 Table 4 為準,把 17% 視為作者概述。具體性欄位合計為 93.0%,表中沒有解釋缺少的 7 個百分點。
FEVER-3 72.5 距 Zhong et al. 76.8 為 4.3 個百分點,而且 RAG 沒有證據句監督。FEVER-2 89.5 距使用 gold sentence 的 RoBERTa 92.2* 為 2.7。取回標題與 gold 文章重疊:top-1 71%、top-10 90%。Appendix E 明寫 FEVER 的第二子任務(抽證據句)因 Wikipedia dump 不同而沒做。
這組結果支持「生成任務上 RAG 比同尺寸 BART 更具體、FEVER 上接近有監督 pipeline」;它不支持「已經贏過看 gold 的系統」或「引用忠實」。
Table 6/Figure 3:學檢索有用,但 FEVER 上 BM25 更好
消融問兩件事:query encoder 要不要學?dense 是否處處贏過 BM25?
Dev Exact Match(Table 6):NQ 上 RAG-Seq 44.0、凍結 retriever 41.2、BM25 31.8。WebQ 上 Token 46.5 vs 凍結 37.1 vs BM25 32.1。學檢索在 QA 上不是裝飾。FEVER 相反:BM25 的 FVR-3 75.1、FVR-2 91.6,高於 dense RAG 的 74.5/90.6。作者解釋 FEVER 主張偏 entity、適合詞重疊。這與後來 BM25 at scale 的工程直覺同方向,但那篇的 10M token 交叉點不是本表數字。
Figure 3 左:測試時多取文件,RAG-Sequence 的 NQ 單調上升,RAG-Token 在 10 篇見頂。中:learned RAG 的 NQ answer recall 高於 Fixed DPR 與 BM25。右:MS-MARCO 上多取文件抬高 RAG-Token 的 Rouge-L、壓低 Bleu-1。Appendix A 的測試 是依 dev 選的,不是生產 SLA。
Index hot-swap:2016 vs 2018 dump、82 位換屆領袖、「Who is {position}?」。匹配索引 70%/68%;錯配 12%/4%。這支持「換非參數記憶就能改答案」;它不支持持續爬蟲或權限過濾。
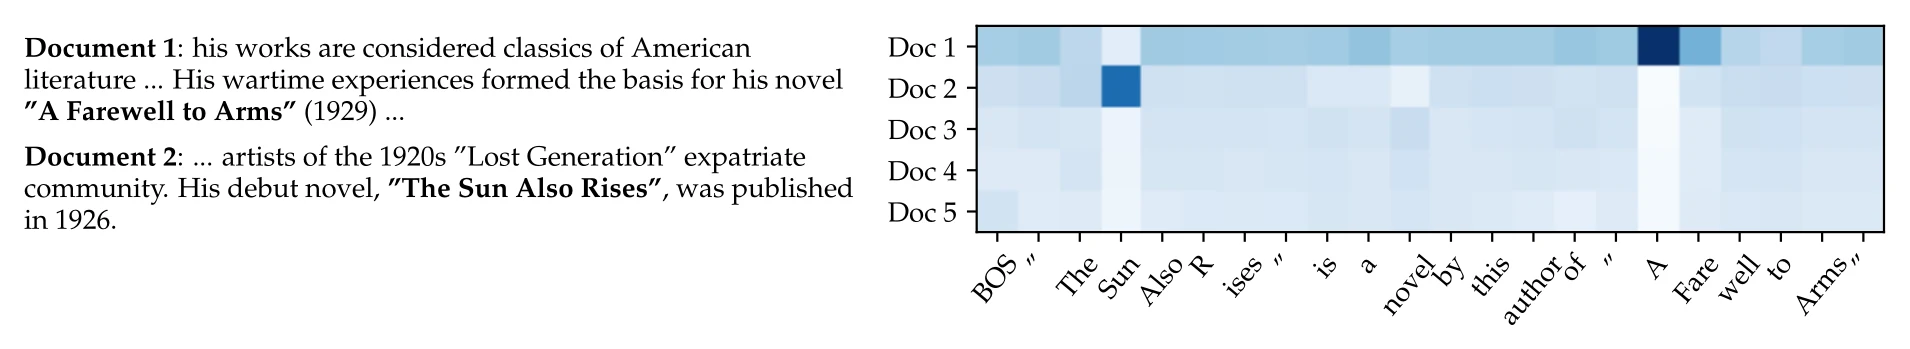
Figure 2,論文 Section 4.3:RAG-Token 在 時每個生成 token 的文件後驗 。原圖可定位到 Figure 2,PNG endpoint 為 posterior_plot.png。取自 arXiv v4 HTML/對應圖檔;授權同 Figure 1。

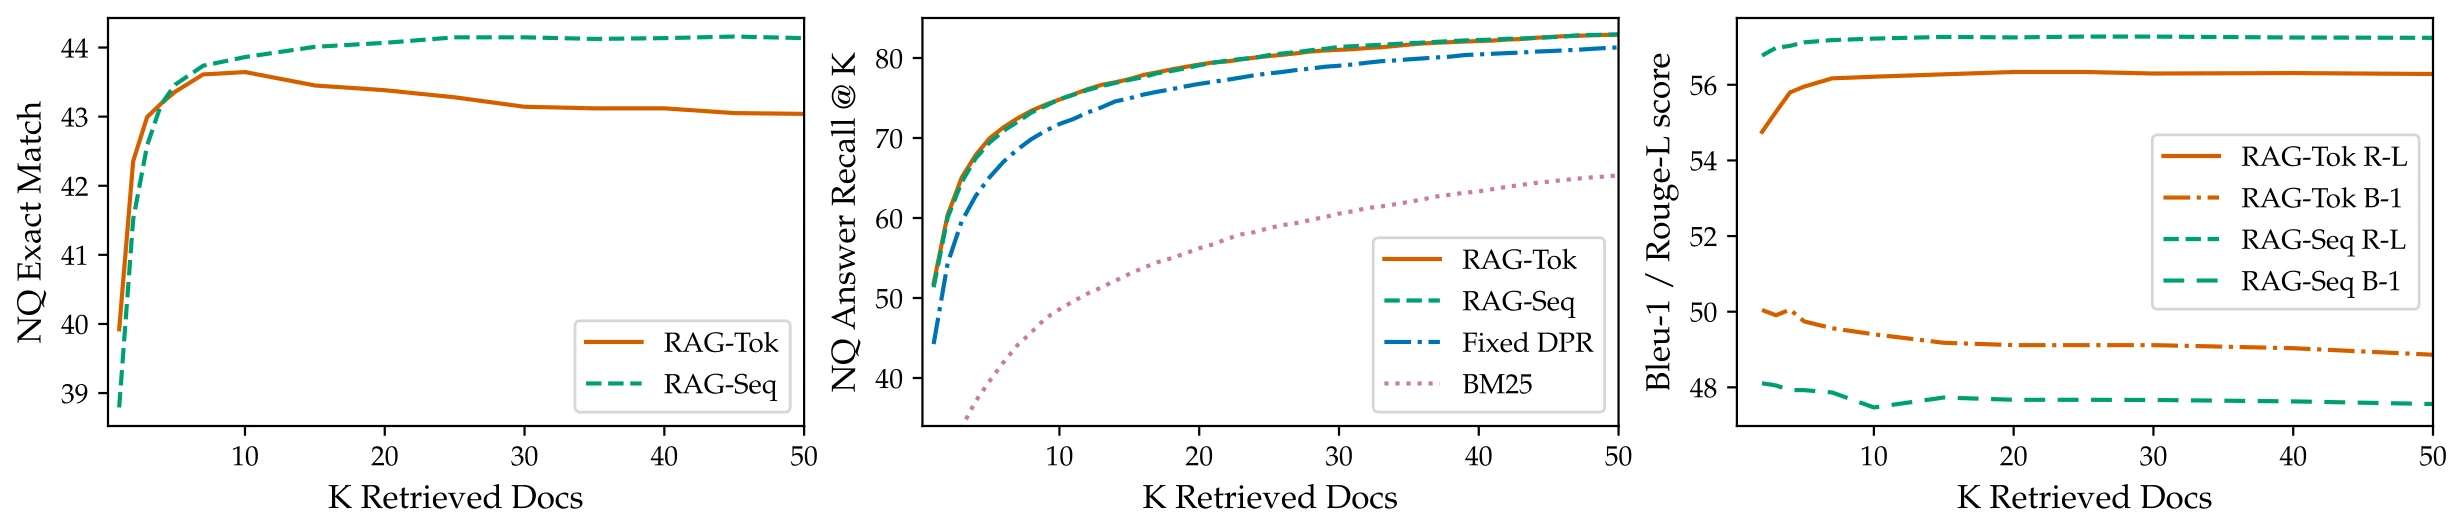
Figure 3,論文 Section 4.5:測試時調整 的三張圖。原圖可定位到 Figure 3,SVG endpoint 為 retrieval_plots_flat.svg。取自 arXiv v4 HTML/對應圖檔;授權同 Figure 1。

限制、威脅與不該過度推導的話 / Limitations and threats to validity
論文把風險寫在 Broader Impact:Wikipedia 並非無偏、可被拿去產假內容。讀表時還要留下這些邊界:
- Wikipedia 當記憶。 21M 個 100 詞塊、2018-12 dump。私有語料、權限、新鮮度治理都不在表內。熱替換證明的是換索引,不是 production freshness SLA。
- Dense-only。 主系統是 FAISS MIPS。BM25 只當消融;FEVER 上它更好。本篇不是 hybrid 堆疊施工圖。
- 不是 agent 迴圈。 沒有 thought、瀏覽器動作或「先讀再答」的程序閘。Before Reasoning Can Fail 等後續方法處理的是另一個問題。
- 不是 citation 產品。 生成可以對、文件也可以錯;11.8% 的 NQ 正確來自參數補洞。FEVER 只報標籤準確率,證據句子任務沒做。
- TriviaQA 的 SOTA 有條件。 左欄 DPR 仍高;68.0 是 Wiki test。
- 人類評估不完美。 Table 4 與正文 17% 不一致;具體性列加總不是 100%。
- 分開後續研究的證據。 Self-RAG、RAG-Anything、RAG-MCP、GraphRAG、DocMemo、FinRank 與 2025–26 agentic RAG 排行榜都不屬於這張表。
- 檢索可能 collapse。 Appendix H:故事生成等任務上 retriever 學成與輸入無關,模型等於 BART。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用本篇?當任務是知識密集生成或短答案 QA,你願意維護一份可替換的文件索引,並且接受答案是生成出來的、不是保證可引用的 span。此時應分開記錄:取回的 、生成的 、以及 是否真的能在 裡對上。query encoder 可以學;文件編碼器與索引可以凍結,再用熱替換改世界。
什麼時候不要把這篇論文當成施工圖?
- 文件是掃描件、表格、公式,需要可回指原圖時,讀 RAG-Anything。本篇假設純文字塊。
- 問題是從大量 tool schema 裡挑一個時,讀 RAG-MCP。那是工具路由,不是 Wikipedia QA。
- 需要圖譜多跳而不是 dense top- 時,讀 GraphRAG vs RAG。
- 語料大到詞重疊開始划算時,讀 BM25 at scale。本表 FEVER 已提示 entity 題上 BM25 可以贏。
- 失敗模式是「搜了但沒讀就答」時,讀 Before Reasoning Can Fail。2020 RAG 沒有那道閘。
- 長文件要跨回合改證據時,讀 DocMemo。
- 需要把答案綁回可審計證據時,讀 FinRank。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v4 PDF、HTML 可讀,license 為 arXiv.org perpetual non-exclusive。NeurIPS 2020 摘要頁 與 camera-ready PDF 可開啟。
- 程式:論文指向 Hugging Face Transformers 的
examples/rag/。當前main上該路徑 404。歷史標籤 v4.21.3 research_projects/rag 可存取(HTTP 200)。模型文件 仍在。這不是一份永遠不變的官方 runtime。 - 模型卡(usable):facebook/rag-sequence-nq、facebook/rag-token-nq 以及
rag-sequence-base/rag-token-base回 200。論文寫的互動 demo 路徑https://huggingface.co/rag會轉到rag-token-nq。 - 索引/資料:facebook/wiki_dpr 可開啟;舊短名
datasets/wiki_dpr回 404。DPR 文件編碼器 facebook/dpr-ctx_encoder-single-nq-base 可開啟。這是相關工件,不是本篇私有釋出。 - 訓練環境(論文宣告):Fairseq、8 張 32GB V100、混合精度;FAISS 放 CPU,全文索引約 100GB,壓縮後 36GB。單卡可跑訓練與推論。主實驗不是「下載一個 notebook 就能復現 Table 1」。
最小有用 reproduction 是:用公開的 facebook/rag-sequence-nq 對一小撮 Natural Questions 題跑 greedy 生成,確認輸出是生成字串、且條件中有取回的 Wikipedia 塊。不要宣稱這能復現 Table 1 的 44.5。
三個記憶點 / Three things to remember
- 技術想法:RAG 把 改成對 dense 取回的 Wikipedia 段落 邊緣化;RAG-Sequence 整段共用一份文件,RAG-Token 可按 token 切換。
- 證據:NQ 上 RAG-Seq 44.5 超過 DPR 41.5 與 T5-11B+SSM 36.6;MS-MARCO 相對 BART +2.6;FEVER-3 72.5 距有監督 pipeline 4.3 分。學 query encoder 在 QA 上有用,FEVER 上 BM25 更好。
- 邊界:這是 2020 年的 Wikipedia seq2seq RAG,不是 hybrid 生產平台、agent 迴圈或 citation 產品;後續方法的數字應分開閱讀。
延伸閱讀
RAG 處理的是「生成要不要條件化於取回的段落」。接下來可依問題選讀:
- 決定何時檢索並進行自我批判:Self-RAG。
- 處理多模態原件:RAG-Anything。
- 檢索工具 schema:RAG-MCP。
- 使用圖譜或規模化詞重疊:GraphRAG vs RAG、BM25 at scale。
- 要求先讀再答、動態更新證據或證據接地:Before Reasoning Can Fail、DocMemo、FinRank。
閱讀方法見 三遍掃描法。