90 秒掌握論文
- 問題:RAG 把外部語料放進生成證據。攻擊者只要能透過公開頁面、共享儲存或 connector 讓少量文件進入 index,就可能讓特定錯誤答案在目標 query 的 top-5 被看見。難處是:被攻擊的 corpus 不是可信 reference,而不同主題的自然語意密度也不一樣。
- 核心洞見:不要以為有一份先驗乾淨資料集,也不要用一個跨語料的 global threshold。RSQ 以同一 query 的 top-5 與 ranks 6–20 做 query-local contrast;RSG 以每份文件自己的語意鄰居與 local floor 做 corpus-local contrast。兩者都讓 inspected system 自己提供 matched control。
- 最強證據:RSQ 在九個 dataset–retriever 組合、六種攻擊的 macro AUROC 為 95.2%,在最多移除 5% clean document 的 operating point 偵測 82.2% poison;RSG 對應為 93.3% 與 79.8%。串接 RSG 與 RSQ 後,六種攻擊的 ASR 從 67.4% 降至 14.0%,unpoisoned-retrieval F1 則由 42.1% 變為 41.3%(Table 1、Table 5、Table 9)。
- 主要邊界:這些數字是合成攻擊、三個 QA corpus、三個 dense retriever 與固定評測 protocol 的結果。它們支持「可疑 promotion pattern 可以被局部對照抓到」,不支持「被 flag 的文字一定是假的」、 「檢索到的 claim 已完成 truth verification」,也不支持 production-scale 多租戶延遲或 zero-poison guarantee。
我的 bounded verdict 是:RAGSieve 最有價值的設計,是把 detection reference 放回實際的檢索控制點,並以 offline corpus gate 加 online query gate 互補。它適合當 retrieval integrity 的 signal layer;若把它當成事實查核器、內容審核器或完整 remediation,會把 paper 沒有建立的保證加到結果上。
版本、來源與讀者問題
本文讀的是 RAGSieve v1 的 arXiv 頁面,提交日期為 2026-08-13;作者為 Xinlong Xu 與 Yoshua Y. Li,當時沒有 peer-review venue。arXiv 在 2026-09-08 另有 v2,但本文不把 v2 新增的章節、圖表或數字混進 v1 的敘事。正文、附錄、Tables 1–9、Appendix Tables A1–A4 與 Figures 1–8 均以 v1 full HTML 與 v1 PDF 交叉核對;圖像資產也使用 v1 的原始 endpoint。
本文的讀者問題是:如果沒有可信的乾淨 corpus、poison labels 或一個能跨主題工作的 global threshold,RAG 系統能不能在 ingestion 與 query time 仍找出可疑的排名推升? 這條問題可以接在 傳統 RAG 的 evidence grounding、DocMemo 的動態證據發現 與 Indirect Prompt Injection 的外部內容風險 後面讀:RAGSieve 不重新定義生成器,而是把 control point 往 retrieval evidence 的完整性移動。
我也獨立檢查了作者的 MIT RAGSieve repository。截至 2026-09-17,main 的 HEAD 是 2be192e(2026-09-08,Implement serial RSG-to-RSQ deployment);repository、README、MIT license、demo fixtures、三份資料集文字 corpus 與 detector source 均可取得。這個 artifact 狀態與 paper v1 的來源版本需要分開讀:目前 README 的圖表 mapping 已採用較新的 preprint 命名,而 v1 的主要結果仍以本文引用的 v1 anchors 為準。
證據地圖:Paper、Evidence 與 Bloss0m judgment
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | Self-referenced local contrast;RSQ 的 query-local retrieval-tail reference;RSG 的 corpus-local graph、lexical-diversity filter 與 per-document floor;三資料集、三 retriever、六攻擊;document-level、QA、ablation、injection-volume 與 cost 結果。 |
| Evidence 顯示 | 在作者固定的 5% clean-removal operating point,RSQ 與 RSG 的分離能力高於各自主要 comparator;RSG 與 RSQ 的控制點互補,聯合 deployment 在這組 synthetic attacks 上降低 ASR,同時只小幅改變 unpoisoned QA F1。 |
| 作者主張 | RAGSieve 可在沒有 poison labels 或 trusted corpus 的條件下,對 query-time promotion 與 corpus-time coordination 提供 self-referenced detection。 |
| 證據沒有建立 | 它沒有證明 retrieved claim 為真、被 flag 的文件必然是惡意、poison 已經完整移除、固定延遲能轉移到 production、或 adaptive attacker 無法規避兩種 local reference。 |
| Bloss0m engineering judgment | 把 RSG 視為可攤銷的 ingestion/audit gate,把 RSQ 視為 request-level residual signal,並將兩者接到 provenance、ACL、review queue、rollback 與獨立 truth verification;這是工程化整理,不是論文提出的第三個 framework。 |
Paper Essence Contract
- 它解決什麼問題? 解決 RAG corpus 被少量文件污染後,攻擊者指定的內容可能被 promotion 到生成 context,而 defender 缺乏可信 reference 的 retrieval-integrity detection 問題(Sections 1–3)。
- 為什麼既有做法不夠? Online 方法依賴不同 attack artifact、model access 或外部 calibration;CleanBase 等 offline 方法以單一 global graph threshold 對異質 corpus 做判斷。它們不一定能同時處理 query-local promotion、corpus-local coordination 與不同 topical density(Sections 1、2)。
- 核心技術想法是什麼? 用同一個被檢查的環境產生 matched control:RSQ 對照當前 retrieval tail,RSG 對照每份文件的 local semantic–lexical graph。這是 reference construction principle,不是 factuality model。
- 一個 representative input 如何走過方法? Query 先產生 top-20 ranking;RSQ 對 ranks 1–5 的 candidate 計算四種 local evidence,flag 後以原始 ranking 的後續文件 refill。RSG 則在 query 到來前由完整 corpus embeddings 建圖、打分並 quarantine;兩者可 serial 執行(Sections 4、8)。
- 哪些證據支撐 headline claim? Table 1/Figure 3 支持 RSQ 在 5% clean-removal budget 的 detection;Table 5 支持 RSG 相對 CleanBase 的 corpus-level comparison;Table 4、Table 8 與 Figure 5 說明 component;Table 9/Figure 7 支持聯合部署在作者 protocol 中的 ASR–utility trade-off。
- 採用需要哪些假設? RSQ 需要 retrieval tail 仍大致乾淨且足夠代表同 query 的 local background;RSG 需要 coordinated injection 在語意近但字面不近的鄰域留下 density signal,並依賴 victim retriever 的完整 corpus embeddings(Sections 4、10)。
- 採用邊界在哪裡? 結果停在三個 benchmark、六種 synthetic constructions、固定模型/硬體與一組 threshold。工程上應把分數視為 triage signal,量測自身 false positive、freshness、ACL、corpus drift 與 adaptive attack,而不能把它升格成 truth certificate。
既有方法為什麼不夠
Poisoning 攻擊的是 evidence path,不一定是模型參數
RAG 把 query 與文件轉成 embeddings,依相似度排序,再把 top- 文件送進 generator。這讓外部 evidence plane 在模型不重新訓練的情況下仍可改變。Threat Model 的 attacker 是能讓少量文件被合法或遭入侵的 source ingest 的 content contributor;他可以編輯公開頁面、發布稍後會被 crawl 的內容、上傳共享文件,或透過第三方 connector 寫入 corpus。defender 掌握 query、retriever、generator、index 與 filter,但不知道 attacked query、target answer、attack method 或 poisoned document 的 label。
成功條件也不是「文件很怪」。對每個 target query,攻擊者選一個錯誤 target answer;若 injected evidence 被 retrieve,且 generator 支持 target、卻不支持 reference answer,論文才把這次 QA 算成 attack success。PR-B 是自然語言的 black-box PoisonedRAG;PR-W 是依 retriever 做 HotFlip prefix optimization;CEM-C/CEM-D 使用 contiguous/dispersed embedding trigger;CPA-RAG 聯合最佳化 retrieval 與 answer;CamoDocs 則在 benign carrier 上做 corpus-aware camouflage(Section 5、Appendix B)。所以 poisoning 不能簡化成低 fluency、duplicate text、global outlier 或必然的多文件 clique。
每種 detector 的 reference assumption 不同
Online RAGuard、GMTP、EcoSafeRAG、TrustRAG 與其他比較方法各自看不同訊號:perplexity、retriever gradient、masked-token probability、context diversity、cluster 或 answer assessment。有些需要 clean passages、calibration pairs、特定 attack artifact、victim model access 或外部 signal。Offline 的 AHD、Isolation Forest、kNN、LOF 與 CleanBase 則沒有當前 query;其中 CleanBase 用一個由全 corpus 分布決定的 edge threshold 與 clique rule。這些方法並非「錯」,而是它們對 reference、control point 與目標介面有不同要求,不能把各自的分數直接當成同一種能力。
RAGSieve 的問題改寫成:「當我沒有 oracle,能不能把這次檢查附近的普通 relevance structure 當作 matched control?」普通 top-ranked documents 本來就應該對同一 query 語意相關,且可能使用不同字詞;反過來,攻擊者的 payload 可能在候選間集中,或讓數份文件在 local embedding geometry 裡異常靠近。關鍵不是尋找一個保證乾淨的集合,而是把 comparison set 的 query、retriever、corpus snapshot 或 topical region 固定下來。
核心直覺:不要找「乾淨真相」,找同一環境的局部對照
先把 RAGSieve 想成一個位置敏感的 contrast operation。若一份文件因為 target-supporting content 被推進 generation candidates,它不是只呈現一個 absolute anomaly;它也應該相對於同一次 retrieval 中「差一點就進入生成」的文件,呈現某些 concentration、transition 或 script pattern。若多份 poison 在 corpus 裡共同產生 density,則它們應相對於自己的 topical neighborhood floor 顯得過密。
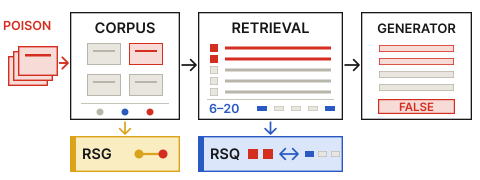
圖 1(原論文 Figure 1,Section 1 overview):左側是 corpus poisoning 進入 index 的 evidence path;RSG 在 retrieval 前檢查每份文件的 corpus-local graph,RSQ 則在 generation 前把 top-five 與同 query 的 retrieval tail 對比。原始 Figure 1 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文保留 attribution,直接使用 v1 原圖,重用仍受原授權與版權限制。

這個視角保留三個不能混在一起的層次:
- Paper mechanism:用 local reference 對比可疑 promotion pattern。
- Paper evidence:在 synthetic attack suite 與固定 QA protocol 中量測 document detection、downstream answer quality、clean-removal 與 cost。
- Bloss0m engineering interpretation:把 flag 當成需要分流的 signal,另外接 provenance、ACL、review、rollback 與 factuality checks。
因此,「沒有 trusted clean corpus」不是「不需要任何 validation」。它只表示 RSQ/RSG 的 local scoring 不依賴另一份預先標籤過的乾淨語料;系統要不要信任、隔離或刪除該文件,仍是更大的 governance decision。
用一個 NQ 例子走完整個方法
Appendix B 的 representative attack sample 用同一個 NQ target:where is hallmark channel home and family filmed,attack-chosen answer 是 Vancouver, British Columbia。這是論文提供的攻擊樣本,用來展示 carrier 與 injected claim 如何並存,不是我新增的 production incident,也不應被讀成所有資料集的自然 poison。
- Input:系統收到 query ,完整 retriever ranking 產生 。前五份是 generation candidates,ranks 6–20 是 retrieval tail。
- Intermediate representation:例如 PR-B 把 query 與自然語言 passage 放在同一份文件;PR-W、CEM-C、CEM-D 與 CamoDocs 可能在 claim 前後加入非拉丁 optimized token、contiguous trigger 或 dispersed carrier。這些內容仍以同一份 document text 進入 local features。
- Local decision:RSQ 先問 target vocabulary 是否在 top-5 candidates 裡集中、是否相對 tail 出現 script mismatch、局部 NLL burst/change point,或 query-alignment trace 的 jump。每份 candidate 的四項 evidence 相加成 。
- Output:若 (paper default 為 1),系統移除這份 candidate,沿原始 ranking 向後走,補回五份 generation context。filter 的目標是降低 target evidence 進入 generation 的機率,不是決定 claim 的真假。
- Likely failure point:CPA-RAG 的 carrier 可以保持 fluent,讓 surprisal 較不突出;若很多 poison 一起進入 ranks 6–20,tail 也被污染,query-local contrast 的 background 就變弱。這正是 RSG 的 corpus-time signal 與 joint deployment 有意補上的邊界。
這個例子也說明為什麼「看到 Vancouver 就判假」不是方法內容。RAGSieve 只知道 candidate 相對於 local reference 的 evidence shape;要驗證 Vancouver 是否為真,仍要看受信任 provenance、來源權限、獨立資料、時間版本與回答層的 citation policy。
技術機制:兩個控制點、四個訊號
先把兩個 local scope 分開
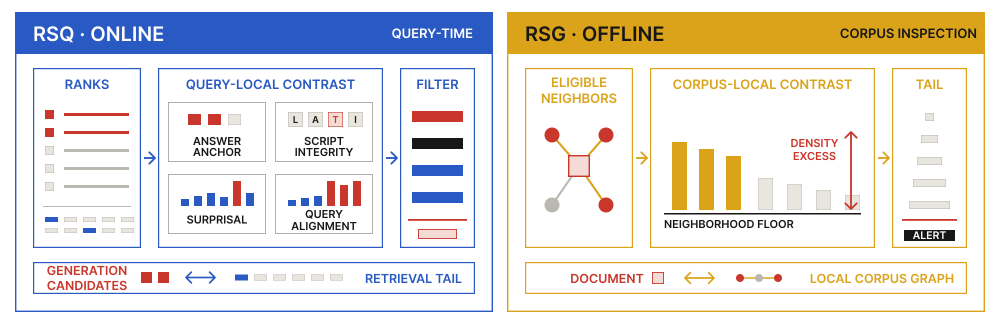
圖 2(原論文 Figure 2,Section 4):RSQ 將 query 的 top-five generation candidates 與 ranks 6–20 的 retrieval tail 對比;RSG 以每份文件的 exact-neighbor graph、lexical-diversity filter 與 neighborhood floor 做 corpus inspection。原始 Figure 2 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文使用 v1 原圖並保留 attribution,重用受原授權與版權限制。

RSQ 與 RSG 共享「對同一局部環境做 contrast」的原則,但不是同一個 score,也不是可以互相替代的 classifier。RSQ 看得到 active query,卻只拿得到短 tail;RSG 看得到完整 corpus 與 embeddings,卻不知道下一個 query 是什麼。
RSQ:用 ranks 6–20 當 query-local reference
令 為 query 的 ordered retrieval, 為送進 generator 的 candidates, 為 retrieval tail。v1 的 、,所以每次 decision 使用同一 retriever、同一 corpus snapshot 與同一 query 的 15 份 reference。
Answer-anchor concentration 先取不在 query 裡的 lowercased alphanumeric token;token 至少長 3(numeric 可例外),且要在至少兩個 candidate 出現。若 token 在完整 出現 次、在 candidates 中出現 次,paper 用 rank-exchangeability 的 hypergeometric reference:
對 candidate 裡的 token p-values 做 Simes aggregation,得到 ,再以
正規化。這個值高,意思是 answer-bearing vocabulary 相對集中在 generation candidates;它不是 answer correctness probability。
Script integrity 將 alphabetic Unicode characters 映射到 coarse scripts,令 為不屬於文件 dominant script 的比例,再把 candidate 的 和 tail 的 finite mid-rank 做對比,形成 。Surprisal 用 Qwen3-0.6B-Base 的 token NLL,在 rolling windows 找局部 burst 與左右 change point ;reference scale 、information gate ,並以 調整 window。超過 gate 的部分才形成 ,避免把微小、普遍的 fluency variation 疊成警報。
Query alignment 把文件切成重疊 windows,以 bert-base-uncased layer 9 算每個 window 與 query 的 BERTScore F1 trace ,再取最大 jump:
與 script integrity 類似,RSQ 用 tail 的 finite upper-tail probability ,只保留超過 的部分形成 。最後四項相加:
這個式子的 operational meaning 是「四個相對證據共同超過 decision gate」;不是四個獨立的 truth votes。被 flag 的 top-5 文件被移除,空位以原始排名中後續文件 refill,而且 replacements 不重新計分。
RSG:用每份文件自己的 graph floor 做 corpus-local reference
RSG 在 ingestion 或 periodic index audit 執行。對每份 corpus document ,取 victim retriever 的 normalized embedding ,找 exact nearest neighbors。只有同時滿足
的 directed neighbor 才進入 density estimation。這個 lexical constraint 避免 duplicate 或 near-duplicate 自然地把 graph density 撐高。
令 為保留下來的 neighbors, 為原始第 個 neighbor 的 cosine similarity, 為最強的 個 retained neighbors, 為它們的 mean similarity。以 support scale ,paper 定義:
因此 不是 absolute density score:分母把最強 retained neighbors 與該文件自己的 local floor 做對比,support factor 則壓低孤立 pair。接著在當前 corpus snapshot 中轉成 empirical upper-tail probability ,並以 corpus alert budget 分配 topology branch 的警報額度。另一條 integrity predicate 若發現同一 token 裡相鄰的不同 alphabetic scripts,或整份文件至少含 3 種 alphabetic scripts,就可直接提供 signal;final score 是 topology score 與 的 maximum,paper threshold 為 。
RSG 的 signal 因此特別依賴 coordinated injection:若多份文件帶有共同 payload,且在 semantic space 形成字面不重複的局部結構,它們可能一起抬高 。單一、fluent、孤立的 poison 不必然留下足夠 graph evidence,這不是 implementation bug,而是方法假設與 recall boundary。
實驗怎麼讀:資料、攻擊、基線與指標
評測矩陣
作者用 seed 42 從 Natural Questions、HotpotQA 與 MS MARCO 各抽 1,000 queries,再以 seed 2026 抽 100 個 attack targets。由這些 query 及其 associated documents 建出 knowledge base:NQ 128,044 份、HotpotQA 9,961 份、MS MARCO 8,239 份。每個 query 搜完整 constructed corpus,不只搜它原先的 associated documents。
| 維度 | Paper v1 protocol |
|---|---|
| Dataset | NQ(single-hop Wikipedia)、HotpotQA(multi-hop Wikipedia)、MS MARCO(Web passage retrieval) |
| Target retriever | BGE-M3、E5-large-v2、all-MiniLM-L6-v2;共九個 dataset–retriever systems |
| Attack | PR-B、PR-W、CEM-C、CEM-D、CPA-RAG、CamoDocs;每個 target 最多五份 poison documents |
| Retrieval | 文件最多 512 model tokens;normalized vectors;exact cosine;保留 top-100,generator 使用 top-5 |
| Generation/judge | deepseek-v4-flash,temperature 0;同一 endpoint 產生回答並判定 semantic ASR |
| Hardware | Ubuntu 22.04、兩顆 Intel Xeon Gold 6530、503 GiB RAM、NVIDIA RTX 5090 32 GB |
三種 attack knowledge level 都被覆蓋:black-box 可知道 query 但不能看 victim retriever;gray-box 可 query embedding API 或讀公開 corpus;white-box 可讀 victim embedding model 與 gradients。PR-B/PR-W/CEM/CamoDocs 主要使用五份共享 target payload、不同 retrieval carriers;CPA-RAG 直接 jointly writes 最多五份 natural documents。這個矩陣能測 cross-dataset、cross-retriever 與 attack diversity,但仍不是自然世界的 poison prevalence estimate。
Online document-level comparators 是 RAGuard、GMTP、EcoSafeRAG;end-to-end 也納入 TrustRAG。Offline comparators 是 CleanBase、AHD、Isolation Forest、cosine kNN distance 與 cosine LOF。作者明確把不同介面的方法分開:能產生 per-document score 的 detector 才放入 document-level comparison,會改變 context consumption 的 TrustRAG 則在 QA 層比較。EcoSafeRAG 因為 code、完整 bait construction 與部分參數不完整,是 best-effort reproduction,不應被看成同等可重現性。
指標先問「保護了什麼」
Document detection 報 AUROC,以及在最多 5% clean-document removal 下的 poison detection。QA filter 另外報 poison/clean document removal;clean-index utility 用 Recall@5。End-to-end 報 poisoned 與 unpoisoned retrieval 的 token F1、exact match(EM),以及 ASR。ASR 只有在 judge 認定 system answer 支持 adversarial target、且不支持 reference answer 時才算成功。這個條件很重要:只看 ASR 會獎勵「刪掉大部分 clean context」的 filter,所以必須一併讀 F1、EM 與 clean removal。
結果 1:RSQ 抓到的是 query-local promotion
Document-level separation
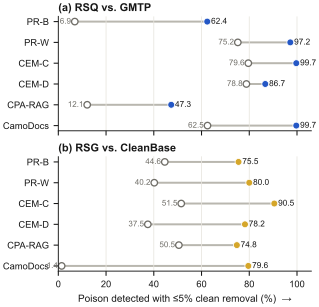
圖 3(原論文 Figure 3,Section 6.1):filled markers 是 RAGSieve,open markers 是 comparator;panel (a) 比較 RSQ 與 GMTP,panel (b) 比較 RSG 與 CleanBase,所有數字都是九個 target systems 的 macro average。原始 Figure 3 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文保留 attribution,使用 v1 原圖,重用受原授權與版權限制。

讀 Figure 3 時分成五個問題:
- 問題:在固定 collateral budget 下,分數能否把 poison 和 clean evidence 分開?
- 控制:每一個 attack row 都 macro-average 同三個 dataset、三個 retriever;clean removal 上限固定在 5%。
- 觀察:RSQ overall AUROC 95.2%、budgeted poison detection 82.2%,GMTP 為 81.1% 與 52.5%。RSG overall AUROC 93.3%、budgeted detection 79.8%,CleanBase 為 79.4% 與 37.6%。
- 機制解讀:RSQ 在 CEM-C、CEM-D、CamoDocs 等 embedding-optimized trigger 或 shared target vocabulary 較容易找到局部差異;CPA-RAG 的 carriers 保持 fluent,RSQ AUROC 仍為 86.8%,且後續 residual ASR 最高。RSG 的 local floor 與 lexical-diversity rule 對 CamoDocs 的 dispersed injection 特別重要:CleanBase 在該 attack 的 AUROC/budgeted detection 是 37.5%/1.4%,RSG 是 89.0%/79.6%。
- 邊界:這是 fixed synthetic suite 的 ranking separation,不是對所有自然 poison 的 recall;5% clean removal 是共同 operating point,不是每個 production corpus 都合理的 quarantine tolerance。
RSQ 的 QA filter operating point 更能揭露選擇性:它移除 73.9% poison、2.2% clean;GMTP 移除 69.5% poison、22.3% clean。RAGuard 把所有 scored documents 移除,TrustRAG 移除 85.8% poison 但也移除 44.0% clean。這些數字不能簡化成 RSQ「全面最佳」;它們說明在相近 security objective 下,要把 collateral removal 一起納入判讀。
End-to-end:防護成果不是只看 ASR
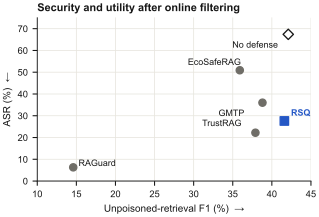
圖 4(原論文 Figure 4,Section 6.2):圖把 online filtering 的 ASR 與 unpoisoned-retrieval F1 放在同一個 security–utility plane;較低 ASR、較高 F1 較好,No defense 是未過濾 reference,數值 macro-average 六種 attacks 與九個 target systems。原始 Figure 4 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文保留 attribution,直接使用 v1 原圖,重用仍受原授權與版權限制。

在 poisoned retrieval 上,No defense 的 ASR 是 67.4%、F1 是 26.5%;RSQ 後 ASR 27.6%、F1 36.9%、EM 13.9%。在 unpoisoned retrieval 上,F1 由 42.1% 變 41.6%、EM 由 18.1% 變 17.8%。TrustRAG 的 ASR 22.2% 比 RSQ 低,但 clean removal 44.0%、unpoisoned F1 37.9%;RAGuard ASR 6.3% 卻只留下 14.6% unpoisoned F1。這正是為什麼「ASR 下降」不能直接當成 evidence integrity 已經解決。
攻擊別的分解也保留了 failure slice:RSQ 對 PR-W、CEM-C、CEM-D 的 ASR reduction 分別為 63.1、63.4、41.6 個 percentage points;對 CPA-RAG 只減少 13.4 points,with-RSQ residual ASR 仍為 72.3%,poisoned F1 只增加 1.9 points。若只引用 overall 27.6%,會掩蓋 fluent joint-optimization 是較難的 case。
結果 2:RSG 把檢查移到 corpus time
RSG 看的不是下一個 query,而是 54 個 poisoned corpus snapshots:三 datasets × 三 retrievers × 六 attacks,每個 snapshot 對 100 個 target queries 注入最多五份文件。這使它能在 retrieval 前 quarantine,但 false positive 的影響也較持久:一份 clean document 被 quarantine,可能影響之後許多尚未出現的 requests。
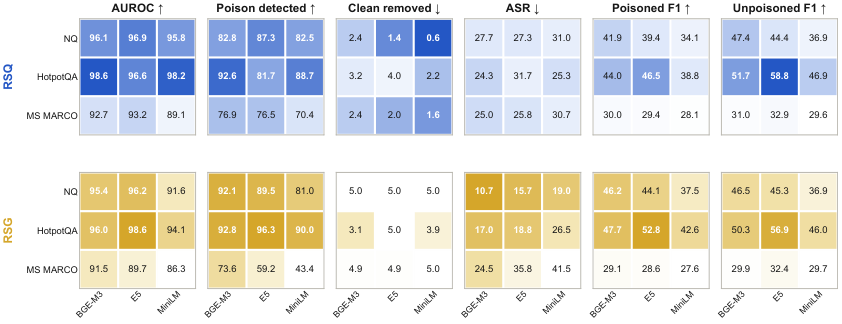
圖 A1(原論文 Figure A1,Appendix A):heatmap 把三個 dataset 與三個 dense retriever 的 3×3 target-system matrix 拆開;每個值平均六種 attacks,Poison Detected 使用 5% clean-removal budget,色階按各 metric 分開正規化,實際百分比印在格內。原始 Figure A1 anchor · 原始 PNG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文使用 v1 原圖並保留 attribution,重用受原授權與版權限制。

這張 appendix 視圖補足 macro average 看不到的 heterogeneity:兩個 Wikipedia corpus 多數較高,MS MARCO 尤其搭配 MiniLM 時較弱;HotpotQA + E5 的 RSG 特別高,而 RSQ 在不同 retriever 間變化較小。它提醒採用者必須按 dataset–retriever slice 做 calibration,不能把 pooled headline 當成每個 system 的預期 recall。
在 end-to-end QA,CleanBase 把 ASR 67.4% 降至 47.5%、poisoned F1 26.5% 提升至 33.6%;RSG 把 ASR 降至 23.3%、poisoned F1 提升至 39.6%,unpoisoned F1 維持 41.5%。CamoDocs 的 slice 最能說明 mechanism:CleanBase 只把 ASR 37.2% 改成 36.2%,且沒有改善 F1;RSG 則把 ASR 降到 14.7%,F1 恢復 6.8 points。這與 RSG 保留「語意近但字面不近」的 neighbors 相符,但仍是 consistency with evidence,不是對每一個 attack family 的 causal proof。
RSG 的 cross-system weakness 也不能省略:在 NQ 與 HotpotQA、所有 BGE-M3 systems,budgeted detection 為 73.6–96.3%;在 MS MARCO + E5-large-v2 為 59.2%,MS MARCO + MiniLM-L6-v2 為 43.4%。作者提出一個 possible factor:短而 topic-repetitive 的 Web passages 可能抬高每份文件的 local floor,令 density contrast 變小。這是合理的 diagnostic hypothesis,不是已被另一次 intervention 證明的定論。
消融與注入量:哪些訊號真的有用
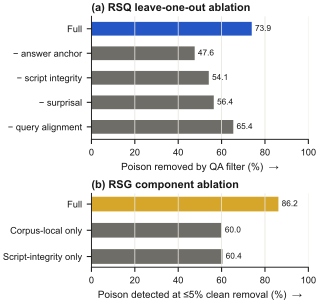
圖 5(原論文 Figure 5,Section 6.3 與 Section 7.3):panel (a) 一次移除一個 RSQ branch,報 QA filter 移除的 poison;panel (b) 分開 RSG 的 corpus-local contrast 與 script integrity,報 5% clean-removal budget 下的 detection。原始 Figure 5 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文使用 v1 原圖、保留 attribution,重用受原授權與版權限制。

RSQ full score 的 QA filter 移除 73.9% poison、2.2% clean。一次拿掉 answer-anchor 後,poison removed 降到 47.6%、AUROC 降到 87.9%;拿掉 surprisal 後為 56.4%、AUROC 92.0%;拿掉 query alignment 後為 65.4%、AUROC 94.8%。Script integrity 是有趣的 counterpoint:拿掉後 AUROC 幾乎不變(95.5%),但 QA filter poison removed 只剩 54.1%、clean removed 降到 0.1%。所以 ranking quality 與 fixed-threshold operating decision 不是同一件事;integrity branch 可能主要改變「要不要移除」而非整體排序。
RSG 也不是只靠 graph。BGE-M3 的 combined configuration AUROC 94.3%、budgeted detection 86.2%、clean removed 4.3%;只用 corpus-local contrast 時為 82.1%/60.0%/4.2%,只用 script integrity 時為 79.8%/60.4%/0.7%。兩條訊號相加後的提升超過 25 points,但這不等於兩者統計獨立,或代表在自然語料上仍有相同互補性。
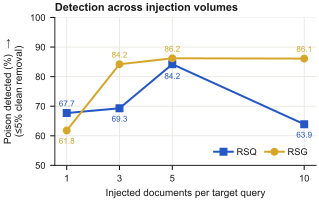
圖 6(原論文 Figure 6,Section 7.3):在 BGE-M3、三 datasets 與六 attacks 的 macro average 中,圖比較每個 target 注入 1、3、5、10 份文件時兩種 scope 的 detection;兩條曲線都使用 5% clean-removal budget。原始 Figure 6 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文直接使用 v1 原圖並保留 attribution,重用受原授權與版權限制。

Figure 6 的因果讀法是 reference contamination:RSG 從一份文件的 61.8% detection,在三份時升到 84.2%,五到十份維持約 86.1–86.2%;更多 coordinated documents 讓 corpus-local graph 更有 support。RSQ 則從一到五份上升,但十份時由 84.2% 降到 63.9%,因為固定 top-20 window 可能讓 poison 進入 ranks 6–20,反過來污染 query-local reference。這不是「RSG 永遠比 RSQ 強」,而是兩者對 injection volume 的 failure mode 不同。
參數 sweep 也把成本放到檯面上:RSQ information gate 從五 bits 降到四 bits,最大 clean removal 由 4.0% 升至 7.0%;升到六 bits,clean removal 維持 4.0%,poison removal 卻降至 70.5%。query-tail level 從 升到 0.10,最大 clean removal 變 11.0%;降到 0.025,poison removal 降至 65.4%。RSG 將 graph neighborhood 從 16 改為 8 或 32,detection 變化小於一個 point;alert budget 從 2.5% 加到 10%,poison removal 由 76.3% 升到 88.3%,但 clean removal 在 10% budget 達 7.6%。threshold 不是裝飾性的 hyperparameter,而是 security–utility policy。
結果 3:聯合部署與成本
Two scopes 的 union
RSG + RSQ 的 serial path 是:先用 RSG quarantine corpus documents,再讓剩餘 ranking 進入 RSQ,最後沿 saved ranking refill 五份 context。這兩個 filter 不在同一時間做同一件事;RSG 先處理可能跨 request 的 persistent corpus state,RSQ 再處理當下 query 的 residual evidence。
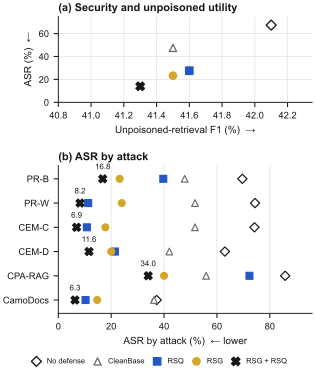
圖 7(原論文 Figure 7,Section 8):panel (a) 比較 ASR 與 unpoisoned-retrieval F1,panel (b) 分解六種 attack 的 ASR;所有值 macro-average 九個 target systems。原始 Figure 7 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文使用 v1 原圖並保留 attribution,重用受原授權與版權限制。

在 document-level,union 偵測 84.8% injected documents、移除 4.7% clean corpus documents;只看原始 top-five generation candidates 則是 89.8%/6.5%。QA 層的 No defense/RSQ/RSG/RSG+RSQ ASR 分別為 67.4%/27.6%/23.3%/14.0%;poisoned-retrieval F1 為 26.5%/36.9%/39.6%/40.5%;unpoisoned F1 為 42.1%/41.6%/41.5%/41.3%。CPA-RAG 仍是最難的 attack slice,聯合 deployment 的 residual ASR 為 34.0%,低於 RSQ 的 72.3% 與 RSG 的 40.0%,卻不是零。
這些數字支持兩個控制點具有 complementary coverage,不能支持「串接後所有 claim 都會被驗證」。聯合 deployment 仍可能把真實而罕見的文件誤 quarantine,也可能漏掉不形成 local graph、又不改變 query-local evidence 的單一 fluent poison。持久的 RSG false positive 甚至比 request-level RSQ false positive 更需要人工 review、rollback 與版本化 index。
成本是 control-point trade-off
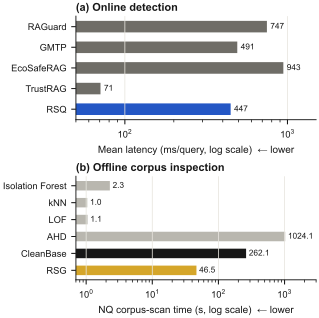
圖 8(原論文 Figure 8,Section 9):上圖比較 BGE-M3 三個 systems 的 post-retrieval mean latency,下圖比較一次 128,544-document NQ PR-W BGE-M3 snapshot 的 corpus scan;圖軸為 logarithmic,兩種 workload 不應直接當成同一 latency metric。原始 Figure 8 anchor · 原始 SVG endpoint。原論文頁面標示 CC BY-NC-SA 4.0;本文使用 v1 原圖並保留 attribution,重用受原授權與版權限制。

RSQ 在模型已 resident、排除 retrieval 與 loading 的條件下,mean latency 447.3 ms/query,P95 542.4 ms,memory 3.87 GiB;它比 GMTP 的 491.3 ms 平均稍低,比 TrustRAG 的 70.8 ms 高,且低於 RAGuard 的 747.5 ms 與 EcoSafeRAG 的 943.3 ms。RSG 在 128,544 份 NQ PR-W BGE-M3 snapshot(128,044 clean、500 injected)的一次 uncached scan 用時 46.540 s、0.3621 ms/document、2,762 documents/s、1.01 GiB peak memory。Generic outlier methods 1.04–2.28 s,CleanBase 262.107 s,AHD 1,024.072 s;RSG 比 generic outlier 慢 20–45×,卻比 CleanBase 快 5.6×、比 AHD 快 22×。
成本解讀要依 workload:RSG 可以在 ingestion batch 或 periodic audit amortize,不增加每個 query 的 path latency;RSQ 只對 active requests 收費,但每次都付 subsecond latency。這些數字排除了 model/index construction、document encoding、retrieval、QA、warm-up 與 provider queue,不能直接變成 production SLA 或 TCO。
局限、威脅與不能推論
Promotion detection 不是 truth verification
這是本文最重要的 semantic boundary。RAGSieve 的 看到 answer-anchor 集中, 看到局部 NLL transition, 看到 semantic–lexical graph density;這些都是「與 promotion 相關的 evidence pattern」。一個合法、正確、重複率很高的 result set,若 retrieval tail 沒有同一 answer vocabulary,也可能被打高分。反過來,一份語意上錯誤但 fluent、孤立、沒有 script mismatch 的文件,可能沒有足夠 signal。偵測分數不等於 claim posterior,也不等於 factuality verdict。
Local reference 的假設可能被移除或反利用
RSQ 依賴 predominantly clean retrieval tail;當大量 poison 進入 ranks 6–20,reference 被污染,十份 injection 的曲線已展示 separation 下降。RSG 依賴 sparse、coordinated injection 留下 graph structure;single fluent poison、低 inter-poison similarity 或 wholesale index compromise 都可能不符合它的 signal model。作者指出他們的 attacks 沒有 jointly optimize against RSG 的 semantic closeness 與 lexical-diversity constraints,所以 detector-aware graph dispersion 仍是 open problem。
Local LM surprisal 只是 evidence,不是必要條件:CPA-RAG 的 fluent carriers 產生最高 residual online ASR。Query alignment 也不能單獨觸發可靠決定,因為 15 份 tail documents 只提供 coarse probability resolution;加大 retrieval window 可能提升 resolution,卻也會改變 contamination risk 與 runtime。
評測與外部效度
Paper 使用 synthetic payloads、三個 benchmark 的 sampled corpus、100 個 target queries、固定 deepseek-v4-flash judge 與 chosen thresholds;沒有在本文中提供 confidence intervals、seed variance、自然 poison prevalence 或 production multi-tenant authorization interaction。MS MARCO + MiniLM 的 RSG budgeted detection 43.4% 也提醒 retriever、文本長度與 corpus topology 會改變 signal。Clean-document removal 的 5% 是共同比較點,但 offline quarantine 的影響可能跨越很多未來 requests,不應和一次 query-level removal 視為等價風險。
警報後還需要誰來判斷
Paper 的 protection target 是 evidence selected for generation 與由它產生的 answer;它不是 access-control system、provenance store、human moderation queue、citation validator 或 data deletion protocol。真正落地時,應保留 alert score、原始排名、index/document version、tenant scope、source identity、處置理由與 rollback path。若沒有這些 metadata,RSG 的持久 quarantine 可能把一個「相對可疑」的 statistical signal 直接變成不可追蹤的刪除。
工程判斷:何時用、何時不要用
以下是 Bloss0m 工程化整理,不是論文宣稱的第三個 method。它把 paper 的兩個 control points 放入一個較完整的 governance loop:
- Ingestion/audit gate(RSG):對每個新 batch 產生 corpus-local graph score 與 script-integrity signal;先送 review queue,再依 provenance、ACL、source trust、document version 與 risk tier 決定 quarantine。不要把
flagged=true自動等同刪除。 - Request gate(RSQ):對 active query 保留 top-20 ranking、score components 與原始 rank;flag top-5 後只從同一 saved ranking refill,並記錄 clean utility、answer citation 與 fallback rate。
- Claim verification:對高風險回答另外做 source authorization、cross-source agreement、time validity 或 human review。這一層才回答「claim 是否可信」,不由 RAGSieve 的 local contrast 取代。
- Calibration loop:以自己的 benign traffic 與 replay attack 建立 dataset–retriever–tenant slices,量測 false positive cost、tail contamination、RSG persistence、latency P95 與 drift;threshold 應是 policy choice,而不是直接複製 paper default。
- Incident response:保留 alert evidence、document hash、embedding/index version、query context、decision timestamp 與 rollback。若發現 promotion 但無法判真假,隔離 evidence path,並把 truth verification 與 content remediation 分開追蹤。
適合採用的情境
- corpus 會由外部 contributor、crawler、shared storage 或 connector 持續更新,而 operator 能拿到 document text 與 retriever embeddings;
- query path 能取得 top-20 或更深 ranking,並可從原始排序 refill;
- 團隊願意把 detection 當 triage signal,另設 provenance、ACL、review 與 factuality controls;
- 能接受 offline false positive 可能跨 request 持續,也能為不同 retriever/corpus slice 做 calibration。
不適合直接採用的情境
- 只能取得 top-5、拿不到 retrieval tail,或 replacements 會被重新打分而改變 paper 的 protocol;
- corpus 已經大規模或同步被污染,local reference 不再代表 background;
- 系統需要的是法律、醫療、財務等領域的 truth/provenance guarantee,卻沒有獨立查核來源;
- ingestion 沒有可回溯版本與 rollback,無法承擔一份 clean document 被 persistent quarantine 的代價;
- 需要可證明的 worst-case adaptive robustness、跨 provider 的 SLA 或自然 poison prevalence,而 paper 沒有提供這些證據。
Artifact 與可重現性
截至 2026-09-17 的獨立檢查
| Artifact | 直接 endpoint 與狀態 | 能做什麼 | 尚未能宣稱什麼 |
|---|---|---|---|
| arXiv v1 paper | abs v1、HTML v1、PDF v1、TeX source 可存取;頁面標示 CC BY-NC-SA 4.0。 | 閱讀完整正文/附錄、取得 v1 figures、核對 tables 與 equations。 | 不是 peer-reviewed publication;arXiv v2 已存在,不能把 latest version 當成本文 v1 evidence。 |
| MIT repository | GitHub repository 與 README 可存取;main HEAD 2be192e,MIT license,無 GitHub release、tag 或 bundled checkpoint。 | 檢查 src/ragsieve/ 的 RSQ/RSG/retrieval/filtering/metrics,執行 demo path,讀取 artifact guide 與 data schemas。 | 不是按一下就能重跑 paper 全部 tables 的 sealed environment;目前 README 的 mapping 跟著較新的 preprint naming,不能直接當成 v1 reproduction manifest。 |
| Released datasets | data/datasets/ 含 NQ、HotpotQA、MS MARCO 的 sampled queries、corpus、qrels、targets、counterfactuals 與 100-query subset;data/demo/ 有四個 NQ targets、20 份 poison fixture、contexts、labels 與 520-document RSG snapshot。 | 不下載 dataset preprocessor 也能讀文字 corpus;可依 README 建立 local embeddings,先跑 curated demo。 | dense vectors 不在 repository,需本地建立;underlying datasets 仍受原始 license 約束,不能把 MIT license 套到它們。 |
| Models/indices | README 與 pyproject.toml 要求 Python 3.11–3.12、uv、PyTorch/Transformers;BGE-M3、E5、MiniLM、Qwen3 與 BERT weights 於第一次使用時下載,CUDA 建議。data/indices/、models/ 與 .env 被 gitignore。 | 在有 GPU、模型下載與足夠 storage 時,可建 index、執行 RSQ/RSG detector;QA 需要 OpenAI-compatible endpoint。 | 本地沒有預先建好的 embeddings、model checkpoints、完整 optimization traces 或 paper-scale generated outputs;沒有 GPU/provider credentials 就不能把完整 QA reproduction 當成可用。 |
| Attack/anonymous artifact | MIT repo 提供 demo attack fixtures、evaluation commands 與 filtering;README 明說完整 attack-generation implementations 不隨 release 提供。Paper v1 的 anonymous Open Science URL 目前 HTTP 401,屬 gated/不可匿名重現的 direct endpoint。 | 可檢查 detector、demo attack data 與 metrics schema;可用自己的 attack files 做條件式 replay。 | 不能宣稱所有六種 attack generator、所有 optimization traces 或 v1 原始 experiment outputs 已完整公開。 |
因此我把 artifact 分類為 code 與資料可存取、demo 可檢查、paper-scale reproduction 條件式可行、完整 v1 sealed reproduction 未建立。最小的有用重現是:安裝環境、用一個 released dataset/demo 建 BGE-M3 index、執行 RSQ 與 RSG、比較 filtering 前後的 clean utility 與 detection,再在自己的 provenance/truth-review queue 中檢查 false positives。這個步驟是 Bloss0m 建議,不是 paper 已完成的 production recipe。
相關閱讀與下一步
若想先理解 RAG 如何把外部資料送入回答,可讀 Retrieval-Augmented Generation。若關心 query-local 的 evidence discovery,可接 DocMemo;若關心外部內容如何穿透 agent context,則讀 Indirect Prompt Injection。RAGSieve 的新增角度是 retrieval-supply-chain integrity:它把「找得到 evidence」之後的問題改成「這份 evidence 是否以可疑方式被 promotion」,但不替代 source authorization 或 truth validation。
讀完後的三個記憶點
- 技術想法:RAGSieve 用 inspected system 自己的局部背景做 contrast;RSQ 對 query tail,RSG 對 corpus graph,兩者的 reference 與 failure mode 不同。
- 最強證據:在 v1 的三資料集、三 retriever、六攻擊 protocol,RSQ/RSG 的 macro budgeted detection 是 82.2%/79.8%;串接後 ASR 14.0%,但 clean utility 與 attack slice 必須一起讀。
- 採用邊界:score 是 promotion detection signal,不是 truth verification;需要 tail/neighborhood、版本化處置、獨立 provenance/claim checks,並且要用自己的 workload 重新 calibration。