讀法可搭配 三遍掃描法。REALM 是 DPR 之前的早期檢索增強方法:它讓世界知識在預訓練期間保留於可檢索語料,代價則是聯合訓練與索引刷新。
DPR 後來改用成本較低的雙編碼器訓練,Lewis RAG 再把取回文件接入生成。三者關係見 RAG 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:預訓練 LM 把世界知識壓進參數;要覆蓋更多事實就得把網路做得更大,而且知識難定位、難更新。
- 核心洞見:預訓練時加入可學習的知識檢索器,從 Wikipedia 等語料取回文件 ,用遮罩語言模型訊號反傳通過檢索(把 當潛變數),並用異步 MIPS 刷新處理「索引會過期」的計算難題。
- 最強證據:ICML Table 1 開放域 QA Exact Match——REALM(=CC-News,=Wikipedia)NQ 40.4、WQ 40.7、CT 42.9;同參數量級的 ORQA 為 33.3/36.4/30.1;T5-11B(約 11318M)NQ 只有 34.5。Table 2:30× stale MIPS 把 NQ dev Exact Match 打到 28.7。
- 主要邊界:記憶是 2018-12-20 English Wikipedia(約 1,300 萬個 ≤288 wordpiece 塊);評測是英語 Open-QA/抽取式 span;訓練要 64 TPU 預訓練與週期重建索引;不是 production RAG,不是生成式 RAG,也不是 when-to-retrieve。
我的結論是:REALM 最值得保留的貢獻,是在預訓練階段把檢索接入 LM,並以異步索引刷新處理反向傳播的計算問題。它不是現成的 RAG 堆疊;DPR、Lewis RAG 與 Self-RAG 的結果也不能拿來補強本篇數字。
版本與閱讀範圍 / Version and reading scope
本文以 Guu et al., ICML 2020 相機就緒 PDF(PMLR 119:3929-3938)為數字來源,並對照 arXiv:2002.08909 v1。該版本於 2020-02-10 首發,截至 2026-08-27 仍是 arXiv 唯一版本,授權為 arXiv.org perpetual non-exclusive license。
作者順序依 PDF:Kelvin Guu、Kenton Lee、Zora Tung、Panupong Pasupat、Ming-Wei Chang;Guu 與 Lee 為共同一作,團隊來自 Google Research。相機就緒 Table 1 多了一列「ORQA (more fine-tune epochs)」,Table 2 則把 REALM(=CC-News)列在消融表頂;本文均以 ICML PDF 為準。
除摘要外,本文核對 Section 3–4、Table 1–3、Figure 1–3、補充材料,以及截至 2026-08-27 的工件。對照只連站上已有的 DPR、Lewis RAG、Self-RAG 與 BM25 at scale 筆記。
ORQA(Lee et al., arXiv:1911.03868)只作為相關先前/平行工作,本站沒有另寫精讀。DPR Table 2 的 top-20 78.4、Lewis RAG-Seq NQ 44.5 與 Self-RAG PopQA 54.9 都不屬於本篇結果。
這是已發表的 ICML 論文;arXiv 快照為 v1。
讀者真正要回答的問題
當世界知識被鎖在 LM 參數裡時,工程上是該繼續把模型做大,還是在預訓練就把大型文字知識庫接成可微檢索?Guu et al. 的回答是:用 MLM 當訊號預訓練檢索器,把取回的 當潛變數邊緣化,並用異步 MIPS 刷新讓「數百萬文件」的反傳變可行;再在 Open-QA 上微調。
比較精確的讀法不是「REALM 是不是現在的企業 RAG」。真正的問題是:把檢索放進預訓練目標之後,在哪些 Open-QA 設定上真的移動 Exact Match,又在哪裡因為 Wikipedia 記憶、異步索引成本、或抽取式答案契約而出界?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1/2 描述檢索增強預訓練與微調框架;Figure 3 描述異步 MIPS 刷新;Eq. 1 把 當潛變數;Table 1 給 NQ/WQ/CT Exact Match;Table 2 給 NQ dev 消融(含 stale MIPS、遮罩方案、retriever/encoder 拆開);Table 3 給 Fermat 質性例;預訓練 200k steps/64 TPU、知識庫約 1,300 萬候選。 |
| 作者主張 | 首次用無監督 MLM 訊號預訓練知識檢索器並反傳通過百萬級文件;相對隱式參數記憶與先前 Open-QA,可在較小參數量下提升 Exact Match,並帶來可解釋/模組化好處。 |
| 論文未證明 | 私有語料與 ACL;production hybrid/reranker;生成式答案或 citation 產品;agent 的 when-to-retrieve;不必異步刷新也能聯合預訓練同等效果;把後來 DPR/RAG/Self-RAG 數字寫回。 |
| Bloss0m 工程判斷 | 本篇的重點是預訓練期的聯合檢索與索引刷新,成本很高。DPR 改用 QA 對與 in-batch negatives 訓練 dense retriever;Lewis RAG 改生成方式;Self-RAG 則處理何時檢索。各自的數字不能直接混用。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2020 年前的兩條線寫清楚。
隱式參數記憶:BERT/RoBERTa/T5 類模型把世界知識壓進權重。優點是閉卷也能答一部分事實題;缺點是知識難審計、難局部更新,且「要裝更多事實」幾乎等於「把模型做更大」——作者對照後來的 T5-11B 路線。
檢索在,但預訓練沒把檢索當潛變數訓到底:開放域 QA 早已有稀疏檢索+reader;ORQA(Lee et al., 2019)已用 dense 檢索與潛變數邊際似然,並用 Inverse Cloze Task(ICT)初始化,但 REALM 強調自己多了語言模型預訓練步驟,並把梯度打進會過期的 MIPS 索引,而不是預訓練期固定索引。稀疏第一段則仍卡在詞重疊。
因此舊方法不夠的地方不是「沒人想過檢索」,而是控制點停在參數記憶或固定索引:要嘛知識不可外掛;要嘛 dense 檢索尚未用無監督 MLM 訊號、在數百萬文件上端到端預訓練。REALM 改的正是預訓練目標本身。
核心直覺 / Core intuition
先不要看表。想像兩種背百科的方式。BERT 像把整本 Wikipedia 壓縮進大腦皺褶——容量貴、改一頁很難。REALM 像考試時允許翻書,而且從模擬考(MLM 預訓練)開始就練習怎麼翻:哪一頁能幫你填對遮罩詞,檢索器就加分;翻錯就減分。因為書有上千萬頁,不能每學一步就重編全書目錄,於是另派一個「索引工」用稍舊的參數在背景重編,主訓練器繼續用當前參數算梯度——這就是異步 MIPS 刷新。
對照三種容易混在一起的下一步:
- REALM(本篇):下一步是預訓練期 retrieve → predict,反傳通過 ,索引要刷新;微調後答案仍是抽取式 span。
- DPR(note 32):下一步用問句–段落對直接學雙編碼器;作者主張不必 ICT/額外預訓練或複雜 joint index update。不要把 DPR 的 NQ top-20 78.4 寫進本篇。
- Lewis RAG(note 31):下一步把 dense retriever 接到 seq2seq 生成,改的是生成控制點。不要把 RAG-Seq NQ 44.5 寫進來。
用一個例子走完整個方法 / Walk one example through the method
以下用論文 Figure 1/Table 3 的教學例走完機制,不是獨立實驗結果。
- Input:預訓練語料裡的一句遮罩句,例如把需要世界知識的 salient span 遮掉(論文用命名實體/日期;Figure 1 示意 “The [MASK] at the top of the pyramid”)。沒有私有 PDF,沒有 agent 工具。
- Intermediate representation:input encoder 把 編成向量;對約 1,300 萬 Wikipedia 塊做 MIPS,取回 top-(預訓練邊際化約 8 個候選,含空的 null document )。假設取回一段談到 pyramidion/Fermat prime 的說明文字 。
- Model or system decision:把 與 接成一條序列,送進 knowledge-augmented encoder;對每個 [MASK] 預測 token。訓練最大化 ,其中 被邊緣化(Eq. 1)。梯度對「比期望更能提高 的文件」提高相關分數。
- Output:預訓練時輸出是填回的 token;微調 Open-QA 時輸出是文件中的答案 span(Exact Match)。Table 3:對 “Fermat”,無檢索的 BERT 機率極低;條件於相關 可到 1.0,邊緣化後約 0.129。
- Likely failure point:若 MIPS 索引相對當前
Embeddoc過期太久(Table 2 的 30× stale),檢索品質崩、連帶 Exact Match 掉到 28.7。若遮罩不需要世界知識、或 null document 沒被正確使用,檢索訊號會變噪。微調若知識庫仍是 2018 Wikipedia,2026 事實不會 magically 出現。
這條例子教的是機制怎麼走完。要看三資料集 Exact Match,應回到 Table 1;要看刷新與遮罩是否多餘,應看 Table 2。
技術機制 / Technical mechanism
REALM 在預訓練與微調都建模 ,並把檢索文件 當潛變數:
實務上對 最高的 top- 求和。檢索器是 dense 內積模型:
兩個 embedding 都是 BERT-style Transformer 的 [CLS] 再經線性投影。Embeddoc 吃標題+正文。Knowledge-augmented encoder 是另一個 Transformer,對 做 cross-attention 後預測:預訓練用 MLM;微調用 span start/end 的抽取式讀取(假設答案是 內連續 span)。
計算控制點——異步 MIPS 刷新:要做 MIPS 必須預先算好所有 Embeddoc(z)。但 一更新,索引就過期。作者每約 500 step 在背景用參數快照 重嵌並重建索引;trainer 繼續用新鮮 對取回的 top- 重算 與梯度。Figure 3:index builder(stale )↔ MLM trainer(fresh )。微調實驗為簡化通常只建一次索引,仍微調 Embedinput。
歸納偏置:salient span masking(實體/日期)讓學習訊號更依賴世界知識;null document 承接「其實不必檢索」的例子;禁止檢索預訓练語料中「含答案的同一文件」,避免捷徑。Retriever 以 ICT 初始化(與 ORQA 相同起點),知識增強編碼器從 BERT-base uncased 起步。
操作約束:
- 記憶 :2018-12-20 English Wikipedia,貪心切成 ≤288 BERT wordpieces,約 1,300 萬 檢索候選。
- 預訓練 :Wikipedia(與 相同)或 CC-News(與 分離)。
- 計算:200k steps、64 Cloud TPU、batch 512、lr ;文件嵌入平行在 16 TPU;每例邊際化 8 個候選(含 )。微調後推論取 top-5,可在單機 12GB GPU 跑。
- 參數量:Table 1 列 REALM/ORQA 為 330M,對照 T5-11B 的 11318M。
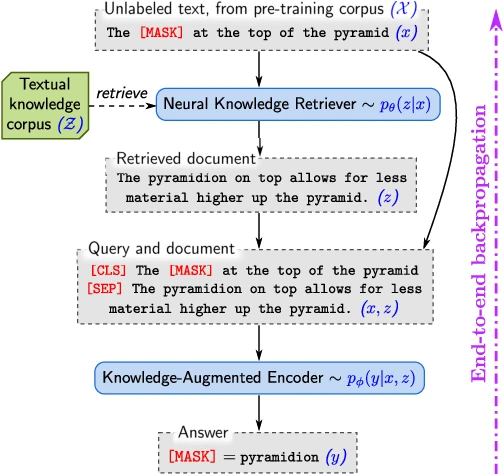
原文 Figure 1,論文 Introduction/Section 3:檢索增強的 MLM 與端到端反傳示意。原圖可定位到 arXiv HTML Figure 1(資產 intro_end_to_end.png)。取自論文源檔 figures;arXiv 頁面標示 perpetual non-exclusive license。本文依 arXiv reuse terms 做教學引用;ICML 正式版另受會議/PMLR 出版條款約束。

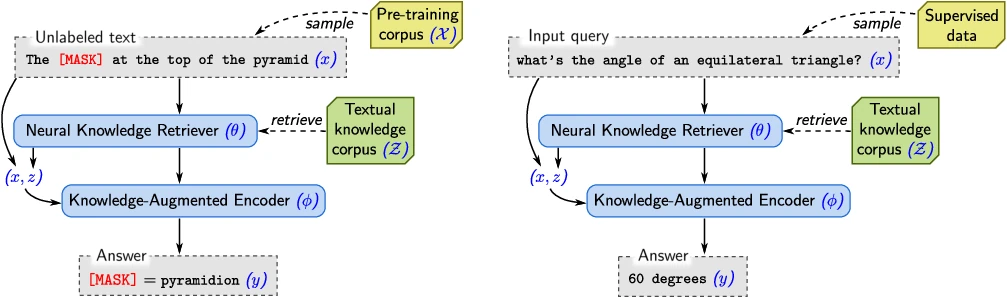
原文 Figure 2,論文 Section 3:預訓練與微調總覽。原圖可定位到 arXiv HTML Figure 2(資產 pretrain_finetune.png)。授權同 Figure 1。

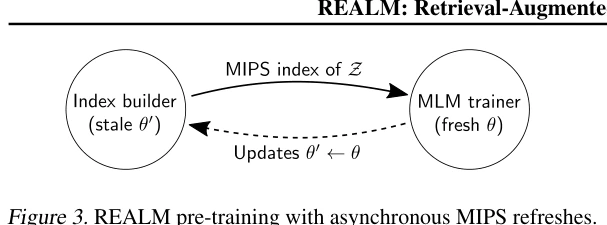
原文 Figure 3,論文 Section 3.3:異步 MIPS refreshes。裁切自 ICML 相機就緒 PDF 對應頁;與 arXiv v1 圖意一致。若裁切邊緣帶入相鄰段落標題,以正文詮釋為準。授權:教學引用 ICML/PMLR 相機就緒圖,並對照 arXiv perpetual non-exclusive 源圖。
實驗如何讀 / How to read the evidence
評測任務是 Open-QA:給問題 ,預測答案字串 ,以 Exact Match(對任一參考答案)計分。資料集是 Natural Questions Open(79k/4k)、WebQuestions(3k/2k)、CuratedTREC(1k/1k)。知識庫始終是同一份 2018 Wikipedia 切塊。微調設定對齊 ORQA,但相機就緒版增加訓練 epoch(NQ/WQ/CT 為 4/60/80),並另報「ORQA more fine-tune epochs」列以便對照。
Table 1:要贏的是 Open-QA Exact Match,不是後來的檢索 top-20 或生成 EM
這張表問:在相同(或標明的)Open-QA 協議下,REALM 相對稀疏檢索+reader、ORQA、以及把知識塞進參數的 T5,Exact Match 差多少?控制住的是 Wikipedia 知識庫與抽取式/生成式各自的答案契約;改的是預訓練是否把檢索接進 LM。
| Name | Pre-training | NQ | WQ | CT | # params |
|---|---|---|---|---|---|
| BERT-Baseline | BERT | 26.5 | 17.7 | 21.3 | 110m |
| T5 (11b) | T5 (Multitask) | 34.5 | 37.4 | — | 11318m |
| ORQA | ICT + BERT | 33.3 | 36.4 | 30.1 | 330m |
| ORQA (more FT epochs) | ICT + BERT | 34.8 | 35.4 | 28.7 | 330m |
| REALM (=Wiki,=Wiki) | REALM | 39.2 | 40.2 | 46.8 | 330m |
| REALM (=CC-News,=Wiki) | REALM | 40.4 | 40.7 | 42.9 | 330m |
觀察:摘要所稱 4–16% absolute 是相對先前 Open-QA 系統的差距量級;與最直接對照 ORQA(同微調配方家族)相比,CC-News 設定在 NQ 上從 33.3 到 40.4。T5-11B 參數大約大 30 倍仍低於 REALM 的 NQ 40.4;作者並提醒 T5 預訓練還看過 SQuAD 閱讀理解資料,REALM 實驗未用。推論時只取回 5 篇,少於許多取 20–80 篇的檢索系統。
這張表支持「檢索增強預訓練能提升這三個英語 Open-QA 基準上的 Exact Match」;它不支持把分數讀成 production RAG,也不要寫入 DPR 的檢索 top-20 或 Lewis RAG 的生成 EM。
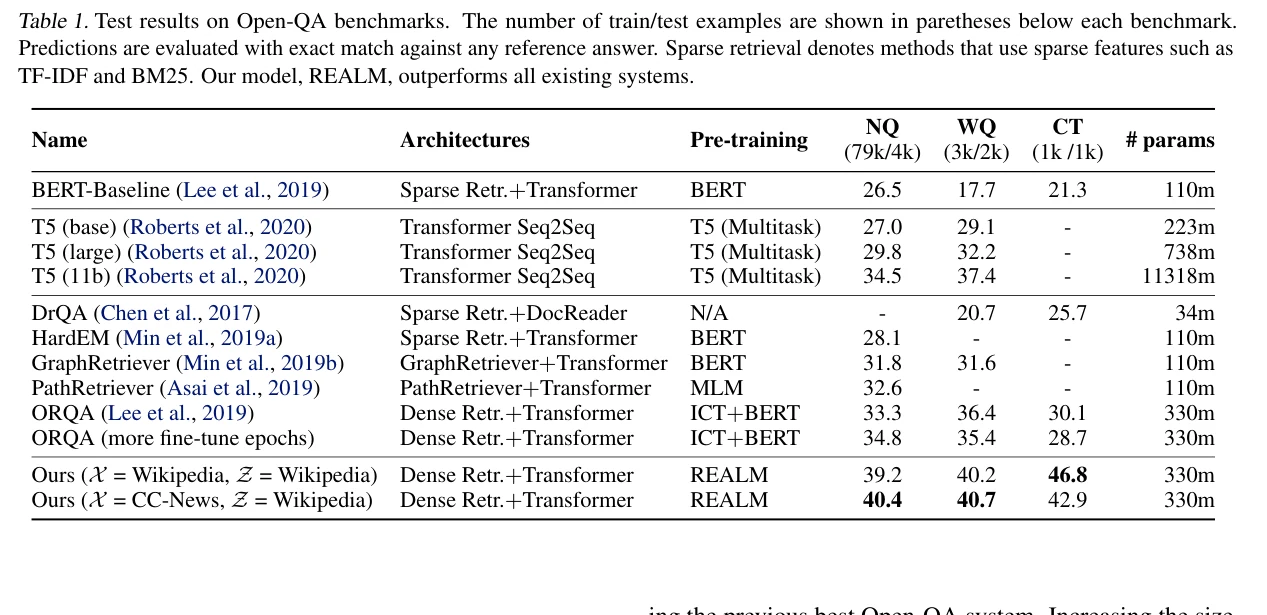
原文 Table 1,論文 Section 4.4 Main results:Open-QA Exact Match。裁切自 ICML 相機就緒 PDF。數字以該 PDF 為準(含 ORQA more fine-tune epochs 列)。授權同 Figure 1/PMLR 相機就緒教學引用。
Table 2:驅動結果的是檢索器預訓練、salient span、以及夠新的 MIPS
消融在 NQ development 上問:換掉 retriever/encoder、改遮罩、或把索引刷新變慢,Exact Match 與 zero-shot Recall@5 怎麼變?
| Ablation | Exact Match | Zero-shot Recall@5 |
|---|---|---|
| REALM (=CC-News) | 38.5 | 52.0 |
| REALM | 38.2 | 38.5 |
| REALM retriever + Baseline encoder | 37.4 | 38.5 |
| Baseline retriever + REALM encoder | 35.3 | 13.9 |
| Baseline (ORQA) | 31.3 | 13.9 |
| random uniform masks | 32.3 | 24.2 |
| random span masks | 35.3 | 26.1 |
| 30× stale MIPS | 28.7 | 15.1 |
觀察:單獨換 REALM retriever 或 encoder 都有幫助,但兩者一起最好。Salient span 明顯優於隨機 token/隨機 span 遮罩——作者解釋潛變數學習更仰賴「檢索真的有用」的穩定訊號。30× stale MIPS 幾乎打回(甚至低於)ORQA 基線,說明異步刷新不是實作細節,而是方法能否成立的條件。CC-News 預訓練在 zero-shot Recall@5 上特別高(52.0)。
這支持「聯合預訓練改善了檢索器,且索引必須夠新」;它不支持「可以忽略刷新成本仍宣稱同一套 REALM」。
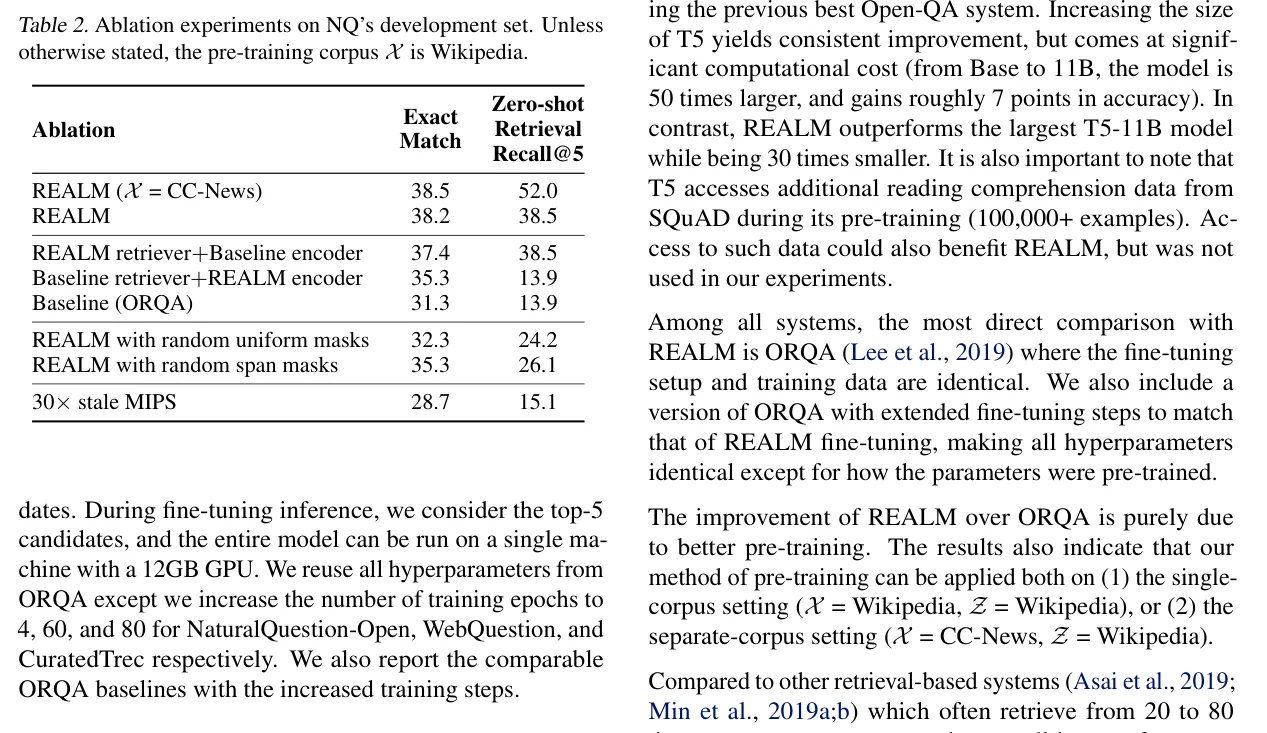
原文 Table 2,論文 Section 4.5 Analysis。裁切自 ICML 相機就緒 PDF。授權同 Table 1。
Table 3:質性例說明「檢索到的文件如何改變 MLM」
Table 3 不是基準分數,而是機制示範:相關文件可以把 “Fermat” 的條件機率拉到 1.0,邊緣化後仍遠高於無檢索 BERT。把它當教學例,不要當獨立 SOTA 證據。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- Wikipedia 塊當記憶。 2018-12-20 dump、約 1,300 萬候選。私有語料、權限、多語、新鮮事實都不在表內。
- 聯合預訓練/異步刷新昂貴。 64 TPU、200k steps、背景重嵌整庫;這正是 DPR 後來拒絕當預設帳單的控制點。
- 答案契約是抽取式 Open-QA。 Span 須出現在取回文件;不是 citation 產品,也不是 Lewis RAG 的生成邊緣化。
- 不是 when-to-retrieve。 預訓練/微調仍以檢索為核心路徑(另有 null document);不是 Self-RAG 的 reflection tokens。
- ORQA 是相關先前工作,不是本站精讀。 可讀 arXiv:1911.03868,不要期待 2026 格式筆記。
- T5 對照有協議差異。 生成式、參數規模、額外 RC 資料;作者已提醒,讀者不要只看「較小模型分數較高」一句話。
- 不要混入後續研究。 DPR top-20、RAG-Seq EM、Self-RAG PopQA、BM25-at-scale、FinRank 都不屬於這張表。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用本篇?當你要理解「檢索增強」最早如何進入預訓練目標,或要評估是否真的要為可微檢索支付索引刷新與大規模預訓練成本。實作上應分開記錄:取回的 、null document 是否被選、索引刷新間隔、以及 Open-QA Exact Match——不要只報一個端到端分數。
什麼時候不要把這篇論文當成施工圖?
- 只要開放域/知識庫 QA 的 dense 第一段、且想避開 ICT/聯合刷新帳單時,讀 DPR。
- 生成必須條件化於取回段落時,讀 Lewis RAG。
- 模型要自己決定何時檢索時,讀 Self-RAG。
- 語料規模讓詞重疊重新划算時,讀 BM25 at scale。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v1 PDF、ar5iv HTML 可讀;license 為 arXiv.org perpetual non-exclusive。ICML/PMLR 相機就緒 PDF 與 補充 PDF 回 HTTP 200。
- 程式(usable):google-research/language
language/realm目錄可開啟(含train_realm.py、refresh_doc_embeds.py、README)。這是可用的原始碼樹,不等於「一鍵復現 Table 1 的 40.4」。 - 模型卡(usable):Hugging Face 上
google/realm-cc-news-pretrained-embedder、google/realm-cc-news-pretrained-encoder、google/realm-cc-news-pretrained-openqa等回 200。公開權重可做推論實驗;完整復現仍依賴論文當日語料切分與 TPU 訓練設定。 - 訓練環境(論文宣告):預訓練 64 TPU、200k steps;文件嵌入 16 TPU;微調後可單機 12GB GPU 推論。主實驗不是「下載 notebook 就能復現 NQ 40.4」。
最小有用 reproduction 是:用公開的 REALM OpenQA 權重對一小撮 Natural Questions 題做檢索+span 預測,確認系統會取回 Wikipedia 塊且答案來自抽取式 span。不要宣稱這能復現 Table 1 的 40.4。
三個記憶點 / Three things to remember
- 技術想法:REALM 在預訓練就把檢索接進 LM:MLM 訊號反傳通過潛變數文件 ,並用異步 MIPS 刷新維持索引可用。
- 證據:ICML Table 1 上 REALM(CC-News)NQ Exact Match 40.4,勝過 ORQA 與更大的 T5-11B;Table 2 顯示 stale MIPS 與非 salient 遮罩會破壞結果。
- 邊界:這是成本高昂的檢索增強預訓練與抽取式 Open-QA 方法。它不是 production RAG,也不是 DPR 的雙編碼器配方、生成式 RAG 或 Self-RAG 的 when-to-retrieve。
延伸閱讀
REALM 處理的是「預訓練要不要聯合檢索與刷新索引」。若下一步是較便宜的 dense retriever,讀 DPR;若是生成如何條件化於 ,讀 Lewis RAG;若是何時檢索,讀 Self-RAG;若是規模化詞重疊,讀 BM25 at scale。ORQA 僅連 arXiv:1911.03868。讀法本身見 三遍掃描法。