90 秒掌握論文
- 問題:企業手冊、課程 syllabus、論文、合約與財報不是一袋互不相干的 chunks。答案常需要先定位哪一份文件,再沿著 chapter、section 或 subsection 找到分散的事實。若把所有 directory 都序列化進 prompt,結構線索會很貴;若只做一次 flat top-k,又可能在第一輪就漏掉跨 section 的依賴。
- 核心洞見:把 hierarchy 從 prompt 移到可查詢的外部 semantic storage。每個 directory node、chunk 與多層 abstract 都有 URI,且 URI prefix 保留 ancestor–descendant 關係;向量結果因此不只是文字片段,也是一個可以繼續 List、Grep、Read 的 navigation handle(論文 Section 2.2、3.1)。
- 最強證據:六個結構化文件資料集、八個 baseline、固定的 K=10、L=1,000、B=15 設定下,作者以 end-to-end accuracy、latency、LLM token、ingestion 與 deletion 評估。Figure 3/Table 3 報告 VikingRAG 的 token ratio 為 11.6%–51.9%,VikingRAG-E+ 為 5.1%–32.5%;Figure 7 也在 VersionQA 上換用 GPT-5.5、Seed-2.0 與 GLM-4.7 做 robustness check。
- 主要邊界:accuracy 是 LLM-as-a-judge 加 expert verification 的 semantic consistency proxy,不是 retrieval recall 或獨立人工重做的 correctness proof。Experience edges 用同一文件語料產生的 1,000 個 synthetic historical questions warm up;evidence checker 的 false-no-escalation 在 QASPER 仍為 14.4%,FinanceBench 為 6.7%(Table 7)。
我的 bounded verdict 是:VikingRAG 把「文件階層、agent navigation、歷史 retrieval reuse、必要時升級」接成一個很值得採用的 serving architecture。它最適合 query 會重複、文件有原生階層、跨段取證的知識庫;但它不是把任意文件轉成可靠證據的保證,也不能把 token ratio 直接當成完整 TCO 或 end-user latency。
版本、來源與讀法
本文讀的是 VikingRAG v1,arXiv 顯示於 2026-09-10 提交,作者為 Peiyuan Gao、Gaoyuan Zhang、Haojie Qin、Yahui Sun、Qianyi Zhang、Yunhao Zhang、Zeyu Wang 與 Wei Lu。它是 arXiv preprint,沒有把它當成已經通過 peer review 的 conference 或 journal result。本文核對了 完整 arXiv HTML、PDF、全部七張 figure、Tables 1–7、Algorithms 1–3、Section 3–6,以及作者的 VikingRAG repository。
這篇文章的讀者問題是:如何讓結構化文件的 RAG Agent 保留多回合找證據的能力,卻不把每份 directory、每次 tool call 和上一輪歷史都無限堆進 prompt? 這個問題接在 RAG-MCP 的工具介面與路由、DocMemo 的動態 evidence discovery 與 BM25 at scale 的成本曲線 後面讀很合適:VikingRAG 不是只換 retriever,而是重新安排 storage、tool loop、trace reuse 與 escalation 的控制點。
證據地圖:哪些是 Paper,哪些是判斷
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | Prompt-decoupled hierarchy-preserving semantic storage;URI namespace 與 subtree scope;Search、List、Grep、Read;evidence-gap-driven multi-round retrieval;query-conditioned experience edges;adaptive retrieval escalation;六資料集的 accuracy、latency、token、ingestion、deletion 與參數結果。 |
| 作者主張 | VikingRAG 保留 structure-aware RAG 的高 accuracy,同時用 selective directory exposure 降低 structural-context token;VikingRAG-E 與 E+ 將成功路徑重用並把不必要的 agentic rounds 移除。 |
| 證據沒有建立 | 沒有建立所有 enterprise workload 的總成本優勢、文件更新或 ACL 變動後 experience edge 的安全性、evidence checker 的 correctness guarantee、實際 provider queue 下的 latency SLA,或 end-to-end citation faithfulness。 |
| Bloss0m 工程判斷 | 把 URI 當成一個同時連接 semantic index、structural navigator 與權限/版本邊界的 control-plane primitive;把 edge 與 escalation 視為需要監控的 cache/policy,而不是無條件相信的記憶。 |
Paper Essence Contract
- 它解決什麼問題? 解決 structured-document RAG 在 accuracy 與 context cost 之間的兩難:flat chunk 丟掉階層線索,完整 directory prompt 與多回合 history 又會膨脹。
- 為什麼既有做法不夠? MoDora、BookRAG、KohakuRAG 等方法雖然使用 hierarchy,仍不一定能把任意 semantic hit 轉成可定位的局部 navigation;DeepRead 可以多回合找證據,但把完整 directories 與歷史互動暴露給 LLM,結構成本會隨候選文件與回合數增加(Section 1.1、2.3)。
- 核心技術想法是什麼? 讓 semantic lookup 回傳 URI,讓 URI 又能 scope 後續 structural 與 lexical operation;再把曾經成功的多回合 path 物化成有 query context 的 directed edge,最後由 sufficiency check 決定是否需要完整 agentic path。
- 一個 input 怎麼走?
question → Search 找語意入口 → Read/List/Grep 在 URI subtree 內找缺口 → 必要時追加 tool round → sufficient evidence → answer;warm 的 E+ 則是question → vector + edge augmentation → constraint-aware sufficiency check → answer 或 escalation。 - 什麼證據支持 headline claim? Figure 3/Table 3 測端到端 accuracy、latency、token ratio;Figure 4 測 insert、delete、internal/external update;Figure 5 測 M、γ、K、L、B 的 trade-off;Table 7 直接量 false-no-escalation。
- claim 在哪裡停止? 結果停在作者選的六個資料集、LLM judge、合成 warm-up、24 小時 ingestion budget 與 provider API。工程後果是:要以自己的 workload、freshness、ACL、edge invalidation 與 checker calibration 做 canary,不能只複製論文的 default。
既有方法為什麼不夠
先不要把「structure-aware」當成單一方法。論文 Table 1 把差異拆成三個能力:是否考慮 directory、是否能做 evidence-gap-driven multi-round directory retrieval,以及是否只 expose 需要的 directory segments。
Flat chunk retrieval 丟掉了證據的所在位置
NaiveRAG 把文件切成 chunks、embed、取 top-k、生成答案。這條 pipeline 對局部 fact 很直接,但它不保證 chunk 的 native section、chapter 或 sibling context 仍然可取回。兩段內容都可能提到同一個 entity,真正的答案卻只在其中一段的 policy、時間範圍或例外條件裡。Graph RAG 能把 entity 或 passage 連起來,但論文的比較指出,這些 edge 多半是 ingestion 時抽出的 content-derived relation,不等於文件本身的 containment hierarchy,也不等於「這個 query 走過的證據路徑」。
既有 structure-aware retrieval 仍有兩種成本
MoDora 以 document tree 做 root-first、top-down traversal;BookRAG 把 entity graph 與 structure-aware tree 接起來;KohakuRAG 以 hierarchy boundary 做 chunking 並建立 multi-level embedding。它們都比 flat chunks 更能利用結構,但論文主張的缺口是:初始 retrieval 之後,系統不一定能明確診斷「還缺哪一個 entity、時間或 scope」,也不一定能隨缺口改寫下一輪 query。
DeepRead 更接近這個需求:它讓 Agent 在多回合中根據中間發現繼續找證據。然而論文指出,DeepRead 會把候選文件的完整 directory 當成 plain-text prompt metadata,且每輪把 reasoning、directory view 與 retrieved contents 加進 interaction history。這個 design 的 trade-off 很清楚:多回合可以補回分散證據,但每多一個候選文件或一輪 tool interaction,LLM 看到的結構與歷史也一起增長。
VikingRAG 的改變不是「不要多回合」,而是把多回合需要的 state 從完整 prompt 改成外部、可隨需暴露的 URI namespace。這個差異稍後會連到 experience edges:一次探索留下的不是整個 prompt,而是一個可條件啟用的 path hint。
核心直覺:把文件 hierarchy 做成可尋址的外部 state
假設一份名為 Home Cooking 的文件有 Pasta chapter,再有 Carbonara subsection。VikingRAG 不只保存一串 chunks;它會建立 directory node、每個節點的 abstract、真正的 evidence chunks,並給它們可以表達 containment 的 URI,例如:
viking://home_cooking/Pasta/Carbonara/
viking://home_cooking/Pasta/Carbonara/.abstract.md
viking://home_cooking/Pasta/Carbonara/Carbonara_1.md
這些 URI 的重點不是字串長得像檔案路徑,而是 prefix 具有 scope meaning。論文 Section 3.1 以 表示 是 的 component-wise path prefix;因此以 Pasta/Carbonara/ 為 scope 的 operation 只應看見該 subtree。每個 chunk 或 abstract 的 index record 同時保存 embedding、URI、type、hierarchy depth 與 preview。向量搜尋於是回傳「相似的 object + 可繼續瀏覽的 address」,而不是一段與原文件脫鉤的文字。
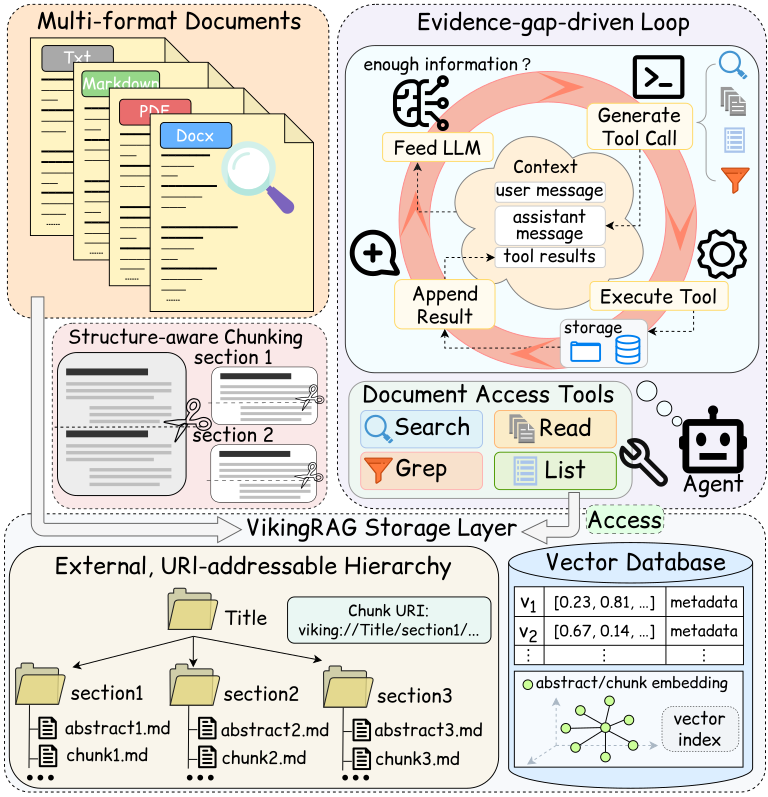
Figure 1,論文 Section 2.2 與 Section 3.1 的 VikingRAG overview:圖中同時展示 hierarchy、multi-granular abstracts、URI-addressable objects、semantic index 與 retrieval tools 的關係。原始 Figure 1 · 原始 SVG endpoint。原圖取自 arXiv HTML v1;該頁標示 arXiv.org perpetual non-exclusive license,本文保留來源與 attribution,並使用本地 SVG 鏡像;重用須遵守原授權與版權限制。

三層物件如何一起工作
文件 insertion 的第一步是 hierarchy extraction 與 structure-aware segmentation。Markdown 可以直接讀 heading;PDF、DOCX 等格式先轉成 Markdown,再沿 headings、paragraphs、sentences 在 chunk-size upper bound 內切分。每個 chunk 記住它最細的 owner node ,所以拿到 evidence 後仍能放回 section context。
第二步是 bottom-up abstraction。leaf abstract 摘要自己擁有的 chunks,internal abstract 再摘要 children 的 abstracts。這些 abstracts 是導航用的 compact representation;真正回答問題時,原始 chunks 才是主要 evidence。兩者都進 vector index,卻不必把整棵 tree 一次送進 prompt。
第三步是 shared URI materialization。論文把 stored representation 寫成:
其中 是 materialized hierarchy,包含 nodes、chunks、abstracts; 將物件映射到 URI; 是對 chunks 與 abstracts 的 vector index。這個式子的 operational meaning 是:刪除文件時可以移除 URI namespace 下的 materialized objects 與 vector records;查詢時則能從 semantic index 的 URI 直接 resolve 回 hierarchy,而不必從 root 重新走一遍。
Search、List、Grep、Read 不是四個同質工具
Search(q, u, K):在 optional URI scope 內做 vector search,回傳 top- chunks 或 abstracts、URI、score 與 metadata preview。它負責 coarse semantic localization。List(u):列出某個 directory URI 的 immediate children。它不是把全 corpus 的目錄灌給模型,而是讓 Agent 看見當下已定位 subtree 的鄰近結構。Grep(p, u):在 的 subtree 內做 lexical pattern matching。它適合找 exact keyword、版本號、policy term 或欄位名稱,補足 embedding 對稀有字串與否定條件的不穩定。Read(u):讀取 URI 指向的 chunk 或 abstract。它是從「可能相關」走到「可以引用的原文」的 evidence acquisition step。
這四個工具的分工形成一個小型 reader loop:Search 先找 handle,List 確認局部地圖,Grep 找精確線索,Read 讀完整證據。重要的是 scope 由 URI 帶著走,因此「semantic 結果」和「structural navigation」共用同一個 address space。
一個 syllabus 問題怎麼走完整個方法
以下依照論文 Section 3.2、Algorithm 1 與 Figure 2 的 cs466_syllabus case study 重述;它是論文提供的 retrieval trace,不是我額外捏造的實驗。
問題是:「根據 cs466_syllabus,這門課是否要求我購買 textbook?」正確答案是 No,但第一個 semantic hit 只會找到 syllabus header,包含課名、term、instructor、schedule 與 teaching assistants,沒有 textbook policy。
- Input:使用者問題 加上 retrieval prompt 。系統設定 ,並把可用的
Search、List、Grep、Read與 round budget 告訴 Agent。 - URI-level intermediate representation:第一輪
Search命中cs466_syllabus下的 chunk,雖然還不是答案,卻把 corpus-level uncertainty 轉成一個可定位的 URI handle。這是 VikingRAG 與「top-k 命中就直接生成」的關鍵差別。 - Evidence-gap decision:
Read讀到 header 後,Agent 發現缺口不是「找不到 syllabus」,而是「需要在這一份 syllabus 裡驗證 textbook policy」。因此它用List取 immediate neighboring chunks,而不是把所有文件 directory 重送給 LLM。 - Scoped exact lookup:Agent 在
cs466_syllabusscope 內以Grep搜尋textbook、book、required、purchase等詞。它找到提到 “optional accompanying textbook” 的候選 chunk;因為 search 被 scope 限住,exact match 不必掃整個 corpus。 - Verification and output:最後
Read讀完整 matched chunk,確認 textbook 是 optional,才生成 No。若只看高分 vector hit 或單行 keyword,容易把「提到 textbook」誤讀成「必須購買」。 - Likely failure point:若 chunking 把 policy 的否定句切開、Grep pattern 漏掉同義詞,或 Agent 在
Read前誤判 evidence sufficient,答案仍會錯;如果 耗盡,Algorithm 1 只會用累積的 finalize,不代表證據已完整。
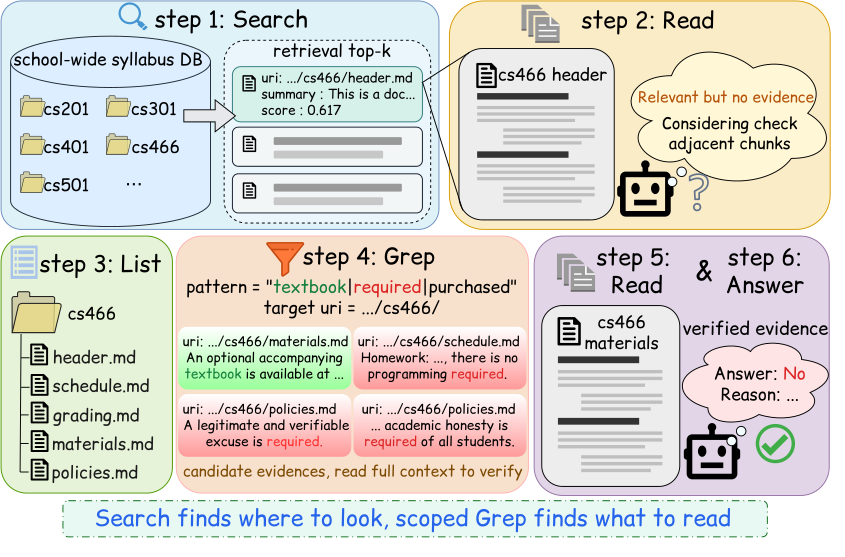
Figure 2,論文 Section 3.2 的 evidence-gap-driven retrieval example:cs466_syllabus 先以 Search 找到 URI anchor,再用 List、Grep 與 Read 找到並驗證 optional textbook policy。原始 Figure 2 · 原始 SVG endpoint。原圖取自 arXiv HTML v1;該頁標示 arXiv.org perpetual non-exclusive license,本文保留來源與 attribution,並使用本地 SVG 鏡像;重用須遵守原授權與版權限制。

多回合 retrieval 的 token 與停止條件
Algorithm 1 在第 回合看到的 context 可寫成:
這裡 是模型產生的 retrieval response, 是解析出的 function calls, 是 tool outputs, 表示把這些互動 append 到 message context。它回答了「Agent 如何根據上一輪的發現改變下一輪行動」,也暴露出成本來源:每輪的 input 會攜帶之前的 reasoning、call 與 result。Round budget 是硬上限;模型沒有再發 function call 時直接 finalize,達到 則以 accumulated context finalize,且論文明說這不等於 evidence 一定充分。
這裡有一個容易被 headline token ratio 蓋掉的 trade-off:VikingRAG 把 directory metadata 從 prompt 拿出去,卻沒有讓 agentic history 消失。每次 Search、List、Grep、Read 的輸出仍可能進入下一輪 context。VikingRAG 的答案是兩個 serving-time optimization,而不是宣稱 multi-round 沒有成本。
Experience edges:把成功 trace 變成 query-conditioned shortcut
它不是一般 knowledge graph edge
VikingRAG-E 的 edge 是 usage-derived,不是 ingestion 時由 corpus semantics 抽出的 entity relation。假設某次問題先由 Search 找到 source URI ,之後在 Grep/Read 找到真正支撐答案的 target URI ,系統會把這次歷史 trace 摘要成:
其中 是歷史問題, 是 compact tool-call trace summary。方向 表示「先到 時,對相似問題, 可能是下一個有用證據位置」。它不聲稱 與 在所有任務都語意相關。論文用 person–university relation 舉例:同一條 relation 對 graduate study 有用,不代表對 hometown 問題也有用。
建 edge 的判斷也依賴 judge
從 trace 中,Search 回傳的 URI 形成 source set;Grep 命中的 URI 與 Read 的 input URI 形成 candidate set;再由 evidence-selection judgment 保留真正支援 、 的 target。若某 URI 是沿既有 edge 走到的,會被排除,避免每次重用都再長出同樣的 edge。這裡有兩個工程含義:
- edge construction 並非單純的 deterministic log compaction;它使用 LLM-powered evidence selection,因此錯誤答案或 judge 漏選都可能把錯路徑物化。
- edge 是 directed 且有 reverse record,刪除 URI node 時能找到 incoming edges 並移除。可是這只說明 repository/paper 設計了 maintenance path,不等於已證明文件修改、ACL 變更、embedding revision 或跨租戶資料隔離的完整治理。
查詢時如何啟用
新問題 先做普通 top- vector search 得到 seed URIs。從每個 seed 往外展開 outgoing edges,但只有在:
時才接受 target。 是新問題 embedding, 是 edge 保存的歷史問題 embedding, 是 activation threshold。低 會啟用太多弱相關 edge,污染 evidence、增加 token 與 latency;高 則讓有用 shortcut 很難命中。論文在 Figure 5 的參數實驗採 作為 default,但這是作者 workload 下的 operating point,不是跨 corpus 的校準常數。
在 Supplement 的 case study 中,experience edges 把原本五回合的探索壓到兩回合;正文的 Table 4–6 則報告,在每個資料集以 historical questions warm up 後,edge 數量從 VersionQA 的 14,371 到 FinanceBench 的 38,540,每題建 edge 約 1.5–3.7 秒,測試問題與 historical question 的 semantic similarity ratio 為 26.48%–60%。這些數字支持「重複 query 可以受益」,卻不支持「所有新問題都能走 shortcut」。
Adaptive escalation:先便宜驗證,再決定是否叫 Agent
VikingRAG-E+ 把 E 的 edge-augmented search 放在一個 policy gate 前面:
one-round vector + experience-edge retrieval
        ↓
candidate answer + evidence-sufficiency check
        ├─ sufficient → generate answer
        └─ incomplete / ambiguous → VikingRAG multi-round retrieval
Checker 不是只問「這段 context 看起來相關嗎?」論文 Section 5 說它先要求 LLM 列出答案必須被支援的 constraints,例如 entity、time、scope,再挑出 direct evidence,最後判斷這些 evidence 是否足以回答。這個順序的直覺是把 semantic relatedness 和 answer sufficiency 分開:一段提到同一家公司但年份不同的財報,不應因為相似就通過 no-escalation。
它改變的 control point 是 是否要付出完整 agentic retrieval 成本,不是把 checker 當成 correctness oracle。Table 7 的 false-NoEscalation 定義很重要:one-round evidence 明明不足,系統卻錯誤決定不升級。作者的 checker 相較 naive prompt 的數值如下:VersionQA 5% vs 13%、SyllabusQA 8.3% vs 24.3%、QASPER 14.4% vs 29.7%、HotpotQA 3% vs 8%、LegalBench-cuad 7.5% vs 20.7%、FinanceBench 6.7% vs 22.7%。它確實降低錯誤,但 QASPER、LegalBench-cuad、FinanceBench 仍不是可以忽略的風險。
更微妙的是,false-no-escalation 不會一比一轉成 end-to-end accuracy loss。論文的解釋是:有些 one-round insufficient 的題目,即使升級做 multi-round,也仍然很難找到完整 evidence;因此「沒有升級」沒有改變原本就會錯的結果。這個解釋合理,卻不能被倒讀成 checker 安全:若升級後本來能答對,而 checker 恰好跳過,accuracy 就會真的下降。Production 應額外記錄 checker verdict、被列出的 constraints、實際 evidence、是否 escalation、最終 judge/human review,以及抽樣重跑的 disagreement。
原論文證據:accuracy、成本、storage 與參數 trade-off
端到端結果:token 少,不代表每個 baseline 都公平可比
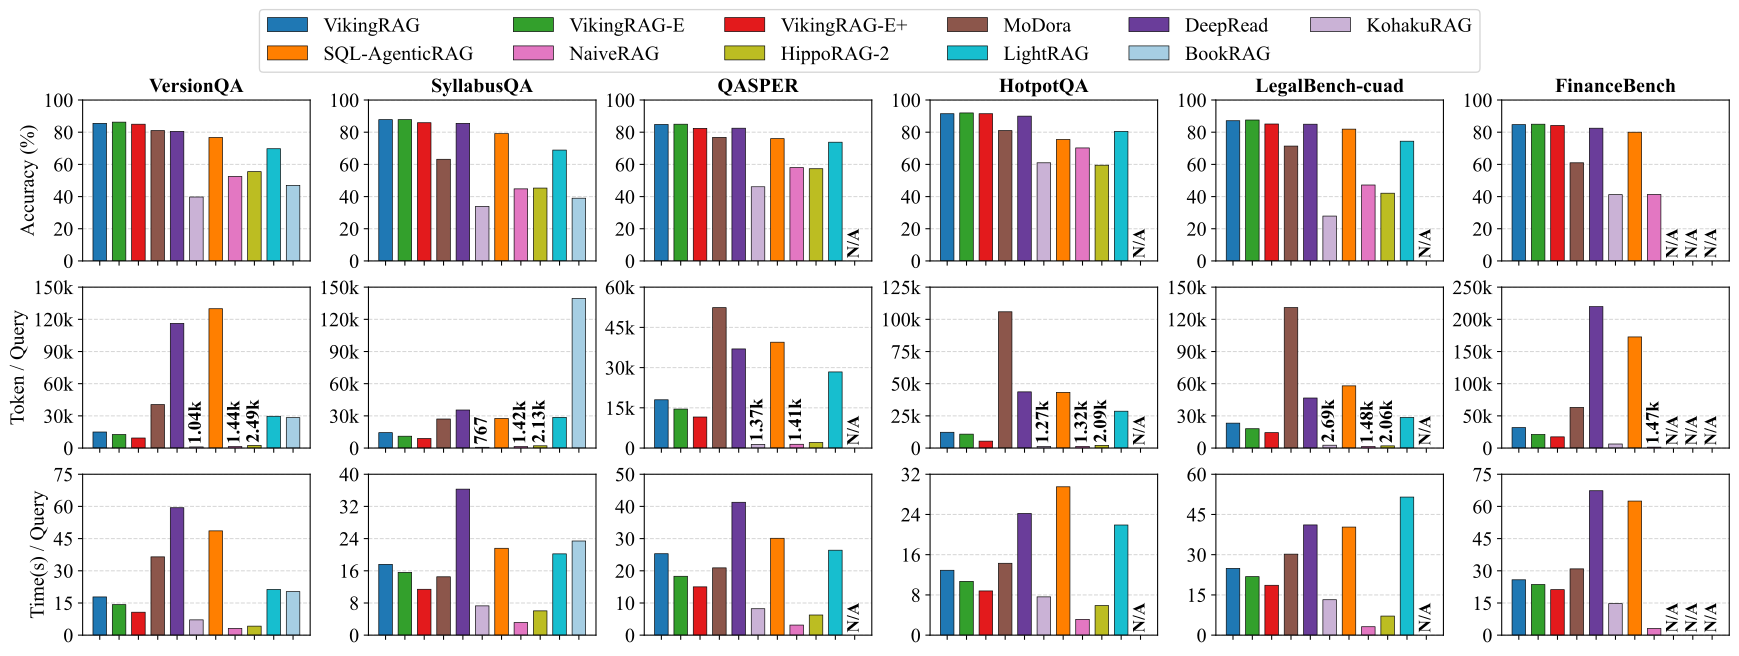
Figure 3,論文 Section 6.2 的 end-to-end RAG performance:比較 VikingRAG、VikingRAG-E、VikingRAG-E+ 與八個代表性 baseline 的 accuracy、latency、token consumption。原始 Figure 3 · 原始 SVG endpoint。原圖取自 arXiv HTML v1;該頁標示 arXiv.org perpetual non-exclusive license,本文保留來源與 attribution,並使用本地 SVG 鏡像;重用須遵守原授權與版權限制。

Figure 3 與 Table 3 的第一個可讀結論是:相對於 accuracy 最高與次高的 baseline,VikingRAG token ratio 是 11.6%–51.9%;VikingRAG-E 是 10.2%–40.2%;VikingRAG-E+ 再到 5.1%–32.5%。這些是相對比例,不是每題固定節省某個 token 數,也不是 API bill 的直接金額。比如 Table 3 的 HotpotQA,E+ 對 gold baseline 為 12.3%,對 silver 為 5.1%;FinanceBench 則是 7.9% 與 10%。分母不同,不能把區間當成一個普遍 uplift。
比較 protocol 也有條件:所有方法先 ingest 完整 collection,再 sequentially answer QA pairs;每個 dataset-method 有 24 小時 ingestion budget;VikingRAG(-E+) 預設 K=10、L=1,000、B=15。HippoRAG-2、LightRAG、BookRAG 在某些資料集因超過 24 小時而是 N/A,作者仍以能完成的高 accuracy baseline 作主要 comparison set。這支持「在這個 budget 下,VikingRAG 提供較好的 accuracy-token operating point」,但不等於所有 N/A 方法在無限 compute 下都比較差。
Accuracy 使用相同 answer-generation prompt 與 LLM-as-a-judge:judge 同時看到 question、gold answer、system final answer,判斷 semantic consistency,另有 expert verification 處理不一致或模糊案例。這讓方法間的相對比較更一致,但仍可能受 judge model、prompt、gold answer wording 與 retrieval-induced answer style 影響。它也把 end-to-end answer score 當成 evidence quality proxy,而不是直接量 Recall@k、citation precision 或每個 claim 的 support。
Storage trade-off:把 query 成本搬一部分到 ingestion
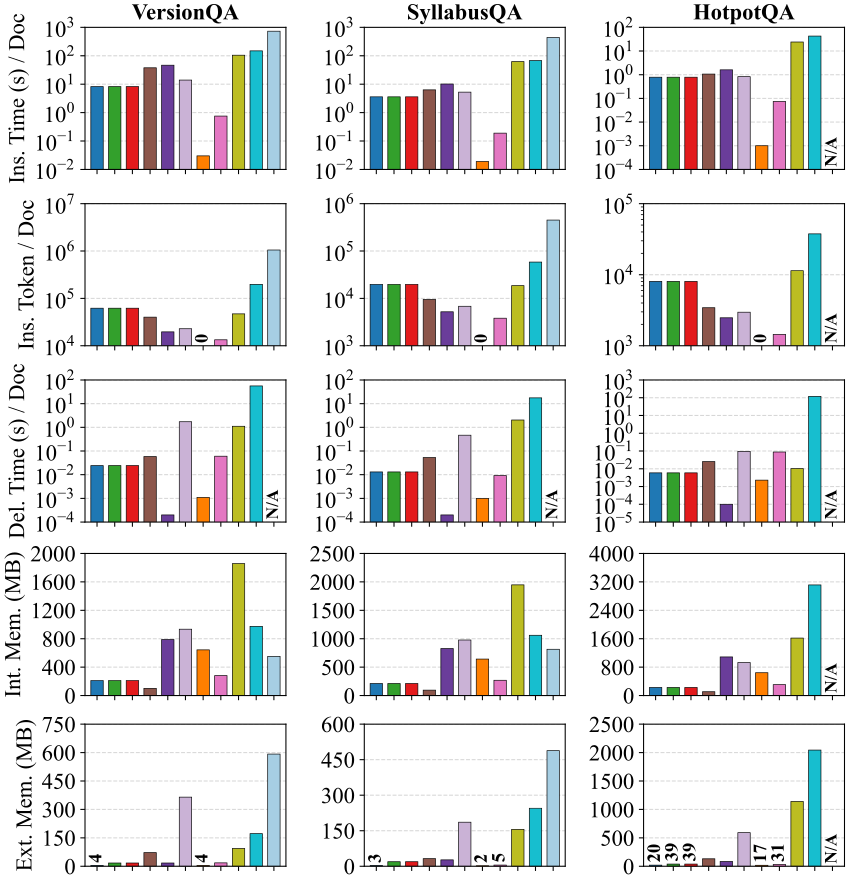
Figure 4,論文 Section 6.3 的 document storage performance:在三個代表性資料集比較 insertion、deletion 與 internal/external update;作者說明 LLM preview 與 graph extraction 造成不同 ingestion trade-off。原始 Figure 4 · 原始 SVG endpoint。原圖取自 arXiv HTML v1;該頁標示 arXiv.org perpetual non-exclusive license,本文保留來源與 attribution,並使用本地 SVG 鏡像;重用須遵守原授權與版權限制。

VikingRAG 的 hierarchy、abstract、embedding、preview 與 vector index 不是免費的。論文 Section 3.1 把 insertion space 寫成 : 是原文件 token、 是 abstracts 的總大小、 是 structural nodes、 是被 index 的 chunks 與 abstracts 數量、 是 embedding dimension、 是 index auxiliary storage。它把「每個新物件都要 embedding 和 preview」的建置代價明確放到 data-management side。
作者觀察 VikingRAG(-E+) 的 insertion latency 和 DeepRead、MoDora 相近,但比 knowledge-graph baseline 快;同時它的 insertion token 比 directory-based baseline 多,主要因為每個 vector-indexed object 都要產生 preview。作者認為這在「文件較少更新、query 重複很多次」的服務合理:一次 ingestion 的額外成本可被後續 query savings 攤平。這是一個 workload-dependent inference,不是 paper 量出的 break-even TCO。
Deletion 方面,VikingRAG 先移除 materialized objects,再刪除 URI 落在該 namespace 的 vector records;像多數 baseline 一樣不需要 LLM token。Paper Figure 4 也包含 edge 增加後的 storage 影響,作者認為 URI endpoint 加 compact summary 的額外空間仍可接受。可是實際部署仍須加入版本與權限索引:刪除一份文件不能只刪內容,還要移除指向它的 outgoing、incoming experience edges,以及任何 cache、preview 與 ACL-filtered index record。
參數結果:K、L、B、M、γ 都在改變 evidence path
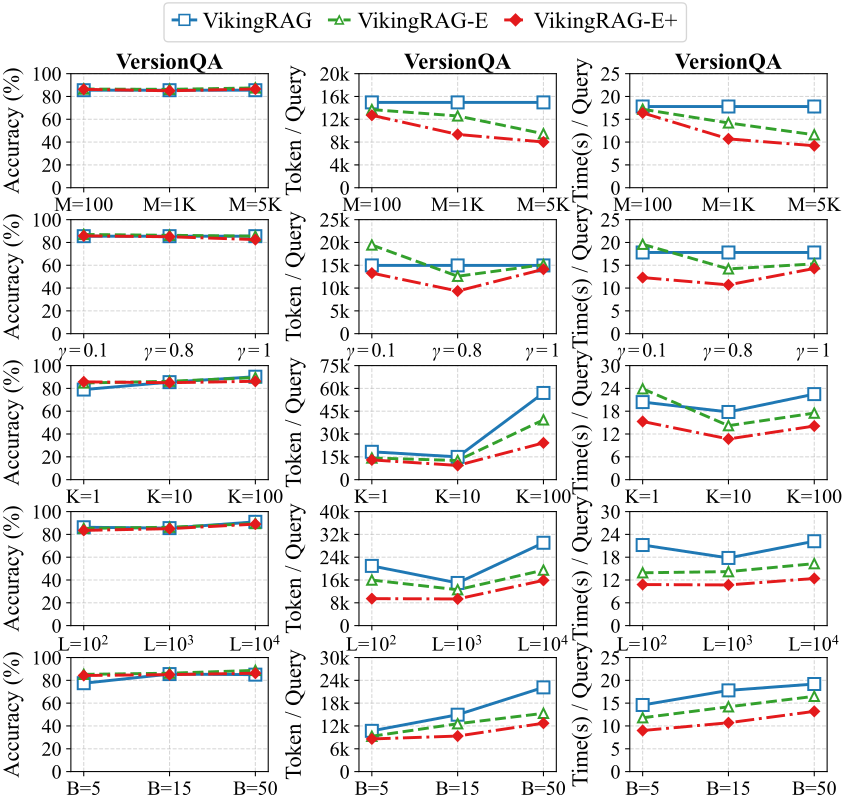
Figure 5,論文 Section 6.6 的 parameter impact:五列實驗分別展示 warm-up 數量 、edge activation threshold 、每次 Search 的 、chunk bound 與 round budget 對 accuracy、latency、token 的影響。原始 Figure 5 · 原始 SVG endpoint。原圖取自 arXiv HTML v1;該頁標示 arXiv.org perpetual non-exclusive license,本文保留來源與 attribution,並使用本地 SVG 鏡像;重用須遵守原授權與版權限制。

- :warm-up coverage。Historical questions 越多,測試問題與某個歷史問題相似的比例會上升,E+ 的 token 與 latency 傾向下降,accuracy 維持穩定。但這個 warm-up 生成成本在 paper 的 deployment discussion 沒有算入 query cost;實際流量的歷史 query 也未必像 synthetic questions 一樣乾淨。
- :shortcut precision–recall。低 threshold 讓弱相關 edge 帶來 irrelevant evidence;高 threshold 又讓經驗很難重用。 是這個實驗的折衷,不是固定 global default。
- :每輪 evidence breadth。 會因證據不足而觸發更多 rounds,反而比 更貴; 則一次塞進太多 chunks,增加 token 與 latency。這是一個有趣的 non-monotonic cost curve,說明「每輪少拿一點」不必然較省。
- :chunk granularity。 太小,證據被碎成多塊,Agent 要多走幾輪; 太大,每個 chunk 混入更多不相關文字。作者選 ,但不同語言、表格密度與 section 長度都可能改變最佳點。
- :recovery budget。 太小,難題沒有足夠回合補證據; 太大,少數難題會把平均 token 拉高,卻沒有相稱 accuracy gain。 是 bounded retrieval budget,不是「最多 15 回合就一定找齊」。
Robustness、尺度與負面訊號
作者還在 HotpotQA 改變 stored document 數量,並在 VersionQA 更換 backbone LLM。Figure 6 顯示,在 “only related” 到 50%/100% 文件量的設定下,DeepRead 的 accuracy 下降且 token/latency 增加;VikingRAG(-E+) 的 retrieval performance 整體較穩定。不過 “only related” 依賴 gold answer-containing documents,不能視為未知 production corpus 的自然條件。Figure 7 使用 DeepSeek-V4-Pro Preview 之外的 GPT-5.5、Seed-2.0 與 GLM-4.7,作者報告主要 accuracy/token 結論仍一致;這是 backbone robustness evidence,不是對所有 embedding、judge 或 provider 的 transfer proof。
資料集本身相當異質:VersionQA 是 software docs,SyllabusQA 是 DOCX syllabus,QASPER 是 scientific papers,HotpotQA 是 Wikipedia pages,LegalBench-cuad 是 commercial contracts,FinanceBench 是 financial reports。總 token 規模從 0.24M 到 8.78M,文件格式包含 PDF、Markdown、DOCX、TXT。這支持方法不是只對一種文件格式有效;但每個 QA pair 仍只關聯文字內容,沒有評估圖像、表格視覺布局、ACL、文件 revision 或多租戶噪音。
最重要的負面訊號是 ingestion feasibility。Paper 說 LightRAG 與 HippoRAG-2 在 FinanceBench 24 小時內無法完成 ingestion,BookRAG 只在 VersionQA 與 SyllabusQA 能完成。這讓 VikingRAG 的「practical storage」主張有實務價值,但也提醒我們 baseline 的 N/A 受 budget、實作與 provider 共同影響。另一個負面訊號是 checker:作者的 prompt 能減少 false-no-escalation,卻沒有消除它;而且最難的題在 escalation 後仍可能回答錯,因此 E+ 和 E 的 end-to-end accuracy 很接近不代表 escalation 沒有價值。
Limitations、threats to validity 與不該過度解讀的地方
Evidence-sufficiency checker 仍是 probabilistic policy gate
Checker 以 LLM 找 constraints、選 direct evidence、判斷 sufficiency。它比 naive prompt 更結構化,卻依然不是 deterministic verifier。錯誤可能來自 constraint 漏列、同義 entity 解析錯、時間範圍被忽略、否定句被當成支持,或模型因看見相關摘要而過早停止。false-no-escalation 對高風險財務、法律與 compliance 問題尤其不能只用 average accuracy 解釋。
Experience edges 會把歷史錯誤變成持久狀態
Edge construction 依賴歷史的 final answer 與 LLM evidence-selection judgment。若文件當時已過期、歷史答案本身錯、使用者權限和下一個使用者不同,shortcut 可能複製錯誤或越權。論文有 directional edge、reverse deletion record、similarity threshold,但沒有實驗 document update、ACL change、tenant isolation、poisoned trace、edge TTL 或 rollback。因此不能說 experience edges 已經安全地解決 long-term RAG memory。
同一份語料的 warm-up 與 evaluation 可能共享主題
作者避免讓 historical-question generator 看到 evaluation questions、gold answers、metadata 或 paraphrases,也把所有 edges 在測試前固定。不過 historical questions 與 evaluation questions 都從同一份 document corpus 獨立生成,自然可能共享 entity 或 topic。這不是直接 data leakage,但它比較接近「固定知識庫上的 recurring workload」而不是全新的 production question distribution。相似率從 SyllabusQA 26.48% 到 VersionQA 60%,不同資料集的 E+ benefit 不能只看 headline 區間。
Token、latency、storage 的分母不一樣
Query token ratio 不含把 1,000 個 historical questions 生成並回答的成本,也不等同於 provider 的美元價格;latency 受同一 LLM API service condition 與 sequential evaluation 影響;storage cost 還要看 embedding dimension、index implementation、preview 長度與 edge payload。作者報告 insertion、deletion、update 的 practical 行為,卻沒有給出每個 workload 的長期 break-even curve。採用前需要在自己的 traffic replay 上同時算 cold query、warm query、edge build、re-index、permission filter、cache miss 與 escalation tail latency。
LLM-as-a-judge 不是獨立 correctness proof
同一 judge 與 answer prompt 套在所有方法上,對相對比較有幫助;expert verification 又能處理一部分 disagreement。但 judge 仍可能偏好語意相似而忽略 citation provenance、數值精度或一個小但關鍵的限定詞。Paper 沒有提供每個 headline comparison 的 conventional confidence interval,也沒有以獨立人工 annotation、claim-level evidence recall 或 calibrated abstention 取代 aggregate judge accuracy。因此本文把結果稱作「端到端 semantic answer proxy」,不把它改寫成 production truthfulness rate。
Artifact availability 與最小 reproduction
截至 2026-09-15,作者的 VikingRAG GitHub repository main HEAD(本次核驗 commit 365d2adc00c8f42517aaef1dd037e0d6f9b58263)可存取;repository 的 LICENSE 是 AGPL-3.0。它不是只有 paper pseudocode:README、compose.yaml、Dockerfile、benchmark/RAG runner、六個 dataset adapter、YAML configs、generated_questions/、checkpoint/output mount 說明與 Supplement.pdf 都可讀取。這是 usable source artifact with external dependencies,不是「我已在本機成功重跑」的聲明。
資料狀態要單獨看。Repository 的 DATA_LICENSE.md 明確說它不重新分發 FinanceBench、QASPER、SyllabusQA、LegalBench-CUAD、HotpotQA 或 VersionQA 的 upstream data;dataset service 從官方 host 下載 pinned revision,並由使用者負責遵守各 upstream license。模型也不是隨 repo 一起提供:README 的預設設定需要 Volcano Engine/OpenAI 類 provider credentials、VLM 與 embedding model,實驗報告的 hardware 是 2 顆 Intel Xeon 6342 CPU 與 2 張 NVIDIA L20 GPU。故此處的 artifact 分類是:code/config/supplement 可存取;資料需由官方來源另行取得;checkpoint 與 provider access 未隨 repo 完整提供;端到端重現尚未由本文獨立驗證。
最小有用 reproduction 不應一開始就追六個 dataset 的所有 Table。可以先:
- 安裝 Docker 與 Compose,執行
docker compose config --quiet,建立benchmark/RAG/.env,只填入本地 secret,不把它提交。 - 依 README 對 VersionQA 做 dataset download/verify,固定官方 revision 與 manifest;不要把下載成功誤認成資料 license 已自動解決。
- 依
import → VikingRAG跑單一 dataset,再比較 NaiveRAG、DeepRead 與 VikingRAG;記錄 accuracy proxy、每題 input/output token、round count、tool calls、latency、ingestion time 與 storage。 - 在同一份固定語料用受控 historical question set 建 edge,再跑 VikingRAG-E/E+;把 edge count、similarity ratio、checker constraints、false-no-escalation、escalation rate 與 final answer 保存下來。
- 以一組人工審核的 hard cases 做 shadow verifier:特別抽出跨文件、時間條件、否定、ACL、更新後 URI 與不應回答的問題。只有當 checker 的 skip decision 經過獨立驗證,才可在低風險流量打開 E+。
最小 reproduction 的目的不是宣稱重現 Table 3 的每個數字,而是回答自己的 break-even 問題:歷史 trace 何時足以抵銷 edge build cost?文件修改後要重建哪些 object?checker 誤判一次的代價是否高於多走一輪?如果答案未知,先把 E+ 當成 shadow mode,讓它產生 verdict 與建議 path,仍由完整 agentic route 產生正式答案。
工程落地:什麼時候值得用,什麼時候不要用
值得用的情境
- 文件有穩定原生 hierarchy:章節、條款、附錄、課程單元、產品版本或財報 sections 本身就是 query 的導航訊號。
- 查詢存在重複與跨段依賴:使用者會反覆問同一個知識庫,但答案分散在不同文件或遠距 section,能攤平 edge construction。
- retrieval cost 是主要瓶頸:你已經有可觀測的 token/latency budget,且願意將一部分成本移到 ingestion、preview、embedding 與 edge maintenance。
- 可以建立安全的 evidence gate:你能保存 checker input、constraint、evidence、verdict,並對高風險 domain 強制 escalation 或人工 review。
什麼時候不要直接套用
- 文件頻繁更新、ACL 經常變動、租戶隔離要求高,卻沒有 URI version、edge invalidation 與 permission-aware retrieval。
- 問題高度 open-ended、歷史 query 很少、每次 intent 都不同;此時 experience edges 可能只增加 index 與噪音。
- 你真正需要的是 deterministic database query、精確 numerical computation、schema validation 或 transaction semantics。VikingRAG 的 LLM-guided retrieval 不能取代那些 control。
- 你沒有能力抽樣審核 false-no-escalation,卻打算讓 E+ 直接為法律、財務、醫療或 compliance 結果跳過深度 retrieval。
- 你只看 query token ratio,沒有量 ingestion、rebuild、storage、provider queue、tail latency、judge disagreement 與 human correction。這樣會把 serving trade-off 誤判成產品 ROI。
我會把採用順序定成:先做 URI storage 與 scoped tools,再做完整 VikingRAG multi-round;接著以 shadow traffic 建 experience edges;最後把 adaptive escalation 當成可撤回的 policy gate。每一層都保留 full-agent fallback,並將 Search → List/Grep → Read → answer trace 與 one-round → checker → escalation decision 一起納入 observability。這比一次打開所有優化更容易定位「是 index、edge、checker,還是 answer judge 造成品質變化」。
如果只記得三件事
- 技術想法:VikingRAG 的核心是 shared URI address space。Hierarchy 不必常駐 prompt,但每個 semantic hit 都能回到可 scope 的 structural object;Search、List、Grep、Read 因此組成 evidence navigation,而不是四個孤立 API。
- 最強證據:六個異質 structured-document datasets 與多種 backbone 下,作者報告接近高 accuracy baseline 的結果,同時把 token ratio 壓到 11.6%–51.9%,E+ 進一步到 5.1%–32.5%;Figure 3、Table 3、Figure 4、Figure 5 共同說明這是 accuracy、history、ingestion、storage 與 parameter 的系統 trade-off。
- 採用邊界:Experience edges 是帶 query context 的歷史 shortcut,E+ 的 no-escalation 是 LLM checker 的 policy decision;checker 仍有 5% 以上的錯誤區間,artifact 也需要外部資料與 model provider。把 edge、ACL、freshness、checker calibration 與 full-path fallback 治理好,才有資格把 token savings 帶進 production。
原始出處
- VikingRAG arXiv abstract and metadata — v1 submitted 2026-09-10,preprint status。
- VikingRAG full paper HTML — Sections 2–6、Figures 1–7、Tables 1–7、Algorithms 1–3。
- VikingRAG GitHub artifact — AGPL-3.0 code、Docker workflow、benchmark adapters、configs 與 Supplement.pdf。
- VikingRAG DATA_LICENSE.md — upstream datasets 的下載與 license 責任說明。
本文沒有修改 Paper Radar ledger;文章中的 artifact 狀態以 2026-09-15 的獨立 endpoint 核驗為準。