論文精讀
RAG vs. GraphRAG 論文精讀:檢索方法比較與混合策略
原文:RAG vs. GraphRAG: A Systematic Evaluation and Key Insights
90 秒掌握論文
- 問題: 近期多種 GraphRAG 系統被提出,並宣稱在多跳推理與全局摘要等複雜任務上全面超越傳統向量 RAG。然而各家論文在評估時往往同時改變圖譜建構演算法、檢索拓撲、上下文 token 預算及生成提示詞(Prompt),導致技術社群無法辨明:圖結構本身究竟在何時提供真實增益?又在何時淪為徒增延遲與開銷的無效複雜度?
- 核心洞見: 在統一前處理、檢索預算與生成模型的公平受控基準下,RAG 與 GraphRAG 各有不可取代的優勢區間,並非單純的取代關係。標準向量 RAG 在單跳事實檢索與精確拒答(Null 查詢)上表現最穩健且具備極低延遲;GraphRAG 的價值取決於查詢的「證據拓撲(Evidence Topology)」——當且僅當任務依賴跨實體關聯跳躍、時間序列演化或語料全局聚合時,圖引導檢索才呈現結構優勢。透過動態路由(Selection)或證據拼接(Integration)的混合架構,能有效兼顧各拓撲的長處。
- 最強證據: 論文在統一評估協議下測試問答(NQ、HotpotQA、MultiHop-RAG、NovelQA)與查詢導向摘要(SQuALITY、QMSum、ODSum)。在單跳 NQ 上,傳統向量 RAG 以 64.78% F1 領先所有 Graph 方法;在 MultiHop-RAG 綜合評比中,以文本塊為核心的圖引導方法 HippoRAG2 以 70.27% 準確率拔得頭籌;以社群報告為核心的 Community-Global 在時間推理(Temporal)上達 53.34%(RAG 僅 30.70%),但在無答案拒答題(Null)上驟降至 19.27%(RAG 高達 96.01%)。此外,圖索引建置時間高達 RAG 的 41 至 57 倍(Table 4)。
- 主要邊界: 實驗主要基於 Llama-3.1-8B-Instruct(部分測試輔以 70B)與固定公開 Benchmark 測試集;圖譜皆為一次性離線批量抽取,未驗證動態增量更新;效率分析僅記錄單機基準運算時間,未涵蓋生產環境的 API 調用失敗重試、權限過濾(ACL)、快取策略與整體維運成本。
論文版本註記:本文依據 Han 等人(密西根州立大學、Meta、IBM 等)發表之 arXiv:2502.11371 初始版本(v1)研究內容展開精讀,arXiv 頁面後續已遞交更新修訂版(至 v3);本文數據以受控對照實驗論文報告結果為準。
理解前需要知道什麼
在深入比較前,必須釐清傳統檢索增強生成(Flat Dense RAG)與四類新興 GraphRAG 系統的運作架構與控制點差異:
- 傳統向量 RAG(Flat Dense RAG):
將文檔切分為固定長度的文本塊(Chunks),透過預訓練稠密嵌入模型(如 Contriever、BGE)將每個文本塊映射為向量。檢索階段計算問題向量與庫中向量的餘弦相似度(Cosine Similarity),取 Top- 相關文本塊直接拼接入提示詞交由大型語言模型(LLM)回答。 - 既有方法的瓶頸(Why traditional RAG is insufficient):
- 孤立文本塊盲區: 向量檢索預設文本塊之間彼此獨立。若回答問題所需的證據鏈條跨越數個文檔或章節,向量相似度往往只能匹配到帶有問題關鍵字的部分文本塊,而遺漏缺乏直接關鍵字的中介橋樑段落。
- 多跳推理(Multi-hop Reasoning)斷裂: 面對需要「實體 A 實體 B 實體 C」的複雜推論,傳統 RAG 缺乏顯式結構追蹤實體跳轉路徑,容易檢索出雜訊過多的片段。
- 宏觀語料聚合失能: 面對「整份語料庫的核心主題演變」等全局性摘要問題,傳統 RAG 難以在有限 context window 內拼湊出全景視角。
- 既有評估協議的混亂:
過往支持 GraphRAG 的研究往往伴隨不同的 chunk 大小、擴增的 context 預算與更強大的生成模型,使得讀者無法確定性能提升究竟來自「圖結構檢索」還是單純「讀了更多 tokens」或「用了更好的提示詞工程」。 - 論文界定的四類 GraphRAG 系統(Table 1, §3.2):
- 知識圖譜型(KG-based GraphRAG): 以 LlamaIndex KG-GraphRAG 為代表。利用 LLM 抽取實體與關聯三元組 構成顯式圖譜。檢索時以問題實體為種子進行多跳子圖遍歷。論文進一步區分純三元組(Triplets only)與三元組附帶原段落(Triplets + Text)兩種檢索單位。
- 社群報告型(Community-based GraphRAG): 以微軟 Microsoft GraphRAG 為代表。從文本抽取實體網絡後,利用 Leiden 演算法劃分多層級圖社群(Communities),並由 LLM 為各社群預先生成結構化摘要報告。分為 Local(檢索實體鄰域及低階社群報告)與 Global(直接檢索高階社群報告進行全域聚合)兩種模式。
- 文本為本的圖引導型(Text-centric Graph-guided RAG): 以 HippoRAG2 為代表。圖結構僅作為索引與走訪的引導機制(透過個體化 PageRank 在實體圖上傳播權重),最終傳遞給 LLM 的依然是包含完整上下文的原始文本塊(Text Chunks)。
- 層級摘要型(Hierarchical Summary RAG): 以 RAPTOR 為代表。不進行顯式實體抽取,而是對文本塊進行遞迴聚類(Recursive Clustering)並為各層聚類生成摘要,建構樹狀層級結構,檢索時跨層級匹配節點。
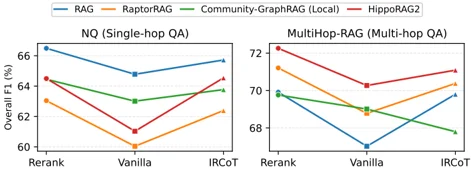
Figure 1,論文 Section 2 的架構對比:傳統 RAG 依賴獨立文本塊向量檢索,KG-based GraphRAG 透過實體與關係三元組進行圖遍歷,Community-based GraphRAG 則透過階層式社群劃分與預生成摘要提供全景視野。原始 Figure 1 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

核心直覺
評估 RAG 與 GraphRAG 的根本心智模型,應從「哪種演算法在平均分數上更高」轉變為「該問題的證據分佈屬於哪種拓撲結構(Evidence Topology)」:
- 局部集中型拓撲(Local Topology): 答案集中在單一事實陳述或連續段落(如定義查詢、特定數值、具體條款)。原始文本塊保留了最細緻的語義上下文,幾乎沒有訊息抽取損失。此時傳統向量 RAG 是速度最快、準確率最高且最具成本效益的解法。
- 跨實體路徑型拓撲(Relational / Multi-hop Topology): 答案仰賴多個分散實體之間的關聯鏈條。圖譜中的邊與節點提供了跨越語義鴻溝的導航路標,使系統能夠追蹤中間橋樑實體。
- 全局社群型拓撲(Global Corpus-level Topology): 問題需要全景視角的主題歸納、趨勢對比或宏觀總結。社群層級報告(Community Summaries)預先壓縮了全局分佈,避免在檢索階段因 token 上限而截斷全局視野。
然而,圖結構並非免費的架構升級。實體抽取本身會帶來訊息流失(Information Loss),抽取失敗率更直接造成召回盲點;當面臨不具備答案的負向問題時,高階社群報告容易導致模型過度演繹,引發嚴重的幻覺;此外,圖譜的建構耗時與遍歷延遲呈數量級暴增。
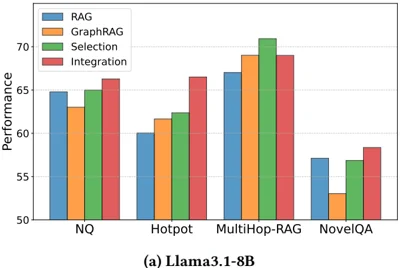
Figure 3(a),論文 Section 4.4 的 QA comparison:RAG、GraphRAG、Selection 與 Integration 在 NQ、HotpotQA、MultiHop-RAG 與 NovelQA 上的差異,讓「graph 是否值得」回到 query type 與 evidence topology。見 原始 Figure 3 anchor 與 Figure 3(a) source endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

用一個例子走完整個方法
以下透過三個代表性問題,走完整個檢索與生成流程,對照各方法在不同證據拓撲下的決策路徑與失敗隱患:
- 輸入查詢(Input Queries):
- 查詢 A(多跳關聯): 「去年甲公司收購乙公司後,負責主導其雲端遷移專案的總監是誰?」
- 查詢 B(局部事實): 「丙雲端服務 Enterprise 方案的每月標準授權費是多少?」
- 查詢 C(不存在資訊的拒答題): 「甲公司在 1995 年指派哪位經理執行丁專案?」(語料中甲公司成立於 2005 年,丁專案並不存在)。
- 中間表徵與檢索遍歷(Intermediate Traversal):
- 傳統 RAG: 計算查詢的稠密向量 ,在向量空間計算餘弦相似度,拉回 Top- 文本塊。查詢 B 能直接命中含有定價表格的段落;查詢 A 則因「收購新聞」與「專案團隊名冊」分散在不同文檔且字面相似度不高,往往只檢索到收購段落,遺漏後續負責人段落。
- KG-GraphRAG: 透過 LLM 辨識實體「甲公司」、「乙公司」、「雲端遷移」,在知識圖譜中尋找關聯三元組 以及 ,由實體節點延伸檢索相鄰三元組或原段落。
- Community-GraphRAG: 定位實體所屬的 Leiden 圖社群。查詢 A 在 Local 模式下鎖定「併購重組與技術整併」社群報告,取得跨部門脈絡;查詢 C 在 Global 模式下檢索了公司歷年發展的宏觀社群報告。
- HippoRAG2: 以問題抽取的實體為種子節點,執行個體化 PageRank(Personalized PageRank)在實體共現圖上進行機率遊走擴散,計算所有關聯實體的權重,並將權重聚合回原本的原始文本塊(Text Chunks)。
- 決策與轉換(Selection & Integration 混合策略):
- Selection 路由(Appendix G): 透過輕量分類器預先判斷查詢類型。查詢 B 識別為 Fact-based,路由至傳統向量 RAG;查詢 A 識別為 Reasoning-based,路由至 GraphRAG。
- Integration 拼接(Appendix H): 同時調用 RAG 與 Graph 檢索器,將兩者檢索出的文本塊與圖摘要依評分拼接為統一上下文 。
- 輸出生成(Output Generation):
- 查詢 A: 圖導引檢索(如 HippoRAG2)成功尋回連結兩個事件的中介橋樑段落,Llama-3.1 8B 輸出正確負責總監;傳統 RAG 因證據鏈斷裂無法推論。
- 查詢 B: 傳統 RAG 迅速回傳精確金額;GraphRAG 經歷多步實體擴展與圖遍歷,輸出相同答案但耗費了 8 倍的檢索時間與數倍 token。
- 潛在失敗點(Likely Failure Points):
- 三元組抽取斷鏈: 若建圖時 LLM 漏抽了關鍵的三元組,KG-GraphRAG 的圖遍歷將直接中斷,造成召回率歸零。
- 拒答題嚴重幻覺(針對查詢 C): 在面臨無解查詢時,Community-Global 檢索出的高層摘要充滿了概括性的業務敘述,缺少精確的事實邊界。LLM 接收到龐大但無直接關聯的宏觀文字後,容易產生幻覺捏造虛構經理,在拒答能力上徹底失守。
技術機制
論文為了消除既往研究的混雜變因,建立了嚴謹的統一對照體系(Section 3):
1. 統一評估協議原則
- 檢索與生成嚴格解耦(Decoupling Retrieval and Generation):
評估框架將各檢索系統的檢索結果(Retrieved Contexts)先固化存儲,隨後使用完全相同的生成腳本、完全相同的溫度參數(Temperature = 0)與標準提示詞模板餵給目標生成模型(以 Llama-3.1-8B-Instruct 為基準,部分實驗驗證 70B),杜絕提示詞工程或生成超參數對檢索機制的干擾。 - 檢索上下文預算對齊(Budget Alignment):
嚴格限制檢索送入 LLM 的總內容預算。對傳統 RAG 採 Top- chunks(預設 ,約 1500–2000 tokens);對 GraphRAG 方法亦匹配相應的 token 長度預算,確保比較焦點在於「內容的拓撲品質」而非「誰塞了更多字」。
2. 檢索機制公式化表達
- 標準向量檢索(Flat Dense RAG):
給定問題 與候選文本塊集合 ,利用嵌入模型 計算: 選取評分最高之前 個文本塊。 - HippoRAG2 圖引導檢索(Text-centric Graph-guided):
建構實體共現關聯圖 。由問題 抽取種子實體集合 。定義初始重啟機率向量 ,其中 之權重均分,其餘為 0。透過隨機遊走演算法計算穩態個體化 PageRank 向量 : 其中 為節點轉移矩陣, 為阻尼係數。文本塊 的最終關聯分數由其所包含之實體穩態機率加總決定: 檢索系統隨後挑選分數最高之文本塊集合返回,保證最終輸出單元具備完整的語意連貫性。 - 社群報告檢索(Community-based):
將實體圖透過 Leiden 演算法劃分為不同階層的社群結構 。每個社群預先生成結構化摘要報告 。- Local 檢索: 計算問題實體與低層社群實體鄰域的關聯,檢索局部的實體關聯與低階社群報告。
- Global 檢索: 計算問題向量與高階社群報告 的向量相似度,檢索數個宏觀報告後由 LLM 進行映射歸納(Map-Reduce)。
3. 混合策略機制(Hybrid Strategies)
- Selection 路由策略(Appendix G):
使用輕量級 LLM 分類器分析輸入問題特徵,動態指派檢索器: - Integration 證據整合策略(Appendix H):
平行執行向量檢索與圖檢索,將傳統 RAG 召回的文本塊集 與 GraphRAG 召回之實體/報告集 去重整合: 依綜合排序截斷至既定 token 預算後輸入生成模型。
實驗如何讀
論文在統一控制下執行了跨資料集、跨任務與多維度效率評估,主要實驗數據與觀察如下:
1. 單跳與多跳問答評估(Table 1)
Table 1 在 Llama-3.1-8B-Instruct 設定下,比較各檢索方法在單跳事實基準 NQ 與經典多跳基準 HotpotQA 上的 F1 分數(%):
| 檢索方法(Method) | NQ F1(單跳) | HotpotQA F1(多跳) |
|---|---|---|
| 標準向量 RAG | 64.78 | 60.04 |
| RaptorRAG(層級摘要) | 60.04 | 61.31 |
| KG-GraphRAG(純三元組 Triplets only) | 34.28 | 25.02 |
| KG-GraphRAG(三元組加原文 Triplets+Text) | 50.27 | 42.60 |
| Community-GraphRAG(Local 本地模式) | 63.01 | 61.66 |
| Community-GraphRAG(Global 全域模式) | 54.48 | 45.16 |
| HippoRAG2(文本為本圖引導) | 61.03 | 63.01 |
數據深入解析:
- 單跳事實 RAG 稱霸: 在 NQ 上,傳統 RAG 以 64.78% F1 領先所有圖方法。KG-GraphRAG(純三元組)崩跌至 34.28%,即使補上原文也僅有 50.27%。
- 知識圖譜覆蓋率瓶頸(Appendix C): 論文進一步調查發現,在自動構建的知識圖譜中,HotpotQA 僅約 65.8% 的答案實體存在於圖譜節點中,NQ 僅有 65.5%。這證明單純仰賴 LLM 抽取實體三元組會造成嚴重的資訊流失,直接封死了純圖方法在單跳與事實題上的準確率上限。
- 多跳對決: 在 HotpotQA 上,HippoRAG2 達到 63.01% F1,略優於傳統 RAG(60.04%)與 Community-Local(61.66%)。其關鍵在於 HippoRAG2 雖用圖來導航,但最終檢索送入 LLM 的依然是完整的原始段落,避免了語義破碎。
2. MultiHop-RAG 細粒度子類型評估(Table 2)
Table 2 呈現 MultiHop-RAG 測試集中四種細粒度查詢類型的準確率(Accuracy, %),揭示了不同架構在特定推理模式下的極端差異:
| 檢索方法(Method) | 推論(Inference) | 對比(Comparison) | 拒答(Null) | 時間序列(Temporal) | 綜合總評(Overall) |
|---|---|---|---|---|---|
| 標準向量 RAG | 92.16 | 57.59 | 96.01 | 30.70 | 67.02 |
| RaptorRAG | 91.91 | 55.26 | 90.03 | 45.28 | 68.78 |
| KG-GraphRAG(Triplets) | 55.76 | 22.55 | 98.67 | 18.70 | 41.24 |
| KG-GraphRAG(Triplets+Text) | 67.40 | 34.70 | 97.34 | 17.15 | 48.51 |
| Community-GraphRAG(Local) | 86.89 | 60.63 | 80.07 | 50.60 | 69.01 |
| Community-GraphRAG(Global) | 89.34 | 64.02 | 19.27 | 53.34 | 64.40 |
| HippoRAG2 | 91.54 | 58.41 | 85.71 | 49.91 | 70.27 |
核心數據發現:
- HippoRAG2 總評最高: 達到 70.27% 綜合準確率,展現平衡的跨維度表現。
- 時間維度(Temporal)圖結構大勝: Community-Global(53.34%)與 Local(50.60%)大幅超越傳統 RAG 的 30.70%。時間線查詢往往橫跨多篇文檔的事件發展,社群摘要結構能有效保留宏觀時間推進脈絡。
- 拒答維度(Null)社群報告雪崩: 當問題在語料中根本沒有答案時,標準 RAG 維持 96.01% 的極高正確拒答率;然而 Community-Global 的拒答準確率暴跌至 19.27%!社群報告中泛化的大段背景文字容易引發 LLM 的確認偏誤,導致模型無中生有產生幻覺回答。
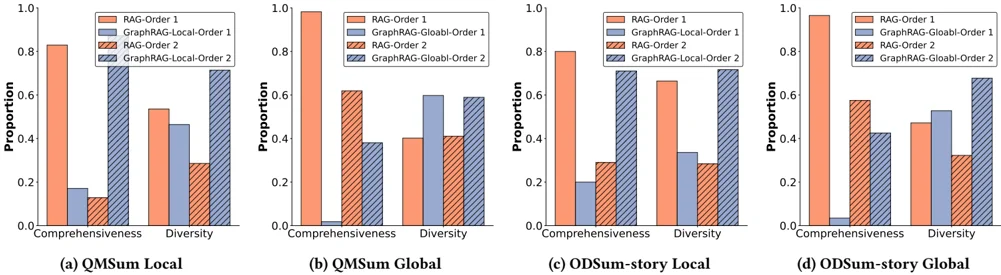
Figure 2,論文 Section 4.2 的檢索內容重疊分析:展示在不同問題複雜度下,RAG 與各類 GraphRAG 所召回的上下文內容重疊程度,揭示圖結構如何補足純向量相似度無法觸及的中介路徑證據。原始 Figure 2 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

3. NovelQA 21 類精細切片(Table 3 節選)
在小說超長語境問答 NovelQA 中,傳統 RAG 在單跳問題(sh)上平均達 68.73% 顯著領先;在細節查詢(dtl)上達 55.28% 保持優勢;只有在多跳關聯(mh)上,GraphRAG 系列展現出更具競爭力的水準(約 57–60%)。
4. 正交推論增強:重排序與迭代檢索(Section 4.3, Figure 1)
論文在 Section 4.3 與 Figure 1 測試了引入重排序模型(BGE-Reranker-Large)與多輪迭代思維鏈檢索(IRCoT)。結果顯示:
- 重排序與 IRCoT 幾乎對所有 RAG 與 GraphRAG 方法都帶來一致的增益。
- 但相對優劣位階完全不變: NQ 單跳依舊是 RAG 最強;MultiHop-RAG 依舊是圖導引方法佔優;Community-Local 搭配 IRCoT 依然無法修復 Null 查詢上的低劣表現。
- 工程結論: 推理時技巧(Rerank, CoT)屬於正交優化手段,無法彌補基礎檢索拓撲的根本盲區。
5. 建圖 LLM 等級對圖品質的決定性影響(Table 5)
在 Llama-3.1-70B 下評估 MultiHop-RAG,測試使用不同模型建置圖譜的影響:
| 建圖模型(Construction LLM) | 推論(Inference) | 對比(Comparison) | 時間(Temporal) | 綜合總評(Overall) |
|---|---|---|---|---|
| 無圖(標準向量 RAG) | 94.85 | 56.31 | 25.73 | 65.77 |
| GPT-4o-mini | 92.03 | 60.16 | 49.06 | 71.17 |
| GPT-4o | 93.63 | 66.59 | 58.49 | 75.08 |
數據表明,Temporal 準確率隨著建圖模型從無圖(25.73%) GPT-4o-mini(49.06%) GPT-4o(58.49%)呈躍升式改善。這證明 GraphRAG 的推理天花板高度依賴建圖 LLM 的資訊擷取精度;若為了節省開銷採用弱模型建圖,產生的噪聲圖譜將嚴重拖累下游檢索品質。
6. 效率與開銷代價(Section 4.6, Table 4)
在 MultiHop-RAG 測試集上量測的索引建置與檢索資源消耗:
| 檢索方法(Method) | 索引建構耗時(秒) | 檢索查詢耗時(秒) | 索引儲存空間(MB) |
|---|---|---|---|
| 標準向量 RAG | 135 | 1,724 | 127 |
| KG-GraphRAG | 7,702(57×) | 14,434(8.3×) | 117 |
| Community-GraphRAG | 5,560(41×) | 1,249 | 165 |
- 建圖成本昂貴: 圖索引建構需要對全量文檔調用 LLM 抽取實體與關係,耗時高達傳統 RAG 的 41 至 57 倍。
- KG 檢索延遲巨大: KG-GraphRAG 在查詢時需進行實體抽取與多輪子圖走訪,檢索耗時為傳統 RAG 的 8.3 倍。
- Community 檢索的延遲亮點: Community-GraphRAG 檢索時間(1249s)反而低於傳統 RAG(1724s),原因在於高階社群報告大幅縮減了比對候選集數量。
7. 查詢導向摘要與評估協議偏誤(Section 5, Figure 4)
在 SQuALITY 與 QMSum 查詢導向摘要中,直接回傳原始文本的 RAG、RAPTOR 與 HippoRAG2 顯著優於 Community-Global。因人類標註摘要需要具體事件的細微細節,Community-Global 的高層社群摘要丟失過多具體事實。
更重要的是,論文在 Section 5.3(Figure 4)嚴厲檢驗了前人研究仰賴的 LLM-as-a-judge 評估協議。當改變候選摘要呈現給評審 LLM 的先後次序(Order 1 vs Order 2)時:
- 全面性(Comprehensiveness): 順序 1 時 LLM 顯著偏好 RAG;順序 2 時卻劇烈反轉偏好 Community-Local。
- 多樣性(Diversity): 顛倒順序同樣導致勝率大幅逆轉。
- 這直接證明了過往宣稱「GraphRAG 摘要品質碾壓 RAG」的結論,很大程度上是評審模型嚴重的位置偏誤(Position Bias)所造成的評估假象。
證據地圖
為確保架構選型具備堅實依據,本節依據論文實驗將直接證據、因果推論、未竟邊界與工程化結論明確分離:
論文直接證據
- 統一受控協議下的拓撲差異: Section 3 與 Table 1–3 證實,在對齊檢索 token 預算與生成模型的條件下,各架構互有勝負。標準向量 RAG 在單跳問答(NQ F1 64.78%)與事實檢索上穩居第一;HippoRAG2 在多跳問答總評上達到最高(70.27%);Community-Global 在時間跨度推理(53.34%)上具備優勢。
- 知識圖譜實體抽取流失: Appendix C 實測顯示自動抽取構建的 KG 僅涵蓋約 65.5%–65.8% 的基準答案實體,直接限制了純三元組檢索的表現。
- 拒答(Null)災難: Table 2 數據證實 Community-Global 面對無答案問題時,拒答準確率暴跌至 19.27%(傳統 RAG 為 96.01%)。
- 建置與運算開銷倍率: Table 4 測量顯示圖譜構建時間高達向量索引的 41–57 倍;KG 查詢延遲為傳統 RAG 的 8.3 倍。
- 評估協議的位置偏誤: Figure 4 證實利用 LLM-as-a-judge 評估摘要時,改變提示詞呈現順序會導致勝率劇烈翻轉。
作者因果解讀
- 作者主張 RAG 與 GraphRAG 本質上並非互斥的競爭對手,而是互補的技術家族。
- 圖結構的核心價值在於提供結構化的「關係先驗」與「跨文本語義橋樑」,這正是向量空間局部匹配所缺乏的。
- 提出 Selection 路由分類器與 Integration 雙路拼接策略,能夠在保持 RAG 局部事實精確度的同時,吸納圖譜的多跳推理能力。
- 圖譜品質高度取決於建圖 LLM 的推論能力,高階 LLM 抽取的實體邊緣品質直接決定下游表現。
論文未證明
- 動態增量維護(Incremental Updates): 論文所有實驗均基於靜態語料庫的一次性離線建圖。在真實業務中文檔頻繁增刪改查(CRUD)時,圖譜如何低成本增量維護完全未被探討。
- 企業級生產環境條件: 未涉及企業私有數據、文檔存取權限過濾(ACL)、多租戶隔離(Multi-tenancy)與跨語言混合檢索。
- 整體擁有成本(TCO): Table 4 僅記錄單機基準實驗時間,未計算商業 API 調用費用、抽取失敗重試成本、資料庫伺服器託管費用與工程維護人力。
- 模型泛化範圍: 主要結論奠基於 Llama-3.1-8B-Instruct,雖然 70B 趨勢相近,但尚未涵蓋其他專有前沿模型(如 GPT-4o、Claude 3.5 Sonnet)或領域專用小模型。
Bloss0m 工程化整理
綜合論文實證,Bloss0m 歸納出以下可落地的工程判斷原則:
- 摒棄「全面升級 GraphRAG」的盲從: 切勿僅憑基準論文的 Overall 分數替換既有向量檢索管道。
- 切片驗證(Slice-based Evaluation): 評估既有系統時,必須將查詢流量細分為單跳事實、多跳關聯、全局概括與邊界拒答(Null)四類,量化各類佔比。
- 優選文本為本的圖引導架構: 若需引進圖能力,應優先考慮 HippoRAG2 這類保留原始 chunk 作為回傳單元的架構,避免純三元組的訊息流失。
Artifact 與可重現性
- 檢查狀態與存取性: 截至 2026 年查核,論文原始碼 github.com/haoyuhan1/RAGvsGraphRAG 可公開存取(Usable);arXiv 論文頁面(arXiv:2502.11371)提供完整 PDF 與 HTML 版本。
- 可重現性限制:
- 官方代碼儲存庫僅有單一初始 commit,GitHub Releases 處於空白狀態(Empty),未附帶已編譯好的圖譜快取(Graph Caches)、固定權重檢查點(Checkpoints)或包含全量超參數與亂數種子的環境 Docker 映像檔。
- 代碼高度依賴多套外部開源工具鏈(LlamaIndex、vLLM、HippoRAG、RAPTOR、Microsoft GraphRAG 以及 OpenAI API)。各上游套件版本變更、API 模型端點行為演進及非確定性生成,意味著獨立重跑實驗可能產生微幅波動。
- 結論定位: 本文報告之所有實驗指標均為作者論文原載數據,非外部第三方獨立完整重跑結果;代碼庫足以支援工程師實作相似流程之 POC,但難以無條件進行百分之百位元級的確定性重現。
Bloss0m 工程判斷與不適用條件
依據客觀證據,Bloss0m 制定之檢索架構選型矩陣與不適用清單如下:
| 業務場景與查詢特性 | 架構推薦決策 | 關鍵工程依據 |
|---|---|---|
| 以單跳 FAQ、具體名詞定義、細節規格查詢為主 | 堅決維持傳統向量 RAG | Table 1 證實 RAG 在 NQ 單跳達 64.78% F1 領先全場;導入圖結構只會白白浪費 40 倍建圖成本與增加檢索延遲。 |
| 嚴格要求防範幻覺、拒答敏感的生產環境 | 禁止使用 Community-Global | Table 2 顯示 Community-Global 在無答案題目上拒答率僅 19.27%(RAG 為 96.01%),存在巨大的法規與合規風險。 |
| 高頻增刪改查、即時性要求高(Freshness < 1 小時) | 暫緩導入全量 GraphRAG | 圖譜重建極其昂貴(Table 4 需數千秒),目前缺乏成熟穩定的工業級增量社群重算方案。 |
| 跨文檔實體關係密集(如金融舞弊追查、醫療診斷路徑) | 採用 HippoRAG2 型圖引導 RAG | Table 2 總評達 70.27%,兼顧圖拓撲走訪優勢與原始文本塊的上下文保真度。 |
| 需要全庫宏觀綜述(如產業趨勢報告自動生成) | 評估 Community-Global(需防護) | 在時間軸(53.34%)與宏觀對比(64.02%)有明顯信號;但必須搭配檢索後過濾器與防幻覺校驗。 |
| 異質混合查詢流量 | 部署 Selection 智慧路由層 | 透過小型分類器(如 Figure 7 Prompt)分流單跳與多跳查詢,以最低系統代價獲取整體效能最優解。 |
什麼時候不要用 GraphRAG(不適用警訊)
- 沒有明確關係鏈需求: 若業務知識庫 80% 以上查詢均能透過 1–2 個段落直接回答,建圖純屬浪費資源。
- 對 p95 延遲要求極端(< 300ms): KG 檢索耗時為傳統 RAG 的數倍以上,無法滿足即時互動介面的 SLA。
- 沒有圖譜維護與資料治理人力: 圖譜的實體抽取對 Prompt 與 LLM 敏感,缺乏本體(Ontology)規範與監控將導致圖譜快速腐化。
- 打算在小模型(8B)上直接做雙路拼接(Integration): 實驗顯示過長且異質的上下文會分散小模型注意力,甚至破壞拒答能力。
讀完後的三個記憶點
- 技術本質: GraphRAG 不是單一算法,而是包含 KG-based、Community-based、Text-centric 與 Hierarchical 四種完全不同拓撲的設計家族。其核心價值是提供跨文本的「關係與全局結構先驗」,而非取代傳統向量檢索。
- 核心證據: 在公平受控測試下,傳統向量 RAG 在單跳事實(NQ F1 64.78%)與防幻覺拒答(Null 96.01%)上強烈領先;HippoRAG2 在多跳綜合表現最佳(70.27%);Community-Global 雖擅長宏觀時間線(53.34%),但拒答率暴跌至 19.27%,且建圖成本高達 RAG 的 41 至 57 倍。
- 工程邊界: 拒絕以平均分數作為技術選型標準。應依據問題的「證據拓撲」導入 Selection 路由機制,將局部事實保留給輕快廉價的向量 RAG,僅在多跳關聯或全局概括時動態啟動圖引導檢索。
Primary sources
- 原始論文: Haoyu Han, Li Ma, Yu Wang, Harry Shomer, Yongjia Lei, Zhisheng Qi, Kai Guo, Zhigang Hua, Bo Long, Hui Liu, Charu C. Aggarwal, Jiliang Tang. RAG vs. GraphRAG: A Systematic Evaluation and Key Insights. arXiv:2502.11371 [cs.CL], 2025. arXiv:2502.11371 頁面 | PDF 下載
- 官方開源代碼: haoyuhan1/RAGvsGraphRAG(涵蓋 RAG、KG-GraphRAG、Microsoft GraphRAG、HippoRAG2 與評估腳本)。
- 關鍵關聯研究:
- Edge et al. From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130, 2024.
- Soman et al. HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models. NeurIPS 2024.
- Sarthi et al. RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval. ICLR 2024.