檢索系統:從證據到 Production RAG
系列 · 1 篇
-
REVA:把 RAG 壓縮搬到可重用的 evidence view,而不是每次請求重新付費
進階精讀 Nguyen 等人的 REVA(arXiv 2609.11209 v1):用 generator attention 的歷史軌跡建立 document-keyed score store,在離線評分與線上渲染之間切開 RAG 壓縮成本,並檢查 unseen-document fallback、local/global budget、品質與延遲邊界。
90 秒掌握這篇論文
- 問題
- post-retrieval compressor 如果在每個 request 上另外呼叫 model、做 token scoring 或生成式 rewriting,縮短 context 的收益可能被 compression latency 抵消;model-agnostic 的 selector 也可能保留模型本來就知道的內容,反而刪掉真正需要的 evidence。
- 核心直覺
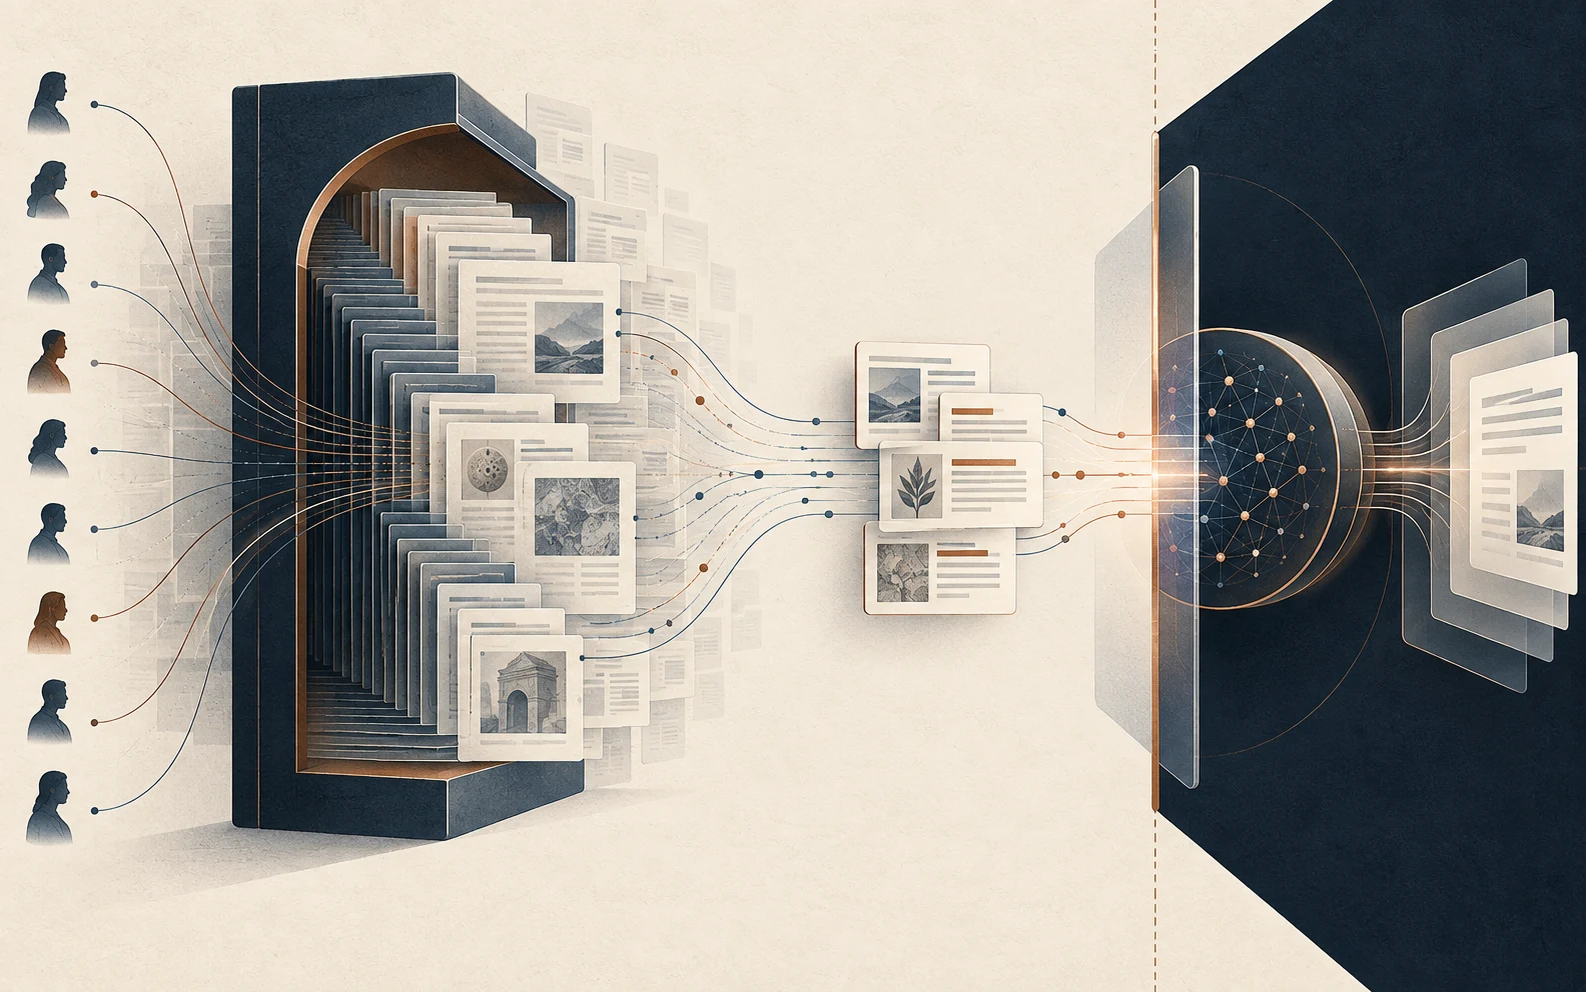
- 歷史 RAG request 已經留下 generator 如何使用文件的訊號。把 query 與可用的 answer/response 對文件 token 的 attention 映射到可讀的 word units,再跨重複 document access 平均,就能得到一份可重用的 evidence prior。它不是 query-specific answer,而是文件層級的 retention tendency。
- 最強證據
- 在固定 top-10 retrieval cache、四個 QA benchmark 與三個 generator 上,B=512 full-split Table I 的 REVA-local 在 NQ、TriviaQA、HotpotQA、2Wiki 都比 Trunc-local 高;Table II 的 12 個 generator–dataset 設定平均為 37.83 F1、26.98 EM、27.5 ms online overhead。all-seen Table III 的 120 個 budget cells 則讓 REVA-global 達 43.72 F1、32.75 EM、49 ms。
- 主要邊界
- all-seen 只保留所有 top-K 文件都有分數的 held-out query,不能代表正式環境 coverage;full-split 才含 prefix fallback。attention 也只是 evidence importance proxy,不是 citation correctness 的驗證器;報告的 online overhead 排除 score-store 建置與更新。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡