讀法可搭配 三遍掃描法。本篇是 Lewis RAG 使用的基礎 retriever 方法,不是生成論文,也不是 Agent 迴圈。昂貴的聯合預訓練對照見 REALM;完整方法關係見 RAG 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:開放域 QA 依賴高效段落檢索;實務上幾乎都用 TF-IDF/BM25 這類稀疏倒排。稀疏表示難處理同義與改寫,也無法用問句–段落對直接學任務特定空間。
- 核心洞見:把檢索改成兩個獨立 BERT-base 編碼器:passage encoder 離線把 Wikipedia 切成的段落編成 768 維向量並建 FAISS 索引;question encoder 在線編碼問題,用點積做 MIPS。訓練用 gold 正例+in-batch negatives(再加 BM25 hard negatives),不必像 ORQA/REALM 那樣做昂貴的額外預訓練或週期重建索引。
- 最強證據:Table 2 的 top-20/top-100 檢索準確率——NQ 上 Single DPR 78.4%/85.4%,BM25 59.1%/73.7%(約 +19.3 個百分點的 top-20);摘要寫 9%–19% absolute。Table 4 端到端 Exact Match:NQ 上 DPR 41.5,高於 ORQA 33.3 與 REALMNews 40.4。Figure 1:只用 1,000 個訓練例的 DPR 已勝過 BM25。
- 主要邊界:記憶是 2018-12-20 English Wikipedia 切成約 2,101 萬個 100-word 段落;評測是英語開放域/抽取式 QA;相似度是雙編碼器點積,沒有 late interaction;不是 production hybrid、不是 citation faithfulness、不是 agentic search/read/final。
我的結論是:DPR 最值得保留的貢獻,是用可學習的 dense 雙編碼器取代第一階段的稀疏檢索。它沒有定義 Production RAG 平台或生成式答案,也不應與後續 embedding 排行榜直接比較。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Karpukhin et al., EMNLP 2020 對應的 arXiv:2004.04906 v3,首發於 2020-04-10,最後修訂於 2020-09-30。PDF 與 arXiv HTML 標示 arXiv.org perpetual non-exclusive license;ACL Anthology 正式版另受 ACL 授權約束。
作者順序依 v3 PDF/HTML 與 Anthology:Vladimir Karpukhin、Barlas Oğuz、Sewon Min、Patrick Lewis、Ledell Wu、Sergey Edunov、Danqi Chen、Wen-tau Yih。Karpukhin 與 Oğuz 是共同一作;Min 屬 University of Washington,Chen 屬 Princeton,其餘作者分屬 Facebook AI。
除摘要外,本文核對 Section 2–6、Table 1–4、Figure 1、Appendix A–D(含 Table 5–7),以及截至 2026-08-27 的工件。Lewis et al. 的 RAG(本站 note 31)把本篇的 dense retriever 接到 BART 生成;本文不把 RAG-Sequence/RAG-Token 的 Exact Match 納入 DPR 表格。
ColBERT late interaction、E5/GTE、2025–26 embedding 排行榜,以及 BM25 at scale、FinRank、RAG-Anything 的結果也不納入本文。
這是已發表的 EMNLP 論文,不是 preprint。
讀者真正要回答的問題
當開放域 QA 的第一段仍是 BM25 時,工程上是該繼續靠關鍵詞倒排,還是用問句–段落對學一組可 MIPS 的 dense 編碼器?Karpukhin et al. 的回答是:兩個獨立 BERT、點積相似度、in-batch negatives,先把 top- 檢索準確率拉起來,再交給抽取式 reader。
比較精確的讀法不是「dense embedding 是不是永遠贏過 BM25」。真正的問題是:把稀疏第一段換成雙編碼器 dense 檢索,在哪些資料集上真的移動 top- 與 Exact Match,又在哪裡因為高詞重疊(SQuAD)、無 late interaction、或語料仍是 Wikipedia 而出界?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Table 2 給出五個資料集的 top-20/top-100 檢索準確率(BM25、Single/Multi DPR、BM25+DPR);Figure 1 顯示訓練例數對 NQ dev top- 的影響;Table 3 是 negatives/in-batch/BM25 hard negatives 消融;Table 4 是端到端 Exact Match;Appendix Table 5–6 是 distant supervision 與相似度/loss;Table 7 是 BM25 vs DPR 質性例子;效率數字:995.0 qps(DPR/FAISS top-100)對 23.7 qps/thread(BM25)。 |
| 作者主張 | Dense 表示單獨就能實用;不必 ICT/額外預訓練或複雜 joint training 也能超過 ORQA/REALM 路線上的開放域 QA;關鍵是 dual-encoder 訓練配方(尤其 in-batch+hard negatives)。 |
| 論文未證明 | 私有語料上的 dense 檢索;BM25+dense+reranker+ACL 的 production hybrid;late interaction(ColBERT 僅作相關工作提及);生成式答案或 citation faithfulness;agent 的多步 search/read/final;2025–26 embedding 排行榜。 |
| Bloss0m 工程判斷 | 本篇處理第一階段的 dense 檢索;再讀 Lewis RAG 可了解生成如何條件化於取回的 。規模化詞重疊見 BM25 at scale,證據接地見 FinRank,多模態文件見 RAG-Anything。這些方法的問題設定與證據不能直接互換。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列,不是 2026 的排行榜。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2020 年前的兩條線寫清楚。
稀疏檢索當第一段:開放域 QA 簡化成 retriever → reader 之後,第一段幾乎都是 TF-IDF 或 BM25。優點是倒排索引快、可解釋詞重疊;缺點是同義、改寫、少詞重疊的問句容易漏掉——論文舉 “Who is the bad guy in lord of the rings?” 對 “Sala Baker … portraying the villain Sauron …” 這類幾乎無共享 token 的例子。
可微/預訓練 dense 但仍重:ORQA 用 ICT 預訓練並 joint train;REALM 還要異步更新 passage encoder 並重建索引。論文承認它們證明了 dense 可以贏 BM25,但計算貴,且「一般句子是否適合作為問題的 surrogate」並不清楚;passage encoder 若沒有用問答對微調,表示也可能次優。
因此舊方法不夠的地方不是「沒人想過 dense」,而是控制點被卡住:要嘛第一段鎖在稀疏詞重疊;要嘛 dense 路線綁在昂貴預訓練/joint indexing 上。DPR 改的是:用現成 QA 的 question–passage 對,直接學一對可分解的雙編碼器。
核心直覺 / Core intuition
先不要看表。想像圖書館兩種找法。BM25 像依卡片上的關鍵詞對號入座:詞對得上就高分。DPR 像先把每本書的段落編成座標,再把問題也編成座標,用最近鄰(MIPS)拿回 top-。編碼器是兩個獨立的 BERT,不是把問題與段落塞進同一個 cross-encoder——因為 cross-attention 無法離線預先索引整庫 Wikipedia。
對照三種容易混在一起的下一步:
- BM25/Lucene:下一步是稀疏分數排序;更新世界=改倒排,不必重訓神經網路。
- DPR(本篇):下一步仍是檢索段落,但分數是 ;reader 再抽 span。沒有生成 對 的邊緣化。
- Lewis RAG(note 31):把本篇這類 dense retriever 接到 BART,改的是生成控制點。不要把 RAG 的 NQ 44.5 寫進本篇 Table 4。
用一個例子走完整個方法 / Walk one example through the method
以下用 Appendix C/Table 7 的質性例子走完檢索,不是獨立實驗結果。問題是:What is the body of water between England and Ireland?
- Input:只有這句英語問句。沒有 Bing、沒有 MCP、沒有私有 PDF。語料是預先切好的 Wikipedia 段落(標題+
[SEP]+100-word 塊)。 - Intermediate representation:passage encoder 已離線把約 2,101 萬段落編成 768 維向量並寫入 FAISS HNSW。question encoder 把問句編成 。相似度是點積。
- Model or system decision:MIPS 取出 top-(主實驗檢索看 20/100;reader 訓練從 top-100 抽 24 篇)。BM25 的 top 篇可能是 “British Cycling”——因為 England/Ireland 等高選擇性詞反覆出現,但內容無關。DPR 回 “Irish Sea”——論文解釋為把 “body of water” 對到 sea/channel 這類語義鄰近,即使幾乎無詞重疊。
- Output:抽取式 reader(另一個 BERT)在取回的段落上預測 span 起迄與 passage selection 分數;最終答案是分數最高的 span(例如 Irish Sea 相關字串)。本篇主結果報的是 Exact Match,不是生成句。
- Likely failure point:若關鍵是罕見專名(Table 7 第二例 “Thoros of Myr”),BM25 可能反而更穩,因為 dual-encoder 對高選擇性短語的容量有限。若題目來自 SQuAD 那種「看過段落再出題」、高詞重疊設定,Table 2 上 BM25 的 top-20(68.8%)反而高於 Single DPR(63.2%)。索引若仍是 2018 Wikipedia,2026 的事實不會 magically 出現。
這條 Irish Sea 題教的是機制怎麼走完。要看系統性的 top- 差距,應回到 Table 2;要看 negatives 配方,應看 Table 3;要看端到端 EM,應看 Table 4。
技術機制 / Technical mechanism
系統有兩塊:dense retriever,以及可插拔的 extractive reader。
Retriever 的相似度(Eq. 1)是可分解的點積:
越大,該段落越容易進 top-。必須可分解,才能離線算完所有 ;cross-encoder 再強也不能直接掃 2,000 萬篇。推論時 與 FAISS 索引固定;線上只跑 +MIPS。
訓練把 metric learning 寫成正例的負對數似然(Eq. 2):
提高正例相似度、壓低負例相似度,等於把相關對拉近、無關對推遠。負例來源有三種:Random、BM25(高詞重疊但無答案字串)、Gold(同 batch 其他問題的正例)。In-batch negatives:batch 內 個問題與 個正例段落做 相似度矩陣,一題對其他 篇當負例,等於每 batch 用到 個配對。主實驗還再加 1 個 BM25 hard negative;batch size 128。
Reader(Section 6)用 BERT 對每個取回段落做 span start/end 與 passage selection;訓練時從 retriever 的 top-100 抽 1 正+23 負()。這是抽取式,不是 seq2seq 生成。
操作約束:
- 記憶:2018-12-20 English Wikipedia;DrQA 清理後切成不相交 100-word 塊,共 21,015,324 篇;標題 prepend。
- 索引:FAISS HNSW(CPU;neighbors 512;construction depth 200;search depth 128)。編碼 21M 向量約 8.8 小時/8 GPU;建 FAISS 約 8.5 小時;Lucene 倒排約 30 分鐘。查詢:DPR 995.0 questions/sec(top-100);BM25 23.7/sec/thread。
- 訓練:Adam,,大資料集最多 40 epoch、小資料集 100;dropout 0.1。Multi 設定合併除 SQuAD 外的訓練集。
- Hybrid 消融:BM25+DPR 取兩邊 top-2000 聯集,用 ()重排——這是論文內的線性融合,不是 production hybrid 施工圖。
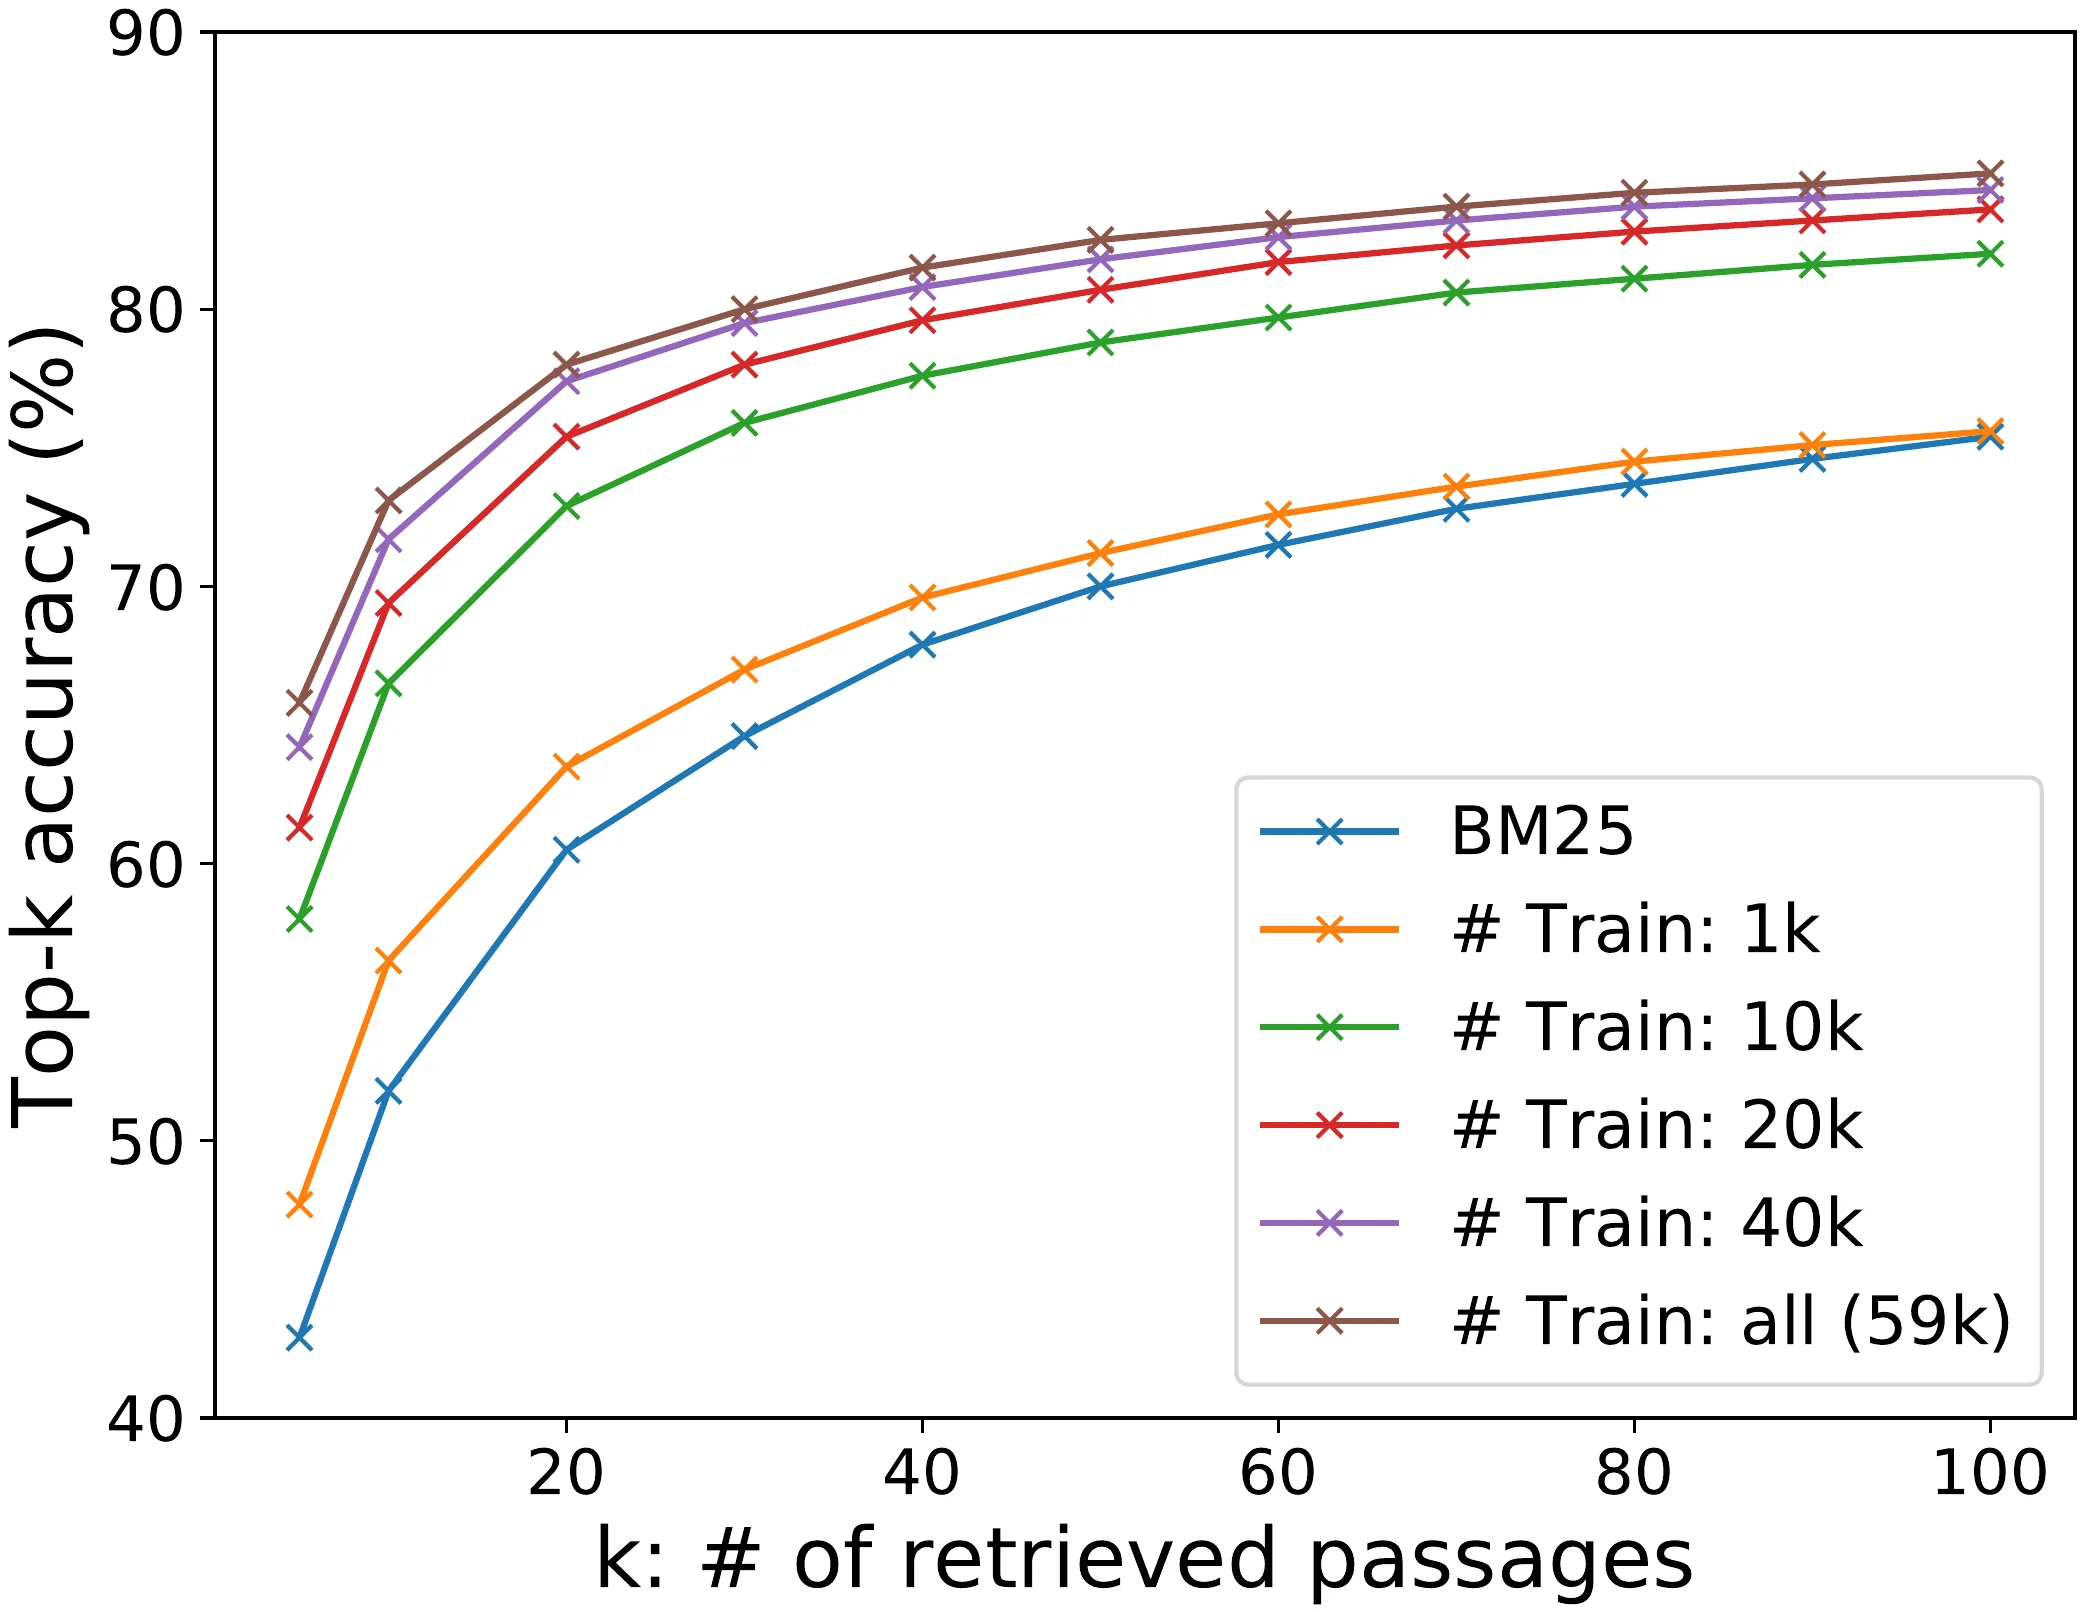
原文 Figure 1,論文 Section 5.1/5.2 Sample efficiency:橫軸為取回篇數 ,縱軸為 top- 準確率;曲線為 1k/10k/…/59k 訓練例的 DPR 與 BM25。原圖可定位到 Figure 1,SVG endpoint 為 ir_training_examples_fig.svg。取自 arXiv v3 HTML/論文源檔 figures;頁面標示 arXiv.org perpetual non-exclusive license,EMNLP 2020 正式版另受 ACL 授權約束。本文依 arXiv reuse terms 做教學引用。

實驗如何讀 / How to read the evidence
檢索準確率與端到端 Exact Match 問的不是同一件事。前者問 top- 裡有沒有答案字串;後者還要 reader 抽對 span。語料始終是同一份 Wikipedia 段落庫。SQuAD 在開放域設定下是「高詞重疊+文章子集偏斜」的壓力測試,不是 DPR 主戰場。
Table 2:要贏的是 top-20/100 檢索,不是生成 EM
這張表問:同一個 Wikipedia 段落庫上,BM25、DPR、以及線性融合,top-20/top-100 命中答案的比例差多少?控制住的是 2018 Wikipedia 切分與既有 train/dev/test;改的是檢索器與是否 multi-dataset 訓練。
| Training | Retriever | NQ@20 | TriviaQA@20 | WQ@20 | TREC@20 | SQuAD@20 |
|---|---|---|---|---|---|---|
| None | BM25 | 59.1 | 66.9 | 55.0 | 70.9 | 68.8 |
| Single | DPR | 78.4 | 79.4 | 73.2 | 79.8 | 63.2 |
| Single | BM25+DPR | 76.6 | 79.8 | 71.0 | 85.2 | 71.5 |
| Multi | DPR | 79.4 | 78.8 | 75.0 | 89.1 | 51.6 |
| Multi | BM25+DPR | 78.0 | 79.9 | 74.7 | 88.5 | 66.2 |
Top-100(同表):NQ 上 BM25 73.7、Single DPR 85.4、Multi DPR 86.0。觀察:除 SQuAD 外,DPR 全面高於 BM25;NQ top-20 的 Single 差距是 78.4−59.1=19.3 個百分點,對上摘要的 “9%–19% absolute”。Multi 對小資料 TREC 幫助大(70.9→89.1@20);TriviaQA Multi 略低於 Single。SQuAD 上 BM25 仍強——作者歸因於「看段落再出題」的高詞重疊,以及僅 500+ 篇文章的偏斜。
這張表支持「dense dual-encoder 可以在開放域 Wikipedia QA 上取代稀疏第一段」;它不支持「dense 處處贏過 BM25」,也不支持把 hybrid 列讀成已上線的 production 堆疊。
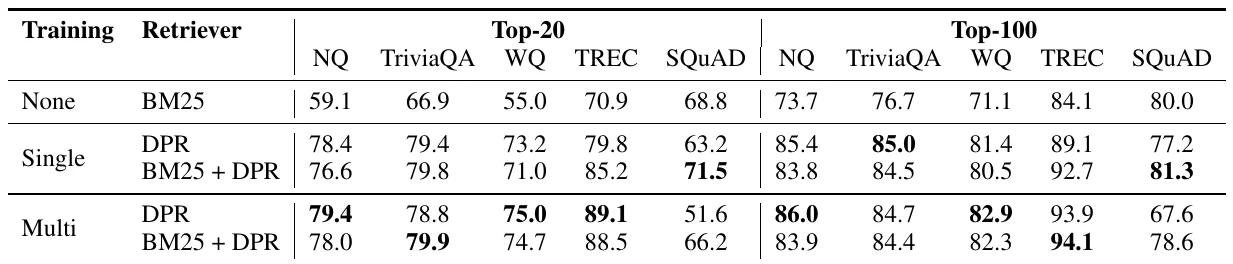
原文 Table 2,論文 Section 5.1 Main Results:Top-20/Top-100 retrieval accuracy(取回段落是否含答案字串)。原表可定位到 arXiv HTML 論文正文;裁切自 v3 PDF 對應頁。授權同 Figure 1(arXiv perpetual non-exclusive;EMNLP 正式版另受 ACL 約束)。
Table 3/Figure 1:in-batch 與 hard negatives 才是配方,不是換相似度
消融問:負例怎麼選?要不要 in-batch?要不要加 BM25 hard negatives?樣本要多少?
Table 3(NQ dev):標準 1-of-N、7 個負例時,Random/BM25/Gold 的 top-20 都在約 63–64%。改成 in-batch Gold 後 top-20 到 69.1(#N=7)、73.0(#N=127)。再加 1 個 BM25 hard negative(G.+BM25(1),127+128)到 78.0 top-20、84.9 top-100。加兩個 BM25 negatives 沒有更好。正文另寫:主實驗用的相似度消融裡,L2 與點積相當,兩者都優於 cosine;triplet loss 相對 NLL 沒有明顯好處(細節在 Appendix Table 6)。
Figure 1:1,000 個訓練例的 DPR 已超過 BM25;從 1k 加到 59k 曲線持續上移。這支持「有預訓練 LM 時,小量問句–段落對就能學出勝過 BM25 的 dense retriever」;它不支持「不需要任何標註對」。
跨資料集:只在 NQ 訓練、不微調就測 WQ/TREC,top-20/100 仍遠高於 BM25,但比專用微調低約 3–5 點(論文正文數字)。
Table 4:端到端 41.5 是抽取式 DPR,不是 RAG 生成
這張表問:更高的檢索準確率是否變成更高的 Exact Match?控制住的是同一 reader 插拔不同 retriever,以及與 ORQA/REALM 等公開數字的對照。
| Training | Model | NQ | TriviaQA | WQ | TREC | SQuAD |
|---|---|---|---|---|---|---|
| Single | ORQA | 33.3 | 45.0 | 36.4 | 30.1 | 20.2 |
| Single | REALMNews | 40.4 | — | 40.7 | 42.9 | — |
| Single | BM25(本篇 reader) | 32.6 | 52.4 | 29.9 | 24.9 | 38.1 |
| Single | DPR | 41.5 | 56.8 | 34.6 | 25.9 | 29.8 |
| Multi | DPR | 41.5 | 56.8 | 42.4 | 49.4 | 24.1 |
| Multi | BM25+DPR | 38.8 | 57.9 | 41.1 | 50.6 | 35.8 |
觀察:NQ 上 DPR 41.5 超過 ORQA 33.3 與 REALMNews 40.4,而且作者強調不必額外預訓練、也不必靠 joint training 取勝——Appendix 的 joint 方案在 NQ dev 只有 39.8,低於隔離訓練的 reader。小資料 WQ/TREC 在 Multi 下跳很大(WQ 34.6→42.4;TREC 25.9→49.4)。SQuAD 上 BM25 reader 仍較高。Hybrid 在 TriviaQA/TREC Multi 取表內最高,但 NQ 上純 DPR 更高——不要把「有時融合更好」讀成「必須上 hybrid 平台」。
Reader 可一次吃 100 篇、單卡 32GB、延遲約 20ms; 對 NQ 最佳, 時 EM 40.8 vs 41.5。
這張表支持「檢索變強通常帶動抽取式開放域 QA」;它不支持生成式 RAG 的 Exact Match,也不要把 Lewis et al. Table 1 的 RAG-Seq 44.5 寫進來——那是另一篇論文、另一種答案契約。
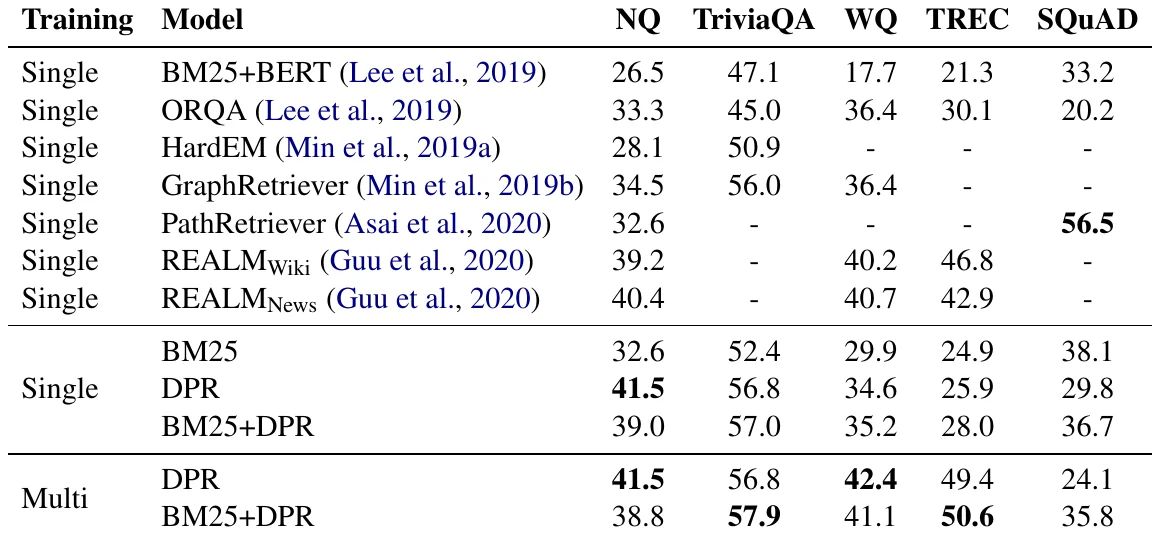
原文 Table 4,論文 Section 6 End-to-end QA Results:Exact Match。原表可定位到 arXiv HTML;裁切自 v3 PDF。授權同 Figure 1。注意:此表是抽取式 QA,不是 RAG-Sequence/Token 生成 EM。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
論文把結論寫成「dense retrieval 可以 outperform 並 potentially replace 傳統稀疏第一段」,同時留下這些邊界:
- Wikipedia 段落當記憶。 2018-12-20 dump、21,015,324 個 100-word 塊。私有語料、權限、多語、表格/列表(預處理已刪)都不在表內。
- 雙編碼器,無 late interaction。 相關工作提到 ColBERT,但本篇證據是點積 dual-encoder。不要把 late interaction 的分數寫回來。
- SQuAD/高詞重疊反例。 Table 2/4 都顯示 BM25 在此設定仍強。Dense 不是萬能取代。
- 答案契約是抽取式。 Span 必須出現在段落裡;不是 citation 產品,也不是 Lewis RAG 的生成邊緣化。
- 不是 agent 迴圈。 沒有 thought、沒有瀏覽器動作、沒有「先讀再答」程序閘。
- 質性失敗模式。 Table 7:DPR 擅語義、弱於極高選擇性專名;BM25 相反。
- 索引成本。 查詢很快(995 qps),但建 dense 索引遠貴於 Lucene(小時級 vs 約 30 分鐘)。
- 分開後續研究的證據。 RAG 的生成 EM、BM25-at-scale、FinRank、RAG-Anything 與 E5/GTE 排行榜都不屬於這張表。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用本篇?當任務是英語開放域/知識庫 QA,你願意維護一份可離線編碼的段落索引,並且接受第一段是 dual-encoder MIPS、答案仍可能走抽取式 span。此時應分開記錄:取回的段落、reader 選中的 span、以及 top- 命中率與端到端 EM。Negatives 配方(in-batch+適量 BM25 hard negatives)比換 fancy 相似度函數更關鍵。
什麼時候不要把這篇論文當成施工圖?
- 生成必須條件化於取回段落、且答案可以是抽象句時,讀 Lewis RAG。它進一步改變的是生成方式。
- 語料大到詞重疊開始划算、或 entity 題主導時,讀 BM25 at scale。本表 SQuAD/質性例子已提示稀疏仍有領地。
- 需要把答案綁回可審計證據時,讀 FinRank。
- 文件是掃描件、表格、公式,需要可回指原件時,讀 RAG-Anything。本篇假設純文字塊。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v3 PDF、HTML 可讀,license 為 arXiv.org perpetual non-exclusive。ACL Anthology 2020.emnlp-main.550 可開啟。
- 程式(usable):facebookresearch/DPR 回 HTTP 200。論文脚註指向此 repo。
- 模型卡(usable):facebook/dpr-question_encoder-single-nq-base、facebook/dpr-ctx_encoder-single-nq-base 回 200。
- 索引/資料(usable):facebook/wiki_dpr 可開啟。這是相關公開工件;完整復現 Table 2/4 仍依賴論文當日的切分與訓練設定。
- 訓練環境(論文宣告):retriever/reader 實驗在八張 32GB GPU;FAISS 查詢可在 CPU HNSW。編碼 21M 段落約 8.8 小時/8 GPU;建索引約 8.5 小時。主實驗不是「下載一個 notebook 就能復現 Table 4 的 41.5」。
最小有用 reproduction 是:用公開的 DPR question/ctx encoder 對一小撮 Natural Questions 題做 top- 檢索,確認取回的是 Wikipedia 段落、且分數來自雙編碼器點積。不要宣稱這能復現 Table 2 的 78.4 或 Table 4 的 41.5。
三個記憶點 / Three things to remember
- 技術想法:DPR 用兩個 BERT 雙編碼器與點積 MIPS,把開放域 QA 的第一段從 BM25 换成可學習 dense 段落檢索;訓練關鍵是 in-batch negatives+BM25 hard negatives。
- 證據:NQ top-20 檢索 78.4% vs BM25 59.1%;端到端 Exact Match 41.5,高於 ORQA/REALMNews。1,000 例已勝過 BM25;SQuAD 高詞重疊上 BM25 仍可贏。
- 邊界:這是 2020 年的 Wikipedia dense retriever+抽取式 reader,不是 Production RAG 平台、生成式 RAG 或 agent 迴圈。生成如何接上檢索可續讀 Lewis RAG;其他後續方法的數字應分開閱讀。
延伸閱讀
DPR 處理的是「第一階段檢索要不要改成 dense dual-encoder」。接下來可依問題選讀:
- 生成如何條件化於取回段落:Lewis RAG。
- 規模化詞重疊:BM25 at scale。
- 證據接地:FinRank。
- 多模態原件:RAG-Anything。
閱讀方法見 三遍掃描法。