讀法可搭配 三遍掃描法。本篇接在 Lewis RAG 之後:Lewis RAG 問的是「生成是否以取回的 為條件」,Self-RAG 則問「是否需要檢索、何時檢索,以及如何批判自己的生成」。
若要對照程序式的先讀再答,可看 Before Reasoning Can Fail;整體方法關係見 RAG 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:標準 RAG 不問需不需要,一律取回固定篇數;無關段落會拖累生成,也傷害指令遵循的通用性。取回之後,模型也不保證會跟著段落走。
- 核心洞見:訓練一個任意 LM,讓它在生成過程中穿插 reflection tokens:
Retrieve決定要不要檢索;ISREL/ISSUP/ISUSE分別批判相關性、支持度與效用。檢索變成決策,而不是管線預設階段。 - 最強證據:Table 2 六任務總表——Self-RAG 7B/13B 在 PopQA 54.9/55.8、TriviaQA 66.4/69.3、PubHealth 72.4/74.5、ARC 67.3/73.1;biography FactScore 81.2/80.2;ASQA citation precision/recall 66.9/67.8 與 70.3/71.3。Table 3a:相對 Self-RAG(50k)45.5,No Critic 的 PopQA 42.6、ASQA em 18.1;Retrieve top1 的 PopQA 41.8。
- 主要邊界:critic 先靠 GPT-4 銀標再蒸餾;reflection tokens 仍可能錯;索引與評測是 Wikipedia/公開 QA,不是企業 ACL 與 citation 產品;也不是帶工具的 agent 迴圈。
我的結論是:Self-RAG 最值得保留的貢獻,是把檢索變成可學習的決策,並用批判 token 篩選生成結果。它不是 Production RAG 的完整閘門;銀標 critic 也不是黃金標註,後續 agentic RAG 排行榜的數字更不能混入本篇結果。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Asai et al., ICLR 2024 對應的 arXiv:2310.11511 v1;該版本於 2023-10-17 首發,截至 2026-08-27 仍是 arXiv 唯一版本。arXiv HTML 標示 CC BY 4.0,源碼包使用 iclr2024_conference 樣板。
作者官方倉庫 AkariAsai/self-rag 的引用資訊寫明 ICLR 2024 Oral,OpenReview forum id 為 hSyW5go0v8;PDF 頁眉則仍標示 Preprint。本文因此以 v1 PDF/HTML 的表格與數字為準。作者順序依 v1 PDF:Akari Asai、Zeqiu Wu、Yizhong Wang、Avirup Sil、Hannaneh Hajishirzi(UW/AI2/IBM)。
除摘要外,本文核對 Section 3 的問題形式與訓練/推論、Table 1–3、Figure 1–4、Appendix 中的 critic 準確率與訓練資料規模,以及截至 2026-08-27 的工件。
方法對照只連站上已有的 Lewis RAG、DPR 與 Before Reasoning Can Fail 筆記。RAG-Anything、DocMemo、FinRank、2025–26 agentic RAG 排行榜與 Deep Research 產品數字不納入本篇結果。
這是已發表的 ICLR 論文;本文證據核對固定在 arXiv v1 快照。
讀者真正要回答的問題
當系統已經會「取回段落再生成」時,工程上是該繼續對每題一律 top-,還是讓模型自己決定何時檢索,並在生成後批判相關性、支持度與效用?Asai et al. 的回答是:把這些決策寫進 vocabulary 的特殊 token,端到端訓練同一個 LM。
比較精確的讀法不是「Self-RAG 是不是現在的企業 citation 產品」。真正的問題是:把檢索從預設管線改成可學習決策之後,在哪些任務上真的移動分數,又在哪裡因為銀標 critic、固定 Wikipedia 記憶、或 reflection tokens 本身會錯而出界?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1 對照 always-retrieve RAG 與 on-demand Self-RAG;Table 1 定義四類 reflection tokens;Algorithm 1 與 Section 3.3 描述推論;Table 2 給六任務結果;Table 3a/Figure 3 給訓練與推論消融、權重客製、檢索頻率;Figure 4 給資料規模與 50 例人工評估;Appendix 給 critic 對 GPT-4 的吻合率與約 145k 訓練例。 |
| 作者主張 | 按需檢索+自我反思能同時提升短答 QA、事實驗證、推理與長文 citation;reflection tokens 讓推論期可調控;不必靠更大參數或閉源系統也能超過多個檢索增強基線。 |
| 論文未證明 | 私有語料與 ACL;production hybrid/reranker 堆疊;reflection tokens 等於黃金標註;帶工具的 agent 迴圈;把 Read-Gate 程序失敗率換成 Self-RAG 分數;2025–26 agentic RAG 或 DocMemo 數字。 |
| Bloss0m 工程判斷 | 把本篇放在 Retrieval 方法主線的「何時檢索」位置。固定檢索的基礎方法見 Lewis RAG,程序式先讀再答見 Before Reasoning Can Fail,dense retriever 見 DPR。三者回答的問題不同,數字不能直接混用。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2023 年前的兩條線寫清楚。
Always-retrieve RAG(如 Lewis et al. 2020):輸入一律接上固定篇數的取回段落。優點是參數記憶不足時可由外部知識補充;缺點是「要不要檢索」從未成為決策。不需要事實依據的題目也可能被無關段落拖累;作者引用 Shi et al. 說明低品質段落會傷害生成。
取回但不保證跟隨:即使段落相關,生成也不保證與引用一致(作者引 Gao et al.)。模型沒有被明確訓練去批判「這段夠不夠支持我剛寫的句子」。
因此舊方法不夠的地方不是「沒人想過檢索」,而是控制點停在 always-on:檢索是管線預設階段,批判是外部評測或事後 prompt,不是模型自己學出的 token 決策。Self-RAG 改的正是這一步:Retrieve/Critique 進入同一個 next-token 目標。
核心直覺 / Core intuition
先不要看表。想像兩種開卷方式。Lewis RAG 像每題都先把五本參考書堆上桌,再寫答案——即使這題其實閉卷也會。Self-RAG 像先問自己「這句需要查嗎?」;若需要,才取回段落,並對「相關嗎/支持嗎/有用嗎」打記號,再挑一條延續。
對照三種容易混在一起的下一步:
- Lewis RAG(note 31):下一步幾乎總是「取回 ,再條件化生成 」。沒有學出的 when-to-retrieve token。
- Self-RAG(本篇):下一步先解碼
Retrieve;Yes 才呼叫 retriever,再對每篇候選生成並解碼ISREL/ISSUP/ISUSE,用批判分數挑段。 - Read-Gate/Before Reasoning Can Fail(note 15):改的是 search 之後、final 之前有沒有讀證據的程序閘,不是訓練 reflection tokens。
用一個例子走完整個方法 / Walk one example through the method
以下用論文 Appendix 的 PopQA 教學例走完機制(作者書寫的示範軌跡),不是獨立實驗結果。輸入是 Who is the author of The Lie?。
- Input:短答事實題。沒有 MCP、沒有私有 PDF、沒有 agent 的 browser tool。系統用的是訓練過 reflection tokens 的 Llama2 系 generator,外加離線 Contriever 檢索。
- Intermediate representation:模型先解碼
Retrieve=Yes,retriever 取回段落;其中一篇提到 Sam Harris 的 Lying。段落被包在<p>…</p>這類標記裡(訓練時這些 chunk 的 loss 被 mask)。 - Model or system decision:對該段落解碼
ISREL=Relevant,寫出答案句「The author of The Lie is Sam Harris.」,再解碼ISSUP=Fully Supported與ISUSE=5。若多篇候選並行,會依相關性、支持度、效用的加權分數挑段(Section 3.3)。 - Output:短答案字串,外加可見的 reflection tokens(推論期可用 soft weight 或 hard constraint 調行為)。
- Likely failure point:同一附錄也給「看起來合理但沒被支持」的反例——取回的書名相近、作者卻是另一本。此時
ISREL/ISSUP若跟著錯,批判閘就失效。人工評估(Figure 4d,各 50 例)顯示 PopQA 上 S&P 92.5、ISREL 95.0、ISSUP 90.0,但 Bio 上 S&P 只有 70.0——長文更容易在「看似相關」處失手。
這條 PopQA 題教的是機制怎麼走完。要看六任務分數,應回到 Table 2;要看「批判與按需檢索是不是多餘」,應看 Table 3a。
技術機制 / Technical mechanism
系統有三塊:retriever 、critic 、generator (推論時通常是同一個經過擴詞的 LM 兼任生成與批判)。
Reflection tokens(Table 1)
| 類型 | 輸入 | 輸出值 | 作用 |
|---|---|---|---|
| Retrieve | 或 | yes/no/continue | 要不要呼叫檢索,或繼續用既有證據 |
| ISREL | relevant/irrelevant | 段落是否對解題有用 | |
| ISSUP | fully/partially/no support | 生成是否被段落支持 | |
| ISUSE | 5…1 | 回應整體效用 |
粗體值是作者標成較理想的批判結果。
訓練兩段式(Section 3.2)
- Critic learning:對各類 reflection,用 GPT-4 few-shot 產銀標(作者抽樣人工核對:relevance/retrieval 各約 95%,support 約 90%,usefulness 約 80%),再把 Llama2-7B 初始化的 訓成預測這些 token。Appendix 表:Llama2-7B critic 對 GPT-4 的吻合率 Retrieve 93.8、ISSUP 93.5、ISREL 80.2、ISUSE 73.5。
- Generator learning:用 與 把原始 擴成穿插段落與 reflection tokens 的監督序列(約 145,619 例;正文常寫 150k),再對 做標準 next-token 訓練,loss 避開 retrieved chunk 本文,詞表擴充 reflection tokens。
這與 PPO/RLHF 不同:批判離線算完,直接寫進語料,訓練仍是 LM loss,而不是線上 reward model+PPO。
推論(Algorithm 1/Section 3.3)
對每個 segment:先預測 Retrieve。若 No,直接生成並評 ISUSE。若 Yes,取回多篇 ,並行生成候選,評 ISREL/ISSUP/ISUSE,再以加權批判分數做 segment-level beam(實驗預設 beam 2)。也可用 Retrieve=Yes 機率相對門檻 做自適應檢索: 越大,檢索越少(Figure 3c)。
操作約束(論文實驗設定):
- Retriever:預設 Contriever-MS MARCO;多數任務 top-5,可到 top-10。PopQA/biography 另加 web search top-5;ASQA 各基線統一用作者提供的 GTR-XXL top-5。
- 記憶:官方 Wikipedia embeddings(2018 English Wikipedia);PopQA 因實體較新改用 2020-12 dump(Appendix)。
- 門檻:多數任務 retrieval threshold 0.2;ALCE/ASQA 因 citation 需求設 0。
- 基座:Self-RAG 7B/13B 基於 Llama2。
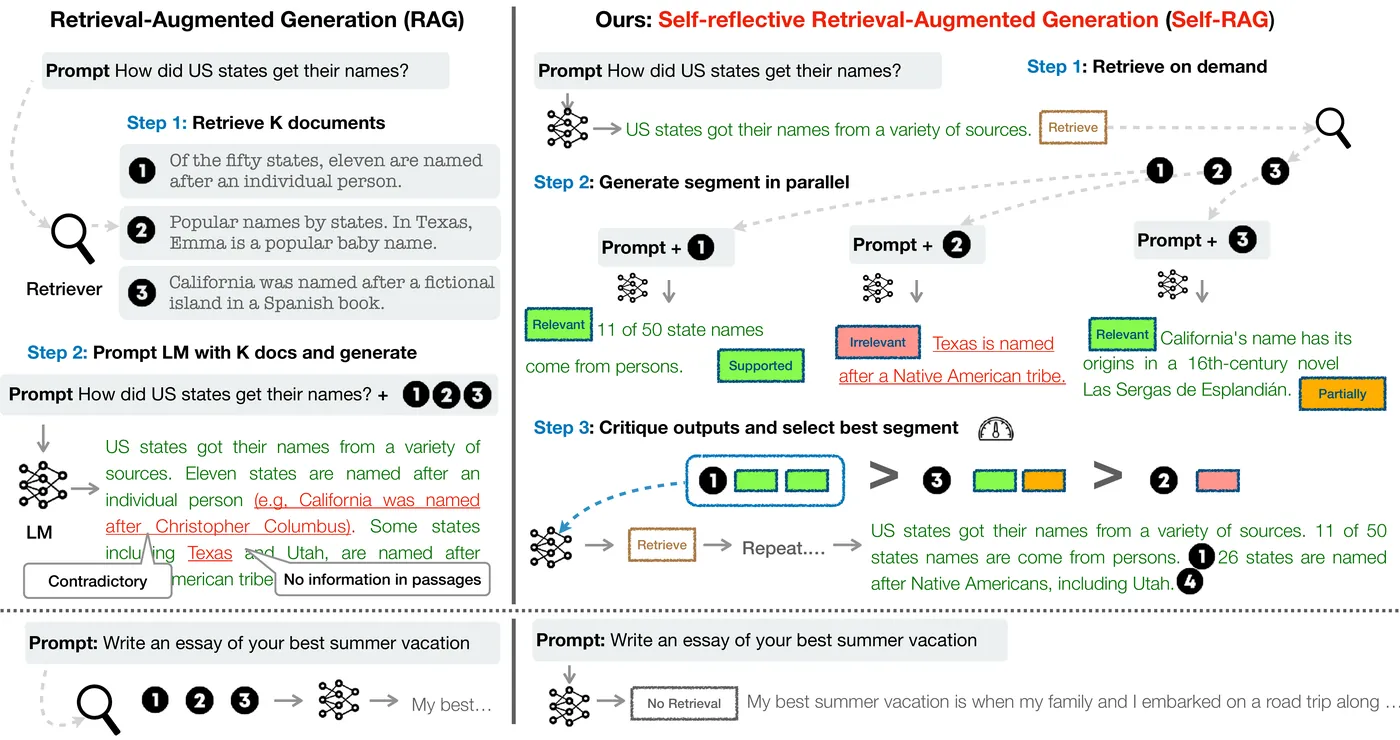
Figure 1,論文 Introduction:左為固定取回 篇再生成的 RAG;右為 Self-RAG 的三步——判斷是否檢索、對多篇候選生成、用批判 token 挑段。原圖可定位到 Figure 1,SVG endpoint 為 teaser_self_rag_v8.svg。取自 arXiv v1 HTML/源碼圖檔;頁面標示 CC BY 4.0。本文依授權做教學引用。

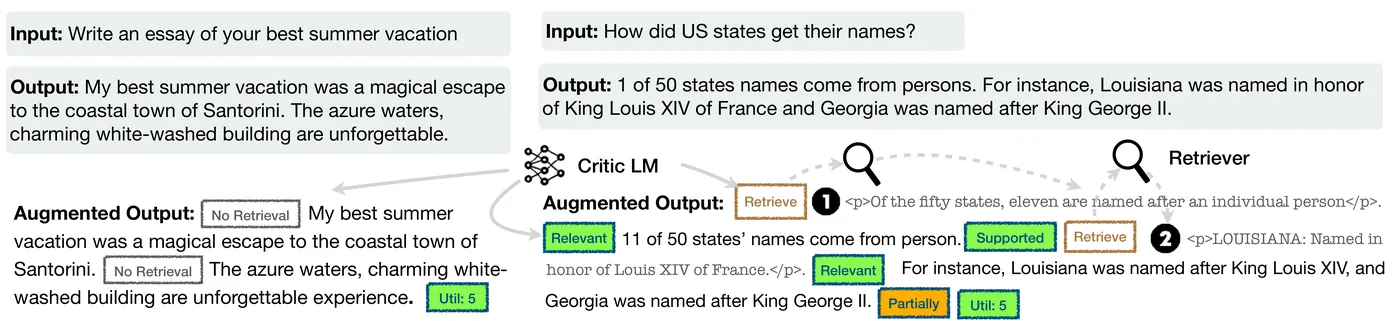
Figure 2,論文 Section 3.2:generator 訓練樣本。左:Retrieve=No 後直接生成並評效用;右:Retrieve=Yes 後插入 <p> 段落並交織 ISREL/ISSUP。原圖可定位到 Figure 2,SVG endpoint 為 training_examples.svg。授權同 Figure 1。

實驗如何讀 / How to read the evidence
短答 QA、封閉選擇、長文 citation 問的不是同一件事。PopQA/TriviaQA 看答案是否被包含;PubHealth/ARC 看分類/選擇準確率;Bio 看 FactScore;ASQA 同時看正確性、流暢度與 citation precision/recall。不要把 ASQA 的 citation precision 讀成 PopQA 的 acc。
Table 2:標題分數是六任務總表,不是單一排行榜
這張表問:在同一套公開任務上,Self-RAG 相對無檢索 LM、test-time RAG、以及部分私有資料系統,差多少?控制住的是公開評測設定與作者描述的 retriever;改的是要不要訓練 reflection tokens,以及推論期如何按需檢索與批判。
精選列(完整表見論文 Table 2):
| 模型 | PopQA | TQA | Pub | ARC | Bio FS | ASQA pre/rec |
|---|---|---|---|---|---|---|
| ChatGPT | 29.3 | 74.3 | 70.1 | 75.3 | 71.8 | —/— |
| Ret-ChatGPT | 50.8 | 65.7 | 54.7 | 75.3 | — | 65.1/76.6 |
| Ret-Llama2-chat 13B | 51.8 | 59.8 | 52.1 | 37.9 | 79.9 | 19.8/36.1 |
| Alpaca 13B + retrieval | 46.1 | 66.9 | 51.1 | 57.6 | 77.7 | 2.0/3.8 |
| Llama2-FT 7B + retrieval | 48.7 | 57.3 | 64.3 | 65.8 | 78.2 | 5.0/7.5 |
| Self-RAG 7B | 54.9 | 66.4 | 72.4 | 67.3 | 81.2 | 66.9/67.8 |
| Self-RAG 13B | 55.8 | 69.3 | 74.5 | 73.1 | 80.2 | 70.3/71.3 |
觀察:在開放域/事實驗證軸上,Self-RAG 7B 已超過 ChatGPT 的 PopQA 29.3 與 PubHealth 70.1;13B 在 ARC 73.1 仍低於 ChatGPT/Ret-ChatGPT 的 75.3。TriviaQA 上 ChatGPT 74.3 仍最高。ASQA 上 Self-RAG 的 citation precision 接近或超過 Ret-ChatGPT 65.1,但 recall 低於 Ret-ChatGPT 76.6;str-em/rouge 仍低於 Ret-ChatGPT。作者也寫:在事實精度指標上,7B 有時勝過 13B,因為較小模型傾向產出更短、更貼引用的文字。
這張表支持「按需檢索+反思在多個公開任務上勝過同尺寸 always-retrieve 指令微調」;它不支持「全面超過所有閉源系統」或「已是 citation 產品」。
Table 3a/Figure 3:批判與按需,不是裝飾
消融在 50k 訓練規模上跑(不是最終 150k),問:拿掉 retriever/critic、或推論改成 always top-1,會怎樣?
| 設定 | PopQA | PubHealth | ASQA em |
|---|---|---|---|
| Self-RAG(50k) | 45.5 | 73.5 | 32.1 |
| No Retriever | 43.6 | 67.8 | 31.0 |
| No Critic | 42.6 | 72.0 | 18.1 |
| No retrieval(test) | 24.7 | 73.0 | — |
| Hard constraints | 28.3 | 72.6 | — |
| Retrieve top1 | 41.8 | 73.1 | 28.6 |
| Remove ISSUP | 44.1 | 73.2 | 30.6 |
No Critic 讓 ASQA em 從 32.1 掉到 18.1;Retrieve top1 讓 PopQA 從 45.5 掉到 41.8。這支持「批判與多候選篩選有貢獻」;它不支持把 50k 消融列直接等同最終 7B/13B 的 Table 2。
Figure 3b:提高 ISSUP 權重抬升 ASQA citation precision,但壓低 MAUVE——更貼證據的生成往往更短、更不「流暢」。Figure 3c:調高 大幅降低檢索頻率;PubHealth 掉分較小,PopQA 掉分較大——長尾實體題更依賴檢索。
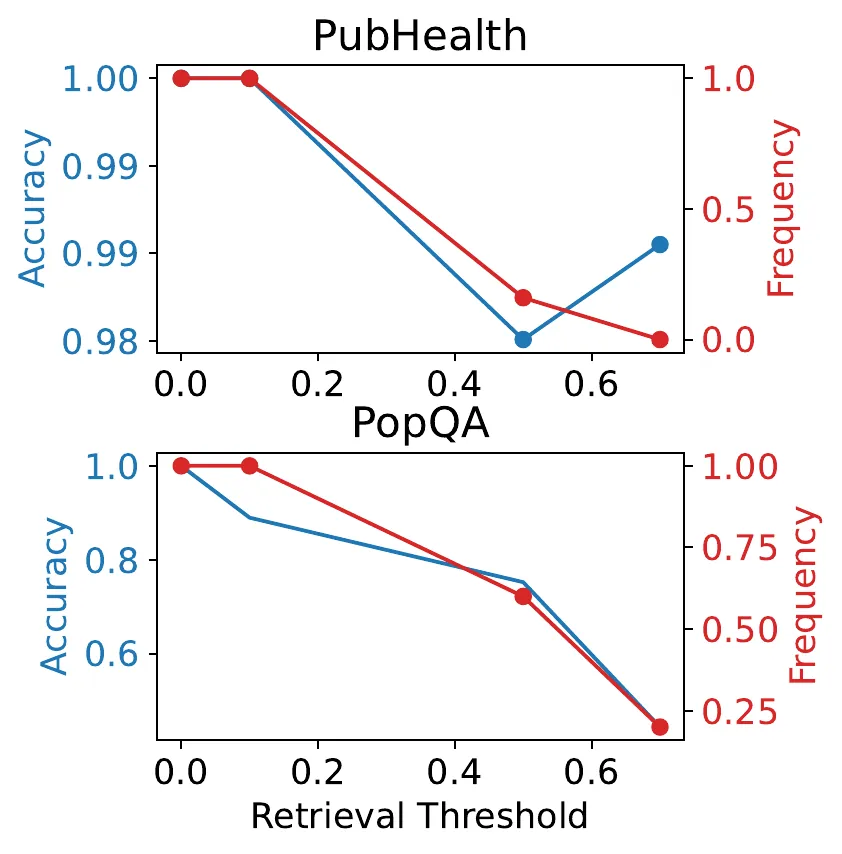
Figure 3c,論文 Section 5.2:自適應檢索門檻 對檢索頻率與準確率的影響。原圖可定位到 Figure 3,SVG endpoint 為 tradeoff_fever.svg。授權同 Figure 1。若裁切只見單面板,完整三欄(消融表/客製化/檢索)以 HTML Figure 3 為準。

Figure 4:資料規模有用,人工評估樣本很小
5k→150k 時 PopQA 與 ASQA citation precision 上升軌跡較明顯;PubHealth 變化較平。Llama2-FT 從 50k 增到 150k 沒有同等幅度——作者用此主張增益不只來自「多看一點指令資料」。人工評估各 50 例:短答 PopQA 的 S&P/token 吻合較高,Bio 的 S&P 70.0 提醒長文仍易「看起來對」。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
論文 Ethical Concerns 寫明:即使有自我反思與細粒度 attribution,輸出仍可能不被引用完全支持。讀表時還要留下這些邊界:
- 銀標 critic。 GPT-4 標籤不是黃金標註;usefulness 類別人工也不穩(1↔2、4↔5)。把 reflection tokens 當 production 閘門,等於把蒸餾誤差寫進控制面。
- 不是 Production RAG 平台。 沒有 ACL、私有語料治理、hybrid 堆疊或 citation SLA。ASQA 的 precision/recall 是評測指標,不是產品保證。
- 不是 agent 工具迴圈。 沒有 browser action、沒有 MCP、沒有多步 tool policy。Toolformer 與 Agent 方法主線處理的是另一類問題。
- 不是 Read-Gate。 Before Reasoning Can Fail 量的是 search 後有沒有 read 的程序失敗;Self-RAG 量的是學出的 when-to-retrieve/critique。不要互換數字。
- 消融規模較小。 Table 3a 用 50k;ASQA 消融還只在 150 例子集。主表是 7B/13B 全資料結果。
- 評測記憶是 Wikipedia 公開設定。 PopQA 還換了 2020 dump;私有知識庫外推未證明。
- 不要混入後續研究的數字。 DocMemo、RAG-Anything、FinRank、2025–26 agentic RAG 排行榜與 Deep Research 產品,都不屬於這張表。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用本篇?當任務在知識密集 QA/長文生成之間切換,你願意維護一份可查的非參數索引,並且接受「是否檢索」由模型 token 決定、批判分數可在推論期調權重。此時應分開記錄:Retrieve 決策、取回的 、生成的 、以及 ISREL/ISSUP/ISUSE——token 說 fully supported,不代表稽核系統已通過。
什麼時候不要把這篇論文當成施工圖?
- 你要理解 2020 年固定檢索的基礎設計時,讀 Lewis RAG。
- 你要的是 dense 雙編碼器第一段時,讀 DPR。
- 失敗模式是「搜了但沒讀就答」的程序問題時,讀 Before Reasoning Can Fail。那是 runtime invariant,不是 reflection token 訓練配方。
- 需要多模態原件、工具 schema 路由、圖譜或多跳動態證據時,應閱讀對應的後續研究;不要把那些分數混入 Self-RAG。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v1 PDF、HTML 可讀;license 為 CC BY 4.0。OpenReview forum 可開啟(本環境曾遇挑戰頁,以 GitHub citation 與 forum id 交叉確認 ICLR 2024)。
- 專案頁:selfrag.github.io 回 200。
- 程式:AkariAsai/self-rag 回 200,license MIT。
- 模型卡(usable):selfrag/selfrag_llama2_7b、selfrag/selfrag_llama2_13b 回 200。
- 訓練環境(論文宣告):Stability AI 算力訓練與評測;OpenAI API 用於 GPT-4 銀標;主實驗不是「下載一個 notebook 就能復現 Table 2」。
最小有用 reproduction 是:載入公開的 selfrag_llama2_7b,對一小撮 PopQA 長尾題跑推論,確認輸出中出現 Retrieve/critique tokens,且僅在 Retrieve=Yes 時看到檢索段落。不要宣稱這能復現 Table 2 的 54.9。
三個記憶點 / Three things to remember
- 技術想法:Self-RAG 把 when-to-retrieve 與 self-critique 寫進 reflection tokens,讓同一個 LM 學習檢索、生成與批判;檢索成為決策,而不是 always-on 管線階段。
- 證據:Table 2 上 7B/13B 在 PopQA、PubHealth 等任務超過多個 retrieval-augmented 基線,ASQA citation precision 達 66.9/70.3;Table 3a 顯示 No Critic 與 Retrieve top1 會掉分。
- 邊界:銀標 critic、公開 Wikipedia 設定、非 agent 工具迴圈。不要把它讀成 Production RAG 閘門,也不要混入後續研究的數字。
延伸閱讀
Self-RAG 處理的是「要不要/何時檢索,以及如何批判生成」。若要理解固定檢索,讀 Lewis RAG;若要理解 dense retriever,讀 DPR;若關心程序式的先讀再答,讀 Before Reasoning Can Fail。整體關係見 RAG 方法底座閱讀地圖,閱讀方法則見 三遍掃描法。