論文精讀
xMemory 論文精讀:Agent 記憶的解耦與聚合檢索
原文:Beyond RAG for Agent Memory: Retrieval by Decoupling and Aggregation
90 秒掌握論文
- 問題:現有自主 Agent 系統常將長期記憶簡化為標準 RAG 流程,但真實互動日誌是有界、高相關、存在大量近似重複且具備時間連續性的對話流;直接採用固定 Top- 向量檢索會導致證據崩塌至單一密集語意區塊(redundant collapse),而事後剪裁(post-hoc pruning)又極易切斷前後依賴的時序證據鏈。
- 核心洞見:xMemory 主張「先解耦後聚合」(decoupling before aggregation),將原始互動流拆解並組織為 Message、Episode、Semantic 與 Theme 四層階層結構;引入 Sparsity–Semantics 目標動態引導節點的分裂與合併,並在推理時執行自適應的 Top-down 兩階段檢索,僅在能顯著降低預測不確定性時才向下展開細節。
- 最強證據:在長對話基準測試 LoCoMo(平均約 9,000 tokens、300 turns)上,xMemory 在三個骨幹模型(Qwen3-8B、Llama-3.1-8B-Instruct、GPT-5 nano)上平均 F1 與 BLEU 均顯著超越 Naive RAG、A-Mem、MemoryOS、LightMem 與 Nemori 等基準;其中在時序推理(Temporal QA)中 F1 提升達 3.72 至 11.23 分,且每次查詢消耗的 Context tokens 降低約 39% 至 48%(Table 1)。
- 主要邊界:階層結構品質高度取決於初始對話切分與語意嵌入品質;實驗評測集中於學術多輪對話 QA,尚未涵蓋即時線上高併發寫入、資料刪除義務(right-to-be-forgotten)、長程語意漂移或真實工具調用工作區狀態。基準測試分數不代表已解決生產環境的記憶治理與併發衝突。
本文依據 arXiv:2602.02007 預印本(Hu 等人,倫敦國王學院與艾倫·圖靈研究所)。
理解前需要知道什麼
要理解 xMemory 的核心突破,必須先釐清傳統 RAG 架構在面對自主 Agent 長期記憶時產生的根本假設錯位,以及既有方法與過去作法的瓶頸:
- 傳統 RAG 的語料假設 vs. Agent 記憶的真實型態:標準 RAG(檢索增強生成)的理論基石建立在「大型、異質、主題多樣且文檔相對獨立」的知識庫上。然而,自主 Agent 面對的記憶源是「有界、連續、單一對話者或任務參與者高度聚焦」的時間序列流。
- 語意冗餘崩塌(Redundant Collapse):在 Agent 長期對話中,相鄰或相似的回合往往重複討論相同主題的微調變體。當系統以純向量相似度查詢 Top- chunks 時,檢索結果極易被同一個密集語意空間中的微小變體填滿,耗盡 context budget 卻沒有帶入任何互補性新資訊。
- 時序依賴與證據鏈斷裂(Temporal Entanglement):對話中的關鍵事實往往依賴於時間線上的代名詞共指(coreference)、省略(ellipsis)與前置決策。例如「使用者在第三週修改了第一週建立的部署密鑰」,若檢索僅依據相似度撈出第一週的原始密鑰,而遺漏了後續的撤銷訊息,Agent 就會做出致命的錯誤決策。
- 現有壓縮剪裁的脆性(Brittle Pruning):既有記憶壓縮方法(如結合 LLMLingua-2 的 LightMem)嘗試事後過濾 chunk 內的 token。但這類演算法基於獨立文檔假設,在高度依存的對話流中,隨意刪減字詞極易直接破壞因果與時序依賴鏈條。
| 比較維度 | 標準 RAG 架構 | Agent 長期記憶情境 |
|---|---|---|
| 語料特性 | 大規模、跨領域異質語料 | 單一實體或對話流,具備強連續性 |
| 候選文本片段 | 主題多樣,相互獨立 | 高度相關、近似重複、包含版本演進 |
| 主要失敗模式 | 檢索出不相關內容(Irrelevance) | 語意冗餘崩塌(Redundant collapse) |
| 證據結構 | 段落間多為無序並列 | 時序因果糾纏(Temporal entanglement) |
| 檢索單元 | 固定大小文字塊(Raw chunks) | 多尺度語意組件(Latent components) |
因此,Agent 記憶的檢索核心問題,不是如何訓練更強的重排序模型(reranker),而是從根本上改變記憶在寫入時的組織維度與檢索時的搜索尺度。
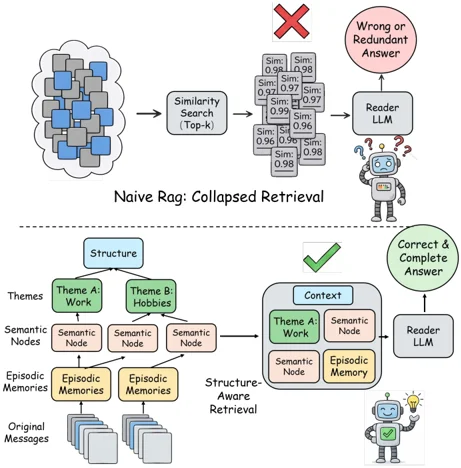
Figure 1,論文 Section 1 的動機與機制對比:Agent 記憶具有高度時序相關性與局部聚集性,傳統純相似度 Top-k 檢索導致語意冗餘崩塌,而結構化拓撲導航能在多尺度語意組件中提取互補資訊。原始 Figure 1 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

核心直覺
xMemory 的核心直覺是:記憶檢索不應只是文本切片的字面比對,而是多尺度語意組件(latent components)的拓撲導航。
在傳統的決策規則中,系統對記憶庫的所有原始片段進行全域相似度排序,導致「相關但不具資訊增益」的片段集體勝出。xMemory 將決策規則重構為:先解耦(Decoupling),後聚合(Aggregation)。
具體而言,系統將平鋪直敘的原始對話流分解為多個最小可變動單元,再依據語意相似性與稀疏分佈目標,自底向上建立四層層級架構:
- Message(訊息層):不可分割的單回合原始對話;
- Episode(情節層):按時間滑動窗口或自然會話邊界匯總的連續對話塊摘要;
- Semantic(語意事實層):從 Episode 中提取的長期重用事實,作為跨時間檢索的核心索引單位;
- Theme(主題層):將語意相近的 Semantic 節點聚合成宏觀主題群。
在檢索階段,系統不再一次性拉取海量原始文字,而是由頂向下(Top-down)按需探索:查詢首先在 Theme 層定位主題,再在 Semantic 層選出互補的事實代表,最後僅對能顯著降低下游模型預測不確定性的節點展開對應的完整 Episode 或原始 Message。每一層向下延伸都伴隨著精確計算的 context token 消耗,從結構上根除冗餘崩塌。
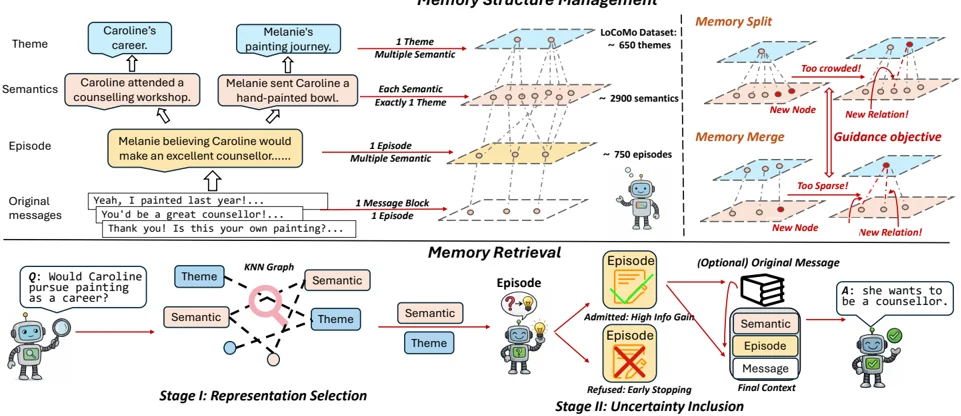
Figure 2,論文 Section 2 的 methodology overview:圖中把四層 hierarchy、sparsity–semantics objective 與 top-down retrieval 放在同一個方法脈絡中。見 原始 Figure 2 anchor 與 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留 attribution,依 arXiv reuse terms 使用。

用一個例子走完整個方法
為了具體展示 xMemory 的端到端處理流程,以一個長程工程維運與部署權限查詢為例:
- 輸入(Input):
- 歷史記憶庫 :包含過去兩個月累積的 35 次多輪會話記錄(累計數萬 tokens),涵蓋資料庫升級、服務架構、日常討論以及安全規範變更。
- 當前查詢 :「上週會議中決定的 production 資料庫部署例外條款,目前是否仍然有效?」
- 中間表徵(Intermediate representation):
- 記憶已被解耦並聚合成四層結構:在 LoCoMo 等級規模下,約包含 650 個 Theme 節點、2,900 個 Semantic 節點與 750 個 Episode 區塊。
- Theme 與 Semantic 節點間維護著 NN 鄰近圖拓撲連接。
- 「資料庫部署規範」為一個獨立 Theme 節點,其下掛載了「初期部署許可」、「連線逾時調整」、「安全團隊提出的臨時例外撤銷」等多個 Semantic 節點,各節點各自雙向鏈結到底層完整的 Episode 區塊。
- 決策與轉換(Decision or transformation):
- Stage I:代表節點貪婪選擇: 查詢 首先在 Theme 層級進行圖導航。演算法透過式 (4) 權衡覆蓋度(coverage)與查詢關聯性(relevance),迅速鎖定 Theme 節點「資料庫部署規範」,排除「前端樣式調整」等無關主題。 接著在該 Theme 誘發的子圖中,演算法貪婪選取代表性 Semantic 節點。它不僅檢索出「臨時部署例外條款」節點,由於演算法獎勵跨子群覆蓋度,同時選中了在語意上相似度略低、但時序上具備更新關係的「安全覆核撤銷通知」節點。
- Stage II:不確定性自適應展開: 針對選中的 Semantic 節點,系統調取其背後的關聯 Episode 摘要區塊。此時系統不進行暴力拼接,而是計算引入該 Episode 是否能實質降低讀者模型(reader model)的預測熵(entropy)。 首先納入「安全覆核撤銷通知」的 Episode,模型對「是否有效」的不確定性大幅驟降;此時演算法判定後續若再載入更多歷史微小討論已無法產生顯著的資訊增益,觸發 early stopping,停止繼續載入無關的 raw messages。
- 輸出(Output):
- 組裝出極度緊湊且因果鏈條完整的 Context (僅耗費數百 tokens,而非傳統檢索拉取的上萬 tokens)。
- 下游 LLM 產出準確且具備時間依賴的回答:「該部署例外已在上週五的安全團隊覆核會議中被明確撤銷,目前恢復嚴格審批機制。」
- 潛在失效點(Likely failure point):
- 若在動態聚類過程中,Sparsity–Semantics 目標未能妥善設定超參數,導致「安全審批」與「系統日常維護」被過度聚合(over-clustering)在同一個超大 Theme 中,Stage I 可能因候選節點稀釋而漏掉關鍵撤銷語意;
- 若 Stage II 的熵減計算代理模型產生誤判,可能過早終止展開,導致模型僅看到例外批准的 Episode,而遺漏了隨後撤銷的前置條件。
技術機制
xMemory 的架構由「分層記憶建構與動態維護」及「兩階段自適應檢索」兩大核心機制構成。
1. 問題形式化
設 Agent 的歷史對話為時間序列流 ,其中 為單個對話訊息。給定當前查詢 與上下文 token 預算限制 ,目標是構建精簡上下文 ,在滿足 的前提下,最大化答案生成品質並保全關鍵證據的拓撲結構。
2. 四層階層架構與規模
記憶自底向上嚴格定義為四個維度:
Original Messages (Message) → Episode Blocks → Semantic Facts → Themes| 層級名稱 | 本質定義 | 映射與組織規則 |
|---|---|---|
| Message | 原始對話回合(Raw turns) | 連續的一組對話輪次構成一個區塊,映射至 1 個 Episode |
| Episode | 連續對話的時間窗口抽象 | 提取時序完整的情節摘要,1 個 Episode 映射至多個 Semantic 事實 |
| Semantic | 具備獨立原子性的長期事實節點 | 每個 Semantic 節點嚴格且僅屬於 1 個 Theme,保證結構正交 |
| Theme | 高階語意主題聚類 | 1 個 Theme 聚合多個語意相近的 Semantic 節點 |
在標準基準測試 LoCoMo 的實證尺度下(Figure 2 caption),典型對話流最終解耦並聚合為約 650 個 Themes、2,900 個 Semantics 與 750 個 Episodes。
3. Sparsity–Semantics 指導目標與動態可塑性
為了防止某些主題無限膨脹而引發候選集爆炸,或主題過度破碎形成孤島,xMemory 在聚類劃分 上定義了引導目標函數(Section 3.2,Eq. 1–3):
- SparsityScore(稀疏性得分,Eq. 2):懲罰過大或分佈極不均勻的主題聚類,獎勵大小適中的結構,確保各 Theme 底下的 Semantic 節點數量受控,避免檢索時陷入局部的組合爆炸。
- SemScore(語意連貫得分,Eq. 3):計算主題中心之間的距離分佈,同時懲罰質心距離過近(存在語意冗餘)與質心過遠(形成缺乏關聯的語意孤島 semantic islands)。
- 動態分裂與合併(Split & Merge):當新的對話轉化為 Semantic 節點寫入時,若某 Theme 節點超過預設容量上限(如單個 Theme 最多容納 12 個 Semantics),系統觸發子聚類分裂並選取最大化 的新劃分;反之,若主題過小且彼此高度重合,則觸發合併。
- 拓撲圖維護:在 Theme 與 Semantic 節點間動態維護 Top- 餘弦相似度邊,為檢索階段的高效圖遍歷奠定基礎。
4. 兩階段自適應檢索(Two-Stage Adaptive Retrieval)
Stage I:查詢感知代表節點選擇(Query-Aware Representative Selection)
在 圖拓撲上,系統採用貪婪策略選取代表節點子集 ,在全域覆蓋度與查詢語意相關度之間達成最優折衷(Section 3.3,Eq. 4):
其中:
- 為當前層級的所有候選節點集合, 為已選出的代表節點集合;
- 表示將節點 納入後,在 之外新覆蓋到的鄰居節點集合;
- 為節點 與鄰居 之間的邊權重, 為歸一化常數;
- 為查詢 與候選節點 的語意相似度分數;
- 為調節覆蓋度與相關度權重的超參數。
演算法首先在 Theme 層級求解代表主題,隨後將範圍限制在選中 Theme 所誘發的 Semantic 子圖中,進一步挑選最具代表性的 Semantic 事實節點。這一機制天然支援多跳推理(Multi-hop)與集合層級證據(Set-level evidence),能有效將分散在不同語意分支中的關鍵事實一併召回。
Stage II:基於預測不確定性的自適應證據納入(Uncertainty-Adaptive Evidence Inclusion)
選定核心 Semantic 節點後,系統調取其背後的關聯 Episode 摘要區塊。關鍵原則:Episode 作為完整的原子單元(intact units)被納入,嚴禁在內部進行字面剪裁。
- 系統透過計算讀者模型在當前 Context 下的條件預測熵(predictive uncertainty / entropy),評估新 Episode 帶來的邊際資訊增益;
- 僅當新納入的 Episode 能顯著降低預測不確定性時,才將其正式寫入 Context;
- 若任務對具體語法細節要求極高,可進一步按需展開至原始 Message;
- 一旦後續節點無法繼續提供熵減收益,立即觸發 Early Stopping,終止 context 擴張。
與傳統 RAG 基於語料多樣性假設的字詞級剪裁(如 LLMLingua-2)相比,xMemory 保全了對話的完整敘事鏈條,徹底避免了因刪減連接詞或主詞而引發的語意斷裂。
實驗如何讀
論文在多個長程基準測試上展開了深入的實驗驗證,涵蓋對話 QA、個人終身記憶、骨幹模型泛化性以及多維度的機制消融。
1. 實驗設定與評測維度
- 資料集(Datasets):
- LoCoMo:包含 50 組超長對話流,平均長度約 9,000 tokens、300 turns(跨越最多 35 個獨立 session),問題涵蓋 Single-hop、Multi-hop、時序因果推理(Temporal) 與開放領域對話。
- PerLTQA:個人終身記憶基準測試,涵蓋個人畫像(profile)、人際關係與歷史事件,要求句子級別的精確問答。
- 對照基線(Baselines):
- Naive RAG:直接對原始對話 chunks 進行 Top-20 相似度檢索並拼接;
- 結構化與圖記憶系統:A-Mem、MemoryOS、Nemori;
- 壓縮剪裁基線:LightMem(結合 LLMLingua-2 壓縮)。
- 基礎骨幹模型(Backbones):
- 開源模型:Qwen3-8B、Llama-3.1-8B-Instruct;
- 商業閉源模型:GPT-5 nano。
- 嵌入與推理環境(Compute & Embedding):
- 採用
text-embedding-3-small生成嵌入向量; - 生成模型採用貪婪解碼(Greedy decoding, );
- 評測指標涵蓋 BLEU-1、Token F1、ROUGE-L 以及每次查詢的平均 Token 開銷(Token/query)。
- 採用
2. 主實驗結果分析
Table 1:LoCoMo 長對話基準測試評測
在 Qwen3-8B 骨幹模型下,各方法在 LoCoMo 上的核心表現如下(節錄自論文 Table 1):
| 方法 | Avg F1 | Avg BLEU | Temporal F1 | Multi-hop F1 | Token/query |
|---|---|---|---|---|---|
| Naive RAG | 40.45 | 28.51 | 32.14 | 17.01 | 7754.66 |
| Nemori | 40.45 | 28.51 | 33.74 | 18.25 | — |
| LightMem | 30.28 | 23.77 | 26.50 | 12.30 | 5545.35 |
| A-Mem | 21.78 | 19.49 | 19.20 | 11.15 | 9103.46 |
| MemoryOS | 33.76 | 29.20 | 28.40 | 14.80 | 7234.66 |
| xMemory (論文方法) | 43.98 | 34.48 | 37.46 | 20.69 | 4711.29 |
核心數據解讀:
- 長程時序推理突破(Temporal QA):xMemory 在最考驗時間依賴的題目上,F1 達到 37.46,相比最強基線 Nemori(33.74)提升 3.72 分,相比 Naive RAG 提升 5.32 分;BLEU-1 更是由 Nemori 的 23.60 躍升至 29.58。
- 多跳關聯能力(Multi-hop):在需要跨 session 組合多個事實的題目上,xMemory 取得 20.69 的 F1 分數,顯著優於 Naive RAG 的 17.01 與 A-Mem 的 11.15。
- 極致的 Context 效率:xMemory 的平均單次查詢 token 消耗僅 4711.29,相較於 A-Mem 的 9103.46 降低近 48%,相較於 Naive RAG 的 7754.66 降低近 39%。這證明其準確率的提升並非來自塞入更多 context,而是來自結構化過濾。
- 跨模型泛化性:
- 在 GPT-5 nano 上:xMemory 達到 Avg F1 50.00(Nemori 為 48.17),Token/query 由 9155 驟降至 6581;
- 在 Llama-3.1-8B-Instruct 上:xMemory 同樣取得平均 F1 34.77、BLEU 24.73、Token 5539.97,在所有測試模型上全面保持平均最優。
Table 2:PerLTQA 個人終身記憶評測
在個人長期記憶資料集 PerLTQA 上,以 Qwen3-8B 為例(Table 2):
| 方法 | BLEU-1 | Token F1 | ROUGE-L | Token/query |
|---|---|---|---|---|
| Naive RAG | 32.08 | 41.37 | 35.95 | 6274.38 |
| MemoryOS | 35.14 | 42.35 | 38.48 | 6499.47 |
| xMemory (論文方法) | 36.24 | 47.08 | 42.50 | 5087.18 |
在 Llama-3.1-8B 上,xMemory 的 F1 達到 52.37,而採用傳統 RAG 剪裁的 LightMem 則因破壞了人際畫像與事件鏈條,BLEU 崩跌至 23.47、F1 僅 35.93。這直接驗證了 xMemory 的設計原則能跨越單純的對話 QA,成功遷移至複雜的個人終身記憶管理。
3. 消融實驗與診斷分析(Figure 3–5, Table 3)
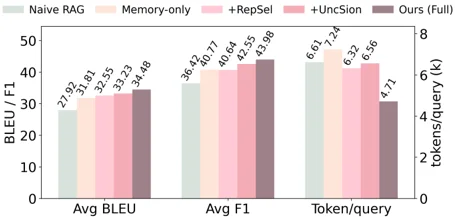
Figure 3,論文 Section 5 的架構元件消融實驗:左軸為 BLEU 與 F1 分數,右軸為每次查詢 token 開銷;對比 Naive RAG、Memory-only、w/o Stage II、w/o Split & Merge 與完整 xMemory,驗證各層級組件在提升準確性與控制 context 上的協同效益。原始 Figure 3 anchor;圖片取自 arXiv HTML figure endpoint。arXiv source 標示 perpetual non-exclusive license;本文保留完整 attribution,依 arXiv reuse terms 使用。
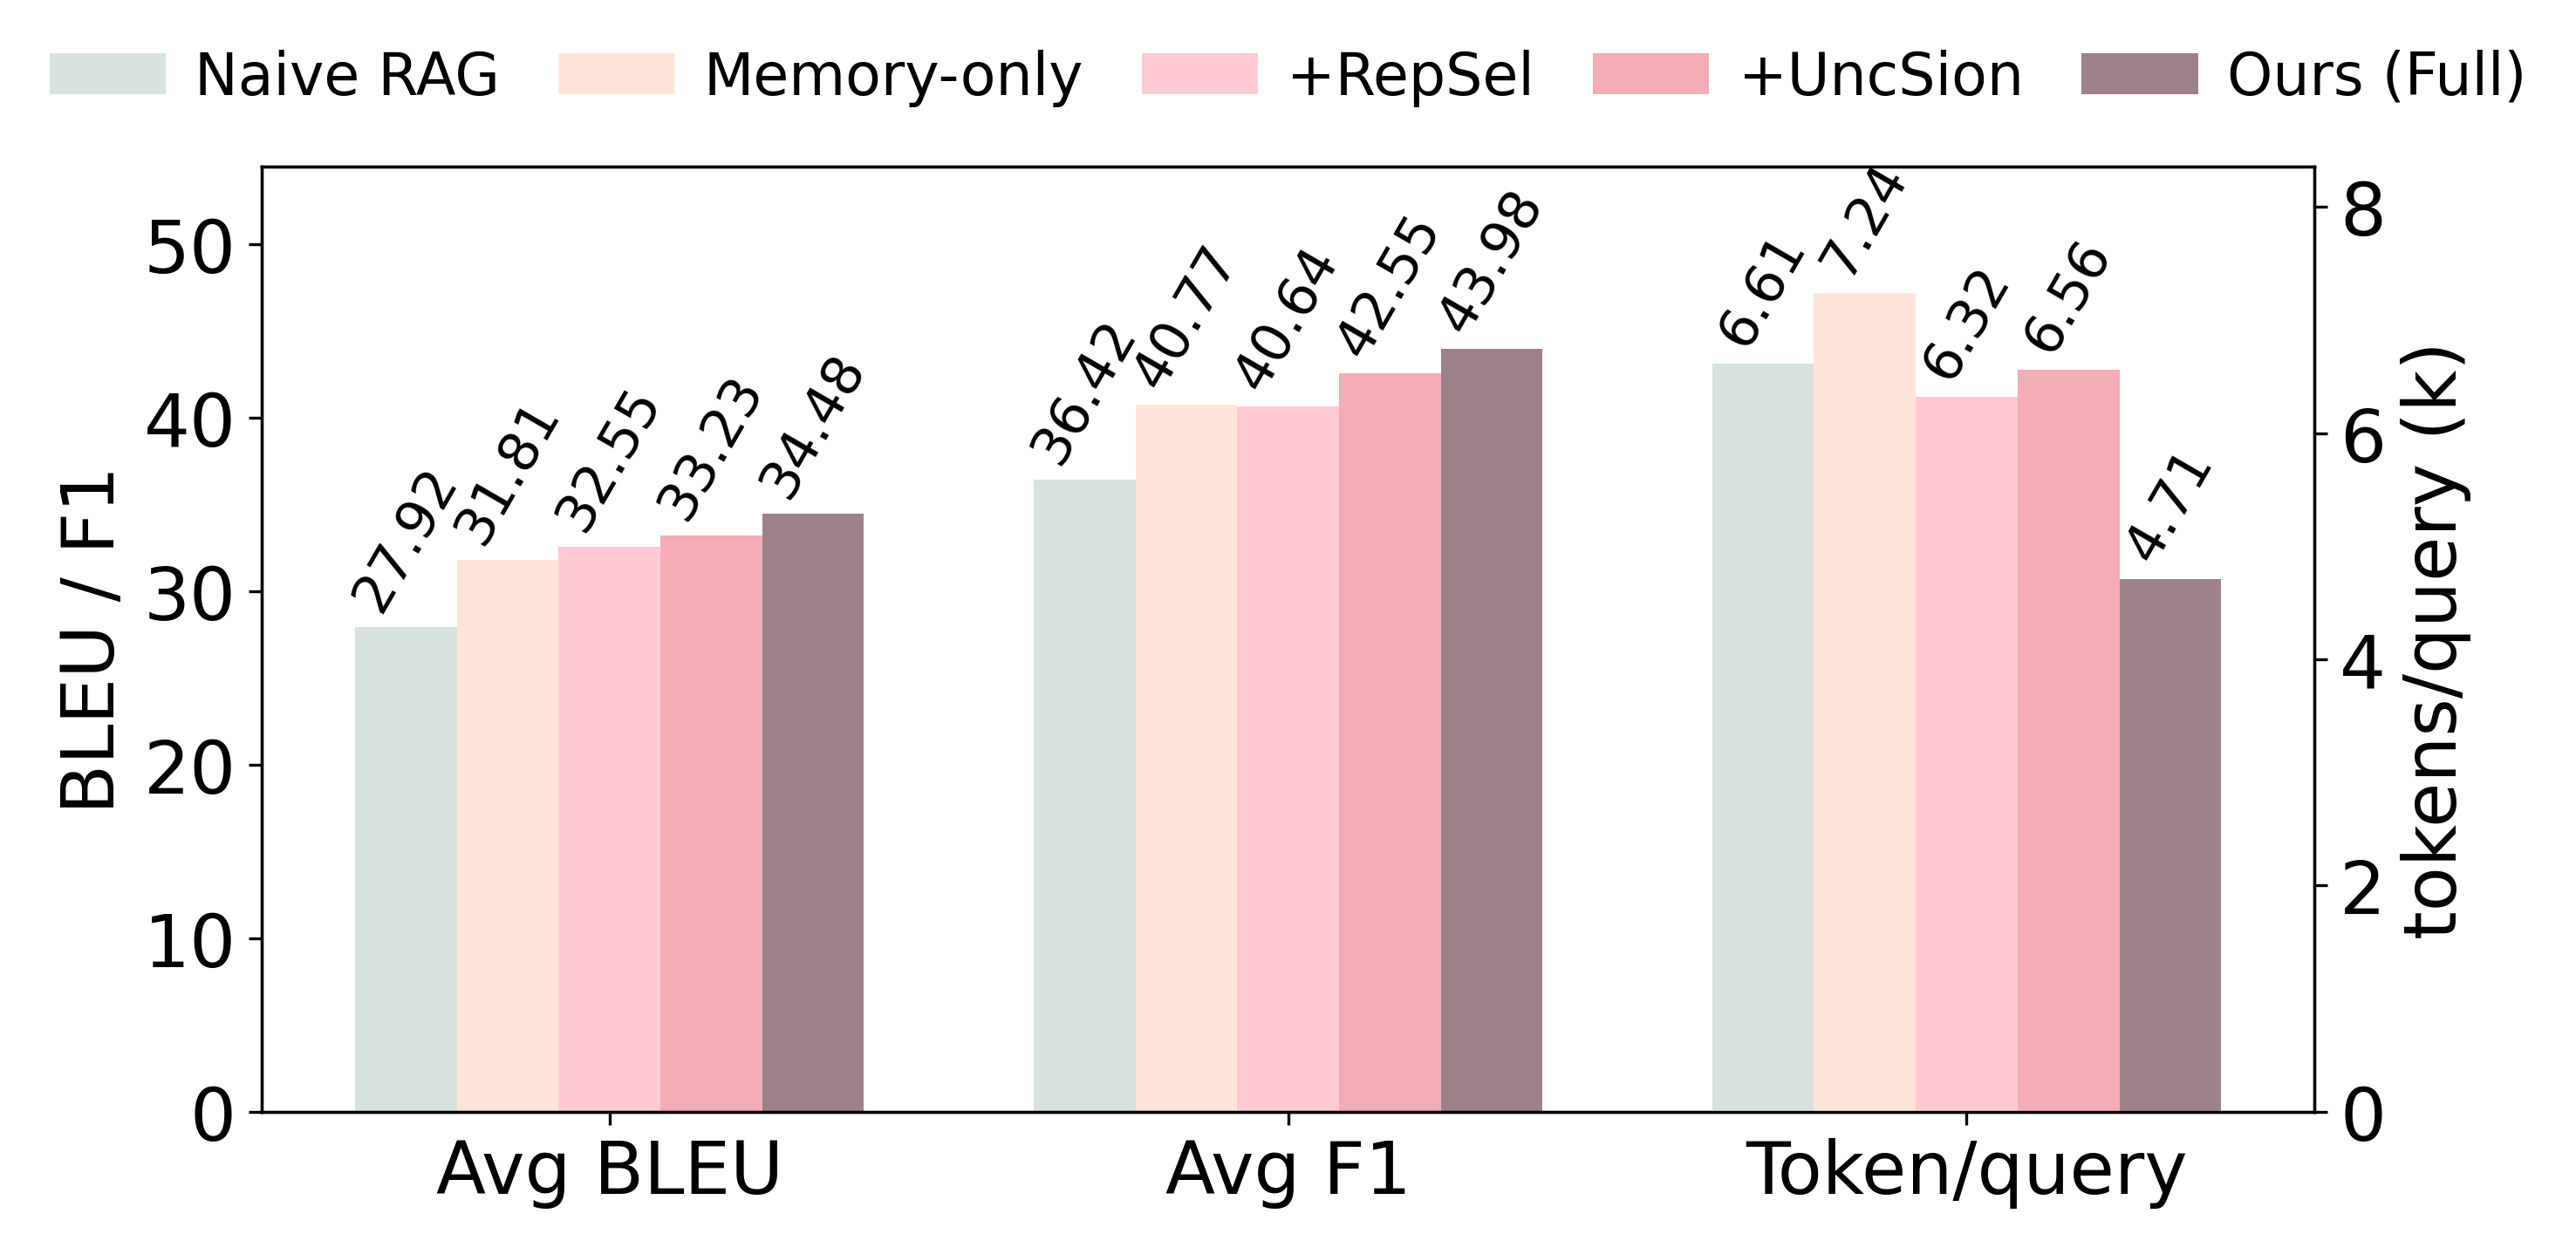
- Figure 3 五種架構變體消融(LoCoMo, Qwen3-8B):
- Naive RAG(原始 chunks Top-):表現平庸且 token 開銷高;
- Memory-only(僅構建四層結構,無自適應檢索):證明僅有靜態階層不足以解決檢索冗餘;
- w/o Stage II(移除基於不確定性的納入機制):F1 顯著下滑,驗證了完整 Episode 熵減篩選的價值;
- w/o Split & Merge(凍結聚類結構,不允許動態分裂合併):下游任務準確率全面回落;
- Full xMemory:完整機制在各項指標上均達峰值。
- Figure 4 證據命中分佈(Evidence Hit Distribution):在需要多個事實支撐的題目中,xMemory 展現出顯著較高的 Multi-hit 比例;而剪裁基線則嚴重集中在 1-hit 區間,證實扁平剪裁極易發生關鍵證據的覆蓋不足。
- Figure 5 結構可塑性(Structural Plasticity):實驗表明,若在寫入新會話時禁止執行事後動態重組(Retroactive Restructuring),隨著會話輪次增加,模型檢索效能呈現加速衰退。
- Table 3 覆蓋效率(Coverage Efficiency):統計數據表明,xMemory 能在維持顯著較低 token 開銷的同時,達成更高的黃金證據覆蓋率(Golden Evidence Coverage)。
4. 與相關工作的本質定位對比
| 技術路線 | 代表系統 | 架構特性 | 面對 Agent 記憶的根本缺陷 |
|---|---|---|---|
| 扁平上下文(Flat Context) | MemGPT, MemoryOS | 分頁機制或對話 FIFO 佇列 | 本質仍為原始文字片段,長程對話下冗餘不可避免 |
| 結構化圖記憶(Structured Memory) | MemoryBank, Zep, A-Mem | 構建實體關聯圖或記憶卡片 | 檢索時通常需跨層大規模展開,缺乏拓撲引導與預算感知 |
| RAG 事後剪裁(RAG Pruning) | LightMem + LLMLingua-2 | 基於模型小樣本重要性刪字 | 假設語料獨立多樣,在時序對話流中極易切斷因果與代名詞鏈條 |
| xMemory (論文方法) | xMemory | 先解耦後聚合,建構四層拓撲 | 寫入期動態塑形,查詢期自適應兩階段展開,兼顧覆蓋度與時序完整性 |
證據地圖
為清楚界定論文所建立的客觀事實與推論界限,將各項結論劃分為四個層次:
論文直接證據
- 基準測試分數與效率:在 LoCoMo 與 PerLTQA 兩項長歷史基準測試中,xMemory 在 Qwen3-8B、Llama-3.1-8B 與 GPT-5 nano 三個骨幹模型上,平均 F1、BLEU 與 ROUGE 指標均優於 Naive RAG、A-Mem、MemoryOS、LightMem 與 Nemori;
- 時序與多跳推理優勢:在 LoCoMo 的時序子集上,xMemory 取得了 37.46 的 F1 分數(高於 Nemori 的 33.74);在多跳子集上取得 20.69 的 F1(高於 Naive RAG 的 17.01);
- Context 壓縮比例:在達到更高問答分數的同時,xMemory 的單次查詢 token 消耗比 Naive RAG 減少約 39%,比 A-Mem 減少約 48%;
- 機制消融證據:Figure 3、Figure 4、Figure 5 與 Table 3 的消融數據證實,移除動態 Split/Merge、移除 Stage II 不確定性過濾或停用拓撲結構,均會導致下游 QA 分數出現可測量的顯著下滑。
作者因果解讀
- 解耦與聚合解決了冗餘崩塌:作者認為,將檢索維度由文本切片提升為語意組件,是消除向量空間冗餘聚集的直接因果機制;
- 完整 Episode 守護了時序連續性:作者主張,不對 Episode 內部進行字詞刪減,是其在時序推理與長程問答中勝過 LightMem 等剪裁演算法的根本原因;
- 熵減為停機標準具備最優性:作者將基於讀者模型預測不確定性的 Early stopping 視為控制 token 預算與答案精確度平衡的最佳決策依據。
論文未證明
- 未證明在線上即時動態環境中的可行性:論文未提供真實生產環境中的併發寫入延遲、即時圖維護開銷(split/merge 與 NN 重新計算耗時)或服務端端到端 SLA 數據;
- 未證明在資料刪除義務下的結構穩定性:論文完全未探討隱私法規(如 GDPR)要求的記憶刪除(Right to be forgotten)。在經歷多次 split/merge 後,刪除某個特定 Episode 對整個四層階層與質心空間的破壞程度未知;
- 未覆蓋惡意對抗與記憶污染(Memory Poisoning):實驗在 Section 4.1 中主動排除了 LoCoMo 的對抗子集(adversarial subset),論文未證明當對話流中存在刻意注入的矛盾資訊或假記憶時,動態聚類是否會產生拓撲混亂;
- 未證明可直接推廣至工具型工作區 Agent:評測僅局限於文字問答代理,未證明該記憶階層在需要進行實體檔案修改、終端機命令執行等工作區狀態變更任務中的直接有效性;
- 未包含完整系統的全生命週期成本核算:Table 1 報告的僅為檢索生成時的 inference tokens,並未將階層建構、LLM 摘要生成、嵌入計算與圖維護所需的綜合計算成本納入對比。
Bloss0m 工程化整理
- 記憶系統的範式升級:xMemory 證明了「盲目增加向量資料庫檢索維度」不如「在寫入期對記憶進行結構化塑形」;
- 雙軌驗證護欄原則:在生產實踐中,不能依賴單一聚類算法,必須在記憶層外圍建立資料溯源(provenance)、時間戳標籤(timestamps)與有效期限(TTL);
- 不可變日誌與可重構索引分離:原始對話(Messages)應作為不可變的事件日誌(Event Log)永久持久化,而 Episode、Semantic 與 Theme 則作為可隨時銷毀與重建的衍生索引(Derived Projections),以應對刪除要求與演算法升級。
Artifact 與可重現性
本文依據的論文為 arXiv:2602.02007 預印本(Hu 等人)。官方提供了公開的 xMemory GitHub 倉庫 與 專案展示頁面。
截至 2026-08-09 的公開端點查核狀況:
- 程式碼可存取性(Usable Code):官方倉庫具備 MIT 開源授權,提供了
environment.yml環境設定檔、資料集下載鏈結,以及針對 LoCoMo 進行建構、檢索與評測的指令碼。但 README 文件的指引主要圍繞在單張 A100 80GB GPU 下執行 Llama-3.1-8B 的特定路徑,未提供開箱即用的全管線一鍵評測腳本。 - 模型 Checkpoint 與發布狀態(Announced but Unavailable):官方倉庫的 GitHub Releases 頁面在該日期處於 空白狀態(Empty)。儘管 README 聲明會在 release 中提供預先建構好的 LoCoMo Llama 記憶快照,但直接下載鏈結並未附帶實體檔案,屬於宣布但未實際發布。
- 基準測試重現範疇:
- 本文所有實驗數據均直接引用自作者發布的論文報告數值;
- 倉庫中的資料集鏈結指向第三方上游公開資料,並非作者預先處理好的完整評測封裝包;
- 針對 GPT-5 nano 與 Qwen3-8B 的具體超參數設定、提示詞範本、熵值計算判定邏輯、隨機數種子以及原始推論紀錄目前仍處於缺失狀態。工程團隊可在本地重現單一 Llama 管線的執行邏輯,但無法直接一鍵驗證 Table 1 與 Table 2 中的每一項精確數值。
建議的最小化本地驗證路徑: 若團隊評估引入 xMemory 架構,無需在本地強行重現龐大的多模型全量基準。建議選取 10 組具備明確時間前置條件的多輪歷史對話,在固定開源模型(如 Llama-3.1-8B)下,分別運行 Naive RAG 與 xMemory 官方倉庫提供的分層檢索腳本,直接對比 Context token 開銷、檢索命中精確度與是否存在冗餘崩塌。
Bloss0m 工程判斷與不適用條件
結合 Bloss0m 在自主 Agent 與檢索增強系統中的工程落地經驗,對 xMemory 的採用界限提出以下明確判斷:
什麼時候值得考慮採用
| 業務情境 | 建議落地策略 | 工程考量依據 |
|---|---|---|
| 多 Session 長期相伴型對話系統 | 以歷史凍結日誌進行 Shadow Replay 評測 | 最契合 Figure 1 與 Table 1 的對話特徵;先在離線資料中量測是否存在嚴重的 Top- 語意冗餘與時序斷裂。 |
| 具有嚴格 Context 預算限制的高頻調用系統 | 評估引入兩階段 Top-down 檢索機制 | Table 1 證實其能減少近 40% 的 Context token,在 API 成本高昂的場景下具備實質收益。 |
| 具備完善資料溯源與可回滾架構的系統 | 允許引入帶有版控的動態分層索引 | Figure 5 證實動態重組是維持長效精確度的關鍵,但底層儲存必須支援索引重構與變更審計。 |
什麼時候絕對不要直接使用
- 單輪問答、短文檔或靜態知識庫檢索: 若業務主要是企業內部知識庫查詢、一次性 FAQ 或缺乏時序關聯的技術手冊,切勿使用 xMemory 的完整四層結構。其階層建構、摘要提取與圖維護的運算開銷將遠遠超過檢索收益,標準 RAG 搭配高品質重排序器(Reranker)是更穩健且經濟的選擇。
- 具備嚴格法規刪除義務(GDPR / 個人隱私)的敏感場景: 論文完全未給出動態節點刪除或權利撤回時的維護方案。若系統需頻繁響應使用者的「刪除此段對話」請求,複雜的聚類質心與拓撲圖將面臨嚴重的更新連鎖反應。在未建立記憶 tombstone 與安全重構機制前,嚴禁直接上線。
- 無受信防護的高併發線上即時寫入系統: xMemory 的 Split & Merge 與圖維護依賴批次聚類運算,無法在毫秒級別內完成一致性寫入。若線上即時對話吞吐量極高,動態重組將引發嚴重的寫入鎖爭用與效能抖動。
- 存在提示詞注入或對抗樣本威脅的開放環境: 在缺乏語意安全過濾的情況下,惡意使用者可透過刻意設計的對話誘導聚類演算法將惡意指令擴散至 Theme 節點,造成記憶庫的深層污染。
四維落地架構實踐原則
若團隊決定在架構中借鑑 xMemory 的思想,建議落實以下工程原則:
- 日誌不可變性(Immutable Log Principle):底層 raw messages 必須以不可變 append-only 儲存,任何 Theme/Semantic 結構均視為無狀態的快取索引;
- 時序硬標籤(Hard Timestamping):在 Semantic 節點中強制注入物理時間戳,檢索時結合時序過濾,防止過時記憶覆蓋最新狀態;
- 主動熵閾值兜底(Entropy Threshold Fallback):Stage II 的不確定性估計必須設定嚴格的最小展開保護,防止小模型因置信度膨脹而過早截斷關鍵證據;
- 全生命週期成本監控(Total Cost of Ownership):同時監控構建期 LLM 摘要費用、圖維護延遲與檢索期 token 節省,確保架構具備真實的淨經濟效益。
讀完後的三個記憶點
- 技術思想:Agent 長期記憶的核心瓶頸在於時序糾纏與語意冗餘崩塌;xMemory 透過「先解耦後聚合」構建四層記憶拓撲,將檢索由扁平的字面匹配提升為受控的多尺度語意導航。
- 核心證據:在超長對話基準 LoCoMo 上,xMemory 在三個主流骨幹模型上取得了全面最優的問答表現,時序推理 F1 顯著提升,且將每次查詢的 Context token 開銷大幅削減近 40% 至 48%。
- 工程邊界:階層式記憶並非萬靈丹;其建構與維護伴隨著額外的運算成本,且論文未證明其在即時併發寫入、隱私刪除合規與對抗環境下的穩健性,切忌在缺乏資料溯源與安全護欄下盲目套用。
Primary sources
- arXiv 預印本論文頁面(arXiv:2602.02007):版本演進、作者名錄、摘要與官方專案指標。
- arXiv 完整論文 HTML(arXiv:2602.02007v1):Figure 1–5、第 2–3 節方法論定義、第 4 節實驗數據與 Table 1–3 原始表格。
- xMemory 官方 GitHub 倉庫(HU-xiaobai/xMemory):開源 MIT 授權、環境依賴檔、LoCoMo 評測腳本與資料集鏈結。
- xMemory 官方專案展示頁面:專案架構概覽與學術展示資源。
- arXiv 非專屬學術散佈授權(Perpetual Non-exclusive License):本文引用與呈現原論文圖表(Figure 2)所遵循之開放學術規範。