Agent 記憶與適應
12 篇精讀筆記
理解長期任務中的記憶層次、索引更新、持久狀態與安全的系統適應。
讀者問題
系統要記住、更新或遺忘什麼,才能隨時間變好而不累積錯誤?
READING LIBRARY
深入讀這個議題
目前收錄在這個研究議題下的所有論文精讀。
-
Predicting Partial Answer Quality:讓 Agentic RAG 在下一輪以前知道是否值得繼續
進階深讀 Predicting Partial Answer Quality and Utility in Agentic Retrieval-Augmented Generation:把每輪中間答案的 quality、utility 與 trajectory signals 變成 early-stopping controller,並檢查節省迭代的證據與轉移邊界。
90 秒掌握這篇論文
- 問題
- Agentic RAG 在多輪 query、retrieve、read、reasoning 之後才產生最終答案;如果每個 instance 都跑到自然停止,可能在答案已經足夠後繼續花成本,也可能在已經失敗時反覆搜尋。論文問的是:能不能在每一輪的 partial answer 出現時預測它的 quality 與 utility?
- 核心洞見
- partial quality 與 incremental utility 是兩個不同 target。Quality 問「現在的 answer 有多接近 ground truth」,utility 問「從上一輪到現在增加了多少」;前者較可預測,後者的正負方向更受 trajectory、retrieval noise 與 task 影響。
- 最強證據
- 作者在 Search-R1 與 R1-Searcher 的 HotpotQA、2WikiMultiHopQA、MuSiQue 上測試 supervised 與 unsupervised predictors。Search-R1 的 quality Pearson 最高約 0.438、utility 最高約 0.321;controller 在 thetaP=0.3、thetaU=0.2 時將平均 iterations 由 3.21 降至 2.86,減少 10.89%,保留 97.60% 的自然停止品質。
- 主要邊界
- partial answer 以 F1 against gold answer probe;它不等於 open-ended answer quality,也不代表 threshold 能直接轉移到新的 retriever、model、corpus、答案型態或 controller。probing 本身還需要 generation cost。
-
EvoOntology:讓 Data Agent 的本體層從靜態說明變成可驗證的自演化介面
進階深讀 EvoOntology:把 heterogeneous data 的 ontology 封裝成 MCP server,由 builder agent 建立 evidence-grounded 初始層,再用 attribution-guided typed edits 與 backbone-conditional paired gate 持續演化。
90 秒掌握這篇論文
- 問題
- data agent 面對 tables、files、databases 時,不只是不知道欄位名稱,也不知道一個 domain concept 對應哪個 field、哪個 join、哪個 filter、哪個數值限制。Raw querying 讓 agent 自己反覆探索;static semantic layer 又可能太大、太舊,且要靠人工維護。這個 agent–data gap 會直接轉成錯誤的 query、冗長的 trajectory 與無法解釋的答案。
- 核心洞見
- 不要把 ontology 當成一份永遠不變的 prompt 文件,而是當成由 Content、Schema、Tool 組成、可被 agent 查詢的 versioned MCP service。Builder agent 用 probe 把語義接到真實資料;evolution agent 從失敗 trajectory 找出缺口,提出單層、typed、evidence-grounded patch,再以同一 backbone 的 paired validation 決定是否接受。
- 最強證據
- Figure 2 描繪三層架構;Figure 4 顯示四個 backbone 在 accepted rounds 中逐步上升;Table 5–7 分別拆解 gate/attribution/diagnose、editable level 與 object family 的貢獻;Appendix B 的 Table 8 顯示 per-turn context 變大,但平均 turns/task 從 14.6 降到 8.4、total tokens/task 從 52.6K 降到 42.0K。
- 主要邊界
- headline gain 需要把四-backbone analysis subset、六-backbone main tables、不同 benchmark metric 與 round-wise evolution 分開閱讀。作者的 repository 有可檢查的 framework code 與 demo,但 raw benchmark data、prebuilt ontology、模型 weights 與完整 provider credentials 不是隨 repo 一起交付。
-
VikingRAG:讓結構化文件的 Agentic RAG 少走幾輪、少吃幾千 token
進階深讀 VikingRAG:把文件階層保留在 URI 可定位的外部 storage,以 Search、List、Grep、Read 支援 evidence-gap retrieval,再用 experience edges 與 adaptive escalation 降低重複探索的 token 與延遲。
90 秒掌握這篇論文
- 問題
- 企業手冊、課程 syllabus、論文、合約與財報不是一袋互不相干的 chunks。答案常需要先定位哪一份文件,再沿著 chapter、section 或 subsection 找到分散的事實。若把所有 directory 都序列化進 prompt,結構線索會很貴;若只做一次 flat top-k,又可能在第一輪就漏掉跨 section 的依賴。
- 核心洞見
- 把 hierarchy 從 prompt 移到可查詢的外部 semantic storage。每個 directory node、chunk 與多層 abstract 都有 URI,且 URI prefix 保留 ancestor–descendant 關係;向量結果因此不只是文字片段,也是一個可以繼續 List、Grep、Read 的 navigation handle(論文 Section 2.2、3.1)。
- 最強證據
- 六個結構化文件資料集、八個 baseline、固定的 K=10、L=1,000、B=15 設定下,作者以 end-to-end accuracy、latency、LLM token、ingestion 與 deletion 評估。Figure 3/Table 3 報告 VikingRAG 的 token ratio 為 11.6%–51.9%,VikingRAG-E+ 為 5.1%–32.5%;Figure 7 也在 VersionQA 上換用 GPT-5.5、Seed-2.0 與 GLM-4.7 做 robustness check。
- 主要邊界
- accuracy 是 LLM-as-a-judge 加 expert verification 的 semantic consistency proxy,不是 retrieval recall 或獨立人工重做的 correctness proof。Experience edges 用同一文件語料產生的 1,000 個 synthetic historical questions warm up;evidence checker 的 false-no-escalation 在 QASPER 仍為 14.4%,FinanceBench 為 6.7%(Table 7)。
-
Generative Agents:用觀察–反思–計畫模擬多人行為,但不能把沙盒記憶當成 MemGPT 的 OS 分頁
中階 Agent Runtime、安全與評測精讀 Park et al. UIST 2023/arXiv:2304.03442 v2:25 個 agent 在 Smallville 以 memory stream、週期反思與檢索式規劃互動。訪談消融 TrueSkill μ 29.89 對完全消融 21.21;兩天沙盒中資訊擴散與派對協調是定性證據,不是生產 runtime。
90 秒掌握這篇論文
- 問題
- LLM 能在單一時間點產生像人的行為,但長期連貫的 believable agent 需要隨互動增長的記憶、跨 agent 的社會動態,以及把過去經驗用來規劃下一步——只靠更長 prompt 或單次生成不夠。
- 核心洞見
- 把每個 agent 的完整經驗以自然語言寫進 memory stream,用 reflection 週期合成高階推論,再用 relevance/recency/importance 檢索相關記憶來 plan 與 react;25 個 agent 在 Smallville 沙盒中互動,記憶控制平面是「社交模擬的觀察–反思–計畫」,不是 MemGPT 對單一 agent 的 OS 式 context 分頁。
- 最強證據
- 訪談消融(Figure 8)上完整架構 TrueSkill μ 29.89(σ=0.72),優於無反思(26.88)、無反思+規劃(25.64)、眾包基線(22.95)、完全消融(21.21)。兩天開放模擬(Section 7.1):市長資訊持有者 4%→32%、派對資訊 4%→52%;關係網路密度 0.167→0.74;派對 12 人受邀、5 人到場。
- 主要邊界
- 沙盒+ChatGPT,模擬兩天遊戲時間成本「數千美元 token、多天運行」(Section 8.2);常見失效是檢索不到相關記憶、捏造 embellishment、instruction tuning 帶來過度正式語氣。不是生產 ACL 記憶、不是 Reflexion 的跨 trial 語言 credit assignment,也不是後來 Letta/xMemory 產品或 benchmark 數字。
-
Reflexion:用語言反映寫進記憶,但不能把多次重試當成參數學習
中階 Agent Runtime、安全與評測精讀 Shinn et al. NeurIPS 2023:凍結權重、把語言反映寫進 episodic memory,跨 trial 做口語式 credit assignment。HumanEval pass@1 91.0 對 GPT-4 80.1 是程式設定下的數字;WebShop 與 MBPP 顯示邊界。
90 秒掌握這篇論文
- 問題
- 語言 agent 已經能跟環境互動,但要從試錯裡學,傳統 RL 需要大量樣本與權重更新;只靠 in-context few-shot 又幾乎沒有「跨 episode 的可解釋經驗」。
- 核心洞見
- 不更新權重。把二值或純量回饋放大成語言反映,寫進 episodic memory buffer,再條件化下一次 trial。改動的控制點是跨 trial 的口語式 credit assignment,不是參數梯度。
- 最強證據
- HumanEval (PY) Reflexion pass@1 91.0 vs GPT-4 單次生成 80.1(Table 1);ALFWorld heuristic 設定解出 130/134(Section 4.1);HotPotQA 報告相對強基線約 +20%(Section 4 開頭)。Rust 消融:完整 Reflexion 0.68,缺反映或只反映不測都會掉到 0.60/0.52(Table 3)。
- 主要邊界
- 需要可用的評測訊號;反映可以寫錯;多次 trial 有算力成本;記憶是滑動窗口(通常 1–3 條),不是企業級治理。WebShop 幾乎不提升(Figure 6);MBPP (PY) 甚至掉到 77.1。這不是權重學習,也不是可部署 runtime。
-
MemGPT:把 context 當記憶體分頁,但不能把 OS 比喻當成企業記憶層
中階 Agent Runtime、安全與評測精讀 Packer et al. arXiv:2310.08560 v2:把有限 context 當 RAM,用 OS 式階層與函式分頁管理外部記憶。DMR 上 GPT-4 從 32.1% 到 92.5%;Nested KV 顯示多跳查詢,但不等於治理型記憶庫。
90 秒掌握這篇論文
- 問題
- 固定長度 context window 讓長對話與長文件分析很快撞牆;直接把 transformer context 拉長成本二次成長,而且長視窗仍可能用不好中間段資訊。
- 核心洞見
- 不要先追求「更大的 RAM」。把 LLM 的 prompt tokens 當成主記憶體(main context),把對話歷史與文件庫放在外部記憶(external context),再用函式呼叫決定寫出、取回、驅逐——像 OS 的虛擬記憶體分頁。
- 最強證據
- Deep Memory Retrieval(Table 2)上,GPT-4 固定視窗正確率 32.1%、+MemGPT 92.5%;GPT-4 Turbo 35.3% → 93.4%。Nested KV(Figure 7)上,固定視窗模型在更深巢狀層級崩到 0%,MemGPT+GPT-4 能持續多跳查詢。
- 主要邊界
- 系統依賴模型的工具/函式呼叫保真度;分頁策略本身是 agent 決策,可能寫錯或丟掉關鍵事實;實驗是對話一致性與合成/抽樣文件任務,不是帶 ACL、稽核、rollback 的企業記憶層。後續 Letta 產品化也不等於這篇論文的實驗工件。
-
ADIAS:把 Agent 自我改良改寫成可追蹤的問題修復
進階 Agent Runtime、安全與評測深讀 ADIAS:以持續的 issue state 組織跨回合失敗證據,讓 full-code agent optimization 能記住修過什麼、哪些介入失效,以及何時真的修好。
90 秒掌握這篇論文
- 問題
- 自動化 agent design 通常以 candidate 為中心保存歷史。每一回合都重新閱讀候選程式、分數與 trajectory,卻沒有明確記住「同一個失敗是否已經修過、哪個介入有效、哪個改動造成 regression」。
- 核心直覺
- 把被修復的 issue,而不是 candidate agent,變成跨回合的控制狀態。每個 issue 擁有穩定身份、priority、supporting evidence、lifecycle status 與 intervention-outcome history。
- 最強證據
- 論文在 Tau-Bench、ALFWorld、TextCraft、WebShop、ScienceWorld 五個互動式環境比較 ADIAS 與五種 baseline;Table 1 的平均分數為 78.4,最強 baseline DGM-H 為 62.6。這些方法共用 task split、wrapper、action interface、scoring script、十回合 optimization budget 與每回合 15 個 training episodes(論文 Section 4、Table 1)。
- 主要邊界
- 論文把 trajectory diagnosis 與 issue association 固定下來,沒有獨立測量診斷正確率;評估也限於文字型互動 benchmark。GitHub repository 的 README 仍是 Coming Soon,因此本文不把「paper 說有 code」等同於「讀者現在可重現」。
-
DocMemo:讓長文件 RAG 在找錯證據後仍能回頭
進階 理解檢索、記憶與 Production RAG深讀 DocMemo:用 document schema、page belief 與 question episodic memory 保存跨回合 retrieval state,再以 Bayesian update、Thompson sampling 與 adaptive granularity 找回遺漏證據。
90 秒掌握這篇論文
- 問題
- 長文件的答案可能分散在數十頁、表格、圖與跨頁線索中。static retrieval 一開始就固定 top-k pages;若第一輪漏掉 evidence,後續 reasoner 沒有狀態可以解釋「哪一頁可能有用、哪些頁面已被排除、還缺什麼」。
- 核心直覺
- 把 retrieval 做成 dynamic evidence exploration。Document Schema Memory 保存文件結構,Page Belief Memory 更新頁面相關性信念,Question Episodic Memory 記住當前問題的發現與 query refinement。
- 最強證據
- 在 MMLongBench-Doc、LongDocURL、PaperTab 三個 long-document DocVQA benchmark 上,DocMemo 的 accuracy 為 71.3、81.1、80.4,平均 77.6;Table 4 的 ablation 也顯示移除 memory 或 Bayesian update 會使 MMLongBench-Doc accuracy 從 71.3 降到 68.5 或 68.8。
- 主要邊界
- 評估依賴 GPT-4.1 binary judge、PDF rendering、Qwen3.5-VL-9B、ColQwen2.5、MinerU 與三個 benchmark 的 annotation;它沒有證明任意企業 corpus 的 citation faithfulness、access-control correctness、freshness 或總成本。
-
ContextWeave 論文精讀:記憶真的讓 Agent 更會做事嗎?
進階 Agent Runtime、安全與評測拆解 ContextWeave 如何把多月工作流重建成可執行 benchmark,並檢驗記憶對工作區結果、偏好一致性、連續性與誤導風險的真實影響。
90 秒掌握這篇論文
- 問題
- 記憶 benchmark 常把「找得到歷史」當成成功,卻沒有測試它是否讓下一個可執行工作真的做得更好。
- 核心想法
- 把多月工作流重建成固定、可執行的任務串,對同一 target task 只切換是否提供過去軌跡;用結果品質與偏好遵循,而非 retrieval hit,量出記憶造成的差值。
- 最強證據
- 在 14 位參與者、1,005 個重建任務(568 個核心評測任務)的設定中,作者報告最強 memory component 將 Workspace Score 由 68.08 提升至 78.20、Preference Score 由 41.50 提升至 70.60(Section 5.2、Table 2)。
- 邊界
- 重建的 Docker/模擬 API 與 LLM 型評分器使結果可比較,卻不能直接代表真實企業資料、真實工具漂移或所有 memory 實作的 production uplift。
-
PAST-Bench:Persistent Agent 真的從過去學會了什麼嗎?
進階 Agent Runtime、安全與評測深讀 PAST-Bench 如何用 fresh-session task families、matched persistence controls 與 trace-level mechanism evidence,分辨 Agent 變好是因為保留經驗,還是只是分數變高。
90 秒掌握這篇論文
- 問題
- 持久 agent 後續得分提高,可能來自模型、prompt、任務難度或殘留 context,而不是正確使用先前經驗。
- 核心想法
- PAST-Bench 在 fresh-session task families 中,固定 prompt、grader、tool stack,只切換 persistence-on/off;同時量 task-score gap 與 write/read/artifact 的 mechanism evidence。
- 最強證據
- 26 個 scenario、204 個 episode、四種能力、七個模型與四個框架;Hermes+ 報告 overall gap 從 +0.13 到 +0.15、Mech 從 0.64 到 0.73(Table 2、Section 4.3)。
- 邊界
- overall gap 差異小於 run-to-run variation,任務由提案團隊設計,matched ablation 是強控制而不是完整因果證明。
-
Beyond RAG for Agent Memory:xMemory 詳細筆記
中階 理解檢索、記憶與 Production RAG依 arXiv:2602.02007 解讀 xMemory 四層階層、sparsity–semantics 目標、兩階段 top-down 檢索,以及 LoCoMo/PerLTQA 實證。
90 秒掌握這篇論文
- 問題
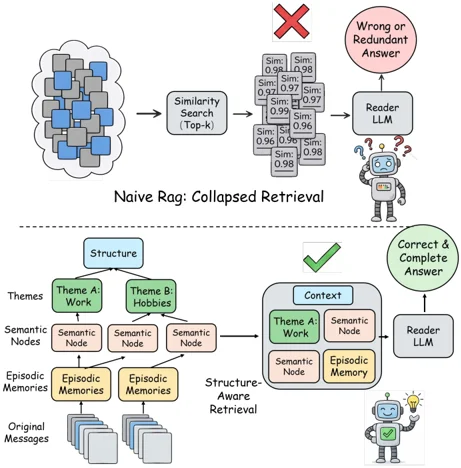
- agent memory 是有時間連續性、近重複且高度相關的互動流;固定 top-k chunks 容易集中在同一局部,pruning 又可能切斷時間依賴。
- 核心想法
- xMemory 將 raw messages decouple 再 aggregation 成 message、episode、semantic、theme 四層,以 sparsity–semantics objective 指導 split/merge,並 top-down 逐層縮小到需要的細節。
- 最強證據
- 論文在 LoCoMo、PerLTQA 與長對話設定比較 memory baseline;Table 1、Figure 2、Figure 3 與 Appendix ablation 分別支援層級、檢索與效率論述。
- 邊界
- 階層品質依賴 segmentation、embedding 與 token budget;benchmark QA 分數不直接證明真實 agent 能安全地更新或治理長期記憶。
-
RAG without Forgetting:把成功的 Query Expansion 寫回索引,但不要把錯誤也寫進去
中階 理解檢索、記憶與 Production RAG以論文證據檢視 ERM 的 correctness gate、選擇性歸因、有界 key update、BEIR/BRIGHT 結果與未釋出 artifact。
90 秒掌握這篇論文
- 問題
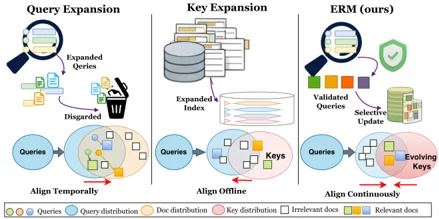
- query expansion 可改善 query–document mismatch,卻要每次重新生成;持久 key expansion 又容易把錯誤 feedback 寫入 index。
- 核心想法
- ERM 只接受通過 correctness gate 的 expansion unit,並把它歸因給真正提高 similarity 的 document key,再做 bounded update;它更新 key,不重訓 retriever。
- 最強證據
- 作者在 13 個 BEIR/BRIGHT domain 報告 retrieval 與 generation 結果,並在 Table 1、Table 2、Figure 3 與 Appendix B.9 分別呈現品質、延遲、budget 與 transfer。
- 邊界
- 公開論文沒有 implementation、live A/B、attack/privacy/rollback study;gate 的錯誤會把錯誤關聯變成持久 index state。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡