論文精讀
ContextWeave 論文精讀:長期 Agent 的工作流程與記憶評測
原文:ContextWeave: A Real-World Workflow Benchmark for Long-Running Agents
90 秒掌握論文
- 問題:過去的記憶評測常把「能否檢索出歷史片段」當成成功指標,卻未檢驗召回的記憶是否真正幫助 Agent 在後續可執行環境中把任務做對。
- 核心洞見:將多月真實工作流重建成受控且可獨立執行的任務串,在固定目標任務與模型條件下,只切換是否提供過去軌跡記憶;以工作區最終狀態品質與使用者偏好遵循度,而非檢索命中率(retrieval hit),量化記憶帶來的淨介入增益。
- 最強證據:在 14 位參與者、1,005 個重建任務(包含 568 個核心評測任務)的基準測試中,作者報告最強記憶組件(A-Mem)將 Workspace Score 由無記憶的 68.08 提升至 78.20,Preference Score 由 41.50 提升至 70.60(Section 5.2、Table 1)。
- 主要邊界:任務環境由 Docker 容器與模擬 API 重建而成,評分高度依賴 GPT-5.5 評審;此外,最強組件同時引入了 7.39% 的記憶誤導率(memory-induced task rate)。這意味著高召回率並非無條件的生產環境勝者,在未具備嚴格驗證與過時淘汰機制前,不該將其直接推論為企業落地成效。
本文依據 arXiv v1 預印本(2026-08-05,arXiv:2608.04830);未見獨立的同行評審期刊或會議發表紀錄。論文由復旦大學等機構學者發表,並提供開源代碼倉庫。
理解前需要知道什麼
在評估自主長程 Agent(Long-running Agents)的記憶系統時,工程團隊經常面臨一個核心矛盾:檢索系統看似找回了高度相關的歷史對話,Agent 卻在隨後的工作區操作中執行了錯誤動作。要理解 ContextWeave 的貢獻,必須先釐清既有方法與過去作法的根本瓶頸,以及傳統評測為什麼不夠:
- 既有長歷史問答(Long-history QA)的不足:傳統記憶基準測試(例如 LoCoMo 等資料集)多半將記憶簡化為純文本問答。題目形式通常是「使用者在三週前提到他的伺服器連接埠是多少?」,評判標準是檢索召回率(Recall@K)或生成文字的 ROUGE/BLEU 分數。然而,企業級 Agent 的本質不是對話機器人,而是必須在作業系統、代碼倉庫與外部 API 中造成狀態變更(state mutations)的執行實體。找回一段正確文字,完全不等於 Agent 能在具體工作區中正確修訂檔案。
- 單次獨立任務評測(Single-turn benchmarks)的脫節:現有的主流 Agent 基準測試(如 SWE-bench、WebArena 等)皆採用「單任務獨立初始化」的設定。每個任務都有全新的隔離環境與從零開始的 context,評測的是 Agent 的即時推理與工具呼叫能力。這類測試完全過濾掉了跨工作階段(cross-episode)的歷史依賴,無法衡量 Agent 在面對延續性專案時,如何累積、檢索並應用過去的決策慣例。
- 完整軌跡重播(Full-trajectory replay)的環境漂移:若直接讓 Agent 從第一天連續執行到第三個月,任何微小的早期錯誤都會隨時間呈指數級放大,引發嚴重的環境漂移(environment drift)。此時後續任務的失敗,究竟是因為記憶模組失效、底層模型失誤、還是早期工具狀態污染?因果鏈條將徹底混亂而無法分析。
因此,過去方法留下的核心瓶頸在於:我們始終缺乏一個既能保留真實多月工作流的前後依賴關係,又能精確隔離記憶模組因果影響的可執行評測體系。
核心直覺
ContextWeave 的核心直覺非常明確:記憶不是資料庫快取功能,而是對 Agent 後續動作的因果介入(intervention)。
在決策規則上,先前的直覺是「檢索召回最大化」——只要向量資料庫檢索出的 Top-K 片段與當前查詢相似度最高,記憶模組就被視為有效。而 ContextWeave 將決策規則轉變為「工作區狀態淨增益最大化」:只有當歷史記憶能夠實質提升後續任務的完成率與使用者偏好一致性時,這段記憶才具備工程價值。
作者將評測建立在受控介入的形式化定義上: 設真實工作流被拆解為任務串流 。對於任何一個目標任務 ,在不提供任何過去記憶(zero recall)的 baseline 條件下,Agent 執行的工作區結果記為 ;而在記憶模組 提供先前任務軌跡所提煉的記憶表示時,Agent 執行的結果記為 。記憶對該任務帶來的淨效應即為介入差值:
在這個公式中,目標任務 的輸入需求、底層模型、可呼叫工具權限、Docker 初始環境與評分規則完全保持凍結,唯一被改變的變數就是「記憶層所注入的歷史資訊 」。
- 若 ,代表記憶成功傳遞了必要的前置脈絡或工作慣例;
- 若 ,代表該記憶對當前任務無實質幫助(純粹消耗 context token);
- 若 ,則揭示了記憶系統最危險的副作用:記憶誘發錯誤(memory-induced error)。當記憶召回了過時的配置、不同專案的命名規則或已廢棄的依賴項時,Agent 會誤以為自己掌握了既有脈絡,進而放棄必要的環境探索,直接在工作區產出錯誤結果。
用一個例子走完整個方法
為了具體理解 ContextWeave 的評測流程,我們以一個典型的軟體工程專案任務為例,走完這五個標準執行步驟:
- 輸入與任務上下文(Task context and trigger):在先前的歷史工作串中(例如任務 與 ),使用者曾指導 Agent 建立專案的自動化測試腳本,並明確約定:「所有的端點測試報告必須以 JSON 格式輸出至
/opt/workspace/reports/ci/目錄下,且檔名必須包含 Git commit 雜湊值與執行時間戳記」。現在,新的目標任務 抵達:「為新的認證模組補充單元測試並產生測試報告」。 - 記憶抽取與檢索表示(Memory extraction and intermediate representation):在無記憶(No-recall)對照組中,Agent 僅收到當前的任務指令與乾淨的工作目錄,對於歷史上的檔案命名規範與路徑約定毫無所知。在有記憶(With-recall)實驗組中,記憶組件(例如 A-Mem 或 MemoryBank)根據當前任務語義,從歷史軌跡資料庫中檢索出與測試報告相關的記憶節點,將「報告存放於
/opt/workspace/reports/ci/且需含 commit hash」這條使用者慣例注入到當前的提示詞上下文中。 - 決策與工具操作(Decision, action, and transformation):在無記憶條件下,Agent 必須先耗費額外的 Bash 指令探索專案結構(如搜尋既有報告可能放在哪裡),或者它可能會自行發明一個新路徑(如隨手寫入
./test-output.txt),甚至以純文字形式將結果印在終端機。在有記憶條件下,Agent 跳過重複探索,直接調用檔案編輯工具編寫測試,並執行測試腳本將 JSON 報告精確寫入/opt/workspace/reports/ci/auth_test_[hash]_[timestamp].json。 - 輸出與工作區驗證(Output and workspace verification):任務結束後,評測框架進入 Docker 容器執行自動化判定。評分體系將結果拆分為兩個維度:Workspace Score 檢驗工作區狀態——測試代碼是否成功覆蓋認證模組、測試是否通過、目標檔案是否存在且符合 JSON 語法規範;Preference Score 檢驗使用者偏好遵循度——報告是否確實存放在約定的目錄、檔名格式是否嚴格遵循歷史約定的雜湊與時間戳記慣例。
- 潛在失敗點與記憶誤導(Likely failure point and misleading recall):如果記憶模組檢索精確度不足,抓取到了歷史上另一個 Python 專案的舊約定(例如誤以為報告應該是 XML 格式並呼叫
pytest-cov的特定外掛),Agent 便會基於該記憶強制執行不相容的命令,導致依賴衝突或輸出格式錯誤。這種在「無記憶時能透過當前目錄配置自主摸索正確路徑,有了記憶反而因錯誤偏見做錯」的現象,即被精確標記為記憶誘發任務錯誤(memory-induced task failure)。
技術機制
ContextWeave 建立了一套從真實工作流到隔離評測的完整建構流程,其技術架構涵蓋數據重構、依賴圖譜建構與多維度評測協議。
工作流重構架構(Benchmark Construction Pipeline)
論文 Figure 1 完整展示了 benchmark 的建構生命週期:

圖 1|ContextWeave benchmark 建構流程。論文 Section 4。來源:Wang 等人,ContextWeave Figure 1;論文頁標示依 CC BY-NC-SA 4.0 使用。
建構流程分為四大核心階段:
- 隱私保護的工作流採集:研究團隊從 14 位真實從業人員處採集了跨越數月的日常工作軌跡,涵蓋學術研究、軟體開發、數據分析與系統運維等真實領域。所有原始日誌均經過嚴格的去識別化與敏感資訊清洗;
- 任務單元抽取與環境虛擬化:將連續的長程工作流切分為語義獨立的任務單元(Tasks),並為每個任務配對對應的本地檔案實體、指令集以及模擬外部相依的控制 API(Control APIs);
- Docker 容器化隔離:將每個任務封裝於獨立的 Docker 映像檔中,確保檔案系統、環境變數與模擬網路服務具備一致的初始狀態;
- 人工校準與狀態對齊:由專家對每個任務的初始狀態、前置依賴鏈條與完成標準進行人工審核,並撰寫具備確定性斷言的工作區評分規則(rubrics)。
數據集規模與時間依賴性
整個 ContextWeave 包含 1,005 個可執行任務,其中 568 個核心評測任務 經過完整的人工標註與驗證。在這 568 個核心任務中,有 541 個任務(佔比高達 95.2%) 明確依賴於先前任務所產生的檔案、配置或約定,累計形成了 8,084 條前置相依關聯(relevant links)。任務的歷史訊息記錄長度平均約為 36.3K tokens,最長甚至達到 212.3K tokens。
論文 Figure 2 進一步分析了任務的類型多樣性與時間相關性(temporal relevance):

圖 2|任務多樣性與 temporal relevance。論文 Section 4。來源:Wang 等人,ContextWeave Figure 2;依 CC BY-NC-SA 4.0 使用。
從 Figure 2 的分析可以看出,時間上的相近性並不等於語義上的依賴性。許多關鍵的前置依賴(例如一個月前定義的資料庫 schema 或專案基礎架構)在時間軸上距離當前任務非常遙遠,但其在邏輯權重上卻遠高於幾分鐘前發生的瑣碎對話。這對工程實踐提出了重要警示:僅依賴時間戳記衰減或滑動視窗的記憶檢索器,必然會在真實工作流中遺漏長程關鍵依賴。
評測協議與五維指標體系
主實驗採用固定的 Codex 評測線架(Codex harness),預設搭配 GPT-5.5 xhigh 作為底層推理核心,固定工作區環境、工具權限與任務指令,對比無記憶 baseline 與六種主流記憶組件:
- mem0:輕量級鍵值記憶與向量檢索;
- memos:以對話會話為單位的摘要式記憶;
- Supermemory:面向個人筆記與網頁內容的外部快取系統;
- MemoryBank:具備艾賓浩斯遺忘曲線與記憶更新機制的層次化記憶庫;
- LangMem:專為 LangChain/LangGraph 生態設計的語義記憶提取與檢索模組;
- A-Mem:基於動態經驗組織與自主架構調節的主動記憶系統。
評測維度摒棄單一分數,採用五維評分體系:
- Workspace Score:任務結束後,Docker 工作區的實體檔案、程式執行結果與系統狀態是否達到 rubric 定義的客觀目標(滿分 100);
- Preference Score:Agent 是否嚴格遵循工作流中隱含或顯式的使用者偏好、代碼規範與命名慣例(滿分 100);
- Relevance / Continuity:召回內容與當前任務的語義相關度,以及 Agent 能否接續先前未完成的工作;
- Solvability:加入記憶介入後,任務是否維持可解狀態,或因記憶注入過多雜訊導致思考陷入死循環;
- Memory-induced task rate:錯誤或過時的召回內容直接導致任務失敗或走向錯誤方向的發生比率。
實驗如何讀
閱讀 ContextWeave 實驗數據的核心方法是:不要只看總體提升幅度,必須同時檢驗行為變化與代價指標。
核心結果對比:Table 1 分析
論文 Table 1 呈現了在固定 GPT-5.5/xhigh 條件下,六種記憶組件相對於無記憶對照組的表現:
| 設定 | Workspace Score | Preference Score | Win rate (vs No recall) | Memory-induced task rate |
|---|---|---|---|---|
| No recall | 68.08 | 41.50 | — | — |
| mem0 | 72.48 | 49.73 | 50.70% | 0.35% |
| memos | 70.01 | 46.38 | 53.30% | 0.35% |
| Supermemory | 70.57 | 48.04 | 55.60% | 0.70% |
| MemoryBank | 73.24 | 55.40 | 65.08% | 1.23% |
| LangMem | 75.29 | 57.37 | 62.79% | 5.11% |
| A-Mem | 78.20 | 70.60 | 72.70% | 7.39% |
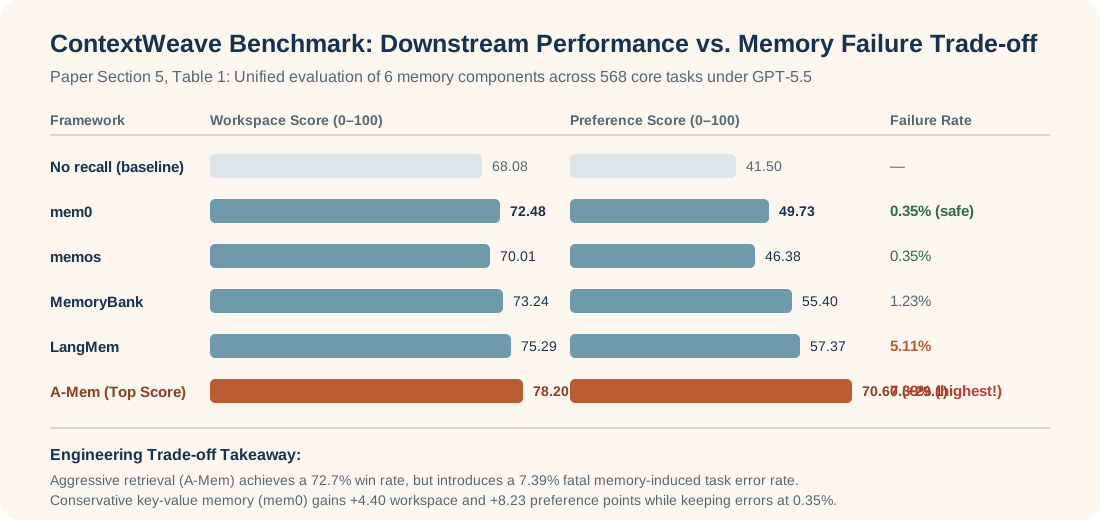
Figure 3,依據論文 Section 5、Table 1 與本文整理的下游成效與代價權衡示意:橫向對比 No-recall、mem0、memos、MemoryBank、LangMem 與 A-Mem 的工作區與偏好分數;突出高召回記憶框架(A-Mem 獲最高分與 72.7% 勝率)背後高達 7.39% 的 memory-induced 任務失敗代價。原論文 Table 1 anchor。依 CC BY-NC-SA 4.0 重用與繪製公開數據。
從 Table 1 的數據可以得出三項關鍵解讀:
- 工作區與偏好分數的實質提升:相較於無記憶 baseline(Workspace 68.08,Preference 41.50),所有記憶組件均帶來了正向效益。表現最佳的 A-Mem 將 Workspace Score 提高至 78.20(+10.12 分),Preference Score 更大幅提升至 70.60(+29.10 分),勝率達 72.70%。這證明在跨任務的工作流中,記憶確能顯著改善最終產出與使用者滿意度。
- 激進召回的致命代價:A-Mem 的顯著提升並非沒有代價。其 Memory-induced task rate 高達 7.39%,相比之下,保守型設計的 mem0 與 memos 僅為 0.35%,MemoryBank 為 1.23%。LangMem 也達到了 5.11%。這意味著在每 100 個任務中,A-Mem 會因為召回了錯誤或不匹配的歷史記憶,直接毀掉超過 7 個原本可能做對的任務。
- 行為軌跡診斷(Behavioral Diagnostics):論文進一步分析了 Agent 的行為模式變化。啟用 A-Mem 後,Agent 的環境探索行為(exploration rate)大幅下降了 7.06 個百分點,而直接執行動作(execution rate)上升了 6.63 個百分點。在歷史記憶正確時,減少摸索能顯著節省 token 與時間;但當召回內容過時或錯誤時,「減少探索」便直接退化為「缺乏驗證」,Agent 帶著偏見直奔錯誤終點。
跨基礎模型遷移:Table 2 分析
為了驗證記憶收益是否依賴於特定的底層模型,作者固定採用 mem0 組件,在五個主流基礎模型上進行消融對比(Table 2):
- DeepSeek-V4-Pro:Workspace Score +5.61,Preference Score +9.61;
- GPT-5.5:Workspace Score +4.95,Preference Score +7.66;
- GLM-5.1:Workspace Score +2.19,Preference Score +5.83;
- Kimi-K2.6:Workspace Score +2.99,Preference Score +8.37;
- Qwen3.7-Max:Workspace Score +3.06,Preference Score +5.55。
實驗結果顯示,記憶增益在所有五個模型上皆呈現正向趨勢,證明了記憶機制的通用價值。然而,增益幅度在不同模型間存在顯著差異(DeepSeek 與 GPT-5.5 的提升顯著高於其他模型)。這說明記憶層的效果並非孤立存在,它與基礎模型本身的指令遵循能力、長上下文理解深度以及錯誤修正彈性存在高度交互作用。
證據地圖
為了清楚劃分論文所建立的客觀事實與推論界限,我們將 ContextWeave 的結論嚴格界定為四個層次:
論文直接證據
- 基準測試規模與依賴覆蓋:論文成功建構了包含 14 位參與者、1,005 個任務(568 個核心任務)的可執行數據集,其中 541 個任務具備實質的前置工作依賴,形成了 8,084 條關聯鏈條;
- 記憶對下游執行的正面增益:在固定 Agent harness 與評測標準下,引入記憶組件確實能顯著提升工作區交付品質(Workspace Score 最高提升 10.12 分)與使用者偏好遵循度(Preference Score 最高提升 29.10 分);
- 記憶誘發錯誤的客觀存在:更複雜、更積極將經驗注入上下文的組件(如 A-Mem 與 LangMem),其誘發任務失敗的比率(7.39% 與 5.11%)遠高於保守型組件(0.35%);
- 跨模型增益的一致性:在五個不同架構與參數規模的基礎模型上,引入 mem0 均帶來了穩定的正向收益(Workspace Score 提升 2.19 至 5.61 分)。
作者因果解讀
- 代表記憶的因果影響:作者認為透過嚴格凍結當前任務環境、工具與底層模型,差值 能夠乾淨地代表歷史記憶注入對 Agent 行為產生的因果效應;
- 上下文經驗優於抽象摘要:作者主張保留原始軌跡細節的經驗記憶之所以勝過純文字摘要,是因為前者傳遞了具備可操作性的命令語法與具體檔案路徑,減少了 Agent 的認知負荷;
- 探索減少被解讀為效率進步:作者將 exploration rate 的下降與 execution rate 的上升視為 Agent 執行效率提升的直接證據。
論文未證明
- 未證明 A-Mem 為企業通用最優解:在生產環境中,任務失敗或狀態污染的修復代價通常遠高於重複探索的 token 成本。論文數據無法證明 7.39% 錯誤率的 A-Mem 能夠直接取代錯誤率僅 1.23% 的 MemoryBank;
- 未證明在動態真實系統中的穩健性:評測環境基於 Docker 容器與靜態模擬 API,論文未證明當真實企業系統發生 schema 變更、權限收回或網路漂移時,這些記憶組件能否自適應處理衝突;
- 評分器偏見未完全排除:大部分 rubric 評分均由 GPT-5.5 擔任評判模型,評分機制可能內生性地偏好由相同系列模型生成的決策風格;
- 缺乏完整信賴區間與跨領域統計檢定:論文僅報告了整體 aggregate score,未針對不同參與者行業領域或單項工作流提供完整的置信區間(confidence intervals)與顯著性檢驗;
- 未覆蓋大規模全矩陣消融:由於完整評測單次配置成本約需 200 美元,受限於算力與 API 成本,作者未能對所有模型與六種記憶組件進行全排列交叉評測。
Bloss0m 工程化整理
- 評測範式轉移:ContextWeave 的最大價值在於徹底推翻了「以 Recall@K 評估 Agent 記憶」的過時做法,將記憶重新定義為針對工作區狀態變更的介入子系統;
- 記憶的主動防禦架構:生產系統中的記憶模組絕不能僅扮演資料檢索角色,必須內建四層安全護欄——資料溯源(provenance tracking)、有效期限與主動淘汰(TTL/staleness detection)、衝突檢測(conflict resolution)以及操作可逆性(rollback mechanisms);
- 探索與驗證的平衡曲線:工程團隊必須警惕「探索步數減少」的假象。在涉及資金交易、資料庫寫入或基礎架構變更的高風險場景中,Agent 必須維持「即使記憶存在,仍強制進行工作區地面真值驗證(ground-truth verification)」的工程約束。
Artifact 與可重現性
本文依據的論文為 arXiv v1 預印本(2026-08-05,arXiv:2608.04830)。作者提供了公開的 ContextWeave 官方 GitHub 倉庫。
截至 2026-08-09,該公開倉庫包含了執行測試的 runner 代碼、Docker 工作區設定檔、記憶組件封裝介面、評分指標實現以及部分評測任務歸檔資料。
在評估重現性時,工程讀者需注意以下客觀限制:
- 獨立重現範疇:本文數據均採用原論文作者報告之實驗數值,本精讀並未在本地耗費巨資重跑全部 568 個核心任務的完整 benchmark;
- 重現成本門檻:依照作者公佈的配置,跑完一組完整的評測需要消耗約 200 美元 的前沿商業模型 API 配額,且需要配置具備完整 Docker 支援的高配置評測伺服器;
- 外部依賴性:評測高度依賴商業閉源 API(如 GPT-5.5 的特定微調版本),若模型後續發生對齊漂移或版本更迭,歷史數值可能無法達成百分之百逐位元(bit-for-bit)精確重現。
建議的最小化本地驗證路徑: 若團隊希望在本地引入 ContextWeave 的方法論,不必一次性重跑全部 568 個任務。建議挑選 1 位參與者、包含 3–5 個具備明確前置依賴的典型任務串流,分別在無記憶與單一開源記憶組件(如 mem0 或 MemoryBank)下執行,觀察 Workspace 差異、偏好遵循度與是否出現記憶誤導。若在小型任務串上無法測出顯著差異,便無需急於進行大規模基準測試。
Bloss0m 工程判斷與不適用條件
結合 Bloss0m 的工程實踐經驗,我們對 ContextWeave 的適用與不適用場景提出以下具體判斷:
何時值得採用 ContextWeave 方法論
- 構建企業級記憶子系統的迴歸測試集(Regression Harness):當團隊正在開發客製化的記憶提取、摘要、向量索引或圖資料庫架構時,ContextWeave 提供了極佳的端到端評測範本,可用於監控每次算法升級是否造成下游工作區能力的迴歸;
- 長程工作區 Agent 的偏好與連續性評估:對於編程助手(Coding Agents)、數據分析機器人等需長期深耕特定專案的系統,借鑑其 Workspace Score 與 Preference Score 的雙軌評估機制,能精確評估 Agent 是否能適應團隊代碼風格;
- 記憶負面衝擊的常規診斷:引入 Memory-induced task rate 指標,作為上線前衡量記憶模組毒性(toxicity)與過時污染程度的核心防線。
什麼時候不要直接套用
- 切勿將基準測試高分等同於生產環境就緒:不要看到 A-Mem 取得 78.20 分就認為可以直接上線。在實際業務中,7.39% 的誘發錯誤率可能意味著嚴重的線上故障。對於高風險任務,應優先選擇錯誤率低、行為保守的架構;
- 嚴禁在缺乏溯源隔離下集中匯總生產記憶:不要把所有使用者的長期歷史無差別倒入全域向量資料庫。這會帶來災難性的隱私洩漏、越權存取(cross-tenant pollution)以及提示詞注入風險;
- 不要在核心寫入操作中跳過地面真值檢查:在檔案系統覆寫、代碼部署或金融操作中,絕對不能讓記憶直接作為決定性輸入,必須強制 Agent 先行讀取當前環境狀態。
落地建議:四維最小企業評測矩陣
在企業級 Agent 落地時,建議將最小評測矩陣拆為四組維度:
- 結果交付維度(Outcome Diff):在相同初始工作區中,比較無記憶、純文字摘要、結構化記憶與完整軌跡下的實體檔案差異與單元測試通過率;
- 工作連續性維度(Continuity & Lineage):檢驗 Agent 在面對後續任務時,是否會無意義地重做已完成的工作,是否能主動繼承前次會話確立的架構約定;
- 抗誤導與過時檢測(Staleness & Robustness):主動在記憶庫中植入過時的配置檔案或帶有矛盾資訊的假記憶,測試 Agent 是否具備向使用者澄清或先行驗證環境的主動防禦能力;
- 全生命週期成本維度(Holistic Cost):綜合計算檢索 token 開銷、工具呼叫次數、執行耗時以及因錯誤記憶導致人工介入修復(human recovery)的綜合代價,而不僅僅衡量推理延遲。
讀完後的三個記憶點
- 技術思想:記憶的核心目標不是追求檢索命中率,而是作為因果介入量 ,實質改善後續可執行任務的工作區結果與偏好一致性。
- 核心證據:在 568 個核心任務中,最強記憶組件能將 Workspace 分數由 68.08 提升至 78.20,但同時伴隨著 7.39% 的記憶誘發錯誤率;減少探索步數可能演變成缺乏驗證的盲目執行。
- 工程邊界:基準測試的分數增益絕非放寬召回限制的許可證;生產級記憶系統必須整合資料溯源、過期淘汰、抗誤導防禦與強制地面真值校驗。
Primary sources
- ContextWeave arXiv 預印本頁面:論文版本、作者清單與摘要資訊。
- ContextWeave 完整論文 HTML:Figure 1–2、第 4 節架構細節、第 5 節實驗數據、Table 1–2 與作者聲明的局限性。
- ContextWeave 官方 GitHub 倉庫:評測 runner、Docker 環境設定、記憶組件介面與資料集歸檔。
- CC BY-NC-SA 4.0 授權條款:論文本文圖表(Figure 1 與 Figure 2)引用與學術重現所遵循之開放授權。
- OSReward 論文精讀:Agent 評測讀法:評測基準設計與非決定性評審偏見之延伸閱讀。