若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:語言 agent 已經能跟環境互動,但要從試錯裡學,傳統 RL 需要大量樣本與權重更新;只靠 in-context few-shot 又幾乎沒有「跨 episode 的可解釋經驗」。
- 核心洞見:不更新權重。把二值或純量回饋放大成語言反映,寫進 episodic memory buffer,再條件化下一次 trial。改動的控制點是跨 trial 的口語式 credit assignment,不是參數梯度。
- 最強證據:HumanEval (PY) Reflexion pass@1 91.0 vs GPT-4 單次生成 80.1(Table 1);ALFWorld heuristic 設定解出 130/134(Section 4.1);HotPotQA 報告相對強基線約 +20%(Section 4 開頭)。Rust 消融:完整 Reflexion 0.68,缺反映或只反映不測都會掉到 0.60/0.52(Table 3)。
- 主要邊界:需要可用的評測訊號;反映可以寫錯;多次 trial 有算力成本;記憶是滑動窗口(通常 1–3 條),不是企業級治理。WebShop 幾乎不提升(Figure 6);MBPP (PY) 甚至掉到 77.1。這不是權重學習,也不是可部署 runtime。
我的結論是:Reflexion 最值得保留的貢獻,是在凍結權重的情況下,把失敗經驗寫成短期語言記憶,供下一次 trial 使用。91% 是多次嘗試後的結果,不代表 GPT-4 單次生成提高 11 個百分點,也不代表模型完成了參數學習。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Shinn et al., NeurIPS 2023 對應的 arXiv:2303.11366 v4,首發於 2023-03-20,並在 2023-10-10 更新。v4 PDF 與 arXiv HTML 標示 CC BY 4.0。
除摘要外,本文核對 Actor/Evaluator/Self-Reflection 架構、Algorithm 1、ALFWorld/HotPotQA/程式實驗、主要表格,以及附錄中的 mug+desklamp 軌跡與 WebShop 結果。工件狀態核對至 2026-08-27。
這是已發表的 NeurIPS 論文,不是 preprint。論文正文仍寫 github.com/noahshinn024/reflexion;截至 2026-08-27 該 URL 回傳 404,可用 endpoint 是 noahshinn/reflexion(MIT)。本文不把後來的 Reflexion 變體、企業 memory 產品或 SWE-bench/ProMax 分數寫回這篇的表。
讀者真正要回答的問題
當一個語言 agent 已經會在環境裡行動,卻付不起梯度式 RL 時,能不能用「說出自己錯在哪」來代替權重更新?Reflexion 的回答是:可以,但前提是你有一個能判斷成敗的 Evaluator,以及一個把稀疏訊號放大成可執行語言經驗的 Self-Reflection 模型。
比較精確的讀法不是「91% 是不是新的 coding SOTA」。真正的問題是:凍結權重之後,跨 trial 的語言記憶到底改變了哪一步決策,又在什麼任務上因為評測訊號差、探索空間大或反映無幫助而失效?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Algorithm 1 與 Figure 2 定義 Actor/Evaluator/Self-Reflection/mem;Table 1 給出 HumanEval (PY) 91.0 vs GPT-4 80.1;Section 4.1 給出 ALFWorld 130/134;Figure 4(c) 顯示反映相對純 episodic memory 再 +8%;Table 3 給出 Rust 消融;Figure 6 顯示 WebShop 幾乎不提升。 |
| 作者主張 | 語言反映可當「語意梯度」;政策可參數化成 LLM 權重+記憶編碼;自我反映是較強模型的 emergent 能力。 |
| 論文未證明 | 91.0 不是單次生成;多次 trial 的算力/延遲未被系統報表化;滑動窗口記憶不是長期治理;反映正確性沒有形式保證;企業工具權限與副作用不在實驗範圍。 |
| Bloss0m 工程判斷 | 把 Reflexion 當跨 trial verbal credit assignment 來實作。單 trial 的 thought–action–observation 仍讀 ReAct。需要 issue 帳本時讀 ADIAS;需要測「是否真的從過去學會」時讀 PAST-Bench。 |
後文把數字、作者 claim 與工程判讀分開。「提升」只指論文報告的 setup。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2023 年初的缺口寫得很清楚。ReAct、SayCan、Toolformer、WebGPT 這類工作證明了語言核心可以驅動環境動作,但它們多半停在 in-context 教學:權重太大,梯度式 RL 又貴又慢。
相對地,傳統 RL 的 credit assignment 靠純量或向量報酬。作者認為這類訊號難以在語意空間裡精確告訴模型「哪一步該怎麼改」。Self-Refine 等 refinement 迴圈多半服務單次生成任務,不一定留下跨 trial 的持久經驗緩衝。
因此,舊方法不夠的地方不是「模型不夠會想」,而是學習訊號放錯層:要么只在單次生成裡 refinement,要么付權重更新的成本。Reflexion 改的正是這個控制點——用語言經驗做跨 episode 的政策條件化。
核心直覺 / Core intuition
先不要看表格。想像一個人在廚房連續失敗兩次:第一次先找杯子再找燈,結果燈早就在同一張桌上;第二次他對自己說「應該先開燈再找杯子」,然後把這句話記在便條上。下一輪開始時,他不是改大腦結構,而是先讀便條。
Reflexion 把這份分工寫進系統:
- Actor :產生文字與動作(可用 CoT 或 ReAct)。
- Evaluator :對整條 trajectory 打分——可以是環境二值成功、heuristic、自產單元測試,或另一個 LLM 分類器。
- Self-Reflection :把稀疏報酬放大成語言經驗 。
- Memory :把 append 進去;實務上用容量 (通常 1–3)的滑動窗口,以免撐爆 context。
政策被寫成 ,其中 。權重不動;變的是條件化 Actor 的長期記憶。
這與 ReAct 的差異要講清楚:ReAct 改的是同一條 trial 內下一步是 thought 還是環境動作;Reflexion 改的是trial 與 trial 之間如何把失敗寫成可重用的語言提示。Actor 可以是 ReAct——論文在 ALFWorld 與部分 HotPotQA 正是這樣做——但 Reflect 步驟發生在 reset 之後。
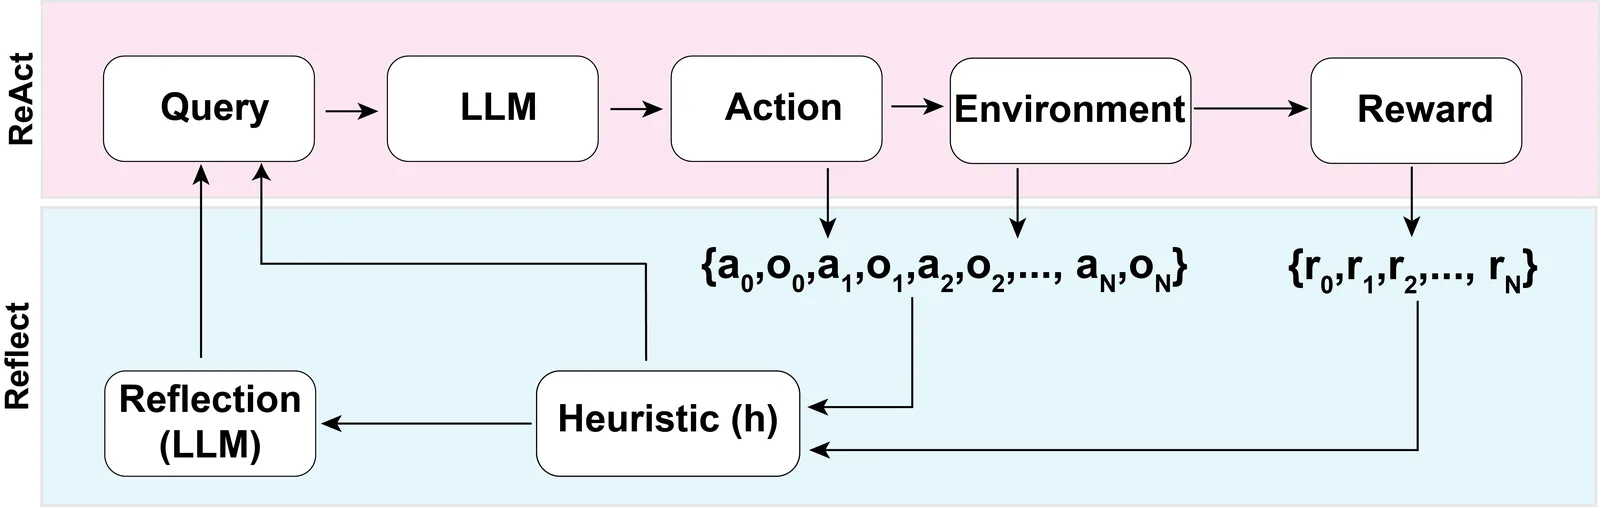
Figure 2,論文 Section 3:左邊是環境與外部/內部回饋,中間是 Actor 產生 trajectory(短期記憶),Self-Reflection 寫出 reflective text 進入長期記憶,再條件化下一次行動。右側是 Algorithm 1。原圖可定位到 Figure 2,SVG endpoint 為 reflexion_rl.svg。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

用一個例子走完整個方法 / Walk one example through the method
以下是 Appendix B 的 ALFWorld 例子:任務是 examine the mug with the desklamp。這是論文自己的定性軌跡,不是獨立實驗分數。
- Input:房間觀察列出 bed、desk 1/2、多個 drawer 與 shelf;任務要求用桌燈檢查馬克杯。
- Intermediate representation:Trial #1 的 Actor(ReAct 風格)先 plan「找 mug → 拿起 → 找 desklamp → use」。它在多個 drawer 空轉後,終於在 desk 1 同時看到 mug 與 desklamp,卻先 take mug,再離開找燈,最後對不存在於當前位置的燈反覆
use,得到 Fail。 - Model or system decision:Evaluator(此處是任務失敗訊號/heuristic)判定失敗。Self-Reflection 寫出:計劃順序錯了——任務是 examine mug with desklamp,應先找燈;而且 desk 1 已經同時有兩者。這段 被 append 進 。
- Output:環境 reset 後的 Trial #2 直接
go to desk 1,take mug,再use desklamp 1,Success。 - Likely failure point:若反映寫成錯誤因果(例如怪罪「drawer 太多」而不是順序),或 WebShop 那種需要大幅換搜尋策略的任務,下一 trial 會把錯教訓當提示。Appendix B.1 正是這類失效。
技術機制 / Technical mechanism
Algorithm 1 把迴圈寫死:
- 用當前 生成 trajectory 。
- 。若通過或達到 max trials,結束。
- 。
- ,必要時截斷到 。
- ,重跑。
各任務的 Evaluator 不同,這會直接改變「學到什麼」:
| 任務 | Actor | Evaluator 訊號 | Memory 上限(論文實務) |
|---|---|---|---|
| ALFWorld | ReAct(GPT-3 few-shot) | 環境完成訊號;另用 heuristic(同動同觀超過 3 次,或步數>30)或 LLM 二值分類觸發反映 | 最近 3 條反映 |
| HotPotQA | CoT/ReAct | 答案 exact match(EM)二值 | 3 條經驗;失敗可重試至連續 3 次失敗 |
| Programming | 函式本體生成 | 自產單元測試(最多 6 個,經 AST 過濾) | 1 條經驗 |
程式設定特別關鍵:作者用自產測試來維持 pass@1 資格——不偷看隱藏測試。這讓 91.0 可以寫進 pass@1 欄,但也把正確性綁在「測試寫得好不好」。Table 2 的 FP(測試全過但解錯)在 MBPP (PY) 是 0.16,在 HumanEval (PY) 只有 0.01;作者用這個差距解釋為什麼 HumanEval 能到 91、MBPP 反而掉到 77.1。
實驗如何讀 / How to read the evidence
ALFWorld:跨 trial 搜尋與糾錯
問題:在長軌跡家庭任務上,ReAct 卡在幻覺持有物或低效計畫時,語言記憶能不能解鎖更多環境?
控制:134 個環境、六類任務;兩條 few-shot;ReAct-only 在建議反映時只 reset、不寫記憶;Reflexion 寫記憶後再試;最多觀察約 12 個 iterative learning steps。
觀察:ReAct + Reflexion(heuristic)完成 130/134。作者報告相對強基線約 +22%(Section 4 開頭)。ReAct-only 的提升在 trial 6–7 附近停住;Reflexion 曲線在前兩 trial 急升,之後緩慢爬到近完美(Figure 3)。
解釋:長軌跡早期錯誤可被蒸餾成「下一步換計畫」;空間太大時,多 trial 記憶可累積已搜過的表面。這是跨 trial 機制,不是單次 ReAct thought 變強。
邊界:GPT-3 Actor;環境動作空間可觀察。換到 WebShop 這種搜尋歧義大、合法動作不那麼「看得見」的設定,同一套方法幾乎無效。
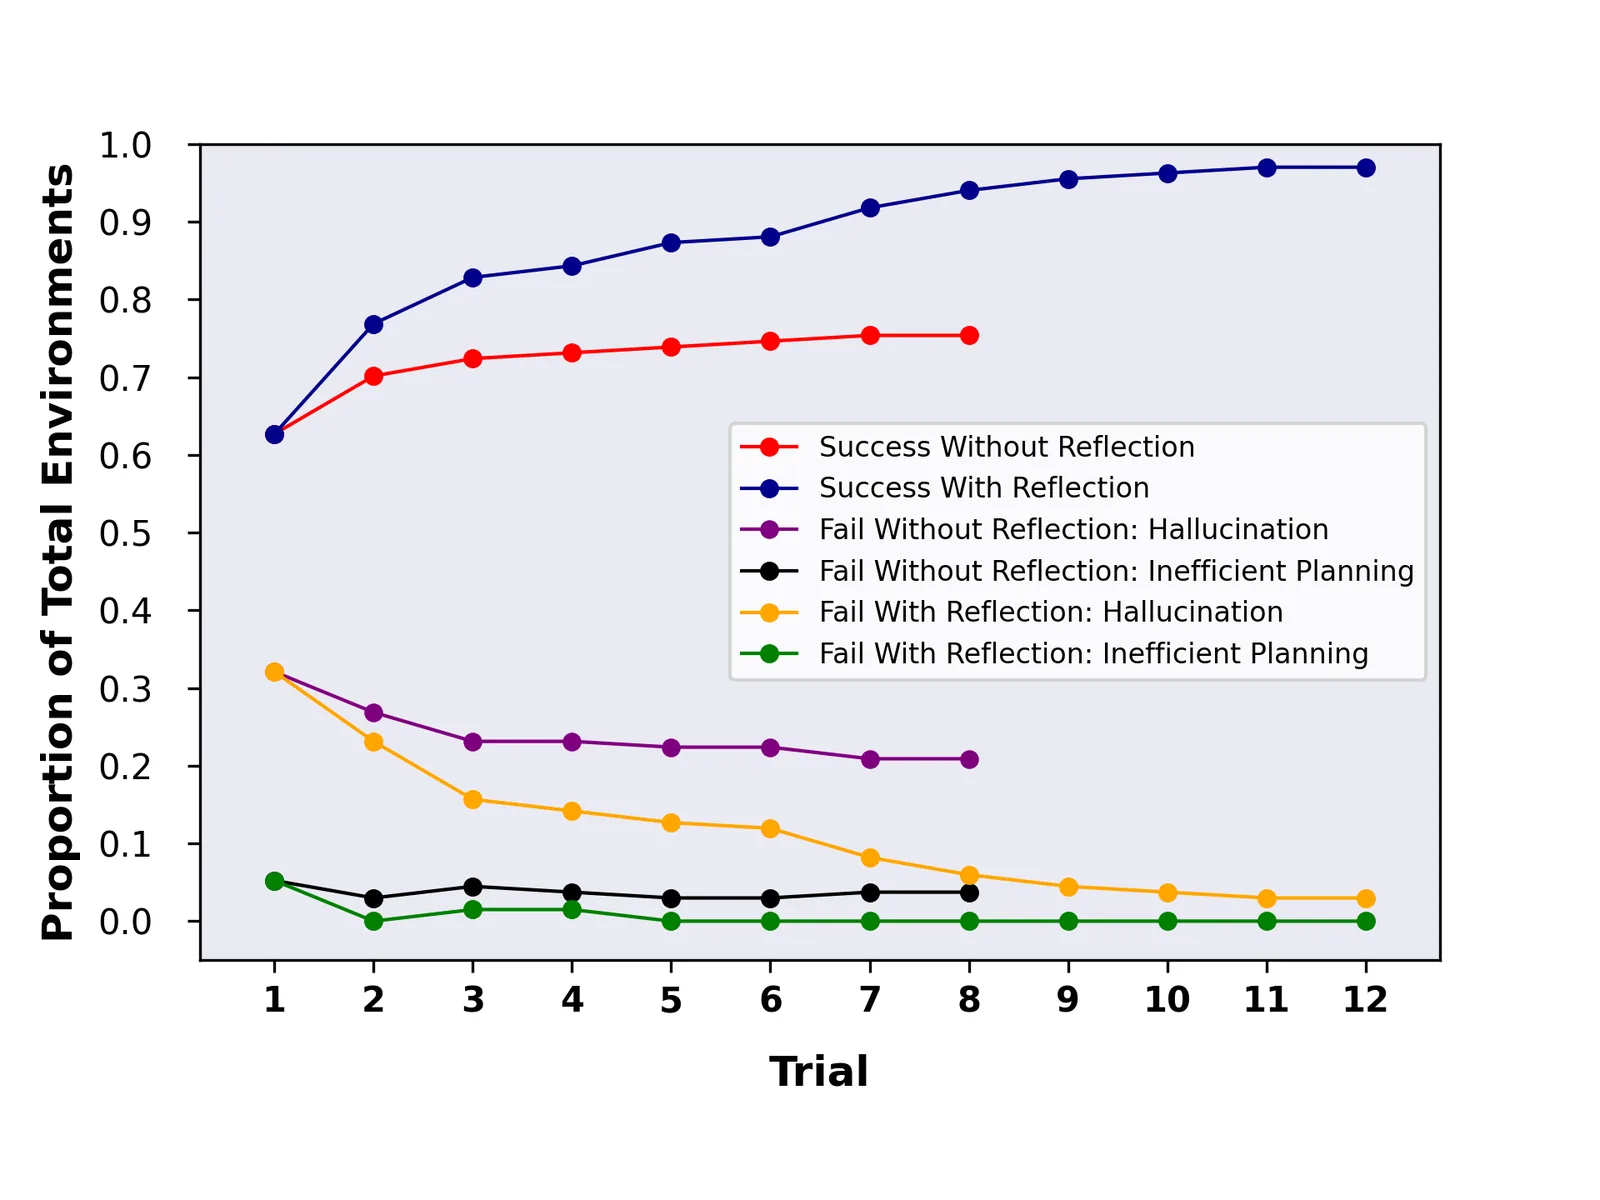
Figure 3,論文 Section 4.1:(a) heuristic/GPT 自評兩種觸發下的學習曲線;(b) 失敗原因分類。原圖可定位到 Figure 3;對應曲線素材見 alfworld_success.svg。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

HotPotQA:推理與「只記軌跡」消融
問題:把二值 EM 放大成第一人稱語言反映後,搜尋型 QA 與給定 gold context 的純推理能不能改善?
控制:100 題樣本;CoT 6-shot、ReAct 2-shot、反映 2-shot;CoT (GT) 提供 ground-truth context 以隔離推理;溫度 0.7 下,基線幾乎無法在後續 trial 偶然解對先前失敗題。
觀察:作者報告相對基線約 +20%(Section 4)。CoT (GT) 仍有 39% 錯,Reflexion 在無 ground-truth 答案的條件下再改善約 14%。Figure 4(c) 的消融:只加最近軌跡的 episodic memory(EPM)有幫助,但完整 Reflect 再給約 +8% absolute。
Appendix Table 5 補上 backbone 切片(仍是 100 題設定):例如 CoT (GT)+GPT-4 從 0.68→0.80;ReAct+text-davinci-003 從 0.30→0.55。數字隨模型變,但方向一致。
解釋:單純重放失敗軌跡不如「用語言指出該改哪」。這支持作者把 Reflect 當成語意梯度的說法,但仍依賴 EM 這種乾淨二值訊號。
邊界:100 題樣本;EM 不是開放式答案評測;CoT (GT) 有答案上下文,不能直接外推成「閉卷搜尋已解決」。
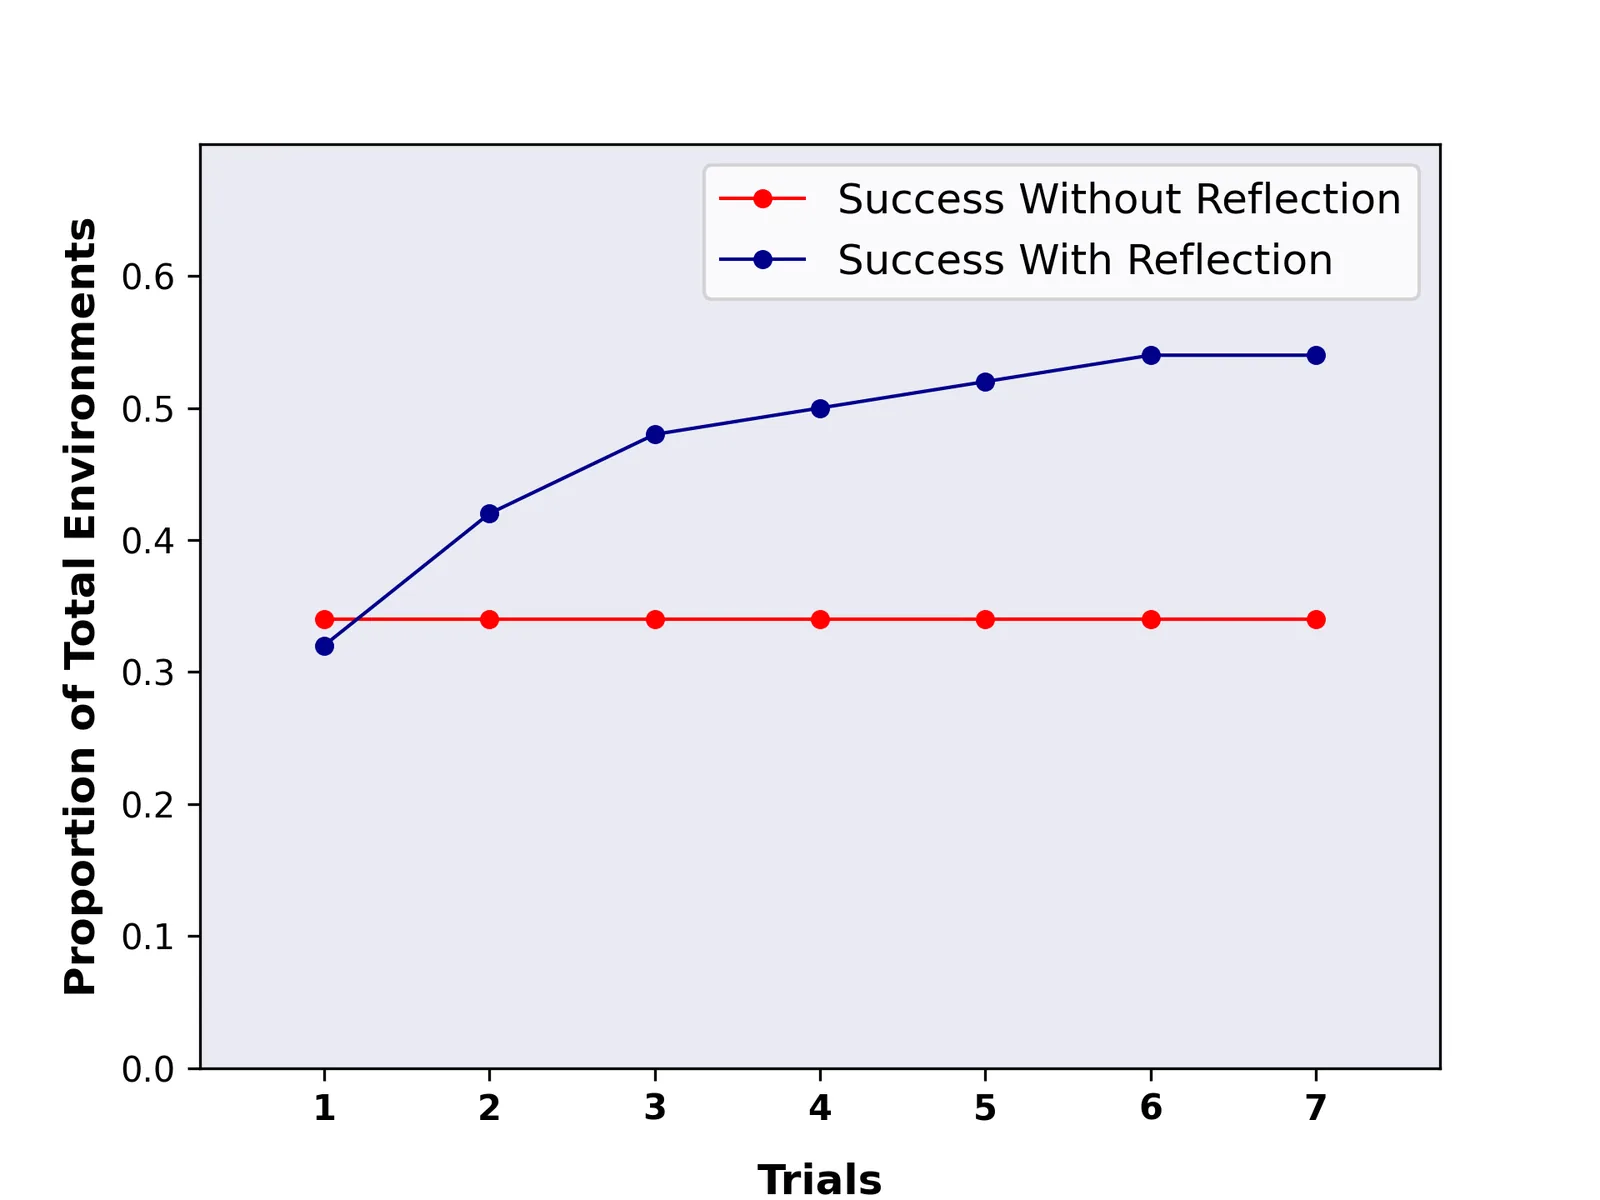
Figure 4,論文 Section 4.2:(a) CoT/ReAct ± Reflexion;(b) CoT (GT);(c) EPM vs EPM+Reflect。原圖可定位到 Figure 4;面板素材見 hotpotqa_success.svg 等。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

Programming:91.0 的分母與消融
問題:在可用編譯器/直譯器的程式任務上,自產測試+語言反映能不能提高 pass@1?
控制:HumanEval/MBPP 的 Python 與 Rust(MultiPL-E 翻譯);LeetcodeHardGym 40 題(GPT-4 cutoff 後);指令模型 zero-shot 函式本體;自產測試最多 6 個;memory=1。
觀察(Table 1):
| Benchmark | Prev SOTA | SOTA(單次) | Reflexion |
|---|---|---|---|
| HumanEval (PY) | 65.8(CodeT+GPT-3.5) | 80.1(GPT-4) | 91.0 |
| HumanEval (RS) | — | 60.0(GPT-4) | 68.0 |
| MBPP (PY) | 67.7(CodeT+Codex) | 80.1(GPT-4) | 77.1 |
| MBPP (RS) | — | 70.9(GPT-4) | 75.4 |
| Leetcode Hard (PY) | — | 7.5(GPT-4) | 15.0 |
Table 2 把 Base/Reflexion 與測試品質一起列:HumanEval (PY) Base 0.80→0.91;MBPP (PY) 0.80→0.77。作者指出分析段落寫 baseline「約 82%/80%」時,應以 Table 1/2 的 80.1/0.80 為準來報 headline。
Table 3(HumanEval Rust 最難 50 題,GPT-4):
| Approach | Test gen | Reflect | Pass@1 |
|---|---|---|---|
| Base | ✗ | ✗ | 0.60 |
| 省略測試 | ✗ | ✓ | 0.52 |
| 省略反映 | ✓ | ✗ | 0.60 |
| Reflexion | ✓ | ✓ | 0.68 |
解釋:測試提供「能不能早停/哪裡錯」;反映提供「怎麼改」。少任何一邊,在這個困難切片上都不比基線好——省略測試甚至更差,因為模型會在不確定對錯時持續有害改寫。
邊界:91.0 依賴自產測試品質;FP 高時會提早交出錯解(MBPP)。starchat-beta 上 Table 4 是 0.26 vs 0.26——作者認為自我修正能力隨模型強度出現,不是萬能 prompt 模式。多次 trial 的 token 成本未在主表攤開。
WebShop:探索不足的失敗模式
問題:同一套 ReAct+Reflect 在電商搜尋這種高歧義任務上是否仍有效?
控制:100 個客戶請求;two-shot ReAct+Reflexion;觀察約 4 個 trial 後終止。
觀察:Figure 6 上 Reflexion 幾乎不顯著超過 ReAct;反映也不直觀有用。作者結論:需要大量多樣性與探索的任務,Reflexion 容易卡在 local minima。
邊界:這是論文自己提供的反例,不是外部挑刺。它限制「任何失敗都能靠寫反思修好」這種工程口號。
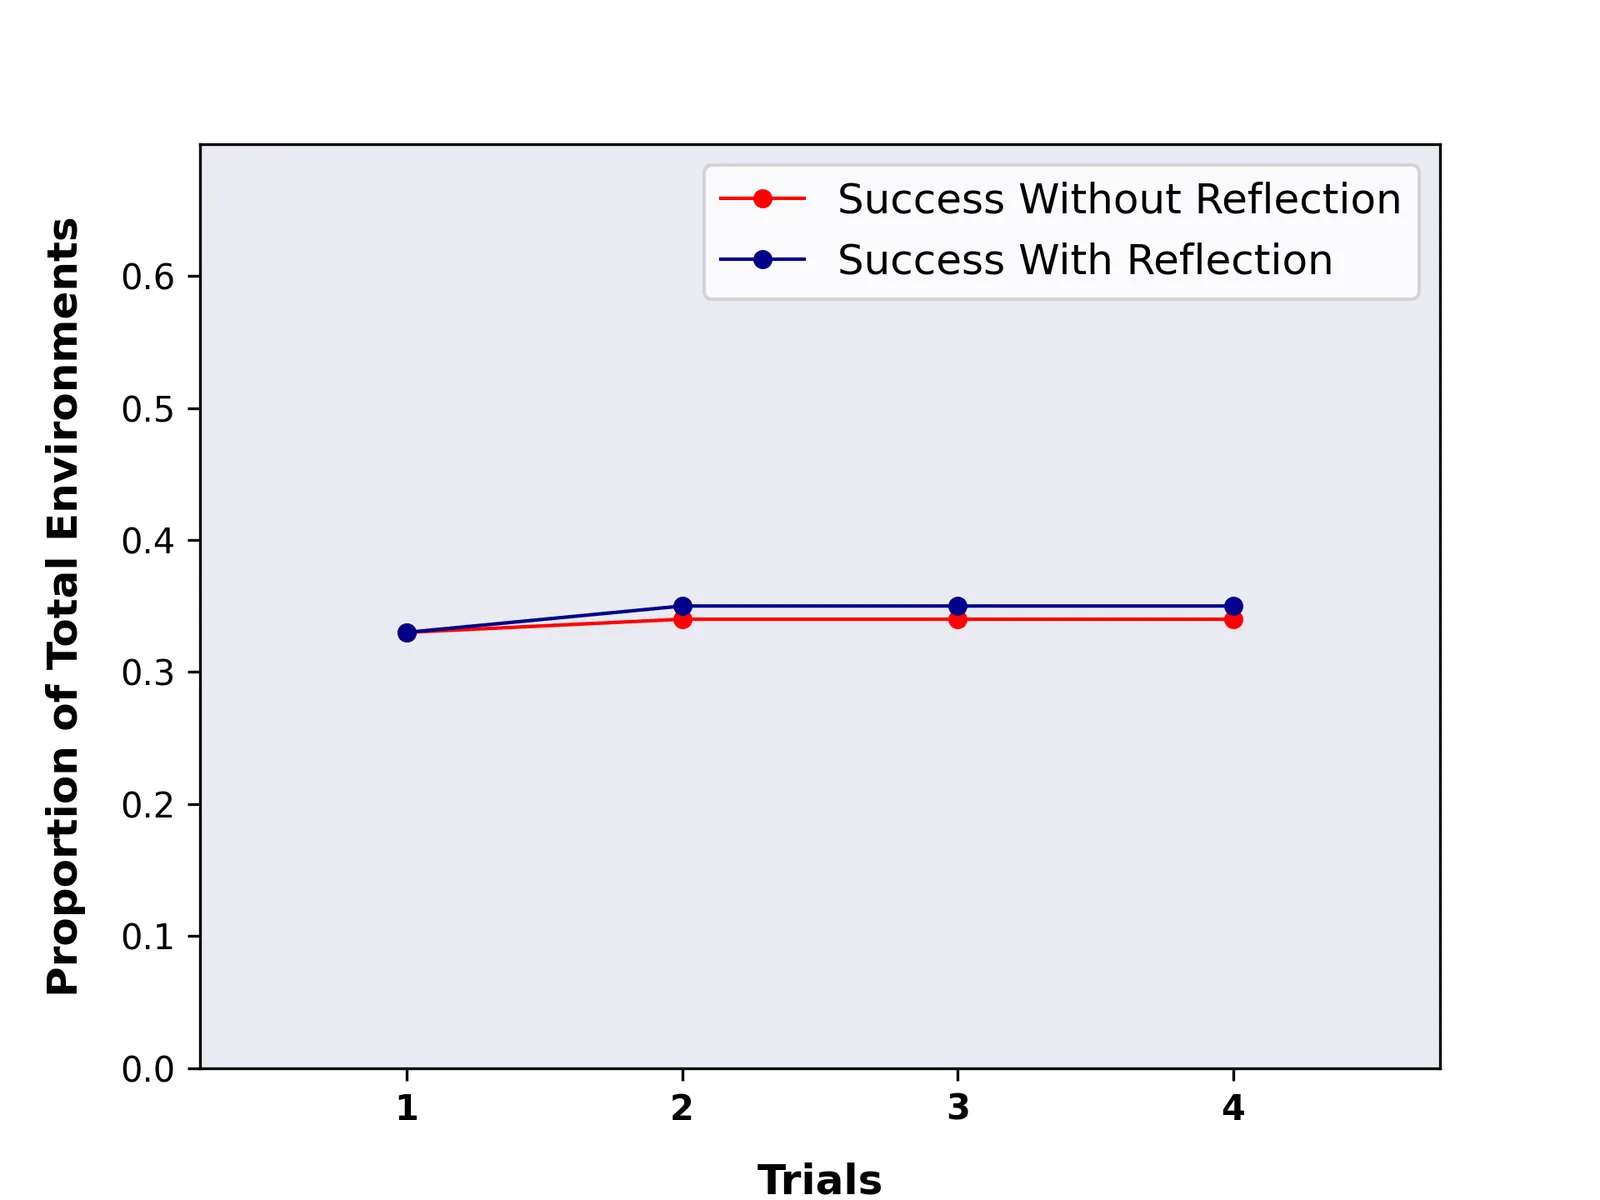
Figure 6,論文 Appendix B.1:四個 trial 內看不到穩定拉開。原圖可定位到 Figure 6,SVG 為 webshop_success.svg。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

限制、威脅與不該過度推導的話 / Limitations and threats to validity
Section 5 與全文邊界可以收成工程清單:
- 仍可能陷入 local minima。 WebShop 是實證。
- 記憶只是有容量上限的滑動窗口。 作者建議未來接向量庫或 SQL;那是未來工作,不是這份系統。
- 程式的測試驅動假設脆弱。 非確定、有副作用、硬體相依、並發行為都難寫成穩定 I/O 測試。
- 反映沒有正確性保證。 錯反映會污染下一 trial。
- 算力與延遲。 每個失敗都可能再跑完整 trial;主表報的是最終正確率,不是單位成本。
- 不是企業記憶治理。 沒有權限、遺忘、稽核、rollback 契約——那些要另讀 Argus 一類 runtime。
- 分開不同評測的證據。 本篇程式實驗使用 HumanEval、MBPP 與 LeetcodeHardGym;SWE-bench/ProMax 的評測單位不同,分數不能直接比較。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 Reflexion?當你已經有可自動判定的成敗訊號(測試、明確任務完成、可靠 heuristic),而且願意把「反映文字」當成可審查的跨 trial 狀態;同時能接受多試幾次的成本,並把 memory 截斷策略寫進協議。
什麼時候不要把它當施工圖?
- 需要單 trial 內 thought 與工具交錯時,先讀 ReAct。Reflexion 不取代那份契約。
- 需要訓練時學會「何時插入 API」時,讀 Toolformer。
- 需要 issue 級帳本、避免重複無效修復時,讀 ADIAS。Reflexion 的 是短文本窗口,不是 issue lifecycle。
- 需要證明「分數上升真的來自保留經驗」時,讀 PAST-Bench。
- 需要真實 GitHub issue 的執行式評測基板時,讀 SWE-bench。不要把 HumanEval 91.0 寫進 SWE-bench 協議。
- 沒有可靠 Evaluator、探索空間極大、或反映無法人工抽查時:不要上。WebShop 與 MBPP FP 就是警告。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v4 PDF、HTML 可讀,license 為 CC BY 4.0。NeurIPS 2023 論文頁 可開啟。
- 程式:論文印刷的
noahshinn024/reflexion目前 404。可用 repo 為 noahshinn/reflexion(MIT;README 標 NeurIPS 2023)。內含 HotPotQA notebooks、程式實驗與 log;需要OPENAI_API_KEY等外部 API,不是一鍵重跑 Table 1 的離線 bundle。 - LeetcodeHardGym:README 指向 GammaTauAI/leetcode-hard-gym;另行驗證,不自動等於本篇所有程式數字可重現。
- 資料/環境:ALFWorld、HotPotQA、HumanEval、MBPP 皆為既有基準;論文未附「同一 100 題索引+完整 API 快照」的單一封存。
- 最小有用 reproduction:跑 HotPotQA notebook 中單一 agent 設定,或對一題 HumanEval 走「生成→自測→反映→再生成」迴圈並人工檢查 。這只能驗證機制方向,不能宣稱重現 91.0。
- 安全註記:Section 8 提醒自主寫碼實驗應使用隔離執行環境;生成碼執行前未驗證。
三個記憶點 / Three things to remember
- 技術想法:Reflexion 用凍結權重的語言反映,把稀疏回饋寫進 bounded episodic memory,做跨 trial 的口語式 credit assignment。
- 證據:HumanEval (PY) 91.0 vs GPT-4 80.1;ALFWorld 130/134;HotPotQA 約 +20%,反映相對純記憶再 +8%;Rust 消融顯示測試與反映缺一不可。
- 邊界:需要可用評測訊號;反映可錯;多次 trial 有成本;WebShop/MBPP/弱模型顯示它不是萬能重試器,更不是參數學習或企業記憶治理。
延伸閱讀
Reflexion 處理的是「失敗之後如何用語言記住教訓」。接下來可依問題選讀:
- 同一 trial 內交錯 thought 與 action:ReAct。
- 訓練時插入 API:Toolformer。
- 真實 GitHub issue 的成功定義:SWE-bench。
- 把修復進度變成 issue 帳本:ADIAS。
- 驗證分數提升是否來自保留經驗:PAST-Bench。
- runtime 權限與 rollback:Argus。