若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:LLM 能在單一時間點產生像人的行為,但長期連貫的 believable agent 需要隨互動增長的記憶、跨 agent 的社會動態,以及把過去經驗用來規劃下一步——只靠更長 prompt 或單次生成不夠。
- 核心洞見:把每個 agent 的完整經驗以自然語言寫進 memory stream,用 reflection 週期合成高階推論,再用 relevance/recency/importance 檢索相關記憶來 plan 與 react;25 個 agent 在 Smallville 沙盒中互動,記憶控制平面是「社交模擬的觀察–反思–計畫」,不是 MemGPT 對單一 agent 的 OS 式 context 分頁。
- 最強證據:訪談消融(Figure 8)上完整架構 TrueSkill μ 29.89(σ=0.72),優於無反思(26.88)、無反思+規劃(25.64)、眾包基線(22.95)、完全消融(21.21)。兩天開放模擬(Section 7.1):市長資訊持有者 4%→32%、派對資訊 4%→52%;關係網路密度 0.167→0.74;派對 12 人受邀、5 人到場。
- 主要邊界:沙盒+ChatGPT,模擬兩天遊戲時間成本「數千美元 token、多天運行」(Section 8.2);常見失效是檢索不到相關記憶、捏造 embellishment、instruction tuning 帶來過度正式語氣。不是生產 ACL 記憶、不是 Reflexion 的跨 trial 語言 credit assignment,也不是後來 Letta/xMemory 產品或 benchmark 數字。
我的結論是:Generative Agents 最值得保留的貢獻,是在多人沙盒中用記憶流、反思與檢索式規劃支撐可信行為。沙盒訪談分數與派對案例不能直接代表可上線的企業記憶層,也不能和 MemGPT 的 DMR 92.5% 放在同一張表比較。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Park et al., UIST 2023 對應的 arXiv:2304.03442 v2,首發於 2023-04-07,並在 2023-08-06 修訂。作者順序依 PDF:Joon Sung Park、Joseph C. O’Brien、Carrie J. Cai、Meredith Ringel Morris、Percy Liang、Michael S. Bernstein。
除摘要外,本文核對 Section 3–4 的 Smallville 與架構、Section 6 的訪談消融、Section 7 的兩天開放模擬、Figure 2/4/5–8,以及截至 2026-08-28 的工件狀態。
這是 UIST 2023 會議論文(ACM 出版),不是僅限 arXiv 的 preprint 敘事。底層 LLM 為 ChatGPT(論文引用 OpenAI 2022)。本文不把後來 Letta 產品指標、LoCoMo、xMemory 或 MemGPT DMR 92.5% 寫回這篇的表。
讀者真正要回答的問題
當你要模擬 believable 的多人社交行為,而不是只讓一個 chatbot 回一句話時,記憶架構該長什麼樣?Park et al. 的回答是:每個 agent 維護可增長的語言記憶流,週期反思、檢索後規劃,並在沙盒裡與其他 agent 互動。
比較精確的讀法不是「Smallville 是不是 AGI」。真正的問題是:觀察–反思–計畫這條記憶控制平面,在什麼證據下提升 believability,又在哪裡因檢索失敗、捏造或沙盒規範不清而崩潰? 以及它與 MemGPT「單 agent OS 分頁」差在哪一層。
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 5 定義 memory stream/檢索/反思/規劃迴圈;Figure 6–7 說明檢索三因子與反思樹;Figure 8 給訪談消融 TrueSkill;Section 7.1 給兩天模擬的資訊擴散、關係密度、派對出席數字;Figure 4 定性展示情人節派對鏈。 |
| 作者主張 | 觀察、規劃、反思對 believability 皆關鍵;LLM+適當架構可產生個體與湧現社會行為;架構可支援角色扮演、社會原型等應用。 |
| 論文未證明 | 生產環境 SLA、企業權限與稽核;長週期(遠超兩天)穩定性;開放權重複現;對抗 prompt/memory hacking 的魯棒性;眾包基線等於專家上限。 |
| Bloss0m 工程判斷 | 本篇處理多人沙盒中的語言記憶。單 agent context 分頁見 MemGPT;跨 trial 語言反思見 Reflexion;階層記憶建構見 xMemory。三者的問題設定與證據不能直接互換。 |
後文把數字、作者 claim 與工程判讀分開。
先前方法為何不足 / Why the previous approach is insufficient
Section 1–2 把缺口寫成兩層。
單時間點 LLM 行為:大型語言模型能在單次提示下模擬像人的回應,但缺乏隨互動增長的記憶與跨時間規劃時,agent 會「當下可信、長期不可信」——例如反覆在 12:00、12:30、13:00 各吃一次午餐(Section 4.3 的例子)。
缺乏社會動態的架構:Believable agent 文獻長期追求 NPC 與社會模擬,但要在多 agent 環境裡維持關係、資訊擴散與協調,需要能檢索長期觀察、合成反思、並把結論寫回記憶流——不是只把 transcript 塞進視窗。
相對地,Reflexion 解的是跨 trial 如何把失敗寫成語言經驗;MemGPT 解的是單一 agent 如何把有限 context 當 RAM、用函式在外部 recall/archival 間分頁。Generative Agents 改的是同一沙盒時間線內、多 agent 並存時,如何用自然語言記憶流支撐 believable 的觀察、反思與計畫。
核心直覺 / Core intuition
先不要看 TrueSkill。想像小鎮上有 25 個人,每人一本只屬於自己的日記(memory stream):今天遇見誰、爐子燒焦、聽說誰要選市長——全都用句子記下來。
當要決定「現在幹嘛」時,不是翻整本日記,而是依相關性(跟當前情境像不像)、新近性(剛發生的事)、重要性(LLM 打的 1–10 分)挑出幾頁。累積的重要事件夠多(重要性總和超過 150)時,agent 反思:把近期觀察合成「我對自己的看法」或「我對某人的看法」,再寫回日記。最後用規劃先排一天大綱,再遞迴細化成可執行動作——計畫本身也進日記,供之後檢索。
這與 MemGPT 的對照要講清楚:
| 維度 | Generative Agents | MemGPT |
|---|---|---|
| Agent 數 | 25 人在 Smallville 互動 | 架構針對單一 LLM processor |
| 記憶單元 | 自然語言觀察/反思/計畫 | main context vs external recall/archival |
| 控制機制 | 檢索打分+週期反思+階層規劃 | 函式呼叫分頁、request_heartbeat 鏈 |
| 證據類型 | 訪談 believability、兩天社會模擬 | DMR 正確率、Nested KV 多跳查詢 |
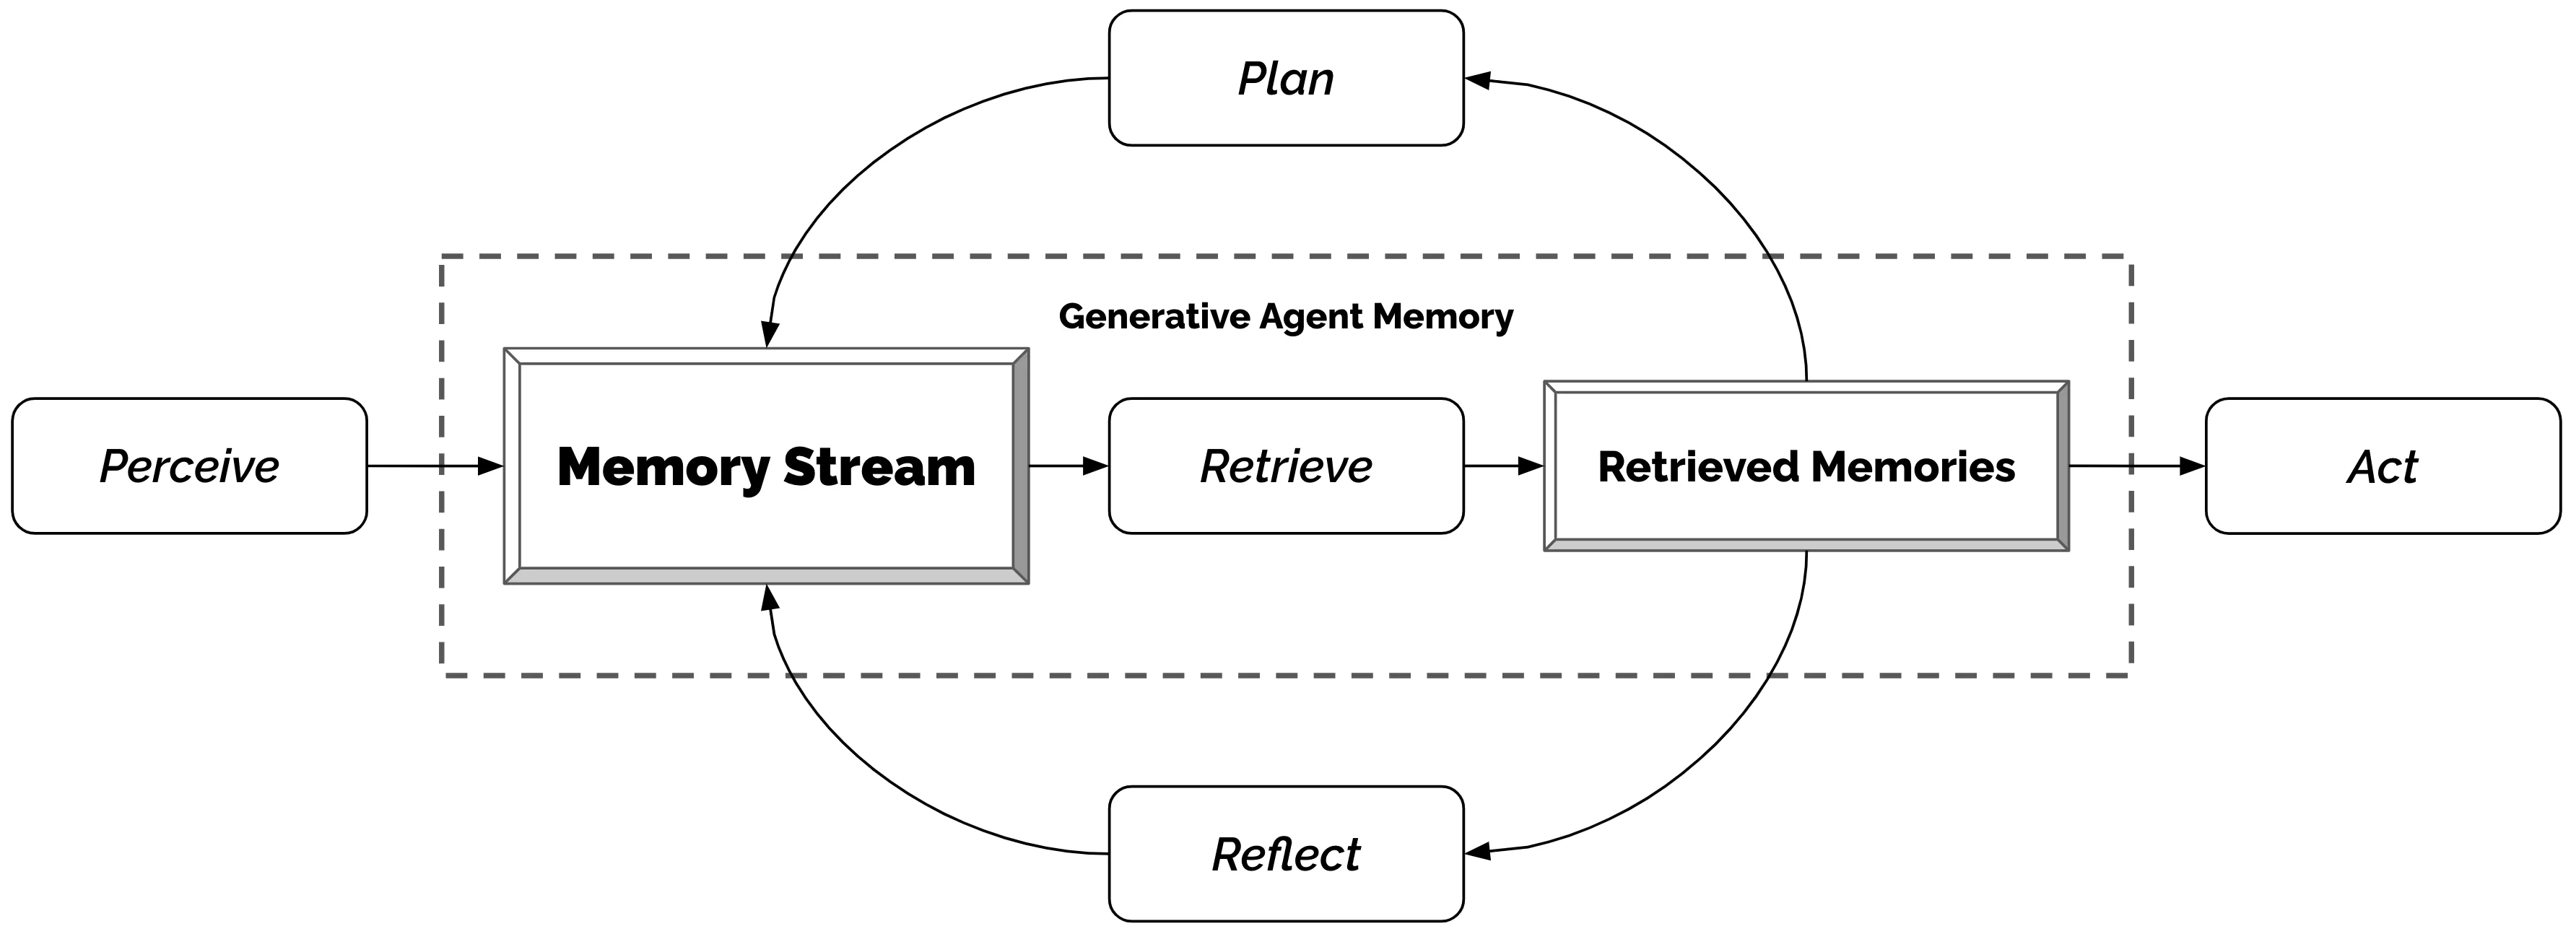
Figure 5,論文 Section 4:agent 感知環境,所有感知存入 memory stream;檢索相關記憶以決定行動,並形成反思與計畫寫回 stream。原圖可定位到 Figure 5,圖檔 figure_architecture2.png。取自 arXiv HTML/對應圖檔;頁面標示 arXiv.org perpetual non-exclusive license。

用一個例子走完整個方法 / Walk one example through the method
以下依論文情人節派對敘事(Figure 4、Section 3.4)整理成可教路徑。數字來自 Section 7.1 的兩天模擬,不是獨立 benchmark。
- Input:使用者只告訴 Isabella「想辦情人節派對」;另有一位 agent Maria 對 Klaus 有好感(初始化種子記憶)。Smallville 有 25 個 agent、咖啡館 Hobbs Cafe 等地點(Figure 2)。
- Intermediate representation:Isabella 的計畫與邀請、裝飾、找人幫忙等觀察寫入她的 memory stream;她與他人對話時,對方把「有派對」寫入各自 stream。資訊透過對話擴散——兩天後知道派對的 agent 從 1(4%)增到 13(52%),且作者逐條對照 memory stream 排除憑空捏造。
- Model or system decision:被邀請的 agent 需「聽說→決定出席→在對的時間到對的地點」。12 人受邀、5 人到場;未到場者訪談顯示日程衝突或「有興趣但未排進計畫」。
- Output:2 月 14 日 17:00 五人出現在 Hobbs Cafe(含 Klaus 與 Maria);部分邀請與調情由架構自發產生,非手寫劇本。
- Likely failure point:檢索不到邀請記憶、把地點記錯、或 instruction tuning 讓 agent 過度答應與他人提案(Section 7.2)——派對仍「辦成了」,但出席率與對話禮貌度是邊界訊號。
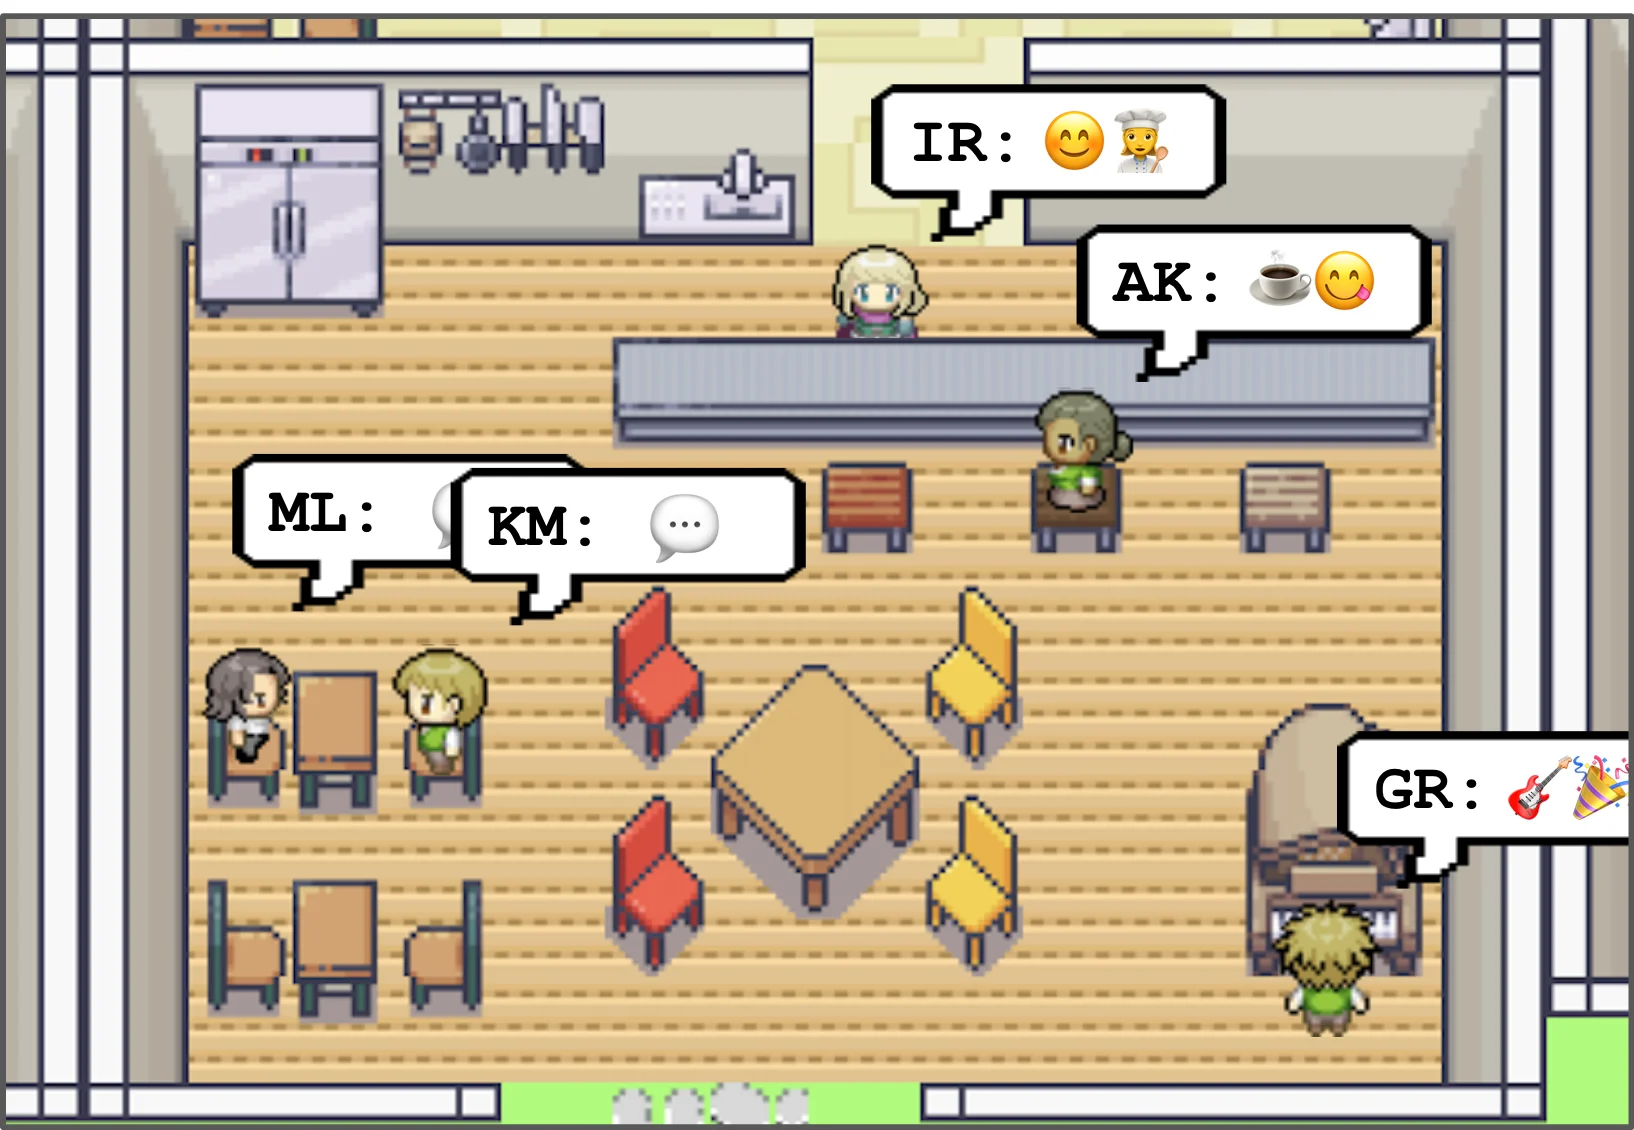
Figure 4,論文 Section 3.4:模擬開局一位 agent 想辦情人節派對;儘管遺忘、未告知、未出席等失敗點很多,派對仍發生並有多人互動。原圖 Figure 4。取自 arXiv HTML;arXiv reuse terms。
技術機制 / Technical mechanism
Memory stream 與檢索
所有觀察以自然語言物件存入 stream。檢索對候選記憶算加權分:
實作要點(Section 4.2):
- Recency:自上次檢索起的 sandbox 遊戲小時數指數衰減,衰減因子 0.995。
- Importance:建立記憶時用 LLM 輸出 1–10 整數(例:整理房間 2、約 crush 8)。
- Relevance:查詢記憶與候選記憶 embedding 的 cosine similarity。
- 三項 min-max 正規化到 [0,1],論文實作 α 皆為 1;top 記憶塞進 context window。
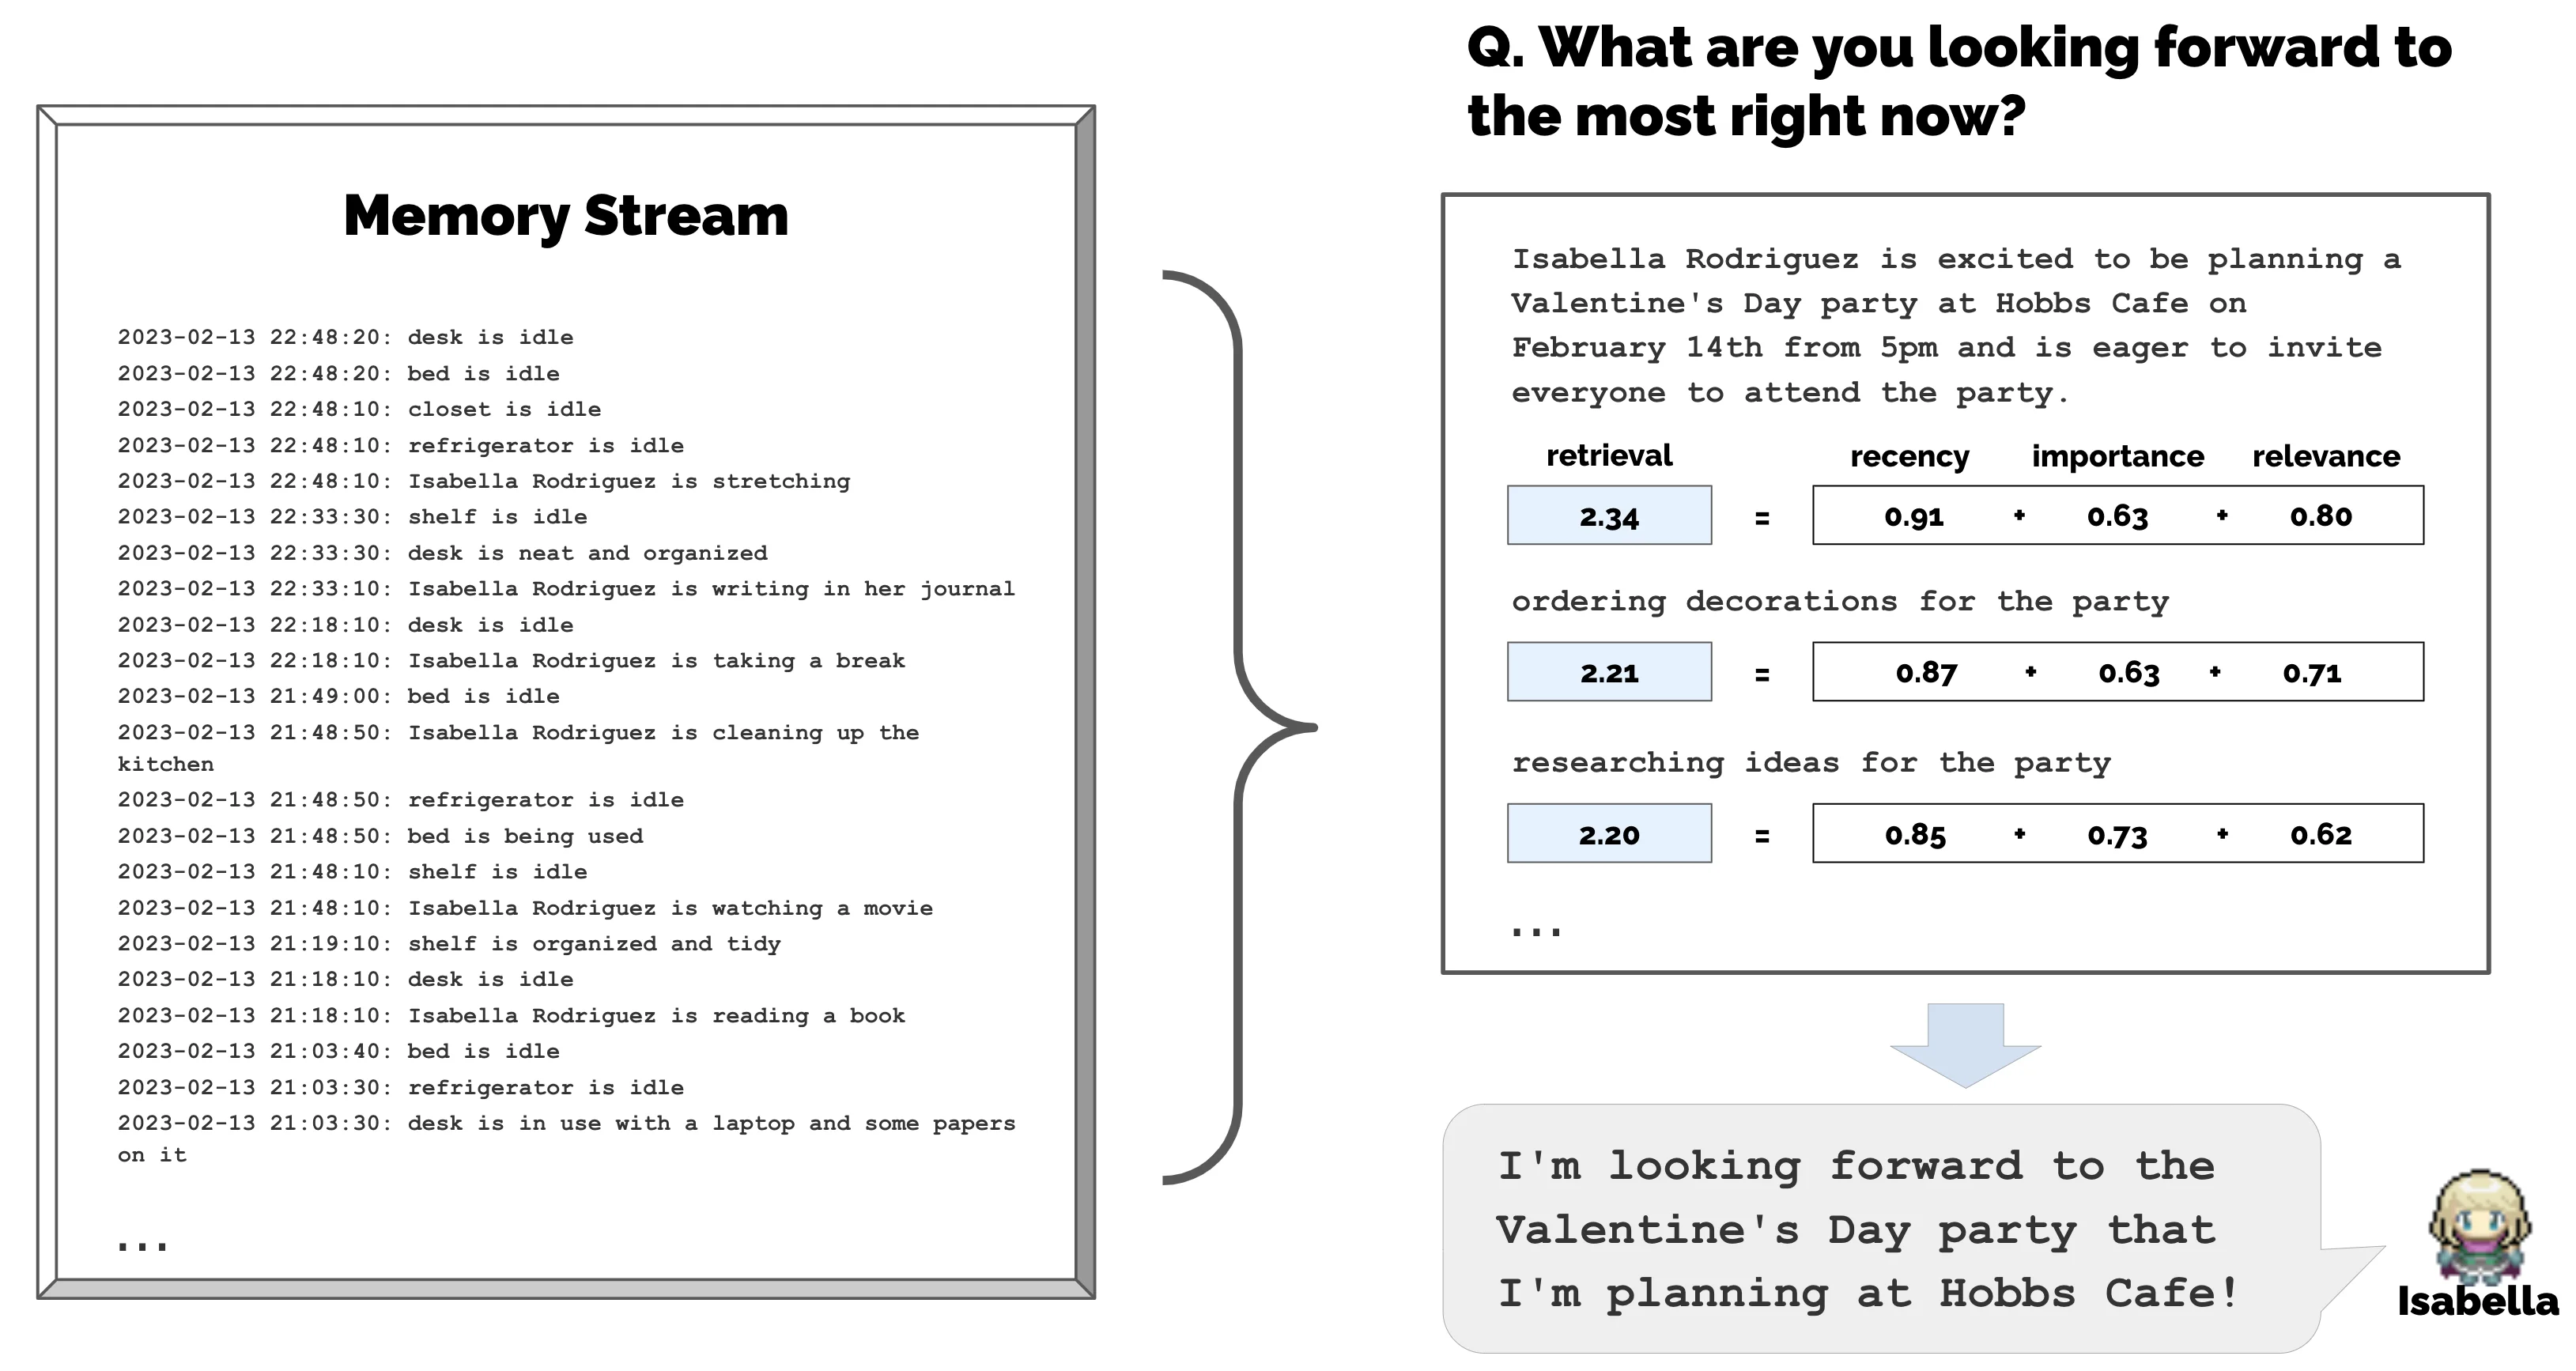
Figure 6,論文 Section 4.2:左側大量觀察,右側依問題檢索出派對相關記憶並生成回應。原圖 Figure 6。取自 arXiv HTML;arXiv reuse terms。
Reflection
當近期感知的重要性分數總和超過閾值 150 時觸發(約 每天 2–3 次):先由 LLM 提出可反思的問題,再根據相關記憶合成更高階陳述寫回 stream(Figure 7)。反思與一般觀察一樣可被檢索。
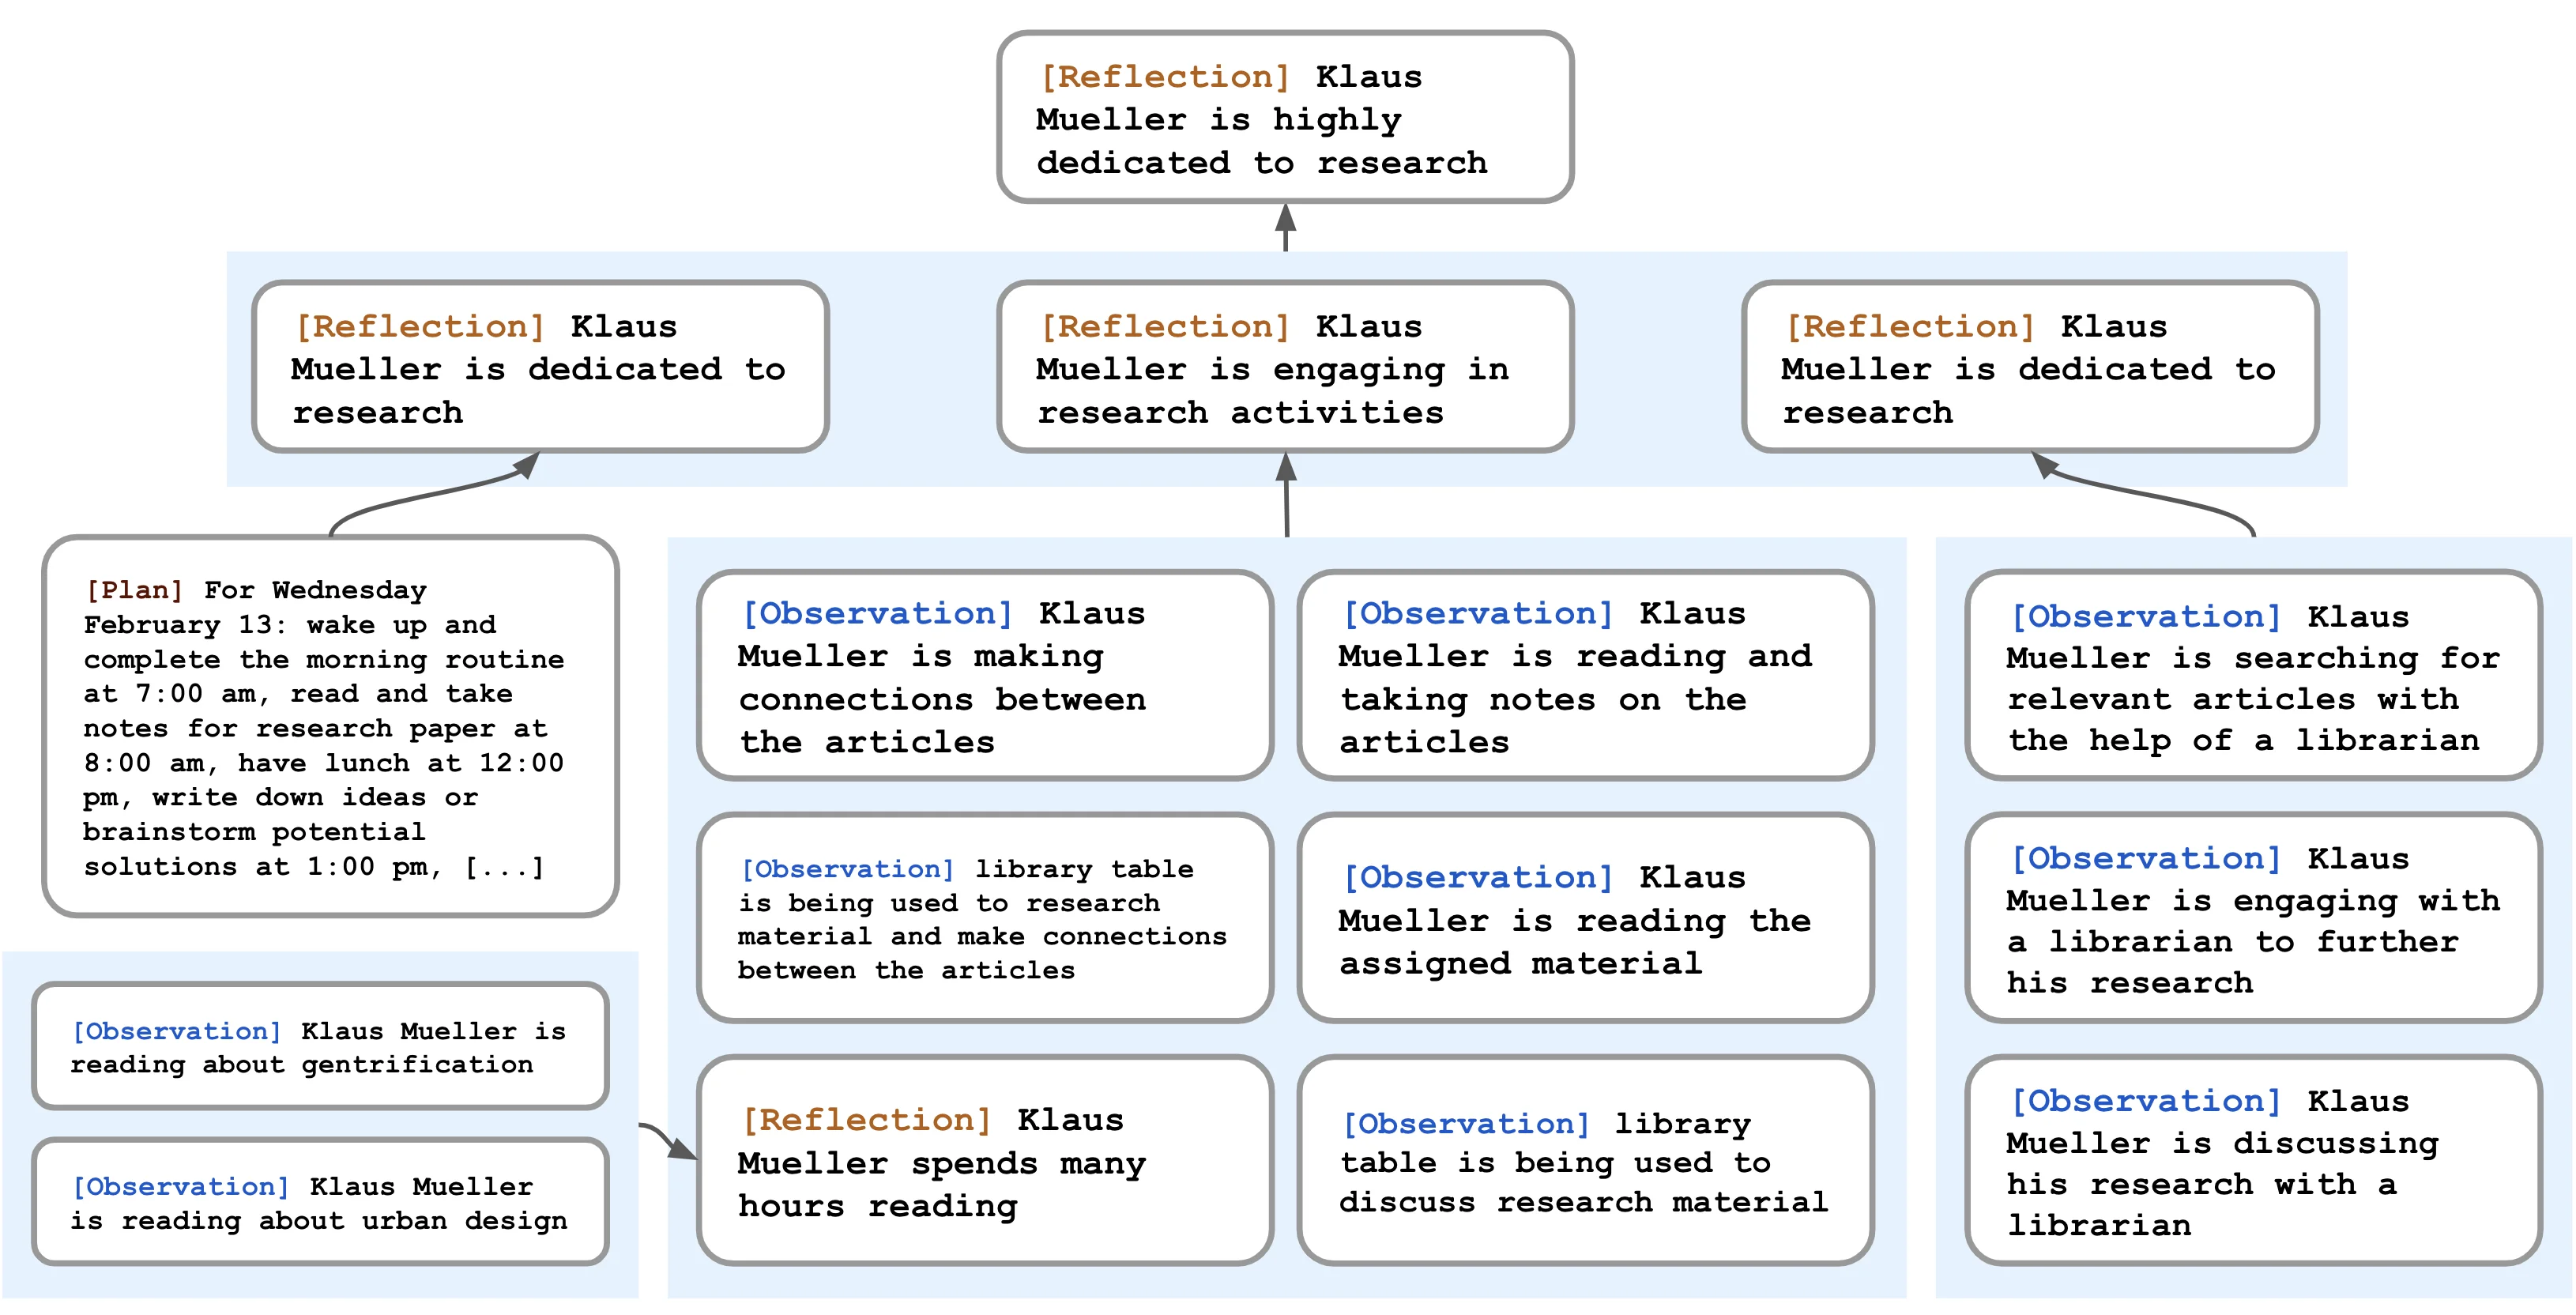
Figure 7,論文 Section 4.2:觀察葉節點向上合成「Klaus 對研究很投入」等反思。原圖 Figure 7。取自 arXiv HTML;arXiv reuse terms。
Planning
先產生一天 5–8 段粗計畫,再遞迴細化為帶地點、起迄時間的條目(Section 4.3)。計畫存入 stream 並參與檢索,使行為跨小時一致;環境變化時可中斷重規劃。
Smallville 實作
25 個 agent 各有一段人設段落作 seed memory(Section 3.1);世界為樹狀區域/物件(Figure 2)。使用者可用自然語言改動物件狀態(如爐子 burning),agent 下一時步感知並反應。
實驗如何讀 / How to read the evidence
訪談消融:元件是否必要
問題:觀察、反思、規劃是否提升「像這個人」的 believability?
控制:兩天模擬結束後,對 agent 做自然語言「訪談」——五類題(自我知識、記憶、計畫、反應、反思),每類五題。100 位參與者看該 agent 生活重播與 memory stream,對五種條件排序:完整架構、無反思、無反思+規劃、眾包人工撰寫、完全無記憶/反思/規劃(對應 Park et al. 2022 等僅 LLM 基線)。
觀察(Figure 8):TrueSkill μ 完整 29.89 > 無反思 26.88 > 無反思規劃 25.64 > 眾包 22.95 > 完全消融 21.21。相對完全消融,完整架構 Cohen’s d=8.16。Kruskal-Wallis H(4)=150.29,p<0.001;Dunn 事後檢定多數成對差異顯著,眾包與完全消融之間不顯著。
解釋:每拿掉一層記憶控制,排序 believability 下降——支持「架構元件有因果貢獻」,不是單靠更大模型。
邊界:眾包不是專家金標;訪談是隔離單 agent,不是生產多租戶負載。
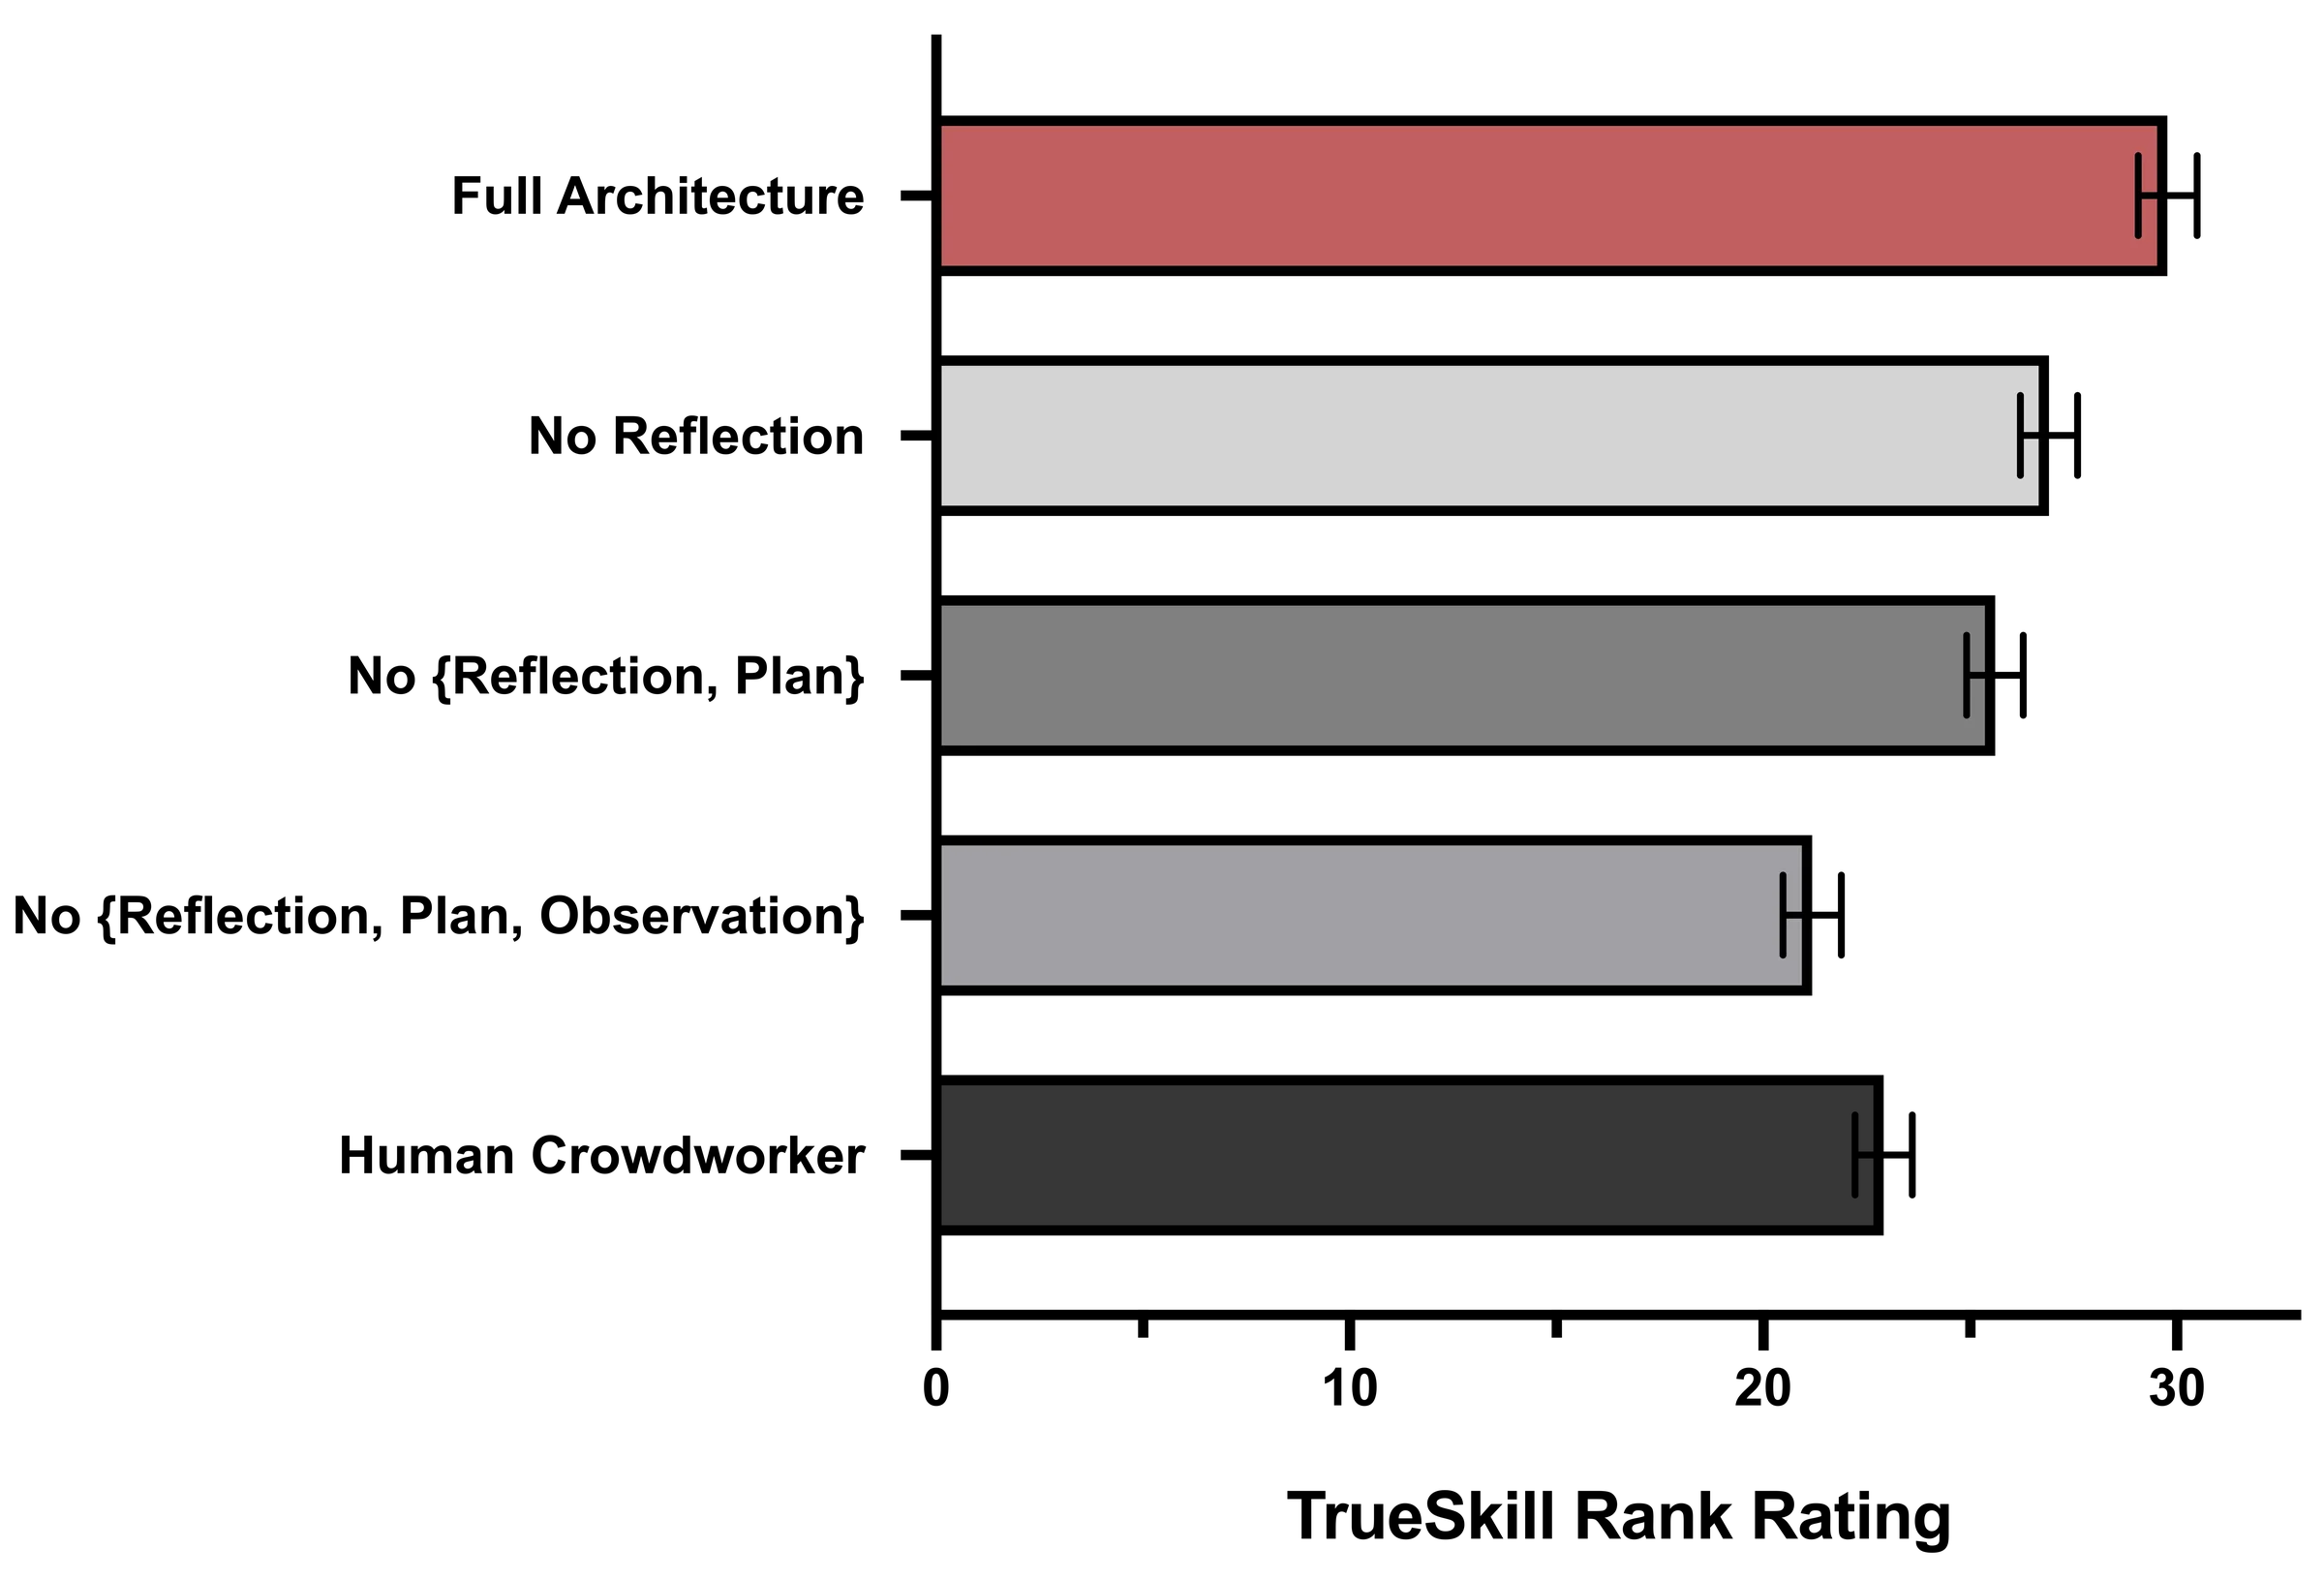
Figure 8,論文 Section 6.5:橫軸為條件,縱軸為 TrueSkill μ。原圖 Figure 8。取自 arXiv HTML;arXiv reuse terms。
兩天開放模擬:湧現社會行為
問題:多 agent 連續互動兩天,會否出現資訊擴散、關係與協調?
控制:市長候選(Sam)與派對(Isabella)資訊各僅 1 人初始知曉;結束後對 25 人訪談並對照 memory stream。
觀察(Section 7.1.2):
| 測量 | 結果 |
|---|---|
| 知曉市長候選 | 4% → 32%(1→8 人) |
| 知曉情人節派對 | 4% → 52%(1→13 人) |
| 雙向認識網路密度 η | 0.167 → 0.74 |
| 關係回答幻覺率 | 1.3%(6/453) |
| 派對出席 | 受邀 12,實到 5 |
解釋:定性+訪談標籤支持「資訊會傳、關係會長、部分協調會發生」,情人節鏈是 Figure 4 的量化補充。
邊界:兩天、25 人、單一沙盒地圖;出席率遠低於 100%;論文自述模擬成本高昂。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- 檢索是單點故障:技術與開放模擬最常見錯誤是檢索不到相關記憶或捏造細節(Section 6、7.2)。
- 沙盒規範難用自然語言寫清:單人浴室被誤當多人、商店 17:00 關門仍進入等(Section 7.2)。
- Instruction tuning 副作用:對話過於正式、過度配合他人建議(Section 7.2)。
- 成本與規模:25 agent×兩天即「數千美元 token、多天」(Section 8.2);不適合直接當即時產品 backend。
- 不是 MemGPT/Letta:沒有 main/external 函式分頁證據;不得寫入 DMR 92.5% 或產品 SLA。
- 不是 Reflexion:反思發生在同一模擬時間線的 stream 內,不是跨 trial reset 後的短緩衝 credit assignment。
- 魯棒性未充分測試:prompt hacking、memory hacking 在 Section 8.2 僅討論,非實證通過。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借鑑本篇?當你要做社會原型、遊戲 NPC 群、或多人模擬,需要 agent 記住互動、合成反思、並在檢索後規劃——且你能接受 LLM 成本與 believability 評估,而非單一準確率指標。
什麼時候不要把它當施工圖?
- 單 agent 長對話/長文件、視窗裝不下 → 讀 MemGPT,不是本篇。
- 失敗後跨 episode 語言學習 → 讀 Reflexion。
- 同一 trial thought–action–observation → 讀 ReAct。
- 階層記憶建構與 top-down 檢索 → 讀後續的 xMemory。
- 權限、rollback 的 durable runtime → 讀 Argus。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-28 的直接 endpoint 狀態:
- 論文:arXiv abs、v2 PDF、HTML 可讀;UIST DOI 10.1145/3586183.3606763。
- Demo:reverie.herokuapp.com/UIST_Demo/ 論文連結;需在瀏覽器實測是否仍可用(Heroku 免費層可能休眠)。
- 程式:github.com/joonspk-research/generative_agents 論文公開倉庫;重現 25×2 天模擬需 ChatGPT API 與大量 token——論文自述非輕量一鍵重跑。
- 最小有用 reproduction:對單 agent 餵入幾條觀察,手動算 recency/importance/relevance 排序,檢查 top-k 是否含預期派對或人名記憶;或跑訪談題單題比較有/無反思。這只能驗證機制方向,不能宣稱重現 μ=29.89。
三個記憶點 / Three things to remember
- 技術想法:多人沙盒 believability 靠 memory stream+週期反思+檢索式規劃,不是單 agent 的 OS context 分頁。
- 證據:Figure 8 消融 μ 29.89→21.21 階梯;兩天模擬 4%→52% 派對資訊擴散、密度 0.167→0.74、5/12 出席。
- 邊界:沙盒+高成本 LLM;檢索與捏造是主失效;不得與 MemGPT DMR 或 Letta/xMemory 數字混表。
延伸閱讀
本篇處理「多 agent 沙盒裡,記憶如何支撐計畫與社會行為」。若問題是單 agent 視窗分頁,讀 MemGPT;若問題是跨 trial 語言反思,讀 Reflexion;若問題是 thought–action 交錯,讀 ReAct。完整方法關係見 閱讀地圖。