90 秒掌握論文
- 問題:data agent 面對 tables、files、databases 時,不只是不知道欄位名稱,也不知道一個 domain concept 對應哪個 field、哪個 join、哪個 filter、哪個數值限制。Raw querying 讓 agent 自己反覆探索;static semantic layer 又可能太大、太舊,且要靠人工維護。這個 agent–data gap 會直接轉成錯誤的 query、冗長的 trajectory 與無法解釋的答案。
- 核心洞見:不要把 ontology 當成一份永遠不變的 prompt 文件,而是當成由 Content、Schema、Tool 組成、可被 agent 查詢的 versioned MCP service。Builder agent 用 probe 把語義接到真實資料;evolution agent 從失敗 trajectory 找出缺口,提出單層、typed、evidence-grounded patch,再以同一 backbone 的 paired validation 決定是否接受。
- 最強證據:Figure 2 描繪三層架構;Figure 4 顯示四個 backbone 在 accepted rounds 中逐步上升;Table 5–7 分別拆解 gate/attribution/diagnose、editable level 與 object family 的貢獻;Appendix B 的 Table 8 顯示 per-turn context 變大,但平均 turns/task 從 14.6 降到 8.4、total tokens/task 從 52.6K 降到 42.0K。
- 主要邊界:headline gain 需要把四-backbone analysis subset、六-backbone main tables、不同 benchmark metric 與 round-wise evolution 分開閱讀。作者的 repository 有可檢查的 framework code 與 demo,但 raw benchmark data、prebuilt ontology、模型 weights 與完整 provider credentials 不是隨 repo 一起交付。
我的 bounded verdict 是:EvoOntology 最值得借用的是「可查詢的語義 control plane + 有類型的局部 edit + 同 backbone gate」這個組合,而不是把任何 data agent 都換成 ontology 就會變強。它適合把重複出現的 schema/domain gap 物化成可審計的 shared asset;若資料經常改名、權限高度動態,或需要跨模型共用同一份演化結果,則要先解決 freshness、provenance 與 transfer,而不是直接採用作者的 score headline。
版本、來源與讀者問題
本文讀的是 EvoOntology v1,arXiv 顯示於 2026-09-14 提交,作者為 Meiduo Chong、Shaolei Zhang、Ju Fan 與 Xiaoyong Du。它是 arXiv preprint,未經同儕審查;本文把作者報告的 benchmark score 視為 paper evidence,不把它寫成已被外部 replication 證明的 universal gain。我核對了完整 arXiv HTML、PDF、全部 Figure 1–8、Tables 1–8、Appendices A–D、builder/evolution method,以及作者的 EvoOntology repository 和其使用說明。
這篇文章的讀者問題是:如何讓 data agent 不必每次重新猜 schema 與 domain semantics,又不把一份巨大且靜態的 metadata 永遠灌進 context? 這個問題接在 VikingRAG 的結構化 evidence navigation、DocMemo 的 dynamic evidence discovery 與 MidTool 的 tool-use control 後面讀很合適:EvoOntology 把探索結果、語義結構與 tool interface 綁成一個可演化的中介層。
證據地圖:Paper、Evidence 與 Bloss0m judgment
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | Content/Schema/Tool 三層;四種 Content node families 與兩種 edge families;builder 的 probe-and-verify initialization;trajectory analysis、attribution、typed patch 與 backbone-conditional paired gate;三個 benchmark、六個 backbone、四-backbone analyses;主要 tables、ablations、cost、transfer 與 case study。 |
| 作者主張 | Interactive ontology layer 能讓 agent 以語義方式查詢 heterogeneous data;self-evolution 能從 execution trajectories 找出缺口並逐輪提升 benchmark performance;相較 static semantic layer,typed gate 能避免不受控的 rewrite regression。 |
| Evidence 沒有建立 | 所有企業 data source 的 domain transfer、跨模型共用 ontology 的最佳策略、production freshness/ACL 變更下的安全性、無 provider cost 的實際 TCO、外部獨立 replication,以及 repo clone 後可直接重現論文所有數字。 |
| Bloss0m 工程判斷 | 把 ontology 當成 versioned data-agent control plane;把 accepted patch、rejected patch、evidence、benchmark split 與 serving backbone 一起留在 lineage 中,並讓 gate 的 failure 成為可觀測訊號。 |
Paper Essence Contract
- 它解決什麼問題? 解決 agent 在 heterogeneous data 上缺少可操作語義的 agent–data gap:同一個商業概念可能散落在不同欄位、表格、檔案與 reference path。
- 為什麼既有方法不夠? Raw querying 把 schema discovery 成本丟給每個 trajectory;static semantic layer 可能塞滿 context、需要人工維護,且沒有依照 agent 實際失敗修正的閉環。
- 核心技術想法是什麼? 以三層 ontology state、MCP browse/resolve tool、evidence-grounded initialization,以及 attribution-guided typed edit 加 paired gate,把語義探索變成可查詢、可演化、可回退的物件。
- 一個 input 怎麼走? user question → agent 呼叫 browse 找 Terms/Mappings → resolve 取得 linked records、Constraints、Evidence → agent 產生 query/分析 → trajectory 被診斷 → candidate patch 在 held-out validation 上與 parent paired 比較 → 接受或拒絕 → 下一個 input 使用新的 ontology version。
- 什麼證據支持 headline claim? Figure 2 的架構與 Figure 8 的 card-legality case;Table 1–4 的 benchmark results;Figure 3–5、Table 5–7 的演化、消融與 transfer;Appendix B Table 8 的 token/turn cost。
- claim 在哪裡停止? 主要 tables 有六個 backbone,但深入 analyses 以四個 backbone 為主;不同 model 的 ontology 會分開演化。這些數字支持 paper 內的 comparison,不能直接推出跨 provider、跨企業 data 或長期 production 維運結果。
核心直覺:ontology 是一個會被驗證的 semantic control plane
先把 ontology 想成 agent 與原始資料之間的一層 translator。原始資料保留 table、file、column、record 與 reference;ontology 不取代它,而是增加四種可以被 agent 使用的語義物件:
- Term:例如「Legality Status Code」或某個商業指標的 domain concept;
- Mapping:把 Term 對到實際欄位、join path 或 record relation;
- Constraint:說明 Term 何時有效、哪些值可以一起出現、哪些 filter 要綁定;
- Evidence:保存 value distribution、schema observation、query result 或其他能支持語義的資料根據。
Schema layer 再規定這些物件的欄位、允許的 relation 與 reference pattern;Tool layer 只把 agent 當下需要的語義暴露出來。這個 mental model 的關鍵是「語義不是 prompt 裡的裝飾文字」,而是有 type、有 mapping、有 constraint、有 evidence 的可解析 object graph。當 agent 的 trajectory 暴露缺口時,系統不是全文重寫,而是針對一個 editable level 提出 patch,並把 patch 當成候選版本來測。
既有方法為什麼不夠
Raw-querying agent 可以讀 schema、執行 SQL、檢查 spreadsheet 或檔案,但每個新 task 都要重新猜概念與位置。對於跨資料源的問題,這不只是多幾輪 tool call;它也讓 agent 可能使用錯誤欄位、漏掉 reference、把同名欄位當成同一概念。反過來,傳統 semantic layer 雖然能提供 metadata、entity、metric 與 schema,卻有兩個瓶頸:整份 layer 不能無限塞入 context,而且通常由人工或一次性 pipeline 維護,不會根據 agent 的實際 trajectory 自動定位缺口。
EvoOntology 的差異不是只把 metadata 換成 graph。它把 layer 包成 MCP server,讓 agent 用 browse 與 resolve 做 selective access;又把 agent 使用結果當成 evolution evidence。也就是說,既有方法通常把語義當成固定輸入,本篇把語義當成 runtime dependency 與可測試的 versioned state。
走完整個方法:從 raw data 到 accepted ontology patch
1. State 與三層架構
在 evolution round t,論文把 ontology state 寫成 :Content Layer 是 ,Schema Layer 是 ,Tool Layer 是 。三者切開有兩個好處:agent 可以只取與當前問題相關的內容,evolution agent 也能區分「缺一個 Term」「schema 不允許某種 relation」與「tool manifest 沒有把既有內容 expose 出來」。
Figure 2 展示完整 overview:typed content graph 在中間,object schema 規定可接受的形狀,runtime tool interface 讓 data agent browse/resolve。Builder agent 以 evidence-grounded initial state 開始;evolution agent 讀 historical interaction trajectories,改動 content、schema 或 tool 的其中一層。
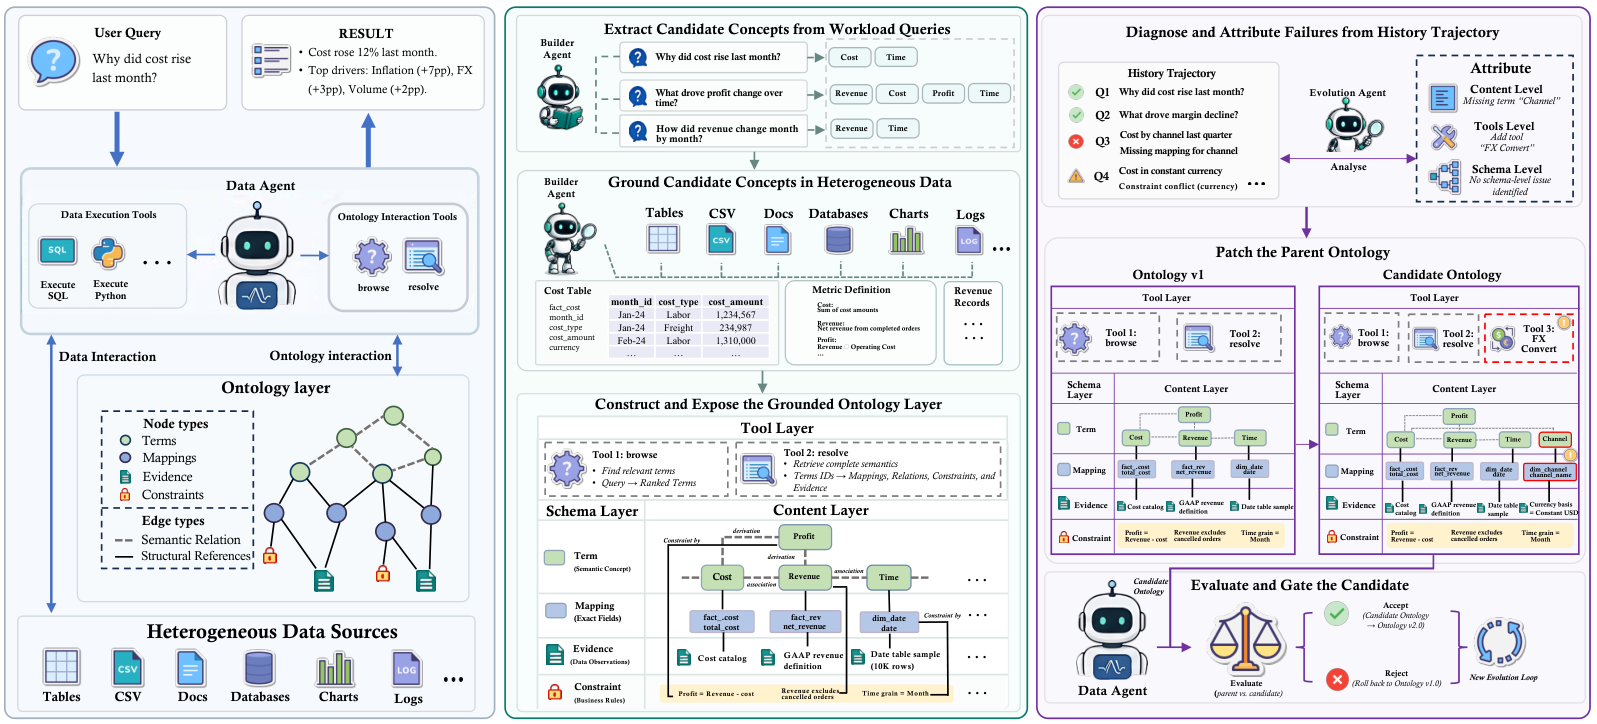
Figure 2(Section 3, anchor Sx3.F2):原論文 overview,展示 typed content graph、object schema、runtime tool interface,以及 builder/evolution agent 的分工。原始圖:arXiv HTML Figure 2。License/reuse restriction:原文標示 arXiv.org perpetual non-exclusive license;本文保留原圖、附來源供研究閱讀,任何再散布請依原始授權與引用要求確認。
2. Builder:先以 probe 把語義接到資料
初始化不是讓 builder 自由幻想一份 ontology。給定 workload W 與 raw data D,builder 先提出 concepts C;對每個 concept 做 probe(c,D),再驗證 type、filter、value distribution 或 reference 是否真的在 D 中成立。只有 verify(probe(c,D))=1 的概念才進入 C+,最後建構 S0=construct(C+,D;Γ0),得到 L0=(S0,Γ0,R0)。
這個流程的意義是把 evidence 放在 ontology entry 的旁邊。若一個 Term 只看起來合理、卻沒有任何可查詢的 column、value pattern 或 structural reference,builder 不應該因為語言模型的流暢度就把它當成 ground truth。它仍可能漏掉真正困難的概念,但至少把「知道」與「猜測」分出來。
3. Runtime:browse 與 resolve 讓 agent 選擇性取語義
Tool layer 主要提供兩類介面:
- browse(q,k,n) 回傳 query q 的 top-n semantic matches,讓 agent 先找到可能相關的 Terms 或概念;
- resolve(I,c) 根據 identifiers 與 context c 回傳 linked records 以及 compact manifest,詳細 records 再按需取得。
這種設計避免把整個 ontology 直接注入 prompt。agent 可以先 browse「banned card format」或「customer churn」,再 resolve 具體 Term 的 Mapping、Constraint 與 Evidence,接著回到原始資料做 query。Tool layer 不是只做搜尋;它也是 ontology 的 exposure contract,決定 agent 看見哪些欄位、哪些 relation、哪些 evidence。
4. Evolution:diagnose、attribute、patch、gate
每一輪演化使用 trajectory set T_t:
- Diagnose:分析 interaction trajectories,找出 agent 重複失敗、錯誤 mapping、缺漏 constraint 或 tool exposure gap。
- Attribute:把失敗歸因到 Content、Tool 或 Schema level,形成可檢查的 hypothesis。
- Patch:針對一個 level 產生 typed candidate L’_t=patch(L_t,σ,α(σ));不是把整份 ontology 改寫。
- Gate:以同一 backbone m 在 held-out validation V 比較 candidate 與 parent;只有當 φ(L’,V;m)−φ(L,V;m)≥τ 才接受,否則保留 parent 並記錄 rejection。
Gate 是 backbone-conditional 的:不同 backbone 對同一 ontology 的使用方式不同,論文讓各 backbone 獨立演化。這會換來較好的 in-backbone score,也引入 cross-backbone transfer 問題,後面 Figure 5 會看到。
實驗設計:三個 benchmark、六個 backbone、兩種 evaluation scope
作者使用三個 data-agent benchmark:
- DDR-Bench 10-K:同時報 Message-Wise、Trajectory-Wise 與 Overall,重點是多輪 data-agent workflow;
- InsightBench:報 Insight、Summary 與 Overall,測資料探索後的洞見與摘要;
- BIRD with Oracle Knowledge:報 EX 與 VES,聚焦 text-to-SQL 在 oracle knowledge 設定下的執行與語義分數。
主要 tables 報告六個 backbone:GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8、DeepSeek-V4-Flash 與 Qwen3.5-Flash。深入 analysis(Figure 3–7 與多數 Appendix summary)則固定四個 backbone:GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8。這兩個 scope 不可混成「所有結果都只測四個」或「所有分析都涵蓋六個」。
Baseline 是 ReAct;另有 Baseline + SL 的 static semantic layer,以及 DDR 上的 ReAct + Memory。作者採 reciprocal two-fold protocol:A→B、B→A;約 70% 用於 ontology construction、trajectory 與 candidate,剩下 30% 做 paired validation;選定的 ontology freeze 後才進 test。作者也說明 held-out validation 不使用 gold answer 或 evaluator feedback 來建構 ontology。
結果一:先看總體 gain,再看它從哪裡來
四-backbone analysis subset 的主結果可濃縮如下。這是 paper Figure 3/Appendix summary 的 mean trajectory,不是把六個 backbone 的每一列重新平均後擅自改寫的數字。
| Benchmark / primary metric | Baseline | Initial | Evolved | Paper reading |
|---|---|---|---|---|
| DDR-Bench / Traj-Wise | 69.5 | 81.8 | 89.5 | 初始 ontology 已降低 exploration gap,evolution 再補 recurring failure。 |
| InsightBench / Insight | 53.2 | 54.0 | 54.2 | gain 很小,說明 ontology 對 insight score 的邊際效果與 DDR 不同。 |
| BIRD / EX | 63.6 | 68.7 | 72.4 | mapping、constraint 與 tool exposure 仍能改善 SQL execution,但不是所有 metric 都同幅提升。 |
在 DDR 的 full six-backbone Table 1,EvoOntology 相對 ReAct 的 Overall 也呈現 backbone 差異:GPT-5.5 為 82.5(+20.1)、GPT-5.6-sol 為 85.9(+19.6)、Claude-Sonnet-5 為 79.9(+6.5)、Claude-Opus-4.8 為 85.2(+11.7)、DeepSeek-V4-Flash 為 44.9(+16.7)、Qwen3.5-Flash 為 20.1(+4.8)。這不是「小模型一定沒用」或「所有 model 同樣受益」的證明,而是提醒我們要同時看 absolute score 與 relative gain。
Table 2 將 DDR 的四-backbone平均與 ReAct + Memory 放在一起:Baseline 69.5,ReAct + Memory 75.8,EvoOntology 89.5。Memory 可以保存 episodic history,但 ontology layer 提供的是可查詢、可結構化、可被 mapping/constraint/evidence 支持的 semantic state;兩者不是同一種記憶。
Figure 3 的 interpreted evidence 是:DDR 從 Baseline 到 Initial 增加 12.3 points,Initial 到 Evolved 再增加 7.7;Insight 只有約 +0.8 再 +0.2;BIRD EX 約 +5.1 再 +3.7。這支持「初始 grounding 與後續 failure-driven refinement 都有角色」,但也顯示不同 benchmark 的 bottleneck 不一定是同一個 ontology gap。
結果二:演化真的逐輪收斂嗎
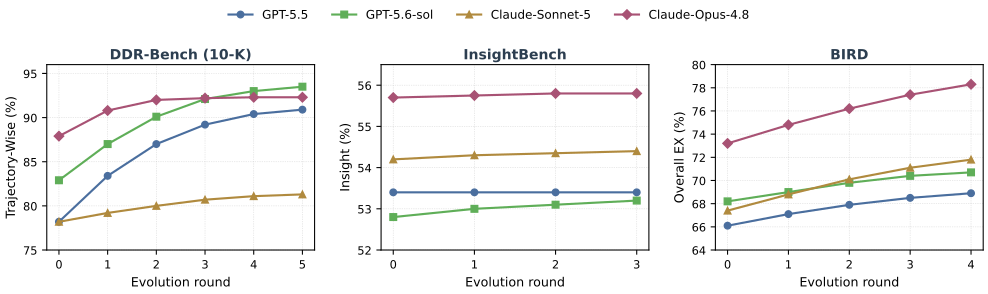
Figure 4(Section 5, anchor Sx5.F4):原論文把 DDR Traj-Wise、InsightBench Insight 與 BIRD EX 沿 accepted evolution rounds 畫在一起;GPT-5.6-sol 在五輪後達 93.5 Traj-Wise,Claude-Opus-4.8 在四輪後達 92.3,後段曲線趨平。原始圖:arXiv HTML Figure 4。License/reuse restriction:原文標示 arXiv.org perpetual non-exclusive license;本文使用未改動的原圖並保留引用,其他用途請先依 arXiv 授權條件確認。
Figure 4 的重點不是「round 越多越好」,而是 gain 看起來由多個 accepted patch 累積,且 late rounds 的 marginal improvement 變小。這使 self-evolution 比一個一次性 prompt rewrite 更容易審計:可以問每一輪是什麼 gap、哪一層被改、parent 分數是多少、candidate 是否通過 held-out gate。
但它也暴露一個 operational question:一個 round 是 accepted candidate,不一定是固定時間。若 production trajectory 分布改變,accepted edit 的頻率與 quality 會改變;若 validation split 太相似,gate 也可能只是在重複測同一種問題。論文的 reciprocal two-fold 與 frozen test 降低了 leakage 風險,卻沒有把長期 concept drift 變成已測量的 guarantee。
結果三:evolved ontology 是否跨 backbone 通用
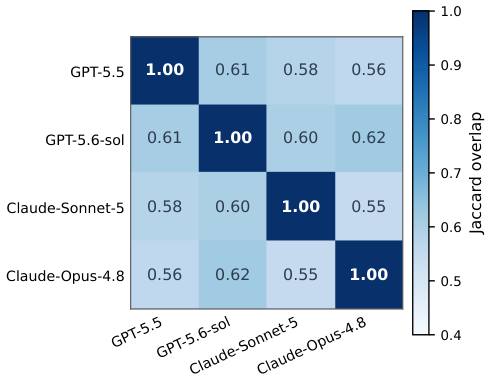
Figure 5(a)(Section 5, anchor Sx5.F5.sf1):原論文比較四個 backbone 的 evolved stores 中 accepted Term identifiers 的 pairwise Jaccard overlap;最大約 0.62,GPT-5.5/GPT-5.6 約 0.61,兩個 Claude 約 0.55。原始圖:arXiv HTML Figure 5。License/reuse restriction:原文標示 arXiv.org perpetual non-exclusive license;本文保留 panel 與原始 figure numbering,請依來源授權與引用規範再利用。
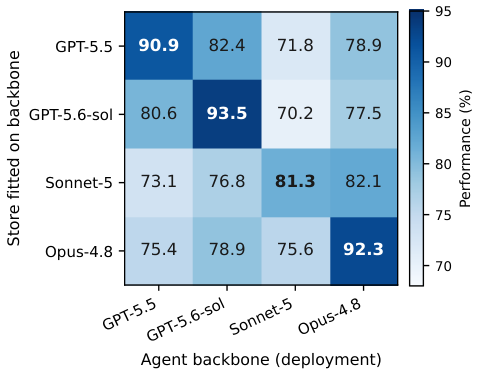
Figure 5(b)(Section 5, anchor Sx5.F5.sf2):原論文把每個 backbone fit 出的 evolved store 交叉服務給其他 backbone;每一欄 diagonal 都最高,off-diagonal 相對同 backbone 至少下降 6.6 points,平均 column drop 約落在 −6.6 到 −10.9。原始圖:arXiv HTML Figure 5。License/reuse restriction:原文標示 arXiv.org perpetual non-exclusive license;本文使用原圖 panel、未製作衍生圖,其他散布請先確認原始條款。
Figure 5 是一個不能被 headline gain 蓋過的 diagnostic。相同 raw data 與同一個初始 ontology,不同 backbone 仍會選出不同 Term identifiers、manifest detail、SQL fragment evidence 或 tool exposure。Term identifier overlap 不是 semantic equivalence proof,但 transfer matrix 的 diagonal pattern 說明 serving backbone 會影響 evolved state 的效用。
工程上有兩種合理路線:第一,接受 ontology 是 model-specific artifact,把 serving model、ontology version、accepted rounds 綁在一起;第二,建立 backbone-agnostic contract,對每個 patch 加跨模型 regression gate,犧牲一部分 local optimization 換取 portability。論文主要支持第一條路,並沒有解完第二條路。
消融、失敗模式、成本與轉移
Evolution loop ablation:gate 是負責避免 regression 的 load-bearing piece
Table 5 的四-backbone DDR average:
| Variant | Traj-Wise | 相對 Full |
|---|---|---|
| Full evolution loop | 89.5 | — |
| w/o Gate | 78.3 | −11.2 |
| w/o Attribution | 83.2 | −6.3 |
| w/o Diagnose | 84.7 | −4.8 |
| w/o typed patch,改成 free-form rewrite | 87.8 | −1.7 |
w/o Gate 的 drop 最大,支持 paired acceptance 不是儀式,而是在候選 edit 帶來 regression 時保留 parent 的保護欄。w/o Attribution 也明顯下降,表示「先說是哪一層、為何」有助於避免 content 與 tool/schema failure 對錯位置。這仍是單一 benchmark/四 backbone ablation;不能推論任何 gate threshold 都同樣有效。
Editable level ablation:Tool、Content、Schema 互補
Table 6 顯示 Baseline 69.5;Content-only 78.2(+8.7);Tool-only 82.7(+13.2);Schema-only 73.1(+3.6);Full 89.5(+20.0)。Tool-only 強,可能表示 agent 不只缺內容,也缺少如何取得內容的 exposure;Schema-only 較弱,則表示限制格式本身不一定能補足 missing concept。Full 的 gain 不應簡化成把三個數字相加,但它支持三層的互補性。
Table 7 再拆 Content object families:Full 89.5;移除 Mappings 76.1(−13.4);移除 Evidence 80.8(−8.7);移除 Constraints 86.0(−3.5);移除 Relations 87.4(−2.1)。這個 failure analysis 把「有 Terms」和「能正確落到 data」分開:Mappings 是最大的 single removal drop,Evidence 次之。Constraint 與 Relation 仍重要,但在此 setup 的邊際影響較小。
Cost:每輪更胖,不代表 task 更貴
Appendix B Table 8 的四-backbone DDR average:
| Metric | Baseline | Initial | Evolved |
|---|---|---|---|
| Input tokens / turn (K) | 3.2 | 4.1 | 4.6 |
| Output tokens / turn (K) | 0.4 | 0.4 | 0.4 |
| Turns / task | 14.6 | 11.2 | 8.4 |
| Total tokens / task (K) | 52.6 | 50.4 | 42.0 |
| Traj-Wise | 69.5 | 81.8 | 89.5 |
Evolved ontology 讓每一輪 input context 從 3.2K 增至 4.6K,但 turns/task 從 14.6 降到 8.4,total tokens/task 約比 baseline 低 20%。這支持「語義 context 換取較少的重複探索」的 paper claim;它不等於 provider billing 一定低 20%,因為 ontology build/evolve、tool latency、cache、prompt serialization、parallelism 與 human review 都可能是額外成本。
Content growth 與 attribution
Appendix A Figure 6 在 GPT-5.6-sol 上顯示 Terms 由 initial 61 增至五輪後 80;round 3 後各 tracked element 的 per-round growth 低於 5%,曲線與 Traj-Wise 一起趨平。Appendix C Figure 7 將累積 gain 分成 Tool 57%(六個 accepted rounds)、Content 34%(十一輪)、Schema 9%(三輪)。因此 Tool edit 的數量不必最多,仍可能帶來最大的累積效用;Schema edit 較少但可能處理 content 無法解決的 representation gap。
Worked example:card-legality 如何從泛稱變成可驗證 constraint
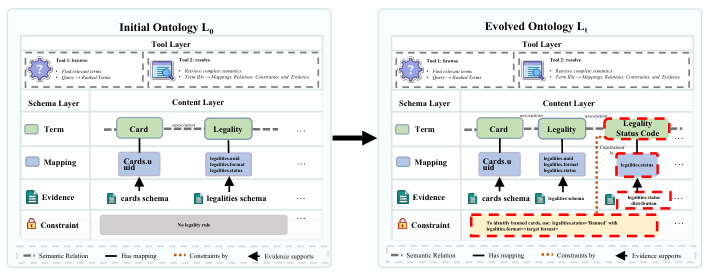
Figure 8(Appendix C, anchor A3.F8):原論文 case study 的 Initial state 有 Card 與 Legality 等一般語義,但沒有解釋 legality status;accepted content patch 新增 Legality Status Code Term、對 legalities.status 的 Mapping、Evidence,以及把 status 與 requested format 綁在一起的 Constraint。原始圖:arXiv HTML Figure 8。License/reuse restriction:原文標示 arXiv.org perpetual non-exclusive license;本文使用未改動原圖並保留 appendix provenance,其他再利用請依原始授權條件確認。
把這個例子走完:
- Agent 問某張 card 在目標 format 是否合法。Initial ontology 能找到 Card 與 Legality,但只給泛稱,browse/resolve 仍無法把 status code 的語義與 format 條件接起來。
- Trajectory 顯示 agent 找到資料卻沒有足夠的 interpretation,或產生缺少 status/format filter 的 query。這是 Content gap,不是一定要換 tool 或 schema。
- Candidate patch 增加 Term「Legality Status Code」,把它 mapping 到 legalities.status,附上 distribution/evidence,再加入 constraint:status 為 Banned 時,必須和目標 format 一起判斷。
- Gate 在 paired validation 上比較 parent 與 candidate。通過後,browse 可以找到新的 concept,resolve 可以取得 mapping、evidence、constraint;最後 SQL execution 仍要在 raw data 上驗證。
這個 case 的教學點是,ontology 不應取代 query execution,也不應把一個自然語言解釋直接當作 truth。它把「哪個 field、哪種 value、何時綁定哪個 filter」變成 agent 可取得的 intermediate representation,最後仍需 data-level check。
Artifact audit:code、data、model、demo 分開判斷
截至 2026-09-16,我直接檢查了作者的 EvoOntology GitHub repository。repository 公開、MIT license、未 archived;主分支當時可核對的 commit 為 ace8ff695f6b1752240cb0e0322f65667d7016eb。
- Code:可取得。 repository 有 core framework、Content/Schema/Tool layer、builder/evolution loop、plugin integration、benchmark adapters、configs、docs 與 tests/usage material;README 與 USAGE 說明可由 Claude/Codex client 透過 marketplace 使用,預設 workspace 為 .evoontology。
- Data:不完整。 BIRD、DDR-Bench、InsightBench 的 raw benchmark data 不隨 repo 提供;README/benchmark instructions 期待使用者自行準備 data path。prebuilt ontology 也沒有作為完整可直接重跑的 artifact 發布。
- Model/checkpoint:未提供。 paper 使用多個 backbone/provider,但 repository 沒有作者訓練的 checkpoint。重現 benchmark 需要對應 model access、API credentials、prompt/config、資料與成本預算。
- Demo:可觀看但不是完整 reproduction。 repository 有 evoontology-demo.mp4,以及 README 對應的 GitHub user-attachment video endpoint;這能檢查互動產品形態,不能代替 benchmark data、model credentials 或 prebuilt ontology。
因此 artifact 的結論是「code 可讀、demo 可看、benchmark data 與模型環境仍需補齊」。要做最小 smoke test,可以依 benchmark README 準備對應資料與 API key;要重現 Table 1–8,還要鎖定 split、backbone、版本化 ontology workspace、evolution rounds、paired gate threshold、token accounting 與 provider response。不要把 public repository 的存在誤讀成 end-to-end reproducibility 已完成。
限制、失敗邊界與什麼時候不要用
Paper limitations:
- 主要表格雖含六個 backbone,深入演化、transfer 與 cost analysis 以四個 backbone 為主,不能推出所有新模型都同樣受益;
- evolved store 對 backbone 有明顯 specificity;Jaccard identifier overlap 也不能直接當 semantic equivalence;
- 三個 benchmark 與 reciprocal two-fold 能降低部分 leakage,但沒有證明長期資料更新、schema migration、ACL 變動或新 domain 的 freshness;
- gate 依賴同一 backbone 與 held-out validation,threshold τ、trajectory quality、diagnosis correctness 都是系統設計選擇;
- repo 沒有附完整 benchmark raw data、prebuilt ontology 或 checkpoint,因此外部重現需要額外 provider 與資料條件;
- cost table 衡量 token/turn/task,不等於完整金額 TCO、wall-clock latency 或 maintenance cost。
什麼時候不要使用 EvoOntology 當成解法? 如果資料 schema 本身不穩定到每小時都重寫、權限會依 user/session 即時變動、ontology 不能安全保存跨租戶 evidence,或任務只做一次且沒有重複 schema gap,演化 layer 的 build、review、invalidation 成本可能超過收益。如果需要一份跨 backbone、跨 provider 完全相同的 semantic contract,先做 portability gate 與 schema standardization,不要把 local evolved store 當成 universal knowledge。
Bloss0m engineering decision: 先為一個窄 workload 建立 versioned ontology;記錄每個 Term 的 mapping、constraint、evidence、source freshness 與 owner;將 accepted/rejected patch 放進 audit log;用 frozen validation、shadow traffic 與 cross-backbone regression 做 canary;最後才決定是否讓 evolution agent 自動接受。若不能查清楚「這個 patch 讓哪個 failure mode 下降」,就維持 human review。
下一步閱讀
下一步讀 VikingRAG:結構化文件的 URI evidence navigation,比較 hierarchy-preserving storage 與 ontology-mediated data access;讀 DocMemo 看 agent 如何從歷史 trace 找 evidence;若要把 MCP tool exposure 與 failure diagnosis 接起來,讀 MidTool。
三個記憶點:離開前請帶走
- Ontology 是可查詢的 control plane,不是 prompt appendix:Content、Schema、Tool 分工,讓 agent 只取當前需要的 semantic state。
- Self-evolution 的安全核心是 typed edit 加 paired gate:diagnose、attribute、patch、gate 缺一不可;w/o Gate 在 DDR 四-backbone average 掉 11.2 points。
- 局部 gain 不等於跨模型通用:Evolved store 在同一 backbone 的 diagonal transfer 最好;production 必須把 model、version、evidence、freshness 與 regression gate 一起治理。