Reflexion 深度精讀
系列 · 1 篇
-
Reflexion:用語言反映寫進記憶,但不能把多次重試當成參數學習
中階 Agent Runtime、安全與評測精讀 Shinn et al. NeurIPS 2023:凍結權重、把語言反映寫進 episodic memory,跨 trial 做口語式 credit assignment。HumanEval pass@1 91.0 對 GPT-4 80.1 是程式設定下的數字;WebShop 與 MBPP 顯示邊界。
90 秒掌握這篇論文
- 問題
- 語言 agent 已經能跟環境互動,但要從試錯裡學,傳統 RL 需要大量樣本與權重更新;只靠 in-context few-shot 又幾乎沒有「跨 episode 的可解釋經驗」。
- 核心洞見
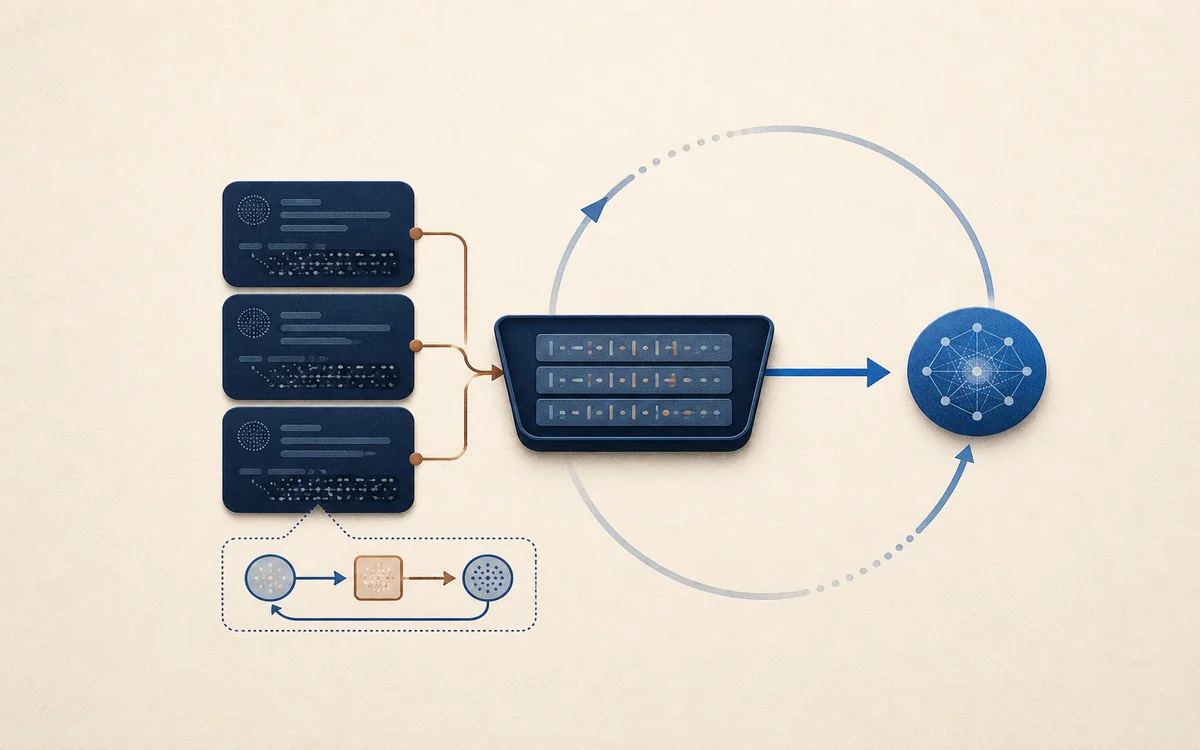
- 不更新權重。把二值或純量回饋放大成語言反映,寫進 episodic memory buffer,再條件化下一次 trial。改動的控制點是跨 trial 的口語式 credit assignment,不是參數梯度。
- 最強證據
- HumanEval (PY) Reflexion pass@1 91.0 vs GPT-4 單次生成 80.1(Table 1);ALFWorld heuristic 設定解出 130/134(Section 4.1);HotPotQA 報告相對強基線約 +20%(Section 4 開頭)。Rust 消融:完整 Reflexion 0.68,缺反映或只反映不測都會掉到 0.60/0.52(Table 3)。
- 主要邊界
- 需要可用的評測訊號;反映可以寫錯;多次 trial 有算力成本;記憶是滑動窗口(通常 1–3 條),不是企業級治理。WebShop 幾乎不提升(Figure 6);MBPP (PY) 甚至掉到 77.1。這不是權重學習,也不是可部署 runtime。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡