若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:固定長度 context window 讓長對話與長文件分析很快撞牆;直接把 transformer context 拉長成本二次成長,而且長視窗仍可能用不好中間段資訊。
- 核心洞見:不要先追求「更大的 RAM」。把 LLM 的 prompt tokens 當成主記憶體(main context),把對話歷史與文件庫放在外部記憶(external context),再用函式呼叫決定寫出、取回、驅逐——像 OS 的虛擬記憶體分頁。
- 最強證據:Deep Memory Retrieval(Table 2)上,GPT-4 固定視窗正確率 32.1%、+MemGPT 92.5%;GPT-4 Turbo 35.3% → 93.4%。Nested KV(Figure 7)上,固定視窗模型在更深巢狀層級崩到 0%,MemGPT+GPT-4 能持續多跳查詢。
- 主要邊界:系統依賴模型的工具/函式呼叫保真度;分頁策略本身是 agent 決策,可能寫錯或丟掉關鍵事實;實驗是對話一致性與合成/抽樣文件任務,不是帶 ACL、稽核、rollback 的企業記憶層。後續 Letta 產品化也不等於這篇論文的實驗工件。
我的結論是:MemGPT 最值得保留的貢獻,是把記憶管理視為固定 context window 上的分頁問題,而不是單純增加 tokens。OS 比喻不能直接代表可上線的治理型記憶庫,後續產品數字也不屬於 Table 2 或 Figure 7。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Packer et al., arXiv:2310.08560 v2,首發於 2023-10-12,並在 2024-02-12 修訂。PDF 與 arXiv HTML 標示 CC BY 4.0。
作者順序依 arXiv 摘要頁:Charles Packer、Sarah Wooders、Kevin Lin、Vivian Fang、Shishir G. Patil、Ion Stoica、Joseph E. Gonzalez。除摘要外,本文核對 main/external context、函式執行器、MSC/DMR/opener/DocQA/Nested KV、主要表圖,以及截至 2026-08-27 的工件狀態。
這是 arXiv/CoRR preprint,不是已確認的 peer-reviewed proceedings 版本。原始 TeX 含 ICLR 2024 樣式檔,但本文不據此宣稱會議錄取。
論文釋出頁為 research.memgpt.ai。截至 2026-08-27,github.com/cpacker/MemGPT 會導向 letta-ai/letta(Apache-2.0),memgpt.ai 則導向 Letta 產品站。後續 Letta 產品指標、LoCoMo 與其他記憶 benchmark 不納入本文表格。
讀者真正要回答的問題
當任務已經長過模型視窗,工程上是該繼續加長 prompt,還是改「誰決定什麼進視窗」?MemGPT 的回答是:把有限 context 當工作集,讓模型用 OS 式階層與工具自己做分頁。
比較精確的讀法不是「MemGPT 是不是無限 context」。真正的問題是:分頁控制平面改了哪一步決策,又在什麼任務上因為工具呼叫不穩、巢狀查詢中斷或外部庫檢索失敗而失效?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 3 定義 system instructions/working context/FIFO 與 recall/archival;Table 2 給出 DMR 正確率與 ROUGE-L(R);Figure 5 顯示 DocQA 上 MemGPT 對固定視窗截斷/檢索上限較不敏感;Figure 7 顯示 Nested KV 在更深巢狀層級上固定視窗崩潰、MemGPT+GPT-4 可續查。 |
| 作者主張 | 虛擬 context 管理能在不改底層有限視窗的前提下提供「更長 context」的錯覺;函式鏈(request_heartbeat)支援多步檢索;OS 的分頁與中斷概念可移植到 LLM agent。 |
| 論文未證明 | 企業級權限、遺忘政策、稽核與 rollback;分頁決策的正確性保證;開放權重模型上的同等數字;產品化 runtime 的 SLA。 |
| Bloss0m 工程判斷 | 把 MemGPT 當 context 工作集的控制平面 來實作。跨 trial 語言反映讀 Reflexion;階層記憶建構與檢索讀 xMemory;需要 durable 權限/rollback 讀 Argus。 |
後文把數字、作者 claim 與工程判讀分開。「提升」只指論文報告的 setup。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把缺口寫得很直接。長對話與長文件會先撞上固定視窗;把 transformer context 直接拉長會付出二次計算與記憶成本,而且既有研究(論文引用 Lost in the Middle)顯示長視窗也不保證中間資訊被有效使用。
相對地,只靠遞迴摘要或截斷來「假裝」有更長歷史,會在需要精確回指舊事實時失真——DMR 的固定視窗基線正是拿過去五個 session 的有損摘要來模擬這條路。文件端若只把 top- 段落塞進 reader,正確率大致被檢索器上限卡住:漏掉的 gold 文件永遠進不了視窗。
因此,舊方法不夠的地方不是「模型不夠會講」,而是控制點放錯層:要么付更長 context 的成本,要么用有損壓縮/單次檢索碰運氣。MemGPT 改的是讓模型自己管理工作集。
核心直覺 / Core intuition
先不要看表格。想像筆記型電腦只有 8GB RAM,卻要編輯遠大於記憶體的專案:OS 不會把整顆硬碟載進 RAM,而是把正在用的頁留在主記憶體,其餘放碟上,缺頁時再載入。
MemGPT 把這份分工搬進 LLM:
- Main context ≈ RAM:當下 prompt tokens,分三塊——唯讀 system instructions、可寫 working context、FIFO 訊息佇列。
- External context ≈ disk:recall storage(完整訊息庫)與 archival storage(任意長度文字/文件庫)。
- Function executor:把模型輸出解析成記憶讀寫/搜尋;可用
request_heartbeat=true把控制權立刻還給模型,串起多步查詢。 - Memory pressure:佇列接近警告閾值(文中例子約 70%)時插入系統警告,逼模型先把重要資訊寫出;超過 flush 閾值則驅逐並做遞迴摘要。
這與 Reflexion 的差異要講清楚:Reflexion 改的是 trial 與 trial 之間如何把失敗寫成語言經驗;MemGPT 改的是 同一條(可跨 session 的)互動裡如何讓有限視窗繼續服務看似無界的歷史與文件。它也不是 Argus 那種帶權限與 rollback 的 durable runtime——Argus 處理的是控制平面治理,MemGPT 處理的是 context 分頁。
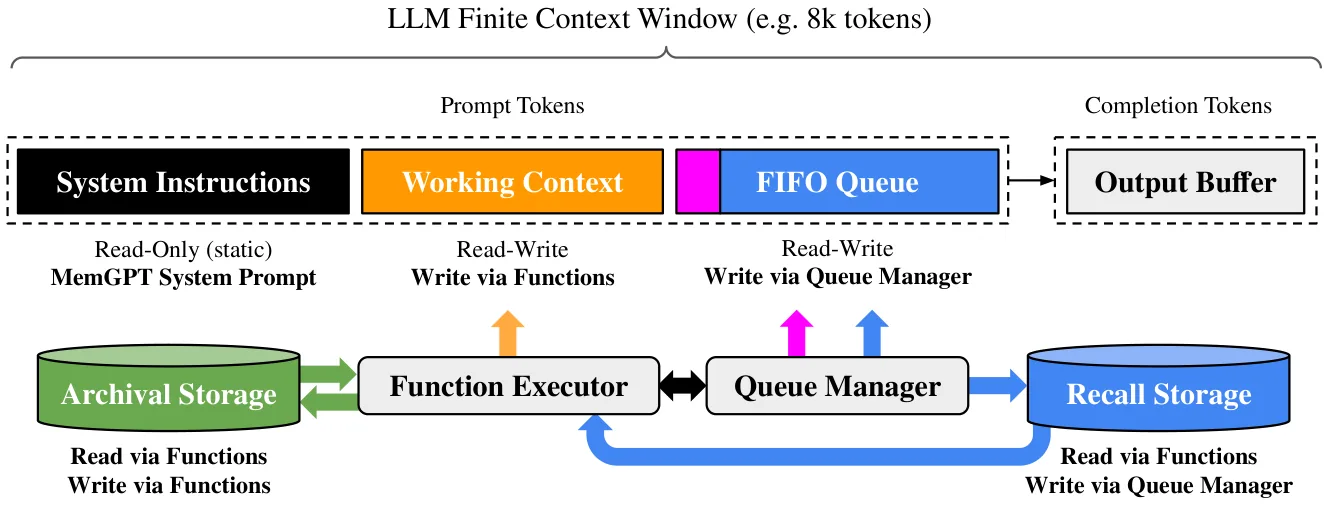
Figure 3,論文 Section 1–2:prompt tokens 分為 system instructions、working context、FIFO queue;函式在 main context 與 archival/recall 之間搬資料;request_heartbeat 支援函式鏈。原圖可定位到 Figure 3,SVG endpoint 為 memgpt_system_flow_2.svg。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

用一個例子走完整個方法 / Walk one example through the method
以下依論文 Nested KV 與 DocQA 敘事整理成一條可教的路徑。Nested KV 是作者設計的合成多跳任務;此處的逐步描述是教學用機制走查,不是獨立實驗分數。
- Input:使用者給一個 UUID key;archival/主儲存裡有 140 對 key–value(約 8k tokens,對齊 GPT-4 基線視窗),且 value 本身可能還是下一個 key(巢狀層級 0–4)。
- Intermediate representation:MemGPT 不把整張表一次塞進 prompt。模型對儲存發出查詢函式,把回傳的一頁結果寫進 main context,檢查「這個 value 是不是另一個 key」。
- Model or system decision:若仍是 key,就設
request_heartbeat=true繼續查,直到確認終端 value;這是函式鏈,不是單次 retrieval。 - Output:回傳最終 UUID value。
- Likely failure point:模型提早停止搜尋、函式參數解析失敗,或像 GPT-3.5 基線那樣直接把第一層 value 當答案。論文觀察:固定視窗 GPT-3.5 在 1 層巢狀就掉到 0%;GPT-4/GPT-4 Turbo 到 3 層也到 0%;MemGPT+GPT-4 則能跨層續查,但 MemGPT+GPT-3.5/Turbo 仍可能因「查得不夠多」在更深層開始掉點。
對話場景的對應失敗點更日常:memory pressure 警告來了,模型卻沒把「男友叫 James」寫進 working context,FIFO flush 後就只能靠有損摘要——這正是 DMR 基線會輸的原因。
技術機制 / Technical mechanism
Main context 三區塊
| 區塊 | 讀寫 | 角色 |
|---|---|---|
| System instructions | 唯讀 | 控制流、記憶層用途、函式用法 |
| Working context | 函式可寫 | 固定大小的非結構化重點(偏好、人設、關鍵事實) |
| FIFO queue | 佇列管理器寫入 | 近期訊息、系統警告、函式 I/O;溢位時驅逐並摘要 |
External context 兩庫
- Recall storage:完整訊息資料庫;可搜尋後再插回 FIFO。
- Archival storage:任意長度物件/文件;論文實作預設 PostgreSQL + pgvector,用
text-embedding-ada-002做向量搜尋,並以分頁避免一次取回撐爆視窗。
控制流
事件(使用者訊息、容量警告、上傳完成、排程)→ 轉成文字附加到 main context → LLM 產生 completion → 函式執行器驗證並執行 → 結果回寫。帶 heartbeat 旗標就立刻再推論;否則 yield,等下一個外部事件。
操作含義:提高警告/flush 敏感度,等於更早強迫模型做記憶寫出;放寬則更像「先塞滿再截斷」。無論哪種,視窗大小仍是硬上限——變的是誰在上限內做置換。
實驗如何讀 / How to read the evidence
實作細節(Section 3):除非另註,GPT-4 Turbo = gpt-4-1106-preview(128k)、GPT-4 = gpt-4-0613(8,192)、GPT-3.5 Turbo = gpt-3.5-turbo-1106(16,385)。MemGPT 與基線都跑這三個骨幹,用來暴露「工具呼叫能力」對系統的影響。
DMR:跨 session 一致性
問題:在 MSC 五段會話之後,問一個必須回指舊對話才能答的窄問題,自導向分頁是否優於有損摘要基線?
控制:同一批 MSC personas;基線看過去五 session 的有損摘要;MemGPT 可經分頁搜尋讀完整歷史,但必須把結果載回 main context;以 LLM judge 正確率與 ROUGE-L recall 評分(因模型回答通常比 gold 更長)。
觀察(Table 2):
| Model | Accuracy ↑ | ROUGE-L (R) ↑ |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 0.394 |
| + MemGPT | 66.9% | 0.629 |
| GPT-4 | 32.1% | 0.296 |
| + MemGPT | 92.5% | 0.814 |
| GPT-4 Turbo | 35.3% | 0.359 |
| + MemGPT | 93.4% | 0.827 |
解釋:增益來自「完整歷史可查+模型決定載入什麼」,不是同一條 prompt 變長。固定視窗基線即使有摘要,仍在精確回指上失敗。
邊界:LLM judge;生成 QA 對;不是開放域任意閒聊。也不要讀成「GPT-4 單次生成變強了 60 個百分點」——分母是帶記憶工具的 agent 設定。
Conversation opener:參與感
問題:新 session 開場白能否主動用到累積人設?
控制:對照 gold personas 與人類開場;Table 3 報告 SIM-1/SIM-3/SIM-H。依論文正文,此表是 MemGPT 搭配不同底模 的開場,不是 Table 2 那種「±MemGPT」對照列。
觀察(Table 3):Human SIM-1/SIM-3 = 0.800;MemGPT+GPT-4 達 0.868/0.843;MemGPT+GPT-3.5 的 SIM-H 0.817 高於 GPT-4/Turbo 變體的 SIM-H。作者並稱 working context 儲存對開場很關鍵。
邊界:相似度不是使用者研究;表上沒有並列「無 MemGPT」數字,不宜過度外推。
Document QA:檢索上限 vs 多輪取回
問題:當 reader 視窗有限,能否靠 archival 多輪查詢突破單次 top- 上限?
控制:與固定視窗基線共用同一檢索器(ada-002);Wikipedia 2018 dump、NaturalQuestions-Open 路線、抽 50 題;MemGPT 把全集放進 archival,用函式搜尋+分頁。
觀察(Figure 5):固定視窗曲線大致被檢索器/可塞進視窗的文件數卡住;用截斷硬塞更多文件會傷正確率。MemGPT 文案強調其表現不受「為了塞更多文件而截斷」那條路徑支配,且 GPT-4 與 GPT-4 Turbo 跑 MemGPT 在此任務結果等價。
解釋:多輪取回讓「有效上下文」不再等於「單次 prompt 能塞多少段落」。
邊界:50 題樣本;LLM judge;圖為主證據,正文未給可獨立抄錄的單一百分比表——本文不從圖上臆造數字。
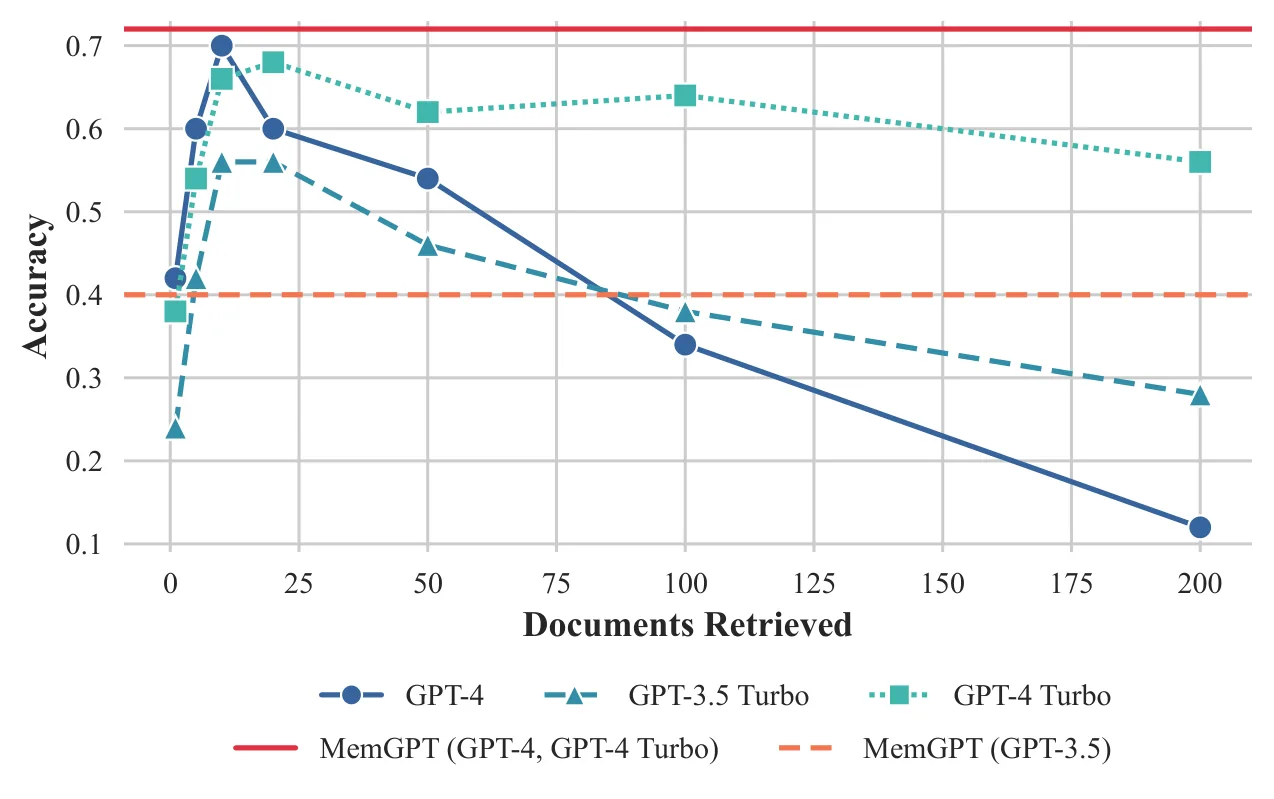
Figure 5,論文 Section 3:固定視窗 reader 受檢索與截斷約束;MemGPT 透過 archival 多輪查詢擴張有效上下文。原圖可定位到 Figure 5。取自 arXiv v2 圖檔/HTML,頁面標示 CC BY 4.0。
Nested KV:多跳查詢壓力測試
問題:當答案要串多層 UUID,系統能否用函式鏈完成多跳,而不是一次把表塞進 8k 視窗?
控制:140 對、巢狀 0–4 層、30 種排列;基線把(截斷後的)文件放進固定視窗。
觀察(Figure 7 與正文):GPT-3.5 在 1 層巢狀即 0%;GPT-4/GPT-4 Turbo 到 3 層亦到 0%。MemGPT+GPT-4 對巢狀深度不敏感、可持續查;MemGPT+Turbo/3.5 優於對應基線,但約在 2 層後仍可能因查詢次數不足掉點。正文亦註:作為基線時 GPT-4 Turbo 較強,但 MemGPT+Turbo 反而不如 MemGPT+GPT-4。
解釋:這測的是「控制流+工具保真」,不是嵌入檢索品質 alone。
邊界:合成 UUID,沒有語言歧義;成功高度綁在模型是否持續下達正確查詢。
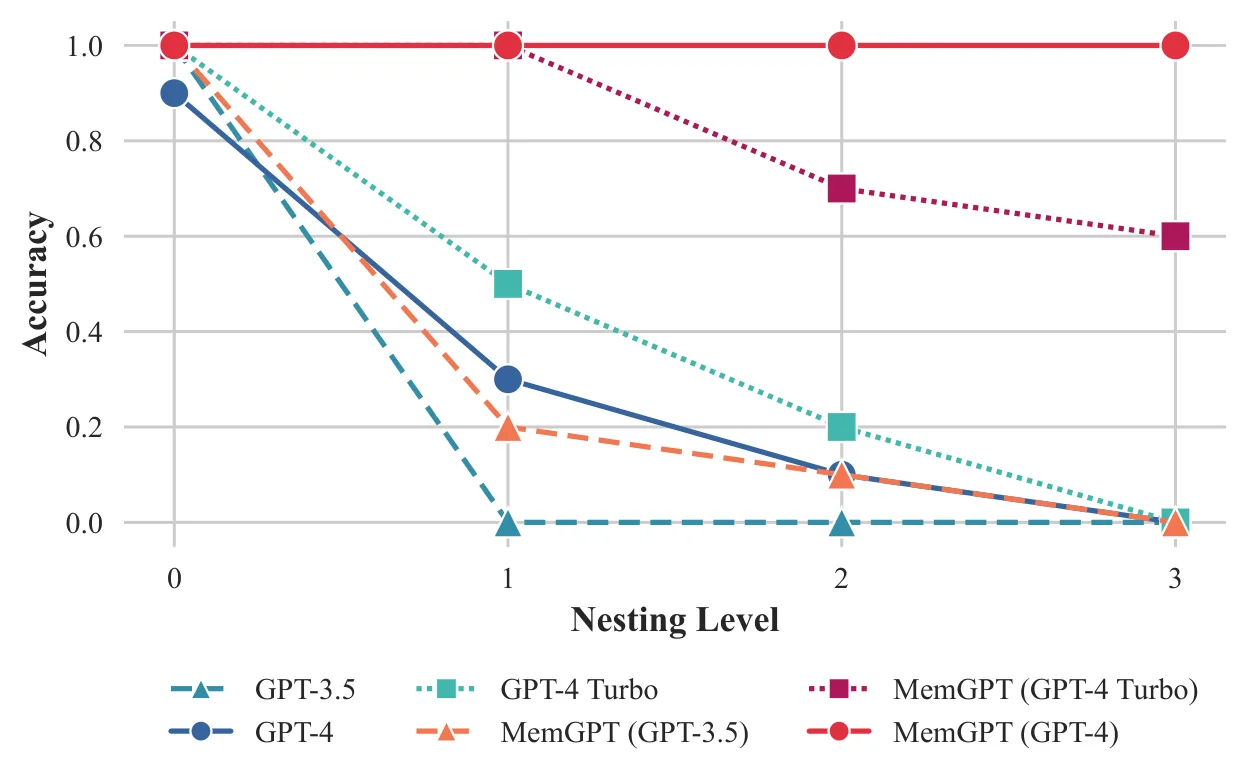
Figure 7,論文 Section 3:固定視窗模型在更深巢狀崩潰;MemGPT+GPT-4 靠多步函式查詢維持。原圖可定位到 Figure 7。取自 arXiv v2 圖檔/HTML,頁面標示 CC BY 4.0。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
論文結論偏前瞻,工程邊界要自己收斂:
- 工具呼叫保真度是單點故障。 GPT-3.5 上 MemGPT 明顯變弱;Nested KV 的提早停止是典型失效。
- 分頁政策會丟錯東西。 Memory pressure 下寫錯 working context,等於污染後續條件化。
- 主證據偏對話一致性與合成/抽樣文件任務。 不是生產環境的權限邊界或副作用測試。
- 不是企業記憶治理。 沒有 ACL、 retention、稽核、rollback——那些要另讀 Argus。
- 分開後續 benchmark 與產品證據。 本篇評估的是 DMR、opener、DocQA 與 Nested KV;後續記憶 benchmark 或 Letta 產品數字不屬於這些實驗。
- Preprint 身分。 可引用機制與表圖,但不要寫成已確認的會議最佳論文敘事。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 MemGPT?當你的痛點是「視窗裝不下,但任務需要回指舊狀態或多跳取證」,而且底模的函式呼叫夠穩、你願意把 working/archival schema 與壓力警告當成可審查協議。
什麼時候不要把它當施工圖?
- 需要跨 trial 把失敗寫成語言經驗時,讀 Reflexion。MemGPT 不取代那份契約。
- 需要同一 trial 內 thought 與環境動作交錯時,讀 ReAct。
- 需要階層記憶如何建構與 top-down 檢索時,讀 xMemory。
- 需要 workflow/長期任務評測基板時,讀 ContextWeave;動態證據發現讀 DocMemo。
- 需要權限、驗證與 rollback 的 durable runtime 時,讀 Argus。加長 prompt 或加一層向量庫都解決不了那裡的控制問題。
- 底模幾乎不會穩定 function call、或你無法接受「模型自己決定刪什麼」時:不要上。Nested KV 與 GPT-3.5 切片就是警告。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v2 PDF、HTML 可讀,license 為 CC BY 4.0。
- 專案頁:research.memgpt.ai 可開啟,連到論文、Discord、GitHub、Hugging Face。
- 程式:論文/專案頁印的
github.com/cpacker/MemGPT目前 301 → letta-ai/letta(Apache-2.0)。這是可用的後續程式庫,不等於凍結在 2023 實驗的一鍵重跑 bundle;README 已產品化為 Letta/stateful agents 敘事。 - 資料:論文宣稱釋放增強 MSC、Nested KV 與約 20M Wikipedia embeddings;HF org huggingface.co/MemGPT 可開啟。實際下載哪個 snapshot、能否離線重現 Table 2,仍需對具體 dataset card 再核——不要把「有 org 頁」寫成「Table 2 可一鍵重跑」。
- 產品站:
memgpt.ai→ letta.com。產品能力與定價不是本篇證據。 - 最小有用 reproduction:對 Nested KV 單題跑「查詢→判斷是否仍為 key→heartbeat 再查」並檢查函式軌跡;或對 DMR 單題檢查 recall search 是否把正確 session 片段載回。這只能驗證機制方向,不能宣稱重現 93.4%。
- 安全註記:自導向記憶寫入可能保存敏感使用者內容;接生產前要另做保留與存取政策——論文未提供該層。
三個記憶點 / Three things to remember
- 技術想法:MemGPT 把有限 context 當 RAM,用階層記憶與函式分頁/中斷,讓模型自己管理工作集。
- 證據:DMR Table 2 上 GPT-4 32.1%→92.5%、Turbo 35.3%→93.4%;Nested KV Figure 7 上固定視窗深層崩潰、MemGPT+GPT-4 可多跳續查。
- 邊界:依賴工具呼叫保真度;分頁會丟錯事實;這是 context 控制平面,不是企業記憶治理,也不是後來 Letta 產品的成績單。
延伸閱讀
MemGPT 處理的是「視窗裝不下時如何分頁」。接下來可依問題選讀:
- 多人沙盒中的觀察–反思–計畫記憶流:Generative Agents。
- 失敗後如何用語言記住教訓:Reflexion。
- 同一 trial 內交錯 thought 與 action:ReAct。
- 階層記憶建構:xMemory。
- durable runtime 的權限與 rollback:Argus。
- workflow 評測或動態證據發現:ContextWeave 與 DocMemo。