讀法可搭配 三遍掃描法。在本站的基礎方法主線中,本篇接在 Transformer 之後。Transformer 處理序列轉換架構;InstructGPT 保留 GPT-3 架構,將重點轉到預訓練後的人類回饋對齊(SFT → RM → PPO),並以 labeler 偏好勝率作為核心證據。
較早的 CV 篇章可見 AlexNet(上)/(下)、ResNet 與 YOLO。
90 秒掌握論文 / The paper in 90 seconds
- 問題:更大的 LM 不會自動更聽話;GPT-3 類模型在 next-token 預訓練目標下常產生不真實、有毒或不依指令的輸出(Section 1)。語言建模目標與「依使用者意圖、安全地回應」並不對齊。
- 核心洞見:沿用 GPT-3 模型架構,但繼續更新模型參數,依序完成三個階段:(1) SFT——用約 40 位 contractor 的示範微調;(2) RM——用 6B reward model 擬合人類排序;(3) PPO——以 RM 分數為獎勵,並加上相對 SFT policy 的 KL 懲罰;預設 PPO-ptx 還混入預訓練目標,以減輕 public NLP 任務退步(Figure 2、Equation 2、Section 3.5)。改變的是 人類偏好對齊程序,不是 attention 架構。
- 最強證據:API prompt 分佈上,labeler 偏好評估(Figure 1、Section 4.1):175B InstructGPT 相對 175B GPT-3 勝率 85±3%;相對 few-shot GPT-3 71±4%;1.3B InstructGPT 仍優於 175B GPT-3(>100× 參數差距)。相對 175B SFT 基線,InstructGPT 勝率 73.4±2%,優於 FLAN/T0 微調(26.8±2%、29.8±2%)。
- 主要邊界:2022 封閉 GPT-3 family;偏好來自特定 labeler 與 API Playground 分佈(Section 5.2–5.3)。ChatGPT 產品指標、GPT-4、DPO、Llama-2-chat、Constitutional AI 不屬本 PDF;YOLO mAP、Transformer WMT BLEU 亦不是對齊契約。
我的結論是:InstructGPT 最值得保留的是預訓練後依序使用 SFT、RM 與 PPO 的 2022 工程路線。85±3% 的偏好勝率則只適用於當時的評測,不能直接當成 2026 chat 產品的 SLA。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Ouyang et al., NeurIPS 2022 對應的 arXiv:2203.02155 v1(2022-03-04)。PDF 標示 arXiv.org perpetual non-exclusive license。作者順序以 v1 為準(標註 * 為同等貢獻):Long Ouyang、Jeff Wu、Xu Jiang、Diogo Almeida、Carroll L. Wainwright、Pamela Mishkin、Chong Zhang、Sandhini Agarwal、Katarina Slama、Alex Ray、John Schulman、Jacob Hilton、Fraser Kelton、Luke Miller、Maddie Simens、Amanda Askell、Peter Welinder、Paul Christiano、Jan Leike、Ryan Lowe。
除摘要外,本文核對 Section 3 方法(Figure 2、Equation 1–2)、Section 4 結果(Figure 1、3–7)、Section 5 討論與限制,以及截至 2026-08-28 的 openai/following-instructions-human-feedback 連結。ChatGPT、GPT-4、DPO、Llama-2-chat 數字,都不回填。
讀者真正要回答的問題
當你已有 預訓練 GPT-3 類 LM,要讓它 依自然語言指令 在開放任務上表現更好,該只靠更大模型與 prompt engineering,還是沿用同一架構、透過 SFT、reward model 與 PPO 繼續調整權重?Ouyang et al. 選後者,並用 labeler 偏好勝率 與 TruthfulQA/毒性等輔助指標同時報告取捨。
比較精確的讀法不是「InstructGPT 是不是 2026 最強 chat」。真正的問題是:三階段 RLHF 如何改寫 post-pretraining 資料流、偏好勝率支持什麼、以及哪些後來產品數字不能寫回這篇。
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1 偏好評估;Figure 2 三階段管線;Figure 3 held-out labeler 勝率;Figure 4 metadata;Equation (1) RM loss、Equation (2) PPO-ptx 目標;Table 1 API 用例分佈;Section 3.2 資料規模(SFT ~13k、RM ~33k、PPO ~31k prompts)。 |
| 作者主張 | 人類回饋微調能對齊廣泛指令任務;偏好勝率顯著優於 GPT-3 與 SFT-only;PPO-ptx 可減輕 alignment tax;成本遠低於重訓 GPT-3。 |
| 論文未證明 | ChatGPT 產品表現;GPT-4/Claude 等後續系統;DPO 等無 RL 替代;跨文化/跨用戶群的普遍偏好;開源可完全復現 175B 管線。 |
| Bloss0m 工程判斷 | 把本篇放在基礎方法主線的 instruction alignment 段落,接在 Transformer 之後。BERT GLUE、YOLO VOC 與 WMT BLEU 不屬於 RLHF 表;85±3% 也不是 ChatGPT SLA。 |
先前方法為何不足 / Why the previous approach is insufficient
Section 1–2 把脈絡寫清楚。純預訓練 LM(GPT-3)優化 next-token 預測,與「依指令、誠實、無害」的使用意圖錯位。Prompt engineering/few-shot prefix(GPT-3 prompted)可小幅改善,但 Figure 1 顯示仍遠低於 SFT 與 PPO。僅 SFT 能學會模仿示範,卻缺少對「哪個輸出更好」的偏好排序信號。FLAN/T0 在 public NLP 任務上微調,在 API 分佈上不如 SFT,更不如 InstructGPT(Section 4.1、Figure 5)。
Transformer 解的是 encoder–decoder 序列轉換與 WMT BLEU;YOLO 解的是 整圖偵測——它們都沒處理 post-pretraining 人類偏好對齊。
核心直覺 / Core intuition
先不要背 PPO 公式。想像一個已預訓練的 175B GPT-3:給它「列出五個重燃職涯熱情的方法」,它可能續寫網頁文風、答非所問或過度發揮。SFT 讓它先看數萬條 labeler 寫好的理想回答 並模仿。RM 再學「在 A/B/C/D 四個候選裡人類最愛哪個」。PPO 則讓模型 自己生成,用 RM 打分當獎勵,但每個 token 都被 KL 懲罰 拉著,別漂離 SFT 太遠。
對照三種容易混在一起的下一步:
- GPT-3 base + prompt:不改權重,只改輸入;便宜但天花板低(Figure 1)。
- InstructGPT(本篇):SFT → 6B RM → PPO(預設 PPO-ptx);架構仍是 GPT-3。
- 後續方法與產品:ChatGPT、GPT-4、DPO 直接優化偏好、Constitutional AI——數字與系統邊界都不屬於 2022 PDF。
用一個例子走完整個方法 / Walk one example through the method
以下用一個簡化 API prompt,先交代三階段訓練留下了什麼,再走一次部署時的推論(Bloss0m 教學例,非論文表格編號)。
- Input:prompt「用兩段以內解釋什麼是梯度消失。」(API 分佈中常見的 generation/QA 混合任務,Table 1)。
- Intermediate representation:tokenizer 後的 token 序列進入 同一套 GPT-3 transformer 堆疊。在先前訓練中,SFT policy 學過示範;RM 則學過人類如何比較「簡潔、冗長、錯誤」等不同回答。
- Model or system decision:部署推論時,完成 PPO 訓練的 policy 直接自回歸生成回答,不再呼叫 RM。只有在 PPO 訓練時,整段 completion 才會得到 RM 的標量獎勵 ,並扣除相對 SFT policy 的 log-probability ratio;PPO-ptx 另混入預訓練目標( 控制強度,Appendix C 寫 )。
- Output:兩段內、較貼指令的解釋(理想情況)。
- Likely failure point:錯誤前提——若 prompt 假設不成立,模型可能照單全收(Figure 9);過度 hedging——簡單問題卻列多種可能;reward hacking——若 RM 有盲點,PPO 可能討好 RM 而失真;封閉 labeler 分佈——偏好未必代表你的終端用戶(Section 5.2)。
技術機制 / Technical mechanism
三階段管線(Figure 2、Section 3.1)
- Step 1 SFT:labeler 在 API/自寫 prompt 上提供示範;微調 GPT-3。~13k 訓練 prompts;訓練 16 epochs(Section 3.5)。
- Step 2 RM:labeler 對 – 個候選 排序;訓練 6B reward model(論文稱 175B RM 不穩定,Appendix C)。~33k 訓練 prompts。
- Step 3 PPO:以 RM 為獎勵 fine-tune SFT 政策;per-token KL 懲罰相對 SFT;預設 PPO-ptx 混入預訓練梯度。~31k PPO prompts(無人類標註,僅作輸入)。
模型規模:1.3B、6B、175B,皆為 GPT-3 架構(Section 3.5)。
Reward model loss(Equation 1、Section 3.5)
是 prompt 與 completion 的標量獎勵; 是人類更偏好的那一側。增大 → 損失下降 → RM 更符合排序。
PPO-ptx 目標(Equation 2、Section 3.5)
控制 KL 懲罰強度; 控制預訓練混合(PPO 版設 )。除非另述,文中 InstructGPT 指 PPO-ptx。
Figure 1,論文 Section 1/4.1:API prompt 分佈上,InstructGPT(PPO-ptx)相對 175B SFT 的偏好評估;1.3B PPO-ptx 優於 175B GPT-3。原圖見 arXiv PDF Figure 1。圖檔自 NeurIPS 2022 camera-ready PDF 擷取;arXiv.org perpetual non-exclusive license。本頁擷取含周邊正文,細節以 PDF 為準。
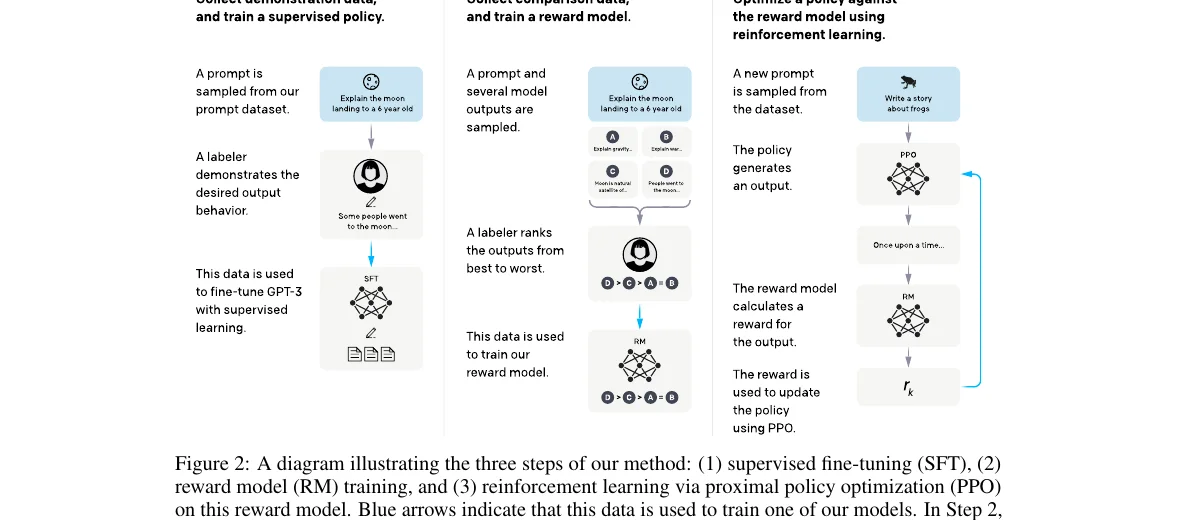
Figure 2,論文 Section 3.1:三階段方法示意——示範資料訓練 SFT、排序資料訓練 RM、PPO 優化政策。原圖見 arXiv PDF Figure 2。擷取與授權說明同 Figure 1。
實驗如何讀 / How to read the evidence
Figure 1/Section 4.1:偏好勝率(headline)
問題:相對 175B SFT 基線 與 175B GPT-3,InstructGPT 有多少 labeler 偏好優勢?控制:held-out API test prompts;三位 labeler 評估;95% 信賴區間。觀察:階梯為 GPT-3 < GPT-3 prompted < SFT < PPO < PPO-ptx;175B vs GPT-3 直接比較 85±3%;vs few-shot GPT-3 71±4%;1.3B PPO-ptx 仍勝 175B GPT-3。邊界:這是 2022 contractor 偏好,不是產品 NPS;prompt 分佈偏 API Playground。
Figure 3:held-out labeler 與 GPT-3 API prompts
問題:是否只 overfit 訓練 labeler?在 提交給 GPT-3 的 API prompts 上是否仍成立?觀察:held-out labeler 排序與訓練 labeler 相近;GPT-3 prompts 上結論大致不變(Section 4.1)。邊界:仍限 英語為主、特定承包商 群體。
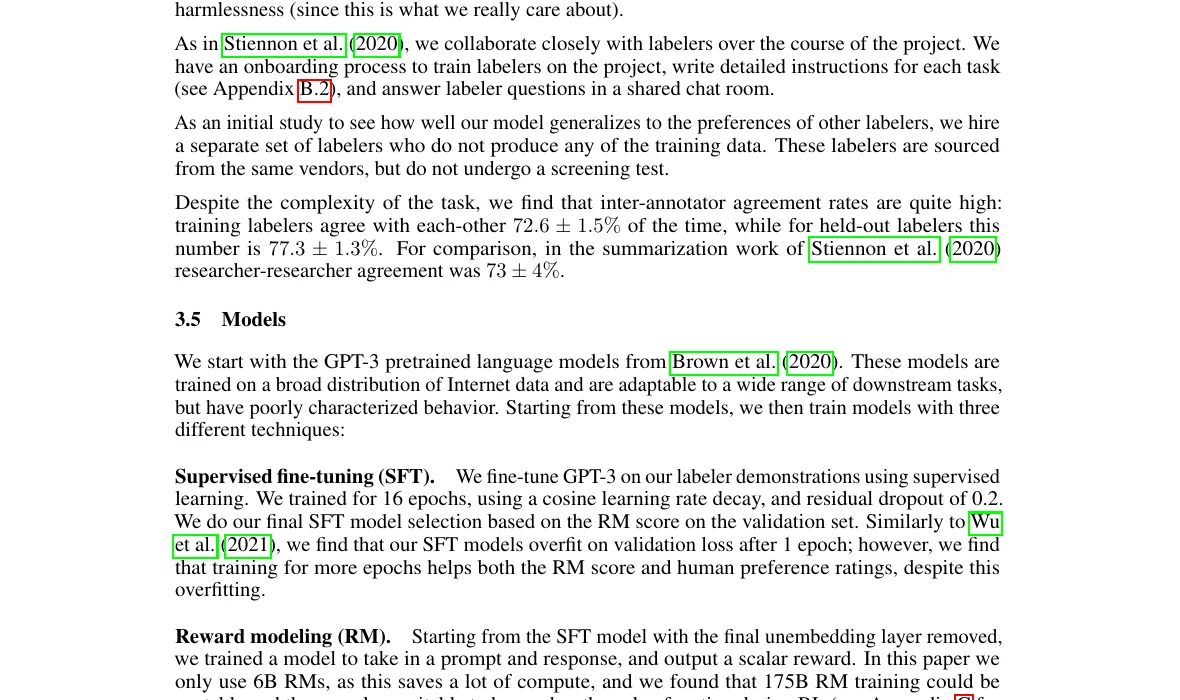
Figure 3,論文 Section 4.1:勝率相對 175B SFT;左為 GPT API prompts、右為 InstructGPT API prompts;上為 held-out labeler、下為訓練 labeler。原圖見 arXiv PDF Figure 3。擷取含頁面其他內容;以 PDF 為準。擷取與授權說明同 Figure 1。
Figure 4/輔助指標:TruthfulQA、毒性、幻覺
問題:偏好勝率之外,真實性/毒性/幻覺是否改善?觀察:TruthfulQA 上 真實且資訊性回答約為 GPT-3 兩倍(Figure 6、Section 4.2);closed-domain 幻覺 21% vs 41%(Section 1);respectful prompt 下毒性約 少 25%(Section 4.2)。邊界:偏見(Winogender、CrowS-Pairs)未顯著改善;public NLP(SQuAD、DROP 等)有 alignment tax,PPO-ptx 可緩解但未完全消除(Section 4.2)。
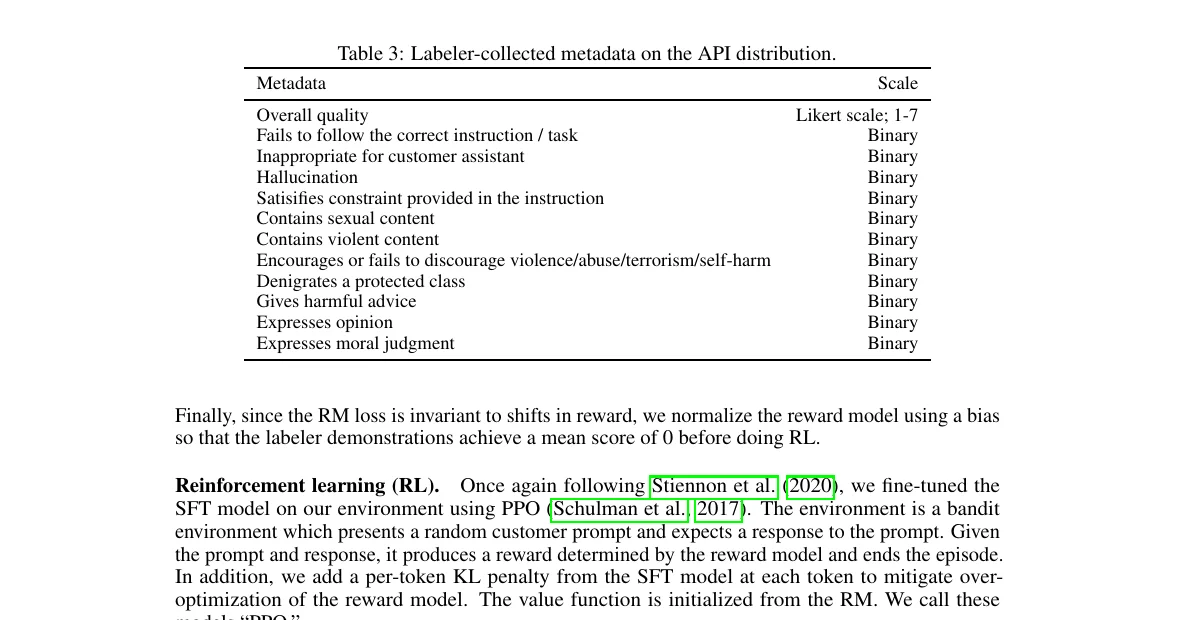
Figure 4,論文 Section 4.1:相對 GPT-3,PPO 模型在 customer-assistant 適切性、遵守約束、減少幻覺等 metadata 上更佳。原圖見 arXiv PDF Figure 4。擷取與授權說明同 Figure 1。
成本(Section 5.1)
175B SFT 約 4.9 petaflops/s-days;175B PPO-ptx 約 60;對照 GPT-3 預訓練 3640(Brown et al., 2020)。作者主張:對齊投資相對預訓練 便宜得多,且 1.3B 對齊可勝過 175B base。
消融與設計選擇 / Ablations
- SFT-only vs +PPO(Figure 1):SFT 已帶來大幅改善,加入 PPO 後再提升;解讀結果時要把 SFT 的增益 與 PPO 在 SFT 之上的增益 分開。
- PPO vs PPO-ptx:偏好分數差異不大;PPO-ptx 顯著減輕 public NLP 回歸(Section 4.2、Figure 29)。
- KL vs 預訓練混合(Figure 33–34):加大 KL 係數會傷驗證獎勵;ptx 混合 較能恢復 SQuAD/DROP。
- RM 規模:實務選 6B RM 而非 175B(不穩定)。
- FLAN/T0 對照(Figure 5):public 指令微調 不如 API 偏好 RLHF;head-to-head 78±4%(vs FLAN)、79±4%(vs T0)。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- 對齊對象:約 40 位 contractor,~73% 標註一致率(Section 3.4、5.2)——不是全人類價值。
- 任務邊界:API Playground prompt;96%+ 英語;非 production API 全量。
- 安全缺口:仍會有毒、偏見、捏造;依有害指令時可能更毒(Section 4.2、5.3)。
- 不要混入後續結果:ChatGPT 上線數據、GPT-4、Claude、DPO、Llama-2-chat、o1。
- 與其他 foundations 節點分開:WMT BLEU、YOLO mAP、ImageNet top-5 不能 寫進 RLHF 證據表。
工程判斷與不適用條件 / Engineering decision and when not to use it
何時借用本篇? 當你已有 夠大的 base LM,產品痛點是 不聽指令/風格不對/偏好不符,且能負擔 示範收集 + 排序 + RL 訓練 時,三階段 RLHF 仍是教科書級起點。先量 標註者一致率與 RM 校準品質,再談偏好勝率。
何時不要照搬?
- 需要 開源可復現 175B 全鏈——本篇模型與資料 未完整開放。
- 只有 少量 SFT 資料 卻期待 ChatGPT 級體驗——RM+PPO 成本與資料品質門檻仍在。
- 把 85±3% 寫進 2026 產品 SLA,或混淆 InstructGPT 論文 與 ChatGPT 產品。
- 以為 DPO/RL-free 偏好優化 已在本文證明——那是後來工作。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-28 的 artifact 狀態:
- 論文:arXiv abs、PDF v1 可讀。
- 樣本:openai/following-instructions-human-feedback 釋出部分 NLP 任務取樣;不等於 可重訓 175B 全管線。
- 模型權重:未公開 175B InstructGPT checkpoint;復現需自有 base LM 與標註預算。
最小有用 reproduction:在 小模型 上跑通 SFT → RM → PPO 迴圈,並記錄 KL 與獎勵曲線——驗證機制,不是復現 85±3%。
三個記憶點 / Three things to remember
- 技術想法:沿用 GPT-3 架構並繼續調整權重;SFT 示範 → 6B RM 排序 → PPO(+KL,預設 PPO-ptx);改變的是 人類偏好對齊程序,不是新的 Transformer 架構。
- 證據:Figure 1——175B InstructGPT vs GPT-3 85±3%、vs few-shot 71±4%;1.3B 勝 175B GPT-3;輔以 TruthfulQA/毒性/幻覺率。
- 邊界:證據來自 2022 封閉 API 的 labeler 偏好,不是 ChatGPT/GPT-4/DPO。基礎方法主線從 CV、序列轉換走到 InstructGPT,這一篇處理的是指令對齊。
延伸閱讀
若尚未讀過序列模型的起點,可先讀 Transformer;閱讀方法見 三遍掃描法。下一篇 Speculative Decoding 討論凍結權重下的無損推論加速,而不是新架構。
若要對照 prompt 內推理與瀏覽器輔助 QA,可讀 CoT 與 WebGPT。兩者不改 post-training 偏好管線,與本篇互補;BERT、GPT-2/3 預訓練、ChatGPT 與 DPO 等後續方法則刻意不展開。