論文精讀
AlexNet 論文精讀(下):網路架構與訓練方法
原文:ImageNet Classification with Deep Convolutional Neural Networks
90 秒掌握論文
- 問題:在 2012 年,一個包含 6,000 萬參數、65 萬神經元的深層卷積神經網路,即使在 ImageNet 120 萬張標註影像下訓練,仍然會遭遇嚴重的過擬合;同時,飽和激活函數與僅有 3GB 的 GPU 記憶體,使反向傳播在工程上極難收斂甚至無法載入。
- 核心洞見:AlexNet 的真正突破不在於單一架構深度,而是將非飽和線性單元(ReLU)、跨雙 GPU 拓撲分割、標籤保持的幾何與光度資料增強、隱藏層隨機失活(Dropout),以及配合動量與權重衰減的 SGD 優化策略,整合成一套彼此互相支撐的可訓練化工程配方。
- 最強證據:PCA 色彩擾動使 Top-1 錯誤率降低超過 1%,重疊池化(Overlapping Pooling)使 Top-1 與 Top-5 錯誤率分別降低 0.4% 與 0.3%,ReLU 讓四層 CNN 在 CIFAR-10 上達到 25% 訓練誤差的速度比 快 6 倍;全系統在 ILSVRC-2010 達到 37.5% Top-1 與 17.0% Top-5 錯誤率,在 2012 競賽中以 15.3% Top-5 顯著領先次名的 26.2%(Section 3–6、Table 1)。
- 主要邊界:論文所呈現的診斷數據為個別元件的單因子比較,並非全因子交叉消融(full factorial ablation);局部響應正規化(LRN)、雙卡通道分組連接與測試時 10 裁剪(10-crop)平均,均具有強烈的年代硬體約束,不能被不加檢驗地外推為現代深度學習系統的通用設計。
本文依據發表於 NeurIPS 2012 論文集的正式版本(“ImageNet Classification with Deep Convolutional Neural Networks”)。接續 AlexNet(上) 對於問題背景、評測協定與頂層架構的梳理,本篇將分析重心置於架構內部連接機制、正則化手段、數值優化動態與可重現性工程邊界。
理解前需要知道什麼
在深度學習尚未成為電腦視覺標準工具的 2012 年,訓練大規模卷積神經網路面臨數項根本瓶頸。要理解 AlexNet 下篇的各項設計,必須先釐清既有方法與過去作法為什麼不夠:
- 傳統淺層方法與特徵工程的表達能力瓶頸:過去的主流視覺管線依賴手工設計特徵(如 SIFT、HOG)結合局部編碼(如 Fisher Vectors、Sparse Coding)與支持向量機(SVM)。這類既有方法在千類規模、百萬張高解析度影像的 ImageNet 上難以捕捉複雜的階層化語義,難以透過增加資料量獲得持續突破。
- 飽和激活函數造成的梯度消失瓶頸:傳統神經網路廣泛採用飽和非線性激活函數,例如 Sigmoid 或雙曲正切 。這類函數在輸入絕對值較大時,導數迅速趨近於零()。在多層反向傳播過程中,連續相乘的微小梯度使早期卷積層的權重更新近乎停滯,導致大網路訓練極端緩慢。
- 單卡硬體顯存與運算頻寬的硬限制:2012 年頂級桌面級加速晶片(NVIDIA GeForce GTX 580)僅具備 3GB 顯存。AlexNet 的前向特徵圖(activation maps)、反向梯度緩衝區與 6,000 萬個浮點參數,其記憶體需求遠超單張顯示卡容量。若無跨卡分散方案,該規模網路根本無法在單機環境執行。
- 模型容量與有限資料間的嚴重過擬合:網路具備 6,000 萬個參數與 65 萬個神經元,自由度極高。即便 ImageNet 擁有 120 萬張訓練影像,若僅以固定中心裁剪進行訓練,網路仍具備強大的死記能力;而傳統藉由訓練多個獨立大型網路進行模型集成(Ensemble)的成本過於昂貴。
因此,過去方法留下的核心困境在於:既需要巨大的參數量來擬合複雜資料,又缺乏能讓深層網路在合理時間內收斂、且不發生嚴重過擬合的系統性訓練方法。
核心直覺
AlexNet 下篇的核心直覺非常明確:深度模型的容量不是孤立的數學物件,訓練成功取決於優化速度、硬體記憶體分配、有效資料分佈擴增與近似集成機制的系統協同。
在決策規則上,先前的直覺是「使用飽和激活函數防止數值發散、依賴 L2 正則化與提早停止、將模型大小限制於單一晶片記憶體」。而 AlexNet 將決策規則全面重構為四項可驗證的工程支柱:
- 以不飽和激活取代飽和激活:採用整流線性單元(Rectified Linear Unit, ReLU)。在正半軸上梯度恆為 1,徹底消除飽和區間,將梯度下降優化速度提高數倍;
- 以非對稱卡間通訊取代全局同步:將網路模型手動切分至兩張 GPU,但只在特定層進行跨卡全連接,其餘層維持卡內獨立運算,以通訊頻寬交換模型容量;
- 以標籤保持轉換在線擴增有效訓練分佈:藉由隨機空間幾何平移、水平翻轉與特徵空間的 PCA 主成分色彩抖動,將原本有限的靜態樣本轉化為廣闊的連續分佈;
- 以隨機神經元遮罩近似指數級子網路集成:在全連接層中引入 Dropout 機制,以單一網路的訓練代價,近似權重共享的巨大模型集成,破壞神經元之間的固定協同適應。
用一個例子走完整個方法
為了具體理解 AlexNet 的完整訓練與推論生命週期,以下以一張標註為「雪橇犬(husky)」的原始影像為例,走完這五個標準執行步驟:
- 輸入與資料擴增(Input and label-preserving transformations):原始影像具有不同長寬比,系統先將短邊等比例縮放至 256 像素,並從中心裁切出 區塊。在訓練迭代中,資料管線在 CPU 上即時隨機抽取一個 的子區塊,以 50% 機率進行水平翻轉,並在像素 RGB 通道加上基於 ImageNet 全局協方差矩陣的 PCA 顏色擾動向量。此時,原本單一的靜態照片轉化為多樣化的動態訓練樣本。
- 中間表徵與雙卡分流(Intermediate representation and split topology):增強後的 影像輸入第一層卷積。96 個 的卷積核被均勻分配至兩張 GPU(每張卡負責 48 個核)。隨後的第二層卷積核僅能讀取同卡上的第一層特徵圖;直到第三層卷積,兩張卡才進行跨卡全通道交換,使高階特徵能夠融合雙卡的早期感知;第四、五層卷積再度回歸局部卡內運算。
- 決策、轉換與正規化介入(Decision, transformation, and regularization):卷積特徵圖展平後進入兩層各 4,096 單位的全連接層(FC6 與 FC7)。在前向傳播計算中,Dropout 機制以機率 隨機將一半隱藏單元的輸出直接強制歸零。未被遮罩的單元輸出乘以 2(或在反向傳播時維持縮放),這迫使每一個神經元必須在隨機失去協同夥伴的條件下獨立提取穩健特徵。
- 推論輸出與測試時集成(Output and test-time ensembling):在評測階段,關閉 Dropout 並將隱藏層權重乘以 0.5。對於測試影像,系統從四個角落與中心提取五個 裁剪,連同各自的水平翻轉共獲得 10 個視角(10-crop)。網路對這 10 個區塊分別進行前向傳播,在 1,000 維的 Softmax 輸出層計算機率分佈並取算術平均,以平均機率最高的前五個類別作為 Top-5 預測。
- 潛在失敗點與邊界(Likely failure point and boundary):若測試物體恰好位於影像邊緣且不在這 10 個固定裁剪覆蓋的視野內,或者場景光照變異遠超 PCA 高斯擾動範圍,分類器將產生不可逆的特徵缺失。此外,10 次前向傳播使推論延遲與算力開銷放大 10 倍,這在延遲敏感的生產服務路徑上構成顯著的成本阻礙。
技術機制
AlexNet 的系統實現建立在五層卷積與三層全連接層的組合上,並由非飽和優化、卡間通訊、正則化算子與隨機梯度下降共同驅動。
網路拓撲與雙 GPU 分割架構
論文 Figure 2 詳盡繪製了網路的層級維度與雙卡分割拓撲:
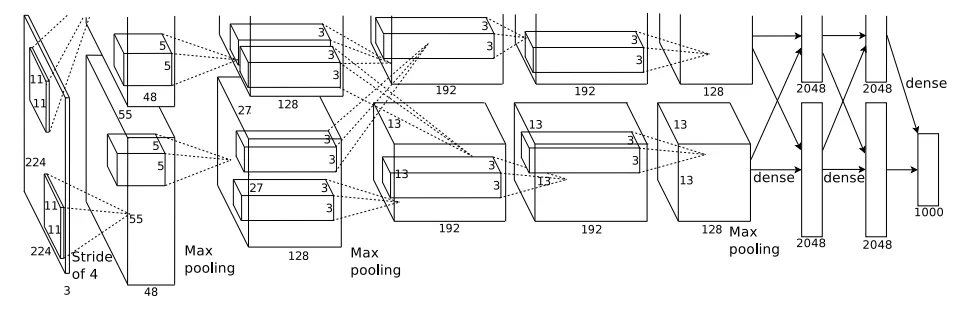
Figure 2,論文 Section 3.5 的網路架構與雙 GPU 分割:展示 224×224×3 輸入影像、五層卷積層與三層全連接層的尺寸,以及第二、四、五層在兩張 3GB GTX 580 上的局部卡內連接與第三、六層的跨卡通訊折衷。原始 Figure 2 來源。這張圖取自 NeurIPS 2012 論文集;版權屬原作者與出版方所有,本文作學術評論與教學引用,未主張 CC BY 授權。
輸入尺寸在圖中標示為 (若嚴格計算第 1 層 padding 則實際可能為 ),整個網路的前向層級運算可逐層形式化追蹤:
- 第一層卷積(Conv1):使用 96 個尺寸為 的卷積核,步幅(stride),padding 為 0。輸出特徵圖維度為 。核被均分於兩張 GPU(每卡 48 核)。隨後接續 ReLU 激活、局部響應正規化(LRN)以及 (步幅 2)的重疊最大池化(Overlapping Max Pooling),空間維度降至 ;
- 第二層卷積(Conv2):使用 256 個尺寸為 的卷積核,padding 為 2。此處兩張 GPU 上的卷積核僅連接至同一張 GPU 上的 Conv1 特徵圖。輸出為 。同樣經由 ReLU、LRN 與重疊最大池化,空間維度降至 ;
- 第三層卷積(Conv3):使用 384 個尺寸為 的卷積核,padding 為 1。此處發生跨卡全連接,GPU 1 與 GPU 2 上的核同時讀取 Conv2 來自兩張卡的全部 256 個特徵圖。輸出特徵圖維度為 (每卡 192 特徵圖),接續 ReLU;
- 第四層卷積(Conv4):使用 384 個尺寸為 的卷積核,padding 為 1。再度回歸卡內局部連接,每張卡僅讀取同卡上的 Conv3 輸出。接續 ReLU,輸出為 ;
- 第五層卷積(Conv5):使用 256 個尺寸為 的卷積核,padding 為 1,維持卡內局部連接。接續 ReLU 與重疊最大池化,特徵圖空間維度最終降至 (每卡 128 通道);
- 全連接層(FC6、FC7 與 FC8):FC6 將兩張卡共 個特徵展平,與 4,096 個神經元全連接;FC7 具備 4,096 個神經元;FC8 為 1,000 維輸出,接續 Softmax 函數計算交叉熵損失。FC6 與 FC7 均採用 ReLU 與 Dropout。
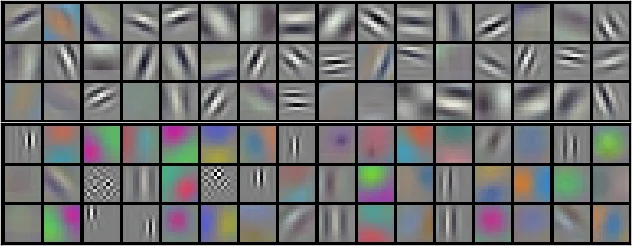
Figure 3,論文 Section 3.5 與 Section 6 的第一卷積層特徵可視化:上方 48 個卷積核由 GPU 1 學習,偏向無色彩的方向邊緣與紋理;下方 48 個卷積核由 GPU 2 學習,高度聚焦於大面積色彩斑塊,呈現雙 GPU 拓撲引發的特異化分工。原始 Figure 3 來源。圖表取自 NeurIPS 2012 論文集;版權屬原作者與 NeurIPS,本文供學術評論引用,未主張 CC BY 授權。
非飽和激活函數(ReLU)的優化機制
傳統以 為激活函數的神經元,在梯度下降中被作者定義為飽和非線性單元(saturating non-linearities)。當 較大時,梯度 趨近於零。
AlexNet 採用 Nair 與 Hinton(2010)提出的整流線性單元:
在 時,導數恆等於常數 1。這意味著無論網路前向層數多深,反向傳播的梯度不會因為激活函數本身的乘積效應而指數級衰減。作者在 Section 3.1 與 Figure 1 中以一個四層卷積網路在 CIFAR-10 上進行受控對照:達到 25% 訓練誤差時,ReLU 網路所需的迭代輪數僅為 網路的六分之一。
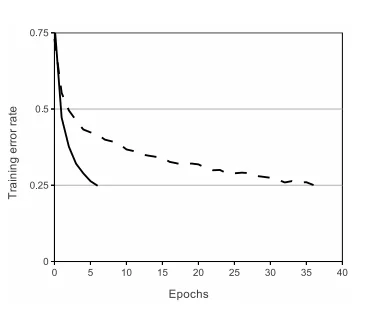
Figure 1,論文 Section 3.1 的非飽和激活函數收斂診斷:實線為 ReLU,虛線為 tanh;達到 25% 訓練誤差時,ReLU 網路的速度比 tanh 快 6 倍,驗證了非飽和激活函數對加速梯度優化的關鍵作用。原始 Figure 1 來源。圖表取自 NeurIPS 2012 論文集;版權屬原作者與 NeurIPS,本文保留來源供學術評論,未主張 CC BY 授權。
局部響應正規化(Local Response Normalization, LRN)
受神經生物學中側向抑制(lateral inhibition)現象的啟發,作者在特定卷積層的 ReLU 之後設計了 LRN 算子:
其中 代表在位置 處應用第 個卷積核並經由 ReLU 運算後的激活值, 為該層總卷積核數量。超參數設為 、、、,並由驗證集決定。
需要嚴格釐清的是:LRN 本質上是沿相鄰通道維度進行平方和能量歸一化,屬於局部亮度歸一化(brightness normalization)。它並未減去平均值,也未追蹤跨樣本的批次統計量,這與現代批次歸一化(Batch Normalization)的數值意義與穩定內部協變量漂移(Internal Covariate Shift)的作用機制完全不可相提並論。
重疊池化(Overlapping Pooling)
傳統池化層通常設置池化單元尺寸 等於步幅 (即 ),相鄰池化網格互不重疊。AlexNet 在 Section 3.4 採用 、 的重疊設定()。相較於傳統不重疊池化(),作者在相同網路維度下觀察到 Top-1 與 Top-5 錯誤率分別降低 0.4% 與 0.3%,並報告重疊池化在訓練中稍微不易陷入過擬合。
兩階段資料增強配方
為了抑制 6,000 萬參數帶來的過擬合,論文在 Section 4.1 設計了兩種計算成本低廉的資料擴增方法:
- 隨機幾何平移與水平鏡像:從 影像中隨機提取 區塊並進行水平翻轉。這在理論上為每張影像構造出 種位置與鏡像變換。但必須注意,這些樣本在空間上高度重疊相依,並非 2,048 倍的獨立新樣本;
- RGB 像素特徵空間 PCA 色彩抖動:在 ImageNet 整體訓練集的像素 RGB 數值上執行主成分分析(PCA)。對每張訓練影像,設其協方差矩陣特徵向量為 ,對應特徵值為 。每次該影像被輸入時,系統抽取服從高斯分佈 的隨機變數,並將以下偏移量加到所有像素上:
此操作旨在捕捉自然影像在光照強度與色彩分佈上的固有不變性(illumination invariance),同時保留物件的核心結構與類別標籤。
隨機失活(Dropout)
在 FC6 與 FC7 中,Dropout 機制以機率 將每個隱藏神經元的輸出設為 0。被失活的神經元既不參與前向傳播,也不參與梯度反向傳播。
在每一次前向輸入時,架構實質上都在抽樣一個獨特且共享權重的子網路結構。因為任何兩個神經元無法保證在下一次迭代中共同出現,模型被迫學習不能依賴特定合作者的穩健特徵。在推論階段,所有神經元均處於激活狀態,但其輸出純量乘以 0.5,在數學上近似於幾何平均所有子網路預測分佈。作者報告,缺乏 Dropout 將引發災難性過擬合,而引入 Dropout 的代價是收斂所需的迭代次數大約翻倍。
優化算法與動量機制
網路採用批次大小為 128 的隨機梯度下降法(SGD),衝量(momentum)設為 0.9,權重衰減(weight decay)設為 0.0005。權重向量 的更新動態遵循:
其中 為迭代索引, 為動量速度變數, 為學習率, 為第 個批次 上的目標函數梯度平均。作者在 Section 5 中明確指出:0.0005 的權重衰減在該設定下不僅扮演 L2 正則化角色,更實質降低了模型的訓練誤差。
初始學習率設為 ,並遵循手動驗證集啟發式調校:每當驗證集錯誤率停止改善時,手動將學習率除以 10。在兩張 3GB GTX 580 顯示卡上,經歷約 90 個 epoch、歷時 5 至 6 天完成訓練,期間學習率總共縮減了 3 次。
實驗如何讀
閱讀 AlexNet 的實驗結果時,必須嚴格區分「針對單一模組的受控診斷」與「整個系統在競賽中的最終表現」,避免將整體誤差的下降粗暴地歸因於某個特定旋鈕。
基準環境與評測維度
論文的核心實驗分佈於兩個主要資料集切分:
- ILSVRC-2010 評測:具備完整的訓練集(1.2M 影像)、驗證集(50,000 影像)以及已公開標籤的測試集(150,000 影像)。指標採用單一預測錯誤率(Top-1 error)與前五名候選未涵蓋標籤之錯誤率(Top-5 error);
- ILSVRC-2012 競賽:測試集標籤完全未公開,僅能透過主辦方伺服器提交獲得測試評分。
對照基線(Baselines)涵蓋了當時基於手工特徵的頂尖系統:NEC 團隊的稀疏編碼(Sparse Coding)以及泛歐團隊的密集 SIFT 特徵結合 Fisher 向量編碼。
元件級受控診斷(Component Diagnostics)
論文在 Section 3 與 Section 4 報告了一系列局部消融數據:
- ReLU 優化加速(Section 3.1、Figure 1):在 CIFAR-10 上以四層卷積網路測試,ReLU 達到 25% 訓練誤差的速度比 快 6 倍。邊界:這是特定小型網路在固定訓練集上的收斂速度診斷,不能直接線性換算為 ImageNet 上的最終分類準確率增益;
- 雙 GPU 分流效益(Section 3.2):相較於在單張 GPU 上訓練一個每層卷積核數量減半的較小網路,雙 GPU 拓撲使 Top-1 與 Top-5 錯誤率分別下降 1.7% 與 1.2%。邊界:作者在腳註 4 中坦承,單卡對照組的最後一層卷積與全連接層參數並未嚴格減半,因此該比較在參數規模上對單卡基準略微偏袒;
- 局部響應正規化(Section 3.3):在無雙 GPU 分割的四層網路上,引入 LRN 使 Top-1 與 Top-5 錯誤率分別下降 1.4% 與 1.2%;
- 重疊池化(Section 3.4): 相較於 不重疊池化,使 Top-1 與 Top-5 錯誤率降低 0.4% 與 0.3%;
- PCA 色彩抖動(Section 4.1):作者報告色彩增強使 Top-1 錯誤率下降超過 1 個百分點;
- Dropout 消除過擬合(Section 4.2):缺乏 Dropout 時網路呈現實質的嚴重過擬合;引入 Dropout 使得訓練達到收斂所需的迭代次數約略加倍。
基準評測對比(Table 1 與 Table 2)
在 ILSVRC-2010 測試集上(Table 1):
- 稀疏編碼(Sparse Coding 基線):Top-1 為 47.1%,Top-5 為 28.2%;
- Fisher 向量(SIFT + FVs 基線):Top-1 為 45.7%,Top-5 為 25.7%;
- AlexNet(單一 CNN):Top-1 降至 37.5%,Top-5 降至 17.0%。
在 ILSVRC-2012 競賽中(Table 2 與 Section 6):
- 傳統特徵最優次名方案的 Top-5 錯誤率為 26.2%;
- AlexNet 單一模型(未集成、單次前向)達到 18.2%;
- AlexNet 五模型集成(結合不同預訓練檢查點與結構微調)達到 16.4%;
- 進一步結合額外 ImageNet 預訓練資料後的六模型集成達到標誌性的 15.3%。
這項歷史性跨越確立了深層卷積神經網路的壓倒性優勢,但必須強調:這項勝利是「ReLU + 雙卡分割 + 資料增強 + Dropout + 手動學習率 SGD」整套系統配方的總體結果,無法從中將功勞單一歸給卷積層數或某個特定超參數。
證據地圖
為了清楚劃分論文所建立的客觀事實與推論界限,AlexNet 下篇的結論被嚴格界定為四個層次:
論文直接證據
- ReLU 加速收斂診斷:Section 3.1 與 Figure 1 證明,在 CIFAR-10 四層卷積網路中,使用 ReLU 取代 能將達到 25% 訓練誤差的優化迭代數縮短至六分之一;
- 多 GPU 分割誤差降低:Section 3.2 證明,雙卡非對稱拓撲相較於參數量受限的單卡模型,能降低 1.7% Top-1 與 1.2% Top-5 錯誤率;
- 局部響應正規化與重疊池化微幅改善:Section 3.3 與 3.4 報告 LRN 降低 1.4%/1.2% 錯誤率,重疊池化降低 0.4%/0.3% 錯誤率;
- 資料增強與 Dropout 抑制過擬合:Section 4.1 證明 PCA 色彩增強帶來 >1% 的 Top-1 改善;Section 4.2 證明 Dropout 成功阻止了 6,000 萬參數全連接層的過擬合,儘管收斂耗時加倍;
- ImageNet 基準突破:Table 1 證明在 ILSVRC-2010 上取得 37.5%/17.0% 錯誤率,顯著超越 SIFT/Fisher 向量的 45.7%/25.7%。
作者因果解讀
- ReLU 為訓練大網路的必要前提:作者主張若無 ReLU,受限於反向傳播梯度飽和,在當時的硬體條件下不可能在數天內訓練完成八層深度的卷積神經網路;
- 雙 GPU 拓撲為兼顧容量與通訊的最佳折衷:作者認為第二、四、五層卡內獨立、第三與全連接層跨卡連接的設計,是在 GTX 580 頻寬與顯存限制下最大化網路特徵容量的最佳架構;
- Dropout 實現了指數級子網路的隱式集成:作者將 Dropout 描述為極低成本的集成近似,認為其阻止了特徵間脆弱的共適應現象;
- 權重衰減具備非平凡的優化效能:作者主張在該特定 SGD 配方下,0.0005 的 weight decay 並非僅為單純正則化約束,反而促進了模型進一步降低訓練誤差。
論文未證明
- 未給出全因子交叉消融(Full Factorial Ablation):論文的元件實驗多在不同階段、不同小型網路或不同資料子集上進行。論文未證明當移除 LRN 或重疊池化時,在包含完整 Dropout 與資料增強的全尺寸 AlexNet 上是否具備統計顯著的誤差差異;
- 未證明雙 GPU 特殊連接優於全局資料並行:受限於當年的自製 CUDA 程式庫,作者未與現代資料並行(Data Parallelism)進行吞吐量與通訊開銷的標準橫向對比;
- 未證明 LRN 為通用歸一化解:論文未與後續出現的批次歸一化(BatchNorm)或層歸一化(LayerNorm)進行比較,亦未證明其在更深層網路中的數值穩定性;
- 未排除驗證集反覆調校帶來的選擇偏差:學習率衰減節奏與 LRN 超參數均依據驗證集手動決定,論文未在多個隨機種子或獨立測試集上提供信賴區間(Confidence Intervals)。
Bloss0m 工程化整理
- 系統配方大於孤立技巧:AlexNet 的本質是一套由底層硬體記憶體拓撲驅動的系統工程。過度神化其 11×11 卷積或雙卡通道分組,而忽略其背後的顯存約束與資料擴增邏輯,是常見的工程誤讀;
- 歷史硬體限制的識別與剝離:雙 GPU 通道分組與 LRN 是 2012 年特定的時代產物。在現代硬體與框架中,應果斷以分散式資料並行(DDP)與 BatchNorm/LayerNorm 替換之;
- 實驗假設的解耦原則:在建立視覺基準時,應嚴格分離「模型容量與表達力(網路結構)」、「優化收斂能力(激活函數與優化器)」與「泛化邊界(資料增強與正則化)」,針對每個維度建立獨立的監控指標。
Artifact 與可重現性
本文依據的論文為發表於 NeurIPS 2012 的正式論文。在評估該奠基之作的重現性時,必須區分歷史代碼遺產與現代框架重構的客觀限制。
截至 2026-08-09,原論文作者於 Google Code 釋出的原生 cuda-convnet 程式碼倉庫已成為歷史存檔鏈接,且其依賴高度特化的硬體組譯與已廢棄的 CUDA 驅動架構,無法作為開箱即跑的現代可執行 artifact。可公開取得且具備廣泛參考價值的複現基準是伯克利視覺中心維護的 BVLC Caffe AlexNet 模型定義,該倉庫提供了標準的 prototxt 結構與預訓練權重工作流,屬於 可用的部分複現資產(usable partial artifact)。
在重現性維度上,工程實作者應清楚區分三個驗證層級:
- 功能重建(Functional Reconstruction):在現代深度學習框架(如 PyTorch)中按照 Figure 2 搭建等效的卷積與全連接層序列,輸出形狀完全吻合。此層級在現代環境中可 100% 達成;
- 協定重建(Protocol Reconstruction):嚴格落實 隨機裁剪、水平翻轉、PCA 色彩擾動、Dropout 比率 0.5、SGD 動量 0.9、權重衰減 0.0005 以及驗證集驅動的學習率手動階梯衰減。此協定可完整對齊;
- 數值精確重建(Numerical Reconstruction):試圖在 ILSVRC 測試集上達成與原論文 Table 1(37.5%/17.0%)或 Table 2(15.3%)完全逐位元對齊的誤差數值。由於 ILSVRC 競賽官方未公開正式測試集標籤、原始資料解碼器隨機性、浮點運算非決定性以及作者原始學習率衰減決策包含人工介入,此層級在客觀上不可嚴格復現。
獨立重現範疇聲明: 本文所引用之實驗數據與消融數值均嚴格源自原論文作者報告之結果。本精讀並未在本地耗費數天訓練 ImageNet 完整模型,而是透過審核原論文原始數據、數學定義與公開模型檔案完成工程考證。
Bloss0m 工程判斷與不適用條件
結合機器學習工程實踐,以下對 AlexNet 下篇各項技術的適用情境提出明確判斷:
何時值得採用 AlexNet 的工程方法論
- 建立卷積網路訓練的最小對照基線(CNN Baseline):當團隊需要在邊緣設備或特定領域自建小規模卷積網路時,AlexNet 展現了最經典的「資料增強 + ReLU + 動量 SGD + 階梯衰減」基礎配方,適合作為檢驗管線是否連通的第一步;
- 將訓練管線與硬體吞吐量解耦設計:借鑑其利用 CPU 在 GPU 計算前一個批次時即時完成影像解碼與隨機擴增的流水線設計(Pipeline Overlapping),確保 GPU 計算核心永遠不處於飢餓等待狀態;
- 正則化手段的逐項量測意識:將資料幾何擴增、特徵色彩擾動與 Dropout 的泛化收益分開量測,而非盲目同時疊加所有正則化技巧。
什麼時候不要直接套用
- 切勿在生產代碼中保留局部響應正規化(LRN):LRN 運算繁瑣且缺乏跨樣本統計支持,早已被批次歸一化(Batch Normalization)與層歸一化(Layer Normalization)徹底取代。盲目引入 LRN 僅會增加額外的核心呼叫與顯存存取延遲;
- 切勿複製雙 GPU 局部連接拓撲:Figure 2 中第二、四、五層的卡內封閉與第三層的跨卡通訊,純粹是為了解決兩張 3GB GTX 580 顯存與 PCI-e 頻寬不足的無奈折衷。現代單張 GPU(如 24GB、80GB 顯存)可輕易容納整個模型,跨卡訓練應採用標準的分散式資料並行(DDP)或張量並行(Tensor Parallelism),硬編碼卡間通道分組只會帶來災難性的程式碼複雜度;
- 切勿在即時線上服務中採用 10 裁剪推論(10-crop Inference):在生產推論服務中,10 次前向傳播會帶來近乎 10 倍的運算耗時與伺服器成本。現代視覺模型透過更好的預訓練與單次前向裁剪即可取得遠超 10-crop 的準確率;
- 切勿採用人工盯盤的手動學習率衰減:原論文的學習率下調完全仰賴研究員人工觀察驗證集損失。現代訓練流程應全面採用餘弦退火(Cosine Annealing)搭配預熱(Warmup)或驗證損失自適應排程器(ReduceLROnPlateau)。
關於更深層網路遭遇的退化問題(Degradation Problem)以及如何透過殘差捷徑取代平坦卷積堆疊,請參閱本系列的延伸閱讀:ResNet 精讀:深度殘差學習的本質。
讀完後的三個記憶點
- 技術思想:AlexNet 的歷史性躍進不是單純增加深度,而是將不飽和非線性激活(ReLU)、雙卡顯存拓撲、資料空間連續擴增與隱式子網路集成(Dropout)整合成可工程化收斂的完整系統。
- 核心證據:ReLU 讓小型 CNN 收斂速度提升 6 倍,PCA 色彩增強貢獻逾 1% 的 Top-1 增益,全系統在 ILSVRC-2010 取得 37.5%/17.0% 錯誤率,在 2012 競賽中以 15.3% Top-5 壓倒手工特徵次名的 26.2%。
- 工程邊界:論文呈現的是單因子消融而非全因子矩陣驗證;LRN、雙 GPU 特殊連接與 10 裁剪推論均屬特定的時代硬體妥協,現代工程實作應以 BatchNorm、DDP 與單次推論予以替代。
Primary sources
- AlexNet 完整論文 PDF(NeurIPS 2012):Figure 1–3、Sections 3–6、Table 1–2。
- BVLC Caffe AlexNet 模型定義倉庫:開源社群廣泛驗證之可用部分複現資產(prototxt 與權重檔案)。
- AlexNet(上):先用證據讀懂它為何改變 ImageNet:本系列第一部分,專注於競賽評測環境、問題意識與宏觀架構。
- ResNet 論文精讀:深度殘差學習:深度卷積網路退化問題與殘差學習跳躍連接之後續演進。