讀法可搭配 三遍掃描法。在本站的 CV 基礎方法主線中,YOLO 接在 AlexNet(上)/(下) 與 ResNet 之後。AlexNet 證明大型 CNN 可以有效訓練,ResNet 讓更深的分類骨幹更容易優化;YOLO 則將物件偵測改成整張圖一次前向,同時迴歸邊界框與類別,並把延遲(FPS)列為核心證據。
90 秒掌握論文 / The paper in 90 seconds
- 問題:2016 年前主流偵測器(DPM、R-CNN、Fast/Faster R-CNN)把分類器或區域提議、特徵、分數、後處理拆成多段管線,難以端到端優化,測試也慢(例如 R-CNN 逾 40 秒/張、Fast R-CNN 約 0.5 FPS)。
- 核心洞見:把偵測改寫成 單一迴歸:輸入整張圖,單一 CNN 直接輸出空間上分散的邊界框與類別機率。控制點是 one-shot global reasoning 對 two-stage propose-then-classify;整個管線是一個網路,可端到端以偵測損失訓練(Section 1–2、Figure 1–2)。
- 最強證據:PASCAL VOC 2007(Table 1,train 2007+2012):YOLO 63.4% mAP、45 FPS(Titan X、無 batch);Fast YOLO 52.7% mAP、155 FPS。同表對照 Fast R-CNN 70.0% mAP、0.5 FPS;Faster R-CNN VGG-16 73.2% mAP、7 FPS。Figure 4:YOLO 定位錯誤 19.0% 為主,背景誤報 4.75% 遠低於 Fast R-CNN 13.6%。
- 主要邊界:粗網格(每格僅 2 框、1 類)、VOC 20 類、非 instance segmentation;VOC 2012 test 57.9% mAP 低於當時 leaderboard 頂端。YOLOv2/v3/v8、COCO 2017、Ultralytics 產品 mAP 不屬本 PDF;ResNet-152 ImageNet 4.49% 亦不是偵測契約。
我的結論是:YOLO 最值得保留的貢獻,是用一次前向完成偵測,並在同一張表比較延遲與 mAP。VOC 2007 的 63.4%/45 FPS 則不能直接當成 2026 影片串流或 COCO 產品的 SLA。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Redmon et al., CVPR 2016 對應的 arXiv:1506.02640 v5(2016-05-09 修訂)。PDF 標示 arXiv.org perpetual non-exclusive license;CVPR camera-ready 另受 IEEE 條款約束。作者順序以 PDF 為準:Joseph Redmon、Santosh Divvala、Ross Girshick、Ali Farhadi(University of Washington、Allen Institute for AI、Facebook AI Research)。
除摘要外,本文核對 Section 2 統一偵測公式與網路、Section 2.2–2.4 訓練/推論/限制、Section 3 與兩階段偵測對照、Section 4.1–4.4 實驗(Table 1–3、Figure 4–5),以及截至 2026-08-28 的 pjreddie.com/yolo 與 Darknet 連結。YOLOv2 之後版本、COCO 2017 leaderboard、ResNet 分類表,都不回填。
讀者真正要回答的問題
當你已能訓練 AlexNet/ResNet 級 CNN,卻要把 多物件、多類別、帶框 的偵測做成可部署系統時,該沿用 R-CNN 式「先提議再分類」,還是把整張圖編碼一次、直接迴歸框與機率?Redmon et al. 選後者,並用 VOC mAP 與 FPS 同時報告取捨。
比較精確的讀法不是「YOLO 是不是 2026 最準偵測器」。真正的問題是:單次迴歸如何改寫管線與錯誤型態、VOC-era 數字支持什麼、以及哪些後來產品數字不能寫回這篇。
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1–3 定義單次管線、S×S 網格與 24 conv + 2 fc 架構;Equation (1)(3) 與 S=7,B=2,C=20→7×7×30;Table 1 VOC 2007 mAP/FPS;Figure 4 錯誤分解;Table 2 Fast R-CNN+YOLO 75.0% mAP;Table 3 VOC 2012 YOLO 57.9% mAP。 |
| 作者主張 | 統一架構極快、全圖上下文減少背景誤報、表示可泛化到藝術品(Figure 5);YOLO 可為 Fast R-CNN 重打分以互補錯誤。 |
| 論文未證明 | 超越當時最高 mAP 的整體 SOTA;小物體/密集群體;任意資料集上的即時 SLA;後續 YOLO 家族或 COCO 數字。 |
| Bloss0m 工程判斷 | 把本篇放在 CV 基礎方法主線的偵測段落,接在 ResNet 分類骨幹之後。Ultralytics、YOLOv8 COCO 與 ResNet ImageNet 的結果不屬於本篇證據。 |
先前方法為何不足 / Why the previous approach is insufficient
Section 1 與 3 把脈絡寫清楚。DPM 用滑動視窗與分離的特徵/分類管線。R-CNN 以 Selective Search 產生約 2000 個候選框,再跑 CNN 特徵、SVM、框調整與 NMS——每段獨立訓練,測試逾 40 秒/張。Fast R-CNN 加速分類階段,仍依賴 Selective Search(約 2 秒/張 產生提議),整體 0.5 FPS(Table 1)。Faster R-CNN 用神經網路提議,VGG-16 版 7 FPS、73.2% mAP,仍非即時。
ResNet 解的是 ImageNet 分類 深度可訓;其 COCO 表是 Faster R-CNN 換 backbone 的轉移實驗,不是 one-stage 迴歸。AlexNet 雙篇教的是 大 CNN 分類系統;它們沒有處理「多框多類、延遲第一類指標」的偵測管線。
核心直覺 / Core intuition
先不要背 24 層細節。想像一張含人、狗、車的街景:兩階段法 先問「哪裡可能有物體?」再對每塊 patch 分類與修框;YOLO 把圖縮到 448×448,用一個 CNN 輸出 7×7 網格,每格負責「中心落在格內」的物體,預測 2 個框(座標、confidence)與 20 類條件機率,合併成 7×7×30(Figure 2、Section 2)。
推論時,整張圖的 7×7 網格共產生 98 個候選框(7×7×2;每格 2 個),再以 class×confidence 分數過濾;NMS 可再增加 2–3% mAP(Section 2.3),但整體後處理仍比 R-CNN 的多段管線簡單。
對照三種容易混在一起的下一步:
- Faster R-CNN(兩階段):RPN 提議 + RoI 分類;73.2% mAP、7 FPS(Table 1)——準但慢。
- YOLO(本篇):單網路迴歸;63.4% mAP、45 FPS——犧牲部分 mAP 換即時。
- 後來 YOLO 產品線(葉子):改 anchor、FPN、COCO 訓練等;數字不屬 2016 PDF。
用一個例子走完整個方法 / Walk one example through the method
以下用 Figure 1 街景走一個 PASCAL VOC 推論 例子,不是獨立實驗編號。
- Input:原始 RGB 圖 resize 至 448×448×3(Figure 1 step 1)。
- Intermediate representation:24 層 conv + 2 層 fc 輸出 7×7×30 tensor——每格 2 組 與 20 維 (Figure 2–3、Section 2)。
- Model or system decision:對每框計算 Equation (1) 的類別分數 ;閾值過濾低分框;NMS 去重(Section 2.3)。
- Output:整圖上少量框與標籤(Figure 1 step 3,例如 Person 94%、Dog 92%)。
- Likely failure point:物體中心落在格界線、或 小物體/密集群體——每格僅 2 框且共享一組類別機率(Section 2.4);定位偏差對小框 IOU 傷害大,故 Figure 4 顯示 localization 19.0% 為 YOLO 主錯誤來源。
技術機制 / Technical mechanism
網格、框與類別(Section 2)
- 圖分 S×S 格;物體 中心 落在哪格,該格負責偵測。
- 每格 B 個框,各含 ;confidence 。
- 每格一組 C 個條件類別機率。VOC:S=7, B=2, C=20 → 7×7×30。
損失與訓練(Equation 3、Section 2.2)
多部分 sum-squared error:座標()、含物體 confidence、不含物體 confidence()、類別。訓練時每物體只指派 IOU 最高 的框預測器負責。VOC 2007+2012 訓練約 135 epochs;batch 64、momentum 0.9、weight decay 0.0005;學習率 (75 epoch)再遞減。ImageNet 預訓練前 20 conv(224 輸入),偵測時升至 448。
架構(Figure 3、Section 2.1)
24 conv + 2 fc(GoogLeNet 啟發,以 1×1 降維 + 3×3 conv 取代 inception)。Fast YOLO 為 9 conv 的輕量版,其餘訓練/測試設定相同。
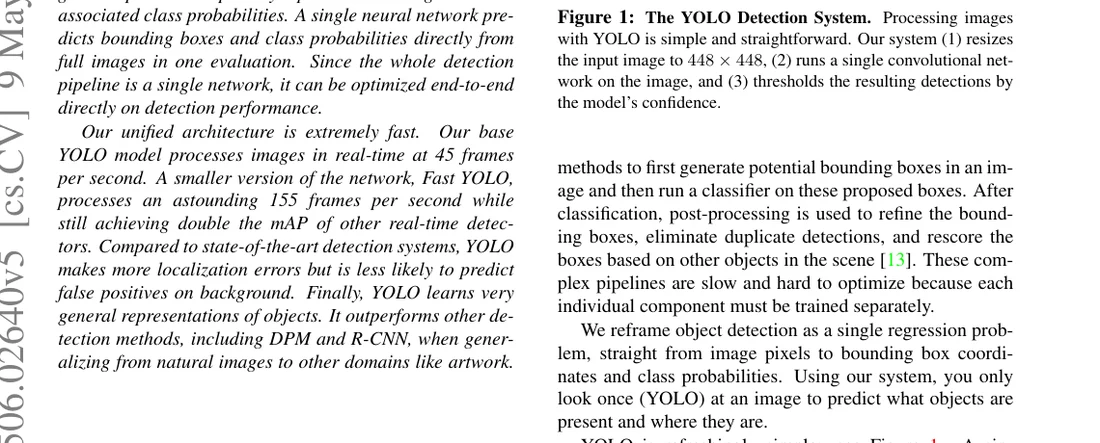
Figure 1,論文 Section 1:統一偵測管線示意。原圖見 arXiv PDF Figure 1。圖檔自 CVPR 2016 camera-ready PDF 擷取;版權屬作者/IEEE,本文保留來源,作學術評論用途,並依 arXiv reuse terms 標註。
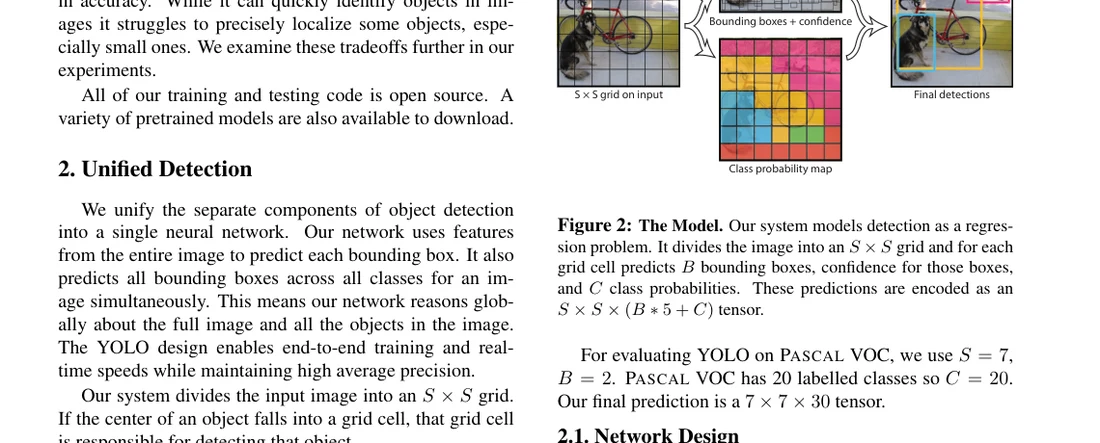
Figure 2,論文 Section 2:偵測即迴歸的張量視角。原圖見 arXiv PDF Figure 2。擷取與授權說明同 Figure 1。
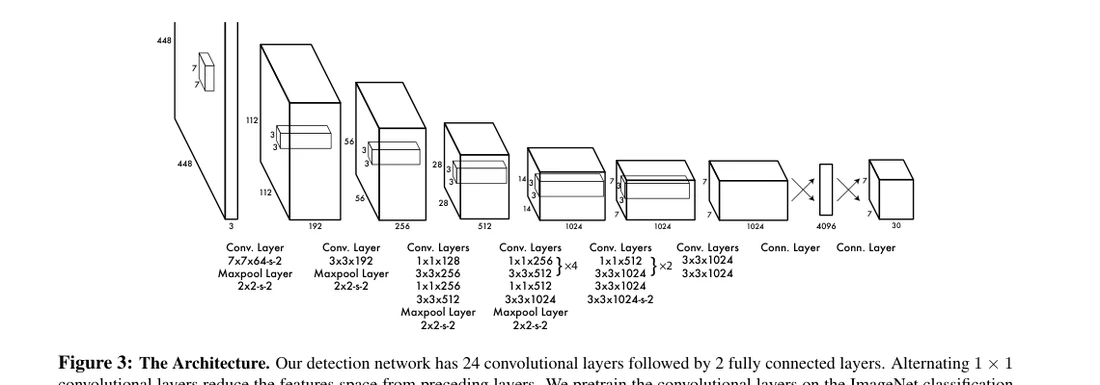
Figure 3,論文 Section 2.1:偵測網路架構(448 輸入)。原圖見 arXiv PDF Figure 3。擷取與授權說明同 Figure 1;長條架構圖在窄欄排版下可讀性有限,細節以 PDF 為準。
實驗如何讀 / How to read the evidence
Table 1:mAP 與 FPS 同表(Section 4.1)
問題:有沒有同時 >30 FPS 且 mAP 明顯高於先前即時法?控制:PASCAL VOC 2007 test;YOLO/Fast YOLO 訓練 2007+2012。觀察:Fast YOLO 52.7% mAP、155 FPS;YOLO 63.4% mAP、45 FPS——作者稱 Fast YOLO mAP 約為其他即時法 兩倍。邊界:Faster R-CNN VGG-16 73.2% mAP 高 ~10 mAP 但僅 7 FPS;Fast R-CNN 70.0% mAP、0.5 FPS。這是 速度—精度取捨表,不是 COCO 契約。
Figure 4:錯誤型態互補(Section 4.2)
問題:YOLO 為何 mAP 低於 Fast R-CNN 卻能互補?方法:Hoiem et al. 錯誤分解(correct/localization/background 等)。觀察:YOLO localization 19.0% 高於 Fast R-CNN 8.6%;YOLO background 4.75% 遠低於 Fast R-CNN 13.6%(約 3×)。邊界:解釋 Table 2 的 +3.2 mAP 重打分,不是單模型無條件超越。
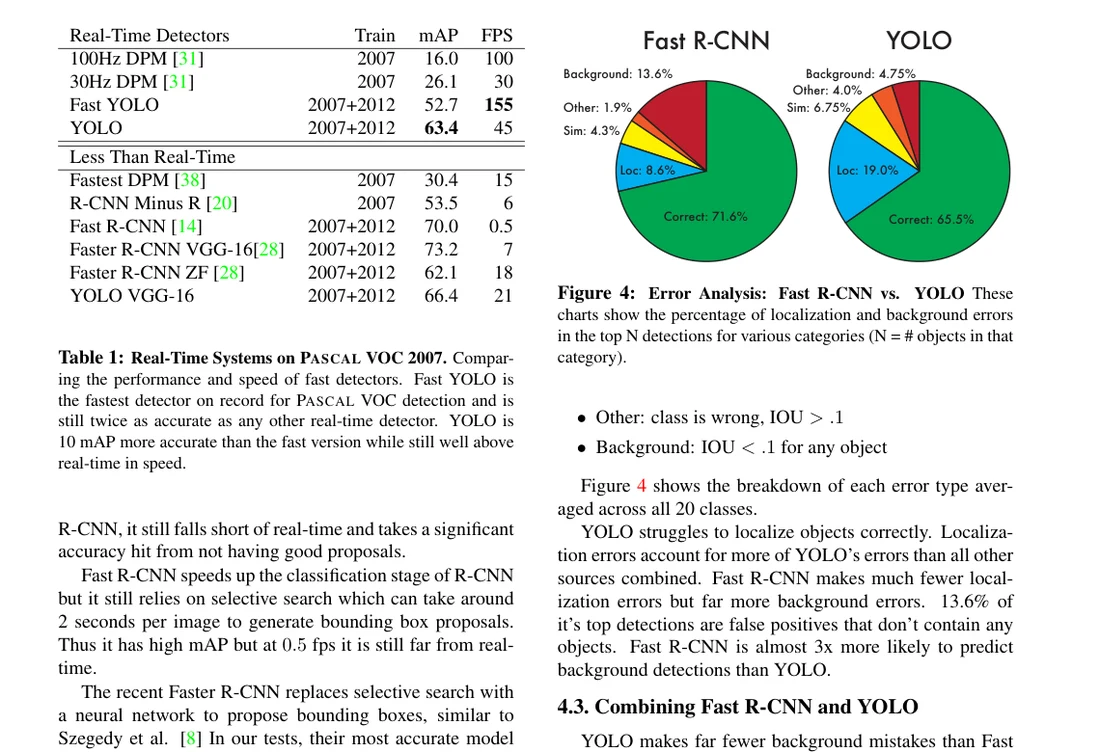
Figure 4 與 Table 1–2,論文 Section 4.1–4.3。原圖見 arXiv PDF 第 6 頁。本頁擷取含表格與圓餅圖,排版較擠;數字以 PDF 原文為準。擷取與授權說明同 Figure 1。
Table 2–3:組合與 VOC 2012(Section 4.3–4.4)
Table 2:最佳 Fast R-CNN 71.8%;加 YOLO 重打分 → 75.0%(+3.2);僅換 Fast R-CNN 變體 ensemble 僅 +0.3~0.6。Table 3:VOC 2012 test 公開榜 YOLO 57.9% mAP(唯一即時列);Fast R-CNN+YOLO 70.7%。YOLO 在 bottle、sheep、tv 等類別低 R-CNN 8–10%(小物體),cat、train 等類別反而較高——類別切片 不能簡化成單一句「輸贏」。
消融與設計選擇 / Ablations
- 網格粗細:S=7 強制空間分工,限制每格物體數與小物體(Section 2.4)。
- λ_coord / λ_noobj:平衡空框 confidence 梯度淹沒(Section 2.2)。
- √w, √h:大框小偏差懲罰較輕(Section 2.2)。
- NMS:+2–3% mAP,非 R-CNN 級依賴(Section 2.3)。
- YOLO VGG-16(Table 1):66.4% mAP、21 FPS——更準但作者後文聚焦更快模型。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- 粗網格與每格 2 框:難以處理鳥群等密集小物體(Section 2.4)。
- 定位為主錯誤:Figure 4;不應把 VOC mAP 劣勢只歸因「分類差」。
- 資料與類別:VOC 20 類自然影像;不等於開放詞彙或 COCO 80 類。
- 年代硬體:45 FPS 在 Titan X;今日需重測你的裝置與解析度。
- 不要混入後續結果:YOLOv2 anchor、YOLOv3 COCO、YOLOv8、RT-DETR 等皆屬後續方法。
- 與 ResNet 分開記:ResNet 教分類殘差;本篇教偵測管線——COCO +6 mAP 轉移表不能反向寫進 YOLO 單次迴歸證據。
工程判斷與不適用條件 / Engineering decision and when not to use it
何時借用本篇? 當產品把 端到端延遲 與 偵測品質 放在同一決策表、且能接受整圖單次解碼時,YOLO 的管線簡化仍是教科書級控制點。實作上先量 單次 forward 延遲 + NMS,再談 mAP。
何時不要照搬?
- 需要 SOTA mAP 且可接受兩階段成本——Table 1 顯示 Faster R-CNN 仍更高 mAP。
- 小物體/密集場景——先讀 Section 2.4 與 VOC 2012 類別切片。
- 把 63.4% VOC 2007 寫進 COCO 或 YOLOv8 產品 SLA。
- 混淆 Ultralytics 倉庫 與 2016 論文——後者是歷史起點,不是現成部署契約。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-28:
- 論文:arXiv abs、PDF 可讀、可存取;CVF open access 可開啟。
- 程式/模型:作者稱訓練與測試碼開源、提供預訓練模型(Abstract、Section 6);專案頁
http://pjreddie.com/yolo/為當年入口,Darknet 框架(Section 2.2)。此環境未逐項驗證下載連結是否仍 可下載;現代 PyTorch 重實作為 downstream ports,不等同原始訓練日誌。 - 資料:PASCAL VOC 2007/2012 可取得;與 ImageNet 預訓練切分不同。
最小有用 reproduction:在 VOC 子集上跑 單次 forward + decode 7×7×30,對照 FPS 與 localization/background 錯誤比例——驗證機制,不是復現 63.4%。
三個記憶點 / Three things to remember
- 技術想法:偵測=整圖一次 CNN 迴歸 S×S 網格上的框與類別;控制點是去掉 propose-then-classify 管線。
- 證據:VOC 2007 Table 1——YOLO 63.4% mAP、45 FPS;Fast YOLO 52.7%、155 FPS;Figure 4 定位錯多、背景錯少;Fast R-CNN+YOLO 75.0% 來自錯誤互補。
- 邊界:VOC 2012 57.9%,並受粗網格與小物體限制;這不是 YOLOv3/v8 或 COCO 的結果。AlexNet→ResNet→YOLO 這條基礎方法主線,依序處理分類訓練、深度殘差與統一即時偵測。
延伸閱讀
若尚未讀過起點,回到 AlexNet(上)、(下) 與 ResNet。讀法見 三遍掃描法。本篇是 原始 YOLO;序列轉換的下一節見 Transformer(原始)。後續 YOLO 版本與 COCO-era 偵測葉子刻意不展開。