讀法可搭配 三遍掃描法。在本站的 CV 基礎方法主線中,本篇接在 AlexNet(上)/(下) 之後。AlexNet 證明大型 CNN 可以在 ImageNet 上有效訓練;ResNet 則回答 plain 網路加深後為何反而變差,以及恆等捷徑如何改寫優化問題。
90 秒掌握論文 / The paper in 90 seconds
- 問題:在 BN 與良好初始化已讓「幾十層」能收斂之後,繼續堆深 plain 卷積層會出現 degradation——更深模型的 training error 反而更高(Figure 1、Figure 4 左),這不是典型 overfitting。
- 核心洞見:把目標映射改寫成殘差學習。若希望底層輸出為 ,不讓堆疊非線性層直接擬合 ,而讓它們擬合 ,再以恆等捷徑輸出 (Equation 1)。控制點是「優化器被要求從零擬合 ,還是在 identity 上學修正量 」。
- 最強證據:ImageNet 上同參數量的 plain-34 top-1 28.54% 差於 plain-18 27.94%;ResNet-34 25.03% 則優於 ResNet-18 27.88%(Table 2,10-crop validation)。CIFAR-10 上 plain-56 training error 超過 60% 不顯示,ResNet 家族隨深度降至 ResNet-110 6.43%(Table 6、Figure 6)。單模型 ResNet-152 top-5 validation 4.49%;ensemble test top-5 3.57%(Table 4–5)。
- 主要邊界:證據核心是 2012 ImageNet 分類 與 CIFAR-10 深度診斷;PASCAL/COCO 偵測只是 Faster R-CNN 換 backbone 的轉移表(Table 7–8),不是 YOLO 契約,也不是 ViT、ConvNeXt 或 ResNet-RS 的現代 leaderboard。
我的結論是:ResNet 最值得保留的貢獻,是以恆等捷徑與殘差映射讓更深的網路可以有效優化。ILSVRC 2015 分類 ensemble 的 3.57% 與 COCO mAP,則不能直接當成今日偵測或 Transformer 系統的規格。
版本與閱讀範圍 / Version and reading scope
本文讀的是 He et al., CVPR 2016 對應的 arXiv:1512.03385 v1(2015-12-10 首發)。PDF 標示 arXiv.org perpetual non-exclusive license;CVPR camera-ready 另受 IEEE 出版條款約束。作者順序以 v1 PDF 為準:Kaiming He、Xiangyu Zhang、Shaoqing Ren、Jian Sun,隸屬 Microsoft Research。
除摘要外,本文核對 Section 3 的殘差公式與架構、Section 3.4 訓練設定、Section 4.1 ImageNet 分類(Table 1–5、Figure 3–5)、Section 4.2 CIFAR-10(Table 6、Figure 6–7)、Section 4.3 偵測轉移(Table 7–8),以及截至 2026-08-28 的工件。YOLO mAP、ViT accuracy、ConvNeXt/ResNet-RS 數字,都不回填。
這是已發表的 CVPR 論文,不是僅限 arXiv 的 preprint 敘事。
讀者真正要回答的問題
當你已經能像 AlexNet 那樣訓練「夠深」的 CNN,還想再加深層數換表示能力時,該繼續堆 plain 層,還是改寫優化目標?He et al. 的回答是:在 VGG 風格的 plain 骨幹上插入 parameter-free identity shortcut,讓區塊學 而非無參照的 。
比較精確的讀法不是「ResNet 是不是 2026 的預設 backbone」。真正的問題是:degradation 是否被殘差公式解除、深度增益出現在哪個資料與深度區間,以及哪些數字只是 ILSVRC 2015 分類或偵測轉移證據?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1/Figure 6 左:plain 更深 → training/test error 上升;Figure 4 右/Figure 6 中:ResNet 更深 → error 下降。Figure 2 定義殘差區塊;Figure 3 對照 VGG-19、plain-34、ResNet-34。Table 2 同深度 plain vs ResNet;Table 3–4 深度變體與單模型成績;Table 6 CIFAR 深度掃描;Figure 7 殘差響應 std 較小。 |
| 作者主張 | 殘差學習緩解 degradation;極深 ResNet 可優化且從深度獲益;恆等捷徑足夠且省參數;原則可泛化到偵測/分割(競賽敘述)。 |
| 論文未證明 | 任意任務上「越深越好」;1202 層在 CIFAR 上優於 110 層;現代 optimizer/正規化組合下的最優配方;ViT 時代仍應機械複製 bottleneck 設計;偵測數字構成 today 的 object-detector 契約。 |
| Bloss0m 工程判斷 | 把本篇放在 CV 基礎方法主線中 AlexNet 之後。架構與訓練證據的起點可讀 AlexNet(上)/(下)。COCO mAP 與 ILSVRC 2015 ensemble 不應混入後續 YOLO/ViT 筆記的表格。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列,不是 2026 的排行榜。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把脈絡寫清楚。AlexNet(上篇)與後續 VGG、GoogLeNet 顯示 深度有用;vanishing gradient 也被 normalized initialization 與 Batch Normalization 緩解,使數十層網路能開始收斂。
但當深度再增加,出現 degradation:準確率飽和後迅速變差,而且 training error 隨深度上升(Figure 1 的 20 vs 56 層 plain CIFAR-10;Figure 4 左的 18 vs 34 層 plain ImageNet)。這表示問題不是「測試集記憶訓練集」,而是 優化器難以找到不劣於淺網的解——即使深網的解空間理論上包含「多層 identity + 複製淺網權重」的構造解。
AlexNet 雙篇教的是 容量、ReLU、增強與正規化讓八層級系統可訓;它們沒有處理 三十層以上 plain 堆疊的 optimization floor。ResNet 改的是區塊級目標函數,不是再發明一種 activation。
核心直覺 / Core intuition
先不要看 ImageNet 排行榜。想像你要把 34 層變換接在 18 層後面。若新增層理想上什麼都不該改,最簡單的解是 identity。但 plain 非線性層很難學出 identity;優化器反而把 training error 推高。
ResNet 把「新增層該做什麼」改成「新增層只負責 相對於輸入的修正 ,輸入 用捷徑直通相加」。若最佳解接近 identity,把 的權重推向零,比讓三層 conv 自己學出 identity 容易。Figure 7 顯示殘差分支響應 std 普遍小於 plain,支持「修正量通常小」這個讀法。
對照三種容易混在一起的下一步:
- Plain deep CNN(VGG 風格):下一層必須重新編碼整個 ,沒有無參照捷徑。
- ResNet(本篇):區塊輸出 ;捷徑在維度匹配時 無參數、無額外 FLOPs(Section 3.2)。
- 後續方法(ViT、ConvNeXt、one-stage 偵測等):改的是 tokenization、stage 設計或任務頭;Table 5 的 3.57% 不屬於那些系統。
用一個例子走完整個方法 / Walk one example through the method
以下用 Figure 2 的兩層殘差區塊走一個 ImageNet conv 特徵圖 通道,不是獨立實驗編號。
- Input:特徵圖 ,通道數與空間尺寸與前一區塊輸出相同(例如 conv3_x 的 28×28、128 通道)。
- Intermediate representation:主路徑計算 (兩個 3×3 conv,Figure 2);捷徑直接傳遞 。
- Model or system decision:元素相加得 ,再經 ReLU。若維度改變(Figure 3 虛線捷徑),可 zero-pad(option A)或 1×1 projection (option B,Equation 2);Table 3 顯示 A/B/C 皆遠優於 plain,identity 已足夠。
- Output: 送入下一殘差區塊。整網以 global average pool + 1000-way fc 結束(Section 3.3)。
- Likely failure point:在 小資料集 上盲目加深——CIFAR 的 1202 層 ResNet training error <0.1% 但 test 7.93% 差於 110 層 6.43%(Table 6、Figure 6 右),作者歸因 overfitting 而非優化失敗。另一失敗模式是讀錯證據域:把 COCO +6.0 mAP 當成分類頭設計的保證。
技術機制 / Technical mechanism
殘差區塊
Equation (1):
維度不符時用 Equation (2) 的 projection shortcut。單層 退化成線性加性,作者未見優勢(Section 3.2)。
網路家族(Table 1、Figure 3、Figure 5)
- Plain baseline:VGG 哲學——3×3 conv、同解析度同通道數、下採樣時通道加倍;34 層 plain 約 3.6×10⁹ FLOPs,僅 VGG-19 的 18%。
- ResNet-18/34:兩層 3×3 basic block。
- ResNet-50/101/152:三層 bottleneck(1×1 降維 → 3×3 → 1×1 升維,Figure 5)。152 層約 11.3×10⁹ FLOPs,仍低於 VGG-16/19。
訓練與評測(Section 3.4)
ImageNet:隨機縮放短邊至 、224 crop、顏色增強、每 conv 後 BN、無 dropout。SGD batch 256、lr 0.1(plateau 時 ÷10)、最多 60×10⁴ iterations、weight decay 0.0001、momentum 0.9。測試用 10-crop;最佳結果用多尺度 fully-convolutional 平均。
CIFAR-10(Section 4.2):6n+2 層架構、batch 128、兩 GPU;lr 0.1,32k/48k 處 ÷10,64k iterations 結束。110 層先用 lr 0.01 warm-up 至 training error <80% 再回 0.1。
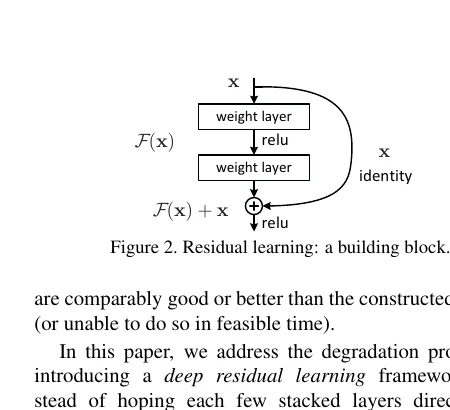
Figure 2,論文 Section 3.2:殘差 building block 與 Equation (1) 對應。原圖可定位到 arXiv PDF Figure 2。圖檔自 CVPR 2016 camera-ready PDF 擷取;版權屬作者/IEEE,本文保留來源,作學術評論用途,並依 arXiv reuse terms 標註。
實驗如何讀 / How to read the evidence
Figure 1/Figure 4:degradation 與其反轉
問題:更深 plain 網路是否更好優化?控制:CIFAR-10 20 vs 56 層(Figure 1);ImageNet 18 vs 34 層 plain(Figure 4 左)。觀察:更深曲線 training/validation error 更高。邊界:這是優化診斷,不是 ImageNet 最終排行榜。
同深度 ResNet(Figure 4 右)反轉:34 層 ResNet training error 低於 18 層,且優於 plain-34。Table 2 量化:plain-34 top-1 28.54% vs ResNet-34 25.03%(差 3.51 個百分點),而 plain-34 還比 plain-18 差 0.60 點。
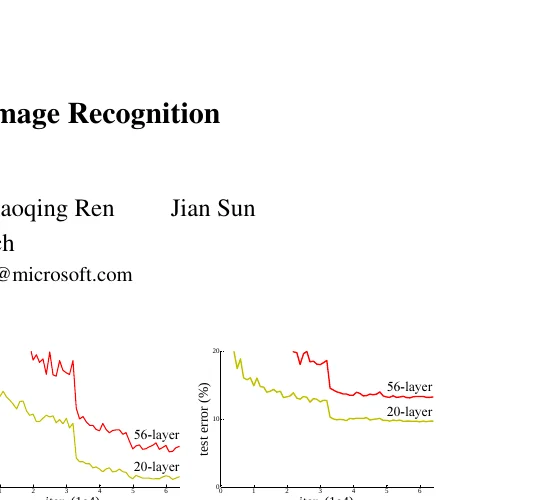
Figure 1,論文 Introduction:左 training error、右 test error。原圖見 arXiv PDF Figure 1。擷取與授權說明同 Figure 2。
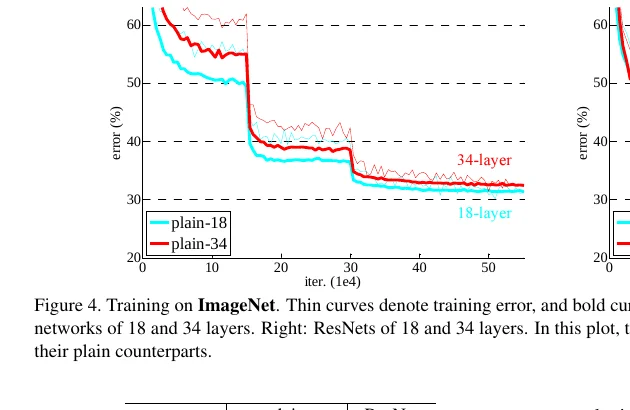
Figure 4,論文 Section 4.1:細線 training、粗線 validation center crops。原圖見 arXiv PDF Figure 4。擷取與授權說明同 Figure 2。
Table 3–4:深度變體與單模型分類
問題:超過 34 層後,bottleneck ResNet 是否持續增益?觀察(10-crop validation,Table 3):ResNet-50 top-1 22.85%、101 21.75%、152 21.43%;top-5 分別 6.71%/6.05%/5.71%。Table 4 單模型最佳:ResNet-152 top-1 19.38%、top-5 4.49%。
邊界:這些是 ILSVRC 2012 validation 協定下的分類誤差,含 10-crop 與多尺度技巧;不是 COCO detection mAP,也不是 ViT 在 JFT 上的數字。
Table 5:ensemble 與競賽敘述
六個不同深度模型 ensemble 得 test top-5 3.57%(Table 5),為 ILSVRC 2015 分類 冠軍敘述。教學上應與 單模型 Table 4 分開:3.57% 是 ensemble + test server 結果,不能當「部署一個 ResNet-152 就該有的誤差」。
Table 6/Figure 6–7:CIFAR 深度掃描與機制診斷
問題:現象是否只屬 ImageNet?觀察:plain 56 層 CIFAR error >60%(Figure 6 左,未畫出);ResNet-20→110 由 8.75% 降至 6.43%(Table 6)。1202 層 可訓練(training error <0.1%)但 test 7.93% 差於 110 層——過擬合邊界案例。
Figure 7:ResNet 各層響應 std 小於 plain,且更深 ResNet 單層修正更小。這支持殘差「接近零映射」的動機,不是額外 accuracy claim。
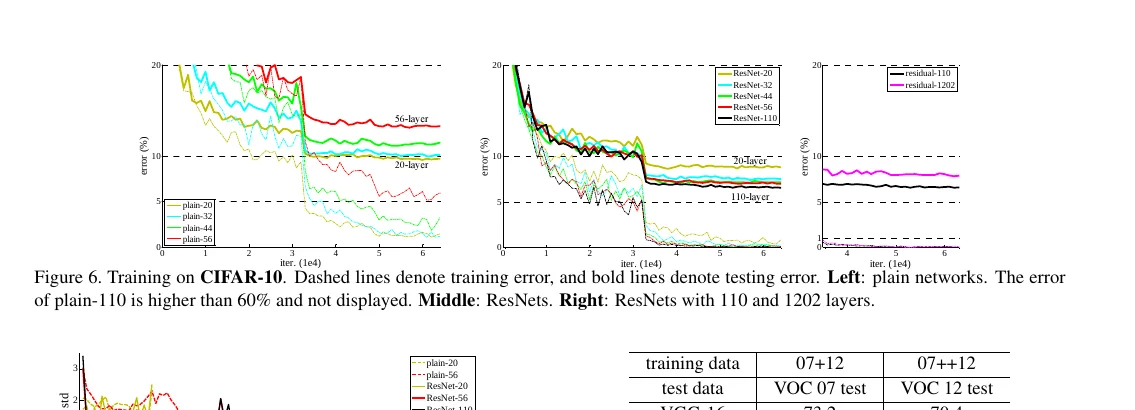
Figure 6,論文 Section 4.2:虛線 training、實線 test。原圖見 arXiv PDF Figure 6。擷取與授權說明同 Figure 2。
Table 7–8:偵測轉移(次要、勿當主線)
以 Faster R-CNN 換 backbone:COCO val 上 ResNet-101 mAP@[.5,.95] 27.2% vs VGG-16 21.2%(+6.0 絕對、28% 相對,Section 4.3)。作者強調 representation 更好,但實驗是 detection baseline,與分類表獨立。
Bloss0m 判斷:讀 ResNet 時先把 Table 2–4 記牢;Table 7–8 只作「特徵可轉移」的附註,不寫進 YOLO 或 ViT 筆記當主證據。
消融與設計選擇 / Ablations
- Identity vs projection(Table 3 A/B/C):三種捷徑皆大幅優於 plain;B 略優於 A,C 略優於 B 但引入 13 個 projection 的參數與複雜度。作者後續以 option B 為主,並強調 identity 對 bottleneck 尤其重要(否則 FLOPs 近似加倍)。
- 同參數公平性(Table 2):比較的 ResNet 與 plain 參數量相同(option A zero-padding),排除「只是變寬」的混淆。
- 非 bottleneck 更深(Figure 5 註腳):CIFAR 上非 bottleneck 加深仍增益,但不如 bottleneck 經濟。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- 年代與資料:ImageNet 2012、CIFAR-10;不等於現代資料分佈或自監督預訓練。
- 評測協定:10-crop、多尺度、ensemble 與競賽 test 數字不能混為一談。
- 極深≠極好:1202 層 CIFAR 反例;論文亦未使用 maxout/dropout 等強正規化(Section 4.2)。
- 偵測/分割:競賽多軌冠軍是附帶敘述;工程上需獨立讀 detection pipeline,不能從分類 3.57% 推 mAP 契約。
- 不要回填後來系統:YOLO、ViT、Swin、ConvNeXt、ResNet-RS 的數字與設計選擇都不屬於本 PDF 的表。
- 與 Highway 的差異(Section 2):Highway 用 有參數 gating 且可「關閉」捷徑;ResNet 恆等捷徑 永不關閉,始終傳遞 並學殘差。
工程判斷與不適用條件 / Engineering decision and when not to use it
何時借用本篇? 當你要堆深 vision backbone、且觀察到 training loss 隨深度變差(degradation)時,優先檢查是否缺少 skip/殘差路徑,而不是立刻加正規化或砍深度。實作上保留 維度匹配的 identity shortcut 為預設,只在 channel/stride 變化時用 1×1 projection。
何時不要照搬?
- 任務是 one-stage 偵測或 ViT 分類 時,ResNet 表內數字不是契約;需重測你的 pipeline。
- 資料很小(類 CIFAR)卻盲目上 千層——先讀 1202 層反例。
- 把 ILSVRC 2015 ensemble 3.57% 寫進產品 SLA。
- 需要 最小 latency 時,152 層 bottleneck 不是免費午餐;應量 FLOPs 與你的硬體。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-28 的直接 endpoint 狀態:
- 論文:arXiv abs、PDF 可讀;CVF open access HTML 可開啟。License 見 arXiv 與 IEEE 條款。
- 程式:KaimingHe/deep-residual-networks(Caffe)HTTP 200,屬 usable historical artifact;非 PyTorch 官方一鍵重現 Table 4 的完整訓練腳本。現代框架(torchvision
resnet*等)為 後續實作,不等同論文原始訓練日誌。 - 資料:ImageNet 2012 需授權;ILSVRC test labels 不公開。CIFAR-10 可公開取得,但與 ImageNet 超參不同。
- Microsoft Research 專頁:
microsoft.com論文頁在此環境 403,不據此宣稱額外 artifact。
最小有用 reproduction:用 torchvision 或等效實作載入 ResNet-34,在 小影像分類 上對照「plain vs residual」的 training curve 是否出現 degradation 反轉——驗證機制,不是復現 3.57%。
三個記憶點 / Three things to remember
- 技術想法:用恆等捷徑把層輸出改寫成 ,讓優化器學殘差而非無參照映射;這是 depth 可訓的控制點。
- 證據:plain-34 比 plain-18 更差(28.54% vs 27.94% top-1),ResNet-34 25.03% 並優於 ResNet-18;CIFAR 與 Figure 7 支撐機制解釋;單模型 ResNet-152 top-5 4.49%,ensemble test 3.57% 需分開記。
- 邊界:這是 2015–16 ImageNet 分類 + CIFAR 深度診斷;COCO mAP 是轉移實驗,不是 YOLO/ViT 契約。AlexNet 教「大 CNN 可訓」;ResNet 教「更深時如何改寫優化問題」。
延伸閱讀
若尚未讀過 CV 基礎方法的起點,可先讀 AlexNet(上) 與 (下);閱讀方法見 三遍掃描法。下一篇 YOLO(原始) 討論統一即時偵測。Transformer 等後續方法處理不同問題,本篇不展開。