InstructGPT 原始論文精讀
系列 · 1 篇
-
InstructGPT:用人類回饋對齊指令,但 2022 偏好勝率不能代表後來的 ChatGPT
中階 先建立方法閱讀底座精讀 Ouyang et al. NeurIPS 2022/arXiv:2203.02155:沿用 GPT-3 架構,以 SFT 示範、reward model 與 PPO(PPO-ptx)三階段繼續調整權重,使預訓練 LM 更符合人類偏好。175B InstructGPT 相對 175B GPT-3 偏好勝率 85±3%;這是 2022 API 標註分佈證據,不是 ChatGPT 產品 SLA、GPT-4 或 DPO 契約。
90 秒掌握這篇論文
- 問題
- 更大的 LM 不會自動更聽話;GPT-3 類模型在 next-token 預訓練目標下常產生不真實、有毒或不依指令的輸出(Section 1)。語言建模目標與「依使用者意圖、安全地回應」並不對齊。
- 核心洞見
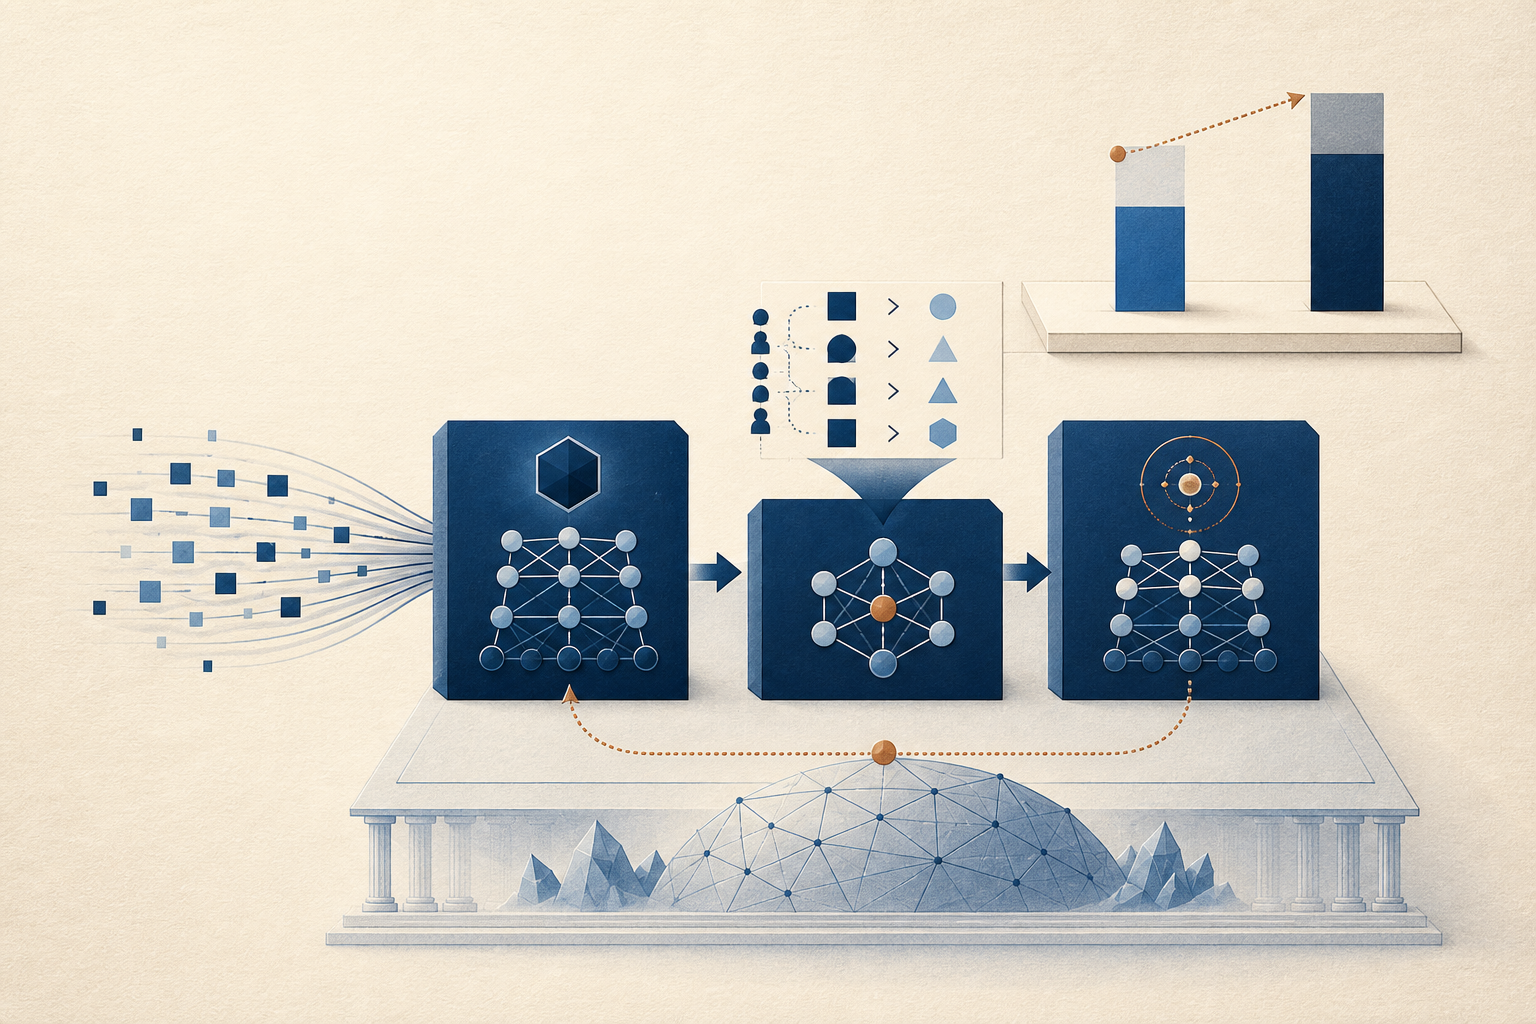
- 沿用 GPT-3 模型架構,但繼續更新模型參數,依序完成三個階段:(1) SFT——用約 40 位 contractor 的示範微調;(2) RM——用 6B reward model 擬合人類排序;(3) PPO——以 RM 分數為獎勵,並加上相對 SFT policy 的 KL 懲罰;預設 PPO-ptx 還混入預訓練目標,以減輕 public NLP 任務退步(Figure 2、Equation 2、Section 3.5)。改變的是 人類偏好對齊程序,不是 attention 架構。
- 最強證據
- API prompt 分佈上,labeler 偏好評估(Figure 1、Section 4.1):175B InstructGPT 相對 175B GPT-3 勝率 85±3%;相對 few-shot GPT-3 71±4%;1.3B InstructGPT 仍優於 175B GPT-3(>100× 參數差距)。相對 175B SFT 基線,InstructGPT 勝率 73.4±2%,優於 FLAN/T0 微調(26.8±2%、29.8±2%)。
- 主要邊界
- 2022 封閉 GPT-3 family;偏好來自特定 labeler 與 API Playground 分佈(Section 5.2–5.3)。ChatGPT 產品指標、GPT-4、DPO、Llama-2-chat、Constitutional AI 不屬本 PDF;YOLO mAP、Transformer WMT BLEU 亦不是對齊契約。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡