論文精讀
AlexNet 論文精讀(上):卷積神經網路與 ImageNet 分類
原文:ImageNet Classification with Deep Convolutional Neural Networks
90 秒掌握論文
- 問題:在 2012 年,將深層卷積神經網路(CNN)擴展至百萬級高解析度影像資料集時,面臨三大同時發生的工程瓶頸:飽和激活函數導致的梯度優化困難、GPU 顯存容量嚴苛限制(單卡僅 3GB),以及大參數量模型在缺乏正規化時的毀滅性過擬合。
- 核心洞見:AlexNet 的突破並非來自單一的「把網路堆深」,而是將卷積的空間局部歸納偏好、非飽和的 ReLU 激活函數、雙 GPU 顯存跨卡分割、重疊池化與重度正規化(Dropout 與資料增強)組合成第一個工程可訓練的端到端深度視覺系統。
- 最強證據:在 ILSVRC-2010 測試集上,AlexNet 取得 37.5% top-1 error 與 17.0% top-5 error,相較於當時最頂尖的 SIFT + Fisher Vector 基線(45.7% / 25.7%)呈現絕對領先;在 ILSVRC-2012 競賽中,其 7-CNN 集成模型以 15.3% top-5 error 奪冠,大幅領先第二名的 26.2%(Section 6、Table 1、Table 2)。
- 主要邊界:局部響應歸一化(LRN)、通道手動切分至兩張 3GB GTX 580 的通訊拓撲,以及第一層 11×11 stride 4 的超大卷積核,本質上是當代硬體與顯存限制下的折衷設計,並非現代加速硬體或通用視覺架構的最佳原則。
2012 年的 NeurIPS 論文《ImageNet Classification with Deep Convolutional Neural Networks》被普遍視為現代深度學習爆發的歷史性分水嶺。然而,在歷史回顧中,這項里程碑經常被簡化為「只要層數夠深就能在 ImageNet 上獲勝」的抽象口號。這種簡化遮蔽了當年真正的工程挑戰:在手動特徵工程與淺層分類器佔據主流的時代,如何在嚴格受限的計算條件下,讓一個擁有 6,000 萬參數的龐大卷積神經網路穩定收斂?本篇作為 AlexNet 精讀的上篇,聚焦於問題定義、評測協定、歷史實證數據與證據邊界的釐清;各層具體的張量維度、資料增強、Dropout 與可訓練化細節,則由 下篇:AlexNet 架構與訓練配方 深入展開。
理解前需要知道什麼
- ImageNet 與 ILSVRC 評測基準: 論文區分了 ImageNet 全集(超過 1,500 萬張帶標籤高解析度影像、涵蓋約 22,000 個類別)與其年度子競賽 ILSVRC(ImageNet Large-Scale Visual Recognition Challenge)。本篇所有核心實驗均在 ILSVRC-2010 與 ILSVRC-2012 的 1,000 個類別子集上進行。該資料集包含約 120 萬張訓練影像、50,000 張驗證影像,以及 150,000 張測試影像(Section 2)。影像尺寸並非標準統一,在輸入網路前必須先進行幾何預處理。
- 分類指標定義:Top-1 與 Top-5 錯誤率: 評測指標採用錯誤率(Error Rate)。當模型預測最高機率的類別不是真實標籤時,計為一次 Top-1 錯誤;當真實標籤完全不在模型預測機率最高的前五個類別之內時,計為一次 Top-5 錯誤。引入 Top-5 指標的關鍵考量在於 ImageNet 的細粒度標籤特性:例如一張影像可能包含多個物體,或者背景中的獵犬被標註為特定品系(如「諾福克梗」而非泛稱的「狗」),Top-5 容許模型在五個合理候選中命中標籤,降低了標註單一主觀性帶來的評估雜訊。
- 傳統方法的瓶頸與局限(為什麼既有方法不足):
在 AlexNet 發表前,計算機視覺的標準工作流程高度依賴專家手動設計的特徵抽取器(如 SIFT、HOG、LBP),配合向量量化技術(Bag-of-Visual-Words、Fisher Vectors、Sparse Coding),最後輸入淺層線性或核化 SVM 進行分類。傳統方法為什麼不夠?
- 表徵容量不足:手動設計的特徵屬於靜態先驗,在小規模資料集(如 Caltech-101、NORB)上表現尚可,但面對 ImageNet 百萬張影像中劇烈的視角變形、光照變化與類內多樣性時,淺層特徵無法自適應學習高階語義抽象。
- 梯度飽和的優化瓶頸:早期嘗試訓練深層類神經網路時,多數採用標準的飽和激活函數,例如雙曲正切 或 Sigmoid 。這類函數在輸入值較大或較小時導數趨近於零,導致反向傳播時梯度嚴重衰減(Vanishing Gradients),使深層網路在常規梯度下降下訓練極為緩慢甚至停滯。
- 2012 年的硬體顯存牆:當時頂級消費級顯卡 NVIDIA GeForce GTX 580 僅配備 3GB VRAM。單張卡根本無法同時容納 6,000 萬參數、動態反向傳播的中間特徵圖激活值,以及高解析度影像的 mini-batch。
核心直覺
在決策機制上,傳統系統遵循「人工啟發式特徵過濾 靜態高維編碼 淺層邊界劃分」的分立式管線。特徵抽取與分類器是解耦的;如果人工設計的 SIFT 算子丟失了某種關鍵紋理或結構,後端的 SVM 無法憑空修復這項表徵缺陷。
AlexNet 帶來的核心直覺轉變,是將表徵抽取與決策邊界融合成單一的端到端(End-to-End)可微系統:
- 影像歸納偏好的結構化利用:全連接神經網路(MLP)若直接作用於 224×224×3 的展開像素(約 15 萬維),首層權重矩陣將膨脹至數億參數,破壞空間幾何結構且無法泛化。卷積操作透過「權重共享」(Weight Sharing)與「局部連接」(Local Connectivity),將相同的一組卷積核在整個空間維度上滑動,精準契合了自然影像的兩大基本統計先驗——平移不變性(Stationarity)與鄰近像素強相關性(Pixel Locality)。
- 非飽和線性激活直覺:放棄飽和 S 型曲線,改用分段線性函數 ReLU 。只要單元處於激活狀態(),其導數恆為 1,不隨輸入值增大而衰減。這讓深層反向傳播能保持穩健的梯度流,根本性地打破了深層網路「無法收斂」的工程魔咒。
- 顯存限制下的模型平行切分:作者不將硬體視為單純的執行底層,而是將硬體約束納入架構設計中。既然單張 3GB 顯卡裝不下整個模型,就將卷積核數量對半切分給兩張 GPU,並設計出僅在特定層(Layer 3 與全連接層)進行跨卡通訊、其餘層保持卡內局部計算的拓撲結構,在高模型容量與有限的 PCIe 匯流排頻寬之間達成工程折衷。
用一個例子走完整個方法
- 輸入(Input): 任意解析度的原始 RGB 影像首先經過等比例縮放,將較短邊縮放至 256 像素,並裁切出中心 256×256 區域。扣除在整個訓練集上計算的 RGB 像素均值(Per-pixel mean activity subtraction)後,在推論階段對該影像裁切出十個 224×224 patch(四個角落與中心點,以及各自的水平翻轉鏡像)。
- 中間表徵轉換(Intermediate representation):
- 第一層(Conv1):96 個 11×11×3 卷積核以 stride 4 掃描 224×224×3 輸入,輸出 55×55×96 特徵圖(每張 GPU 承擔 48 個通道),捕捉基礎邊緣方向與顏色斑塊。經 ReLU 激活、跨通道局部響應歸一化(LRN),以及 stride 2 的 3×3 重疊最大池化(Overlapping Max Pooling),空間尺寸縮減為 27×27×96。
- 第二層(Conv2):256 個 5×5 卷積核(每張 GPU 128 個)在卡內局部連接,經 ReLU、LRN 與重疊池化後輸出 13×13×256 特徵圖。
- 第三至五層(Conv3–Conv5):第三層的 384 個 3×3 卷積核打破 GPU 隔離,跨卡連接第二層兩張 GPU 的全部 256 個通道,合成跨特徵圖的高階結構;第四層(384 個 3×3)與第五層(256 個 3×3)再次恢復卡內局部連接;第五層後接續最後一次重疊池化,輸出 6×6×256 特徵圖(每張 GPU 128 通道)。
- 全連接層(FC6–FC7):將 6×6×256 展平成 9,216 維向量,連接至擁有 4,096 個神經元的全連接層 FC6(此處跨兩卡全連接),再接續 4,096 維的 FC7;兩層均採用 ReLU 並在訓練時施加 50% Dropout。
- 決策轉換(Decision or transformation): FC7 的輸出經過最後一層 FC8,線性投影至 1,000 維未歸一化得分向量(Logits),並透過 1,000 路 Softmax 函數計算預測機率分佈: 推論時,將上述十個 patch 的 Softmax 輸出機率進行向量平均,產生該影像最終的平滑預測分佈。
- 輸出(Output): 模型輸出按機率排序的前五個類別標籤及其信心度得分。若第 1 候選為真值,則 Top-1 與 Top-5 均為正確;若真值落在前五名但非第一名,則 Top-1 錯誤但 Top-5 正確;若真值不在前五名中,則兩者皆計為錯誤。
- 典型失敗點(Likely failure point): 若第一層與第二層卷積核因極端光照、重度模糊或視角失真而未能捕捉到關鍵紋理特徵,後續深層結構無法逆向復原已丟失的低階幾何信號。此外,若目標物體處於畫面極端邊緣,單一中心裁切往往會完全遺漏目標,這也是推論階段需要十裁切集成(Ten-crop testing)來平抑位置偏移的原因。
技術機制
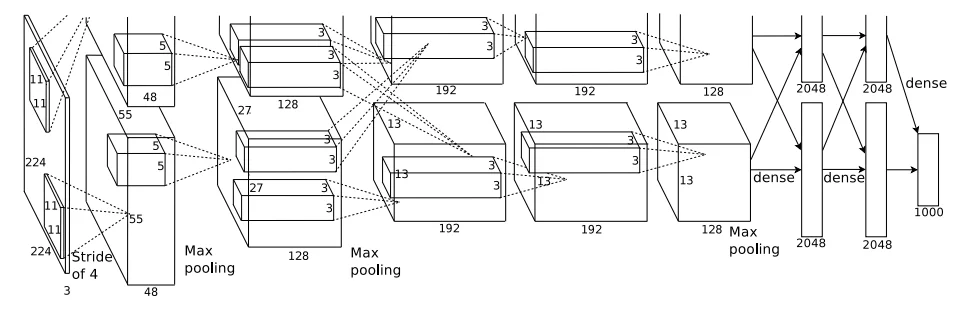
Figure 2,論文 Section 3.5 的 network architecture:圖中同時呈現 224×224×3 輸入、卷積/pooling 層、雙 GPU 的局部與跨卡連接,以及最後的 fully connected classifier。原始 Figure 2 來源。這張圖取自 NeurIPS 2012 proceedings;版權仍屬作者/出版方,本文保留來源,作學術評論用途,未主張其為 CC BY 授權。
- ReLU 非飽和激活函數(Section 3.1): 數學定義為 。相較於標準的 S 型激活函數 或 ,ReLU 的正區間導數恆為 1。在論文的 Figure 1 診斷實驗中,作者在四層 CIFAR-10 卷積網路上對照 ReLU 與 :達到 25% 訓練誤差時,ReLU 網路的速度比 網路快了整整 6 倍。這項實驗證明了非飽和激活函數對大規模深層網路的可優化性起到了決定性作用。
- 雙 GPU 平行化架構(Section 3.2): 受制於 2012 年單張 GTX 580 的 3GB 顯存,作者採用兩張 GPU 分攤計算。兩張卡可直接跨 PCIe 讀寫對方顯存(無需經過主機記憶體)。關鍵機制在於「選擇性跨卡連接」:Layer 2 的卷積核僅讀取同卡 Layer 1 的輸出;Layer 3 的卷積核則同時讀取兩張卡 Layer 2 的所有特徵圖;Layer 4 與 Layer 5 再次回到同卡局部連接;直到 FC6 才再次全連接至兩卡神經元。Section 3.2 的對照實驗指出,這種雙 GPU 切分方案相較於參數量相近的單 GPU 網路,使 top-1 與 top-5 error 分別下降了 1.7% 與 1.2%(但作者亦坦承單卡對照組的參數縮放並非完全嚴格對齊)。
- 局部響應歸一化(Local Response Normalization, LRN,Section 3.3): 公式如下: 其中 為第 個卷積核在位置 經 ReLU 激活後的數值, 為該層總卷積核數量。超參數設為 、、、。該公式在同一個空間位置對鄰近的 個通道實施橫向抑制(Lateral Inhibition),懲罰連續多個通道同時產生巨大激活值的現象。作者報告 LRN 在四層網路上使 top-1 降低 1.4%、top-5 降低 1.2%。雖然 LRN 在現代架構中已被 Batch Normalization 與 Layer Normalization 取代,但它是早期控制深層數值尺度的重要嘗試。
- 重疊池化(Overlapping Pooling,Section 3.4): 傳統池化單元使用步長等於窗口大小的網格()。AlexNet 採用窗口 、步長 的重疊池化。作者報告重疊池化使 top-1 降低 0.4%、top-5 降低 0.3%,並在訓練過程中表現出較不易過擬合的特性。
- 八層整體參數量與顯存分佈(Section 3.5): 網路總計 8 個可學習層(5 層卷積 + 3 層全連接),包含約 6,000 萬個參數與 650,000 個神經元。其中,第一層全連接層 FC6(連接 6×6×256 的展平特徵圖與 4,096 個神經元)單獨佔據了 萬參數,佔全網參數量超過 60%。這揭示了 AlexNet 參數量主要沉積在分類器頭部,而計算量則高度集中在卷積前幾層的架構不對稱性。
實驗如何讀
- 評測設定與基準受控條件:
- 資料集(Datasets):ILSVRC-2010 包含 1,000 類、約 120 萬張訓練集、50,000 張驗證集,以及 150,000 張帶有公開真實標籤的測試集;ILSVRC-2012 測試集標籤未公開,需提交至評測伺服器進行官方盲測。
- 對照基線(Baselines):當時非深度學習領域的頂級競賽方案,包括 Sparse Coding(Lin et al., 2011)與 SIFT + Fisher Vectors(Sánchez & Perronnin, 2011)。
- 算力成本(Compute):兩張 NVIDIA GeForce GTX 580 3GB GPU,以 SGD(動量 0.9、權重衰減 0.0005、初始學習率 0.01)訓練約 90 個 epoch,耗時 5 至 6 天。
- 評測指標(Metrics):Top-1 error 與 Top-5 error。
- ILSVRC-2010 測試集對照(Table 1):
在 ILSVRC-2010 上,三種受控比較的最終測試誤差為:
- 稀疏編碼(Sparse Coding):47.1% top-1、28.2% top-5
- SIFT + Fisher Vectors:45.7% top-1、25.7% top-5
- AlexNet(CNN):37.5% top-1、17.0% top-5 在同一測試集與評測協定下,AlexNet 相對 SIFT+FV 展現出 Top-1 絕對降低 8.2 個百分點、Top-5 絕對降低 8.7 個百分點(相對減少達 34%)的巨大優勢。Table 1 的所有數值均為 test error 而非 validation error。
- ILSVRC-2012 競賽提交對照(Table 2):
Table 2 記錄了 2012 年競賽的實證結果:
- 單一 AlexNet 模型:18.2% top-5(驗證集)
- 5 個相似 CNN 的集成模型:16.4% top-5(驗證集)、16.4% top-5(競賽測試集)
- 包含 ImageNet Fall 2011(1,500 萬張影像、22,000 類)預訓練後微調的單一模型:16.6% top-5(驗證集)
- 7 個 CNN 集成(結合常規訓練與預訓練模型):15.3% top-5(競賽測試集)
- 競賽亞軍方案(非 CNN 傳統特徵集成):26.2% top-5 勝出差距達到驚人的 10.9 個百分點絕對差距。特別需要注意:Table 1 的 17.0% 與 Table 2 的 15.3% 代表不同的資料集版本與評測設定(前者為 2010 單模型測試,後者為 2012 競賽 7-CNN 集成提交),工程引用時切忌混為一談。
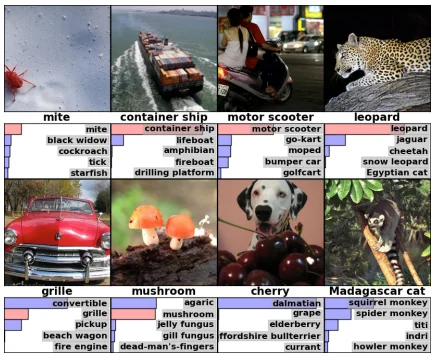
Figure 4,論文 Section 6 的定性評估(qualitative evaluations):展示八張 ImageNet 測試影像與模型給出的 top-5 候選標籤,呈現網路在非中心偏移、遮擋與多目標共存下的預測分佈。原始 Figure 4 來源。圖表取自 NeurIPS 2012 論文集;版權屬原作者與 NeurIPS,本文保留來源供學術評論,未主張 CC BY 授權。
- 診斷與非嚴格消融分析(Diagnostic observations):
- Figure 1 為 CIFAR-10 上的優化速度消融:驗證了 ReLU 在小架構下收斂至 25% 訓練誤差比 快 6 倍,但該曲線反映的是優化效率而非 ImageNet 最終精度。
- 深度因果性的局限:Section 1 中作者提及「移除任一卷積層都會導致性能下降約 2%」,這項觀察常被轉述為「深度必勝」的證明;然而論文並未在控制參數量、通道寬度與算力預算的前提下進行系統性消融,因此不能視為嚴格的因果律證明。
- 比較表缺乏統計誤差區間:Table 1 與 Table 2 未報告隨機種子方差(Seed variation)、置信區間或單張推論延遲,其核心價值在於定性展示大容量神經網路跨越式的競爭力,而非現代生產級系統的成本效益表。
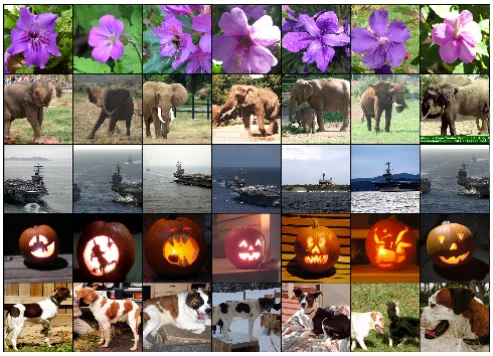
Figure 5,論文 Section 6 的語義特徵空間分析(feature nearest neighbors):第一欄為測試影像,其餘六欄為在最後隱藏層 4096 維特徵向量歐氏距離最近的訓練影像,證明網路學到的是高階語義而非低階像素重疊。原始 Figure 5 來源。圖表取自 NeurIPS 2012 論文集;版權屬原作者與 NeurIPS,本文作學術評論引用,未主張 CC BY 授權。
證據地圖
- 論文直接證據(論文直接支持):
- Table 1 在 ILSVRC-2010 公開標籤測試集上,AlexNet 取得 37.5% top-1 / 17.0% top-5 error,嚴格超越同基準下的 SIFT+FV(45.7% / 25.7%)。
- Table 2 在 ILSVRC-2012 盲測競賽中,AlexNet 7-CNN 集成提交取得 15.3% top-5 error,大幅領先非 CNN 亞軍的 26.2%。
- Figure 1 證實四層卷積網路在 CIFAR-10 上,ReLU 達到 25% 訓練誤差的速度是 的 6 倍。
- Section 3.2–3.4 報告了 LRN 帶來約 1.2% top-5 降低、重疊池化帶來約 0.3% top-5 降低,以及雙 GPU 方案帶來約 1.2% top-5 降低的作者自測數據。
- 作者因果解讀(作者主張):
- 作者主張網路深度至關重要,移除任一卷積層均造成約 2% 性能損失(Section 1)。
- 作者將歷史性成功歸因於「百萬級資料規模 + GPU 高度最佳化計算 + 非飽和神經元深層架構」的三位一體協同作用。
- 作者認為卷積的局部連接與權重共享對自然影像提供了「大部分正確」(mostly correct)的強歸納偏好。
- 論文未證明(證據邊界):
- 論文未證明「單純增加深度」是準確率提升的唯一充分條件:實驗缺乏等參數量、等計算量的橫向對照,亦無統計置信區間。
- 論文未測試跨資料集遷移泛化能力、長尾少樣本分類表現、對抗性防禦,或開放世界偵測。
- 論文未證明 Softmax 預測機率的校準度(Calibration);高 Top-5 命中率並不保證模型不會在類外影像上產生高置信度的荒謬誤判。
- 論文未證明 LRN 或手動雙 GPU 分割是表徵學習的本質最優解;後續深度學習發展證實 LRN 可被 Batch Normalization 完全取代,而模型切分亦被通用的資料平行(DDP)與張量平行庫取代。
- Bloss0m 工程化整理:
- AlexNet 應被定性為一整套「系統工程配方」(資料規模 + 算力併行 + 激活函數革新 + 結構正則化),而非孤立的靜態網路拓撲。
- 歷史指標遷移檢核四維度(Four-dimension transfer checklist):
- 資料分母:確認專案場景為固定 1,000 類封閉集合,還是存在長尾、未知類與多標籤;後者無法依賴 AlexNet 的實證數據支撐。
- 指標對齊:區分 single-crop 與 ten-crop;勿將 ten-crop 的離線高精度誤用作低延遲線上服務的預估吞吐量。
- 基線時代性:評測現代視覺方案時,應對照當代輕量級骨幹(如 ConvNeXt、MobileNetV4、ViT),而非重演 2012 年與 SIFT 的差距。
- 硬體執行模型:採用現代框架原生資料平行(PyTorch DDP),拋棄手動指定層級跨卡通訊的歷史寫法。
Artifact 與可重現性
- 截至 2026-08-09,原文腳註指向的
cuda-convnetGoogle Code 專案已封存為唯讀歷史端點,缺乏對現代 GPU 架構與 CUDA 驅動的相容支援,不能作為現代可用的開箱即用重現套件。 - 社群可公開存取的 BVLC Caffe AlexNet model definition 屬於後續實作,將原論文雙 GPU 的分組卷積合併為單卡模型定義並提供權重檔案,但不包含原論文底層雙 GTX 580 的手動記憶體路由與原始資料預處理程式碼。
- 現代框架(如
torchvision.models.alexnet)多數實作了統一通道的 AlexNet 變形,通常移除 LRN 或改用標準通道排布,其實測 Top-1 準確率約為 56.5%(單裁切 error 約 43.5%),與原論文雙卡原始實現存在些微設定差異。 - ImageNet(ILSVRC)資料集需要向官方學術端點提出申請並審核通過方可下載,且 2012 年競賽測試集真實標籤至今未隨文公開發布。
- 本文實驗數據採用原論文發表的官方數值,未重跑完整基準測試;若工程師欲進行可重現性驗證,建議在現代框架下固定已獲授權的 ImageNet 資料集切分與十裁切評測協定,並將實驗定位為「AlexNet-like reproduction」,而非嚴格宣稱完全復刻 2012 年的競賽提交環境。
Bloss0m 工程判斷與不適用條件
- 工程沉澱原則:
- 軟硬體協同設計(Hardware-Software Co-design):當模型規模突破硬體限制時,將硬體顯存與互聯頻寬作為架構先驗,設計與硬體匹配的通訊與計算拓撲。
- 優先保障梯度流:非飽和激活函數是深層神經網路優化的第一前提,現代 GELU、Swish 等變體均延續了這一思想。
- 資料與容量匹配:模型容量的提升必須與標註資料規模及重度正則化同步前進,否則大容量只會加速過擬合。
- 不適用條件(何時不要使用 AlexNet):
- 切勿在現代生產環境中將 AlexNet 作為視覺骨幹網路(Backbone):現代輕量級架構(如 MobileNetV4、EfficientNet、ResNet、ConvNeXt)在參數量僅為 AlexNet 幾分之一甚至幾十分之一的情況下,ImageNet Top-1 準確率均大幅超越 AlexNet(> 80% vs ~62.5%)。
- 切勿引入 LRN 算子:LRN 運算繁瑣且缺乏通道間特徵分佈的跨 batch 統計穩定性,已全面被 Batch Normalization、Layer Normalization 或 RMSNorm 所淘汰。
- 切勿手動編寫層級跨卡模型分割:現代分散式訓練應優先採用資料平行(Data Parallelism)、FSDP 或現代張量平行(Tensor Parallelism),依賴框架底層高度最佳化的通訊原語(如 NCCL),而非手動限制特定層跨卡。
- 切勿將 Top-5 錯誤率直接視為高可靠性業務指標:在醫療影像、自動駕駛、缺陷檢測等安全敏感場景中,決策必須依賴經過嚴格機率校準的 Top-1 輸出或置信度閾值拒識,不能以「落在前五名即算正確」寬泛帶過。
讀完後的三個記憶點
- 技術思想(Technical idea):AlexNet 的歷史突破在於構建出第一個可端到端訓練的百萬級影像深層系統;卷積的局部歸納偏好、ReLU 的非飽和梯度、雙 GPU 顯存分割與 Dropout 共同解決了深層優化與過擬合問題。
- 核心證據(Evidence):在同一 ILSVRC-2010 測試集上,AlexNet 取得 37.5% top-1 與 17.0% top-5 error,將 SIFT+Fisher Vector 的最優紀錄推進了 8.2 與 8.7 個百分點;2012 競賽版本以 15.3% top-5 領先非深度學習亞軍達 10.9 個百分點。
- 工程邊界(Boundary):雙卡手動切分、LRN 與超大 11×11 卷積核是 3GB 顯存時代的折衷產物;應汲取其「模型、算力與資料協同設計」的系統思維,而非盲目複製其過時的架構參數。
Primary sources
- Krizhevsky、Sutskever、Hinton,完整論文(NeurIPS 2012):Section 1–2、Figure 1–2、Table 1–2。
- BVLC Caffe AlexNet model definition:社群後續可存取的模型定義與權重範圍。
- 系列導航:本篇為 AlexNet 兩部曲的上篇,聚焦問題、評測與歷史性實證結果;架構的可訓練化配方、層級尺寸、正則化與資料增強請參閱下篇:AlexNet 架構與訓練配方。