若要先了解 CoT 與 ReAct、Toolformer 的方法關係,可見 Agent 方法底座閱讀地圖。讀法可搭配 三遍掃描法。
90 秒掌握論文 / The paper in 90 seconds
- 問題:標準 few-shot prompting 只給 題目, 答案,多步算術、常識與符號推理表現差;只把模型放大也填不平這條曲線。
- 核心洞見:把 exemplar 改成 題目, 中間推理, 答案。決策點從「直接答」改成「先把推理寫出來再答」。模型權重凍結;這仍是 prompt,不是 agent。
- 最強證據:PaLM 540B 在 GSM8K 上 17.9 → 56.9,對當時 Cobbe et al. finetuned GPT-3 + verifier 的 55(Table 1、Figure 2)。Figure 4/Table 2 顯示增益大約在 100B 才出現。
- 主要邊界:沒有環境、沒有工具、沒有記憶分頁。小模型常更差;鏈可以不通、也可以碰巧答對。Self-consistency(Wang et al., 2022a)是後來的論文,本文主結果用 greedy decoding。
我的結論是:CoT 最值得保留的貢獻,是把中間推理步驟寫進 prompt,再由模型接續作答。它沒有查詢工具、接收環境 observation 或管理長期記憶,因此不能直接視為 Agent。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Wei et al., NeurIPS 2022 對應的 arXiv:2201.11903 v6,首發於 2022-01-28,最後修訂於 2023-01-10。PDF 與 arXiv HTML 標示 CC BY 4.0。
作者順序依 camera-ready/v6 PDF:Jason Wei、Xuezhi Wang、Dale Schuurmans、Maarten Bosma、Brian Ichter、Fei Xia、Ed H. Chi、Quoc V. Le、Denny Zhou。arXiv 摘要頁把兩位作者簡寫成 Ed Chi、Quoc Le;NeurIPS 頁把 Brian Ichter 印成小寫,本文採 PDF 版本。
除摘要外,本文核對 Section 2 的 exemplar 格式、Section 3–5 的算術/常識/符號實驗、Appendix Table 1–7、Figure 1/4/5,以及截至 2026-08-27 的工件。論文也明確說明,研究過程沒有 finetune 任何語言模型。後續 self-consistency、o1/o3、DeepSeek-R1 與 2025–26 的 GSM8K 排行榜不納入本文表格。
這是已發表的 NeurIPS 論文,不是 preprint。
讀者真正要回答的問題
當模型不會做多步推理時,工程上是該收集大量 rationale 去 finetune,還是只改 exemplar 裡答案前面那一段字?Wei et al. 的回答是:在夠大的凍結模型上,把中間步驟寫進 few-shot prompt 就夠引出一條可讀的推理鏈。
比較精確的讀法不是「CoT 是不是 Agent」。真正的問題是:prompt 裡要不要先寫出工作,這個改變在哪些任務、哪個規模上真的移動分數,又在哪裡因為模型太小、題目太簡單、或鏈不忠實而失效?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1 對照 standard 與 CoT 的 exemplar;Table 1/2 給出五個算術 benchmark 的規模曲線;Figure 5 與 Table 6 給出 GSM8K 消融;Table 4 給出常識任務;Table 5 給出 last-letter/coin-flip 的 in-domain 與 OOD。 |
| 作者主張 | 中間自然語言步驟能引出多步推理;這是規模上的 emergent ability;單一凍結 checkpoint 可做多種任務,不必為每種任務 finetune。 |
| 論文未證明 | 模型「真的在推理」;鏈與內部計算忠實對應;可部署 Agent runtime;工具使用;環境回饋;記憶分頁;後來 sample-and-vote 方法的數字。 |
| Bloss0m 工程判斷 | 把 CoT 當成「只產生推理步驟、不操作外部環境」的方法。需要 thought 與環境動作交錯時讀 ReAct;需要在訓練時插入 API 呼叫時讀 Toolformer。 |
後文把數字、作者 claim 與工程判讀分開。「SOTA」只指論文寫作當下、表內那一列,不是 2026 的排行榜。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2021–2022 的兩條線寫清楚。
昂貴的 rationale 訓練:Ling et al.(2017)與 Cobbe et al.(2021)讓模型產生自然語言中間步驟,但要從頭訓或 finetune,也要一大批高品質 rationale。那比普通的輸入–輸出對貴得多。
標準 few-shot prompting:Brown et al.(2020)用 輸入, 輸出 示範就能做不少簡單 QA。可是在需要推理的任務上表現差,而且放大模型常常拉不動曲線(論文引 Rae et al., 2021)。
因此舊方法不夠的地方不是「沒人想過中間步驟」,而是控制點被切開:要嘛付 finetune 與標註成本,要嘛只用答案示範、把多步工作留給模型一次跳完。CoT 改的正是 exemplar 裡答案前面那一段。
核心直覺 / Core intuition
先不要看表。想像小學生解應用題:不會只寫「答案是 9」,而會先寫「原本 23 顆,用掉 20,剩下 3,再買 6,所以 9」。CoT 要語言模型做同一件事——而且是靠 few-shot 示範,不是靠更新權重。
對照三種容易混在一起的下一步:
- Standard prompting:下一步只能是最終答案。
- CoT prompting:下一步是中間自然語言步驟,走完再給答案。環境不變,也沒有 observation 回來。
- ReAct:thought 是 action space 裡一種不碰世界的合法動作,而且可以與 search/lookup 交錯;環境會回 observation。那是後來的匯流,不是這篇。
WebGPT 能用瀏覽器行動,但幾乎不要求顯式語言推理。CoT 剛好相反:只推理、不行動。
用一個例子走完整個方法 / Walk one example through the method
以下是 Figure 1 的教學例,不是獨立實驗結果。測試題是:The cafeteria had 23 apples. If they used 20 to make lunch and bought 6 more, how many apples do they have? 正確答案是 9。
- Input:只有這句測試題。沒有 Wikipedia、沒有計算機 API、沒有環境狀態。few-shot 裡先放一道網球示範題:Roger 有 5 顆球,買 2 罐、每罐 3 顆。
- Intermediate representation:standard 的 exemplar 是
Q: … A: The answer is 11.CoT 的 exemplar 在答案前插入藍色高亮的步驟:「Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls. 5 + 6 = 11. The answer is 11。」真正實驗的數學題用 Appendix Table 20 的 八 條同類示範(AQuA 例外,用四條選擇題)。 - Model or system decision:把測試題接在 exemplar 後面,對凍結模型做 greedy decoding。模型要自己寫出一串中間句,而不是先答再解釋。沒有 tool 被呼叫,也沒有 observation 寫回 context。
- Output:Figure 1 右側生成:「原本 23,用掉 20,剩下 3,再買 6,所以 9。」左側 standard 輸出 27,被標成錯。
- Likely failure point:小模型會寫出通順但不合理的鏈,分數比 standard 更差(Table 2)。即使答案對,鏈也不保證對:LaMDA 137B 在 GSM8K 抽 50 題答對的樣本裡,有 2 題只是碰巧走到正確數字(Section 3.2、Section D.1)。答錯的 50 題裡,46% 只差小錯(計算機、符號對應、少一步),54% 是語意或連貫性大錯(Section D.2)。
這條食堂題教的是機制怎麼走完。要看規模把曲線拉起來,應回到 Figure 4;要看「寫步驟」是不是只是多吐 tokens,應看 Figure 5。
技術機制 / Technical mechanism
方法沒有新的損失函數。改變的是 few-shot prompt 的三元組。
Standard prompting 的第 條示範是 :題目直接接到答案。測試時模型被要求產生 。
Chain-of-thought prompting 把同一條示範擴成
其中 是導向 的一串中間自然語言步驟。測試時,模型先生成 ,再生成 。增加 的長度,等於把更多中間計算寫成可讀 tokens;這可以讓難題多走幾步,也可能讓小模型把錯誤一步步編圓。
拿掉 ,就回到 standard prompting。若把 移到 後面,或換成與方程式等長的點點,Figure 5 顯示分數幾乎沒有提升。真正有用的不是任意增加 tokens,而是把自然語言推理步驟放在答案之前。
操作上的約束:
- 凍結模型。 Section 6 明寫:寫這篇論文時沒有 finetune。UL2、LaMDA、GPT-3(
text-ada-001到text-davinci-002)、PaLM 8B/62B/540B、Codexcode-davinci-002都是 off-the-shelf prompting。 - 解碼。 主表是 greedy。括號裡提到後續可用多數決改善(Wang et al., 2022a);那是 self-consistency,不是本表的設定,本文也不借用它的數字。
- Exemplar 數量。 數學題共用八條人工 CoT(Appendix Table 20);AQuA 用四條訓練集解答(Table 21)。作者說這八條沒有做 prompt engineering;穩健性在 Section 3.4 與 Appendix A.2。
- 可選的事後計算機。 Appendix B 在生成之後用 Python
eval重算鏈裡的方程式,再把結果字串替換進後面的式子。Table 1 的 “+ ext. calc” 列是這個後處理。它不是解碼中的工具呼叫,也沒有環境 observation。
與後來控制點的對照:CoT 不擴 action space;thought 不是可以穿插環境動作的合法下一步。需要那份契約時讀 ReAct。需要訓練分布裡插入 API 時讀 Toolformer。
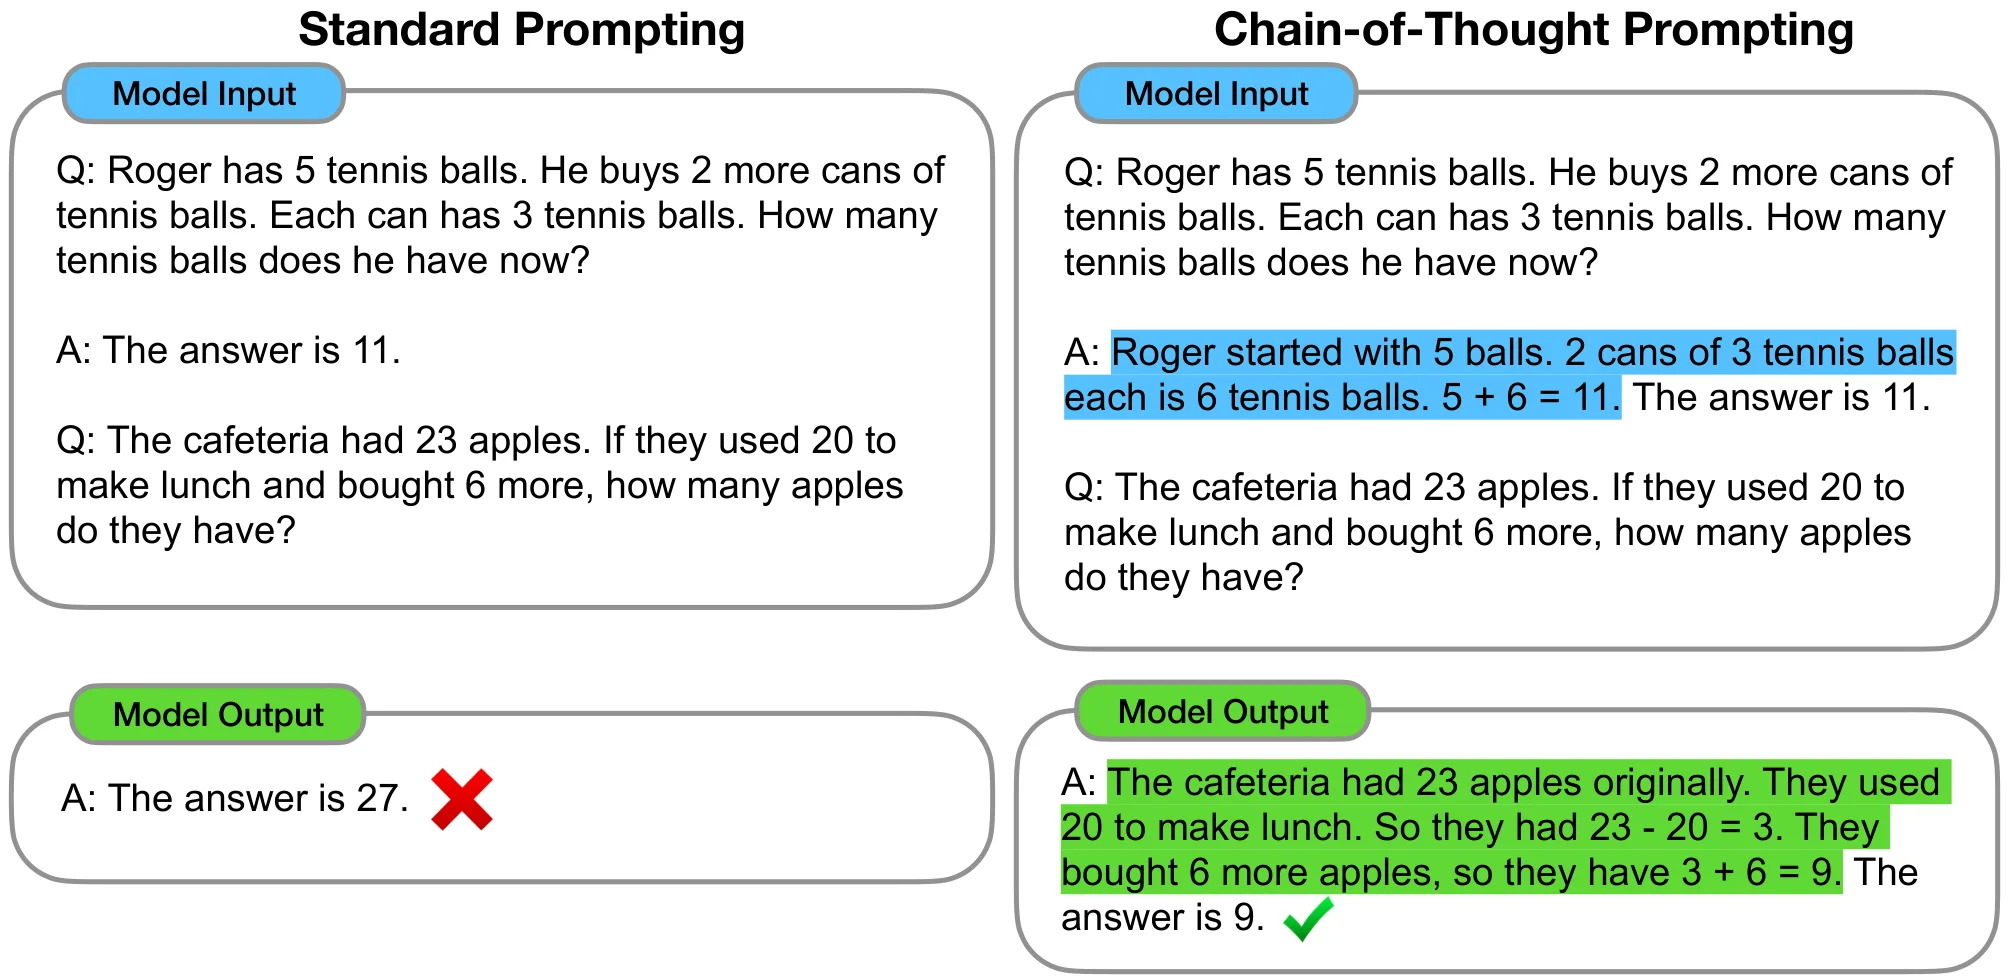
Figure 1,論文 Introduction/Section 2:左側 exemplar 只有答案,測試題被答成 27;右側 exemplar 含中間推理,模型生成逐步計算並得到 9。原圖可定位到 Figure 1,PNG endpoint 為 new-pull-figure-landscape.png。取自 arXiv HTML/對應圖檔,頁面標示 CC BY 4.0。

實驗如何讀 / How to read the evidence
算術、常識、符號三組實驗問的不是同一件事。算術看多步應用題;常識看世界知識與多跳策略;符號看能不能把 exemplar 裡的操作搬到更長的沒見過輸入。主解碼是 greedy;LaMDA 對 exemplar 順序報五個 seed 的平均,其他模型為了省算力只用一種順序。
Table 1:GSM8K 的 56.9 是 prompting,不是 finetune
這張表問:同一個凍結模型,把 exemplar 從「直接答」改成「先寫步驟」,五個數學 benchmark 的正確率怎麼變?控制住的是模型與(數學題上)那組八條示範;改的是示範裡有沒有 。
| 模型 | Prompting | GSM8K | SVAMP | ASDiv | AQuA | MAWPS |
|---|---|---|---|---|---|---|
| Prior best(finetune) | — | 55 | 57.4 | 75.3 | 37.9 | 88.4 |
| GPT-3 175B | Standard | 15.6 | 65.7 | 70.3 | 24.8 | 72.7 |
| CoT | 46.9 | 68.9 | 71.3 | 35.8 | 87.1 | |
| Codex | Standard | 19.7 | 69.9 | 74.0 | 29.5 | 78.7 |
| CoT | 63.1 | 76.4 | 80.4 | 45.3 | 92.6 | |
| PaLM 540B | Standard | 17.9 | 69.4 | 72.1 | 25.2 | 79.2 |
| CoT | 56.9 | 79.0 | 73.9 | 35.8 | 93.3 |
觀察:GSM8K 上 PaLM 540B 從 17.9 到 56.9(+39.0),越過 Cobbe et al. 的 prior best 55,也越過 Figure 2 裡 finetuned GPT-3 175B 的 33。Figure 2 把 56.9 畫成 57。SVAMP 與 MAWPS 上 CoT 也超過當時 supervised best;作者注明 SVAMP 的 standard 其實已經超過 prior best。ASDiv 與 AQuA 上 PaLM CoT 離當時 SOTA 不到 2 個百分點(73.9 vs 75.3;35.8 vs 37.9)。
Codex CoT 的 GSM8K 63.1 高於 PaLM 56.9。那一列是 v5 才加入的 code-davinci-002。Abstract 的 headline 仍是 PaLM 540B 八條示範對上 finetuned GPT-3 + verifier,不要把 63.1 寫回摘要那句。
事後計算機把 PaLM GSM8K 從 56.9 推到 58.6,幫助不大;它比較能抬 UL2/LaMDA 這種較小模型。這支持「GSM8K 的瓶頸比較像語意分解,而不是最後那次加減」。
這張表不能支持「2026 年的 GSM8K SOTA」,也不能把 Codex 63.1 讀成 abstract 的官方主角。
Figure 4/Table 2:增益是規模上才出現的
這組圖問:曲線是平滑變好,還是小模型根本沒有 CoT?控制住 prompting 格式;改的是參數量。
Table 2 的關鍵切片:LaMDA 420M 的 GSM8K 從 2.6 降到 0.4;GPT 6.7B 從 4.0 降到 2.4;PaLM 8B 從 4.9 到 4.1。到 PaLM 62B 才有 9.6 → 29.9;540B 才有 17.9 → 56.9。作者把正向增益的門檻寫在約 100B,並定性觀察:小模型會產生通順但不合邏輯的鏈。
Table 3 把 MAWPS 拆開:PaLM 540B 在 SingleOp 上 standard 與 CoT 都是 94.1;AddSub 甚至從 93.9 降到 91.9。真正拉大的是 MultiArith:42.2 → 94.7。這支持「題目已經很簡單、曲線已經很高時,CoT 沒什麼頭寸」。
這組結果支持「CoT 不是對所有規模都加分」;它不支持把 100B 當成今日小模型的物理定律——預訓練資料與後訓練都已換代,但那是外推,不是這篇的表。
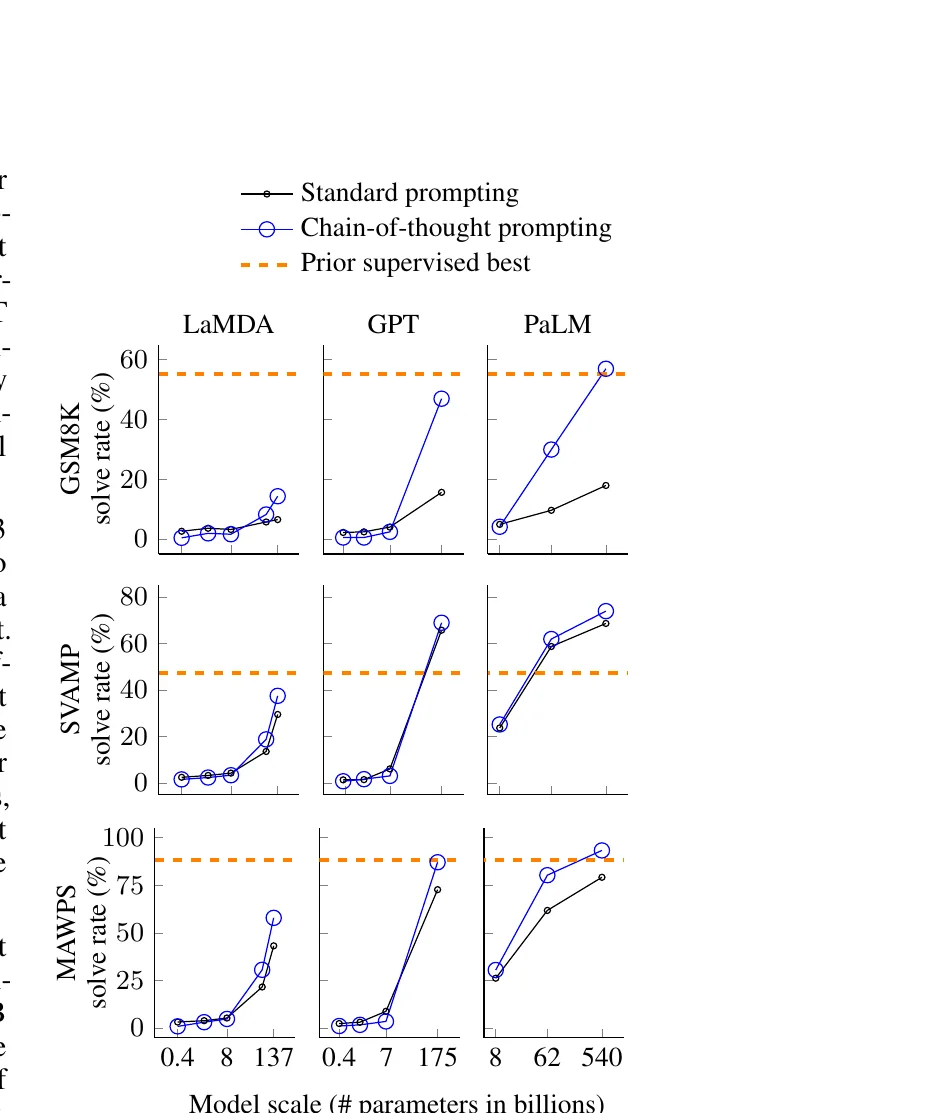
Figure 4,論文 Section 3.2:三列是 LaMDA/GPT/PaLM,三列是 GSM8K/SVAMP/MAWPS。實心點是 standard,空心點是 CoT,虛線是當時 supervised best。原圖可定位到 Figure 4。取自 arXiv v6 PDF/HTML,頁面標示 CC BY 4.0。
Figure 5/Table 6:不是多算力,也不是答完再解釋
消融問:若只輸出方程式、只輸出與方程式等長的點點、或把推理放到答案後面,能不能得到同樣增益?控制模型為 LaMDA 137B 與 PaLM 540B,任務為 GSM8K。
Figure 5 上,前四種柱在 LaMDA 都擠在約 6%;PaLM 上 equation-only 略升、點點與「推理在答案後」仍接近 standard 的 17.9。只有 CoT 把 PaLM 拉到約 57。Table 6 給出 LaMDA 137B、五種 exemplar 順序的標準差:standard 6.5±0.4,CoT 14.3±0.4,equation-only 5.4±0.2,variable compute 6.4±0.3,reasoning after answer 6.1±0.4。
作者的解釋:GSM8K 的語意無法一步翻成方程式(Appendix A.4 的 ping-pong 例:equation-only 算出 6,CoT 算出 9)。點點排除「只是多給 tokens」;答後解釋排除「只是把預訓練知識喚醒」。
這支持「答案前的自然語言步驟」是機制,不是裝飾。它不支持「所有中間步驟都忠實反映內部計算」——論文自己把這列為開放問題。
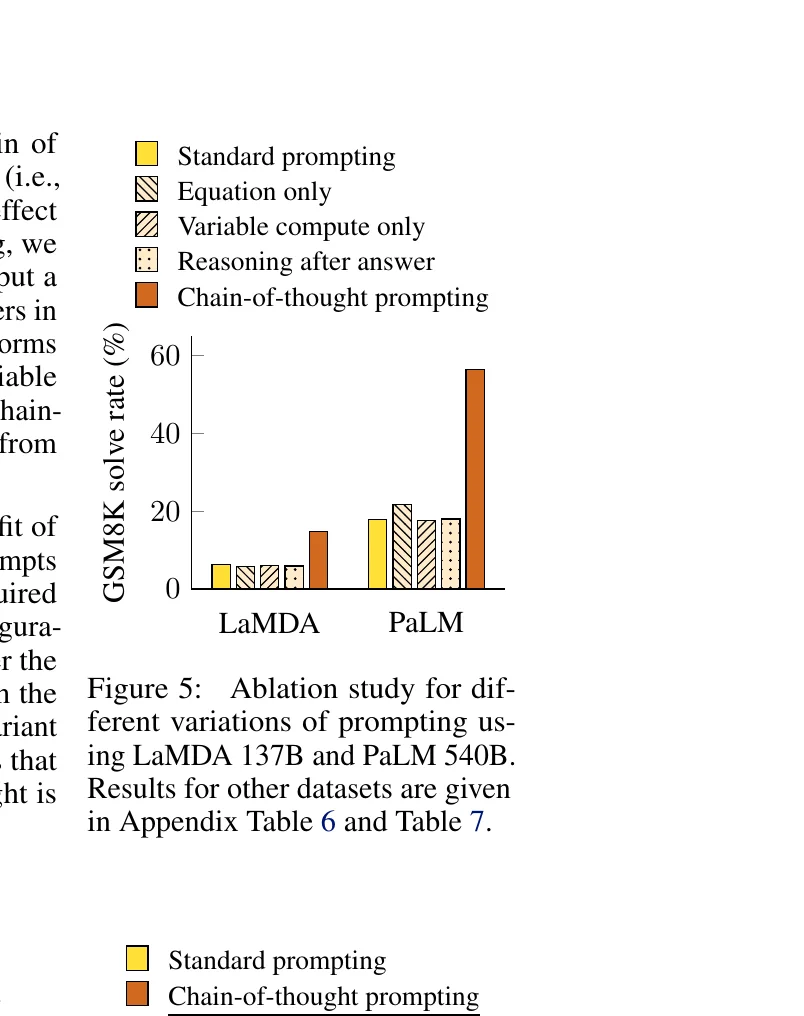
Figure 5,論文 Section 3.3:左為 LaMDA 137B、右為 PaLM 540B。其他資料集見 Appendix Table 6/7。原圖可定位到 Figure 5。取自 arXiv v6 PDF/HTML,頁面標示 CC BY 4.0。
Table 4:常識任務不是全面勝利
Figure 7/Table 4 問:語言形式的中間步驟能不能搬到常識。PaLM 540B 的 standard → CoT:
| 任務 | Standard | CoT |
|---|---|---|
| CSQA | 78.1 | 79.9 |
| StrategyQA | 68.6 | 77.8 |
| Date understanding | 49.0 | 65.3 |
| Sports understanding | 80.5 | 95.4 |
| SayCan | 80.8 | 91.7 |
Section 4 正文把 StrategyQA 寫成 75.6% vs 當時 leaderboard 單模型 69.4%(截至 2022-05-05),體育理解 95.4% vs 未輔助的體育愛好者 84%。Appendix Table 4 的 PaLM 540B CoT 是 77.8。本文用 Table 4 當模型數字,把 75.6/69.4 當作者對 prior SOTA 的陳述,不當第二套官方 PaLM 儲存格。CSQA 幾乎沒動(78.1 → 79.9),作者自己寫 gain was minimal。
GPT-3 175B 在 CSQA 上 CoT 下降(79.5 → 73.5),StrategyQA 幾乎持平(65.9 → 65.4)。Appendix A.2 把「同一組 prompt 沒有在所有模型上同樣加分」列為限制。
BIG-bench 的 Date/Sports 沒有訓練集:作者拿評測集前十題當 exemplar,其餘當測試。這是可重複的協議,但也是對「完全沒看過評測分布」的威脅。
Table 5:符號任務幾乎是抄結構,OOD 才考長度
Last-letter concatenation 與 coin flip 是玩具任務:in-domain 的解法結構已經寫在 exemplar 裡。PaLM 540B 的 CoT 在兩字姓名與兩次翻面上幾乎滿分(99.4/100.0)。OOD 把長度加到 4:last-letter standard 停在 0.0,CoT 到 63.0;coin-flip standard 54.8,CoT 90.2。小模型即使 in-domain 也做不好。
這支持「夠大的模型能把示範裡的操作搬到更長輸入」。它不支持把 100% 讀成一般符號推理能力:作者明說這是 toy tasks。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
Section 6 已經寫了四條:寫出人類式步驟不等於證明網路在「推理」;few-shot 標註雖便宜,若要 finetune 仍可能貴;推理路徑沒有正確性保證,對的答案也可以來自錯的鏈;能力主要出現在大模型,服務成本高。
讀表時還要留下這些邊界:
- 沒有環境。 沒有 search、沒有瀏覽器、沒有 observation。CoT 不是 ReAct。
- 沒有工具學習。 事後
eval不是 Toolformer 那種訓練時插入的 API。 - 沒有記憶分頁。 整段鏈都待在同一個 prompt 裡。
- 規模依賴,且可為負。 Table 2 的小模型、Table 3 的 SingleOp、Table 4 的 GPT-3 CSQA 都不是「加上 CoT 就變好」。
- Exemplar 仍敏感。 多數變體高於 baseline,但 coin flip 上 Annotator A 99.6、Annotator C 71.4(Table 7);有人能寫出反轉五元素列表的 CoT,另兩位寫不出(Appendix A.2)。
- 主模型不可重跑。 PaLM 與 LaMDA 不是公開權重。公開的是 GPT-3 API 設定(許多引擎已下線)與補充包裡的輸入/輸出。
- 分開後續研究的證據。 Self-consistency、o1、o3、DeepSeek-R1 與 2025–26 GSM8K 分數都不屬於這張表。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 CoT?當任務是多步、模型夠大、你需要一條可讀的中間過程,而且不需要接觸外部世界。此時應把「步驟」與「最終答案」分開記錄,並抽查答對樣本裡的鏈是不是碰巧。
什麼時候不要把這篇論文當成施工圖?
- 下一步必須查文件、改環境、或等 observation 時,讀 ReAct。CoT 沒有那條迴圈。
- 問題是訓練時要不要插入一次 API,讀 Toolformer。
- 模型很小,或題目本來就是一步加減:Table 2/3 顯示 CoT 可能有害或沒頭寸。
- 你需要保證中間句與內部計算一致:論文把它留作開放問題,不能當成安全審計。
- 你想用多數決過多樣本:那是後來的 self-consistency,不是這篇的 greedy 主表。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v6 PDF、HTML 可讀,license 為 CC BY 4.0。NeurIPS 2022 摘要頁 可開啟;同 hash 的 Supplemental zip 回 404。
- 程式與補充:jasonwei20/chain-of-thought-prompting 可存取(與 v1 同日建立)。可見
chain-of-thought-zip.zip(LaMDA 137B 與 GPT-3text-davinci-002的 input/target/prediction,以及 SayCan 輸出)與LICENSE_COINFLIP_LAST_LETTER(僅適用合成的 coin-flip/last-letter 資料,MIT/Copyright 2021 Google)。這不是可重跑 PaLM 的訓練代碼,也沒有官方 runtime。 - 模型:PaLM 與 LaMDA 不是一般可下載 checkpoint。論文 Reproducibility Statement 已寫主實驗因此難完全重現;GPT-3 公開 API 實驗在當時可重跑,
text-davinci-002現已不是預設公開引擎。 - 資料:GSM8K、SVAMP、ASDiv、AQuA、MAWPS、CSQA、StrategyQA、BIG-bench Date/Sports、SayCan 各有原倉庫或頁面(Appendix E.3)。合成符號資料在補充包。
最小有用 reproduction 是:用 Appendix Table 20 的八條數學 exemplar,對一小撮 GSM8K 題跑凍結模型,確認輸出含中間步驟、且沒有外部 API 被呼叫。不要宣稱這能復現 Table 1 的 PaLM 540B 56.9。
三個記憶點 / Three things to remember
- 技術想法:CoT 把 few-shot 示範從 改成 ;改變的是答案前要不要寫出中間步驟,不是權重、工具或環境。
- 證據:PaLM 540B 在 GSM8K 上 17.9 → 56.9,且消融表明多 tokens 或答後解釋不夠;正向增益大約在最大的模型才穩定出現。
- 邊界:這是凍結 prompt。小模型可能更差;鏈可以不忠實;沒有 observation。需要行動時讀 ReAct,不要把後來的推理模型分數寫回這張表。
延伸閱讀
CoT 處理的是「要不要把推理寫出來」。接下來可依問題選讀:
- thought 與環境動作是否要交錯:讀 ReAct。
- 是否要在訓練時插入 API:讀 Toolformer。
- 方法之間的完整關係:讀 Agent 方法底座閱讀地圖。
閱讀方法見 三遍掃描法。