序列建模基礎
4 篇精讀筆記
從經典 encoder–decoder 與 self-attention 架構出發,建立判讀序列轉換論文的底座。
讀者問題
一個序列模型的控制點改在哪裡,哪些證據仍值得帶進今天的系統?
READING LIBRARY
深入讀這個議題
目前收錄在這個研究議題下的所有論文精讀。
-
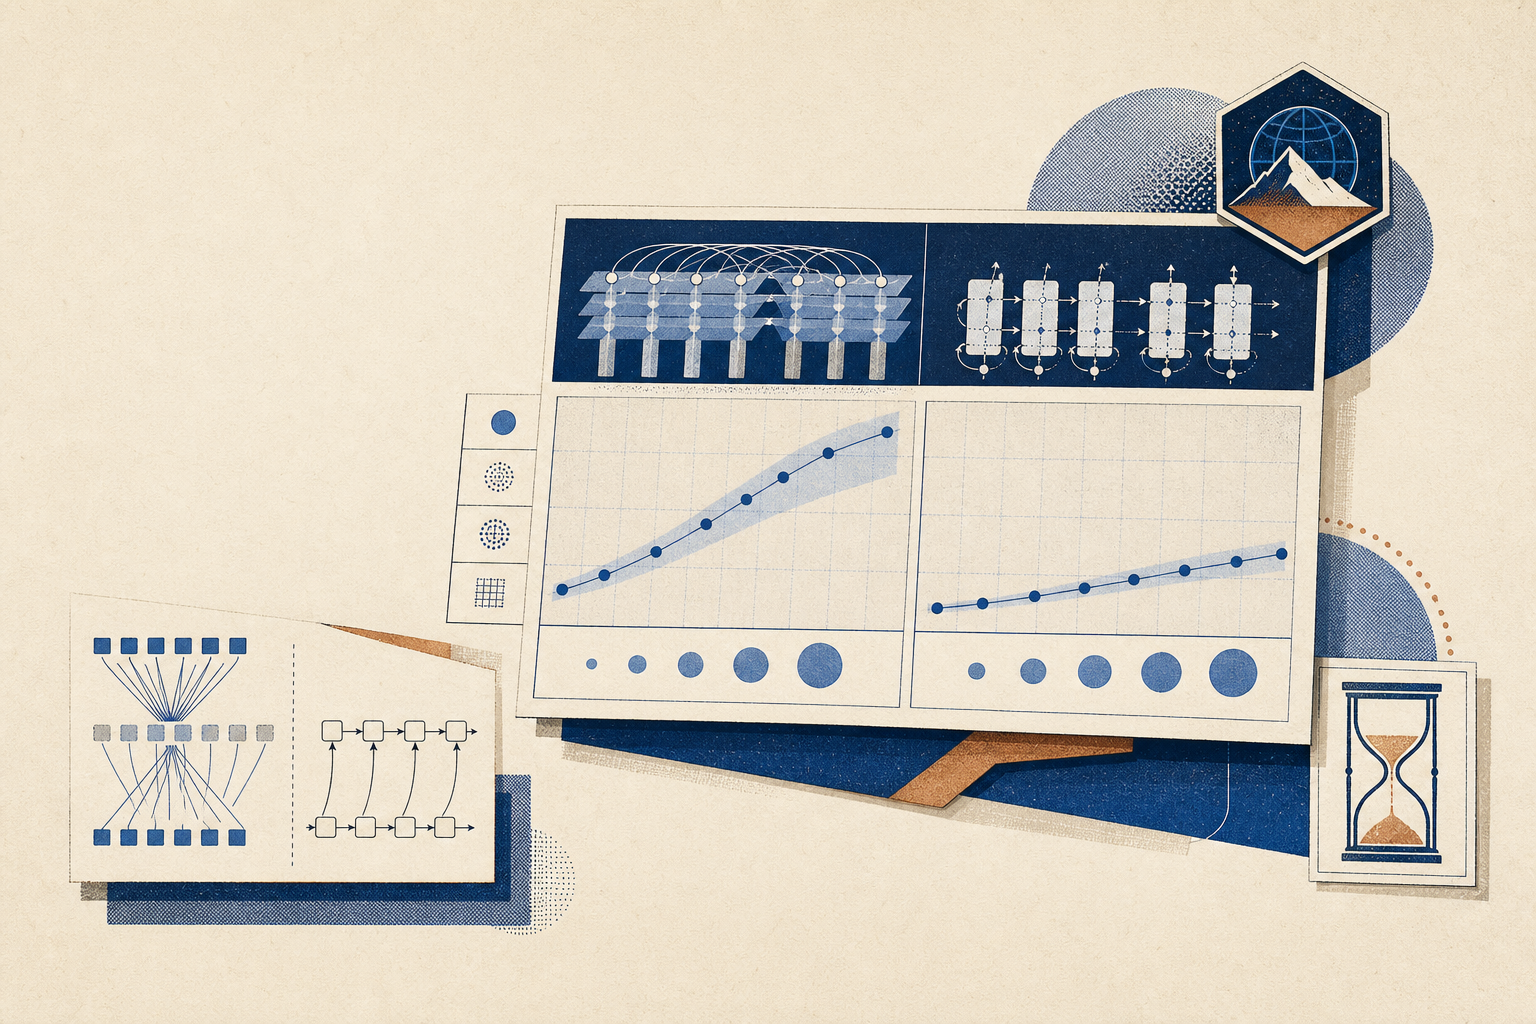
Transformer:用 self-attention 拿掉 recurrence,但 WMT 2017 BLEU 不能代表後來的 LLM
中階 先建立方法閱讀底座精讀 Vaswani et al. NeurIPS 2017/arXiv:1706.03762:用 stacked encoder–decoder、multi-head self-attention 與 positional encoding 取代 RNN/CNN 做機器翻譯。WMT 2014 上 big 模型 EN-DE 28.4 BLEU、EN-FR 41.8 BLEU;這是 2017 序列轉換證據,不是 BERT、GPT-3 或 ViT 契約。
90 秒掌握這篇論文
- 問題
- 2017 年前 SOTA 序列轉換(seq2seq)多靠 RNN/LSTM/GRU encoder–decoder,計算沿時間步序列展開,難以在長序列上充分並行;Bahdanau 等雖已把 attention 接到 RNN 上,但 recurrence 仍是骨幹(Section 1–2)。
- 核心洞見
- 提出 Transformer:encoder 與 decoder 皆由 multi-head self-attention 與 position-wise FFN 堆疊而成,以 sinusoidal positional encoding 注入順序,完全拿掉 recurrence 與 convolution。控制點是 可並行的 global attention 對 循序 hidden state;路徑長度對遠距依賴為 $O(1)$(Table 1)。
- 最強證據
- WMT 2014 newstest2014(Table 2):Transformer (big) EN-DE 28.4 BLEU(超越先前含 ensemble 的最佳結果)、EN-FR 41.8 BLEU;big 在 8×P100 上訓練 3.5 天(300K steps)。Base 模型 EN-DE 27.3 BLEU,訓練 FLOPs $3.3\times10^{18}$,低於 GNMT+RL 的 $2.3\times10^{19}$。硬體段落:base 12 小時/100K steps、每 step 0.4 秒(Section 5.2)。
- 主要邊界
- 任務是 監督式 MT encoder–decoder,不是預訓練語言模型、不是 BERT 雙向編碼、不是 decoder-only GPT、不是 ViT。BERT/GPT-2/3/T5/LLaMA/ChatGPT 的 benchmark 不屬本 PDF;YOLO VOC mAP、ResNet ImageNet 4.49% 亦不是 MT 契約。
-
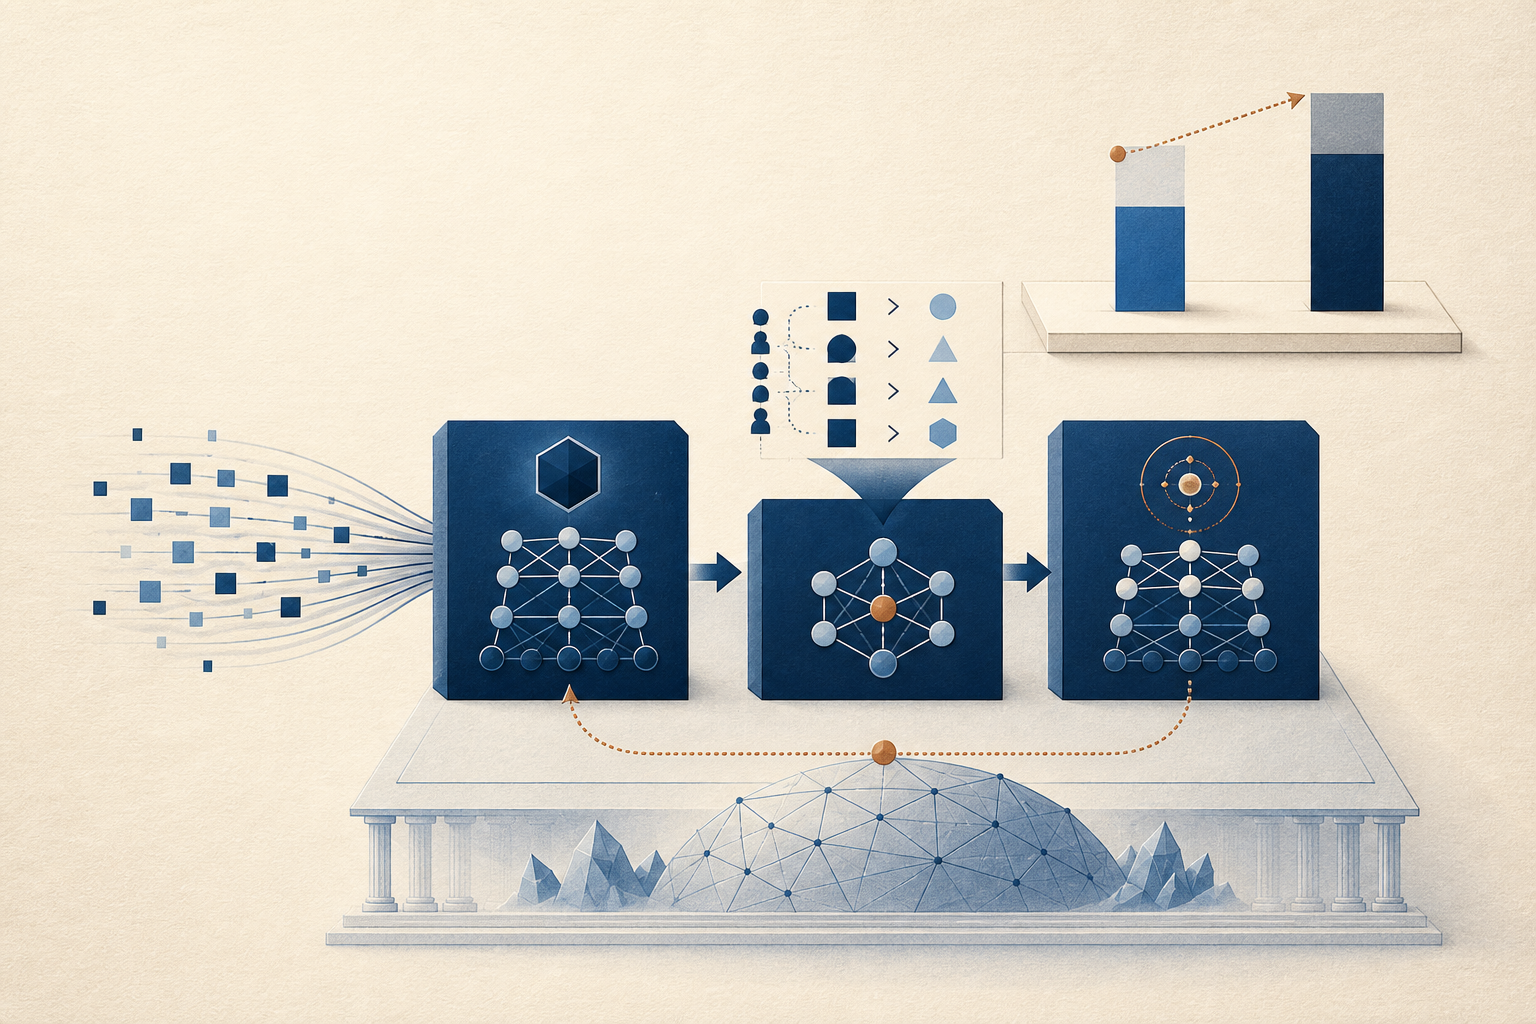
InstructGPT:用人類回饋對齊指令,但 2022 偏好勝率不能代表後來的 ChatGPT
中階 先建立方法閱讀底座精讀 Ouyang et al. NeurIPS 2022/arXiv:2203.02155:沿用 GPT-3 架構,以 SFT 示範、reward model 與 PPO(PPO-ptx)三階段繼續調整權重,使預訓練 LM 更符合人類偏好。175B InstructGPT 相對 175B GPT-3 偏好勝率 85±3%;這是 2022 API 標註分佈證據,不是 ChatGPT 產品 SLA、GPT-4 或 DPO 契約。
90 秒掌握這篇論文
- 問題
- 更大的 LM 不會自動更聽話;GPT-3 類模型在 next-token 預訓練目標下常產生不真實、有毒或不依指令的輸出(Section 1)。語言建模目標與「依使用者意圖、安全地回應」並不對齊。
- 核心洞見
- 沿用 GPT-3 模型架構,但繼續更新模型參數,依序完成三個階段:(1) SFT——用約 40 位 contractor 的示範微調;(2) RM——用 6B reward model 擬合人類排序;(3) PPO——以 RM 分數為獎勵,並加上相對 SFT policy 的 KL 懲罰;預設 PPO-ptx 還混入預訓練目標,以減輕 public NLP 任務退步(Figure 2、Equation 2、Section 3.5)。改變的是 人類偏好對齊程序,不是 attention 架構。
- 最強證據
- API prompt 分佈上,labeler 偏好評估(Figure 1、Section 4.1):175B InstructGPT 相對 175B GPT-3 勝率 85±3%;相對 few-shot GPT-3 71±4%;1.3B InstructGPT 仍優於 175B GPT-3(>100× 參數差距)。相對 175B SFT 基線,InstructGPT 勝率 73.4±2%,優於 FLAN/T0 微調(26.8±2%、29.8±2%)。
- 主要邊界
- 2022 封閉 GPT-3 family;偏好來自特定 labeler 與 API Playground 分佈(Section 5.2–5.3)。ChatGPT 產品指標、GPT-4、DPO、Llama-2-chat、Constitutional AI 不屬本 PDF;YOLO mAP、Transformer WMT BLEU 亦不是對齊契約。
-
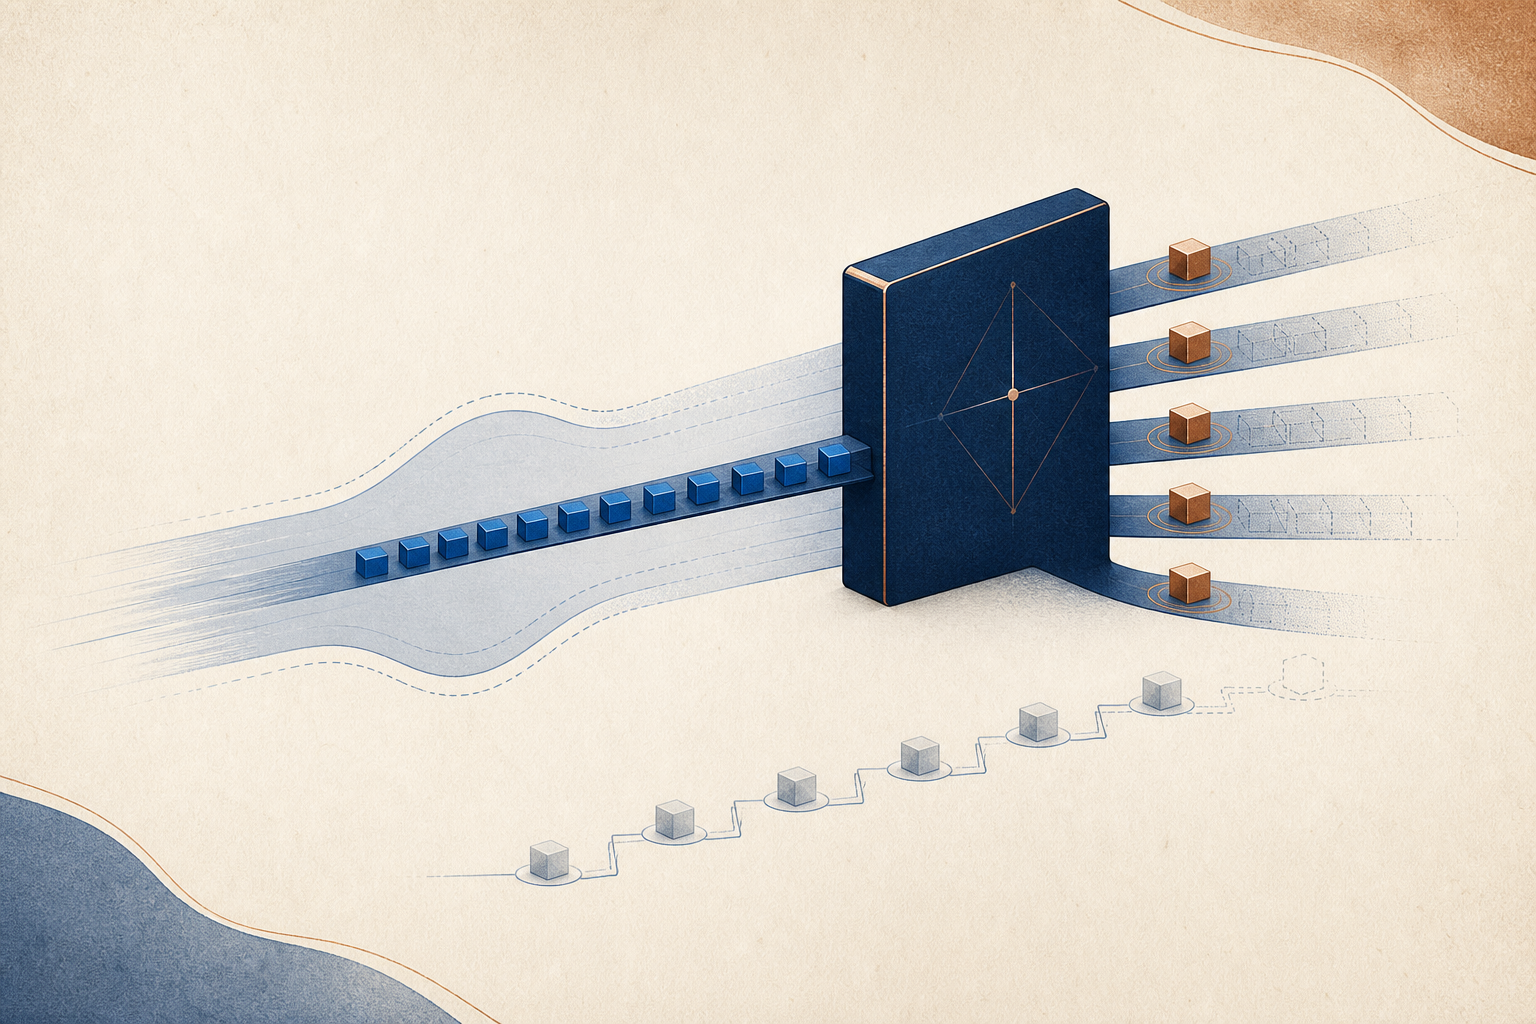
Speculative Decoding:用小模型打草稿、大模型一次驗,但 T5 加速比不代表所有推論堆疊
中階 先建立方法閱讀底座精讀 Leviathan et al. ICML 2023/arXiv:2211.17192:用小模型 M_q 自迴歸打草稿、目標模型 M_p 平行驗證並以 rejection sampling 保證輸出分佈與單獨解碼相同。T5-XXL 11B 在 T5X 上 2.3X–3.4X 牆鐘加速;這是 2023 無損推論演算法證據,不是 GPTQ、FlashAttention、vLLM、Medusa 或 EAGLE 契約。
90 秒掌握這篇論文
- 問題
- 大型自迴歸 Transformer 解碼 $K$ 個 token 需要 $K$ 次 序列 前向;每步常受 記憶體頻寬 限制而非純算力飽和,額外並行資源閒置(Section 1)。
- 核心洞見
- Speculative Decoding——小模型 $Mq$ 先自迴歸產生 $\gamma$ 個草稿 token,目標模型 $Mp$ 一次平行 計算 prefix 到各草稿位置的分佈 $p1,\ldots,p{\gamma+1}$,再用 speculative sampling(rejection sampling + 調整分佈)決定接受幾個草稿並補一個保證來自 $Mp$ 的 token。控制點是 無損平行驗證 對 逐步單模型解碼;輸出分佈與只用 $Mp$ 完全相同(Algorithm 1、Appendix A.1)。
- 最強證據
- T5-XXL 11B 作 $Mp$,現成 T5-small 77M 作 $Mq$,對 T5X baseline、batch=1、單顆 TPU-v4(Table 2):WMT EnDe 3.4X(temp=0,$\gamma=7$,$\alpha=0.75$)/2.6X(temp=1,$\alpha=0.62$);CNN/DM 3.1X/2.3X。摘要與 Section 4 亦報告相對 T5X 的 2X–3X 區間。
- 主要邊界
- 需要 符合任務的 draft model,硬體也必須能在一輪目標模型計算中平行驗證多個草稿位置;總 算術操作數可能上升(Section 3.4、6)。這是 2023 Google T5X 實作契約,不是 vLLM/TensorRT-LLM 產品 SLA、不是 GPTQ bitwidth、不是 Medusa/EAGLE 額外 head。InstructGPT 85±3% 勝率、Transformer WMT BLEU、YOLO mAP 不屬本 PDF。
-
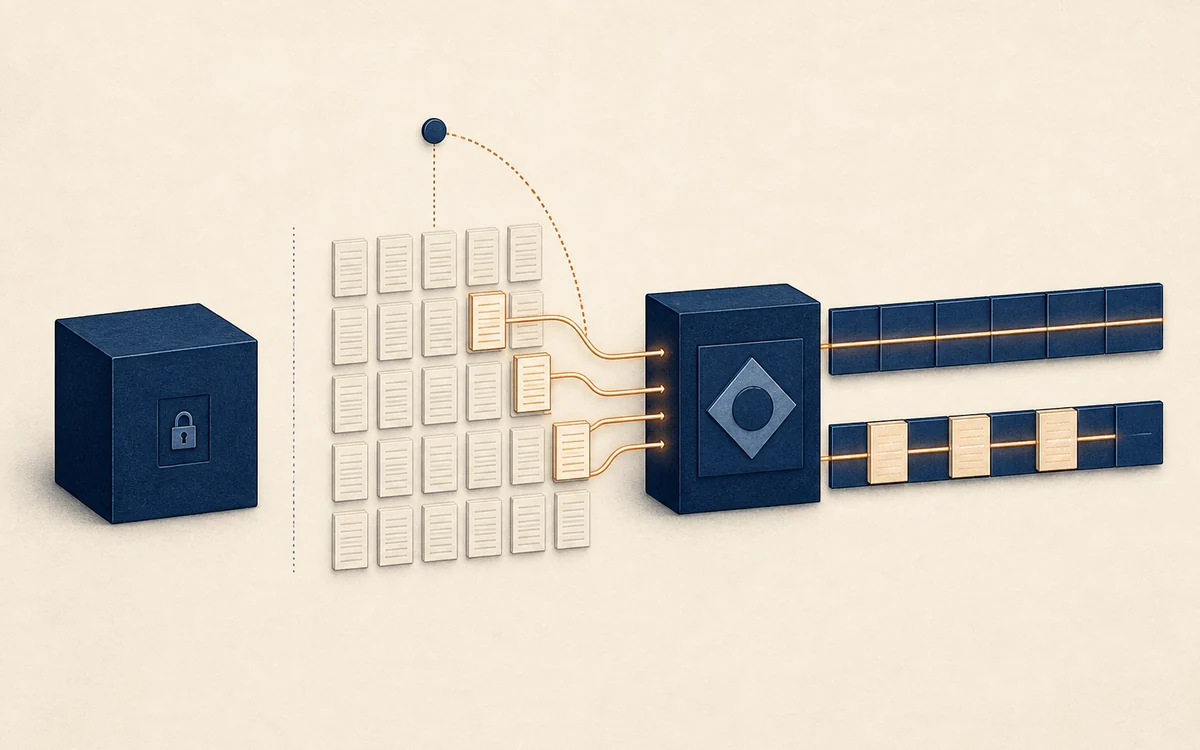
RAG:把檢索接上生成,但不能把 2020 的 RAG 當成 Production RAG 平台
中階 理解檢索、記憶與 Production RAG精讀 Lewis et al. NeurIPS 2020:把 BART 接到 Wikipedia 的 dense retriever,用 RAG-Sequence/RAG-Token 讓取回的段落條件化生成。NQ 上 RAG-Seq Exact Match 44.5;這仍是 2020 的方法論文,不是 2025 的 Production RAG 平台,也不是 agent 迴圈。
90 秒掌握這篇論文
- 問題
- 大型預訓練模型把事實塞進參數裡,知識密集任務仍落後專用架構;參數記憶難更新、難追溯,也容易胡謅。
- 核心洞見
- 把預訓練的 seq2seq 生成器(BART)接到預訓練的 dense retriever(DPR 初始化)與 Wikipedia 索引。決策點從「只靠參數答」改成「先取回段落,再條件化生成」。RAG-Sequence 整段共用一份文件;RAG-Token 可按 token 換文件。
- 最強證據
- Table 1 的開放域 QA:NQ 上 RAG-Seq 44.5、RAG-Token 44.1,高於 DPR 41.5、REALM 40.4、T5-11B+SSM 36.6。Table 2 的生成與分類:Open MS-MARCO 上 RAG-Seq 相對 BART 各 +2.6 Bleu/Rouge-L;FEVER-3 72.5,距當時 pipeline SOTA 76.8 差 4.3 個百分點,且沒有 retrieval 中間監督。
- 主要邊界
- 記憶是 2018 年 12 月 Wikipedia 切成 21M 個 100 詞塊,不是私有語料;檢索是 dense MIPS,不是 production hybrid;沒有 agent 的 search/read/final,也沒有 2026 企業意義上的 citation faithfulness。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡