若要先了解 WebGPT 與 CoT、ReAct 的方法關係,可見 Agent 方法底座閱讀地圖。讀法可搭配 三遍掃描法。
90 秒掌握論文 / The paper in 90 seconds
- 問題:長文問答落後人類;檢索與綜合被拆開做。沒有引用時,人類很難核對段落級事實。
- 核心洞見:把搜尋引擎外包給 Bing,把綜合交給微調後的 GPT-3,中間接一個文字瀏覽器。模型只能發 Table 1 的指令(search、click、quote、scroll、end),瀏覽中收集引用,再寫答案。訓練是人類示範的行為複製,加上人類偏好的 reward model,再用 rejection sampling 選答案。
- 最強證據:175B best-of-64 對示範者整體偏好 56%,對 ELI5 最高票答案 69%(Section 4.1、Figure 2)。best-of-64 對純 BC 偏好 68%;RL 對 BC 58%,但與 rejection sampling 疊加幾乎沒有好處(Section 5.1、Figure 4、Figure 5)。
- 主要邊界:沒有獨立 thought 動作。文字瀏覽器是受限 action space,不是通用工具迴圈。答案仍可能改寫錯或挑對 labeler 有說服力的引用。這是 2021 的 OpenAI 技術報告/arXiv preprint,不是後來的產品瀏覽功能。
我的結論是:WebGPT 最值得保留的貢獻,是讓模型在受限的文字瀏覽器中搜尋、點擊並收集引用。它沒有獨立的推理動作,也不是 ReAct 或今日通用搜尋 Agent 的完整執行環境。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Nakano et al., arXiv:2112.09332 v3,首發於 2021-12-17,最後修訂於 2022-06-01。PDF 與 arXiv HTML 標示 arXiv.org perpetual non-exclusive license,不是 CC BY。
作者順序依 v3 PDF:Reiichiro Nakano、Jacob Hilton、Suchir Balaji、Jeff Wu、Long Ouyang、Christina Kim、Christopher Hesse、Shantanu Jain、Vineet Kosaraju、William Saunders、Xu Jiang、Karl Cobbe、Tyna Eloundou、Gretchen Krueger、Kevin Button、Matthew Knight、Benjamin Chess、John Schulman。前三位註明 equal contribution、順序隨機;通訊信箱另含 John Schulman。
來源 tar 雖含 neurips_2020.sty,那只是排版樣式,不代表論文已在 NeurIPS 或 ICLR 發表。
除摘要外,本文核對 Section 2 的環境與 Table 1、Section 3 的資料與四種訓練、Section 4 的 ELI5/TruthfulQA/TriviaQA、Section 5 的方法比較與 scaling、Section 6 的限度,以及截至 2026-08-27 的工件。Bing Chat、SearchGPT、Deep Research、Browser-use 排行榜與 ReAct 的 WebShop 40.0 不納入本文表格。
這是 OpenAI 技術報告/arXiv preprint,不是已發表的會議論文。
讀者真正要回答的問題
當模型要回答需要上網查的長問題時,工程上是該把檢索做成可微分的 retriever,還是給模型一個人類也用不慣的搜尋框,讓它用示範與偏好學會瀏覽?Nakano et al. 的回答是:外包 Bing、凍結住「只能發瀏覽器指令」這份契約,再用 IL+HF 把答案品質直接優化。
比較精確的讀法不是「WebGPT 是不是 Agent」。真正的問題是:允許模型對環境行動、但不給它一條合法的語言 thought,這個改變在 ELI5 與 TruthfulQA 上移動了哪些偏好,又在哪裡因為引用不忠實、來源不可靠或 action space 太窄而失效?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1 給出環境觀察;Table 1 給出合法指令;Table 4 給出約 6,209 條示範與 21,548 對比較;Figure 2 給出 ELI5 人類偏好;Figure 3 給出 TruthfulQA;Figure 4/5 給出 RL 與 best-of-n;Table 9 給出 TriviaQA 轉移。 |
| 作者主張 | 端到端優化瀏覽與綜合、用引用降低事實核對成本,能達到與人類示範相當甚至略優的 ELI5 偏好;rejection sampling 是主路徑,RL 在推論算力較緊時才較有用。 |
| 論文未證明 | thought–action–observation 契約;通用 Agent runtime;答案對引用忠實;2026 的線上搜尋產品;ReAct 的 WebShop 分數。 |
| Bloss0m 工程判斷 | 把 WebGPT 當成「能在受限瀏覽器中行動,但沒有獨立 thought 動作」的方法。需要把推理寫進凍結 prompt 時讀 CoT;需要 thought 與環境動作交錯時讀 ReAct。 |
後文把數字、作者 claim 與工程判讀分開。「勝過人類」只指論文設定下的偏好比例,不是 2026 的產品評估。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 與 Section 7 把 2020–2021 的兩條線寫清楚。
可微分檢索:REALM、RAG、DPR 用內積搜尋文件再生成答案。優點是優化快;缺點是接不上 Bing 這種非可微搜尋引擎,過程也不好檢查。Krishna et al.(2021)已在 ELI5 上說明 ROUGE-L 幾乎沒有意義,答案被偏好的比例只有 23%。
沒有引用的長文生成:GPT-3 能寫段落,但 labeler 很難在不另做研究的情況下判斷事實。沒有引用,就沒有便宜的事實核對介面。
因此舊方法不夠的地方不是「沒人想過上網」,而是控制點被切開:要嘛把檢索做成可微模組、要嘛讓模型一次寫完答案。WebGPT 改的是:模型必須先對文字瀏覽器行動、收集引用,人類才用比較來打分。
核心直覺 / Core intuition
先不要看偏好百分比。想像一個人用純文字終端機查資料:他不能在心裡「想完再搜」,終端機只接受指令。他輸入 Search …,看到結果,Clicked on link,把一段話 Quote 下來,最後 End: Answer。模型看到的下一步幾乎都是這類指令,不是一段對自己說的計畫。
對照三種容易混在一起的下一步:
- CoT:下一步是中間自然語言步驟,環境不變,也沒有 observation。
- WebGPT:下一步是瀏覽器指令;環境回一段文字觀察。沒有獨立的 thought 動作。
- ReAct:thought 是 action space 裡一種不碰世界的合法動作,可以與 search/lookup 交錯。那是後來的匯流,不是這篇。
用一個例子走完整個方法 / Walk one example through the method
以下是 Figure 1 的教學觀察,不是獨立實驗結果。問題是:How can I train the crows in my neighborhood to bring me gifts?
- Input:只有這句問題。沒有 Wikipedia 工具 wrapper,也沒有 thought 欄位。few-shot 不存在:這是微調後的政策,不是 exemplar prompting。
- Intermediate representation:人類示範介面(Figure 1a)與模型看到的文字(Figure 1b)承載同一份狀態:Question、已收集 Quotes、Past actions、當前頁 Title/Scrollbar/Text、剩餘動作數。連結被編成
【id†text†domain】。Figure 1 的 past actions 已經是Search how to train crows to bring you gifts→Click Gifts From Crows | Outside My Window→Quote→Back。 - Model or system decision:模型必須發出 Table 1 的某一條指令。合法集合包含
Search <query>、Clicked on link <link ID>、Find in page、Quote、捲動、Back、End: Answer。其他文字算 invalid action:仍計入動作上限,但環境忽略。瀏覽在「發出結束指令/達到最大動作數/引用總長上限」三者之一時停止;至少要有一條引用才能進入作答。 - Output:作答階段把問題與引用拼成新 prompt,模型寫出帶引用的長答案。Table 2 另給了一道 ELI5 測試題的 175B best-of-64 樣本(為什麼有些詞是「髒話」),那是輸出長什麼樣,不是 Figure 1 這隻烏鴉題的官方答案。
- Likely failure point:引用可以來自不可靠來源(Table 3 的 TruthfulQA 反例:許願會成功)。綜合時可能改寫錯,而不是「憑空幻覺」。無效指令被吞掉卻仍耗動作預算。RL 若能碰到有副作用的表單本可被強化,但這個環境只允許 Bing 查詢與跟隨已存在的連結(Section 6.5)。
這條烏鴉題教的是機制怎麼走完。要看偏好被推過 50%,應回到 Figure 2;要看「寫步驟」是不是這篇的事,應看 Table 1——裡面沒有 thought。
技術機制 / Technical mechanism
環境把當前瀏覽狀態寫成文字摘要,模型在新的 context 裡產生下一條指令;先前步驟只透過摘要裡的 Past actions 與 Quotes 留下記憶(Section 2)。這不是一個會累積 hidden state 的 agent OS,而是每步重寫觀察。
Table 1 的操作效果:
| 指令 | 對環境做什麼 |
|---|---|
Search <query> | 呼叫 Bing API,顯示結果頁 |
Clicked on link <id> | 用 Readability 簡化後的 HTML 打開新頁 |
Quote: <text> | 若當前頁找得到該段,記入引用 |
End: Answer | 結束瀏覽,進入作答 |
End: <Nonsense, Controversial> 會跳過作答。reddit.com 與 quora.com 的結果會被拿掉,避免直接抄 ELI5。與問題或參考答案有 10-gram 重疊的頁面會被審查,改回錯誤訊息(Appendix A)。
訓練有四條,問題集互斥(Section 3.2):
- Behavior cloning (BC):用示範者發出的指令當 supervised label。
- Reward modeling (RM):從拿掉最後 unembedding 的 BC 模型出發,輸入「問題 + 帶引用的答案」,輸出純量。依 Stiennon et al.(2020),這個分數是 Elo:兩分數之差是人類偏好的 logit。平手當 soft 50% 標。最終 RM 約用 16,000 對比較,另 5,500 只做評估。
- Reinforcement learning (RL):用 PPO 對 BC 政策微調。回合結束時的 RM 分數,加上每個 token 相對 BC 的 KL 懲罰,用來減緩 RM 被刷爆。
- Rejection sampling (best-of-):從 BC(或 RL)抽 4/16/64 個答案,由同尺寸 RM 選最高分。不需要再訓練,但吃推論算力。
主評估的三個 WebGPT 模型都是 BC + 同尺寸 RM 的 rejection sampling:760M best-of-4、13B best-of-16、175B best-of-64。溫度 0.8,最多 100 步瀏覽。作者排除 RL 是因為 Figure 4 顯示它與 rejection sampling 疊加沒有明顯好處。
Reward 的操作含義:把 提高,等於讓 RM 更有把握這份答案會贏過對照組。差值 大約對應 的偏好(Section 5.2)。這可以拿來排序樣本,也可以被 RL 過度優化——所以主結果走 best-of-,不把 PPO 當預設施工圖。
與後來控制點的對照:WebGPT 擴了瀏覽器 action space,但沒有把 thought 加進去。需要那份契約時讀 ReAct。需要「只在 prompt 裡寫推理、不碰世界」時讀 CoT。
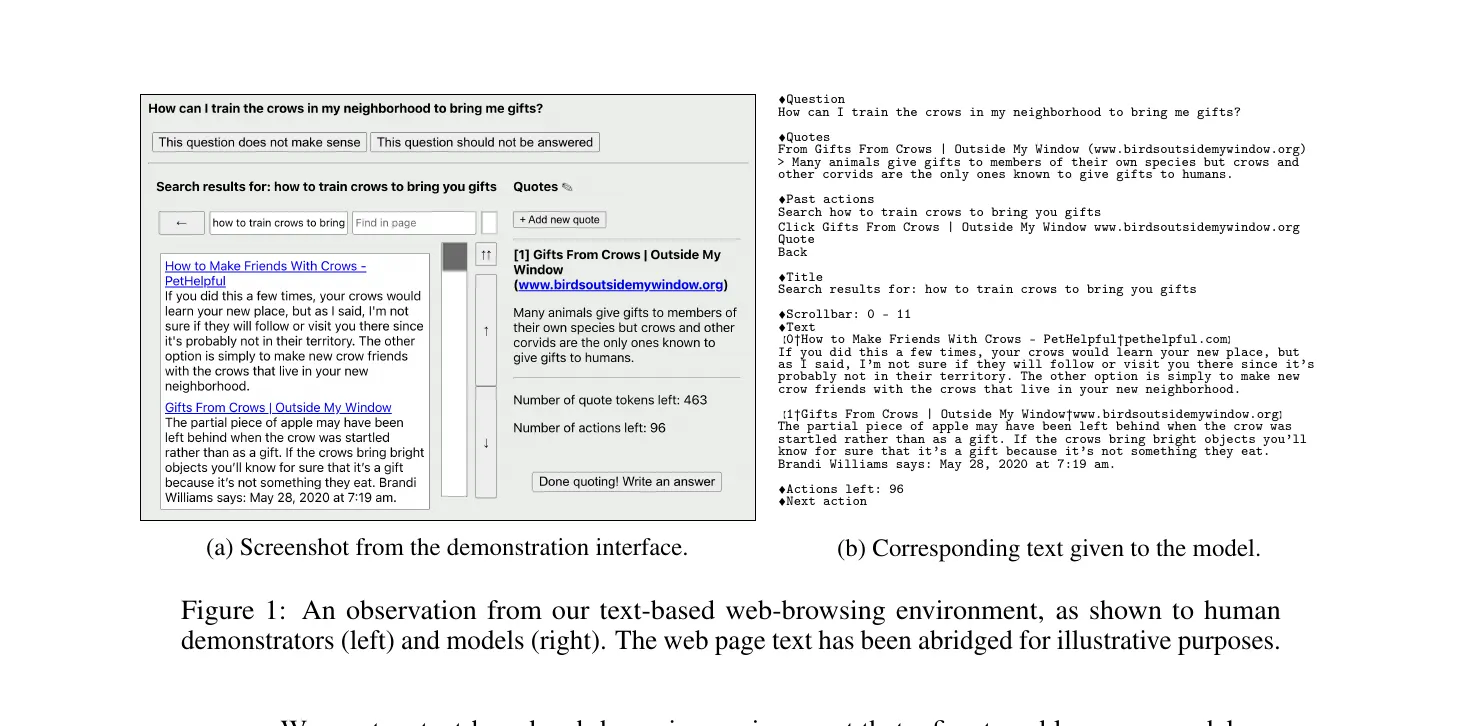
Figure 1,論文 Introduction/Section 2:同一份瀏覽狀態,左邊給示範者看 GUI,右邊序列化成模型可讀的文字。烏鴉送禮題已被示範過 Search → Click → Quote → Back。原圖可定位到 Figure 1。取自 arXiv v3 PDF/HTML;頁面標示 arXiv.org perpetual non-exclusive license,版權仍屬作者/OpenAI。
實驗如何讀 / How to read the evidence
主任務是 ELI5 長文問答。TruthfulQA 是對抗性短題,用來看會不會複述迷思。TriviaQA 是短答轉移,不是標題數字來源。主模型是 BC + best-of-;RL 只在 Section 5 當對照。
資料規模以 Table 4 為準:示範 6,209 條(ELI5 5,711,佔約 92%),比較 21,548 對(ELI5 21,068,佔約 98%)。另混入少量 TriviaQA、ARC、手寫題與 ELI5 fact-check。比較標註的研究者–標註者一致率 74%,標註者之間 73%(平手對非平手当 50%;Appendix C)。
Figure 2:56% 與 69% 不是同一種比較
這組圖問:同一個 WebGPT 答案,對上示範者、或對上 Reddit 最高票,人類比較會怎麼走?三個模型對應不同推論預算:760M best-of-4、13B best-of-16、175B best-of-64。
對示範者(Figure 2a)用與 RM 訓練相同的詳細比較程序,含引用。對 ELI5 參考答案(Figure 2b)則剝掉引用、換一批沒看過詳細說明的承包商,只用 Appendix F 的極簡指示,作者擔心生態效度與盲測。平手当 50%,不剔除。
觀察:175B best-of-64 對示範者整體有用性 56%,對 Reddit 最高票 69%。作者把 56% 讀成「人類水準的文字瀏覽器使用」,並說單靠模仿示範通常不該超過 50%。69% 遠高於 Krishna et al. 的 23%,但算力也大得多。Figure 2a 另外顯示:連貫性的柱多半停在 50% 以下,事實正確接近擲硬幣——所以 56% 不是「每個軸都贏示範者」。
這張圖不能支持「2026 年的長文 QA 產品贏過人類」,也不能把 69% 讀成有引用、有同一套詳細準則的公平賽。
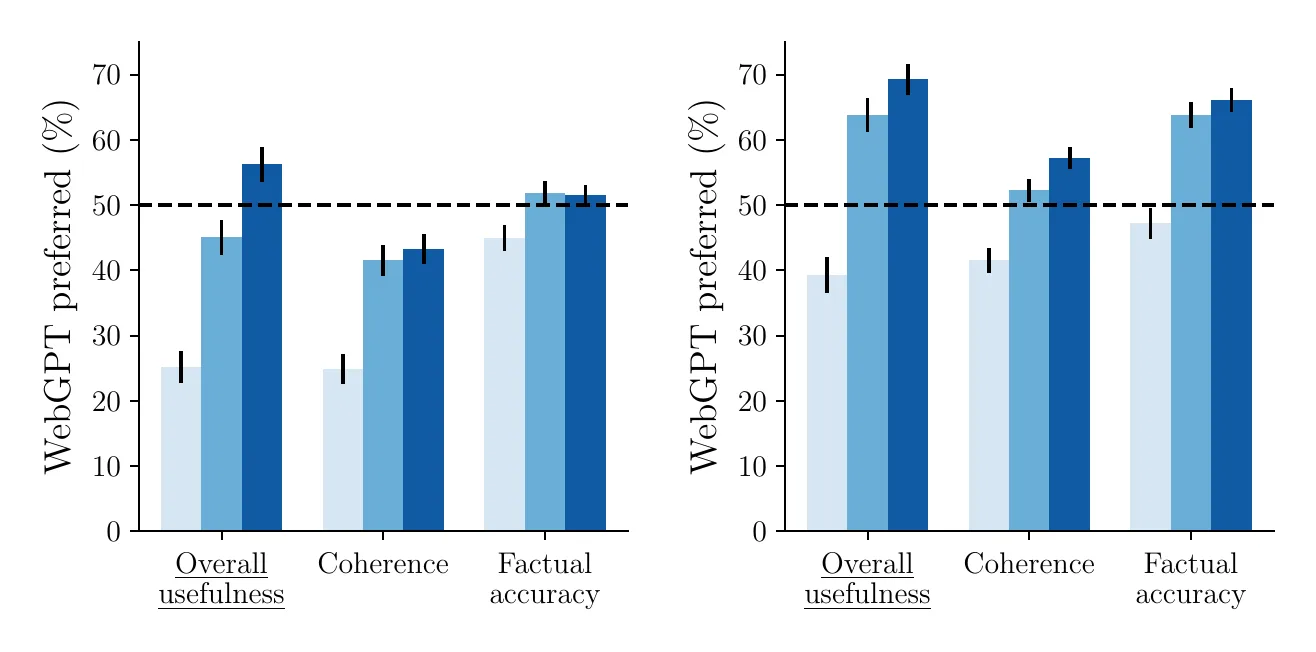
Figure 2,論文 Section 4.1:左欄 Overall usefulness 被畫底線,對應摘要的 56%;右欄是剝掉引用後對 Reddit 答案的 69%。原圖可定位到 Figure 2。取自 arXiv v3 來源 PDF 圖檔;頁面標示 arXiv.org perpetual non-exclusive license,版權仍屬作者/OpenAI。
Figure 3:TruthfulQA 的 75%/54% 仍低於人類
這張圖問:瀏覽 + 引用能不能減少「模仿式謊言」?對照是同一家族 GPT-3 的 QA prompt 與 helpful prompt;WebGPT 用人工評、並把答案截到 50 token(無意中造成約 3% 空答案,被算成真但無資訊)。
Section 4.2/引言寫:WebGPT 答案 75% 為真、54% 又真又有資訊,勝過所有 GPT-3 設定,但低於人類。Figure 3 還顯示 GPT-3 helpful prompt 的「只真」會隨規模上升,但「又真又有資訊」仍低——因為它常答 “I have no comment”。WebGPT 幾乎總是嘗試作答,所以 Table 3 才會出現引用不可靠來源的失敗。
這支持「瀏覽能壓低模仿式迷思」;它不支持「有引用就等於事實正確」——Section 6.1 把剩餘錯誤多半寫成改寫/綜合失誤,而不是狂野幻覺。
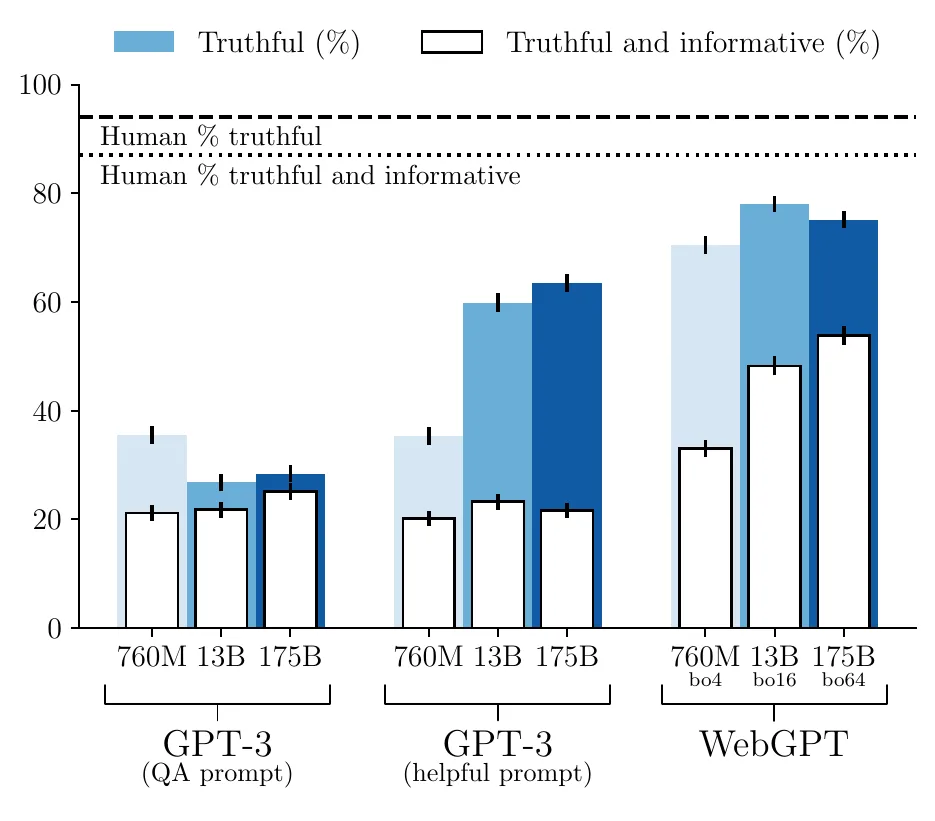
Figure 3,論文 Section 4.2:人類基線以虛線標出,高於所有模型。原圖可定位到 Figure 3。取自 arXiv v3 來源 PDF 圖檔;頁面標示 arXiv.org perpetual non-exclusive license,版權仍屬作者/OpenAI。
Figure 4/5:真正拉分的是 best-of-n,不是 PPO
消融問:同一個 RM,用 RL 微調政策、還是推論時抽很多答案再挑,哪個更能換成人類偏好?
Section 5.1 的文字數字:175B best-of-64 BC 對 175B BC 偏好 68%;175B RL 對 175B BC 偏好 58%。Figure 4 左欄(best-of-1)RL 略高於 50%,右欄加上 rejection sampling 後,175B best-of-64 甚至回到約略平手——也就是 RL 的好處在已做 best-of-n 時消失。Figure 5 顯示驗證 RM 對 best-of-n 的人類偏好預測得不錯。
作者列了幾個機制假設:多試幾次等於多花推論算力;瀏覽環境不可預測,事後再評比較穩;RM 資料多來自 BC 與 rejection sampling,對 RL 的 overoptimize 較脆;RL 還會降低熵、傷害探索。他們也強調:把 BC 的 epoch 與溫度調好,就消掉他們原先以為很大的 RL 缺口。
這支持「主結果是行為複製 + 推論時排序,不是把 PPO 當必要組件」。它不支持把 68% 讀成「RLHF 一定贏模仿」。
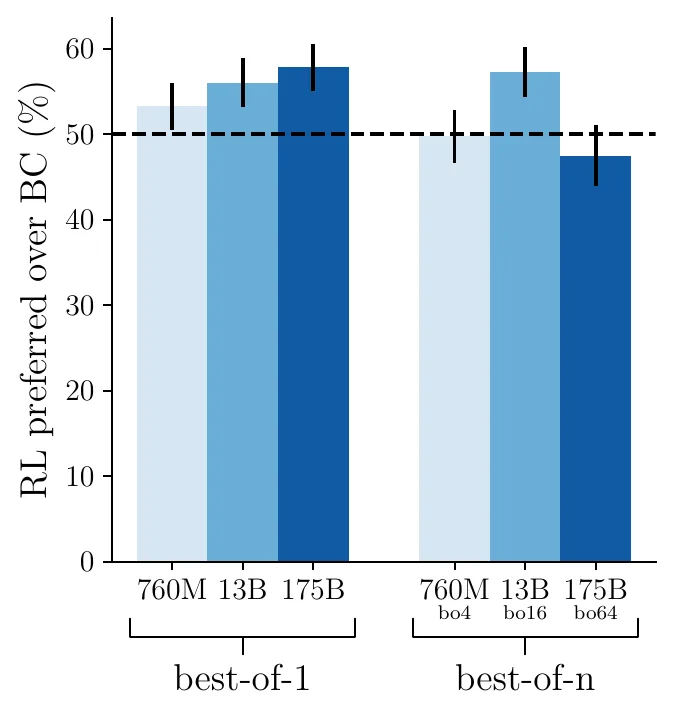
Figure 4,論文 Section 5.1:左為 best-of-1,右為 760M bo4/13B bo16/175B bo64。原圖可定位到 Figure 4。取自 arXiv v3 來源 PDF 圖檔;頁面標示 arXiv.org perpetual non-exclusive license,版權仍屬作者/OpenAI。
Table 9:TriviaQA 是轉移,不是標題
Appendix G 用 沒有 rejection sampling 的 175B BC,再另微調一個 GPT-3 175B 把長答案抽成短答案(僅 256 題)。開發集 overall EM:GPT-3 58.7%,WebGPT+抽取 69.5%,UnitedQA-E 68.9%。無題目重疊子集上略優於 UnitedQA-E。作者自己寫:算力更多、而且用即時網路而不是 TriviaQA 語料庫。這組數字不要寫回摘要的 56%/69%。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
Section 6 已經寫了幾條工程上仍成立的邊界:
- 沒有 thought 通道。 這不是 ReAct,也不是 CoT。
- 引用不是事實證明。 模型有誘因挑 labeler 覺得可信的來源;問題立場會影響答案立場(Appendix H)。權威口吻加上引用,可能讓使用者過度依賴(Section 6.2)。
- 文字瀏覽器很窄。 只有 Bing 查詢與已存在的連結;表單、編輯維基都不直接開放。這保護了 2021 的模型,也代表它不是通用瀏覽器 Agent。
- 主模型不可重跑。 GPT-3 175B 權重不公開;瀏覽器環境與訓練代碼未釋出。
- 評估設計有裂縫。 對 Reddit 答案剝引用、換極簡說明;TruthfulQA 截斷造成空答案;ELI5 的「解釋給五歲聽」本意並不是作者要的評分準則(Section 4.1)。
- 分開後續產品與論文的證據。 這份報告不是 ChatGPT browsing、SearchGPT 或 Deep Research;WebShop 40.0 則屬於 ReAct。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 WebGPT?當任務是長文問答、你需要可檢查的引用軌跡,而且願意把 action space 收成「搜尋/點擊/引用/作答」,用示範與偏好來訓練,而不是在 prompt 裡塞一條 thought。此時應把「瀏覽軌跡」與「最終答案」分開記錄,並抽查引用是否真的支撐那句話。
什麼時候不要把這篇論文當成施工圖?
- 下一步必須在同一條軌跡裡對自己說話、再碰世界:讀 ReAct。
- 問題只是要不要在凍結 prompt 裡寫出中間步驟:讀 CoT。
- 你需要通用工具、寫檔、下單、或長時 runtime:這篇環境明確不提供。
- 你把「有引用」當成安全審計:論文把 cherry-pick 與不忠實改寫留在限度裡。
- 你想把後來搜尋產品的線上評測寫回 56%/69%:那些數字不屬於這張表。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v3 PDF、HTML 可讀。License 為 arXiv.org perpetual non-exclusive license,不是 CC BY。這是 preprint/技術報告,沒有會議 proceedings 頁。
- 比較資料:論文 Appendix K 釋出 comparisons.jsonl(約 19,578 對;endpoint 回 200,約 278 MB)。Hugging Face
openai/webgpt_comparisons頁面可開啟,可見檔案是 loader 腳本與 README,由第三方上傳;不要把它當成官方訓練代碼。 - 樣本瀏覽:answer viewer 可開啟(2021-12-16 的 blob)。這是展示頁,不是環境 runtime。
- 程式與模型:沒有官方 GitHub runtime。GPT-3 760M/13B/175B checkpoint 不是一般可下載權重。Bing API、示範 GUI、PPO 訓練迴圈均未隨論文釋出。OpenAI 產品部落格在本次核對回 HTTP 403,本文不把它當成可核對來源,也不把後來的瀏覽產品算進這篇。
- 最小有用 reproduction:讀 Table 1 與 Figure 1b,對一條 ELI5 題手動走 Search → Click → Quote → End: Answer,確認過程中沒有 thought 欄位。不要宣稱這能復現 56% 或 69%。若只用公開 comparisons.jsonl,最多能重訓一個偏好模型,不能重跑瀏覽器政策。
三個記憶點 / Three things to remember
- 技術想法:WebGPT 把 GPT-3 接到文字瀏覽器;改變的是下一步能不能發 search/click/quote,不是權重裡長出 thought,也不是通用 Agent OS。
- 證據:175B best-of-64 對示範者 56%、對 Reddit 69%;拉分的主路徑是 BC + rejection sampling(68% vs BC),不是把 RL 疊上去。
- 邊界:沒有 thought–action–observation 契約;引用可被挑選、也可被改寫錯。需要推理時讀 CoT,需要交錯迴圈時讀 ReAct,不要把後來的搜尋產品寫回這張表。
延伸閱讀
WebGPT 處理的是「要不要用瀏覽器行動來回答」。接下來可依問題選讀:
- 只在 prompt 中寫出推理:讀 CoT。
- 讓 thought 與環境動作交錯:讀 ReAct。
- 方法之間的完整關係:讀 Agent 方法底座閱讀地圖。
閱讀方法見 三遍掃描法。