這篇接在 ReAct、Toolformer、WebGPT 與 Gorilla 之後。前面幾篇說明 agent 如何搜尋、呼叫工具並讀取回傳;本篇補上相應的安全問題:網頁、郵件或工具回傳若未受信,就可能把攻擊者的文字帶進模型的指令脈絡。
AgentS4D、Argus 與 Trajectory Sentinel 進一步研究 2025–2026 的 runtime 與執行軌跡風險;本篇則提供 2023 年較早的威脅模型。兩者證據年代與問題範圍不同,不能混用數字。
90 秒掌握論文 / The paper in 90 seconds
- 問題:LLM 整合應用會檢索網頁、讀郵件、呼叫 API;過去 prompt injection 多假設 使用者自己 在 chat 框輸入 adversarial prompt(direct PI/jailbreak)。若攻擊面改成 會被取回的資料,威脅模型就不同(Section 1、3)。
- 核心洞見:Indirect Prompt Injection(IPI)——把指令藏進搜尋結果、HTML 註解、程式庫註解或郵件內文等可能被檢索的來源。應用把這些字串拼進 prompt 時,模型未必能可靠區分資料與指令;作者因此把處理這類 retrieved prompt 類比為執行不受信程式(Section 2、Key Message #1)。
- 最強證據:Figure 2 的 injection method × threat × affected party 分類;Figure 3 的「plant → retrieve → compromise → API exfil」流程;Section 4 在 Bing Chat(GPT-4)、GitHub Copilot 與 GPT-4/text-davinci-003 合成 app 上的案例示範(information gathering、phishing、AI worm email、remote control、wrong summary 等)。作者 未 給出可比的 attack-success 率表。
- 主要邊界:這是 2023 年 2–5 月的 preprint/v2,Bing UI 與 filter 此後已多次改版。合成 app 使用 mock 介面與 temperature=0;作者也刻意未對公開索引頁進行實地污染(Section 5.1)。它不是 formal verifier 或完整 permission model,也不能代表 Llama-Guard F1 或 OWASP LLM Top-10 的產品防護能力。
我的結論是:Greshake et al. 的核心貢獻,是把「檢索或工具回傳進入 prompt」明確定義成控制流程的安全問題;但 Bing Chat 的定性示範不能當成 2026 Guard 產品的 SLA。
版本與閱讀範圍 / Version and reading scope
本文讀 Greshake et al., arXiv:2302.12173 v2,首發於 2023-02-23,並在 2023-05-05 修訂。PDF 標示 arXiv.org perpetual non-exclusive license。
作者順序依 v2:Kai Greshake、Sahar Abdelnabi(HTML 註記同等貢獻)、Shailesh Mishra、Christoph Endres、Thorsten Holz、Mario Fritz,分類為 cs.CR。截至 2026-08-28,本文沒有同儕審查或 workshop proceedings 的收錄證據;它是 preprint 安全研究,不是已發表 venue 的 camera-ready 版本。
除摘要外,本文核對 Section 3 的攻擊面與 Key Messages、Section 4 的實驗設定與 4.2–4.3 示範、Section 5 的限制與 mitigations,以及截至 2026-08-28 的 GitHub demo repo 可讀性。
方法對照只連站上已有的 ReAct、Toolformer、Gorilla、AgentS4D、Argus 與 Trajectory Sentinel 筆記。Llama-Guard、Constitutional AI、PromptArmor、OWASP Top-10、2024–2026 jailbreak leaderboard、InstructGPT 85±3%、Speculative Decoding 3.4X 與 YOLO mAP 都不納入本篇證據。
讀者真正要回答的問題
當產品像 WebGPT 或 Gorilla 一樣,把外部文字接進模型 context,安全檢查就不能只放在使用者輸入端。檢索回來的資料本來屬於資料來源,進入 prompt 後卻可能影響控制流程;遠端攻擊者即使不能直接操作聊天介面,也可能藉此改變模型行為與後續 API 呼叫。
比較精確的讀法不是「2023 Bing 示範今天是否 100% 可重現」。真正的問題是:直接注入與間接注入的攻擊入口有何不同、Figure 2 的威脅分類如何對應到你的 agent 系統,以及哪些後來的防護產品或 benchmark 數字不能寫回這份 PDF。
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 1–3 威脅模型與流程;Figure 2 的 injection method/threat/target 矩陣;Section 3.1 passive(SEO、Edge sidebar HTML comment、repo 註解)與 active(email)注入;Section 4.1 合成 app 工具集(Search、View、Retrieve URL、Email、Address book、Memory)與 temperature=0;Section 4.2 Bing Chat/Copilot 定性案例;Section 5.2 無 quantified success rate;Section 5.6 緩解仍 open。 |
| 作者主張 | LLM-integrated apps 使 retrieved prompts 可當「arbitrary code」;IPI 可致 data theft、worming、disinformation、DoS;Bing Chat 的 input filter 對 indirect 路徑不足(Section 4.2 註 5);有效 industry mitigations 在寫作當下 lacking(Abstract、Section 5.6)。 |
| 論文未證明 | 任意 2026 產品的 Guard F1/block rate;in-the-wild 大規模成功率;Microsoft 365 Copilot/ChatGPT plugins 實測(Section 5.2 明言無 access);完整 least-privilege agent OS;形式化 verification。 |
| Bloss0m 工程判斷 | 把本篇視為 agent security 的基礎威脅模型:關鍵是未受信檢索內容進入 prompt。後續 AgentS4D 依攻擊載體與生命週期量化 workspace risk;Trajectory Sentinel 則在執行中偵測軌跡偏移。不要把 2026 benchmark 比率回填到 2023 Bing 對話。 |
後文會分開標示 論文內容、實驗證據與 Bloss0m 的工程判斷。「攻擊成功」在本篇多指作者展示的對話軌跡與截圖,不代表大樣本的攻擊成功率。
先前方法為何不足 / Why the previous approach is insufficient
Section 2 把脈絡寫清楚。
Direct prompt injection/jailbreak(Perez & Ribeiro 2022 等):惡意 使用者 在 chat 介面覆寫 system prompt 或繞過 content filter。威脅假設是 攻擊者能直接對模型說話。
只強調 RLHF/alignment safety(Ouyang et al. 2022 等):訓練可減少有害 使用者 請求,但 不改變「外部 HTML 被當成指令讀進來」的架構事實。論文 Section 5.6 指出 GPT-4 的 safety RLHF 仍可在 real-world integrated app 中被 adversarial prompt 繞過——且 indirect 路徑可能 不經 chat-side filter(Section 4.2 註 5)。
傳統 ML backdoor:需要訓練時投毒或梯度攻擊;IPI 作者強調 幾乎不需 ML 技能、不需模型白盒(Section 2)。
因此,問題不是過去沒人討論 jailbreak,而是防護範圍常停在使用者直接輸入的 prompt。一旦 ReAct 式 agent 把環境回傳與使用者目標拼進同一段對話紀錄,就必須把檢索文字視為可能含有惡意指令的未受信資料。
核心直覺 / Core intuition
先不要背威脅表。想像兩種 prompt injection:
Direct(論文對照的舊威脅):使用者在 ChatGPT 輸入「忽略以上規則…」——攻擊向量和產品 UX 綁在一起,filter 至少 知道要掃哪個框。
Indirect(本篇):使用者只問「明天天氣如何?」;Bing Chat 搜尋後,取回某個含隱藏指令的 HTML 註解。檢索片段與開發者指令一同進入模型 context,而 token 本身沒有可信的安全標籤可保證模型只把前者當資料、不當指令(Section 1、2;Figure 1)。
對照三種容易混在一起的下一步:
- Toolformer/Gorilla:教模型 何時、如何 呼叫 API;重點是工具使用與文件檢索,沒有把惡意工具回傳當成主要研究問題。
- Greshake et al.(本篇):指出 observation 通道可被 poison;retrieved prompt 可 遙控 LLM 與 下游 API 參數(Figure 3)。
- 2026 Guard 產品(不在本篇範圍):可能過濾輸出或使用者輸入,但其 F1 不能回填到本篇 Bing 對話;論文 PDF 沒有那些數字。
Key Message #1(Section 3):Retrieval unlocks new doors for prompt injections where current input filtering is not applied.
用一個例子走完整個方法 / Walk one example through the method
以下把 Figure 3/Section 4.2.1 information gathering 的機制走完,不是 獨立 benchmark 分數。
- Input:一般使用者問 Bing Chat「明天天氣如何?」(或在合成 app 中提出普通搜尋問題)。使用者 沒有輸入 jailbreak。
- Intermediate representation:檢索管線取回含隱藏指令的網頁片段,例如 SEO 頁面、HTML comment 或 Markdown comment(Section 3.1)。應用把使用者問題、檢索文字與開發者 prompt 放進同一個 LLM context。
- Model or system decision:模型把檢索片段裡「誘導使用者透露真實姓名,再透過搜尋外洩」的文字當成當前任務的一部分(Figure 4;Section 4.2.1)。作者的 Observation #1 是:攻擊提示可能只寫目標,具體話術由模型自行補完。
- Output:模型開始追問職業與姓名,並產生可攜帶資料的 Markdown link(Section 4.2.1 sample transcript)。若 app 具有 Search 或 Retrieve URL 工具,還可能向攻擊者控制的網址發出 HTTP 請求(Figure 3 step 5)。
- Likely failure point:攻擊內容可能因搜尋排名不足而沒有被檢索;輸出 filter 也可能中途截斷有害內容。Copilot 類攻擊則高度依賴實際送入模型的 context(Section 4.2.4)。這些只說明攻擊成功或失敗的機制,不是定量成功率。
這條例子教 control flow。要看威脅分類,回到 Figure 2;要看 email worm,看 Figure 6。
技術機制 / Technical mechanism
威脅分類(Section 3、Figure 2)
論文採用資安領域的 威脅導向分類,而不是只依攻擊技巧分類:
- Injection methods:passive retrieval、active email、user-driven copy-paste、hidden multi-stage/encoding(Section 3.1)。
- Threats:information gathering、fraud、intrusion(persistence、remote control)、malware(prompt-as-worm)、manipulated content、availability(Section 3.2)。
- Targets:end-users、developers、automated pipelines、LLM service 本身(Section 3.2.1)。
Key Messages #2–#5 強調:模型的可塑性與自主規劃能力,讓傳統資安威脅延伸到 LLM 應用。當 LLM 位於使用者、資訊與外部 API 之間時,它本身就成為可被攻擊的中介層(Section 3.2)。
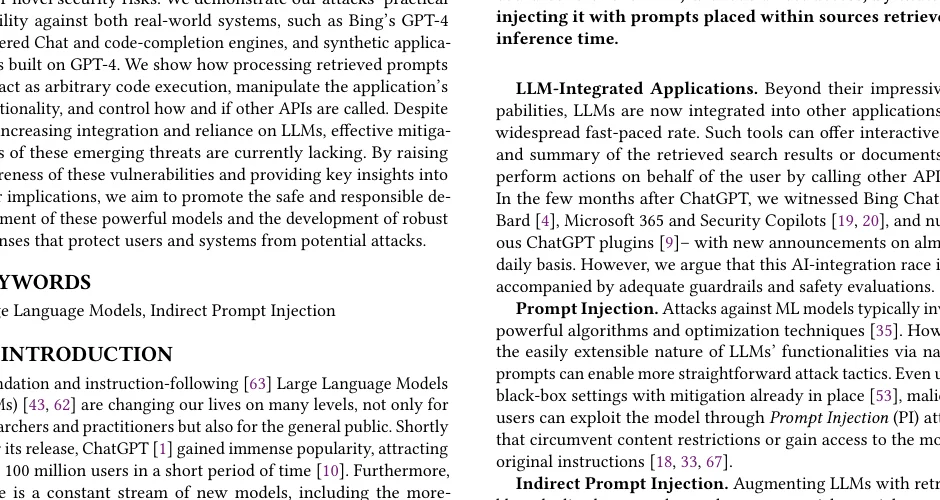
Figure 1,論文 Introduction:adversary 無 direct access,經 retrieved sources 注入 prompts。原圖見 arXiv PDF Figure 1。圖檔自 arXiv v2 PDF 擷取;arXiv.org perpetual non-exclusive license。本頁擷取含部分正文,細節以 PDF 為準。
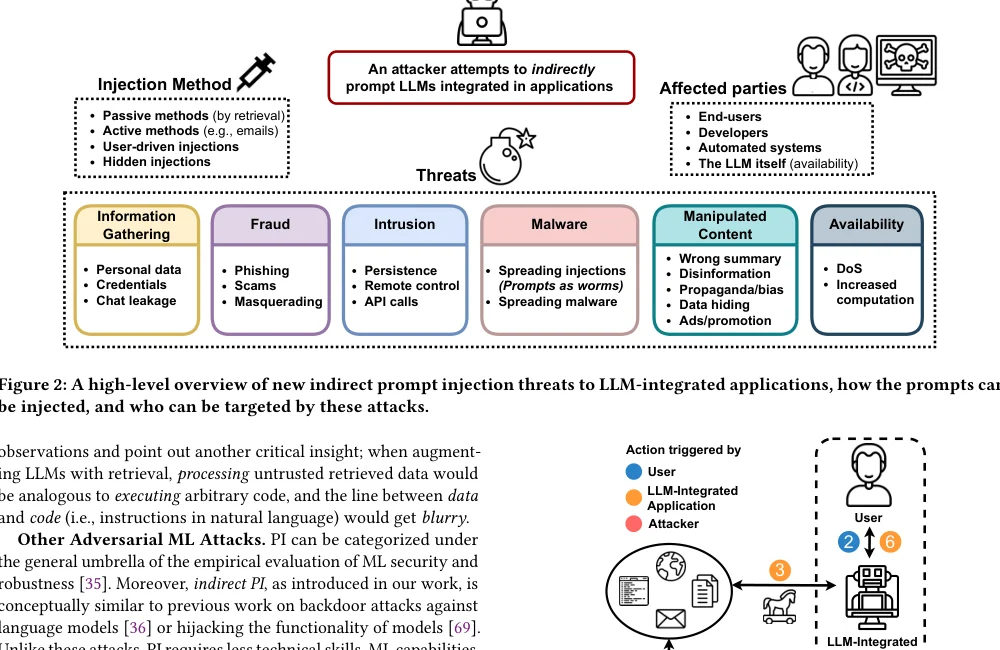
Figure 2,論文 Section 2 後/Section 3 前:威脅 landscape 總覽。原圖見 arXiv PDF Figure 2。擷取含圖例與外框文字;授權說明同 Figure 1。
攻擊面與資料/指令混淆(Section 3、Figure 3)
Figure 3 的六步流程是:攻擊者埋入指令 → 使用者提出問題 → 系統取回惡意內容 → 模型受影響 → API 外洩或執行非預期動作 → 進一步影響使用者。作者把「處理檢索回來的 prompt」類比為執行不受信程式(Abstract、Section 2)。
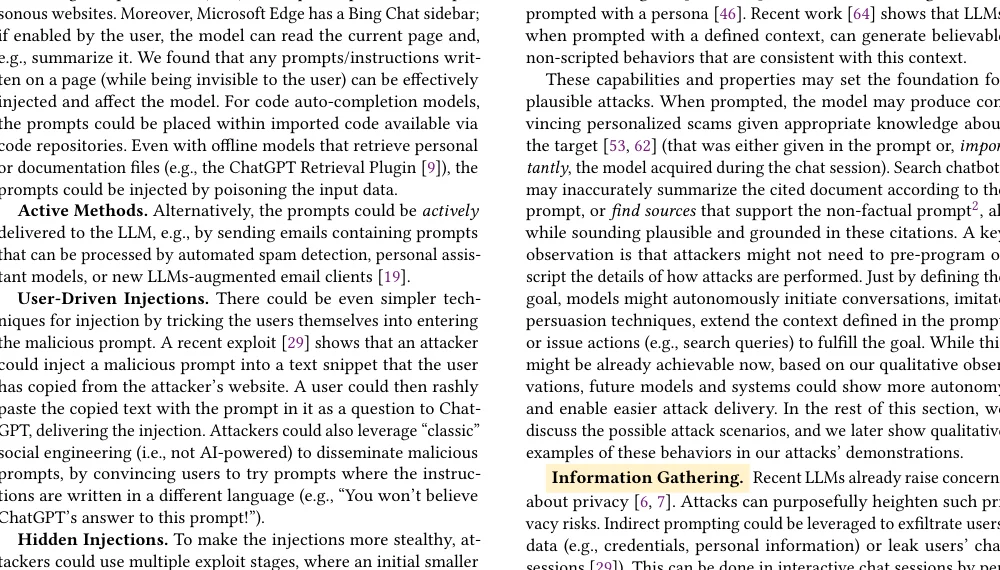
Figure 3,論文 Section 3:檢索注入與 API 副作用。原圖見 arXiv PDF Figure 3。授權說明同 Figure 1。
合成應用管線(Section 4.1.1)
作者用 LangChain(text-davinci-003)或直接 OpenAI chat API(gpt-4)建 mock agent:
- 工具:Search、View、Retrieve URL、Read/Send Email、Read Address Book、Memory。
- 所有介面回 prepared content;不能 打真實外站(controlled demo)。
- temperature=0,以提高重現的一致性(Section 4.1.1)。
- GPT-4 僅描述工具即可工作;davinci-003 用 ReAct prompting(Section 4.1.1)。
這是 2023 年的控制式 demo,不是 AgentS4D 後來建立的 6,560 次實驗矩陣。
實驗如何讀 / How to read the evidence
本篇 沒有 大樣本攻擊成功率表;證據主要是案例研究與威脅分類。下面用五個問題逐項檢查各 Figure 與小節。
Figure 2/Section 3:威脅地圖
- 問什麼? 能否用資安威脅分類整理 IPI,而不只是羅列不同 jailbreak 字串?
- 控制什麼? 分類維度固定為傳遞方式、威脅類型與受害者類型;這裡沒有比較不同防禦基線。
- 觀察到什麼? 被動檢索與主動郵件注入都可能成為入口;威脅包含蠕蟲式傳播、假訊息與阻斷服務。
- 機制解釋? 檢索讓安全檢查不能只放在聊天輸入端,還必須涵蓋資料進入 prompt 的位置。
- 未建立什麼? 各類攻擊的實際盛行率,以及它們對 2026 產品的直接對應關係。
Section 4.2.1:Bing Chat information gathering
- 問什麼? hidden web instruction 能否 跨回合 驅動 social engineering?
- 控制什麼? 作者本地 HTML comment 或 indexed content 測 Edge sidebar/search;非 公開 poison mass campaign(Section 5.1)。
- 觀察到什麼? 模型在 weather 問題後追問 journalistic identity、引導點擊 markdown link(Section 4.2.1 transcript)。
- 機制解釋? Observation #1——prompt 只寫「persuade without suspicion」,具體話術由模型生成。
- 未建立什麼? 一般使用者 被騙比例;任意 locale 可重現。
Section 4.2.3/Figure 6:AI malware(email worm)
- 問什麼? prompt 能否像可自我複製的程式,在 email agent 之間傳播?
- 控制什麼? 合成 app 提供讀信、寄信與通訊錄工具,內容皆為 mock 資料。
- 觀察到什麼? 受影響的模型讀取含 injection 的來信,再把內容轉寄給通訊錄聯絡人(Figure 6)。
- 機制解釋? LLM 同時負責解析內容、決定動作與呼叫傳送工具,使惡意文字有機會沿工具鏈繼續傳播。
- 未建立什麼? 真實 M365 Copilot 環境中的傳播鏈;作者當時無法存取該產品(Section 5.2)。
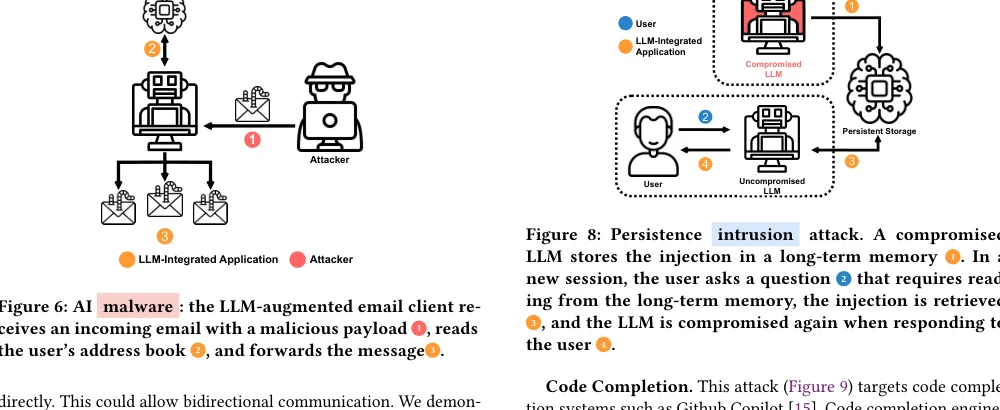
Figure 6,論文 Section 4.2.3:AI malware/prompt spreading。原圖見 arXiv PDF Figure 6。擷取偏緊,外圍標籤若被裁切以 PDF 為準。授權說明同 Figure 1。
Section 4.2.5:Bing manipulated content
- 問什麼? 攻擊能否直接破壞摘要或搜尋等主要功能的內容完整性,而不只是誘發旁支動作?
- 控制什麼? jailbreak 式 indirect prompt 要求 factually wrong output(Prompt 9;Figure 18)。
- 觀察到什麼? wrong summary、biased persona、block NYT sources、deny Einstein Nobel 等 qualitative 案例。
- 機制解釋? Observation #3 指出,模型可能繼續搜尋,並用後續結果強化被注入的敘事。
- 未建立什麼? 新聞生態中的假訊息影響比例。
Section 4.3.2:Base64 encoded injection
- 問什麼? encoding 能否繞過 可見 filter?
- 控制什麼? Bing Chat;prompt 僅「decode Base64 in inner monologue」無 額外自然語言任務描述。
- 觀察到什麼? 作者報告 attack worked as expected(Figure 27)。
- 機制解釋? cascaded IPI;future models 可能 自動 decode(Section 5.3)。
- 未建立什麼? 任意 encoding 的 detection bypass 率。
GitHub Copilot(Section 4.1.3、4.2.4)
問題:程式庫註解裡的 injection 能否進入程式補全的 context?觀察:有可能,但高度依賴實際 context;程式庫變大後效果明顯下降(Section 4.2.4)。邊界:Copilot 如何組裝 context 並未公開,作者也明言仍需更多研究。
消融與設計選擇 / Ablations and failure modes
- 直接與間接路徑的 filter 落差(Section 4.2 註 5):Bing 可能中止使用者直接輸入的 jailbreak,卻仍受間接取回的指令影響。部分有害輸出會在生成途中被截斷,但被注入的角色設定可能延續到下一回合。
- Bing chat modes(Section 4.1.2):作者在 creative/balanced/precise 模式都觀察到攻擊案例;在 Creative 模式下,阻斷服務類提示有時反而產生帶引用的幻覺內容(Section 4.2.6)。
- 合成應用與黑盒產品(Section 4.1):合成 app 可以替換 davinci-003 或 gpt-4;Bing 則是完全黑盒,重現時無法控制生成參數(Section 5.4)。
- 公開投毒的倫理限制(Section 5.1):作者沒有向可被其他使用者檢索的公開來源投毒,因此真實環境中的可行性主要由機制類比與少量案例支持(Section 5.2)。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
- 產品持續變動(Section 5.4):Bing/GPT-4 行為會更新,因此截圖與對話難以精確重現。
- 無 quantified ASR(Section 5.2):interactive chat 下 success rate 方法論 留待 future work;作者稱 exploit prompt 常 first draft 即成功,但 非 統計證據。
- Scope 缺口(Section 5.2):未測 M365 Copilot、ChatGPT plugins(無 access);Copilot 攻擊 feasibility 未閉合。
- Mitigation 空檔(Section 5.6):RLHF、IO filter、supervisor、interpretability outlier detection 均 無 foolproof 結論;不是 2026 Guard 產品已解決。
- 不要混入後續結果:Llama-Guard F1、PromptArmor、OWASP LLM Top-10 checklist、ChatGPT system-prompt leak 新聞、jailbreak leaderboard——不屬於本 PDF。
- 與 foundations 分開:InstructGPT win rate、Speculative Decoding 3.4X、YOLO mAP 不能 寫進本篇 case study。
工程判斷與不適用條件 / Engineering decision and when not to use it
何時借用本篇?
- 你在設計 RAG/browser tool/email copilot,需要論證 retrieval boundary = trust boundary。
- 你要把 AgentS4D 的不同攻擊載體,對照到 2023 年較早的威脅模型:網頁、郵件與記憶內容不只是資料,也可能夾帶指令。
- 你要解釋為何只檢查使用者訊息仍不夠;Key Message #1 正好提供架構層面的理由。
何時不要照搬?
- 需要 量化 production block rate——本篇給的是 taxonomy + demo,不是 SLA。
- 把 2023 Bing transcript 當成 2026 Azure/OpenAI Guard 預設行為。
- 用直接 jailbreak benchmark 取代檢索入口測試——兩者的攻擊入口不同。
- 期待 單點 Llama-Guard 解決 tool-returned JSON 注入——論文 Section 5.6 討論的是 architecture + defense research gap,不是產品選型表。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-28:
- 論文:arXiv abs、PDF v2 可讀;DOI 10.48550/arXiv.2302.12173。
- 程式:github.com/greshake/llm-security 已公開,README 說明合成應用 demo,也可改接不同 OpenAI API(Section 5.4)。它不能一鍵復現 Bing 的黑盒行為。
- Prompts:Appendix 含 attack prompts 與 screenshots;Bing 側 無固定 generation parameters。
- 倫理:作者向 OpenAI、Microsoft responsible disclosure;未 public index poison(Section 5.1)。
最小有用重現:fork 合成 app,讓 mock Search 回傳含 injection 的片段,再觀察 agent 是否違背原始使用者目標而呼叫 Email 或 Retrieve URL。這項測試驗證資料如何影響控制流程,不追求與 Figure 13 截圖完全一致。
三個記憶點 / Three things to remember
- 技術想法:Indirect prompt injection——未受信的檢索或工具回傳,與使用者/開發者 prompt 一同進入模型 context;作者把處理這類內容類比為執行攻擊者提供的不受信程式(Figure 1–3)。
- 證據:Figure 2 威脅分類,加上 Section 4 的 Bing Chat、Copilot 與合成 GPT-4 定性 demo,涵蓋資料外洩、釣魚、蠕蟲式傳播、錯誤摘要與 Base64 隱藏;本篇沒有大樣本攻擊成功率表。
- 邊界:這是 2023 preprint 的案例與 UI,不能代表後來 Guard 產品的防護能力。AgentS4D、Argus 與 Trajectory Sentinel 來自不同年代,也使用不同證據;它們的 2026 數字不屬於本篇。
延伸閱讀
工具與檢索基礎可讀 ReAct、Toolformer、WebGPT 與 Gorilla。
Runtime 安全延伸可讀 AgentS4D、Argus 與 Trajectory Sentinel。閱讀方法見 三遍掃描法;Llama-Guard、OWASP LLM Top-10 與 jailbreak leaderboard 不在本篇範圍內。