若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:語言模型在算術、事實查找、低資源語言與時間意識上明顯弱於更小的專用系統;當時的工具使用要嘛靠大量人工標註,要嘛綁在「已經知道該用哪個工具」的 task-specific few-shot。
- 核心洞見:把 API 呼叫插進 next-token 預測。少量人類示範只負責教格式;要不要留下這次呼叫,由「加上呼叫與結果後,未來 token 損失有沒有下降」決定。改動的控制點不是 thought–action 迴圈,而是何時把一次 API 呼叫寫進語言模型的訓練字串。
- 最強證據:同一套 GPT-J 6.7B、zero-shot。LAMA 的 SQuAD/Google-RE/T-REx 從 17.8/4.9/31.9 升到 33.8/11.5/53.5,並超過 OPT-66B 與 GPT-3-175B;數學 ASDiv/SVAMP/MAWPS 從 7.5/5.2/9.9 升到 40.4/29.4/44.0。QA 與計算機幾乎總是被選中(約 98.1%/97.9%)。
- 主要邊界:關掉 QA 工具後,Wikipedia 搜尋仍追不上 GPT-3。作者限制是不能串工具、不能互動翻搜尋結果、用詞敏感、評測最多一次 API 呼叫、計算機樣本極少、不計工具成本。這不是 production agent runtime。
我的結論是:Toolformer 最值得保留的貢獻,是用語言模型損失篩選有用的 API 呼叫,形成自監督的工具訓練資料。它只處理 next-token 序列中的單次呼叫,不能直接視為今日的多步 Agent 迴圈。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Schick et al., NeurIPS 2023 對應的 arXiv:2302.04761 v1,提交於 2023-02-09,且僅有此 arXiv 版本。
除摘要外,本文核對 Section 2 的採樣/執行/過濾/finetune、Section 3 的五個工具、Section 4 的各項實驗、Section 5 的解碼 與 Table 10、Section 7 的限制,以及 Appendix A–D。
截至 2026-08-27,arXiv HTML、NeurIPS PDF 與 Meta 研究頁 可開啟,但沒有官方程式碼;https://github.com/facebookresearch/toolformer 回傳 404。
這是已發表的 NeurIPS 論文,不是 preprint。arXiv v1 作者列為八人;NeurIPS 議事錄多了 Eric Hambro。正文數字以 arXiv v1 為準,並與 NeurIPS 合併表中的 LAMA/數學列交叉核對。它也不是一份 runtime 規格。
讀者真正要回答的問題
當語言模型算術不准、事實會幻覺時,應不應該先做一個會多步搜尋、改寫 query、串工具的 Agent?Toolformer 的回答比較窄:先問下一個 token 需不需要一次 API 結果。
比較精確的讀法不是「Toolformer 是不是比 GPT-3 強」,因為 Table 5 在開放 QA 上並非如此。真正的問題是:把工具使用從「人先示範這題該怎麼呼叫」改成「語言模型自己用未來損失過濾呼叫」之後,6.7B 模型能在哪些單次工具任務上追上更大的模型,又會在哪裡因為不能串接、不能翻搜尋結果、或評測只准一次呼叫而停住?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Section 2 用 過濾 API 呼叫;Table 3–8 給出 GPT-J/GPT-J+CC/Toolformer/disabled/OPT-66B/GPT-3-175B 的 zero-shot 數字;Figure 4 顯示約 775M 才明顯會用 API;Section 7 列出不能串接、不能互動搜尋、用詞敏感、計算機樣本少、不計成本。 |
| 作者主張 | 自監督工具使用不需要大量人工標註,也不必綁死任務;學會工具後不必犧牲語言建模能力。 |
| 論文未證明 | next-token 工具使用不是可部署 Agent runtime;單次 API 插入不是 ReAct 多步 thought–action–observation;沒有官方訓練代碼或 GPT-J+CCNet 的 可重跑 Table 3。 |
| Bloss0m 工程判斷 | 把 Toolformer 當成訓練側的工具監督方法。MidTool 進一步處理工具 affordance、schema 與恢復能力;ReAct 則在 prompt 中交錯 thought 與 action。模型能輸出 [QA(...)],不代表系統已具備工具治理。 |
後文把數字、作者 claim 與工程判讀分開。「提升」只指論文報告的 setup。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2022 年的兩條線寫得很清楚。
大量人工標註的工具使用:BlenderBot、LaMDA、WebGPT 這類工作能搜尋或瀏覽,但依賴昂貴的人類示範。作者還指出一個更刺的問題:人覺得有用的呼叫,未必是模型預測下一個 token 時真正需要的呼叫。
綁死任務的 few-shot 工具使用:PAL、TALM,以及同時間的 ReAct(論文 Related Work 引為 Yao et al., 2022),通常預先知道這題該用計算機、搜尋或 Wikipedia 三動作,再在 prompt 裡示範怎麼用。這沒有回答「模型能不能自己決定何時用哪個工具」,也沒有把工具使用接回原本的語言模型訓練分布。
因此,舊方法不夠的地方不是「模型不夠大」,而是監督訊號被放錯位置:要嘛監督來自人類,要嘛來自已經知道答案形態的 task prompt。Toolformer 改的正是這個控制點:示範只教 API 語法,留下與否由未來 token 損失決定。
核心直覺 / Core intuition
先不要看公式。想像你在補完一句話:「尼羅河大約長 _____ 公里。」你可以猜一個數字,也可以先問一本會查事實的書。Toolformer 的判斷很刻薄:只有當「書的答案」真的讓「6,853」比較容易接著寫出來時,這次查詢才准留下來。若你問的是「尼羅河流經哪些國家」,即使答案正確,對補完「長度」也沒幫助,這次呼叫就丟掉。
這與 ReAct 不同。ReAct 的下一步可以是 thought(只更新 context)或環境動作(換 observation),而且可以多步。Toolformer 的下一步仍是下一個 token;API 呼叫只是被插進這條 token 序列的特殊子字串。環境不是一個可瀏覽的 agent 世界,而是一次函數呼叫。
對照站內後續工作:
- ReAct 改的是 prompt 裡合不合法的下一步。
- Toolformer 改的是 訓練字串裡要不要插入一次 API。
- MidTool 把工具 affordance 再提前到 mid-training 語料;它繼承的是「訓練側先教會用工具」,不是 Toolformer 的單次損失過濾器本身。
用一個例子走完整個方法 / Walk one example through the method
以下把 Figure 2 的 Pittsburgh 示意,與 Table 10 的 Nile 過濾分數合在一起走完。Pittsburgh 是論文自己的方法圖;Nile 是 CCNet 上被留下來的真實風格例子。兩者都不是獨立實驗分數。
- Input:一段普通語言模型文本,例如
Pittsburgh is also known as the Steel City,或 Table 10 的The Nile has an approximate length of 6,853 kilometers...。還沒有工具、也沒有 agent 狀態。資料來自 CCNet 子集;計算機等工具還會先用啟發式(至少三個數字、出現equals等)縮小要標註的文件。 - Intermediate representation:用少量人類寫的 prompt (Figure 3/Appendix A.2)讓同一個 GPT-J 在每個位置 估計「這裡該不該開始一次 API 呼叫」。超過門檻 的位置最多留 個,每個位置再採樣最多 個候選。Pittsburgh 例子裡,一個候選問「Pittsburgh 還叫什麼」,另一個問「Pittsburgh 在哪個國家」。
- Model or system decision:真的執行 API。QA 用 Atlas(標註時 Atlas-large,推論時 Atlas-xxl,且 Atlas 在 Natural Questions 上 finetune 過);計算機是只含
+ - * /的 Python;Wikipedia 是 KILT dump 上的 BM25;翻譯是 NLLB-600M;日曆在訓練時用 URL 日期近似文件建立日。然後比較兩個損失: 是把e(c,r)(呼叫加上結果)當 prefix 時,後面 token 的加權交叉熵; 是「完全不呼叫」與「呼叫但不給結果」兩者的較小值。只有 才留下。Figure 2 裡,「Steel City」那次留下,「United States」那次丟掉,因為後者幫不上the Steel City。Table 10 裡 Nile 的 QA 得到 ,標成有用;Calculator(85 / 23)得到 ,標成無用——那句「23% were hospitalised」並不是要你做 85÷23。 - Output:留下的呼叫寫回原句,得到 ,全部合併成 ,再用標準語言模型目標 finetune GPT-J。推論時一般解碼,直到模型產出
→(實作是->),就中斷、呼叫 API、把結果與結束符插回去再繼續。評測另外把「開始呼叫」的 token 放寬到 top-,且每個輸入最多一次 API 呼叫,避免模型陷入一直呼叫、不寫答案。 - Likely failure point:問錯問題仍可能過過濾器(Table 10 的
WikiSearch(Fast train success)分數 ,作者標無用但仍降了 perplexity);日曆加 QA 這種需要串接的題,訓練裡根本沒有(TempLAMA 上日曆只用了 0.2%);搜尋結果差也不能改寫 query。Section 7 還寫模型對輸入用詞很敏感。
同一個 Table 10 也說明:高分通常看起來「直觀有用」,低分通常沒有提供預測後面 token 的資訊。作者認為 裡留一點噪音,反而能避免 finetune 後盲從每一次呼叫。
技術機制 / Technical mechanism
Section 2 把每次 API 寫成 : 是工具名, 是字串輸入。線性化不改詞表,只用既有 token 假裝特殊符號:
實作上 、 、→ 分別是 [、]、->。把呼叫插進文本,模型不必長出新詞。
對 ,先算每個位置開始呼叫的機率 ,再採樣、執行、過濾。過濾用的是加權未來損失:
權重在大約五個 token 後掉到 0,強迫呼叫發生在「資訊真正被用到」的附近。 把 當 prefix 而不是插在句中,因為還沒 finetune 的 若在句子中間插入從未見過的 API 字串,會打斷 pretraining 分布、反而傷害 perplexity。 取「空 prefix」與「有呼叫無結果」的較小值,是為了丟掉那些「模型只是喜歡寫 API 格式、結果沒幫忙」的呼叫。
、 依工具而設。預設 、;計算機與翻譯因啟發式後資料少,改 、、、。Table 2 在 時:QA 18,526、Wikipedia 60,974、計算機 994、日曆 20,587、翻譯 1,034。計算機特別少,對應 Section 7 的 sample-inefficient。Appendix B:每個 API 最多用 25k 筆,所以 Wikipedia/日曆還會再裁;batch 128、lr 、最長 1,024、最多 2k step;8 張 A100 40GB、BF16、DeepSpeed ZeRO-3。
五個工具的介面(Table 1/Section 3)全部是「文字進、文字出」:
| API | 做什麼 | 不能做什麼 |
|---|---|---|
| QA(Atlas) | 答簡單 factoid | LAMA 實驗關掉 Wikipedia;下游 QA 實驗關掉 QA 本身,以免 Atlas 在 NQ 上的訓練讓任務變trivial |
| Wikipedia Search(BM25/KILT) | 回短 snippet,模型自己抽 | 不是 dense retriever,也不能翻下一頁 |
| Calculator | 四則運算,結果四捨五入到兩位 | 非法算式不回傳 |
| Calendar | 無輸入,回今天日期 | 訓練時用 URL 日期近似;不能接著把日期餵給別的工具 |
| MT(NLLB) | 任意語言 → 英文 | 目標語言固定英文 |
推論時的 Toolformer 不是 chat runtime:它只是在生成中碰到 -> 就插入一次結果。評測還加了兩個工程旋鈕——top-10 鼓勵呼叫、每題最多一次——Section 5/Table 9 顯示這不是小事。
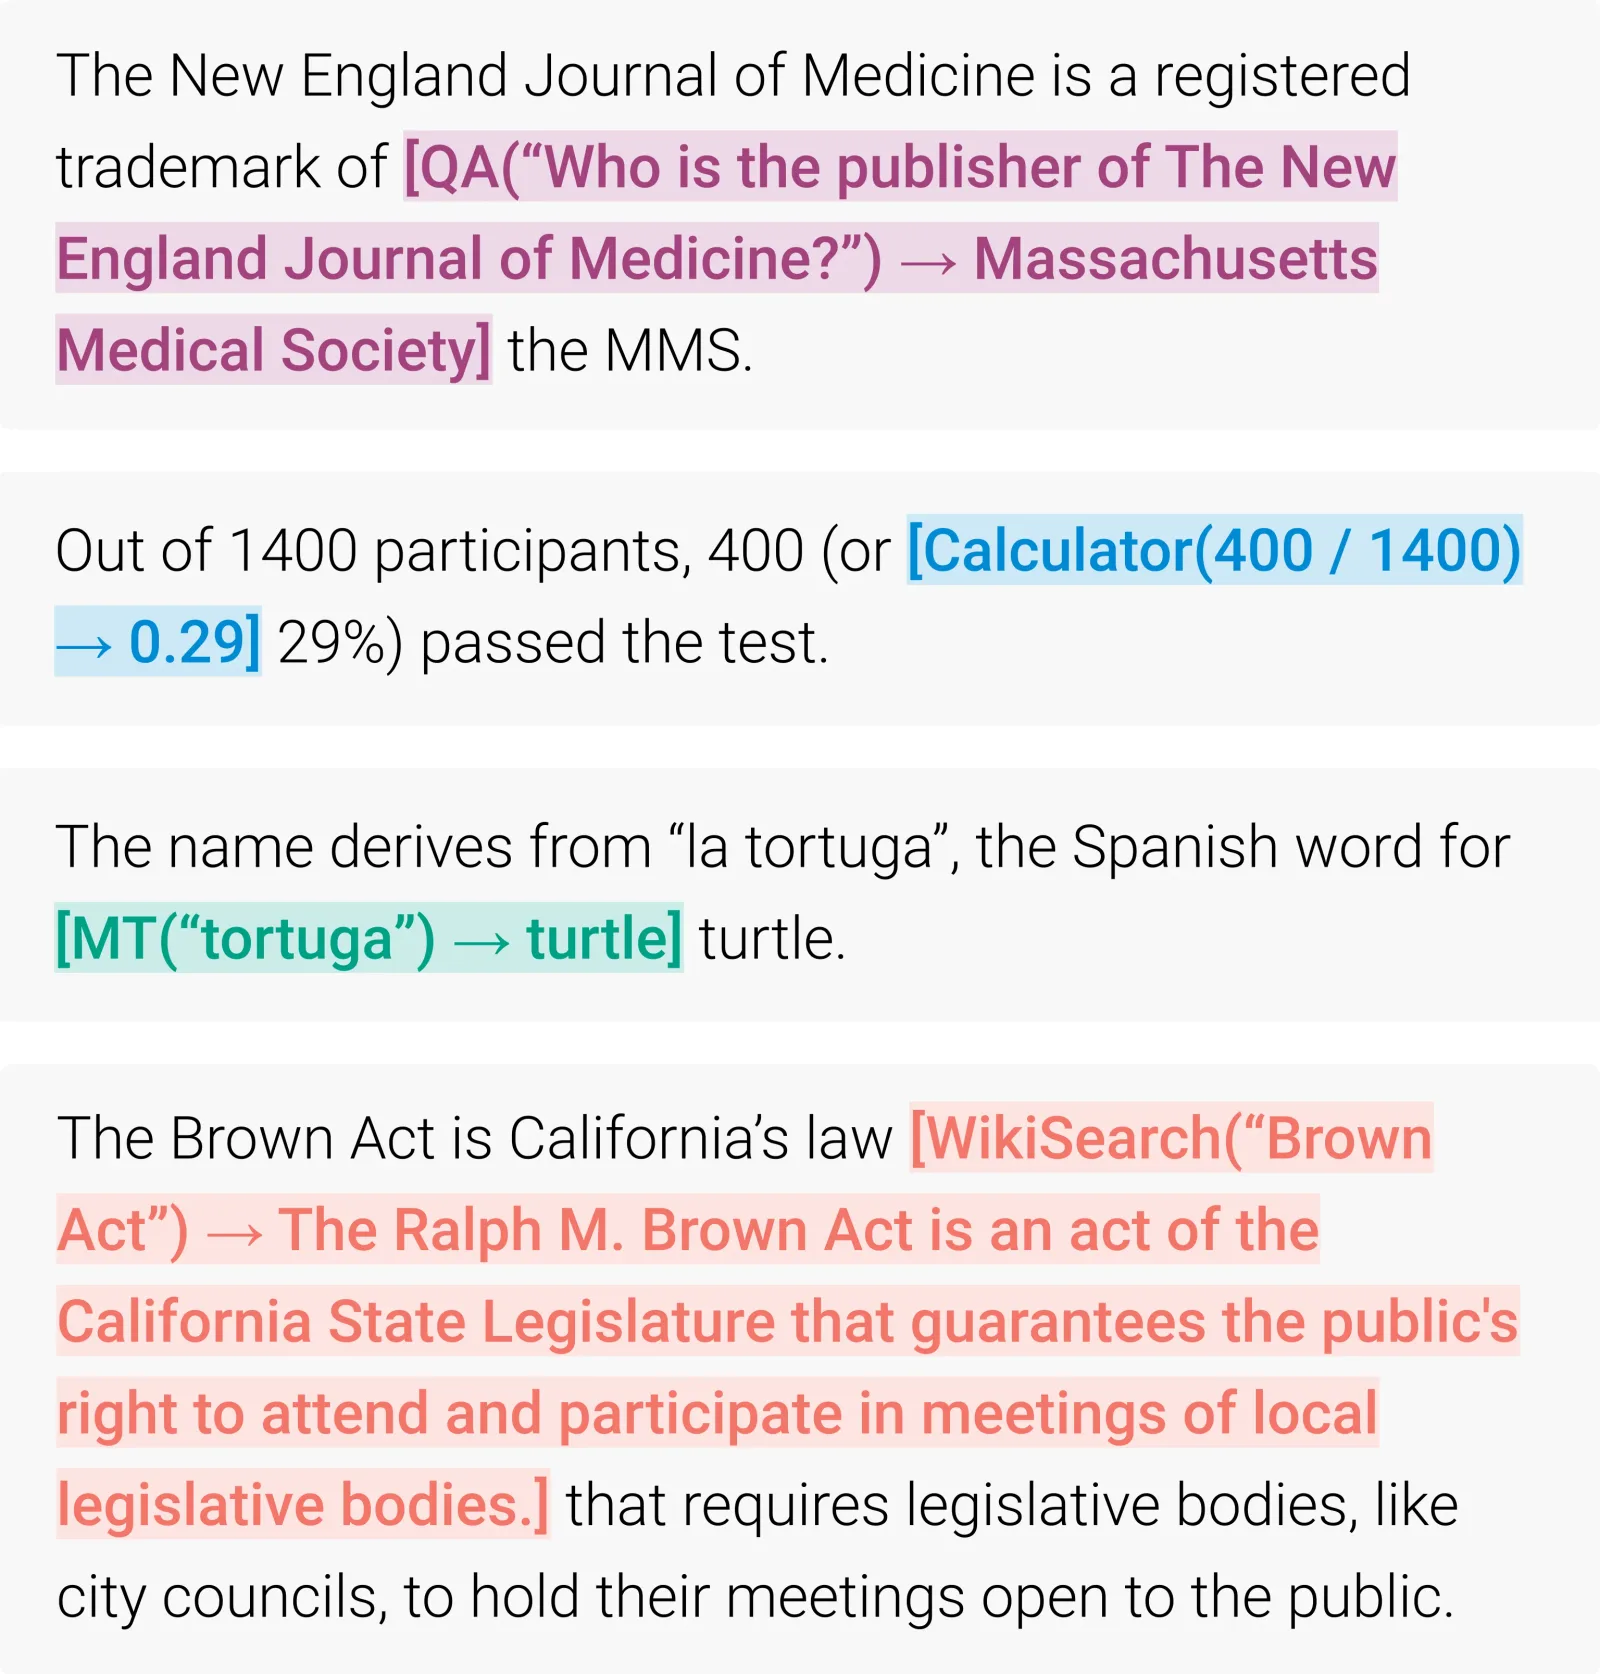
Figure 1,論文 Section 1:由上到下分別是 QA、計算機、機器翻譯與 Wikipedia search。這張圖教的是「API 被寫進 next-token 字串長什麼樣子」,不是 benchmark 分數。原圖可定位到 Figure 1,SVG endpoint 為 example.svg。取自 arXiv HTML;頁面標示 arXiv.org perpetual non-exclusive license,依 arXiv reuse terms 使用並保留 attribution。

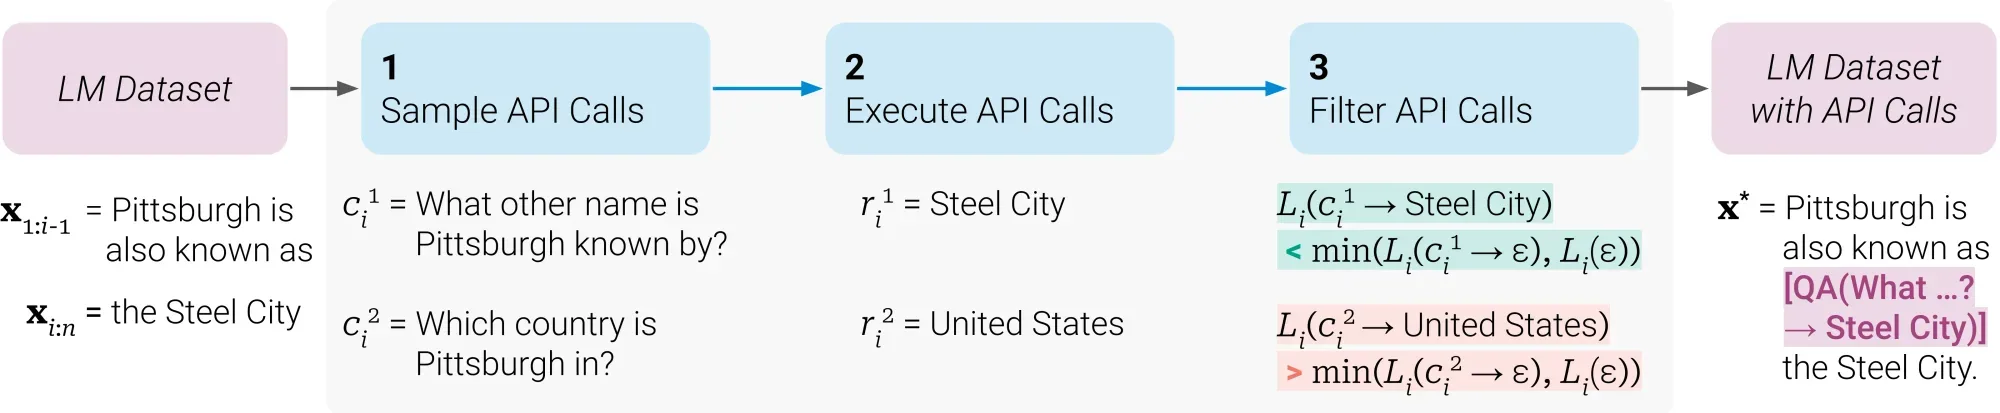
Figure 2,論文 Section 1:同一句 Pittsburgh is also known as the Steel City,問「還叫什麼」的呼叫留下,問「在哪個國家」的呼叫丟掉。原圖可定位到 Figure 2,SVG 為 approach.svg。取自 arXiv HTML;頁面標示 arXiv.org perpetual non-exclusive license,依 arXiv reuse terms 使用並保留 attribution。

實驗如何讀 / How to read the evidence
共同協議(Section 4.2)比單一分數重要。全部是 prompted zero-shot:有自然語言指令,沒有「這題該怎麼呼叫工具」的 in-context 示範。這與 PAL/ReAct 式 few-shot 工具使用不同。解碼主結果是 greedy,但 Toolformer 把開始呼叫的 token 放寬到 top-10,且每題最多一次 API。指標刻意放寬:LAMA 看正確詞是否出現在前五個詞;數學看第一個數字(若輸出算式則看 = 後的第一個數字);開放 QA 看前 20 詞是否包含答案。GPT-3 是原始 davinci,不是 instruction-tuned 變體。
對照組固定為:未 finetune 的 GPT-J、在沒有 API 的 上 finetune 的 GPT-J+CC、在 上 finetune 的 Toolformer、同一權重但推論禁止呼叫的 Toolformer (disabled),以及大約大 10 倍/25 倍的 OPT-66B 與 GPT-3-175B。
Table 3:LAMA 上,單次 QA 呼叫讓 6.7B 超過 175B
這張表問:在「補完 Wikipedia 風格陳述、且不讓模型用 Wikipedia search」時,自監督 QA 呼叫能不能勝過只靠參數記憶?控制住的是 GPT-J 家族與 zero-shot 指令;改的是要不要插入 Atlas 結果。LAMA 原本為 mask LM 設計,作者刪掉 mask 不在句尾的例子。
| Model | SQuAD | Google-RE | T-REx |
|---|---|---|---|
| GPT-J | 17.8 | 4.9 | 31.9 |
| GPT-J + CC | 19.2 | 5.6 | 33.2 |
| Toolformer (disabled) | 22.1 | 6.3 | 34.9 |
| Toolformer | 33.8 | 11.5 | 53.5 |
| OPT (66B) | 21.6 | 2.9 | 30.1 |
| GPT-3 (175B) | 26.8 | 7.0 | 39.8 |
觀察:三個 GPT-J 無工具列差不多;Toolformer 比最佳同尺寸基線高 11.7/5.2/18.6 點,也高於 OPT 與 GPT-3。作者寫 QA 工具用在 98.1% 例子,其他工具 0.7%,完全不用 1.2%。disabled 略高於 GPT-J+CC,說明 finetune 在 API 資料上對記憶也有一點幫助,但主效果仍是真的呼叫。
這張表支持「單次 factoid QA 插入能讓小模型在 LAMA 寬鬆指標上超過更大的無工具模型」。它不支持「Toolformer 已經是更好的知識庫」:指標是前五詞命中,Wikipedia search 被關掉,Atlas 本身是另一個 retrieval-augmented 模型。
Table 4:數學上,計算機幾乎被總是叫出來
問的是:zero-shot 數學應用題上,四則計算機能不能補 GPT-J 的算術缺口?指標是第一個數字,不是完整推理鍊。
| Model | ASDiv | SVAMP | MAWPS |
|---|---|---|---|
| GPT-J | 7.5 | 5.2 | 9.9 |
| GPT-J + CC | 9.6 | 5.0 | 9.3 |
| Toolformer (disabled) | 14.8 | 6.3 | 15.0 |
| Toolformer | 40.4 | 29.4 | 44.0 |
| OPT (66B) | 6.0 | 4.9 | 7.9 |
| GPT-3 (175B) | 14.0 | 10.0 | 19.8 |
允許 API 後分數超過翻倍,且 97.9% 例子呼叫計算機;disabled 已高於 GPT-J,作者猜測是 finetune 看過許多「算式→結果」對。這支持「把計算機插進 next-token 對這三個基準有效」。它不支持「數學推理已解決」:沒有多步程式、沒有單位換算工具,計算機 API 也只有四則。
Table 5:開放 QA 是論文自己留下的反面
問的是:關掉 QA 工具、只准 Wikipedia BM25 時,6.7B 能不能追上 GPT-3?作者關掉 QA,是因為 Atlas 在 Natural Questions 上 finetune 過,否則 NQ 會變 trivial。
| Model | WebQS | NQ | TriviaQA |
|---|---|---|---|
| GPT-J | 18.5 | 12.8 | 43.9 |
| GPT-J + CC | 18.4 | 12.2 | 45.6 |
| Toolformer (disabled) | 18.9 | 12.6 | 46.7 |
| Toolformer | 26.3 | 17.7 | 48.8 |
| OPT (66B) | 18.6 | 11.4 | 45.7 |
| GPT-3 (175B) | 29.0 | 22.6 | 65.9 |
Toolformer 高於所有 GPT-J 列,Wikipedia search 用在 99.3% 例子,但仍低於 GPT-3 的 29.0/22.6/65.9。作者把原因寫成兩件事:BM25 常常回不相關片段;模型不能互動——不能改寫 query、也不能翻 top 結果。這正是 Section 7 的邊界,不是表格註腳。
這張表支持「單次 Wikipedia snippet 對同尺寸模型有幫助」。它不支持「Toolformer 已勝過大規模語言模型的開放 QA」,也不支持把它接上現代搜尋 agent。
Table 6–8 與 Figure 4:翻譯有幫助、日曆不能串、perplexity 沒壞、能力大約在 775M 才出現
MLQA(Table 6)上,翻譯工具在多數語言用 63.8%–94.9%(Hindi 只有 7.3%),有 API 比 disabled 好;但 CCNet finetune 本身傷害部分語言,Toolformer 並未穩定超過 原始 GPT-J。OPT/GPT-3 很弱,作者觀察它們常沒依指令用英文作答。
時間任務(Table 7):Dateset 上日曆用 54.8%,27.3 vs GPT-J 3.9,這才是日曆 API 的證據。TempLAMA 16.3 vs GPT-J 13.7,但日曆只用 0.2%,主因是 Wikipedia/QA;「先查今天、再問誰為哪隊效力」需要串接,而訓練裡呼叫是獨立採樣的,評測又只准一次。
語言模型(Table 8):API 關掉後,WikiText/CCNet perplexity 與 GPT-J+CC 同為 10.3/10.5,沒有因為學工具而變差。作者不報「開啟 API 的 perplexity」,因為要對所有可能呼叫邊際化。
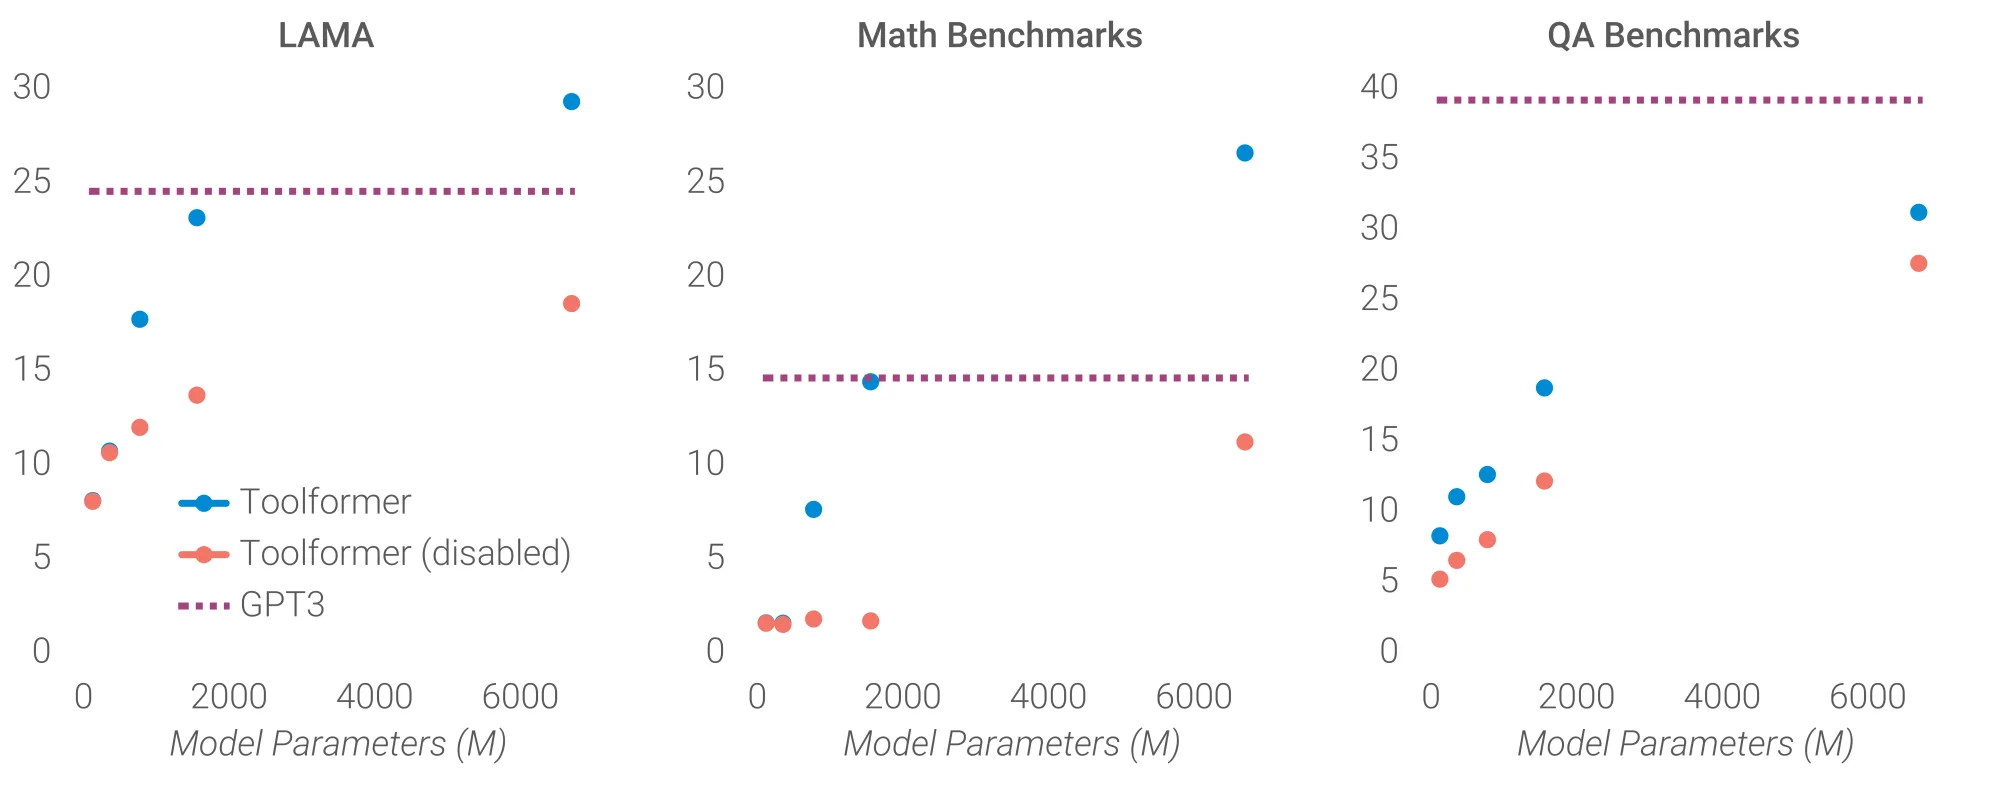
Figure 4,論文 Section 4.4:平均表現來自 LAMA、數學與 QA。API 對最小模型幾乎沒幫助,大約 775M 才開始會用;即使到 GPT-J,有/無 API 的差距仍大。例外是 Wikipedia search,作者認為這個 API 比較好用。原圖可定位到 Figure 4,SVG 為 scaling_laws.svg。取自 arXiv HTML;頁面標示 arXiv.org perpetual non-exclusive license,依 arXiv reuse terms 使用並保留 attribution。

Table 9:headline 數字依賴 ,不是純 greedy
T-REx 上 (真 greedy)已從 34.9 升到 47.8,呼叫率 40.3%; 才到 53.5,呼叫率 98.1%。WebQS 上 幾乎沒叫(8.5%,整體 19.3,接近 disabled 的 18.9); 才跳到 26.3(呼叫率 99.3%),與 的 26.3/100% 相同。作者還觀察 時模型有一點校準:不呼叫的子集(44.3/19.9)比全面禁止呼叫(34.9/18.9)更好;提高 後這份校準消失。
因此,Table 3/5 的「幾乎總是用工具」是解碼旋鈕與過濾器一起造成的,不是模型在 greedy 下自然學會的唯一行為。
限制、威脅與不該過度推導的話 / Limitations and threats to validity
Section 7 的作者限制已經可直接當工程清單:
- 不能串工具。 各 API 的呼叫獨立採樣,finetune 資料沒有「用一個工具的輸出當另一個輸入」。
- 不能互動使用搜尋。 不能翻數百筆結果,也不能像 WebGPT 那樣改寫 query。
- 對用詞敏感。 要不要呼叫,常隨輸入措辭改變。
- 評測最多一次 API 呼叫。 這是為了避免迴圈,不是產品上限的證明,但也讓 Table 3–5 不能代表多步工具使用。
- 計算機極耗樣本。 處理超過一百萬文件,最後只有幾千筆有用呼叫。
- 不計工具成本。 決定呼叫時不看延遲、計費或副作用。
另外幾條是讀表時必須留下的邊界:
- LAMA/數學的「贏過 GPT-3」用的是寬鬆指標與幾乎總是呼叫專用工具;開放 QA 用同一套方法就輸給 GPT-3。
- Atlas 與 NLLB 本身是外部模型;Toolformer 學的是何時呼叫它們,不是把檢索或翻譯能力內化。
- Figure 4 的 775M 門檻只在 QA/計算機/Wikipedia 三個工具、GPT-2 家族上成立。
- 沒有官方 、沒有官方訓練腳本;第三方 GitHub 實作不能替代 Table 3。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 Toolformer?當你已經有文字進、文字出的工具,且真正缺的是 「何時插入一次結果」的監督,而不是多步規劃。這時應記錄:候選呼叫、是否留下、留下是因為 過門檻,以及推論時最多幾次呼叫。適合的原型是計算機、匯率、單次文件查找——一次結果就能改變後面幾個 token。
什麼時候不要把這篇論文當成施工圖?
- 需要多步 thought–action–observation、改寫 query 或例外處理時,讀 ReAct。那是 prompting 迴圈,不是這篇的損失過濾器。
- 需要在 mid-training 建立工具 affordance、schema 與恢復能力時,讀 MidTool。它擴大了 Toolformer 僅含五個固定 API、單次呼叫的設定。
- 候選 API/文件變成目錄,且名稱或參數幻覺成為主要失敗時,讀 Gorilla。它處理目錄級檢索與呼叫,不是本篇的損失過濾器。
- 候選工具很多、schema 會把 prompt 撐爆時,讀 RAG-MCP。Toolformer 假設工具已經很少、而且總是可以呼叫。
- 工具有寫入、計費或權限邊界時,不要複製「損失下降就插入」。這篇論文不對副作用建模。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v1 PDF、HTML 可讀;license 為 arXiv.org perpetual non-exclusive,不是 CC BY。NeurIPS 2023 議事錄 PDF 亦可讀。
- Project page:Meta 研究頁 可開啟,是論文介紹,不是可執行服務。
- 官方程式與 :missing。論文與研究頁未提供第一方 GitHub、訓練腳本、CCNet 標註資料或 GPT-J Toolformer checkpoint。
facebookresearch/toolformer為 404。社群有第三方實作,例如 conceptofmind/toolformer,那不是官方 artifact,也不能用來宣稱 Table 3 可重現。 - 工具依賴:Atlas、NLLB、KILT Wikipedia dump、GPT-J 權重、CCNet 子集、8×A100 40GB。即使複述 Appendix A–B,沒有官方標註檔仍無法核對 18,526 筆 QA 呼叫是哪 18,526 筆。
- 最小有用 reproduction:用 Appendix A.2 的 QA prompt,在一小段事實句上採樣
[QA(...)],實際查一次資料來源,再比較「有結果/無結果/不呼叫」三種 prefix 的後續 token 損失。這只能檢查過濾器方向,不能重現 LAMA 33.8。
三個記憶點 / Three things to remember
- 技術想法:Toolformer 用少量示範採樣 API,再用 決定留下哪些呼叫,把工具使用寫進 next-token 訓練,而不是寫進 agent loop。
- 證據:在寬鬆 zero-shot 與幾乎總是單次呼叫 QA/計算機時,GPT-J 6.7B 於 LAMA 與數學超過 OPT-66B 與 GPT-3-175B;同一方法在開放 QA 上仍低於 GPT-3,且 headline 呼叫率依賴 。
- 邊界:不能串工具、不能互動搜尋、評測最多一次呼叫、沒有官方代碼。可遷移的是損失過濾這份訓練契約;runtime、權限與多步工具使用不能從這篇推論已經完成。
延伸閱讀
Toolformer 處理的是「訓練時要不要插入一次 API」。接下來可依問題選讀:
- thought 與環境動作交錯:ReAct。
- 目錄級 API 文件的檢索與呼叫:Gorilla。
- 在 mid-training 教工具 affordance:MidTool。
- 候選工具太多、schema 膨脹:RAG-MCP。