若要先定位這篇與其他 Agent 方法的關係,可看 Agent 方法底座閱讀地圖。Toolformer 研究少量 API 的 next-token 插入;Gorilla 處理目錄級 API 呼叫;後續的 MidTool 與 RAG-MCP 則分別研究 mid-training 與 MCP schema 路由。四者的問題設定並不相同。
90 秒掌握論文 / The paper in 90 seconds
- 問題:LLM 寫 API 呼叫時容易幻覺名稱、參數與用法;真實世界不是五個固定工具,而是會頻繁更新的巨大 API 目錄。
- 核心洞見:把工具使用做成 檢索+呼叫:用 self-instruct 在 APIBench 上生成指令—API 對,再以 retriever-aware 方式微調 LLaMA-7B(RAT),讓模型學會讀取「Use this API documentation for reference: …」後面的文件並發出正確呼叫。
- 最強證據:NeurIPS Table 1。Gorilla zero-shot 在 TorchHub/HuggingFace/TensorFlow Hub 的 overall 為 59.13%/71.68%/83.79%,hallu 為 6.98%/10.95%/5.40%;同表 GPT-4 zero-shot 為 38.70%/19.80%/18.20% overall,hallu 36.55%/37.16%/78.65%。Figure 6 顯示測時改文件時,RAT 模型會跟著改呼叫。
- 主要邊界:語料是 ML hub 的 model-card/API JSON,不是任意 REST 產品目錄;評測是單次 AST 子樹匹配,不是多步 agent loop;差的檢索器會拖垮表現(Table 2)。不要把 APIBench 數字寫進 MidTool 或 RAG-MCP。
我的結論是:Gorilla 最值得保留的觀點,是將目錄級工具使用視為「檢索+呼叫」問題,並讓模型在訓練時就看見檢索文件。APIBench 不是 MCP 產品的服務規格,後續方法的分數也不能混入本篇結果。
版本與閱讀範圍 / Version and reading scope
本文以 Patil et al., NeurIPS 2024 相機就緒 PDF 為數字與表號來源,並對照 arXiv:2305.15334 v1。該版本於 2023-05-24 首發,截至 2026-08-27 仍是 arXiv 唯一版本。
作者順序依 PDF:Shishir G. Patil、Tianjun Zhang(共同一作)、Xin Wang(Microsoft Research)、Joseph E. Gonzalez(UC Berkeley)。NeurIPS 摘要將方法命名為 Retriever Aware Training(RAT)。Table 1/2 的主要數字與 arXiv v1 一致;相機就緒版本另加入 AST 與人工核對(Table 3),並將約束呼叫與 0-shot/GPT 3-shot 比較分別列為 Table 4、5。
除摘要外,本文核對 Section 3 的 APIBench/Gorilla/AST、Section 4 的 Table 1–5 與 Figure 5–6、Appendix A 的資料與超參,以及截至 2026-08-27 的工件。對照只連站上已有筆記:Toolformer、MidTool、RAG-MCP、ReAct。不發明 HuggingGPT/AutoGPT 精讀。
這是已發表的 NeurIPS 論文;arXiv 快照仍為 preprint 形態的 v1。
讀者真正要回答的問題
當工具從「計算機+搜尋+翻譯」變成「TorchHub/TensorHub/HuggingFace 上千個會改文件的 API」時,工程上是該繼續靠提示塞文件,還是該把檢索進來的文件寫進微調契約?Patil et al. 的回答是:先建 APIBench,再用 RAT 讓 LLaMA-7B 在訓練與推論都看見文件;評測用 AST 子樹匹配分開「幻覺」與「選錯但存在的 API」。
比較精確的讀法不是「Gorilla 是不是永遠比 GPT-4 強」。真正的問題是:在目錄級 API 呼叫上,retriever-aware 微調相對於直接提示閉源模型,移動了哪些 overall/hallu,又在哪裡因為檢索品質、單次呼叫契約、或 ML hub 語料而出界?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Figure 3 描述 self-instruct+檢索訓練/推論;Table 1 給三 hub × 四種檢索設定的 overall/hallu/err;Table 2 對照「無檢索微調」與「Oracle 檢索微調」;Table 3 報告 AST 與人工 0.78、可執行 0.72;Figure 6 展示測時文件變更;超參 lr 、batch 64、5 epochs。 |
| 作者主張 | 目錄級 API 呼叫需要系統性資料與評測;RAT 可降低幻覺並適應文件更新;finetune 在本範圍內可勝過只靠提示的 GPT-4。 |
| 論文未證明 | ReAct 式多步 thought–action–observation;MidTool 的 mid-training mixture;RAG-MCP/MCP 產品的權限與路由 SLA;任意 REST/計費 API 的外部效度;差檢索器不會傷害表現。 |
| Bloss0m 工程判斷 | Gorilla 把問題推進到目錄級工具使用,關鍵是文件是否同時進入訓練與推論。MidTool 接著研究何時教授 affordance,RAG-MCP 則處理產品 schema 過多時的候選縮減。三者的數字不能直接混用。 |
後文把數字、作者 claim 與工程判讀分開。「勝過 GPT-4」只指 Table 1 寫作當下、APIBench holdout、列內那一格。
先前方法為何不足 / Why the previous approach is insufficient
Section 1–2 把 2023 年前的兩條線寫清楚。
少數手寫工具+提示:Toolformer、瀏覽器、計算機、Python 解釋器等工作證明 LLM 可以呼叫工具,但通常假設工具集合小、文件可塞進 prompt。作者指出:一旦工具變成「會更新的雲端 API 目錄」,提示注入整本文件不再可行,幻覺名稱與參數會變成主失敗模式。
只展示 prompting、缺少系統評測與訓練管線:同時間有不少「讓模型呼叫 API」的 demo,但缺少可擴的資料收集、holdout 評測、以及把檢索文件寫進微調的方法。作者也把一般程式合成與「線性、可核對的 API 呼叫」分開:後者比較像工具使用,較容易用 AST 對資料集做功能等價檢查。
因此舊方法不夠的地方不是「沒人想過工具」,而是控制點停在 few-API 或純提示:要嘛工具太少,要嘛沒有把「文件檢索」當成訓練看得見的訊號。Gorilla 改的正是目錄規模下的檢索+呼叫契約。
核心直覺 / Core intuition
先不要看表。想像兩種教模型用工具的方式。
Toolformer 像口袋裡只有五支筆:問自己「插一次 QA/計算機會不會讓後面幾個 token 更好猜」。Gorilla 像走進一座會改架的 API 圖書館:問題變成「先找到正確那一頁文件,再照文件發出呼叫;文件換了,呼叫也要跟著換」。訓練時若從不讓模型看見「Use this API documentation for reference: …」,推論時突然塞一份文件,模型可能當噪音、甚至被帶壞——Table 2 就是這件事的定量版。
對照三種容易混在一起的下一步:
- Toolformer(note 25):下一步是 next-token 要不要插入一次 API;工具很少,損失過濾器決定留下與否。
- Gorilla(本篇):下一步是目錄裡檢索哪份文件、並發出可被 AST 核對的呼叫;訓練可以是 zero-shot 或 RAT。
- MidTool/RAG-MCP(後續方法):MidTool 把 affordance 提前到 mid-training;RAG-MCP 在 MCP 產品面做 schema 候選縮減。不要把它們的數字混入 APIBench。
用一個例子走完整個方法 / Walk one example through the method
以下把 Figure 3/Figure 6 的教學例走完機制,不是獨立實驗分數。
- Input:使用者自然語言,例如「幫我把錄音裡的口語轉成文字」,或「自動去掉輸入影像的背景」。還沒有 agent 狀態,也沒有多輪 observation。
- Intermediate representation:API 資料庫裡每筆 API 是一份 JSON(domain、framework、api_call、arguments、example_code、performance、description 等)。若開檢索,BM25/GPT-Index/Oracle 取回 top-1 文件;使用者 prompt 後方接上
Use this API documentation for reference: <retrieved_API_doc_JSON>。 - Model or system decision:Gorilla(LLaMA-7B 指令微調)讀 prompt(與可選文件),輸出結構化 API 呼叫。RAT 訓練時,文件欄位就已出現在訓練對話裡,所以模型被教會「第二段文件是用來回答第一段任務」。Figure 6:同一句「去背」,檢索改成
fcn_resnet101、或改成 NVIDIA registry 的fcn_resnet50時,輸出跟著改。 - Output:單次 API 呼叫字串(常伴隨 domain/provider/說明)。評測時把候選建成 AST,與資料集做子樹匹配(Figure 4):匹配則算對;完全對不上資料集則算幻覺;對上錯誤 API 則算 err。
- Likely failure point:檢索取回錯文件時,zero-shot 訓練的模型可能被帶歪(Table 2 左側 BM25 欄);約束題(參數量/準確率下界)會讓 overall 下降(Table 4);HuggingFace 非 exhaustive,對非 Gorilla 模型作者改成較鬆的 domain 多選檢查——跨模型比較時要讀註解。
這條例子教的是機制怎麼走完。要看三 hub 主表,應回到 Table 1;要看檢索是否多餘,應看 Table 2;要看測時改文件,應看 Figure 6。
技術機制 / Technical mechanism
APIBench 資料:作者從 Torch Hub、TensorFlow Hub v2、HuggingFace model card 收集 API,轉成可泛化到 REST 欄位的 JSON。Figure 3/正文稱共 1,645 個 API(Torch Hub exhaustive、TensorFlow Hub v2 exhaustive、HuggingFace 每 domain 取 Top-20)。Appendix A.1 另寫 Torch/Tensor/HF 為 95/696/925,加總與 1,645 不完全一致——這是論文內部不一致;本文主數字跟 Figure 3 的 1,645 與「每 API 10 條指令」敘事,並把附錄拆分當邊界註記。
Self-instruct:每 hub 手寫 6 個 instruction–API 示範(三 hub 共 18 條人工資料),再用 GPT-4 為每筆 API 生成 10 條指令(抽樣 in-context 示範),得到約 16,450 個 {instruction, API} 對,再切 train/holdout test。指令被要求不直接洩漏 API 名稱。
Gorilla 微調:把資料轉成單輪 user–agent 對話,對 LLaMA-7B 做標準 instruction finetuning。兩種訓練變體:
- 不帶檢索:只見使用者指令。
- RAT(帶檢索):使用者訊息追加參考文件字串,迫使模型學會解析文件來回答任務。
推論同樣支援 zero-shot 與 retrieval 兩模式;除串接文件外不做額外 prompt tuning。作者提到另有執行系統,但不是本篇焦點。
AST 子樹匹配:因為同一任務可能有多個功能上等價的模型,單元測試難以判定「哪個 API 算對」。作者把候選呼叫建成 AST,檢查是否匹配資料集中某支 API 的子樹(含可選參數如 pretrained=True)。幻覺=對不上任何資料集 API;err=匹配到錯誤 API。NeurIPS Table 3:抽 100 個 Gorilla 生成,AST 準確率 0.78,與人工評估一致;含安裝依賴等支援程式後,人工可執行比例 0.72。
操作約束:
- 檢索器:Zero-shot/BM25/GPT-Index(
text-davinci-003)/Oracle;文件以 API 為單位建索引,取 top-1。 - 基線模型:GPT-4
gpt-4-0314、GPT-3.5gpt-3.5-turbo-0301、Claudeclaude-v1、LLaMA-7B。 - 訓練超參(Appendix):lr 、batch 64、5 epochs、warmup ratio 0.03、max seq length 2048。
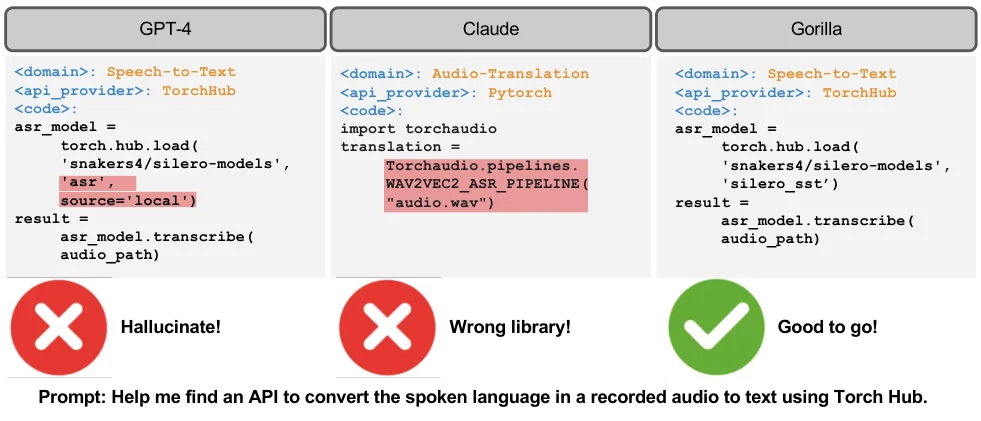
原文 Figure 1,論文 Introduction:閉源提示 vs Gorilla 的 API 呼叫對照。原圖可定位到 ar5iv Figure 1(資產 code-examples.png)。取自 arXiv/ar5iv 源檔;arXiv 頁面標示 perpetual non-exclusive license。本文依 arXiv reuse terms 做教學引用;NeurIPS 正式版另受會議出版條款約束。

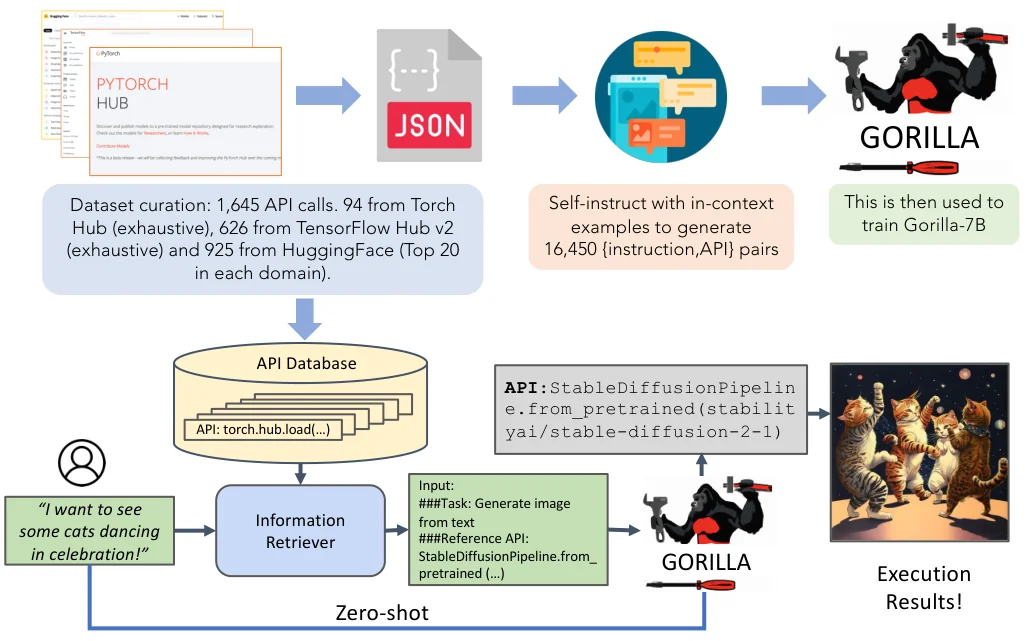
原文 Figure 3,論文 Section 3:Gorilla 系統總覽與 APIBench 建構。見 ar5iv Figure 3(資產 llmapi.png)。授權同上。

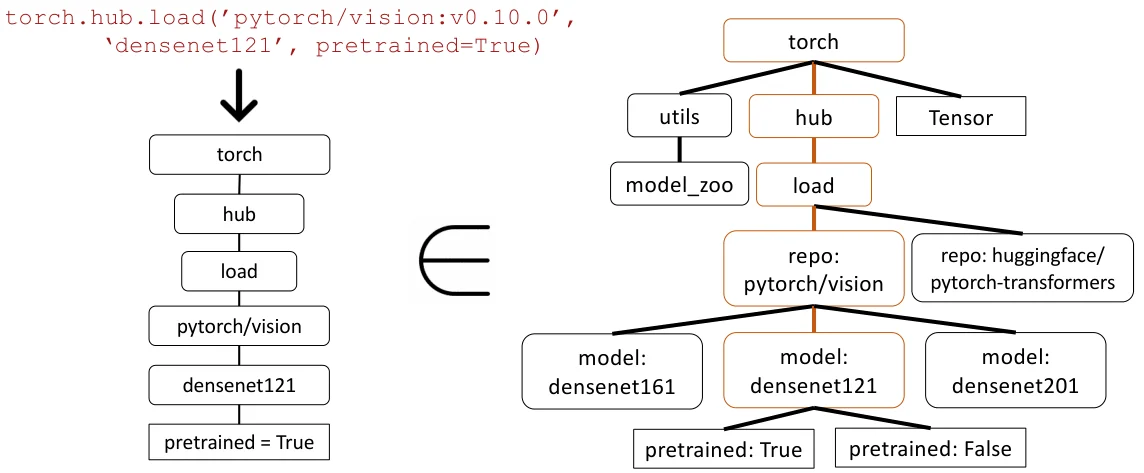
原文 Figure 4,論文 Section 3.3:AST 子樹匹配評測。見 ar5iv Figure 4(資產 ast.png)。授權同上。

實驗如何讀 / How to read the evidence
Table 1:目錄級準確率與幻覺
- 問什麼:在 holdout 指令上,各 LLM 在 0-shot/BM25/GPT-Index/Oracle 下,能否發出 AST 可核對的正確 API?幻覺與選錯如何拆開?
- 控制:同一 APIBench 切分;基線用固定 checkpoint;檢索時 top-1 文件串到同一句式。
- 觀察:Gorilla (0-shot) overall 59.13/71.68/83.79,hallu 6.98/10.95/5.40。GPT-4 (0-shot) overall 38.70/19.80/18.20,hallu 36.55/37.16/78.65。作者正文寫 Gorilla zero-shot 相對 GPT-4 約好 20.43 個百分點、相對 ChatGPT 約 10.75、相對 LLaMA 可達約 83(其表述依表內對照)。GPT-Index 下 Gorilla 在 TorchHub 61.82(hallu 0)、HuggingFace 47.46、TensorFlow Hub 64.96。
- 可能機制:專為 API 呼叫微調,比通用對話模型更對準 AST 契約;文件不在場時,Gorilla 仍可依微調記憶呼叫,故 0-shot 很強。
- 未建立:生產 REST 閘道;多步工具;把 HuggingFace 上「只檢查 domain」的基線列,直接當與 Gorilla 完全同嚴的比較。
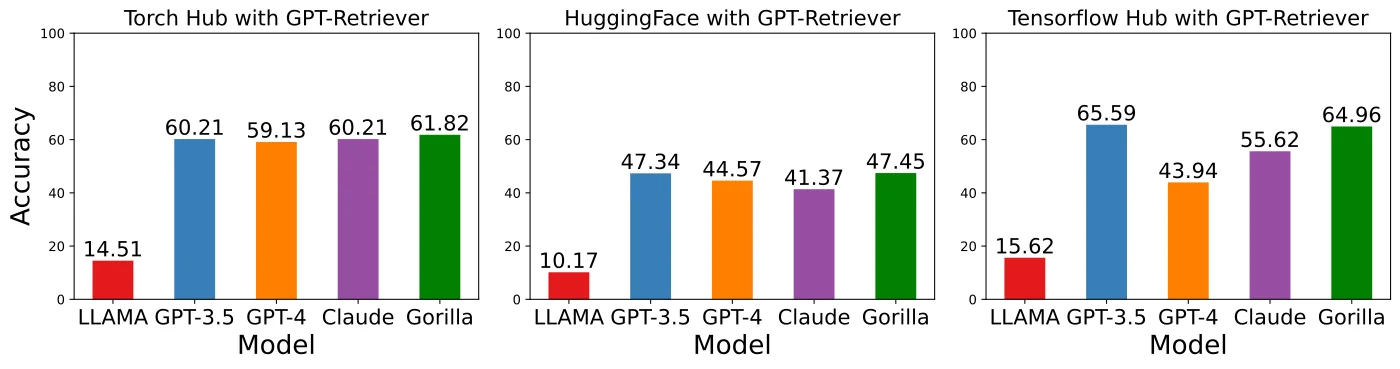
原文 Figure 5,論文 Section 4.1:GPT-retriever 設定下的準確率。見 ar5iv Figure 5(資產 grid_bars_GPT_Retrieval.svg)。授權同上。

Table 2:檢索器是朋友還是噪音
- 問什麼:微調時「有沒有 Oracle 檢索」如何改變測時 0-shot/BM25/GPT-Index/Oracle 的 overall 與 hallu?
- 控制:同一 Gorilla 骨架;左欄無檢索微調、右欄 Oracle 檢索微調。
- 觀察:無檢索微調的 zero-shot 已是 59.13/71.68/83.79;但測時塞 BM25 會掉到 37.63/11.28/34.30。Oracle 微調在測時 zero-shot 崩成 0(hallu ≈100),因為模型預期文件;測時給 Oracle 則升到 67.20/91.26/94.16,且 TorchHub hallu 可到 0。
- 可能機制:訓練分布決定模型依賴什麼;檢索契約要 train/test 一致,差檢索器會「誤導」。
- 未建立:「永遠該上檢索」或「永遠不該上檢索」;只建立本資料與本檢索器集合上的條件建議。
Figure 6 與 Table 4/5:測時變更、約束、提示對照
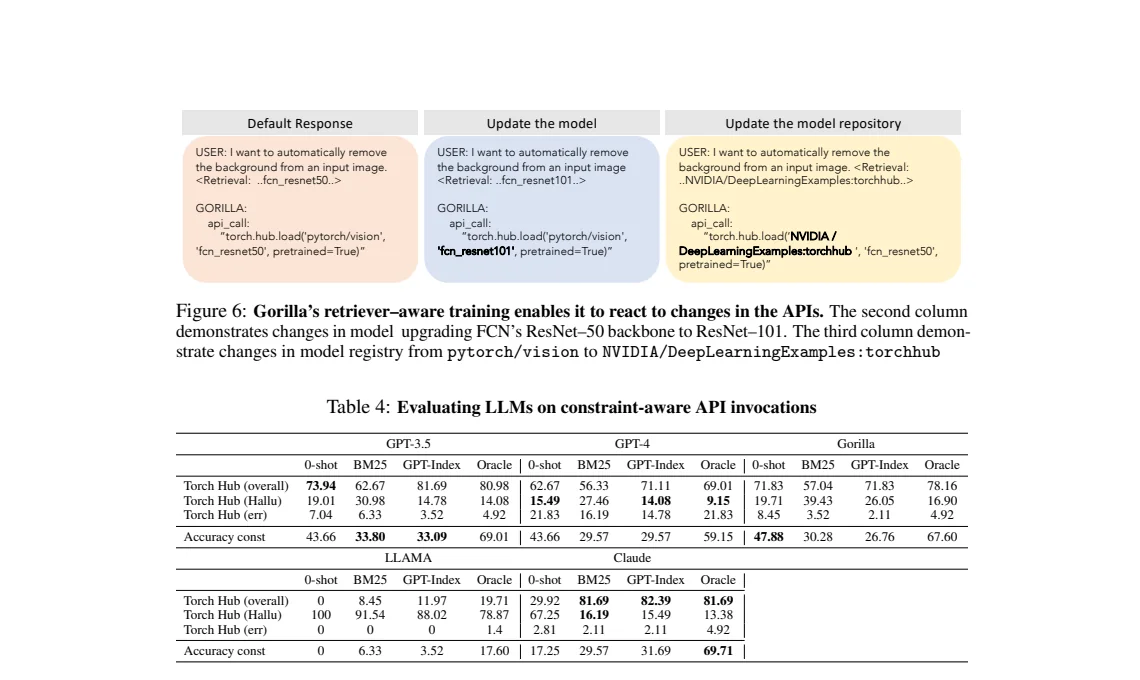
原文 Figure 6,論文 Section 4.2:retriever-aware 訓練對測時文件變更的適應。見 ar5iv Figure 6。本圖自 NeurIPS PDF 頁面裁切供教學引用;授權邊界同上。若裁切邊緣較粗,請以 PDF/HTML 原圖為準。
Figure 6 不是分數表,而是機制示意:文件升級或 registry 遷移時,RAT 模型改呼叫目標。Table 4(約束感知;arXiv 舊稿為 Table 3)在有 ImageNet 準確率欄位的 TorchHub 子集(約 65.26%)上,要求滿足準確率約束;各模型 overall 下降,Gorilla 0-shot accuracy-const 47.88,Oracle 下 67.60。Table 5 另比 Gorilla 0-shot 與 GPT 3-shot in-context;讀時注意部分格子與 Table 1 的 0-shot 基線不完全相同,應把 Table 5 當「提示能否取代微調」的補充,而不是覆蓋 Table 1 的主數字。
作者還觀察:在多個設定下 GPT-3.5 的幻覺率低於 GPT-4,並猜測 RLHF 與「誠實」有關——這是作者詮釋,不是因果實驗。
消融與真正驅動結果的東西 / Ablations and what drives the result
真正驅動 headline 的,不是「又一個 7B 對話模型」,而是三件事疊加:
- 任務被收窄成可核對的單次 API 呼叫(AST),而不是一般程式合成。
- 資料覆蓋目錄規模(APIBench + self-instruct),讓微調看過大量 hub API。
- RAT 讓文件成為一等公民;但 Table 2 證明檢索品質與 train/test 一致性決定它是增益還是傷害。
反面也重要:BM25 常增加 err;Oracle 微調卻不能在零文件時使用。工程上這很像「你到底在部署哪一種契約」——閉卷專家,還是開卷圖書管理員。
限制、效度威脅與不該推出的結論 / Limitations and unsupported readings
- 語料邊界:證據在 ML model hub;REST 成本/延遲等只是動機類比,不是評測主場。
- 單次呼叫:方法與評測都不覆蓋 ReAct 式多步 observation。
- 評測近似:AST 與人工在 100 樣本上一致,但不等於所有生成在真實依賴/GPU 環境可跑;可執行 0.72 含支援程式失敗。
- 基線不對稱:HuggingFace 非 exhaustive 時,非 Gorilla 模型改查 domain,嚴格度不同。
- 統計:清單式 checklist 寫明 LLM 實驗因成本只跑一次,無 error bar。
- 不要推出:APIBench ≠ MCP 產品;Gorilla ≠ MidTool;檢索成功 ≠ 授權成功;後續 BFCL/OpenFunctions 產品線數字不屬於 Table 1。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 Gorilla?當你的痛點是 「工具/文件太多且會變,模型會幻覺 endpoint」,而且你可以接受:版本化 API registry、top-k 文件、AST 或 schema 驗證、以及 train/test 一致的檢索契約。適合的原型是內部 SDK/model hub/openapi 目錄的單次呼叫助手。
什麼時候不要把這篇當成施工圖?
- 需要 thought–action–observation 多步迴圈時,讀 ReAct。
- 只有少數固定 API、要問「這次呼叫有沒有讓後面 token 更好猜」時,讀 Toolformer。
- 要在 mid-training 先建立工具 affordance 與可執行軌跡時,讀 MidTool。
- 候選是 MCP schema、要產品面路由與權限時,讀 RAG-MCP。檢索仍不是授權。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v1 PDF、ar5iv HTML 可讀;NeurIPS 2024 PDF 可讀。arXiv 標示 perpetual non-exclusive license;作者 checklist 稱程式/資料/模型以 Apache 2.0 開源。
- Project page:gorilla.cs.berkeley.edu 可開啟。
- Code/data:ShishirPatil/gorilla 可開啟(Apache-2.0);
data/apibench等目錄存在。倉庫後續也納入 BFCL 等專案;這些後來加入的成果不屬於本篇 Table 1。 - 模型:HuggingFace 上可見
gorilla-llm/*公開模型卡(API 列表可查);本環境對部分模型頁 HTML 回 401,故權重下載路徑標為 usable/需在瀏覽器再確認,不宣稱已重跑 Table 1。 - 最小有用 reproduction:從
data/apibench取一筆 JSON,手寫Use this API documentation for reference:前後兩種 prompt,比較模型是否改呼叫;再用 AST/字串匹配檢查是否落在資料集。這不能重現整張 Table 1。
三個記憶點 / Three things to remember
- 技術想法:目錄級工具使用是 檢索+呼叫;RAT 讓 API 文件在訓練時就進 prompt,而不只是推論時臨時貼上。
- 證據:Table 1 上 Gorilla 0-shot 在三 hub 以更高 overall、更低 hallu 勝過同表 GPT-4 0-shot;Table 2 顯示差檢索會傷害,Oracle+RAT 則推高上限;Figure 6 展示測時改文件。
- 邊界:APIBench 是 ML hub 的單次呼叫評測,不是 ReAct runtime、MidTool 或 MCP 產品的服務規格。可遷移的是「文件在 train/test 必須一致」;不能把 59.13/71.68/83.79 當成今日任意工具閘道的 SLA。
延伸閱讀
Gorilla 處理的是「如何在大規模 API 目錄中檢索並呼叫工具」。若關心少數 API 的 next-token 損失過濾,讀 Toolformer;若關心 mid-training 先驗,讀 MidTool;若問題是 MCP schema 過多,讀 RAG-MCP。完整方法關係見 閱讀地圖。