若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:LLM 的推理(Chain-of-Thought)與行動(WebGPT、SayCan)被當成兩條分開的線。CoT 不接觸環境;Act-only 能查外部,卻沒有高層計畫與例外處理。
- 核心洞見:把語言 thought 加進 action space。thought 不改環境、不產生環境 observation,只更新 context;再與環境動作交錯。決策點從「只想」或「只做」改成「同一條軌跡裡決定下一步是對自己說話,還是碰外部世界」。
- 最強證據:ALFWorld best-of-6 ReAct 71% vs Act 45%、BUTLER best-of-8 37%;WebShop SR 40.0 vs IL+RL 28.7。HotpotQA 人工分析中,CoT 失敗案例有 56% 是幻覺,ReAct 為 0%(Table 2)。
- 主要邊界:HotpotQA PaLM-540B 的純 ReAct EM 27.4,低於 CoT 29.4。35.1/64.6 是 ReAct↔CoT-SC 切換。few-shot prompt,Wikipedia API 只有 search/lookup/finish。這不是可部署 runtime。
我的結論是:ReAct 最值得保留的貢獻,是讓 thought、action 與 observation 形成可檢查的執行軌跡。論文只使用 1–6 條人工示範與三種 Wikipedia 動作,不能直接代表今日可部署的 Agent 框架。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Yao et al., ICLR 2023 對應的 arXiv:2210.03629 v3。v3 PDF 與 arXiv HTML 標示 CC BY 4.0。
除摘要外,本文核對 Section 2 的 action-space 定義、Section 3 的 Wikipedia API 與 Table 1–2、Section 4 的 ALFWorld/WebShop,以及 Appendix A–E 的 GPT-3、人工校正與 Colorado orogeny 軌跡。截至 2026-08-27,project page 與 ysymyth/ReAct 仍可開啟。
這是已發表的 ICLR 論文,不是 preprint。它也不是一份 runtime 規格。
讀者真正要回答的問題
當一個語言模型既會「想」又會「做」時,應不應該把它們拆成兩套系統?ReAct 的回答是否定的:同一條 few-shot 軌跡裡,模型要交替產生 verbal thought 與環境動作。
比較精確的讀法不是「ReAct 是不是比 CoT 強」,因為 Table 1 在 HotpotQA 上並非如此。真正的問題是:把 thought 當成一種不碰環境的合法動作之後,模型能不能用外部 observation 修正計畫,又會在哪裡因為工具太弱、步驟上限或重複生成而失敗?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | Section 2 把 action space 擴成 ;Table 1 給出 PaLM-540B 的 prompting 數字;Table 2 給出 200 條人工標註的成功/失敗類型;Table 3–4 給出 ALFWorld 與 WebShop;Figure 3 顯示 8B/62B 的 finetune 方向。 |
| 作者主張 | 交錯 reasoning 與 acting 能同時提升 groundedness、可解釋性與部分決策任務成功率;abstract 的 +34%/+10% 來自 ALFWorld 與 WebShop 的指定比較。 |
| 論文未證明 | few-shot ReAct 不是可部署 Agent runtime;Wikipedia 三動作不是企業 tool 介面;PaLM-540B 的完整實驗一般讀者無法重跑;HotpotQA 純 ReAct 並未勝過 CoT。 |
| Bloss0m 工程判斷 | 把 ReAct 當成 auditable thought–action–observation 契約來實作;不要把 Wikipedia 的 search/lookup/finish 接到有副作用的工具。 |
後文把數字、作者 claim 與工程判讀分開。「提升」只指論文報告的 setup。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2022 年的兩條線寫得很清楚。
只推理:Chain-of-Thought 讓模型產生多步 thought,但整個過程是靜態黑箱。模型只用內部 representation,沒有外部 grounding,因此難以依環境回饋修正,也容易把幻覺事實一路傳到答案(Figure 1(1b))。
只行動:WebGPT、SayCan 這類工作把觀察轉成文字、再讓語言模型產生 domain-specific action。它們通常不要求模型用語言維持高層目標或 working memory。Inner Monologue 有一點 verbal feedback,但論文認為它主要是複述環境狀態與尚未完成的子目標,不是彈性的內部推理。
因此,舊方法不夠的地方不是「模型不夠大」,而是決策規則被切開了:CoT 的下一步只能是另一句 thought;Act 的下一步只能是環境動作。ReAct 改的正是這個控制點。
核心直覺 / Core intuition
先不要看公式。想像一個人在廚房:切完菜以後,他可以對自己說「現在該燒水了」(thought),也可以打開冰箱確認還有沒有鹽(action)。前一句話不會讓爐火自己點燃;後一個動作才改變世界,並帶來新的 observation。
ReAct 把這個分工寫進 decoder 的合法下一步:
- Thought:對當前 context 做計畫、抽取、常識推理、例外處理。環境不變。
- Action:search、走路、點擊商品。環境會回來一句 observation。
- Observation:唯一能把外部事實寫進 context 的通道。
CoT 只有第一種下一步,所以答錯時常常是「自信地編造」。Act-only 只有第二種,所以即使 Wikipedia 已經把關鍵句找出來,模型仍可能無法合成最終答案。Figure 1 的 Apple Remote 例子就是這個對比:Act 找到了 Front Row,最後卻 Finish 成錯誤答案;ReAct 用 thought 把 observation 收成 “keyboard function keys”。
用一個例子走完整個方法 / Walk one example through the method
以下是 Appendix C.1 的人工 exemplar,不是獨立實驗結果。題目是 HotpotQA:What is the elevation range for the area that the eastern sector of the Colorado orogeny extends into? 標準答案是 1,800 to 7,000 ft。
- Input:只有這句問題。沒有 support paragraph。Wikipedia API 的合法環境動作只有
search[entity]、lookup[string]、finish[answer]。 - Intermediate representation:context 是到目前為止的 Thought/Action/Observation 字串。Thought 1 先把問題拆成「先找 Colorado orogeny,再找 eastern sector 延伸到哪,再找該地區海拔」。這句話不送進 Wikipedia,只附加到下一步的 prompt。
- Model or system decision:Action 1
Search[Colorado orogeny]才碰環境。Observation 1 只回 wiki page 的前五句,沒提到 eastern sector。Thought 2 決定改Lookup[eastern sector]。Observation 2 說 eastern sector 延伸到 High Plains。Thought 3 決定Search[High Plains],但 Observation 3 是消歧義頁(兩個不同地區)。Thought 4 因此改搜High Plains (United States)。 - Output:Observation 4 寫出 High Plains 海拔約 1,800 to 7,000 ft。Thought 5 合成答案,Action 5
Finish[1,800 to 7,000 ft]。 - Likely failure point:若模型在 Observation 3 的消歧義頁就 Finish,或 lookup/search 回空、回不相關句子,軌跡就會脫軌。Table 2 把這類失敗記成 search result error(ReAct 失敗案例的 23%)。另一個論文點名的失敗是重複生成同一組 thought/action,被算進 reasoning error(47%)。
同一個 Appendix C.1 裡,Act-only exemplar 最後也能 Finish 出同一段海拔。所以這條 Colorado 軌跡教的是機制怎麼走完,不是「沒有 thought 就一定失敗」。要看 thought 改變終局,應回到 Figure 1 的 Apple Remote,或 Appendix D.2 的 ALFWorld knife:Act 找到刀子後,沒先走到 sinkbasin 就嘗試 clean,接著卡在重複指令。
技術機制 / Technical mechanism
Section 2 從一般 agent 寫起。時刻 ,agent 收到 observation ,並依政策 選動作 。context 是到目前為止的軌跡:
當 很隱含時,只靠「看完整段軌跡再猜下一個環境動作」會失敗。Figure 1(1c) 的 Act-only 即使有 Act 1–3 與 Obs 1–3,仍無法產生正確的最終 Finish;Figure 1(2a) 則無法從 context 讀出 sinkbasin 裡沒有 peppershaker,於是重複幻覺動作。
ReAct 的核心改動是擴張 action space:
符號怎麼運作:
- :會改變環境的任務動作。HotpotQA/FEVER 是 Wikipedia 的 search/lookup/finish;ALFWorld 是 go to/take/clean/put;WebShop 是 search/click。
- :自由語言空間。其中一個元素 稱為 thought。
- thought 不影響外部環境,因此沒有環境 observation。它做的是對 做推理,再把自身寫回 context:
- 環境動作才會讓 Wikipedia、房間或商品頁回傳 ,並把 接進下一輪 。
增加 thought 的次數,等於把更多可檢查的工作記憶寫進 prompt;這可以提高計畫與例外處理的空間,但也拉長 context,並讓 greedy decoding 更容易陷入「重複同一句 Thought/Action」的迴圈。減少 thought、只留 ,就是 Act-only:環境訊號還在,但模型沒有合法的「對自己更新計畫」這一步。
論文還依任務密度調整 thought 出現方式。知識推理任務用密集的 thought–action–observation 交替,因為每一步都要決定查什麼。決策任務動作可能超過 50 步,thought 改成稀疏,由語言模型自己決定何時 think、何時 act。Inner Monologue 式的 ReAct-IM ablation 把 thought 限縮成環境回饋與當前子目標,結果 ALFWorld best-of-6 從 71 掉到 53(Table 3),說明「有內在獨白」不等於「有能改計畫的 thought」。
Wikipedia 三動作:被故意做弱的
Section 3.1 的環境不是 BM25,也不是 dense retriever:
search[entity]:若頁面存在,回傳該 entity wiki page 的前五句;否則回 Wikipedia search engine 的 top-5 similar entities。lookup[string]:在當前頁找出包含該字串的下一句,模擬瀏覽器 Ctrl+F。finish[answer]:結束任務並交出答案。
作者明說這比當時的 lexical/neural retriever 弱很多:大多只能依精確頁名取回一小段。目的是模擬人怎麼查 Wikipedia,並強迫模型用語言說明下一步為什麼要查。截至 2026-08-27,公開的 wikienv.py 會對 https://en.wikipedia.org/w/index.php?search= 發 live request;think[] 只回 "Nice thought.",不改頁面狀態。HotpotQA 主實驗的 prompt 格式則是 Thought n / Action n / Observation n,thought 走 ,不必假裝自己是 Wikipedia 動作。
Prompt 規模也很小:HotpotQA 6 條、FEVER 3 條人工軌跡;ALFWorld 每種任務 3 條,再從中取 2 條做 6 種排列以測 prompt 穩健性;WebShop 是 one-shot。作者寫更多 exemplar 不會再提升 QA 表現。解碼主結果用 greedy;CoT-SC 才用 temperature 0.7 抽 21 條。
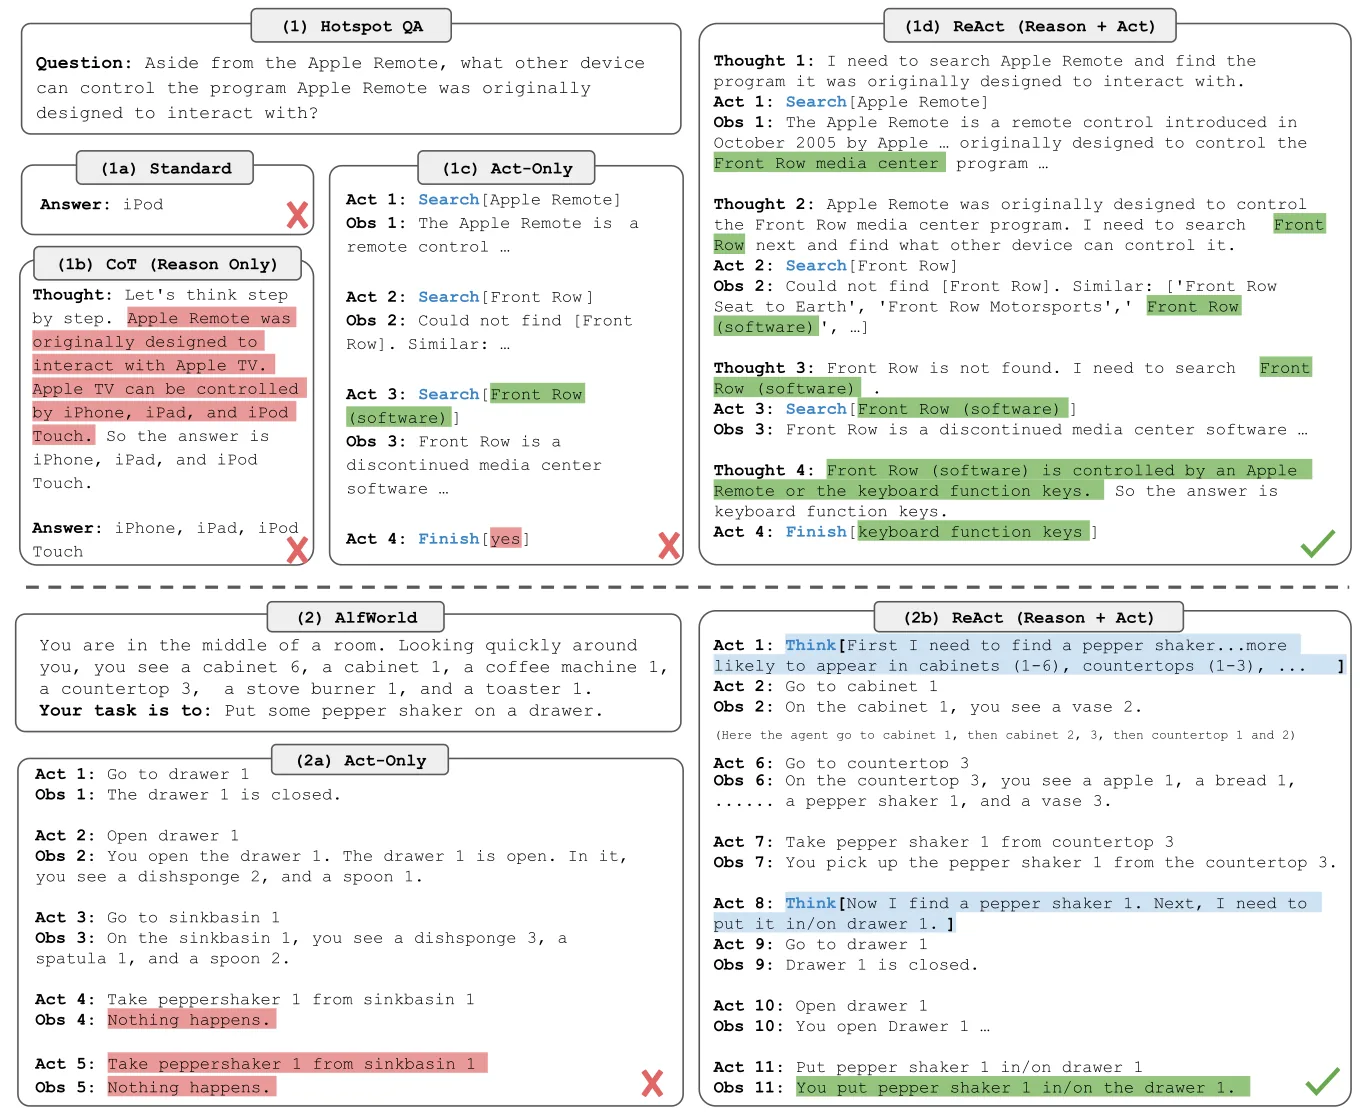
Figure 1,論文 Section 1:左半是同一道 HotpotQA 題,CoT 在內部知識裡幻覺、Act 查到 Front Row 卻無法正確 Finish,ReAct 用 thought 把 observation 收成答案;右半是 ALFWorld,Act 卡在「Nothing happens」,ReAct 用稀疏 thought 改搜尋地點。原圖可定位到 Figure 1,SVG endpoint 為 teaser-new.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

實驗如何讀 / How to read the evidence
四個 benchmark 問的不是同一件事。HotpotQA 與 FEVER 是 question-only:模型看不到 gold paragraph,只能靠內部知識或 Wikipedia API。ALFWorld 是 134 個 unseen text game,專家政策可能超過 50 步。WebShop 有 1.18M 商品與 12k 人類指令,在 500 條 test instruction 上報 average score 與 success rate。
主模型是凍結的 PaLM-540B。QA 的 baseline 由同一組 ReAct 軌跡剝除欄位而成:Standard 去掉 thought/action/observation,CoT 去掉 action/observation,Act 去掉 thought。這讓 Table 1 比較的是同一條人工軌跡的不同可見部分,不是四套獨立標註。
Table 1:HotpotQA 沒有讓純 ReAct 贏
這張表問:在 PaLM-540B、few-shot prompting 下,只想、只做、交錯,或兩者切換,EM/Acc 會怎麼變?控制住的是模型與 exemplar 來源;改的是 prompt 裡看不看環境、看不看 thought。
| Prompt method | HotpotQA EM | FEVER Acc |
|---|---|---|
| Standard | 28.7 | 57.1 |
| CoT | 29.4 | 56.3 |
| CoT-SC | 33.4 | 60.4 |
| Act | 25.7 | 58.9 |
| ReAct | 27.4 | 60.9 |
| CoT-SC → ReAct | 34.2 | 64.6 |
| ReAct → CoT-SC | 35.1 | 62.0 |
| Supervised SoTA | 67.5 | 89.5 |
觀察:ReAct 穩定高於 Act(27.4 vs 25.7;60.9 vs 58.9),支持「thought 有助合成最終動作」。FEVER 上 ReAct 高於 CoT(60.9 vs 56.3),符合「SUPPORTS/REFUTES 可能只差一點,需要查新事實」。HotpotQA 上純 ReAct 27.4 低於 CoT 29.4,也低於 Standard 28.7。最佳 prompting 列是切換:HotpotQA 的 35.1 是 ReAct→CoT-SC,FEVER 的 64.6 是 CoT-SC→ReAct。兩者都遠低於 supervised SoTA 67.5/89.5。
切換規則在 Section 3.2:ReAct→CoT-SC 是 ReAct 在步數上限內交不出答案就退回 CoT-SC(HotpotQA 7 步、FEVER 5 步);CoT-SC→ReAct 是 個 CoT-SC sample 的多數答案出現次數少於 時改走 ReAct。這不是學到的 router,是啟發式 backoff。
這張表不能支持「ReAct prompting 在多跳 QA 全面勝過 CoT」,也不能把 35.1/64.6 寫成純 ReAct。
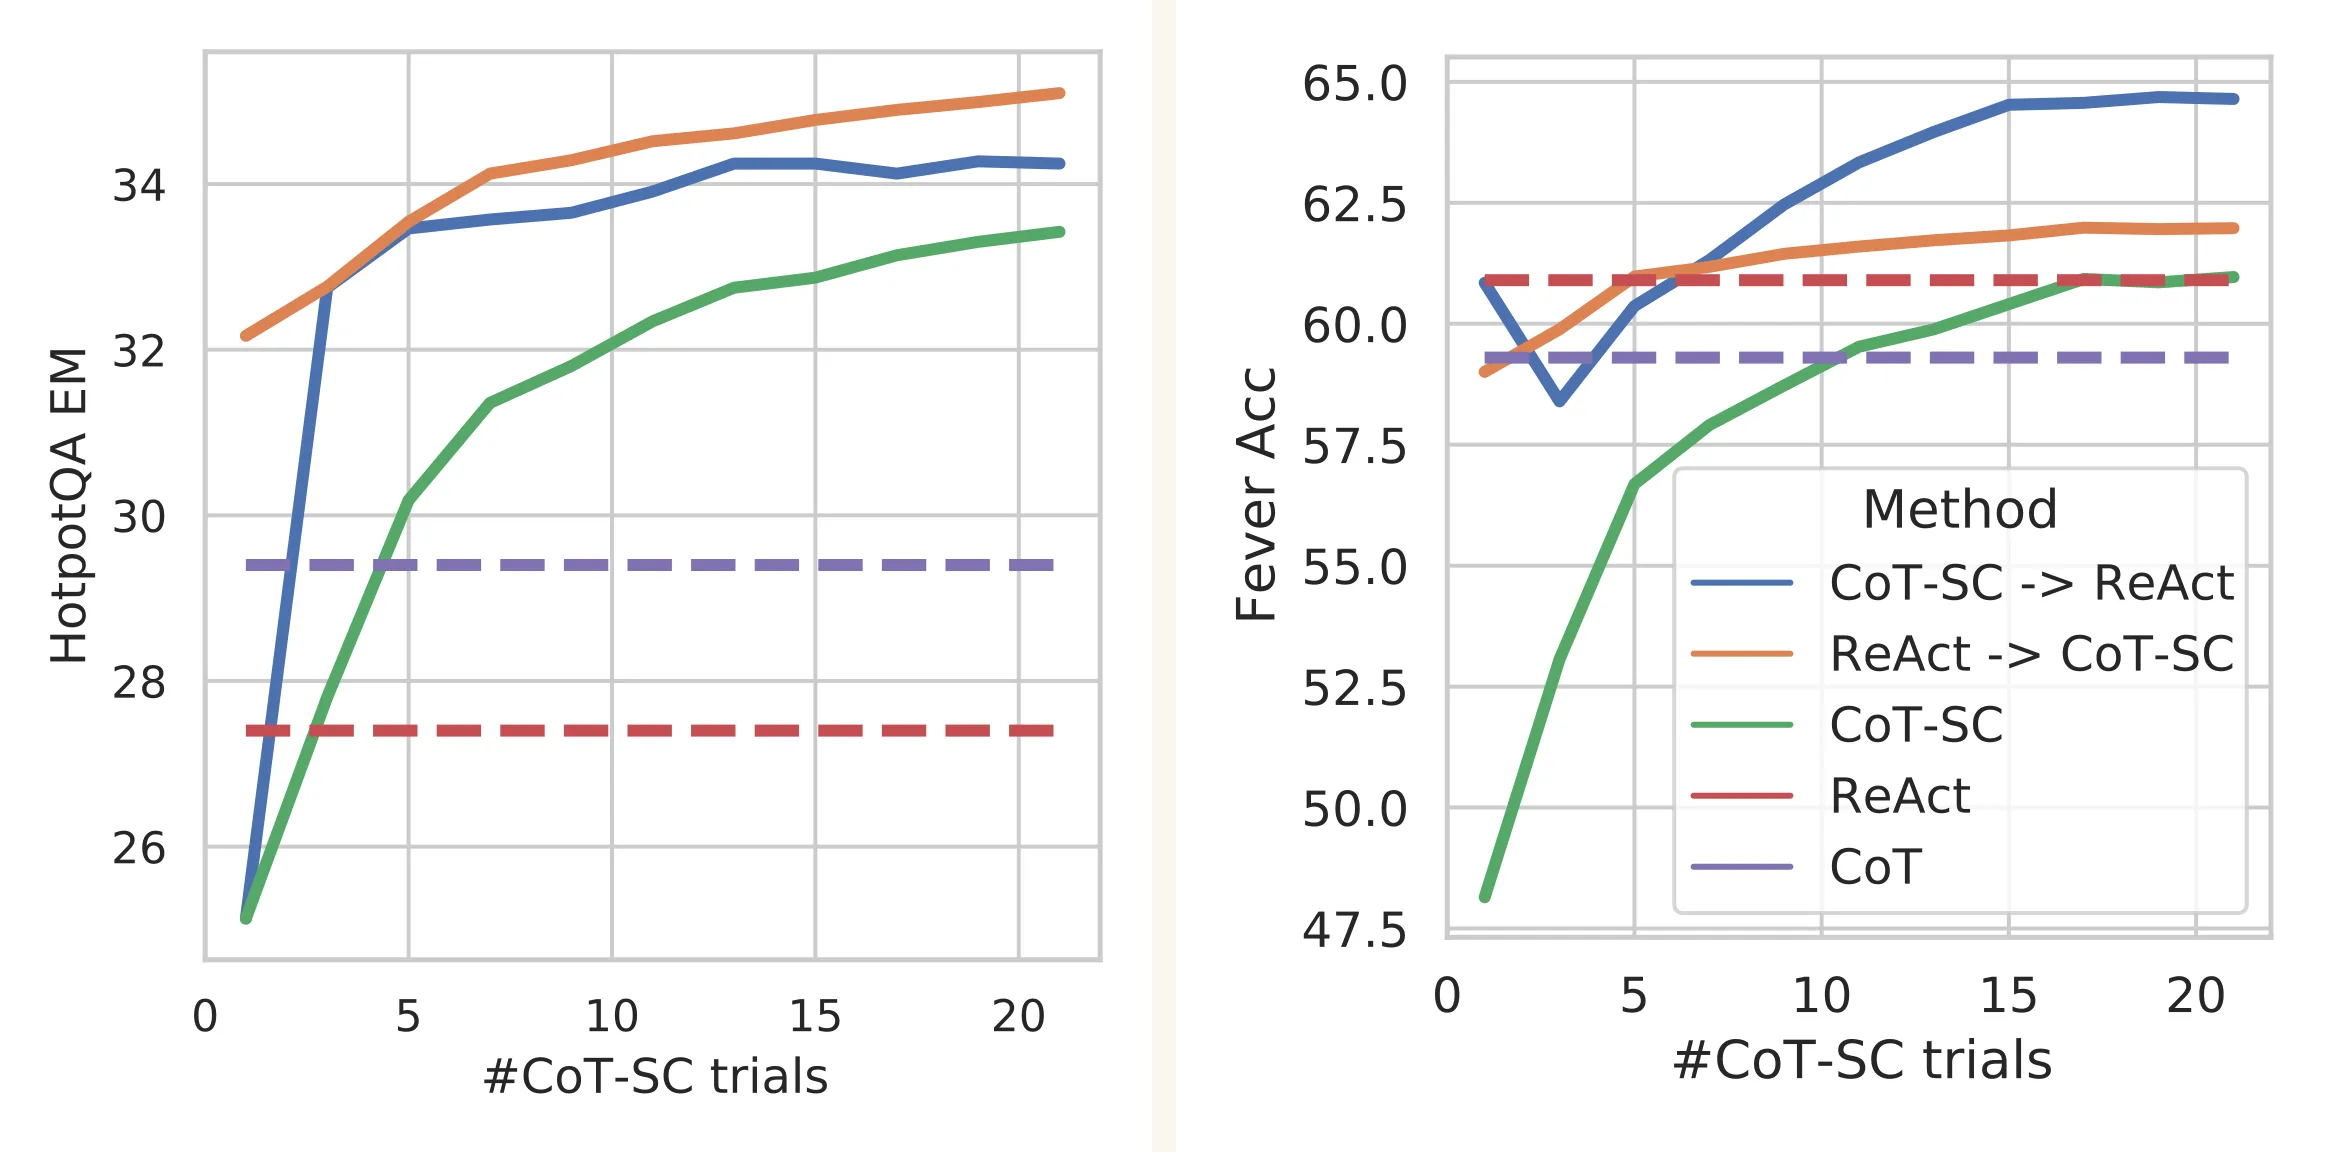
Figure 2,論文 Section 3.3:左為 HotpotQA EM、右為 FEVER Acc。兩條 ReAct↔CoT-SC 曲線在多數 sample 數上高於純 CoT-SC;虛線是純 ReAct 與純 CoT 的水平基準。原圖可定位到 Figure 2,取自 cots_scale.svg 與 fever_cots_scale.svg。arXiv HTML 標示 CC BY 4.0。


Table 2:分數反向時,失敗類型仍支持 groundedness
作者從 ReAct 與 CoT 各抽 50 條 EM 正確、50 條錯誤軌跡(共 200 條)做人工分類。這回答的不是「誰 EM 比較高」,而是「對的時候是否碰巧、錯的時候錯在哪」。
| Type | ReAct | CoT | |
|---|---|---|---|
| Success | True positive | 94% | 86% |
| Success | False positive(幻覺推理或事實仍被判對) | 6% | 14% |
| Failure | Reasoning error | 47% | 16% |
| Failure | Search result error | 23% | — |
| Failure | Hallucination | 0% | 56% |
| Failure | Label ambiguity | 29% | 28% |
CoT 失敗有 56% 是幻覺,ReAct 為 0%;成功裡的 false positive 也是 CoT 14% vs ReAct 6%。代價是 ReAct 的 reasoning error 升到 47%,外加 23% 搜尋空結果或無用結果。作者把重複生成同一組步驟也算進 reasoning error,並懷疑 greedy decoding 是原因之一。
這張表支持「交錯環境能降低幻覺」;它不支持「ReAct 的推理結構比較強」。它也無法外推到有副作用的 tool call:這裡的 search error 最多是查錯頁,不是誤刪資料。
Table 3:ALFWorld 的 +34% 來自分母不對稱的 headline
ALFWorld 問的是:在長視野、稀疏 reward 的家務遊戲裡,稀疏 thought 能不能勝過 Act-only 與模仿學習。控制條件是同一組人工軌跡去掉 thought 就是 Act;BUTLER 則是另一個方法,用約 條 expert trajectory、best-of-8。ReAct/Act 是 best-of-6。
All 欄:Act best-of-6 45,ReAct avg 57,ReAct best-of-6 71,ReAct-IM best-of-6 53,BUTLER best-of-8 37。Abstract 的 +34% 就是 71−37。論文也寫最差的 ReAct trial(48%)仍高於 Act 與 BUTLER 的最佳 trial;相對 Act 的增益在六次 controlled trial 為 33% 到 90%,平均 62%。
這支持「在這個 text game 上,稀疏 thought 比只輸出動作更有用」。它沒有在相同 trial budget 下比較 ReAct 與 BUTLER,因此 +34% 是 headline,不是 matched-budget 因果。它也不是真實機器人結果:環境是對齊 ALFRED 的文字遊戲。
Table 4:WebShop 的 +10% 是四捨五入的 SR 差
WebShop 問 noisy 真實商品頁上,one-shot ReAct 能不能勝過用 1,012 條人類軌跡訓練的 IL,以及再加 10,587 條 instruction 的 IL+RL。
| Method | Score | SR |
|---|---|---|
| Act | 62.3 | 30.1 |
| ReAct | 66.6 | 40.0 |
| IL | 59.9 | 29.1 |
| IL+RL | 62.4 | 28.7 |
| Human | 82.1 | 59.6 |
ReAct 的 SR 40.0 對 IL+RL 28.7,差距 11.3 個百分點,abstract 寫成 +10%。Score 的差距較小(66.6 vs 62.4)。作者觀察 ReAct 比較會用 thought 對齊 noisy observation 與選項。人類仍明顯更高,且會做更多商品探索與 query reformulation;prompting 還沒追上。
這不能讀成「ReAct 已達到可上線購物 agent」。研究基準也不能真的完成購買。
Figure 3:finetune 改變的是「比較誰會查」,不是再刷一次 540B prompt
因為人工標註 thought+action 很貴,作者用類似 STaR 的 bootstrap:拿 3,000 條答案正確的 ReAct(及其他 baseline)軌跡,finetune PaLM-8B/62B,讓小模型依問題解碼整段 thought/action/observation。Appendix B.1:batch size 64;ReAct/Act 訓 4,000 steps,Standard/CoT 在 8B 訓 2,000、在 62B 訓 1,000。作者發現 ReAct/Act 較吃 steps 與資料,Standard/CoT 很快退化。
Figure 3 的定性結果:prompting 時 8B/62B 的 ReAct 在四個方法裡最差,因為 in-context 要同時學會推理與行動。finetune 之後 ReAct 變成最好;論文寫 PaLM-8B finetuned ReAct 勝過所有 PaLM-62B prompting,PaLM-62B finetuned ReAct 勝過所有 540B prompting。作者的解釋是:finetune Standard/CoT 比較像在背(可能幻覺的)知識,finetune ReAct/Act 比較像在學怎麼查 Wikipedia。
本文不從圖上讀出未經論文寫明的精確 EM。這張圖支持「軌跡格式在小模型上可能比單純放大 prompt 更有用」;它不是公開可重跑的訓練曲線,因為 PaLM 權重一般不可取得,且 3,000 條正確軌跡本身由 PaLM-540B 生成。
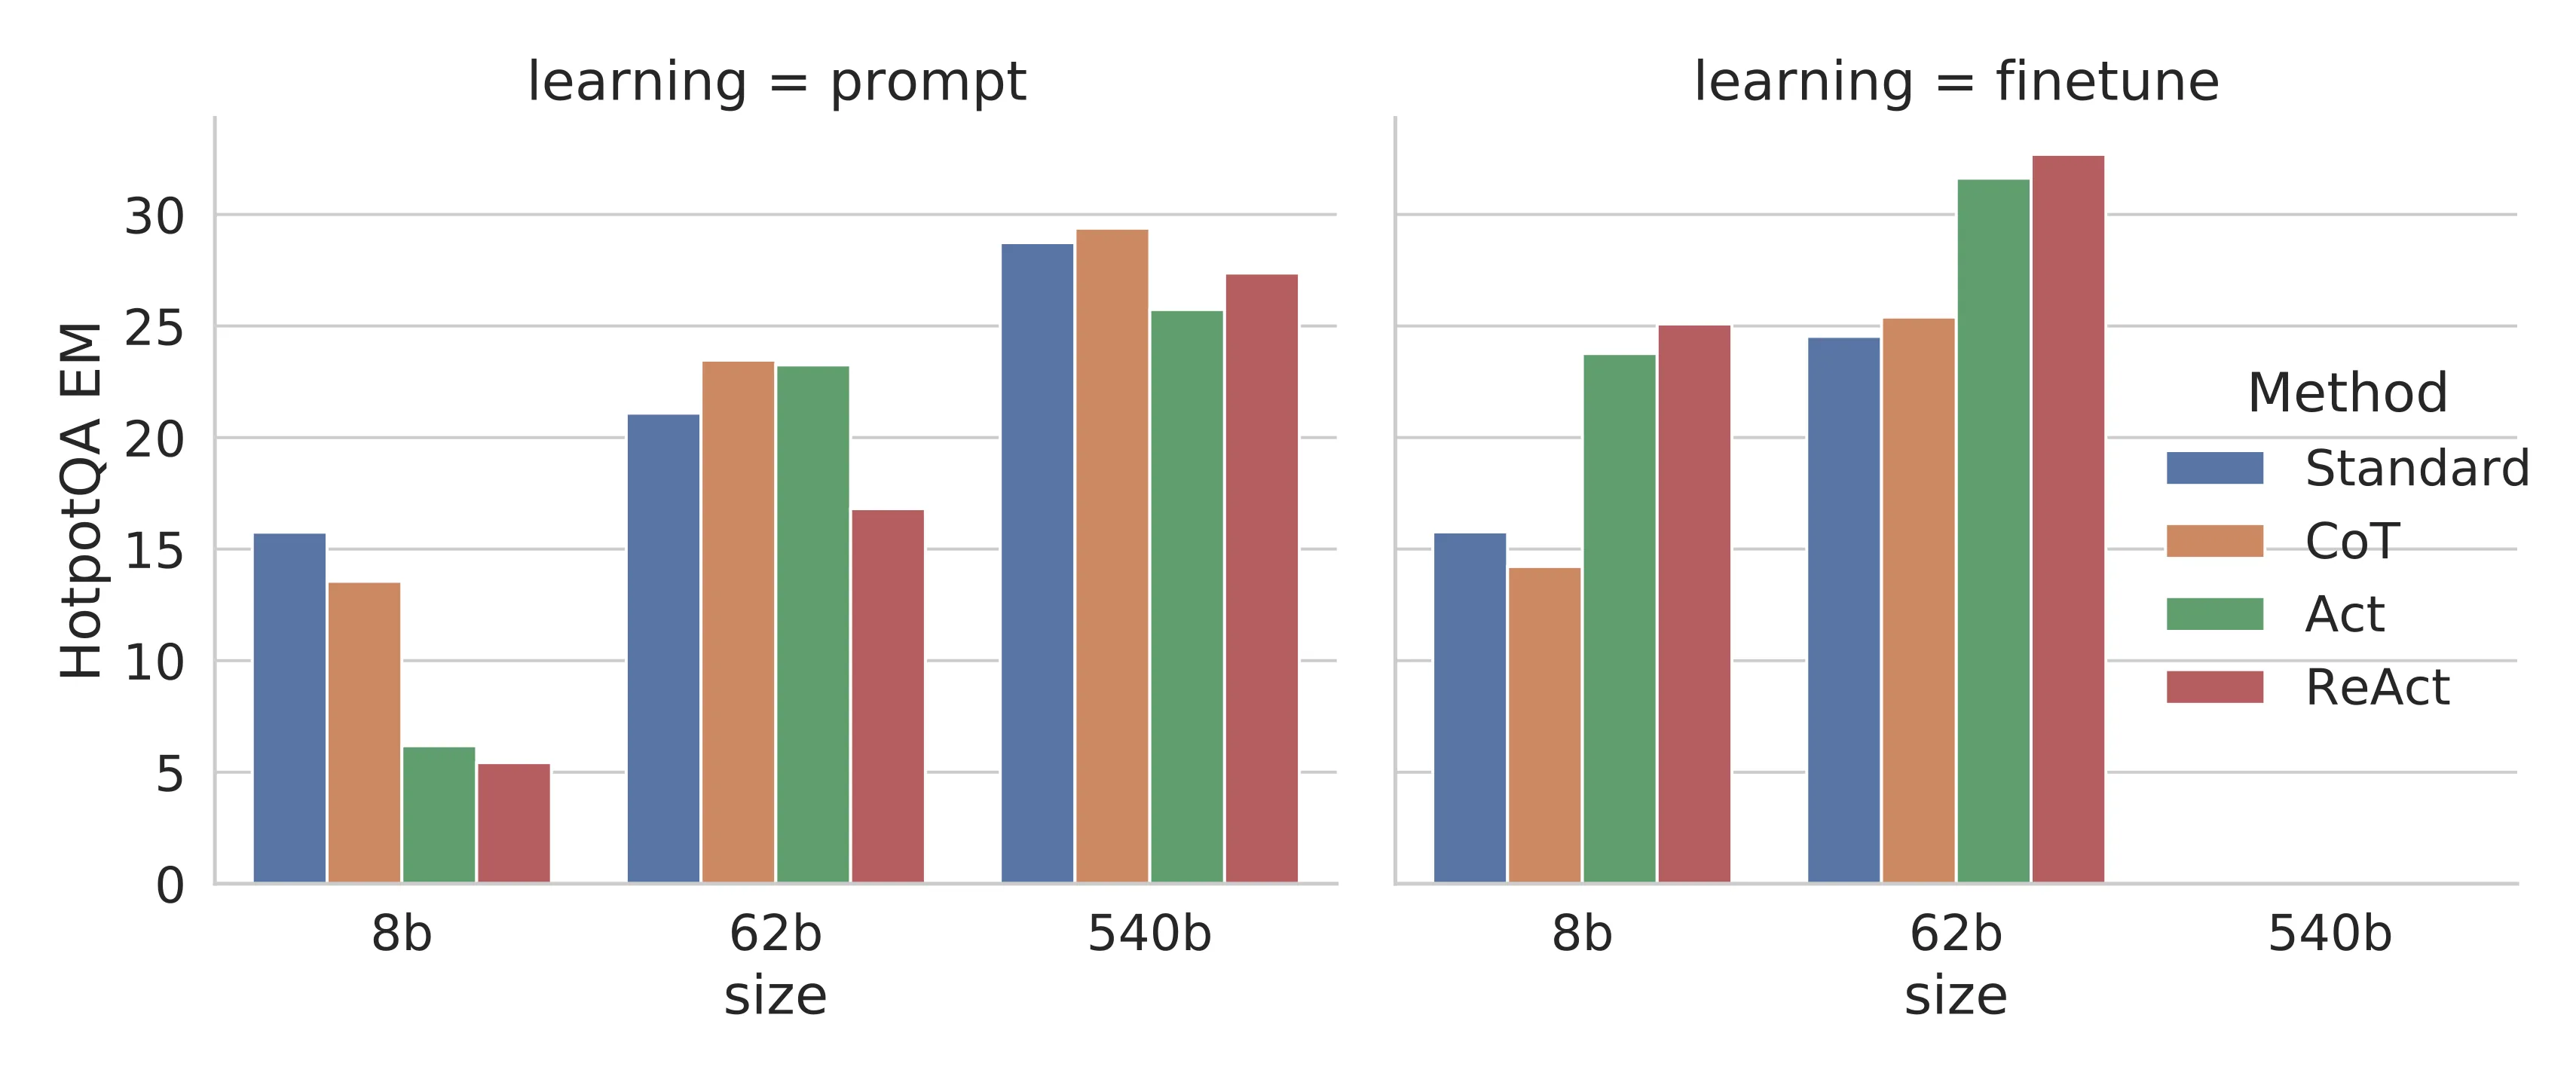
Figure 3,論文 Section 3.3:左為 prompting、右為 finetuning(無 540B finetune 點)。作者用來支持「小模型 finetune ReAct 可超過較大模型的 prompting」。原圖可定位到 Figure 3,SVG 為 hotpot_finetune.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

限制、威脅與不該過度推導的話 / Limitations and threats to validity
論文自己的限制已經相當明確。Conclusion 寫:複雜、大 action space 的任務需要更多 demonstration,很容易超過 in-context 長度;finetune 只是初期結果,更需要高品質人工標註。Ethics Statement 把互動限制在 Wikipedia 與 WebShop 研究環境,避免查隱私或執行危險動作。
另外幾條是讀表時必須留下的邊界:
- Abstract 的 +34%/+10% 不是 Table 1。 它們來自 ALFWorld 71 vs 37、WebShop SR 40.0 vs 28.7,而且 ALFWorld 的 trial budget 不對齊。
- HotpotQA 純 ReAct 沒贏 CoT。 若產品任務比較像多跳 QA、工具又很弱,先假設「加上 thought 分數一定比較高」會與 Table 1 衝突。
- Wikipedia API 是玩具檢索。 沒有權限、版本、citation graph,也沒有現代 retriever。live Wikipedia 還會讓 2023 年的軌跡與今日頁面不一致。
- PaLM-540B 不是一般可重現 runtime。 論文 Reproducibility Statement 已寫 PaLM 當時未公開。公開 repo 是 GPT-3 prompting notebook,README 的 500-example 表(HotpotQA 29.4、FEVER 62.2)與 Table 1 的 ReAct 27.4/60.9 並未對齊,不能互相替代。
- Table 5 的 GPT-3 比較要用 subset 口徑。 Appendix A.1 在 500 題 HotpotQA 與 134 個 ALFWorld 上報告 GPT-3(text-davinci-002)30.8/78.4,對應欄的 PaLM-540B 是 29.4/70.9。表題寫 ReAct prompting,但 29.4 與 Table 1 的 CoT 相同、與純 ReAct 27.4 不同。本文把它當「GPT-3 也可跑 ReAct 格式」的證據,不當成 Table 1 的第三套官方數字。
Appendix A.3 的人工改 thought 很有啟發:改 Act 17 與 Act 23 兩處 thought,就能讓失敗的 ALFWorld 軌跡成功。這是單一例,不是 human-in-the-loop 實驗;它支持「thought 是可編輯的控制面」,不支持「產品只要讓人改兩句就能對齊」。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 ReAct?當你需要一條可讀、可記錄、可中途改 thought 的軌跡,而且環境動作本身可審計:查文件、搜內部知識庫、在模擬器裡走動。這時應把 thought、tool name、arguments、observation、finish 分成欄位,而不是揉成一段散文。
什麼時候不要把這篇論文當成施工圖?
- 工具有寫入副作用、付費、或權限邊界時,不要複製 Wikipedia 三動作。
- 需要 retrieval quality、citation、或 schema validation 時,ReAct 沒有提供這些層。可對照站內的 RAG-MCP:那篇處理的是候選工具太多,不是 thought 介面。
- 需要把「搜到了卻沒讀證據就回答」單獨測出來時,看 推理之前就可能失敗。ReAct 的 Table 2 有 search error,但沒有 Read-Gate 那種程序性失敗分類。
- 需要 durable state、verifier 與 rollback 時,看 Argus。few-shot ReAct 沒有控制平面。
- 若瓶頸是模型根本沒學過 tool affordance,而不是 prompt 裡缺 thought,看 MidTool。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文: arXiv abs、v3 PDF、HTML 可讀,license 為 CC BY 4.0。OpenReview 頁為 WE_vluYUL-X。
- Project page:react-lm.github.io 可開啟,內容是論文導覽而非可執行服務。
- 程式與 prompt:ysymyth/ReAct 可存取,MIT License。可見
hotpotqa.ipynb、FEVER.ipynb、alfworld.ipynb、WebShop.ipynb、wikienv.py,以及prompts/下的prompts_naive.json、fever.json、ALFWorld JSON。這是 GPT-3 prompting 代碼,不是 PaLM 訓練代碼。 - 模型:PaLM-540B/8B/62B 不是一般可下載 checkpoint。論文已聲明主實驗因此難以重現。GPT-3 text-davinci-002 本身也已不是預設公開 API。
- 資料環境:HotpotQA、FEVER、ALFWorld、WebShop 需各自安裝;Wikipedia 實作打 live 站,不是凍結 dump。
最小有用 reproduction 是:用公開 notebook 的 prompt,對一小撮 HotpotQA 題跑 search/lookup/finish,檢查 thought 是否不改 wiki 狀態、以及空搜尋時模型會不會重複同一動作。不要宣稱這能復現 Table 1 的 PaLM-540B 數字。
三個記憶點 / Three things to remember
- 技術想法:ReAct 把 裡的 thought 加進 action space;thought 只更新 context,環境動作才換來 observation。
- 證據:決策任務上 few-shot ReAct 明顯高於 Act 與當時的 IL/RL baseline;QA 上它比較能減少幻覺,但純 ReAct 的 HotpotQA EM 並沒有贏過 CoT,headline 最佳值來自切換。
- 邊界:這是 1–6 條人工軌跡加上被故意做弱的 Wikipedia API,加上不可取得的 PaLM。可審計契約可以搬;runtime、工具治理與 retriever 不能從這篇論文推論已經完成。
延伸閱讀
ReAct 處理的是「想」與「做」要不要交錯。接下來可依問題選讀:
- 工具 schema 太多:RAG-MCP。
- 是否要在 mid-training 先教工具:MidTool。
- 搜尋後是否真的讀取證據:推理之前就可能失敗。
- 長期任務的 runtime 與 rollback:Argus。