90 秒掌握論文 / The paper in 90 seconds
- 問題:長程 Agent 的 trace 會同時超過兩個消費者的能力。人類 observer 需要在執行中知道「現在做什麼、哪些事情已經確定、還缺什麼」;Agent worker 則必須把同一條不斷變長的 trace 放回有限的 context。只保留尾端會丟掉早期事實,直接把整條歷史塞回每一回合又會讓 token、成本與錯誤一起增長。
- 核心洞見:不要為 worker 與 observer 各自做一個彼此不一致的摘要器,而是把 trace 先寫成 append-only typed ledger,折疊成帶有來源與 coverage 的
RunState,再從這個 state 編譯出不同消費者需要的 view。 - 最強證據:在 12 份真實 transcript、每個 condition 70 個監控問題的 COMPREHEND 評估中,compiled view 的 Sonnet 5 accuracy 為 0.871、Haiku 4.5 為 0.850;raw tail 分別只有 0.479 與 0.476。CONTINUE 的 120-link clean protocol 則是 curated fold 30/30、scratchpad 30/30、full context 8/30(Table 1–2、Figure 2–3)。
- 主要邊界:這些結果是 schema coverage 與任務形狀的條件式證據。作者自己在 alternating-sign chain 上展示 fold 會失去優勢,也承認 benchmark–system co-evolution、單一 vendor、固定 schema、單 session,以及 prompt injection、secret redaction、多 Agent ledger 尚未被測試。
我的 bounded verdict 是:Parsing the Stream 最值得帶走的不是「摘要比原文好」,而是把 trace 變成一個可重播、可驗證、可為兩個消費者服務的 state machine。對需要累積統計或清楚 provenance 的 Agent,這是很實用的架構假說;對未知操作、未定義 schema 或不受信工具輸出,它還不是安全的通用壓縮器。
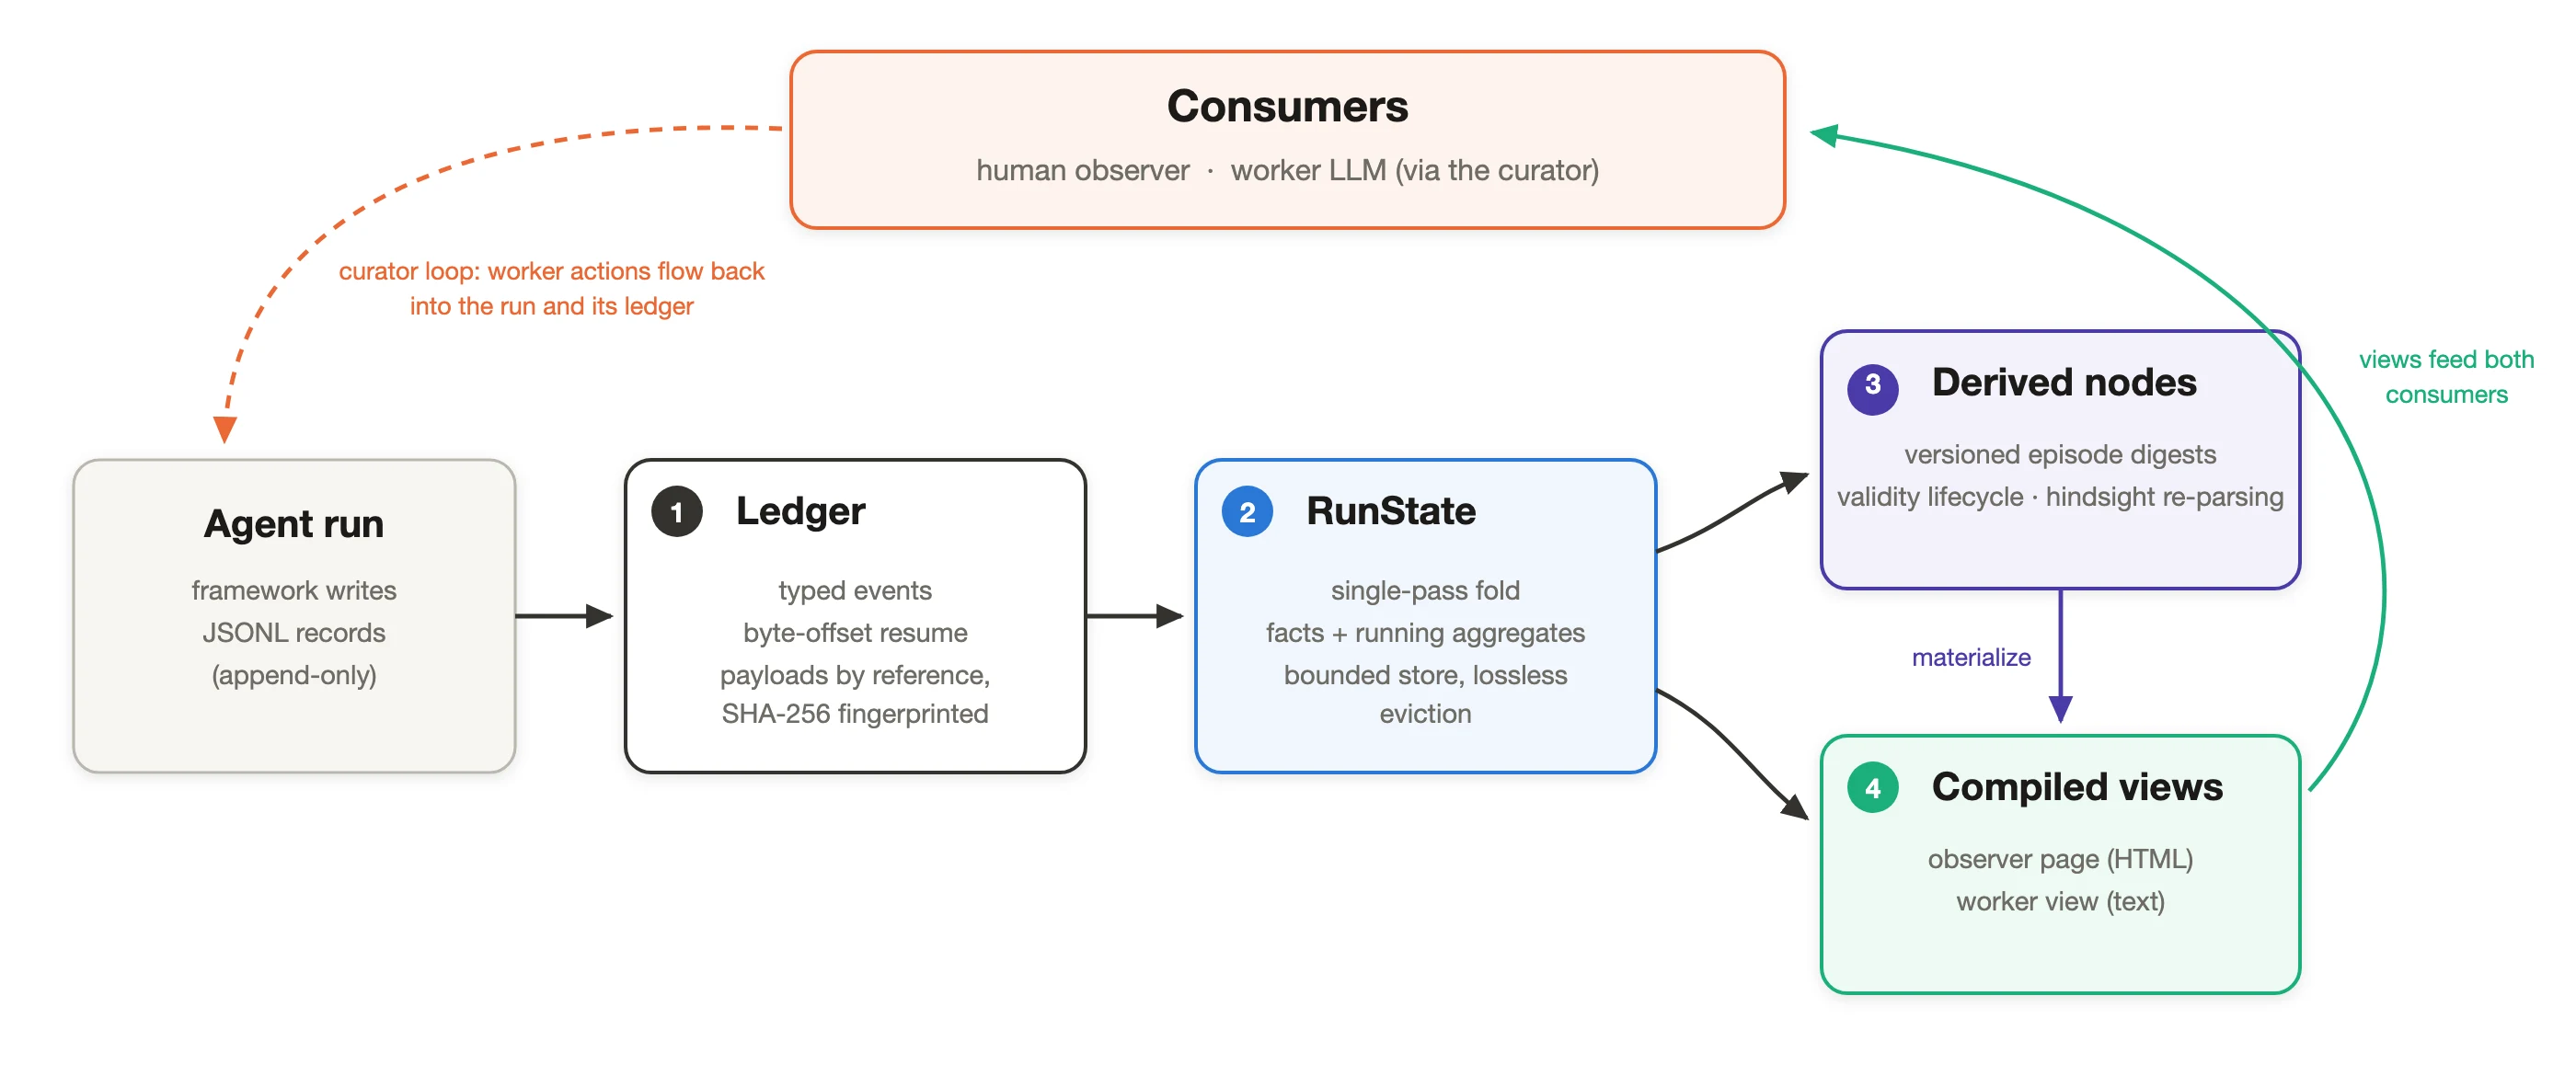
Figure 1,論文 Section 3 的 live trace model:agent run 先產生 append-only JSONL,再經 typed ledger、single-pass fold、versioned derived nodes,最後編譯成 observer page 與 worker view;curator loop 會把 worker 自己的行動再送回 ledger。原始 Figure 1 · 原始圖片端點。圖像取自 arXiv HTML;該頁面標示 CC BY 4.0,本文保留來源與 attribution,並將 PNG 轉為 WebP。

這篇到底在解哪一個問題 / What problem is this paper solving?
一個 Agent run 不只產生最後答案,還會產生一條會持續增長的 trace:user turn、模型訊息、thinking、tool call、tool result、檔案變更、錯誤、retry、compaction summary 與成本欄位。這條 trace 有兩個不同但互相牽動的消費者:
- Human observer 要在途中監控 run。它想知道目前 goal、frontier、pending call、已觸碰的檔案、錯誤與成本,而不是閱讀一個可能已經被截斷的 JSONL 尾巴。
- Worker LLM 要在下一個 turn 繼續做事。它不能無限保留全部歷史,因此必須把早期觀察折回一個小而不會遺失關鍵狀態的 context。
論文 Section 1 用兩個尺度說明 raw trace 的問題:12 份真實 session 合計 112 MB;在 observer 端,frontier model 讀取 raw tail 的 accuracy 只有 0.479,12 個 panel calls 的 input 約 779K tokens。在 agent 端,120-link sequential-dependency workbench 讓 full-context worker 的累計 billed input 到 2.37M tokens,開發期的成功率落到 7/30;final clean protocol 的 full context 也只有 8/30。這些數字不是「所有長 context 都會失敗」的定理,而是作者用來建立控制問題的實驗設定。
既有做法為什麼不夠 / Why the obvious approaches are insufficient
先把幾個容易混在一起的 baseline 分開。
Raw tail:便宜,但只保證最近
把 trace 截成最後一段能控制 input budget,卻不能保證早期事實仍在 view 裡。若 observer 問「所有檔案裡的 delta 總和是多少」,最新的幾個 tool result 可能回答不了。論文的 COMPREHEND 結果也呈現這個差異:latest-ask 這類依賴 recency 的問題在 raw tail 上還能拿到 0.833,但 whole-run aggregation 的 files 問題只有 0.13–0.20;它不是每個問題都同樣困難。
Flat log 或一般 summarization:比 raw tail 短,不等於知道該保留什麼
flat log 把整個 run 做成較緊湊的文字,輸入比 compiled view 多約 8 倍,卻仍落後於 view。作者還測試約 400-word cap 的 rolling summarization:在 30、60 links 都是 0/3;移除硬上限後,30 links 是 3/5、60 links 是 4/5,120 links 的方向性 cell 是 3/10。這個對照很有意思:沒有告知讀者「被截斷了」的 length budget,本身就可能成為一個靜默的錯誤來源。
Retrieval:能找相關片段,但不一定能完成累積
論文在 chain task 上測了 retrieval-over-own-trace:保留最近五步,再用 token-overlap 選最多十個過往步驟。120 links 仍是 0/10。作者的解釋不是「retrieval 永遠無用」,而是這個任務要求「把所有 delta 都加起來」;relevance ranking 很難選出一組必須全部保留的資料。這個結果把問題從「外部 state 有沒有用」改成更精確的問題:state 是否顯式攜帶任務需要的統計。
Worker scratchpad:成功,但不等於 trace model 的全部價值
在 final protocol 中,cached scratchpad 也是 30/30,而且每 run 約 $0.97,比 curated fold 的 $1.59 便宜。這是重要的負面或競爭證據:paper 沒有證明 deterministic fold 在 chain accuracy 上勝過一個寫得好的 worker note。它把 fold 的額外價值放在三件事:不用依賴 worker 自己記得寫 note、state 的計算可重播與可稽核,以及 observer 可以和 worker 共用同一份 fold。若只看 task success,scratchpad 可能已經足夠;若還要問「這個數字從哪裡來」,比較就不一樣了。
核心直覺:把 trace 從文字歷史改成 state machine / Core intuition: make the trace a state machine
這篇真正改變的控制點不是「使用更好的摘要 prompt」,而是 trace 的中間表示。
以前的心智模型通常是:
raw trace → 截斷、摘要或 retrieval → 下一個 prompt
作者提出的心智模型是:
agent run → append-only events → typed ledger → deterministic RunState → consumer-specific views
可以把這個流程抽象成兩個操作。第 個事件是 ,前一刻的執行狀態是 ,fold 做的是:
這裡的 不是一段自然語言摘要,而是包含 goal、frontier、pending calls、turn/tool/error counters、files,以及帶有 source identity 的 facts 與 running aggregates。接著,針對 consumer 編譯 view:
可以輸出 HTML page、anomaly badge、stat card、episode drill-down 與 provenance links; 則輸出較短的 GOAL / NOW / ANOMALY / COUNTERS / FILES / KEY FACTS 區塊。這兩個 view 可以長得不同,但來源是同一份 。因此,Fold 控制的是「狀態如何被保留」,Compile 控制的是「誰需要看哪一種投影」。
這個分層也讓 deterministic 與 non-deterministic 的邊界變得清楚:非 extractor path 的 fold、aggregate 與 renderer 可由測試重播;選配的 semantic extractor 是 LLM,它的輸出可以按 event memoize、帶 provenance,卻不能在 cache 遺失或模型退役後宣稱跨環境 deterministic。
用一個 120-link chain 走完整個方法 / Walk one representative input through the method
以下是依照論文 CONTINUE chain family 做的忠實、簡化 walkthrough;它用來說明資料流,不是另一組實驗結果。
- Input:第一個檔案指向下一個檔案,每個檔案帶有一個 delta;目標是沿著 120 個 dependency links 走完,將全部 delta 加總並寫出
total = <sum>。這個 chain protocol 會關閉 search,避免 Agent 只用外部搜尋繞過依賴。 - Intermediate representation:agent run 寫出 append-only JSONL。adapter 把每個 content block 轉成 typed event,保存 tool-call/result correlation、byte offset、cache-aware usage 與原始內容的 SHA-256 fingerprint;payload 多半以 reference 保存,malformed line 被 quarantine,unknown record type 也不被靜默丟掉。
- State transformation:fold 將
node/<id>:delta以 source-scoped identity 放入 facts。當 bounded store 必須 eviction 時,早期 numeric values 不會消失,而是折入 per-key running count 與 sum;重新讀取同一事件不應重複計算。Renderer 另外把 coverage 寫進 aggregate,告訴 worker aggregate 已經包含到哪一個 source。 - Decision and output:worker 每五個 step 由 curator 從自己的 trace 重新 materialize compact view,再搭配最後五個 raw steps。它不是每次把 120 個檔案重新放入 context,而是看到目前 frontier、錯誤、工具計數與
[aggregate] delta: 120 values total, sum = 5281這類帶 coverage 的狀態,最後寫出答案。 - Likely failure point:如果 aggregate 已涵蓋最後一個檔案,但 view 沒有明確說明涵蓋範圍,worker 可能又把該檔案加一次。論文分析的五個 curated misses 都是這種 last-mile ambiguity:fold 顯示的 total 其實正確,worker 卻多加了最後一個已包含的 delta;加入 coverage stamp 後,五個 motivating failures 都被重新跑回成功。
這個 walkthrough 的重點不是 sum 這個算術,而是 intermediate representation 改變了。raw history 只是一串事件;RunState 把它變成可查詢、可限制大小、可指出涵蓋邊界的物件。
技術機制:四層 live trace model / Technical mechanism: the four layers
1. Ledger:append-only 不是口號,是 parser 的前提
在論文 Section 3,ledger 主要是一個 typed event stream。source framework 原本每個 content block 可能重複帶著同一筆 message-level usage;adapter 把 block 轉成事件時,保留 causal chain、tool-call/result pairing、cache-aware usage,並以 reference 指向 payload。對 message、thinking、tool call、tool result、compaction summary 等 content-bearing record,完整原文會有 SHA-256 fingerprint;因此 view 只內嵌 bounded excerpt 時,仍能知道它對應哪份原文。
parser 同時有幾個工程防線:
- 在觀察到的 append-at-tail、沒有 rotation/truncation/replacement 的 writer discipline 下,byte offset 可作為 resume token;parser 不會消費半行。
- malformed lines 會被 quarantine 並計數,unknown record types 則保留;這讓 observer page 可以誠實標示 materialization point 與 malformed count。
- block-exploded transcript 若不依 API message id 去重,token accounting 在驗證 session 中最多膨脹 3.49 倍;這不是 cosmetic bug,因為成本與 token ratio 會一起被算錯。
- 十個最大 transcript 共 104 MB、16,737 events,在一顆 Apple silicon performance core 上 warm-cache、single-threaded parse 約 0.4 秒;作者特別說這是 indicative timing,不含 optional LLM extraction 與 view materialization,不能當成完整 benchmark。
2. RunState:bounded store 不等於只留最新值
RunState 由 single-pass fold 產生。它保存執行位置、goal、frontier、pending calls、SDK 沒有暴露的 counters、觸碰過的 files,以及 facts。fact 的 key 以 source scoped identity 表示,例如 file:key;同一 key 在不同 occurrence 重複出現時,每次 observation 都算一次,而不是採 newest-wins。
bounded store 的關鍵是 aggregate-preserving eviction:當 in-view facts 太多,舊 numeric value 可以從可見 store 移出,但它的 count 與 sum 仍折到對應 aggregate。這種 eviction 只保證被宣告要追蹤的統計;它不假裝保留了所有任意細節。因此,若未來問題需要 median、順序、關聯 pair 或某種非交換操作,系統必須先把那些資料模型化,不能用現有 sum 當成萬用替代。
論文以兩種 oracle 檢查這一層:fold 的 chunked ingest 與 whole-file parse 通過 property test;從 raw JSONL 重新寫的 independent recount 在五條 120-link trace 上,per-key facts 與 aggregate sums 零 mismatch,另有 8/8 bookkeeping fields 的 mutation-tested fidelity。
3. Derived nodes:修正過去,但不覆寫過去
live run 可能產生跨 turn 才能辨識的狀態。例如 interrupted turn 只有等下一個 user turn 抵達、發現 calls dangling 時才看得出來;late result 也必須掛回原來發出它的 episode。為了處理這類 hindsight re-parsing,derived node 不是被新結果直接改寫,而是保存 versioned episode digest,並有 current、suspected-stale、invalidated/superseded 等 validity lifecycle。
這個設計把「現在的最佳解讀」與「當時曾經產生過的解讀」分開。對 incident review 或 audit 而言,這比一份永遠只剩最新摘要的 log 更有價值;對 production 而言,也代表 schema version、staleness propagation 與 terminal-state guard 都要成為真正的 migration contract,而不只是 prompt 裡的一句話。
4. Compiled views 與 curator:同一份 state,兩個讀法
observer view 是 HTML page,包含 goal、live frontier、anomaly badges、stat cards、episode drill-down、provenance links,以及 materialization point 與 malformed count 的 honesty watermark。worker view 是 compact text,將 key facts、running aggregates、files、counters 與最後幾步排成模型比較容易讀的格式。
curator 在 deployed setup 中每 steps 從 worker 自己的 recorded trace 重新 materialize worker view。這讓 worker 的 actions 會回到它所依賴的同一個 substrate,形成一個 closed loop:
worker action → ledger → fold → state → worker view → next worker turn
它也暴露一個採用上的問題:如果 curator 只是另一個「偷偷摘要」的 LLM,observer 看到的 view 與 worker 讀到的 view 可能再次分叉。因此 paper 將 deterministic fold、provenance、coverage 與可重播的 renderer 放在比 prose summary 更核心的位置。
實驗如何讀:observer leg / How to read the observer evidence
COMPREHEND 問了什麼?
COMPREHEND 使用 12 份真實 transcript,總量 112 MB;每個 condition 有 70 個 monitoring questions,每個 transcript-condition 做一次 reader call。LLM reader 是 observer proxy,不是 LLM judge:問題由 ledger ground truth 機械產生,答案以 exact match、substring 或 set-F1 評分。
| reader / condition | raw tail | flat log | compiled view |
|---|---|---|---|
| Sonnet 5 accuracy | 0.479 | 0.621 | 0.871 |
| Haiku 4.5 accuracy | 0.476 | 0.522 | 0.850 |
| Sonnet 5 panel input | 779K tokens | 479K | 57K |
| Haiku 4.5 panel input | 652K tokens | 372K | 43K |
| Sonnet 5 panel cost | $2.37 | $1.59 | $0.42 |
| Haiku 4.5 panel cost | $0.53 | $0.32 | $0.08 |
這個實驗測什麼? 它測一個沒有直接 API access、只能讀文字 rendering 的 consumer,在固定 budget 下是否能從 view 找到 run state。控制了什麼? transcript、question builder、reader、讀取 budget 與 grading rules;改變的是 raw tail、flat log 或 compiled view 的表示。觀察到什麼? view 對兩種 reader 都把 accuracy 拉高約 0.37–0.39,並讓同一 reader 的 input tokens 降低約 14–15 倍。合理解釋是什麼? aggregation 把超出 budget 的 whole-run facts 保存下來,而不是只讓最近文字變短。不能推出什麼? 不能推出 LLM 是必要的,也不能推出任何未被 schema 覆蓋的監控問題都會改善。
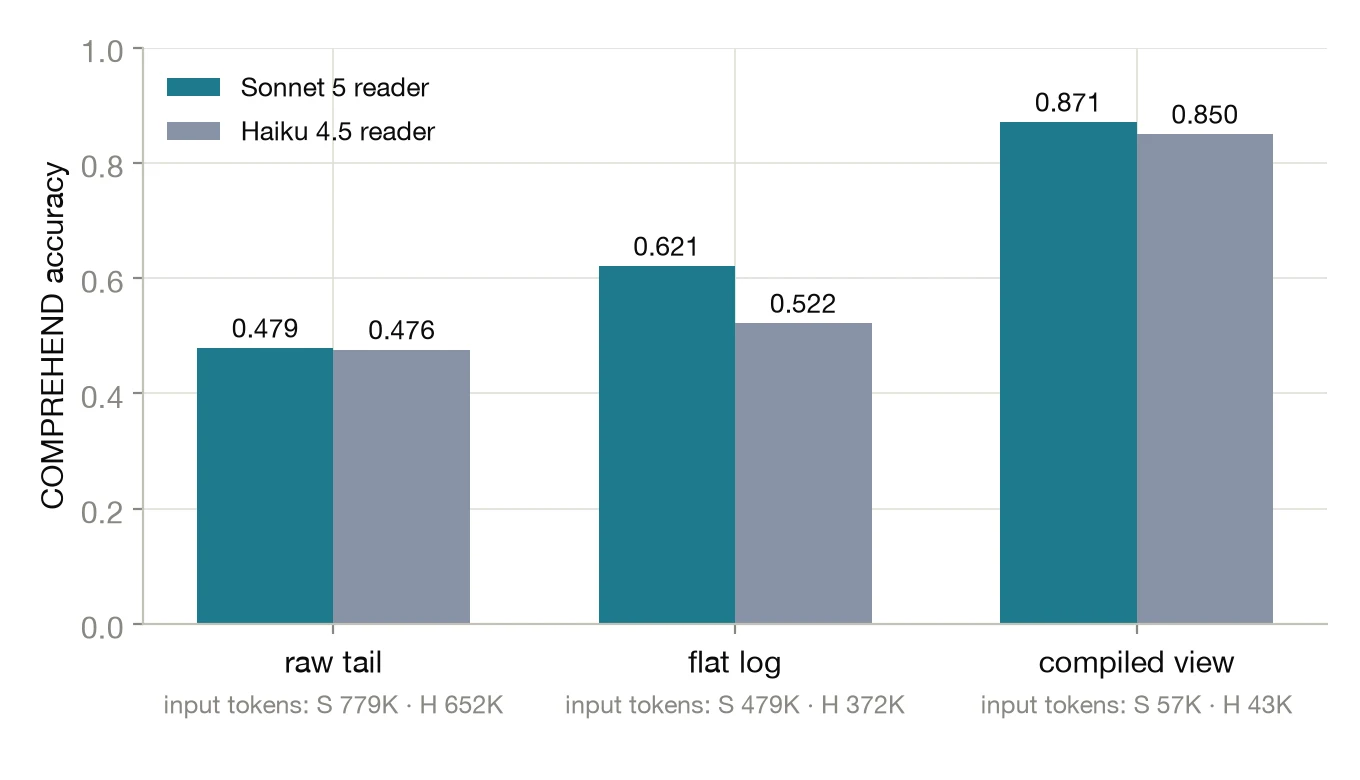
Figure 2,論文 Section 5.1 的 COMPREHEND accuracy:compiled view 在 Sonnet 5 與 Haiku 4.5 都高於 raw tail 與 flat log,但問題是 schema-co-designed。圖中的 token 數是 12 個 reader calls 的 panel total,不是單次 call;原始 Figure 2 · 原始圖片端點。圖像取自 arXiv HTML,頁面標示 CC BY 4.0;本文保留 attribution,並將 PNG 轉為 WebP。

要注意兩個校正。第一,compiled view 的 0.871/0.850 與 raw tail 的 0.479/0.476 是同一實驗條件下的 accuracy,但跨模型的約 30 倍 cost ratio 混合了模型 tier 定價;比較應優先看同一 reader 的 5–7 倍成本差。第二,這 70 題不是獨立於 schema 的通用 observer exam。作者指出 whole-run aggregation 題目幾乎都需要 view,但 dangling-call 題在 12 份 transcript 中大多是 none,每個 condition 都拿到 0.917,幾乎沒有區分度。
作者也提供 transcript-level bootstrap 95% intervals:Sonnet view 0.86 [0.78, 0.93] 對 raw 0.51 [0.42, 0.61];Haiku view 0.81 [0.74, 0.88] 對 raw 0.46 [0.39, 0.54]。這些區間只量測固定、size-selected corpus 的 transcript resampling,沒有量測 reader-call noise,也不代表更廣泛的 session population。
實驗如何讀:agent leg / How to read the agent evidence
CONTINUE workbench 的 chain family 讓每個 file 指向下一個 file,答案是所有 delta 的 sum,並以 deterministic final environment state 判定 success。這個設計有一個優點:它把「context policy 是否能保留累積統計」拆出來;也有一個代價:task generator、fold mechanism 與延伸實驗是共同發展的。
主要比較:clean protocol,120 links,
| arm | success | 每 run 成本 | cache |
|---|---|---|---|
| curated view(fold) | 30/30 | $1.59 | cached |
| scratchpad(full context + note instruction) | 30/30 | $0.97 | cached |
| full context(flat) | 8/30 | $7.13 | uncached |
這是 Table 2 的 final protocol:相同 seeds、shipped renderer、沒有 injected errors。curated 對 full context 有 22 個 sole successes、0 個 sole failures;exact McNemar two-sided ,但作者把它標成 descriptive,因為設計不是 preregistered,且任務與 system co-developed。最重要的比較不是「fold 打敗 scratchpad」——兩者都是 30/30——而是 fold 將 deterministic、auditable state 與 observer view 放到同一個 substrate。
控制組告訴了什麼?
Figure 3 與 Table 3 的 development-era grid 把結果拆得更完整:120 links 的 full context 是 7/30、curated 是 25/30、cached scratchpad 是 26/30;mask + notes hybrid 是 10/10;calculator tool 也是 10/10,但成本約 $14.88;retrieval-over-trace 是 0/10;uncapped summarization 在 120 links 是 3/10。這些 control 的訊息是:
- 需要保留 running statistic 的方法都可能成功。fold 不是唯一能通過 chain 的機制。
- prompting 本身是 first-order treatment。只加一個讓 worker 寫 per-step note 的 instruction,就把 development-era full context 從 7/30 推到 cached scratchpad 26/30。
- context packaging 與 caching 改變成本。flat full context 不 cache;cached notes 可以比 curated fold 便宜。因此不能把 $1.59 對 $7.13 讀成 trace model 本身必然便宜。
- 「有外部 state」不是足夠條件。retrieval 把整條 trace 放在外部仍失敗,因為 top-k relevance 不會自動保存「全部都要加」的統計。
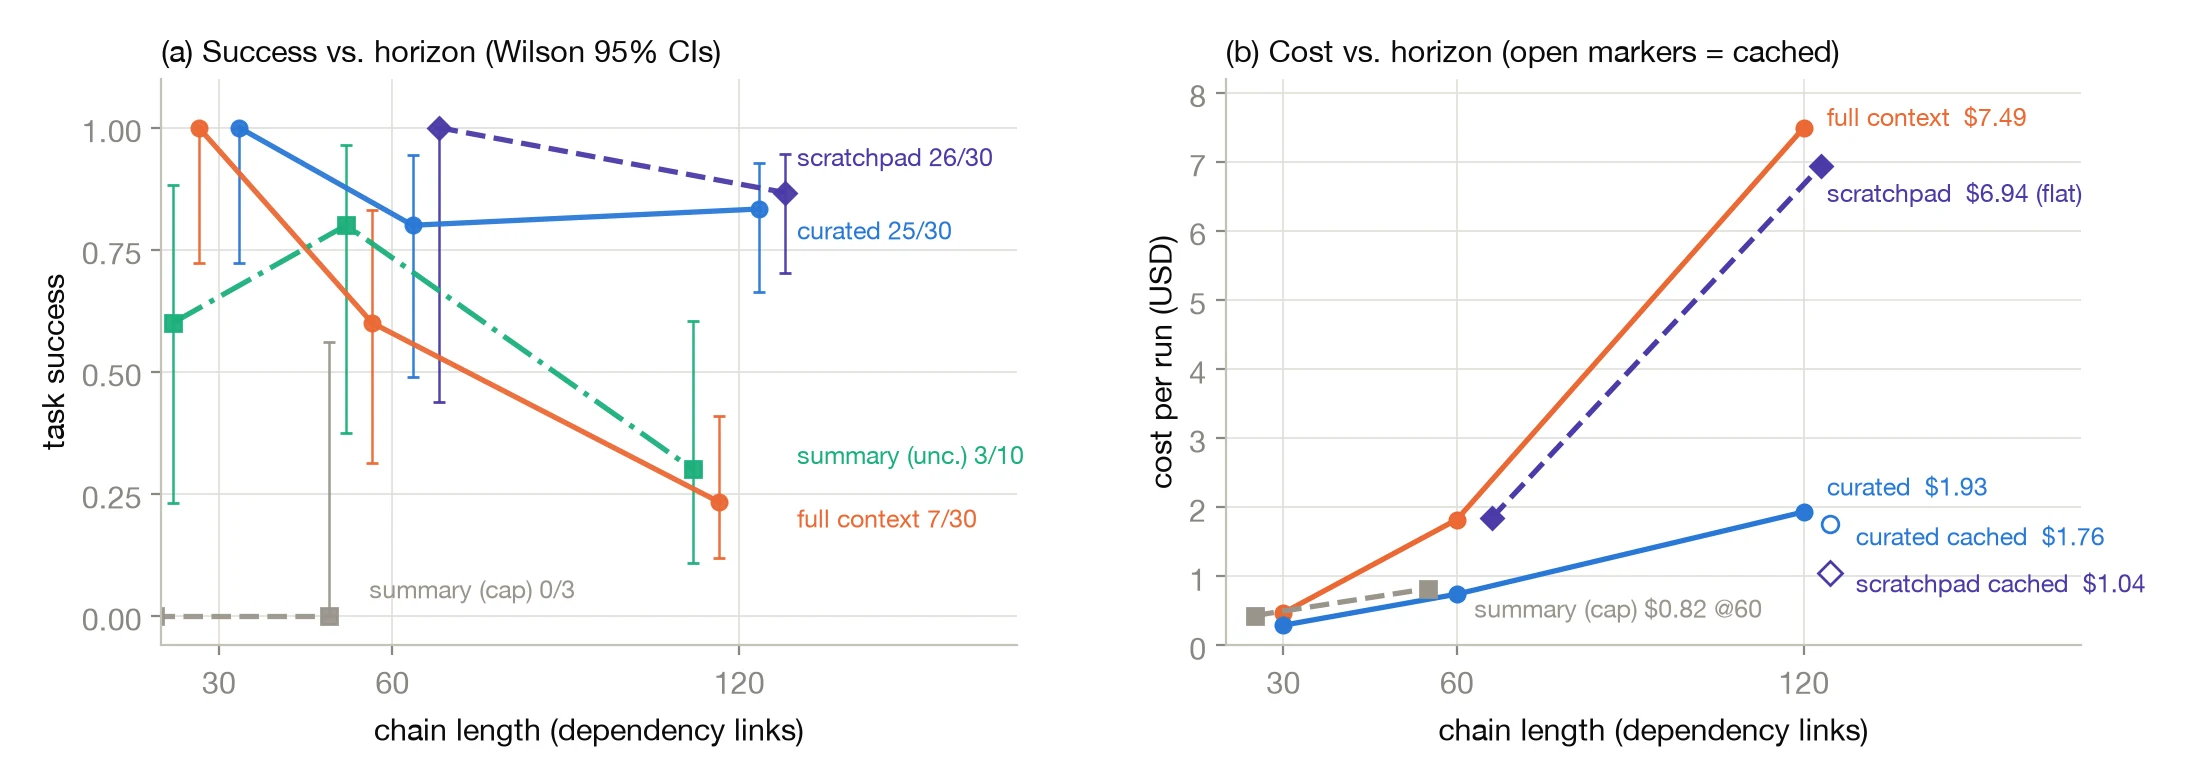
Figure 3,論文 Section 5.2 的 development-era grid:左側是 success by horizon,右側是 cost by horizon;120-link 的 primary clean comparison 在 Table 2,不應把圖內不同 cell size 與 injected-error protocol 混成同一個排行榜。原始 Figure 3 · 原始圖片端點。圖像取自 arXiv HTML,頁面標示 CC BY 4.0;本文保留 attribution,並將 PNG 轉為 WebP。

十一條 requirement:哪些失敗迫使 state 變得更嚴謹? / Eleven requirements surfaced by failure
論文沒有把 11 條規則宣稱成一個預先設計、已被 factorial ablation 證明的普遍定律。它們是 sequential development ladder 中「某個變體失敗 → 找到缺少的 property → 加入實作與 regression test」的結果。這種寫法很適合工程讀者,因為它把資料模型的每一個欄位和一個曾經真的出錯的 failure mode 連起來;同時也提醒我們,這些是針對目前任務類型的 hypotheses。
| # | requirement | 它防止的失敗 |
|---|---|---|
| 1 | carry facts, not references | view 只留下檔案 reference,worker 反覆重讀;把內容 pin 進 state 後,scatter 從 0.20 回到 1.000 |
| 2 | occurrence identity, not newest-wins | 同一 key 的多個 delta 被壓成最後一筆 |
| 3 | never truncate silently | renderer 顯示 complete list,但實際只留最後 40 筆,總數因此錯誤 |
| 4 | source-scoped identity | 不同檔案恰好有相同 value 時被錯誤合併 |
| 5 | deterministic running aggregates | 30 個值到最後才做 arithmetic,容易發生 end-stage slip |
| 6 | aggregate-preserving eviction | 120 links 下早期值因 bounded cap 被靜默丟掉 |
| 7 | re-read idempotence across eviction | re-read 同一事件後 double-count,驗證案例多了 +65 |
| 8 | canonical key schemas across extraction batches | extractor 用不同說法把同一 accumulator 拆成多個 key |
| 9 | refusal-tolerant batching | 安全 classifier 拒絕一整批其實逐筆都 benign 的 machine text |
| 10 | verbatim validation of extracted facts | batch nondeterminism 產生 phantom value,案例多了 +41 |
| 11 | aggregates state their own coverage | fold 正確但 worker 把已在 aggregate 裡的最後一筆再加一次;coverage stamp 後五個 motivating failures 都 recovery |
這張表裡最值得帶回產品的規則是 3、7、10、11。它們共同指出:資料被保留,不代表消費者知道資料的邊界;資料被抽取,也不代表抽取結果已被原文驗證。 如果只做一個看起來很漂亮的 summary card,卻不顯示 materialization point、source range、extraction validity 與 coverage,系統仍然可能在最後一步產生一個無法追溯的錯誤。
Figure 4:parser 自己也有 failure boundary / The parser has its own failure boundary
一個容易被忽略的地方是:live trace model 不是「完全 deterministic 的 parser」。只要 optional semantic extraction 進入 pipeline,就多了一個 LLM 的 availability、schema drift、refusal、batch nondeterminism 與 model-retirement failure axis。
Figure 4 的 prose-chain-60 小樣本()把 extraction arms 放在一起:plain full context 成功率 0.333、curated with a 是 0.000;small parser 達到 1.000,總成本約 $0.80、parser 成本 $0.023;frontier parser 是 0.667,總成本約 $1.01、parser 成本 $0.24。右側 recovery ladder 也顯示,plain batches 為 0,加入 bisection 到 0.333,再加 fallback model 到 0.667,最後 verbatim validation 仍是 0.667。
這不是一個足以排出 model quality 的 benchmark:cell 只有三個 seed,且作者將它定位成 parser availability 與 validation 的 diagnostic。它支持的工程結論比較窄:如果把抽取器當成基礎設施,就必須測量拒絕率、重試策略、canonical schema、原文驗證與每 event 成本,而不能只報 parser 平均 latency。
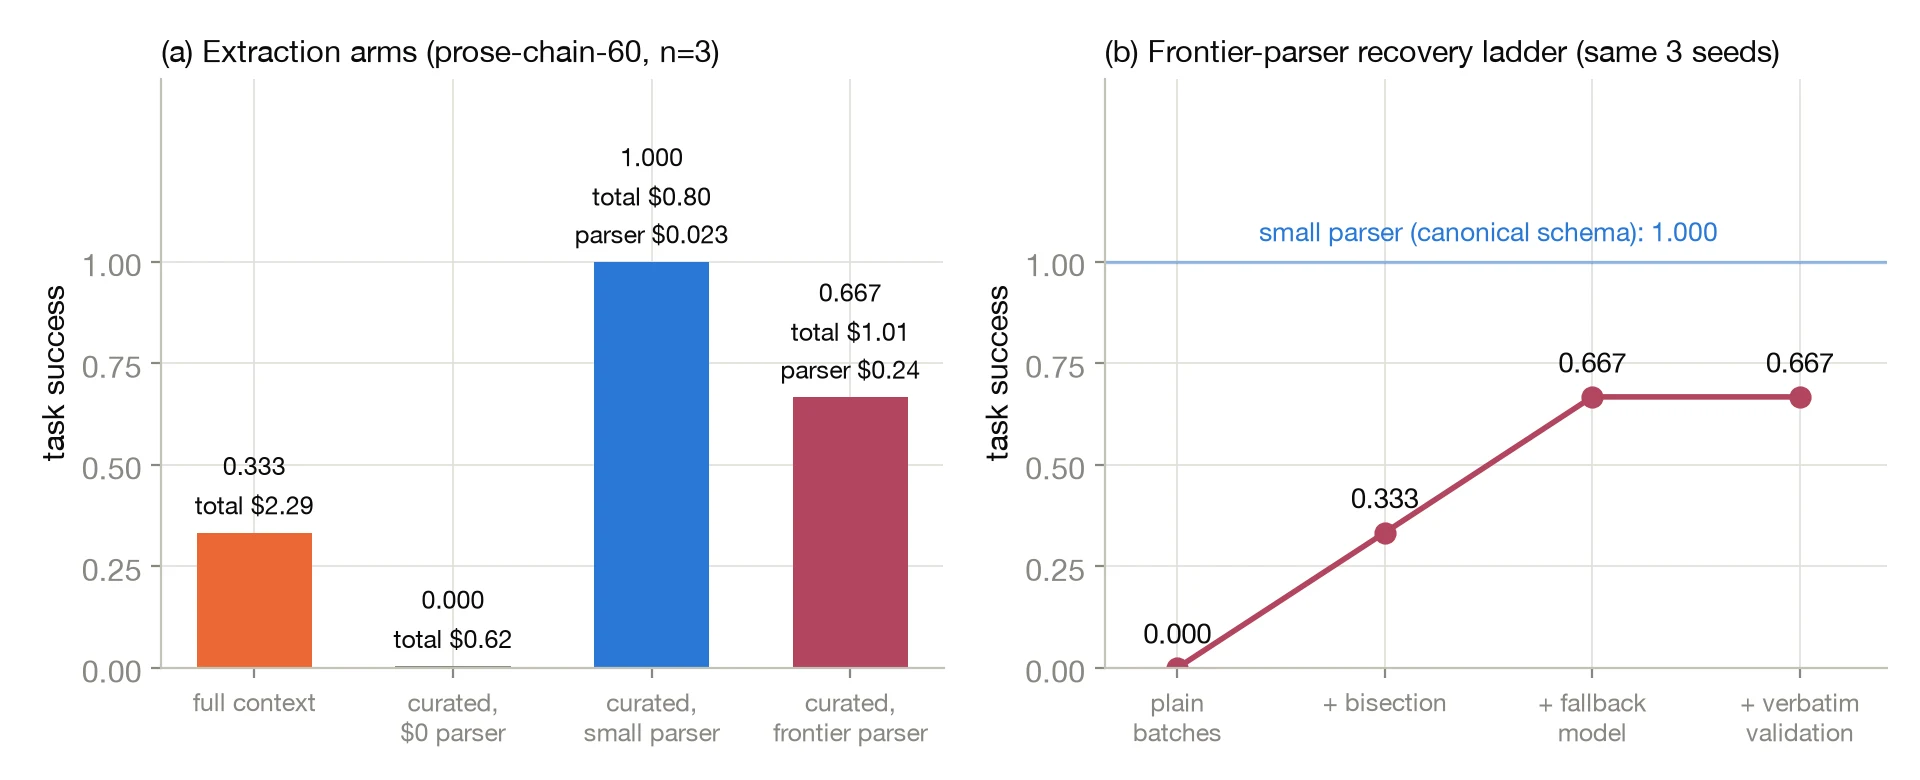
Figure 4,論文 Section 5.5 的 parser diagnostic:左圖比較 full context、、small parser 與 frontier parser;右圖逐步加入 bisection、fallback model、verbatim validation。 的 cell 只能作方向性診斷,不是穩健的模型排行榜。原始 Figure 4 · 原始圖片端點。圖像取自 arXiv HTML,頁面標示 CC BY 4.0;本文保留 attribution,並將 PNG 轉為 WebP。

失敗邊界:什麼時候 curated fold 反而不該用? / Boundary: when should you not use a fixed fold?
論文的價值很大一部分來自它沒有把 30/30 當成通用能力,而是主動尋找 fold 失效的任務。
Alternating-sign chain:順序本身就是資料
在 boundary family 裡,第 個 file 的 delta 以 進入總和。這個操作讓 traversal order 變得重要;只保存「每個 key 的 per-key sum」已經不夠,因為答案依賴順序。curated view 在 60 links 是 3/10,full context 是 6/10;120 links 兩者都是 0/10。cached scratchpad 在同一種 alternating family 則是 60 links 5/5、120 links 9/10。
這是很重要的反例:fixed aggregate 只在 preserved statistics 與任務運算相匹配時有效。 它不能被改寫成「structured state 勝過 raw history」,更精確的說法是「對累積型 task,適合的 state discipline 可以防止長 context 把已知統計弄丟」。
Short horizon:少量 context 不一定需要 curation
在 scatter 的短 horizon,full context 是 1.000,而 structure-only curation 只有 0.20;把 content pinning 加回去後,curated 回到 1.000。這告訴我們,若工作本身只需要幾個原始內容,過早把它抽成只剩結構反而會傷害 worker。bounded view 不是越小越好,而是要知道哪些內容必須原封不動帶著走。
Security boundary:provenance 不是 safety
curator 會把 trace-derived content(包含 tool outputs)送回 worker context。SHA-256、source link 與 verbatim validation 可以證明「這段內容來自哪裡」,卻不能證明「這段內容值得被當作指令」。論文明確把 prompt-injection analysis、provenance-based policy 與 secret redaction 留在未來工作;multi-session 與 multi-agent ledger 也未測試。這使得它目前適合被看作 observability/context architecture case study,不應直接被包裝成安全的 agent memory layer。
證據地圖:作者說了什麼,我們還不能說什麼 / Evidence map
| 層次 | 精確讀法 |
|---|---|
| 論文直接支持 | 在固定 schema、指定 reader、指定 budget 的 COMPREHEND 設定中,compiled view 比 raw tail 與 flat log 更容易讓 reader 回答 ledger-scoped monitoring questions;在共同發展的 120-link chain protocol 中,curated fold 與 scratchpad 都比 plain full context 穩定。 |
| 作者的條件式解釋 | 成功主要來自 deterministic aggregate 與 boundedness;observer 端的 token/cost reduction 應在 schema coverage 條件下理解。fold 的額外價值是 auditability、provenance 與同時服務兩個 consumer。 |
| 尚未建立 | 不是所有 agent trace 都能用固定 aggregate;不是所有 context compression 都會像 raw tail 一樣失敗;也沒有建立多 vendor、外部任務作者、多 Agent、跨 session、受攻擊工具輸出或 production SLA 下的泛化。 |
| Bloss0m 工程判斷 | 最值得移植的是 source identity + coverage + validity + aggregate + replay 這組 contract,而不是把 paper 的 worker prompt 或 K=5 curator cadence 原封不動搬進產品。 |
Artifact 與可重現性:公開不等於一鍵重跑 / Artifacts and reproducibility
截至 2026-09-07,我分別核對了論文、官方 GitHub repository 與 Hugging Face dataset page:
- 官方 code:可存取、結構清楚。
SalesforceAIResearch/tracelab是 public repository,README 列出src/tracelab/、四個 benchmark harness、tests/的 99 regression/property tests、tools/recount_oracle.py、bench/scoreboard.json、bench/spend.json與所有 synthetic CONTINUE traces;repository license 是 BSD-3-Clause。README 提供uv sync --extra dev、uv run pytest -q與 recount oracle 的入口。 - 合成 corpus:紙面上有來源,頁面狀態需保留疑問。 Hugging Face dataset card 顯示 arXiv 2609.01466、CC-BY-4.0、train split 與 n<1K;但截至本文核對時,Dataset Viewer 無法載入 split,頁面回報
StreamingRowsError,並在 revision file request 出現 401/repository-not-found 錯誤。因而本文不把它寫成「我已從 HF 下載並重跑」;paper 與 repo README 所說的 seeded generator 仍是較可靠的 reproduction path。 - 真實 transcripts:明確 withheld。 論文與 README 都說 COMPREHEND 使用的 12 份真實 session 含 personal working sessions,因此不公開;harness 可改跑讀者自己的 local Claude Code transcripts。這表示最有力的 real-corpus observer 結果無法由外部讀者直接用同一批資料重算。
- LLM-backed rerun:有環境條件。 README 說 benchmark 呼叫 Anthropic models on Vertex AI,需要
ANTHROPIC_VERTEX_PROJECT_ID與CLOUD_ML_REGION;模型 endpoint 是否仍供應、定價與 cache behavior 都會影響重評分。CONTINUE的 released code 與 synthetic traces 可先做,不應把「能 clone repo」誇成「所有 paper numbers 都能重現」。
最小而有意義的 reproduction path 是:先執行 repo 提供的 CONTINUE 120-link final-protocol cell,並比較 curated、full、scratchpad 三臂;接著執行 tools/recount_oracle.py,檢查五條 chain-120 traces 的零 mismatch;最後讀 coverage-stamp 與 parser regression tests。這條路徑能驗證 fold、帳務與 shipped traces,不能替代 withheld real corpus,也不能驗證跨 vendor 的外部有效性。
工程判斷:把它當成 trace contract,不是另一個 summary prompt / Engineering decision and when not to use it
如果你正在做一個長程 coding agent、browser agent 或 enterprise workflow agent,我會把這篇的可移植部分整理成一個最小 contract:
- 每一筆 event 要有 stable id、source reference、schema version、timestamp/turn、payload fingerprint 與 ingest status。
- 每一個 fact 要標示 source-scoped identity、occurrence identity、validity 與 extraction provenance;unknown、malformed、refused、superseded 不可靜默消失。
- 每一個 aggregate 要明確寫出計算規則、count/sum 的涵蓋範圍、last included source,以及是否可能因 eviction 或 schema change 失效。
- worker view 與 observer view 可以不同,但必須由同一個 replayable state 產生;任何 LLM extractor 都要有 fallback、verbatim validation、拒絕率與成本帳。
- 在移除 raw event 前,要先問任務是否需要順序、pairing、median、negative evidence 或其他不能由現有 aggregate 還原的資訊。
這個方法適合的場合是:
- 長程 run 需要 whole-run count、累積統計、已完成/待辦 frontier 與 provenance drill-down;
- observer 與 worker 必須看到同一個事實底座,避免 dashboard 說 A、下一個 prompt 說 B;
- 你需要在 incident review 時重播 parser、找到某個欄位何時變 stale,或證明某個答案涵蓋到哪一筆 source。
它不適合被直接用在:
- 任務需要 traversal order、跨事件關聯或未預先定義的統計,而 fold 只保存簡單 aggregate;
- tool output 可能含有 prompt injection、secret 或 tenant-sensitive data,但還沒有 data/instruction plane 分離與 policy gate;
- 多 Agent、跨 session、schema 版本快速演化,而 identity isolation、migration 與 stale propagation 還未被驗證;
- 你只想降低 prompt token,卻沒有 observer、audit 或 replay 需求。這種情況下,cached scratchpad 或 provider-side cache 可能更便宜,paper 本身也沒有證明 fold 是成本最低方案。
與本站既有文章的關係也很清楚:ADIAS 把跨回合的自我改良整理成 issue lifecycle;MidTool 把 tool-use grounding 與 execution 提前放進 mid-training;Indirect Prompt Injection 則提醒 retrieved/tool content 可能進入 instruction channel。Parsing the Stream 位在它們之間的另一個控制點:run 正在進行時,哪些 trace facts 可以被誰讀、以什麼 coverage 被餵回下一步。
讀完後的三個記憶點 / Three things to remember
- 技術想法:先把長 trace 折成 typed、可重播的
RunState,再針對 observer 與 worker 編譯不同 view;不要把兩個消費者各自丟給一個不透明 summary prompt。 - 最強證據:12 份真實 session 的 compiled view observer accuracy 0.850–0.871,高於 raw tail 的 0.476–0.479;120-link clean protocol 中 curated fold 與 scratchpad 都是 30/30,但 fold 多提供 deterministic provenance 與雙消費者共用 state。
- 採用邊界:aggregate 只有在它保留的統計符合任務運算時才可靠;order-sensitive chain、未受信 tool output、多 Agent ledger、schema evolution 與真實 corpus transfer 仍需要外部驗證。