電腦視覺基礎
4 篇精讀筆記
從經典視覺模型的架構、訓練與評測證據,建立判讀方法論文的底座。
讀者問題
一個經典模型的結果,哪些設計與證據仍值得帶進今天的系統?
READING LIBRARY
深入讀這個議題
目前收錄在這個研究議題下的所有論文精讀。
-
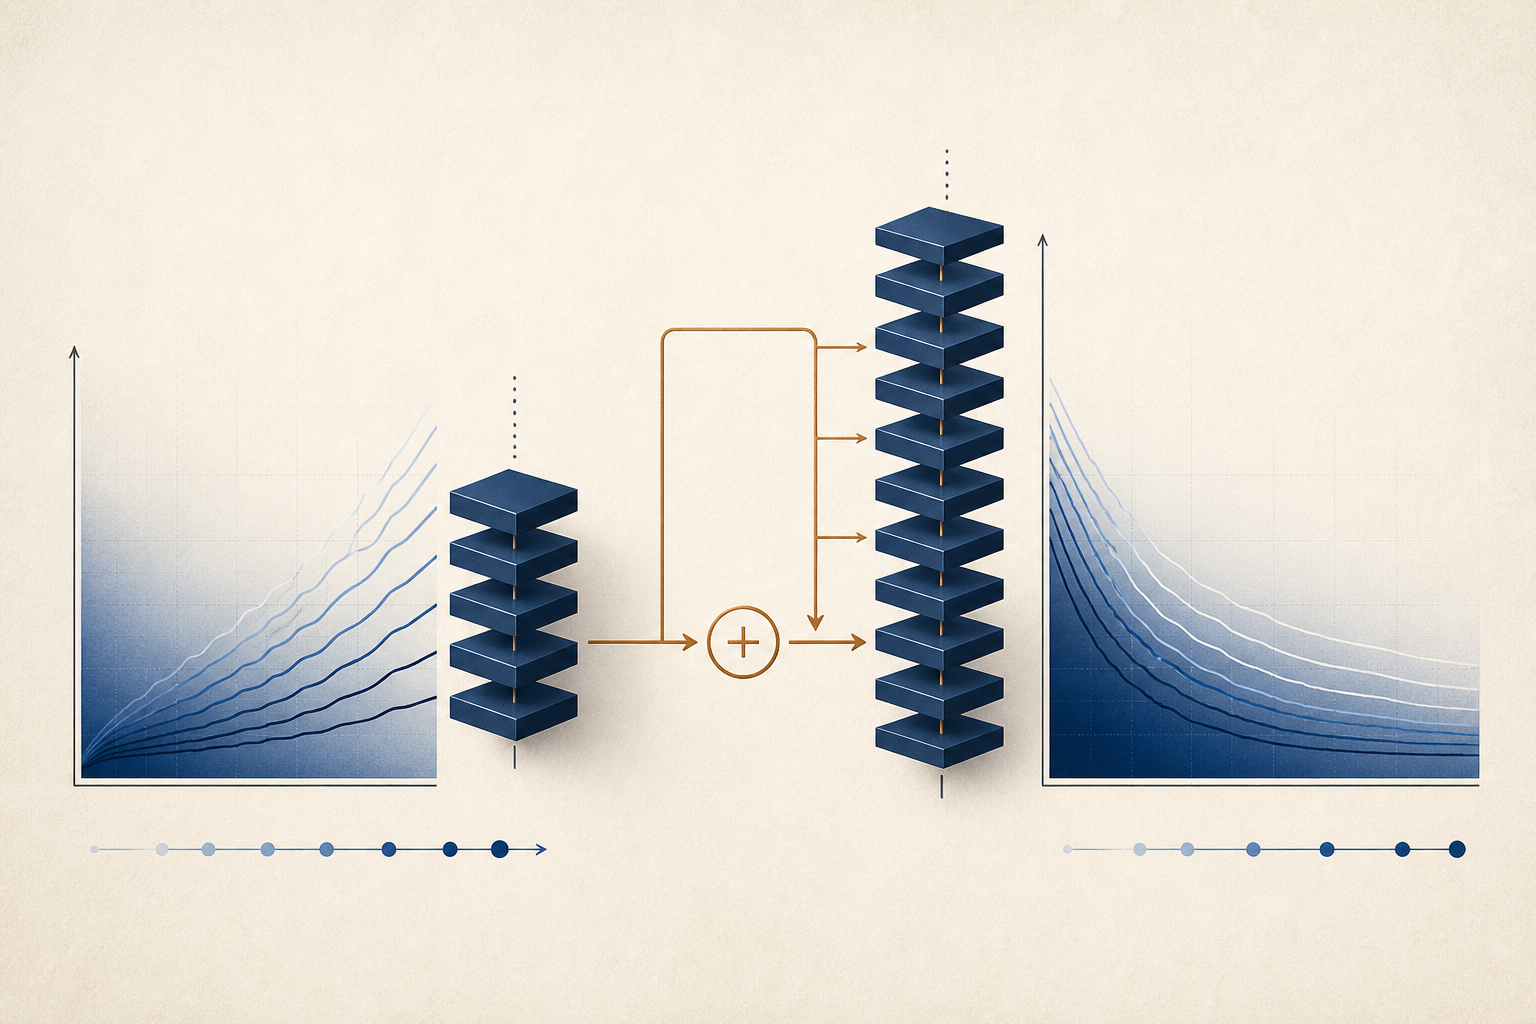
ResNet:殘差讓深度可訓,但不能把 ImageNet 2015 當成現成的偵測或 ViT 契約
中階 先建立方法閱讀底座精讀 He et al. CVPR 2016/arXiv:1512.03385:用恆等捷徑讓堆疊層學殘差 F(x)+x,解決 plain 深網的 degradation。ImageNet 上 ResNet-152 單模型 top-5 驗證誤差 4.49%;這是 2015 分類證據,不是 YOLO、ViT 或現代 ConvNet 排行榜契約。
90 秒掌握這篇論文
- 問題
- 在 BN 與良好初始化已讓「幾十層」能收斂之後,繼續堆深 plain 卷積層會出現 degradation——更深模型的 training error 反而更高(Figure 1、Figure 4 左),這不是典型 overfitting。
- 核心洞見
- 把目標映射改寫成殘差學習。若希望底層輸出為 $\mathcal{H}(\mathbf{x})$,不讓堆疊非線性層直接擬合 $\mathcal{H}$,而讓它們擬合 $\mathcal{F}(\mathbf{x}):=\mathcal{H}(\mathbf{x})-\mathbf{x}$,再以恆等捷徑輸出 $\mathbf{y}=\mathcal{F}(\mathbf{x})+\mathbf{x}$(Equation 1)。控制點是「優化器被要求從零擬合 $H(x)$,還是在 identity 上學修正量 $F(x)$」。
- 最強證據
- ImageNet 上同參數量的 plain-34 top-1 28.54% 差於 plain-18 27.94%;ResNet-34 25.03% 則優於 ResNet-18 27.88%(Table 2,10-crop validation)。CIFAR-10 上 plain-56 training error 超過 60% 不顯示,ResNet 家族隨深度降至 ResNet-110 6.43%(Table 6、Figure 6)。單模型 ResNet-152 top-5 validation 4.49%;ensemble test top-5 3.57%(Table 4–5)。
- 主要邊界
- 證據核心是 2012 ImageNet 分類 與 CIFAR-10 深度診斷;PASCAL/COCO 偵測只是 Faster R-CNN 換 backbone 的轉移表(Table 7–8),不是 YOLO 契約,也不是 ViT、ConvNeXt 或 ResNet-RS 的現代 leaderboard。
-
YOLO:一次看完整張圖做偵測,但 VOC 2016 不能代表後來的 YOLO 家族
中階 先建立方法閱讀底座精讀 Redmon et al. CVPR 2016/arXiv:1506.02640:把物件偵測改寫成單次前向傳播的迴歸——S×S 網格、B 個框、C 類機率一次輸出。VOC 2007 上 YOLO 63.4% mAP/45 FPS;這是 2016 統一偵測證據,不是 YOLOv3 COCO 或 Ultralytics 產品數字。
90 秒掌握這篇論文
- 問題
- 2016 年前主流偵測器(DPM、R-CNN、Fast/Faster R-CNN)把分類器或區域提議、特徵、分數、後處理拆成多段管線,難以端到端優化,測試也慢(例如 R-CNN 逾 40 秒/張、Fast R-CNN 約 0.5 FPS)。
- 核心洞見
- 把偵測改寫成 單一迴歸:輸入整張圖,單一 CNN 直接輸出空間上分散的邊界框與類別機率。控制點是 one-shot global reasoning 對 two-stage propose-then-classify;整個管線是一個網路,可端到端以偵測損失訓練(Section 1–2、Figure 1–2)。
- 最強證據
- PASCAL VOC 2007(Table 1,train 2007+2012):YOLO 63.4% mAP、45 FPS(Titan X、無 batch);Fast YOLO 52.7% mAP、155 FPS。同表對照 Fast R-CNN 70.0% mAP、0.5 FPS;Faster R-CNN VGG-16 73.2% mAP、7 FPS。Figure 4:YOLO 定位錯誤 19.0% 為主,背景誤報 4.75% 遠低於 Fast R-CNN 13.6%。
- 主要邊界
- 粗網格(每格僅 2 框、1 類)、VOC 20 類、非 instance segmentation;VOC 2012 test 57.9% mAP 低於當時 leaderboard 頂端。YOLOv2/v3/v8、COCO 2017、Ultralytics 產品 mAP 不屬本 PDF;ResNet-152 ImageNet 4.49% 亦不是偵測契約。
-
AlexNet(下):把可訓練化配方拆成可驗證的設計
中階 先建立方法閱讀底座從 Figure 1–3、Sections 3–6 重讀 ReLU、多 GPU、overlapping pooling、資料增強與 dropout 的證據。
90 秒掌握這篇論文
- 問題
- 60M-parameter CNN 即使有 1.2M images 仍會過擬合;也需要把訓練 recipe 與 competition result 分開解讀。
- 核心想法
- 以 random crop/flip、RGB PCA lighting jitter 與 dropout 擴增或正規化有效訓練分布,再用 SGD、momentum、weight decay 和 learning-rate schedule 讓 Part 1 的架構收斂。
- 最強證據
- color augmentation 讓 top-1 error 降超過 1%,overlapping pooling 降 0.4/0.3 points;最終 ILSVRC-2010 37.5/17.0,2012 top-5 15.3(Section 4–6、Table 1)。
- 邊界
- 這些 ablation 多在當年的 architecture/data/compute 組合;不代表每個 modern vision model 都需要 ten-crop、LRN 或相同 learning-rate heuristic。
-
AlexNet(上):先用證據讀懂它為何改變 ImageNet
入門 先建立方法閱讀底座以論文可定位證據重讀 AlexNet 的問題、評測與歷史性結果:它證明了什麼,也沒有證明什麼。
90 秒掌握這篇論文
- 問題
- 在 2012 年,用百萬級高解析影像訓練深 CNN 同時受限於優化速度、GPU 記憶體與過擬合。
- 核心想法
- AlexNet 不是單一「大網路」技巧,而是將卷積的局部歸納偏好、ReLU、兩張 GPU 的受限分割與可擴大的八層架構組成可訓練系統。
- 最強證據
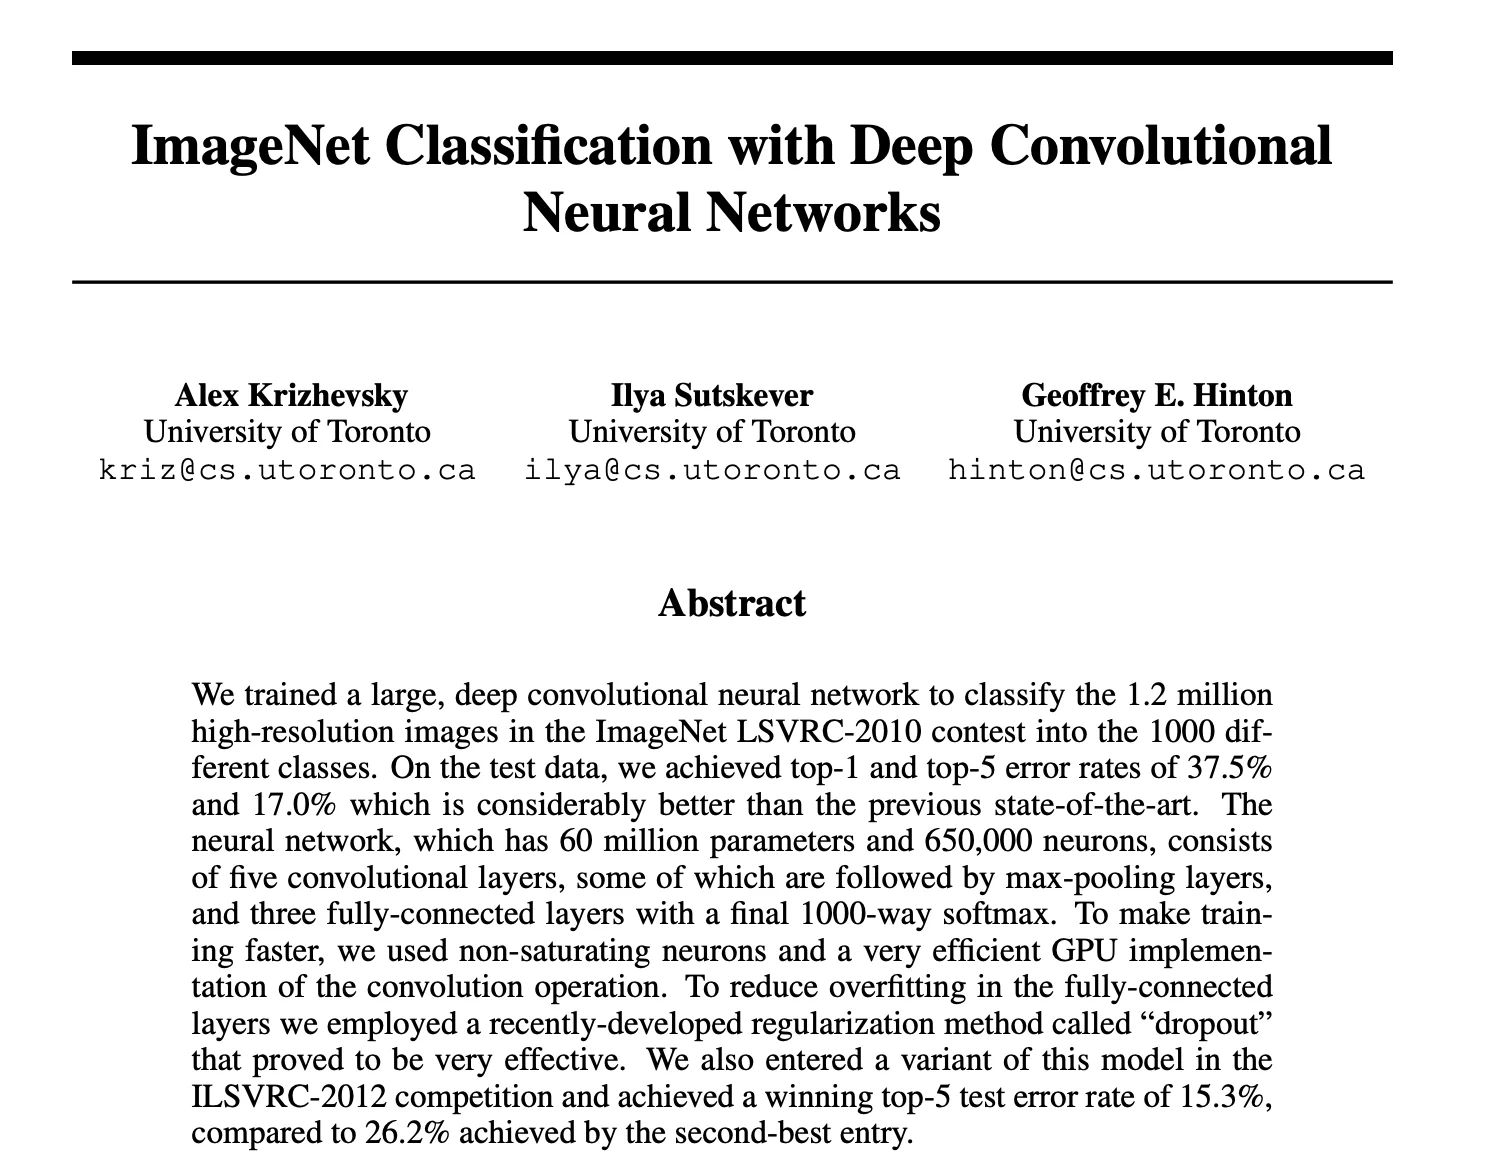
- ILSVRC-2010 的 top-1/top-5 error 為 37.5%/17.0%;2012 competition top-5 為 15.3%,次名為 26.2%(Section 6、Table 1)。
- 邊界
- LRN、雙 GPU split 與部分 kernel 設計是當年硬體折衷;這篇不主張它們在現代 accelerator 或所有視覺任務仍是最佳選擇。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡