若要先看這篇在 ReAct 家族裡站在哪一節,見 Agent 方法底座閱讀地圖。
90 秒掌握論文 / The paper in 90 seconds
- 問題:HumanEval 這類 coding benchmark 把成功壓成「寫一個自包含函式」。真實軟體工程是:讀一份 GitHub issue、在數千檔的倉庫裡改程式,再用測試判定有沒有修好。既有分數測不到這件事。
- 核心洞見:把評測單位改成「真實 issue + 完整 Python 倉庫 + 測試」。模型產出 patch;unix
patch套用後,fail-to-pass 與 pass-to-pass 測試必須全部通過才算 resolve。改動的控制點不是新的 agent 架構,而是什麼算成功。 - 最強證據:BM25 檢索、13k context 下,Claude 2 resolve 1.96%(abstract、Section 1、Table 2)。同一協議的 Table 5 列 Claude 2 為 1.97%,並另外列入 Claude 3 Opus 3.79%。Oracle 檢索時 Claude 2 升到 4.80%(Table 18)。SWE-Llama 在 BM25 只有 0.70%,仍多半只解最簡單的題。
- 主要邊界:Python、issue-fix、binary 測試。Resolve 不測可維護性、未覆蓋行為或 review。BM25 與 oracle 是不同檢索條件。後續 SWE-bench Verified、SWE-agent 與 ProMax 採用不同設定,其分數不屬於本文表格。
我的結論是:SWE-bench 最值得保留的貢獻,是以真實 issue、完整 repository 與執行測試定義成功。1.96% 只代表 Claude 2 在當時檢索與一次生成設定下的結果,不能視為能力上限,也不能與後續 agent scaffold 分數直接相比。
版本與閱讀範圍 / Version and reading scope
本文讀的是 Jimenez et al., ICLR 2024 Oral 對應的 arXiv:2310.06770 v3,首發於 2023-10-10,並在 2024-11-11 更新。v3 PDF 與 arXiv HTML 標示 CC BY 4.0。
除摘要外,本文核對資料建構、任務定義、BM25 與 oracle 設定、主要 resolve 表格、Sphinx 例子,以及附錄中的 fail-to-pass 判定與失敗類型。
截至 2026-08-27,swebench.com、SWE-bench/SWE-bench 與 Hugging Face 的 princeton-nlp/SWE-bench 仍可開啟;princeton-nlp/SWE-bench GitHub 路徑會轉到目前的組織倉庫。
這是已發表的 ICLR Oral,不是 preprint。v3 的 Table 5 已列入 Claude 3 Opus 與 GPT-4-turbo;那是這份相機就緒稿自己的列,不是後來 leaderboard。本文不採用 SWE-agent、SWE-bench Verified 或 SWE-Bench ProMax 的分數來解釋這篇論文。
讀者真正要回答的問題
當語言模型在 HumanEval 上已經「會寫函式」時,我們能不能說它會修真實倉庫裡的 bug?SWE-bench 的回答是否定的:成功條件必須改成「針對一份真實 issue,在完整 codebase 上交出能通過測試的 patch」。
比較精確的讀法不是「Claude 2 是不是只有 2% 的 coding 能力」。真正的問題是:把成功從單函式生成改成 fail-to-pass 測試之後,分數還剩下多少是模型、多少是檢索、多少是測試集合,以及這個 binary 分數不能告訴工程團隊什麼?
證據地圖 / Evidence map
| 層次 | 本文採用的說法 |
|---|---|
| 論文直接支持 | 2,294 題、12 個 Python 倉庫(Table 10);BM25 13k 下 Claude 2 1.96%(Table 2);Table 5 的 BM25 總表;Table 18 的 oracle 4.80%/1.74%;Figure 4 的倉庫切片;Table 22–23 的 No-Op/Regression。 |
| 作者主張 | 真實軟體工程是下一代 LM 的可持續、可驗證測試場;當時的專有模型與 SWE-Llama 都只能解最簡單的 issue。 |
| 論文未證明 | 1.96% 不是模型能力的終點;oracle 不是真實工程師的先驗;binary resolve 不是可 merge;conda 時代的執行環境不是後來 Docker harness 的同一套 reproduction。 |
| Bloss0m 工程判斷 | 把 SWE-bench 當評測基板來讀。ReAct/Toolformer 教的是 agent 怎麼行動與學會工具;ProMax 改的是分母。不要把後者的 41.2% 寫回這篇的表。 |
後文把數字、作者 claim 與工程判讀分開。「提升」只指論文報告的 setup。
先前方法為何不足 / Why the previous approach is insufficient
Section 1 把 2023 年的缺口寫得很清楚。HumanEval 這類基準吸引人,因為程式輸出可以用單元測試驗證;但題目多半是為基準特製、幾行就能解的自包含問題。真實修 bug 要在大型倉庫裡定位、理解跨檔案依賴、改一個小錯誤而不破壞既有行為。既有分數因此同時太容易飽和、又離產品工作太遠。
舊方法不夠的地方不是「模型不夠大」,而是成功定義被放錯位置:測的是單函式生成,不是「一份真實 issue 有沒有被測試判定為已解決」。SWE-bench 改的正是這個控制點。
核心直覺 / Core intuition
先不要看表格。想像一個工程師接到 Django 的 GitHub issue:某段文件字串在特定設定下格式錯誤。他不是在空白檔案裡寫一個函式,而是 clone 當下那份倉庫、讀 issue、改幾個檔、跑測試。測試通過,才算修好。
SWE-bench 把這份工作契約寫成評測:
- Issue 文字 :相關 GitHub issue 的標題與描述;PR 第一個 commit 之後的討論不進入題面,以免洩漏解法。
- 倉庫快照 :該 PR 的 base commit。平均 3,010 個非測試檔、438K 行(Table 1)。
- 模型輸出:一個
.patch,指出要改哪些行。 - 判定器:套用測試 patch 與預測 patch ,跑測試。必須讓所有 FAIL_TO_PASS 與 PASS_TO_PASS 測試通過,才記 resolve。
Gold patch 平均改 1.7 個檔、3.0 個函式、32.8 行。40% 的題至少有兩個 fail-to-pass 測試;pass-to-pass 的中位數是 51。也就是說,成功不只是「讓新測試變綠」,還要「不要把舊行為弄壞」。
這與 ReAct 不同:ReAct 改的是 prompt 裡下一步合不合法。這也與 Toolformer 不同:Toolformer 改的是訓練字串要不要插入一次 API。SWE-bench 不是新的 agent loop;它是後來那些 loop 要被測量的基板。
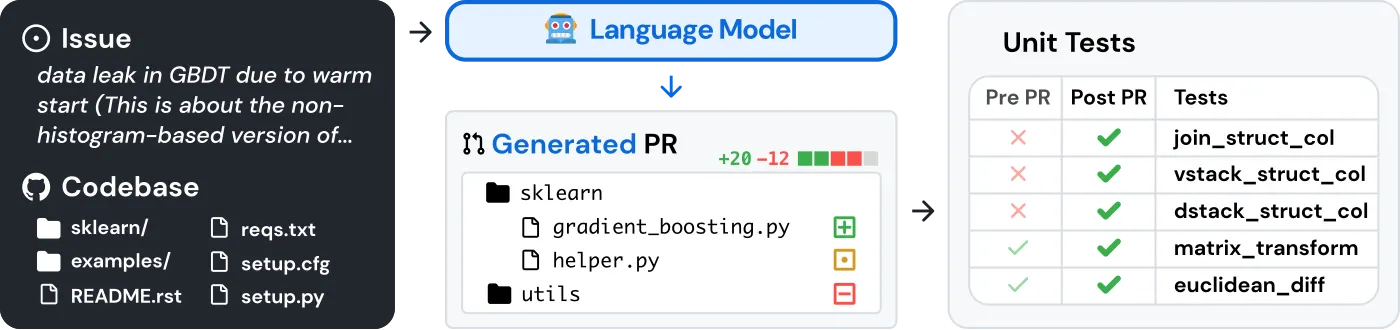
Figure 1,論文 Section 1:左邊是 issue 與倉庫快照,中間是模型生成的 patch,右邊是以真實測試判定 resolve。這張圖教的是評測單位,不是任何模型分數。原圖可定位到 Figure 1,SVG endpoint 為 teaser.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

用一個例子走完整個方法 / Walk one example through the method
以下是 Section 5.1 與 Figure 6 的 Sphinx 任務 sphinx-doc__sphinx-8713,在 oracle 檢索 下的 walkthrough。這是論文自己的定性例子,不是獨立實驗分數。
- Input:issue 說 Sphinx 的 napoleon 擴充在
napoleon.use_param=True時,沒有正確格式化文件關鍵字Other Parameters。題面附了可疑原始碼位置、重現片段與套件版本。Oracle 設定會把 gold patch 改過的完整檔案放進 prompt,加上指令與一份 diff 範例。總輸入 1,558 行、20,882 tokens。 - Intermediate representation:模型看到的不是「請寫一個函式」,而是 issue 文字 + 被選中的原始檔 + patch 格式說明。BM25 設定下,這些檔可能根本不是該改的檔(Table 3:27k limit 時,約一半題一份 oracle 檔都沒召回)。
- Model or system decision:SWE-Llama 改了正確函式
_parse_other_parameters_section(sphinx/ext/napoleon/docstring.py第 684 行),但把它改成永遠當成napoleon.use_param=True,沒有先讀設定、也沒有複製_parse_parameters_section的分支,而 gold patch 做了這件事。 - Output:一個看起來對得上檔案位置的 patch。套用成功之後,測試
test_parameters_with_class_reference在napoleon_use_param=False的設定下比對產出文件,立刻抓到錯誤。任務 unresolved。 - Likely failure point:改對函式、寫出可套用的 patch,仍可能因為忽略設定分支、程式風格或跨模組約束而失敗。Table 23 顯示,多數成功套用的 patch 是 No-Op(一個 F2P 都沒過)或 Regression(舊測試被弄壞)。Figure 6 這例屬於「改到了、但邏輯比 gold 更窄」的那一類。
這個例子教的是:測試才是法官。定位正確不是 resolve;通過 FAIL_TO_PASS 與 PASS_TO_PASS 才是。
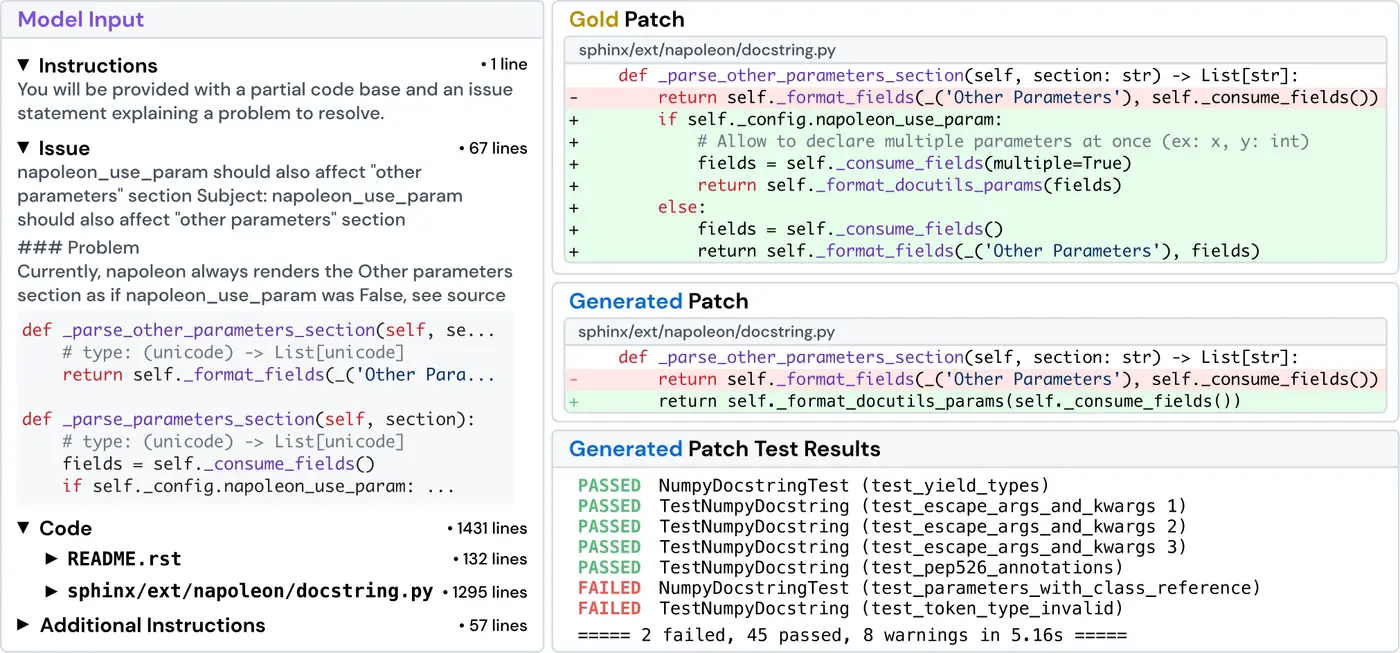
Figure 6,論文 Section 5.1:紅色為刪除、綠色為新增。模型改對函式,但忽略設定分支,被測試抓到。原圖可定位到 Figure 6,PNG endpoint 為 case-study.png。取自 arXiv HTML,頁面標示 CC BY 4.0。

技術機制 / Technical mechanism
標籤怎麼造出來:三階段過濾
Figure 2/Section 2.1 把約 90,000 個 PR(Table 10 精確列為 93,139)收成 2,294 題:
- Repo selection and scraping:從 2023 年 8 月下載量最高的 PyPI 套件對應的 12 個熱門 Python 倉庫抓 PR。熱門倉庫通常文件、貢獻規範與測試覆蓋較好。
- Attribute-based filtering:只留 已合併、解決至少一個 GitHub issue(title/body/commit 出現
fixes/closes/resolves這類連結)、且 改到測試檔 的 PR。這一步把 93,139 收成 11,407 個候選(Table 10)。 - Execution-based filtering:在對應版本的 conda 環境安裝 ,先跑測試、再套 gold patch 再跑。必須至少有一個測試從 fail 變成 pass;安裝或 runtime 錯誤、以及測試去呼叫 gold patch 才剛引入的新函式/類別 的題會被丟掉,因為那種命名對人類也不公平。最後留下 2,294。
Django 佔 850 題,Flask 只有 11 題(Table 10)。總分是被這個分母塑造的,不是 12 個倉庫的均等平均。
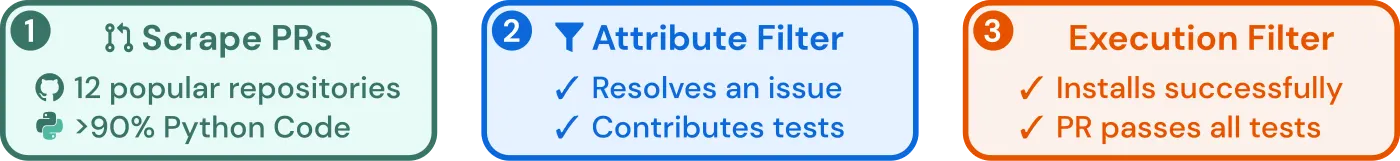
Figure 2,論文 Section 2.1:標籤不是「看起來像修 bug 的 commit」直接入列,而是 merged PR → 連結 issue 且改測試 → 至少一個 fail-to-pass。原圖可定位到 Figure 2,SVG 為 collection-pipeline.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

問題敘述 只聚合 PR 第一個 commit 之前 的 issue 標題、本文與留言;hints_text 有蒐集,但本文實驗沒用。訓練集 SWE-bench-train 另從 37 個不相交倉庫 取約 19,000 對,不要求 PR 改測試;超過 30,000 tokens 的序列被丟掉後,有效訓練約 10,000 筆。這是為了降低訓練/測試倉庫重疊,不是保證預訓練語料沒看過這些套件。
評測時,一個輸入怎麼變成 0 或 1
Section 4 承認倉庫放不進 context(平均 438K 行),所以 baseline 不是 agent loop,而是「檢索檔案 → 一次生成 patch」:
- BM25:用 issue 文字當 query,把檔案路徑 prepend 進文件。在 13k/27k/50k token 上限內盡量塞檔。Table 3:27k 時對 oracle 檔的 All-recall 39.83%,Any-recall 51.27%;約一半題一份 gold 檔都沒拿到。
- Oracle:直接給 gold patch 改過的檔(不含測試檔)。作者明說這比較不真實,也不完整——沒被改的檔仍可能是理解行為所需的 context。
Prompt 順序:指令、issue、檢索到的檔與文件、一份 patch 範例、再要求輸出 patch(Appendix D.3)。解碼是 greedy、每題只生成一次,對齊 Pass@1。
套用失敗時,harness 會試著刪多餘 context 行、重算 header 再套一次(Appendix A.4 Step 6)。再失敗或測試跑不起來,該題直接 0 分。
Resolve 的操作定義(Appendix A.4):
增加 FAIL_TO_PASS,等於把「這份 issue 要的新行為」收得更緊;增加 PASS_TO_PASS,等於把「不能破壞的舊行為」收得更緊。把其中一類拿掉,分數會變鬆,也不再是論文的 Resolve。% Apply 只說 patch 套得進去,不說測試過了;Table 5 裡套用率遠高於 resolve 率,正是因為多數套用成功的 patch 仍是 No-Op 或 Regression。
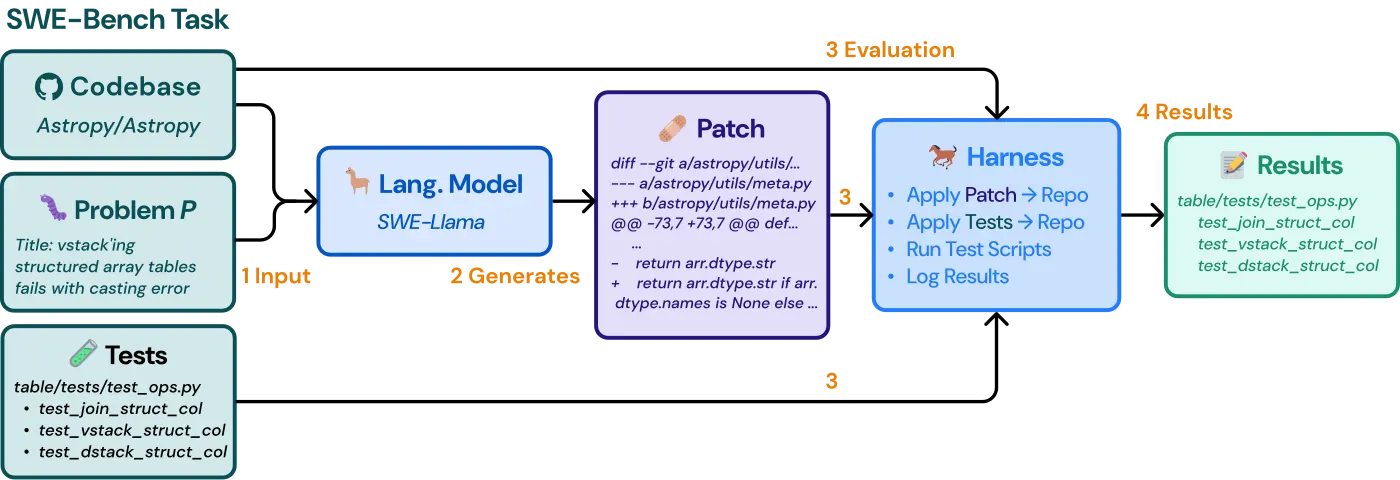
Figure 8,論文 Appendix A.4:評測時 Patch 是模型生成的。預測必須成功套用,並在 FAIL_TO_PASS/PASS_TO_PASS 上重現 gold 的通過集合。原圖可定位到 Figure 8,SVG 為 pipeline-evaluation.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

SWE-Llama 7b/13b 用 LoRA 只訓 attention 子層,在 oracle 檔 + issue 上學 gold patch。7b 約 20 小時/4×A100,13b 約 47 小時/8×A100(Appendix B)。它被訓練成「context 裡出現的檔都該改」;換成 BM25 的雜訊檔,作者認為這就是它 BM25 分數特別差的原因。
實驗如何讀 / How to read the evidence
共同協議比單一分數重要。主設定是 frozen 模型 + 檢索到的檔 + 一次 greedy patch,不是 SWE-agent 式多步工具迴圈。GPT-4(gpt-4-32k-0613)因預算只在 BM25 27k 與 oracle 上跑 25% 隨機子集(574 題);GPT-4-turbo 出現在 v3 Table 5,口徑不同。ChatGPT-3.5 是 gpt-3.5-turbo-16k-0613。
Table 2 與 abstract:headline 1.96% 是 BM25、13k
這張表問:在 BM25 下,加長 context 能不能靠更高檔案召回把 resolve 拉上來?控制住的是檢索器與 greedy 解碼;改的是 token 上限。
| Model | 13k | 27k | 50k |
|---|---|---|---|
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
觀察:最短窗最好。Table 3 顯示 50k 的 All-recall 升到 45.90%,分數卻掉到 1.22%。作者的解釋是模型被無關程式碼干擾,無法定位該改的行。這支持「多給 context 不是免費的召回」;它不支持「Claude 2 的真實能力是 1.22%」——那是 50k BM25 協議。
Abstract、Section 1 與 Section 5 開場都把 1.96% 當 headline。本文跟這條。
Table 5:同一 BM25 協議的總表,含 v3 後加的模型
Table 5 問的是 BM25 主結果,並同時報 SWE-bench Lite(300 題、11/12 個倉庫、較自包含的 functional bug fix;Appendix A.7)。
| Model | Full % Resolved | Full % Apply | Lite % Resolved | Lite % Apply |
|---|---|---|---|---|
| Claude 3 Opus | 3.79 | 46.56 | 4.33 | 51.67 |
| Claude 2 | 1.97 | 43.07 | 3.00 | 33.00 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 | 29.67 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 | 38.00 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 | 38.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 | 10.00 |
Claude 2 的 1.97 與 abstract 的 1.96 差一個百分點的捨入;本文把 1.96 當 headline、1.97 當 Table 5 列,不把它們寫成兩個實驗。Claude 3 Opus 3.79% 是 v3 表內數字,仍是 BM25 一次生成,不是後來的 agent scaffold。套用率 26–54%,resolve 卻小於 4%:多數 patch 套得進去,測試仍判失敗。
這張表支持「在這個 BM25 協議上,當時最強的專有模型也只解個位數百分比」。它不支持用 Lite 3.00% 代替 full 1.96%,也不支持把 GPT-4-turbo 1.31% 與 Table 20 裡 GPT-4 在 25% 子集上的 BM25 0.00% 混成「GPT-4 的分數」。
Table 18:oracle 是檢索上界,不是同一句話裡的模型差距
| Model | Oracle % Resolved | % Apply |
|---|---|---|
| Claude 2 | 4.80 | 62.82 |
| SWE-Llama 13b | 3.97 | 66.78 |
| SWE-Llama 7b | 3.01 | 65.52 |
| GPT-4∗ | 1.74 | 34.00 |
| ChatGPT-3.5 | 0.52 | 21.80 |
∗GPT-4 為 25% 子集。Claude 2 從 BM25 1.96 升到 oracle 4.80,說明 headline 有相當一部分是「找不到該改的檔」,不是單純「不會寫 patch」。SWE-Llama 13b 在 oracle 上與 Claude 2 接近(91 對 110 題),但重疊只有 Claude 2 解中的 42% 也是 SWE-Llama 解的;兩套模型不是在解同一批「簡單題」。Table 6 的 oracle-collapsed(只留 gold 編輯列 ±15 行)是輸入消融:再把 Claude 2 推到 5.93%、GPT-4 到 3.40%,說明即使給對檔,多餘行仍會干擾。Table 23 則是失敗模式分類,不是另一張排行榜。
這支持「檢索與定位是獨立混淆因素」。它不支持「給 oracle 檔就等於真實工程師條件」。
Figure 4、Table 7、Table 23:切片、時間與失敗類型
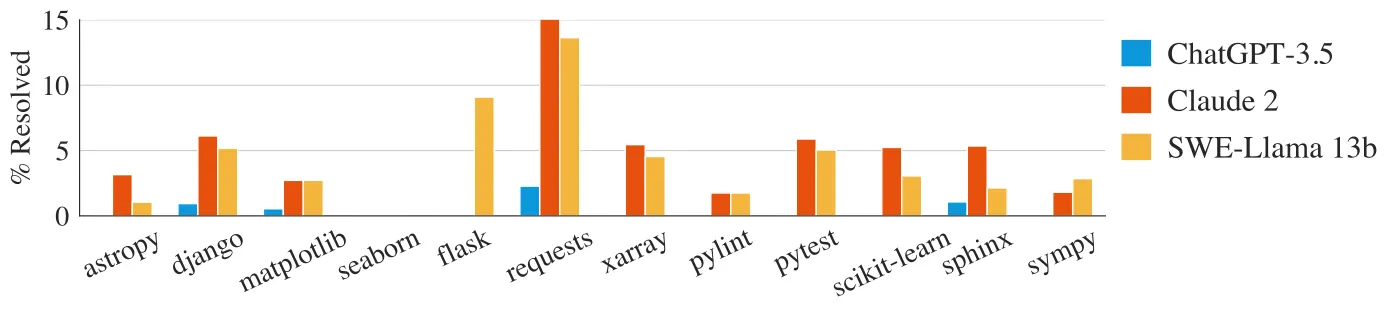
Figure 4,論文 Section 5:三個模型在各倉庫的趨勢相近,但 psf/requests 明顯較高、seaborn 為 0。原圖可定位到 Figure 4,SVG 為 per_repo_oracle_fig.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

Table 19(對應 Figure 4)在 oracle 下:Claude 2 在 requests 15.91%,django 6.15%,sympy 1.94%,seaborn 與 flask 0%。32% 的 matplotlib 與 10% 的 seaborn 題在 issue 裡嵌了圖片;全體只有 2%。總分被 Django 的 850/2,294 題拉著走。
Table 7:oracle 下,2023 年前後 Claude 2 是 4.87 對 4.23,SWE-Llama 13b 是 3.98 對 3.85;GPT-4 子集則從 1.96 掉到 0.0。作者認為模型不太可能只靠「背更新版倉庫」作弊。這不能證明預訓練沒看過這些套件,只能說以「issue 建立年份」切開時,多數模型沒有單調變強或變弱。
Table 23 把成功套用的 oracle patch 分成六類。Claude 2:Applied 1,078,Resolved 110,No-Op 471,Regression 436。多數失敗連一個 F2P 都沒過。Binary Resolve 把「部分修對」記成 0;若產品在乎部分進度,這個指標會把訊號壓扁。
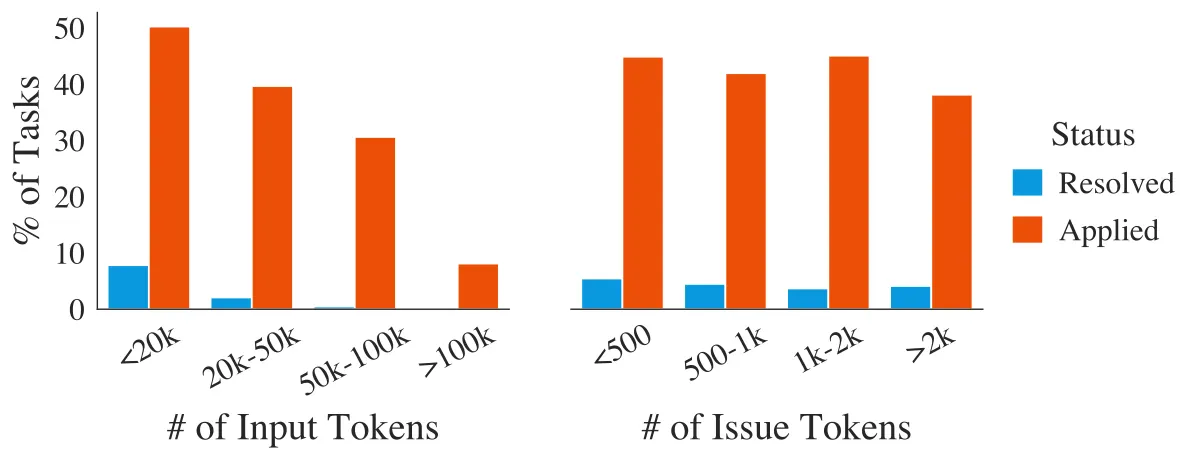
Figure 5,論文 Section 5:左為總輸入長度、右為 issue 長度。更長 context 伴隨更低 resolve,與 Table 2「召回上升、分數下降」一致。原圖可定位到 Figure 5,SVG 為 swellama-issue-length-tokens.svg。取自 arXiv HTML,頁面標示 CC BY 4.0。

限制、威脅與不該過度推導的話 / Limitations and threats to validity
Section 7 的作者限制可以直接當工程清單:
- 只有 Python。 作者希望同一套收集程序能擴到其他語言;那是未來工作,不是這份證據。
- Baseline 是最直白的一次生成。 作者明確不限制未來使用 agent 或工具增強;後續 scaffold 採用新的執行協議,不能直接與 Table 2 混為同一條進步曲線。
- 只靠執行測試不夠。 作者觀察模型生成常比人類解更不完整、更沒效率、更難讀。Figure 10 用 Cyclomatic complexity 說明:較短的 patch 仍可能把複雜度塞進熱路徑。
讀表時還要留下這些邊界:
- 1.96% 與 4.80% 不是同一句話裡的模型差距。 差的是 BM25 對 oracle。
- GPT-4 的 1.74% 帶星號。 25% 子集;同一子集上 BM25 27k 的 GPT-4 是 0.00%(Table 20)。
- Django 850 題。 未分倉庫的總分不是 12 個生態系的均等樣本。
- SWE-Llama 在 BM25 的 0.70% 是 distribution shift。 它在 oracle 檔上微調。
- 論文當下的執行環境是 per-version conda,不是 Docker。 官方 repo 在 2024-06-27 才改成 containerized harness。截至 2026-08-27,Docker 是後續基礎設施,不要寫成 2023 年相機就緒稿已經用 Docker 跑出 1.96%。
- 後來的 Verified/Lite leaderboard/SWE-agent/ProMax 不是這篇的表。 Lite 的 300 題在 v3 已出現,可以用 Table 5 的 Lite 欄;Verified 500 題與 ProMax 170 題不行。
工程判斷與不適用條件 / Engineering decision and when not to use it
什麼時候值得借用 SWE-bench?當你要測的是「模型能不能在真實倉庫裡交出通過測試的 patch」,而且願意把檢索、context、patch 格式與測試集合寫進協議說明。這時應分開記錄:BM25 還是 oracle、context 上限、% Apply 與 % Resolved、F2P/P2P 各死在哪裡。
什麼時候不要把這篇論文當成施工圖?
- 需要 thought–action–observation 迴圈時,讀 ReAct。SWE-bench 的 baseline 沒有這條迴圈。
- 需要訓練側「何時呼叫工具」的過濾器時,讀 Toolformer。
- 需要 mid-training 先教工具 affordance 時,讀 MidTool。
- 需要把同一條執行軌跡留下、之後改指標重評時,讀 A²E。SWE-bench 的成功是終態測試,不保存 agent trace。
- 需要跨語言、跨檔案、行為保持的大型重構時,讀 SWE-Bench ProMax。那是後來改分母的裝置:七種語言、平均 11.4 個 source files、scaffold(OpenHands 對 mini-SWE-agent)被顯式交叉。ProMax 的 41.2% 不是「同一 2,294 題上模型進步了 41 個百分點」。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-08-27 的直接 endpoint 狀態:
- 論文:arXiv abs、v3 PDF、HTML 可讀,license 為 CC BY 4.0。OpenReview 論壇 id 為 VTF8yNQM66。
- Project page:swebench.com 可開啟;內容包含後來的 leaderboard 與變體,不要把頁面上的後期數字當成 v3 Table 2。
- 程式:SWE-bench/SWE-bench 可存取,MIT License。
https://github.com/princeton-nlp/SWE-bench會轉到同一 repo。README 現在預設 Docker 評測;這是 2024-06-27 之後的 harness,論文 Appendix A.3 寫的是 per-version conda。 - 資料:princeton-nlp/SWE-bench 可載入
split='test'。這是資料集 endpoint,不是「一條指令重跑 Table 2」。 - SWE-Llama checkpoint:princeton-nlp/SWE-Llama-7b 與 13b 可開啟。要重跑 Table 2 仍需要當時的 prompt、檢索快取與執行映像。
- 最小有用 reproduction:載入一題、檢查
FAIL_TO_PASS/PASS_TO_PASS欄位、在文件化環境套 gold patch 並確認測試由 fail 變 pass。這只能檢查判定器方向,不能宣稱重現 Claude 2 的 1.96%。
三個記憶點 / Three things to remember
- 技術想法:SWE-bench 把成功改成「真實 GitHub issue + 完整 Python 倉庫 + 測試通過的 patch」,而不是 HumanEval 式的單函式生成。
- 證據:BM25 13k 下 Claude 2 解 1.96%;oracle 才到 4.80%。套用率遠高於 resolve 率;SWE-Llama 在 oracle 上接近 Claude 2,在 BM25 上幾乎解不開。
- 邊界:Python + issue-fix + binary 測試。分數是協議。後來的 agent scaffold、Verified 切片與 ProMax 重構題改的是評測裝置,不能寫回這張表。
延伸閱讀
SWE-bench 處理的是「什麼算 coding 成功」。接下來可依問題選讀:
- thought 與環境動作交錯:ReAct。
- 訓練時插入 API:Toolformer。
- 終態測試與可重評 trace:A²E。
- 跨語言、跨檔案的行為保持重構:SWE-Bench ProMax。