論文精讀
Librarian Agents 論文精讀:讓 Agent 提前整理可重用工作區
原文:Librarian Agents: Training LLMs to Curate Long-Context Workspaces that Anticipate Future Queries
90 秒掌握論文
- 問題:同一個長文件語料會回答很多問題;若每次都從原文重新搜尋,Agent 會反覆找回跨文件關係。固定索引可把工作提前,但預設的分類和摘要未必符合後續任務。
- 核心洞見:讓一個 Builder 在問題到來前,將原始文件整理成多層次的合成檔案系統;另一個 Answerer 再依單一問題導覽它。Builder 的訓練目標,是讓未透露給 Builder 的下游問題更容易答對,而非只讓摘要看來完整。
- 最強證據:在 BrowseComp-Plus 的 50 個隨機保留語料任務上,作者以兩個固定 Answerer 報告 0.75(Qwen3.5-4B)和 0.77(Gemini 3.1 Flash Lite),高於各自最強列出的基線 0.44、0.42。另有獨立的 443 題合成重用集、BRIGHT 三領域 150 題測試,以及 49 個語料、435 題的檔案結構比較(Figure 4、Table 2–3、Table 7)。
- 主要邊界:這些是作者在特定模型、資料和提示設定下的結果。重用集的問題為合成題;BRIGHT 的主要匹配比較只有三個領域;文件更新後如何維護工作區仍未解決。原始回答 token 較多,效益並非單看準確率就能決定。
這篇論文問的不是「檢索要不要換成 Agent」,而是能不能把部分跨文件整理工作移到查詢前,並讓一次整理服務之後的多個問題。作者把工作區建置寫成有限步數的決策過程,以答案正確性回饋 Builder,再把學到的 Builder 與檢索、預先摘要和未經強化學習微調的基線相比。結果呈現一個值得實測的交換:更豐富的可導覽工作區能提升特定基準的答題率,也帶來建置與讀取成本。
本文以 arXiv v1 為準;該版本於 2026 年 10 月 15 日提交,屬尚未經同儕審查確認的預印本。下文將論文實驗視為作者報告,與公開程式提供的紀錄重算能力分開說明。文中原論文 Figure 4、Figure 6 與 Figure 7 依 arXiv 頁面標示的 CC BY 4.0 授權重製,並保留來源連結。
既有方法的限制:每個問題都從頭找,還是先整理再回答?
長文件問答的難處不只是把文件塞進模型上下文。企業知識庫、研究檔案或軟體專案中的關鍵資訊分散在多份文件裡:一個答案可能需要把版本說明、issue 討論和客戶回報連起來。反應式 RAG 先收到問題,再從原始文件找段落、合成回答。這種方式避免為未知用途做完整整理,但每個新問題都可能重複尋找相同關係。另一端的知識圖譜或預計算摘要把工作提前,卻可能將語料固定在一套抽取規則或任務相關性不明的分類中(論文 §1、§2)。
Librarian Agents 提出的中間問題是:若整理工作本身可以透過下游任務訓練,Builder 是否能做出比通用索引更適合 Answerer 使用的結構?這裡的「預先」很重要。Builder 看原始文件,卻看不到測試時的問題;它建出工作區後,Answerer 才收到一個問題並在其中導覽。方法不預先生成每題的答案,也不假設每個未來問題都能被合成摘要涵蓋。工作區保留通往原始文件的路徑,讓 Answerer 有機會回查被摘要省略的細節。
先分清三種角色
| 角色 | 看得到什麼 | 做什麼 | 評估中扮演的角色 |
|---|---|---|---|
| 原始語料 | 原始文件 | 作為不可被 Builder 刪除的底層來源 | 提供證據與回查路徑 |
| Builder | 文件與目前工作區,不看評測問題 | 建立、合併、刪除合成檔案,或停止 | 以隱藏問題上的下游效用接受強化學習訓練 |
| Answerer | 單一問題與最終工作區 | 列出、讀取檔案並產生答案 | 在固定模型設定下量測工作區是否有用 |
原始語料
- 看得到什麼
- 原始文件
- 做什麼
- 作為不可被 Builder 刪除的底層來源
- 評估中扮演的角色
- 提供證據與回查路徑
Builder
- 看得到什麼
- 文件與目前工作區,不看評測問題
- 做什麼
- 建立、合併、刪除合成檔案,或停止
- 評估中扮演的角色
- 以隱藏問題上的下游效用接受強化學習訓練
Answerer
- 看得到什麼
- 單一問題與最終工作區
- 做什麼
- 列出、讀取檔案並產生答案
- 評估中扮演的角色
- 在固定模型設定下量測工作區是否有用
這不是傳統個人助理的對話記憶:整理的對象是外部文件集合,不是 Agent 自己的聊天歷史;品質也由另一個 Agent 的問答表現判定。論文把「工作區能否支援下游回答」當作學習信號,讓組織方式與任務成功相連,而不只以摘要流暢度或人工定義的知識圖譜節點衡量。
核心直覺:把一部分檢索變成可重用的準備工作
想像一個語料包含產品設計文件、版本紀錄、issue 和客訴摘要。問題 A 會問某功能何時改變,問題 B 會問該改動影響哪些客戶,問題 C 會追問原始決策依據。反應式檢索可能每次都從不同關鍵字開始搜尋;固定索引則可能只有一種預先選好的切法。Librarian 的 Builder 可以先做出「版本時間線」、「元件索引」和跨文件摘要,並在每份合成檔案留下原始來源連結。不同問題再從同一工作區走不同路徑(論文 §2.2、Figure 1)。
關鍵不是「摘要越多越好」。有用的工作區需同時具備三件事:涵蓋多種可能問題且容易導覽;合成資料不足時可回到原文;整理成本可被多次查詢攤提。這三項在概念上互相牽制:為了讓索引短而簡潔,Builder 可能刪去罕見細節;若生成大量整理檔,Answerer 可能要讀更多內容;若資料更新,舊整理檔又可能誤導。作者稱這種提前建置的記憶為 anticipatory workspace,可譯為「預期式工作區」。它是一種先整理語料的系統設計,不表示模型真的預知將來的問題。
形式模型:工作區是什麼,Builder 究竟學什麼?
令原始語料為 ,未來問題從分布 抽樣。工作區 是一組檔案與目錄,附有節點類型和父節點等中繼資料。起始狀態 將原始文件放在根目錄下。每一步 Builder 選擇一種增補操作 ,把目前檔案系統改成 ;最多經過 步,或執行 Stop 後結束。原始文件不會被 Delete 操作移除。
| 動作 | 論文中的效果 | 為何可能有用/有風險 |
|---|---|---|
| CreateFile | 從原始文件或既有合成檔整理新檔,附上來源參照 | 可形成跨文件摘要;摘要可能漏掉局部細節 |
| MergeFiles | 把相關合成檔合成較高層檔案或目錄 | 建立階層和短導覽路徑;分組錯誤會把資訊放錯位置 |
| Delete | 從活動工作區移除冗餘或無助的合成檔,不刪原始文件 | 減少雜訊,同時保留原文回查 |
| Stop | 結束建置,交付目前工作區 | 決定後續回答使用的最終表示 |
這個動作集是論文為了限制學習問題而使用的介面,不是任何檔案系統都必須遵守的通用標準。Builder 的策略 根據目前狀態挑操作;Answerer 的策略 依問題 和工作區產生答案 。兩者分工讓建置政策可以相對於固定回答者最佳化:學到的是「哪種整理方式對這個回答設定有幫助」,不是獨立於 Answerer 的通用最佳知識組織。
論文將建置視為有限時域 MDP。狀態是目前檔案系統,動作是上述檔案操作,轉移是操作後的新工作區。若答案正確性以 0 或 1 表示,工作區在問題分布下的期望成功率可寫成 。作者也定義下游效用 ,可扣除合成記憶 token 與讀檔成本;建置目標則可再扣掉各增補操作的建置成本(§2.3,式 1–4)。
概念模型與主要實驗設定要分開看。 這些成本項說明方法可以如何表達「準確率與花費的取捨」;但 BrowseComp-Plus 的主要 RL 訓練明確設定 。也就是說,該次 Builder 主要直接從回答可答性探測與終端正確性得到訓練訊號,沒有把檔案階層、導覽成本或建置 token 成本放進主要獎勵。成本與結構在後續分析中是量測出的診斷結果,不應被說成 RL 已直接學會最省 token 的整理方式(§2.3、§2.4、Appendix A.7)。
為何作者使用增量獎勵
如果只在整個工作區完成後評一次分,Builder 前面做了很多操作,卻很難知道哪一步使回答更容易或更困難。論文定義了每次變更前後效用差的 dense reward,再扣除該步的建置成本;在不折扣回饋時,增量項會望遠鏡式相消,整體仍對應到最終效用減建置費用(式 2–4)。實際訓練沒有在每一次檔案操作後都讓 Answerer 回答,因為那會增加成本;作者每八個 Builder 步驟做一次可答性探測,最多四次,再加上結尾答案分數,並使用 GRPO 更新 Builder。這是對理想逐步效用差的實用近似,不是每個中間操作都被精確評估。
用一個例子走完整個方法
下面是根據論文機制寫成的教學示例,不是 BrowseComp-Plus 或 BRIGHT 的實際題目。假設一個研究團隊有散落的設計文件、issue 討論與版本公告,之後會反覆詢問某項 API 的行為何時變更、這項變更影響哪些功能,以及當初為什麼改動。
- 輸入語料,先不給未來問題。 Builder 看到的是原始文件集合,並不知道待回答的題目。這能避免它為單一已知問題量身製作答案,但也意味著它只能依訓練中學到的任務型態,為問題分布 整理語料。
- 建立跨文件合成檔。 Builder 可將多份材料整理成按版本排列的時間線,建立指向 API 設計說明和 issue 的元件索引,再把相關頁面合併成較高層的目錄檔。新檔應附上來源參照;原始文件仍留在檔案系統中。這些產物不是預先定稿的問答,而是讓 Answerer 能從不同層次開始探索的工作區。
- 遇到問題後由另一個 Agent 導覽。 若問題問「API 的預設值在哪個版本改變,且原因為何?」,Answerer 先讀時間線或索引,定位到相關版本,再循連結讀設計文件和 issue。它可能要讀更多合成檔才找到答案;整體正確率提升不代表單次讀取必然更省 token。
- 在摘要不足時回查原文。 若時間線只記錄新預設值,卻未保留決策原因,Answerer 可沿來源參照回讀原始 issue。這正是「忠實回退」的作用:合成檔提供導航,不應成為唯一事實來源。若參照斷裂、文件版本過期或回答者沒有追蹤引用,回退便可能失效。
- 重複問題,攤提一次建置。 多個未來問題可重用同一工作區。但如果每個 corpus 只查一次,提前建置成本就很難攤平;如果問題改變、語料持續更新或工作區讀取很昂貴,理論上的重用優勢也會縮小。
這個例子點出整篇論文的假設:未來問題雖未知,但會從一個可學習、且建置與測試相似的問題分布出現。若真實工作負載和訓練分布差很多,整理出來的階層可能很完整,卻不是使用者需要的入口。
實驗如何回答:準確率、重用、跨域與結構
BrowseComp-Plus 的主要保留任務
BrowseComp-Plus 將長文件集合和問題配對;答案所需資訊可能散落在多份來源。作者以 680 個 corpus-level task 訓練 Builder,另隨機抽出 50 個未見過的 corpus-level task 用於所有評估。建置時 Builder 只能看文件,不會看評測問題;完成的檔案系統供該語料的評測問題使用。主要指標是對固定參考答案的二元語意正確率,失敗建置與生成失敗仍留在分母中(§3、Appendix A.2)。
比較涵蓋 embedding/reranker、late-interaction、GraphRAG、Agentic RAG、AutoCompaction,以及沒有 RL fine-tuning 的 Builder。為隔離工作區品質,各方法共用固定的 Answerer;跨回答模型結果包含 Qwen3.5-4B 與 Gemini 3.1 Flash Lite。Figure 4 的結果顯示,Librarian Agents 分別達到 0.75、0.77;各模型最強列出的基線為 reranker 或 agentic RAG 的 0.44、0.42。這是相同實驗設定下的作者比較,支持該 benchmark 中 RL Builder 產生的工作區較能幫助固定 Answerer;它不等於模型或索引在所有長文件任務上的普遍優勢。
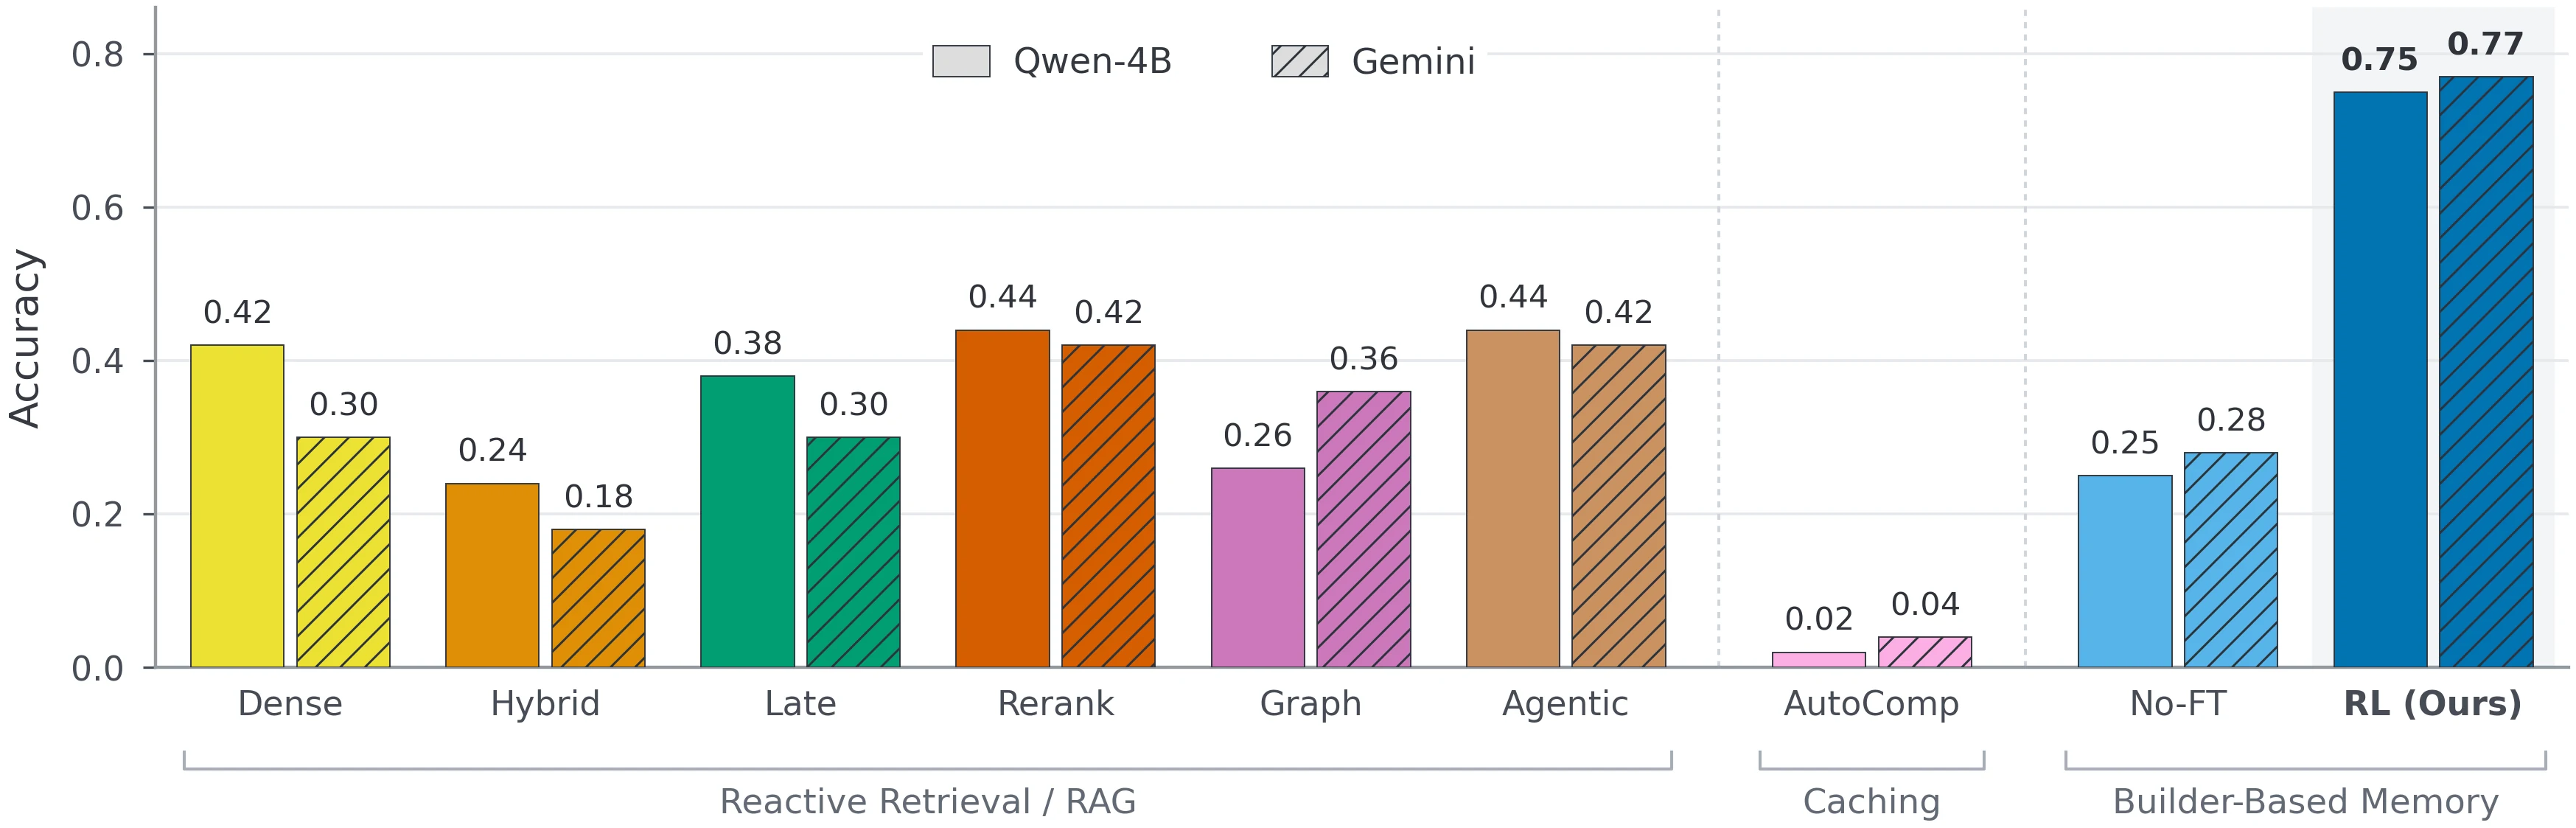 Figure 4(論文 §3,BrowseComp-Plus) 呈現兩種固定 Answerer 上的作者報告比較。閱讀時要同時看每個回答模型的基線,而不是只看最高一格;此圖的樣本單位是保留語料任務,不能把分數解讀成對任意企業知識庫的估計。來源:原論文 Figure 4。依 arXiv 頁面所示 CC BY 4.0 重製。
一次建置是否會在多個問題上回本?
主要保留任務每個語料提供單一任務,不足以呈現重用次數。因此作者另建立一組 443 個合成問題、跨 50 個 corpus 的重用評估;每個 corpus 有 7–10 題,問題由 Gemini 3.1 Flash Lite 參照 DeepDive 問題 few-shot 產生,且在執行評測時固定。這些題目不是 443 個不同的真實語料,也不是代表企業使用者自然提出問題的機率分布。作者在這個設定報告 RL Builder 準確率約 0.64,base Builder 約 0.24;RL Answerer 每題約讀 26.9 個檔案、9,346 個 token,而 base 約 2.72 個檔案、1,238 個 token(論文 Table 2、Appendix A.2)。
因此要問兩種不同的效率問題。每個答案的原始讀取量是否下降? 不一定;RL Builder 的豐富工作區讓 Answerer 讀取更多檔案與 token。考慮建置投入和答對率後,每個預期正確答案的紀錄 token 是否下降? 作者以成本曲線給出條件式答案:在十題/corpus 時,RL 相對 base 的「每個預期正確答案 token」比率為 0.662,配對 corpus bootstrap 95% CI 為 [0.504, 0.836];點估計交叉約在 31 題/corpus,區間為 18–54(Figure 6、Appendix A.4)。這是用已記錄 token 數與全分母準確率做的估算,不是美元成本、端到端延遲或實際採用效益。
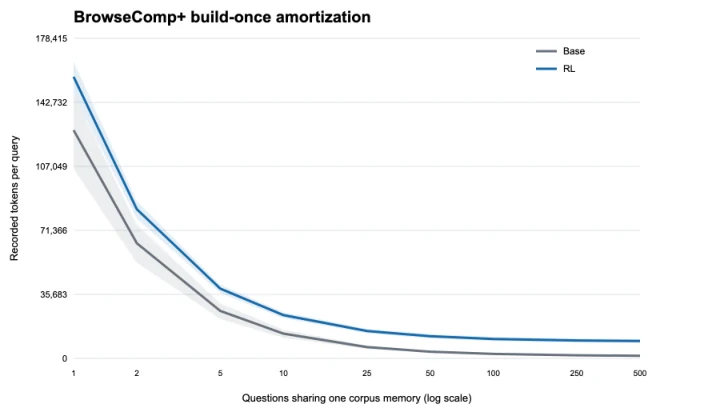
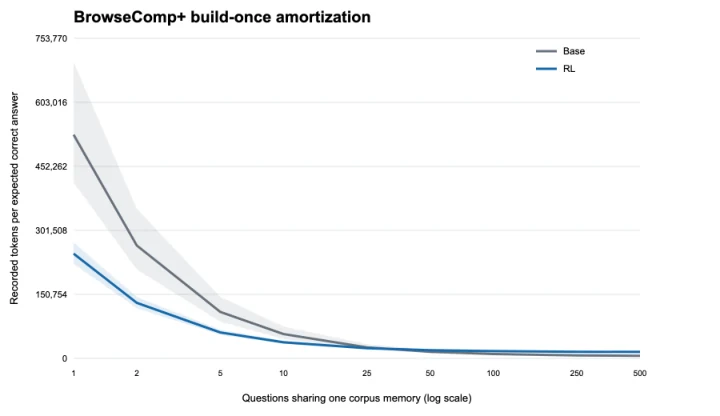 Figure 6(Appendix A.4) 將建置成本 攤到每個 corpus 的 個問題,再加上每題回答階段成本 :。右圖再除以作者觀察到的準確率 ,比較每個預期正確答案的 token。曲線根據凍結紀錄與配對 corpus bootstrap 計算,展示的是特定語料、模型、紀錄成本和成本定義下的重用分析;不是部署帳單預測。來源:原論文 Figure 6。依 arXiv 頁面所示 CC BY 4.0 重製。
目前 repository 的 RESULTS.md、REPRODUCING.md 又描述 443 題評測的一組緊湊紀錄:282/443 對 107/443,準確率 63.66% 對 24.15%;Librarian 建置 token 為每 corpus 147,634,並稱 20 題/corpus 約為 16.8K 記錄 token/題。論文主要段落另報 178,926 建置 token,20 題約 18K。這兩組建置成本來自不同實驗協定;不應把各自的分子、問題數或成本曲線混在一起。讀者可用 repository 腳本從緊湊分數紀錄重算該組結果,但這不會重跑建置、模型生成或原始 benchmark。
BRIGHT 零樣本轉移
作者接著問只在 BrowseComp-Plus 訓練的 Builder,能否套用於不同領域。BRIGHT 主比較取 AOPS、Biology 與 Stack Overflow 各 50 題,總計 150 題;對每個領域只建一個看不到評測題的共用工作區。以固定 Qwen3.5-4B Answerer 評估,Librarian 的平均 pass@1 為 52.0%(SE 2.8),dense retrieval 為 20.8%(SE 2.9);平均 pass@3 分別 66.8%(SE 3.4)和 28.0%(SE 3.5)。pass@3 是作者用每題四個回應估計「三次機會至少答對一次」的無偏估計,不是直接只生成三次得到的簡單比例(Table 3、Appendix A.2)。
三個領域的效果並不等幅:AOPS 從 dense 31.5% 到 36.0%,Biology 從 19.5% 到 34.5%,Stack Overflow 從 11.5% 到 85.5%。因此平均提升主要受到 Stack Overflow 這個領域的大幅差距影響;平均結果不能掩蓋分域表現,也不能證明跨域轉移在更多任務上都可靠。附錄 Table 6 另報九個 BRIGHT domain、每域 的 Builder 對 base 比較,但沒有同一組完整匹配檢索基線。這些方向一致的結果可視為補充訊號,不是和三個主領域同等強度的廣泛泛化證明。
結構診斷與回退案例:階層有什麼用?
如果 RL 只是多產生一些摘要,層級結構是否真的重要?作者在 49 個已有完成工作區的 corpus 上,使用重用擴展集中的 435 題,對同一批內容做原始階層、flatten 與 shuffle 三種匹配比較。Table 7 的原始結構準確率 55.86% ± 2.58%、平均導覽 token 3,635 ± 216;flatten 後準確率 57.70% ± 2.81%,導覽 token 升到 5,497 ± 356;shuffle 後準確率降至 51.72% ± 2.87%,導覽 token 為 3,612 ± 221。此結果顯示,在這個另開的匹配回答流程中,移除層次與打亂語意位置的影響不同:flatten 增加導覽成本,shuffle 降低正確率。它不是主要 Figure 4 結果的消融,也不是完整 Builder 訓練的端到端重做;問題集、完成語料數和評估流程都不同。
Figure 7 給出更具體的回退例子:合成工作區沒有包含一項回答所需細節,Answerer 透過 provenance 資訊回到相關原始文件並找回答案。這說明來源路徑能支援補救,但這是一個質性案例,不是「摘要遺漏時都能恢復」的失敗率估計。實際系統仍需確保連結可讀、原文版本可辨識、Agent 知道何時回查,並讓回答保留可檢查的來源。
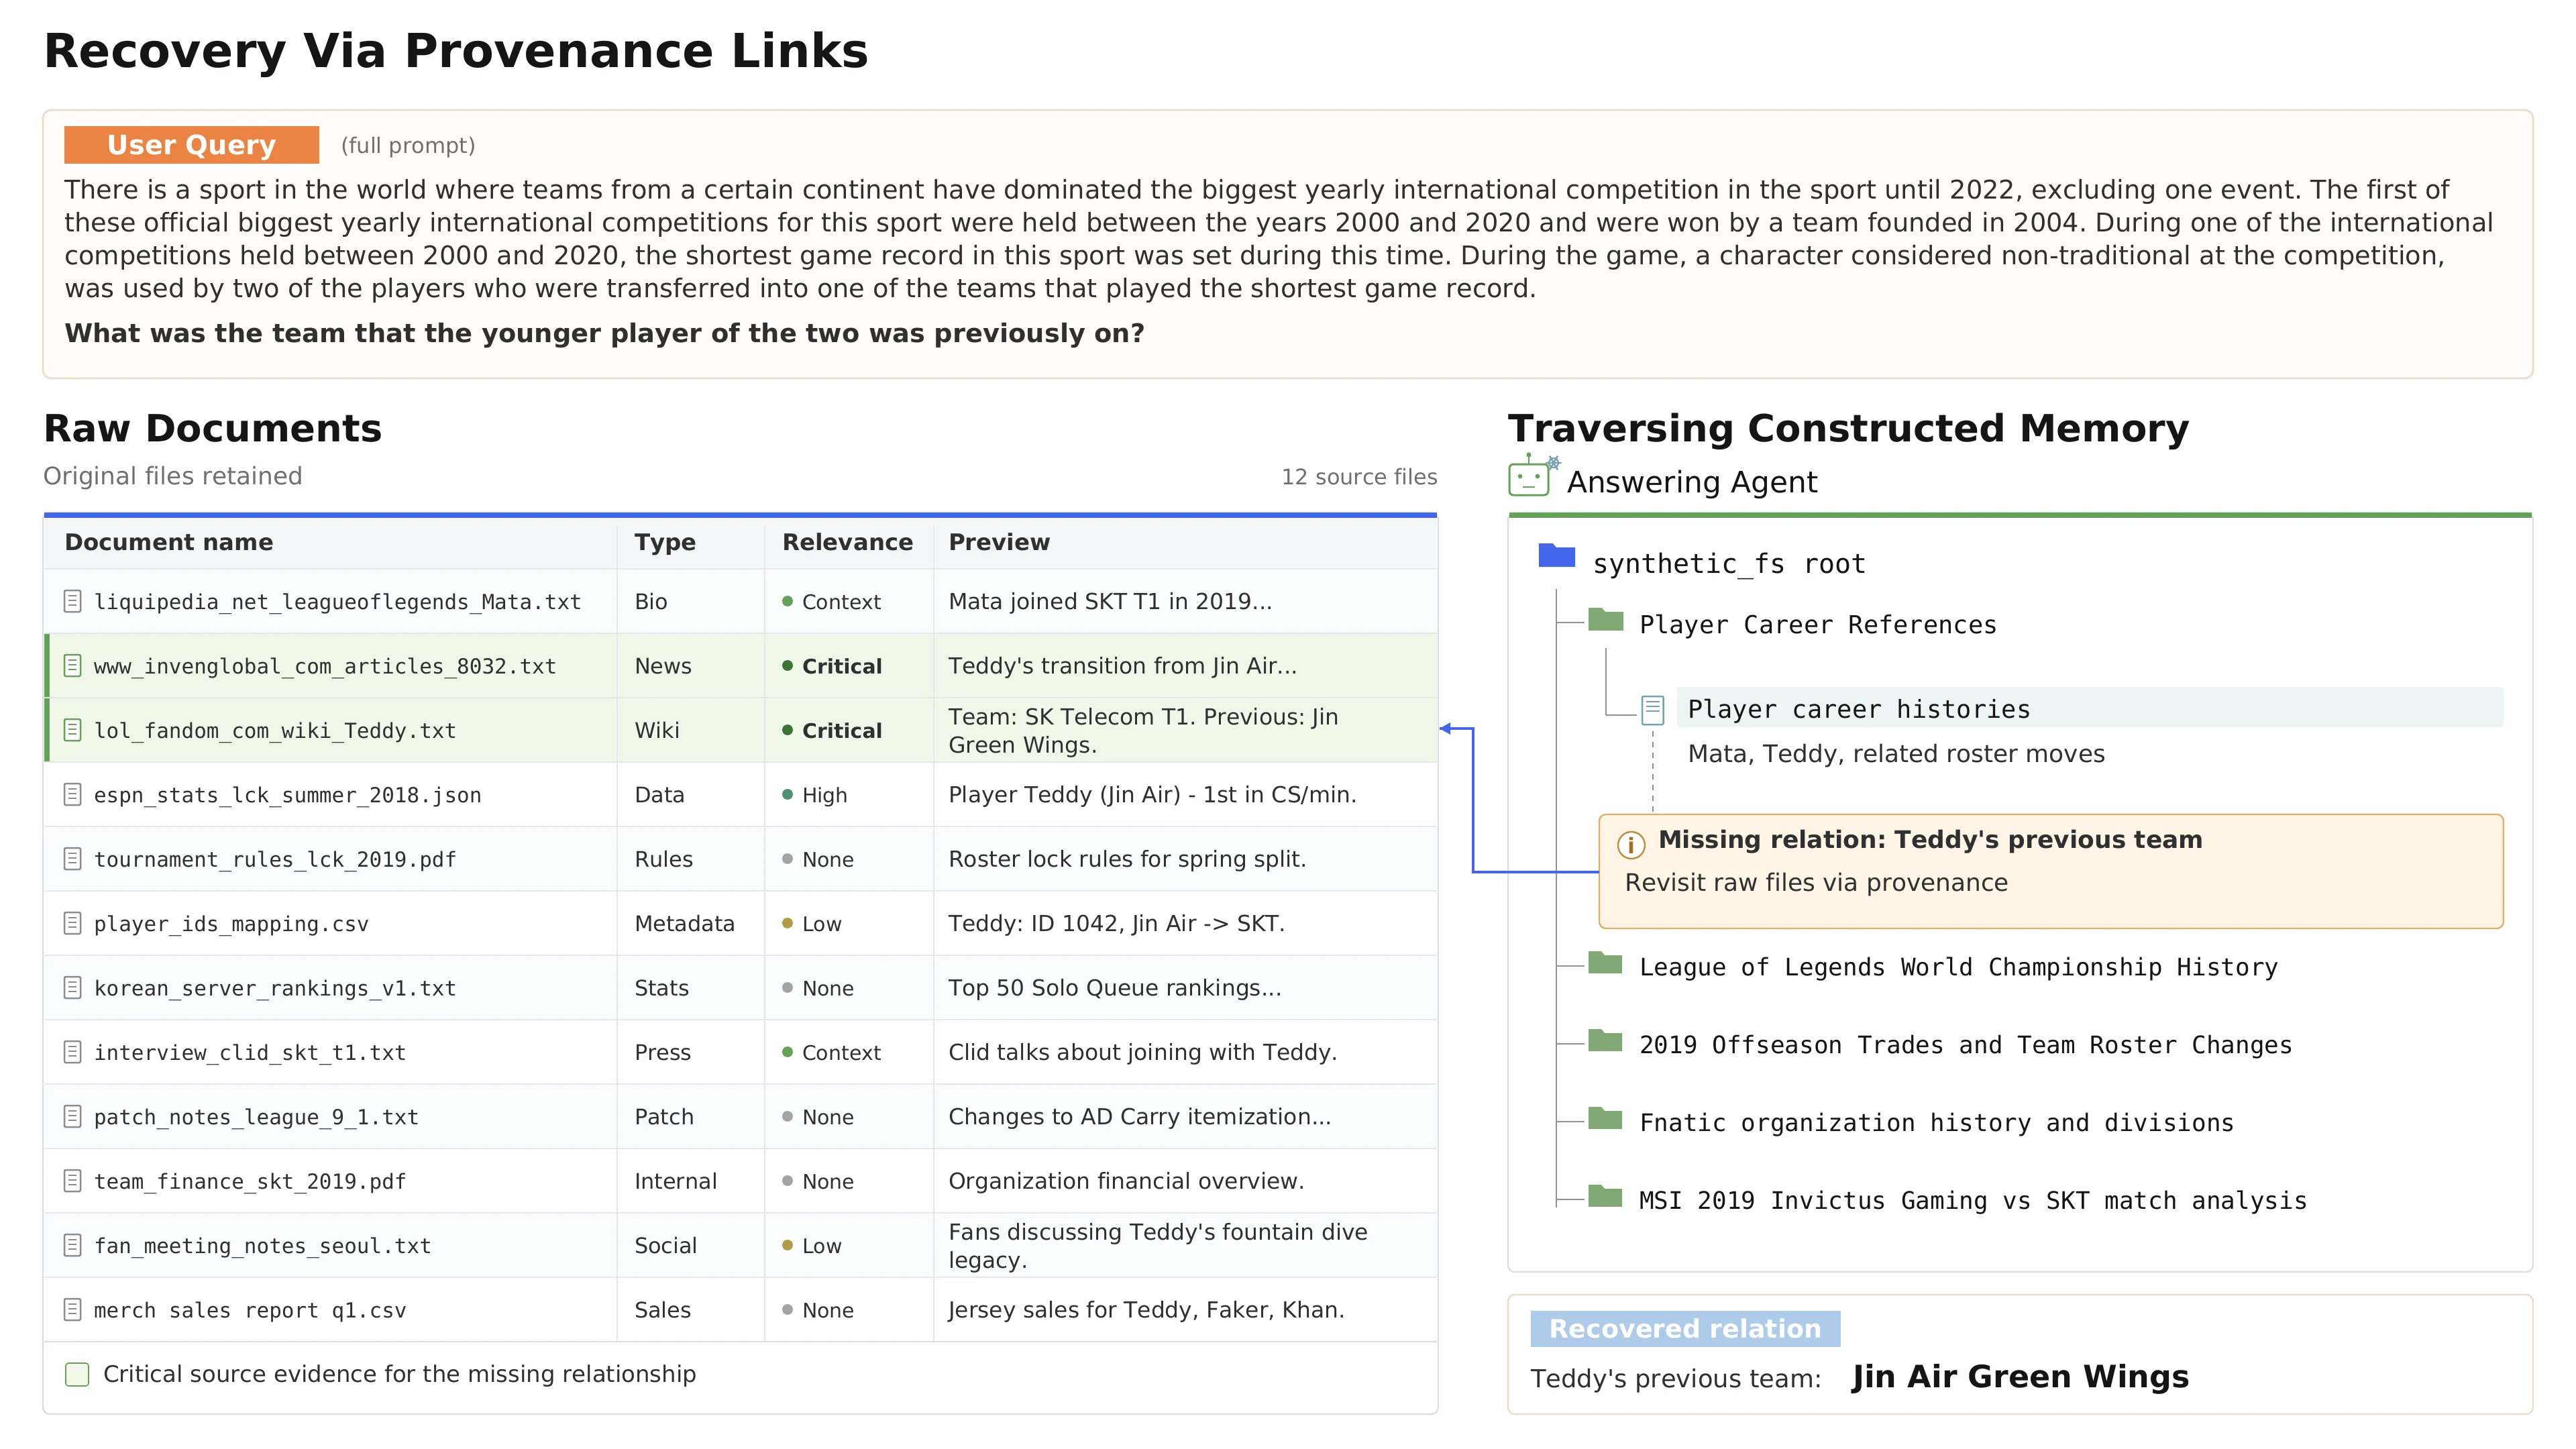 Figure 7(Appendix A.6) 展示作者選出的 provenance 回查案例,重點是合成記憶並未取代原始語料,而是可在需要時引回原文。它只證明論文呈現了這條成功路徑,沒有量化未能恢復的案例或來源鏈失效機率。來源:原論文 Figure 7。依 arXiv 頁面所示 CC BY 4.0 重製。
證據地圖:結果建立了什麼,還留下什麼
| 問題 | 論文證據 | 可支持的結論 | 不足以支持的說法 |
|---|---|---|---|
| RL Builder 是否改善該基準答題? | Figure 4:50 個保留 BrowseComp-Plus corpus-level task、兩個固定 Answerer、多種檢索與預先整理基線 | 在此基準與設定中,作者訓練的 Builder 產生了更有助於下游答題的工作區 | 所有語料、模型、企業知識庫或即時產品都會有同樣提升 |
| 重複問題能否攤提建置成本? | 443 題合成重用集;Figure 6 與 Appendix A.4 用紀錄 token、準確率、bootstrap 曲線分析 | 重用數與每個預期正確答案的紀錄 token 會改變方法間的成本排序 | 一定省錢、延遲更低,或在任何實際查詢分布下都比 RAG 划算 |
| Builder 能否跨域使用? | Table 3:BRIGHT 三個領域各 50 題;Table 6 九個附加領域各 20 題 | 作者觀察到固定測試設定中高於基線的跨域結果 | 廣泛外部效度、所有領域穩定泛化或真實使用者工作流改善 |
| 工作區結構是否重要? | Table 7:49 個完成 corpus、435 題的 original/flattened/shuffled 同流程比較 | 在該分析中,階層影響導覽成本,語意位置被打亂時正確率下降 | 唯一最佳階層,或已隔離所有結構、內容與模型交互作用 |
| 合成摘要漏資料如何處理? | Figure 7:單一來源回查成功示例;§2.2 描述保留原文參照 | 原始來源回退是架構中的重要能力,也有呈現成功例 | 回退一定成功,或 provenance 已保證答案主張的引用忠實度 |
還有一個重要的訓練與評估邊界:作者為了選 Builder 的學習目標,使用隱藏訓練問題估計可答性,並明確不讓評測問題參與建置或選 checkpoint。這比把測試題直接提供給 Builder 來整理更合理;不過對分布 的假設仍然存在。未來問題必須和訓練時的任務及文件形態有足夠關聯,Builder 才可能建立有用的共通入口。
限制:靜態語料、成本口徑與可部署性
- 語料更新尚未解決。 論文評估的是靜態文件集合。文件新增、刪除或修訂後,何時重建、局部更新或失效工作區仍是開放問題;若不處理,合成摘要可能過期。
- 預先建置要求可重用負載。 建置成本由每個 corpus 的查詢數分攤,並且答案端會讀取更豐富的工作區。作者的 token 曲線把正確率納入後仍得到條件式 crossover;不能只拿 accuracy 或建置 tokens 單獨代表總成本。
- 評估對象有限且部分是合成的。 主要測試是 50 個保留語料任務;重用擴展是 443 個合成問題、50 個語料;BRIGHT 的主匹配比較是三個領域、150 題。沒有長期線上流量、跨公司部署或真實使用者成本資料。
- 訓練和評測依賴固定服務與模型。 公開 reproduction guide 列出 Qwen3.5-4B Builder、Qwen3.5-35B-A3B 的 Create/Merge executor、Gemini 3.1 Flash Lite 的歷史壓縮等配置;其他配置涉及 Tinker、Modal 和 API 金鑰。換模型或供應商可能改變工作區內容和分數。
- 回查能力不是來源治理保證。 工作區保留 provenance link,但論文未評估文件版本漂移、連結完整性、權限邊界或回答的逐主張引用忠實度。回到原始文件仍需正確定位與人工/自動核實。
- 不宜將 benchmark 對比解讀為通用檢索排名。 Baseline 的模型、索引、建置方式、成本及回答流程均有各自配置。即使某一列被稱為 strongest baseline,也只在該測試協定下成立;跨 protocol 的 178,926 與 147,634 builder tokens 不可互換。
作者也指出 Builder 的大檔案上下文可能限制擴展,未來可和 clustering 或 retrieval 組合;有限的合成產物不可能涵蓋每個罕見問題,因此是否以及何時跳過摘要、回到原始文件仍是系統問題(論文 §4)。這些不是小型部署細節,而是決定此方法適不適合動態知識庫的重要條件。
Artifact 與可重現性
截至 2026 年 10 月 19 日,作者的 GitHub repository 公開 MIT 授權程式、環境、訓練與檢索方法、設定、測試、緊湊結果紀錄和指標重算腳本。論文 Appendix A.11 將合成工作區、logs 與實驗結果標示為 CC BY 4.0;模型、BrowseComp-Plus、BRIGHT 與 DeepDive 資料仍各受其供應者或上游條款約束。
scripts/reproduce_results.sh 依 README/REPRODUCING.md 從 bundled score records 重算重用、BRIGHT、hierarchy ablation 等已記錄指標,並檢查 aggregate、設定與訓練 reward 序列。這是對已發布紀錄的可檢查重算,不是重建工作區、重新訓練模型或獨立重跑完整 benchmark。完整訓練需要 Python 3.11+、依賴安裝、Tinker、Modal、模型/API 權限與環境設定;部分 baseline 另需 CUDA。本文採用作者報告的實驗數據,未執行完整重現。
Bloss0m 工程判斷:什麼情況適合先整理?
Bloss0m 工程判斷:值得帶走的不是「把 RAG 換成檔案系統」,而是把語料預處理視為可用下游任務評分的策略。若一份相對穩定的語料會反覆服務相近類型問題、跨文件線索常被重複挖掘,而且系統能保存原文與版本來源,預先整理工作區值得和即時 retrieval 放在同一資料與回答器下對比。對短生命週期、一次性查詢、文件頻繁變動或權限差異細緻的語料,建置和維護成本可能抵銷優勢。
落地評估至少要固定 corpus 版本、未見查詢集合、Answerer 版本、回答與判分預算,並同時量測正確率、建置 token/時間、每題讀取 token、每個預期正確答案成本、回查成功率和更新後的失效情況。特別要問工作區重用的真實次數,而不是直接把論文估計的 31 題轉成採購門檻。該點估計來自特定記錄成本曲線和 bootstrap 區間,不等於任何團隊的經濟 break-even。
最穩妥的系統想像是「可回查的整理層」,不是不可質疑的知識庫:合成檔協助找到脈絡,引用連回版本化原文,工作區可按更新失效,Answerer 在不確定時能退回來源。這是 Bloss0m 工程化整理,不是論文明確驗證的生產架構。若無法確保來源權限、日期與回查鏈,則不應因 benchmark 分數高就把合成摘要當成權威答案。
可接著閱讀 RAG 的基本架構與運作原理、用貝氏模型拆解 RAG 評估 與 TRACE 的來源可追溯 Agentic Retrieval。它們分別補足檢索流程、評估判斷和檢索路徑可檢視性的問題。
讀完後的三個記憶點
- 技術想法:Builder 先依文件建立合成、階層式、保留來源路徑的工作區,Answerer 再依未來單一問題導覽;訓練直接使用下游回答訊號。
- 證據:作者在 50 個保留 BrowseComp-Plus 任務、443 題合成重用測試及 BRIGHT 評估報告高於基線的結果;來源結構和回查也有額外診斷,但尚無獨立完整重跑。
- 採用邊界:成本取決於真實重用量、回答器讀取工作區的 token、靜態/更新中的語料差異,以及能否保留可靠原文回退;測試結果不保證生產收益。
Primary sources
- Singh, Anikait, Teresa Zhang, Yoonho Lee, Roshen Sanjay Nair, Aviral Kumar, and Chelsea Finn. “Librarian Agents: Training LLMs to Curate Long-Context Workspaces that Anticipate Future Queries,” arXiv:2610.22273v1, submitted 15 October 2026. See §2–4, Figures 1–7, Tables 1–7, and Appendices A.1–A.11.
- Authors’ code and artifact repository, including
RESULTS.md,REPRODUCING.md,CHECKPOINTS.md, and MIT license. - Authors’ project site.