論文精讀
RetrievalRouter 精讀:讓每個查詢選擇合適的檢索路徑
原文:RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval
90 秒掌握論文
- 問題:文件查詢的難度與證據形態不同。只用 BM25 便宜,卻可能找不到圖表與語意改寫;只用多模態晚期交互則能保留頁面細節,卻可能為每個普通查詢付出很高的延遲。固定選一條管線,會把同一種成本與失敗模式套用到所有查詢。
- 核心洞見:論文把「選哪個 retriever」改成每個查詢都可調整的預測問題。RetrievalRouter 只讀查詢文字,從 BM25、文字 dense、文字 rerank、多模態 dense、多模態 rerank 五條路徑中選一條;訓練目標同時考慮該查詢的 nDCG@5 和正規化延遲。
- 最強證據:在 REAL-MM-RAG、T2-RAGBench、MMDocRAG 的 11 個資料集、85,103 個查詢上,RetrievalRouter 的 λ=0.1 點報告 nDCG@5 0.755、平均延遲 0.666 秒;固定最準確的多模態晚期交互為 0.737、8.283 秒(Section 6、Tables 1–2、Figure 2)。
- 主要邊界:數字來自作者在單張 NVIDIA H100 80GB 上跑的離線 benchmark。索引儲存、建置與更新、多人併發、硬體差異、查詢分布轉移和線上端到端成本,尚未由這個結果證明。
這篇論文處理一個 RAG 工程裡很實際的矛盾:某些問題只需詞面比對,某些需要理解改寫,另一些則必須讀表格、圖形或跨頁線索。若系統每次都跑最重的多模態晚期交互,簡單問題也會變慢;若只使用便宜文字向量,視覺資訊可能在檢索前就被文字抽取抹掉。作者因而提出 RetrievalRouter,讓小型查詢編碼器在查詢時選擇檢索管線。論文的結果顯示,在它測量的資料集和硬體上,動態選擇能落在比固定管線更好的準確率—延遲位置;讀者仍須追問,離線查詢延遲是否足以代表多管線系統的實際營運成本。
本文依據 2026 年 8 月 26 日提交的 arXiv v1;作者與程式庫標示為 EMNLP 2026 主會議論文。下文把論文主張、實驗直接支持的範圍與 Bloss0m 的工程推論分開說明。
既有方法的限制:固定路徑把相同代價加在不同查詢上
傳統做法先在設計階段固定一個 retriever,或只依查詢是否成功把簡單與昂貴路徑串接。這些決策無法表達「兩條路都找得到相關文件,但其中一條對這題排序明顯更好」的細節,也容易把某一類文件的視覺能力強加給所有查詢。晚期交互可保留細節,卻帶來較高推論與索引成本;reranking 減少了候選範圍,但當 dense 路徑已足夠時仍可能浪費或傷害排序。論文要補上的缺口,是在同一底層語料與多種異質 retrieval pipelines 之間,學習每個 query 的品質—效率選擇。
先理解檢索設計空間:模態與架構是兩條軸
檢索系統至少有兩種互相交叉的選擇。第一是模態:文字管線先抽取文件文字,再對文字建索引;多模態管線則直接將頁面影像編碼,較能保留版面、圖表和表格線索。第二是架構:dense retriever 把一段文件壓成一個向量,搜尋效率較高;late interaction 保留詞元或頁面 patch 的多個向量,查詢時計算細緻匹配,通常更昂貴。Reranking 則先用較快的 retriever 找候選,再讓 late-interaction 模型只重排候選清單。
因此,一條「檢索品質」軸不足以描述部署選擇。文字抽取可能丟失空間結構;dense 壓縮可能平均掉文件不同位置的證據;晚期交互則要索引更多向量、執行更多比較。多模態也不是單向升級:直接讀頁面影像能處理圖表,但長段文字細節仍可能由文字管線處理得更好。作者在 Section 3 定義七條比較管線,其中五條成為可學習的路由選項,兩條純 late-interaction 管線保留為靜態基準。
| 縮寫 | 路徑 | 本文中的角色與代價 |
|---|---|---|
| BM25 | 抽取文字上的詞面搜尋 | 最便宜;精確詞彙相符時足夠,但不擅長同義改寫,也看不到未轉成文字的版面資訊 |
| TD | 文字 dense | 以單一向量表示文字,能找語意近似;編碼和向量搜尋比 BM25 貴 |
| TL | 文字 late-interaction | 保留文字 token 細節;作為較慢的靜態比較,不在五個路由動作中 |
| TR | 文字 dense 後接 late-interaction reranker | 先找 100 個候選,再精排,以較低成本取得部分細節匹配能力 |
| MD | 多模態 dense | 將整頁影像壓成單一表示;在多模態路徑中較快 |
| ML | 多模態 late-interaction | 使用頁面 patch 細節;最強靜態效果之一,但代價最高 |
| MR | 多模態 dense 後接 late-interaction reranker | 先視覺檢索,再精排候選;是重要的可部署固定基準 |
在其設定中,文字管線另外使用視覺語言模型為圖表與表格產生描述,再接到抽取文字,因此文字與多模態的差距不是單純「文字索引完全沒看見圖」。作者意圖比較架構本身在所列管線上的表現。然而,描述模型也成為文字管線的前處理依賴,其他團隊以不同 OCR、captioning、索引切分或向量資料庫建置時,可能量到不同的品質與延遲。
這個設計空間與 BM25 在大規模搜尋中的成本角色及複雜切塊何時值得採用相互補充:前者提醒便宜詞面搜尋仍可成為有效路徑,後者提醒文件表徵的維運複雜度也要計價。RetrievalRouter 的新意是把多種路徑視為同一個查詢選擇問題,而不是宣稱其中一種架構淘汰其他架構。
核心直覺:讓查詢類型決定付出哪種成本
固定管線相當於事先對所有問題做相同賭注。若選擇最便宜者,較難的查詢可能失敗;若選擇最精細者,很多簡單查詢也支付不必要的延遲。路由器的基本假設是:即使不先掃描所有文件,查詢文字也包含一些可預測訊號,能指出所需能力。例如「哪一行寫著總資產」可能可由詞面比對解決;「圖表中藍色柱代表哪個年度」需要視覺資訊;「同一份長報告首尾兩處證據如何共同支持結論」可能需要保留多處細節的檢索表示。
這些例子是對論文 Figure 1 所列定性案例的說明,不代表每一類問題都可由特定詞彙穩定識別。路由器不是直接讀文件再決定,也不會先對五條管線各跑一次、找出贏家;它以離線標註學得一個 query-only policy,線上只執行政策並選一個動作。它能否在新文件、不同語言或負載下做出合理選擇,取決於訓練資料中「查詢形式—各管線成績」的對應是否仍成立。
一個容易忽略的概念點是,這裡的「適合」同時包含檢索有效性和相對延遲。所以改變 λ 會改變 router 被教成什麼樣的路由器,而不只是部署時加上一個即時速度旋鈕。論文分別訓練不同 λ 的 checkpoint 來形成前緣;使用者不能直接把已訓練 λ=0.1 的模型任意改成 λ=0.7 而假設策略會相同。
用一個查詢走完整個方法:從候選路徑到一次選擇
假設使用者在一份年報中問:「右側柱狀圖裡,哪個顏色代表海外營收?」這是幫助理解方法的示例,並非論文評測的逐字查詢。
- 離線建立每條路徑的觀測結果:在資料集的訓練查詢上,研究者對五個路由動作各自執行檢索,記錄 nDCG@5 和 wall-clock latency。nDCG 衡量相關文件在前五名中的排序品質,且對更前面的結果給更高權重。這一步成本不會在每次線上查詢都重做。
- 將品質與速度轉成 per-query reward:對每條路徑計算 。其中 是該路徑對查詢 q 的 nDCG@5, 是此路徑延遲除以同一查詢五條路徑延遲總和後的正規化值。λ 越小越重視排序品質,越大越重視相對速度。
- 保留多個近似最佳選擇:reward 向量不直接轉成單一「冠軍」標籤,而經溫度 τ=0.1 的 softmax 轉成 soft target。若某兩條路徑對這題得到接近的 reward,訓練目標會保留兩者偏好程度,而不任意把微小差異當成絕對分界。
- 學習查詢表示到路徑分布的映射:Qwen3-0.6B-Base 編碼查詢,加入 LoRA adapter,將最後隱藏狀態平均池化成 1024 維向量,再由單層線性 head 輸出五條路徑的分數。以預測政策對 soft target 最小化 KL divergence。
- 線上只選一條路徑並回傳候選:輸入這個「右側柱狀圖顏色」查詢後,政策以最大機率選擇 BM25、TD、TR、MD 或 MR 的其中一條,再由該路徑搜尋頁面。若查詢中的視覺指示和訓練模式足夠類似,多模態路徑可能較合適;路由器不會證明該路徑一定成功,也不會檢查另一條路徑是否找出更好答案。
- 失敗邊界要回到檢索結果,而非 policy confidence:如果題目要求長距離文字推論,或圖表色彩在渲染時遺失,查詢文字分類可猜對模態,檢索仍可能因索引品質或模型能力失敗。論文報告的 router 選擇準確度不能替代每次檢索的相關性驗證。
這個流程分開兩種工作:資料製備期間以昂貴的多路徑測量建立「每個查詢各路表現」監督訊號;推論時則使用小型政策避免每次都支付所有路徑的執行成本。測得每個訓練查詢的多路徑 reward 是訓練資料的標註成本,不能只報線上 15 毫秒 router overhead 就當作整套方案沒有前置成本。
技術機制:五個動作、soft target 和 λ 前緣
作者先比較七種 retrieval pipelines,再基於初步分析排除純 TL、ML 作為路由動作。理由是相應的 reranking 管線 TR、MR 在接近效果下顯著降低延遲;若把近乎重複的兩個動作一起交給模型,路由標籤會更難學。這裡的「五條路徑」指 BM25、TD、TR、MD、MR;TL、ML 仍出現在靜態基準與 Oracle 動作集合中。不要將路由集合和所有比較管線混為一談。
在查詢 q 上,路由動作 的品質分數是 ,延遲為 。作者以當次查詢五個可選管線延遲總和將其正規化:。然後定義:
正規化延遲是一種相對效率獎勵,讓兩個不同查詢各自的路徑能比較;它不是直接將實際延遲轉成美元成本,也不等於在服務 SLA、資源費用或索引更新等條件下的效用函數。λ=0 只看 nDCG,λ 趨近 1 越傾向較短路徑。掃過 λ 會訓練不同政策 checkpoint,呈現作者所稱的 accuracy-latency frontier。
為避免硬標籤把「並列」或幾乎相同的 reward 強行分成對錯,作者將 reward 除以 τ=0.1 後再 softmax:。低溫會放大小小 reward 差異,exact tie 仍是 tie;全部 reward 為零的查詢不進入梯度。當 λ 大於零,即使所有路徑都沒有相關結果,速度項仍能提供偏好訊號,所以不會全被排除。模型預測出的 以 KL loss 擬合這個分布,而不是直接回歸答案文件。
Query encoder 使用凍結的 Qwen3-0.6B-Base 權重,LoRA 套用在 attention 和 feedforward projection;只以查詢文字形成 1024 維 pooled representation,後接線性決策 head。部署時取 。因此它是單一動作選擇,不是 cascade,也不是多檢索結果融合。要避免把多路徑測量的「oracle」和可部署 router 混淆:oracle 能知道當題目各管線的實際 reward 後再選最佳者,僅是上限參考,沒有 query-only 推理可用的資訊條件。
有用的操作差別是 λ 的兩種位置:它一方面改變訓練 reward,另一方面在文章中用來描繪政策能力前緣。固定部署一個 λ checkpoint 後,線上查詢不會看到系統依 workload 即時調整政策偏好。若要從低延遲模式切至高品質模式,現有實驗支持的做法是選擇另一個相應 checkpoint,再驗證新工作負載,而非把 λ 參數塞給既有政策就假設立刻生效。
實驗如何讀:11 個資料集的結果到底比較了什麼
作者將 REAL-MM-RAG 的 FinReport、FinSlides,T2-RAGBench 的 FinQA、ConvFinQA、VQAonBD、TAT-DQA,以及 MMDocRAG 的 ArxivQA、Wiki-SS、MP-DocVQA、SciQAG、DUDE 合計為 11 個 dataset、85,103 個 query。涵蓋財務文件、科學論文、開放領域與圖表密集簡報。論文所有檢索管線、router 訓練和推論都放在同一張 NVIDIA H100 80GB 上量測,提升該實驗內時間比較的一致性;它不能代表各模型以不同硬體、批次、快取或索引布局運作時的實際部署快慢。
主要指標是 nDCG@5、MRR@5、Recall@5,以及包含 router inference、embedding generation、vector search 的每查詢平均與 P95 latency。統計上,作者先檢視成對差值常態性,選擇 paired t-test 或雙尾 Wilcoxon signed-rank test,並使用 Holm correction 控制計畫比較的 family-wise error;顯著性門檻為 。Storage 部分報告四個 neural vector index 的磁碟 footprint;合併語料時,多模態 late-interaction index 約 39 GB,文字 dense index 約 3 GB,前者超過 13 倍,BM25 詞法索引則未計入向量儲存表(Limitations、Table 3)。這說明 query latency 的取捨可能由更多常駐儲存換來,仍不可由向量表推斷全部索引與維運成本。
| 評估問題 | 論文觀察 | 解讀邊界 |
|---|---|---|
| 固定管線有沒有一條兼顧效果與速度? | ML 的 nDCG@5 最高,0.737,但平均需 8.283 秒;MR 為 0.733、1.121 秒;MD 為 0.666、0.385 秒;BM25 為 0.510、0.019 秒(Table 1) | 這說明此 benchmark 上不同管線形成取捨,不能證明任意企業 corpus 都呈現相同排序 |
| router 前緣是否改善固定神經管線? | λ=0.1 時 0.755、0.666 秒;λ=0.5 時 0.707、0.314 秒;λ=1 時 0.510、0.034 秒(Table 2) | 前兩點顯示所測範圍的準確率—延遲組合;λ=1 即使都選 BM25,仍比 BM25 原管線多約 15 ms policy overhead |
| 是否優於較接近的既有 adaptive baseline? | λ=0 至 0.5,router nDCG 顯著較高,但該 baseline latency 較低;λ=0.7,router 數字 0.630/0.148 秒,baseline 0.624/0.171 秒,差異不顯著(Section 6) | 不是全點都統計顯著領先。準確率導向點有更高效果也付出較多時間,需依需求選 operating point |
| 理論上還有多少選擇空間? | 7 pipeline per-query oracle 在 λ=0.1 報 0.901,遠高於 router 0.755(Table 2) | Oracle 看過每條路徑對測試查詢的 reward,非部署策略;高 gap 同時代表可提升空間和 query-only router 仍有錯選 |
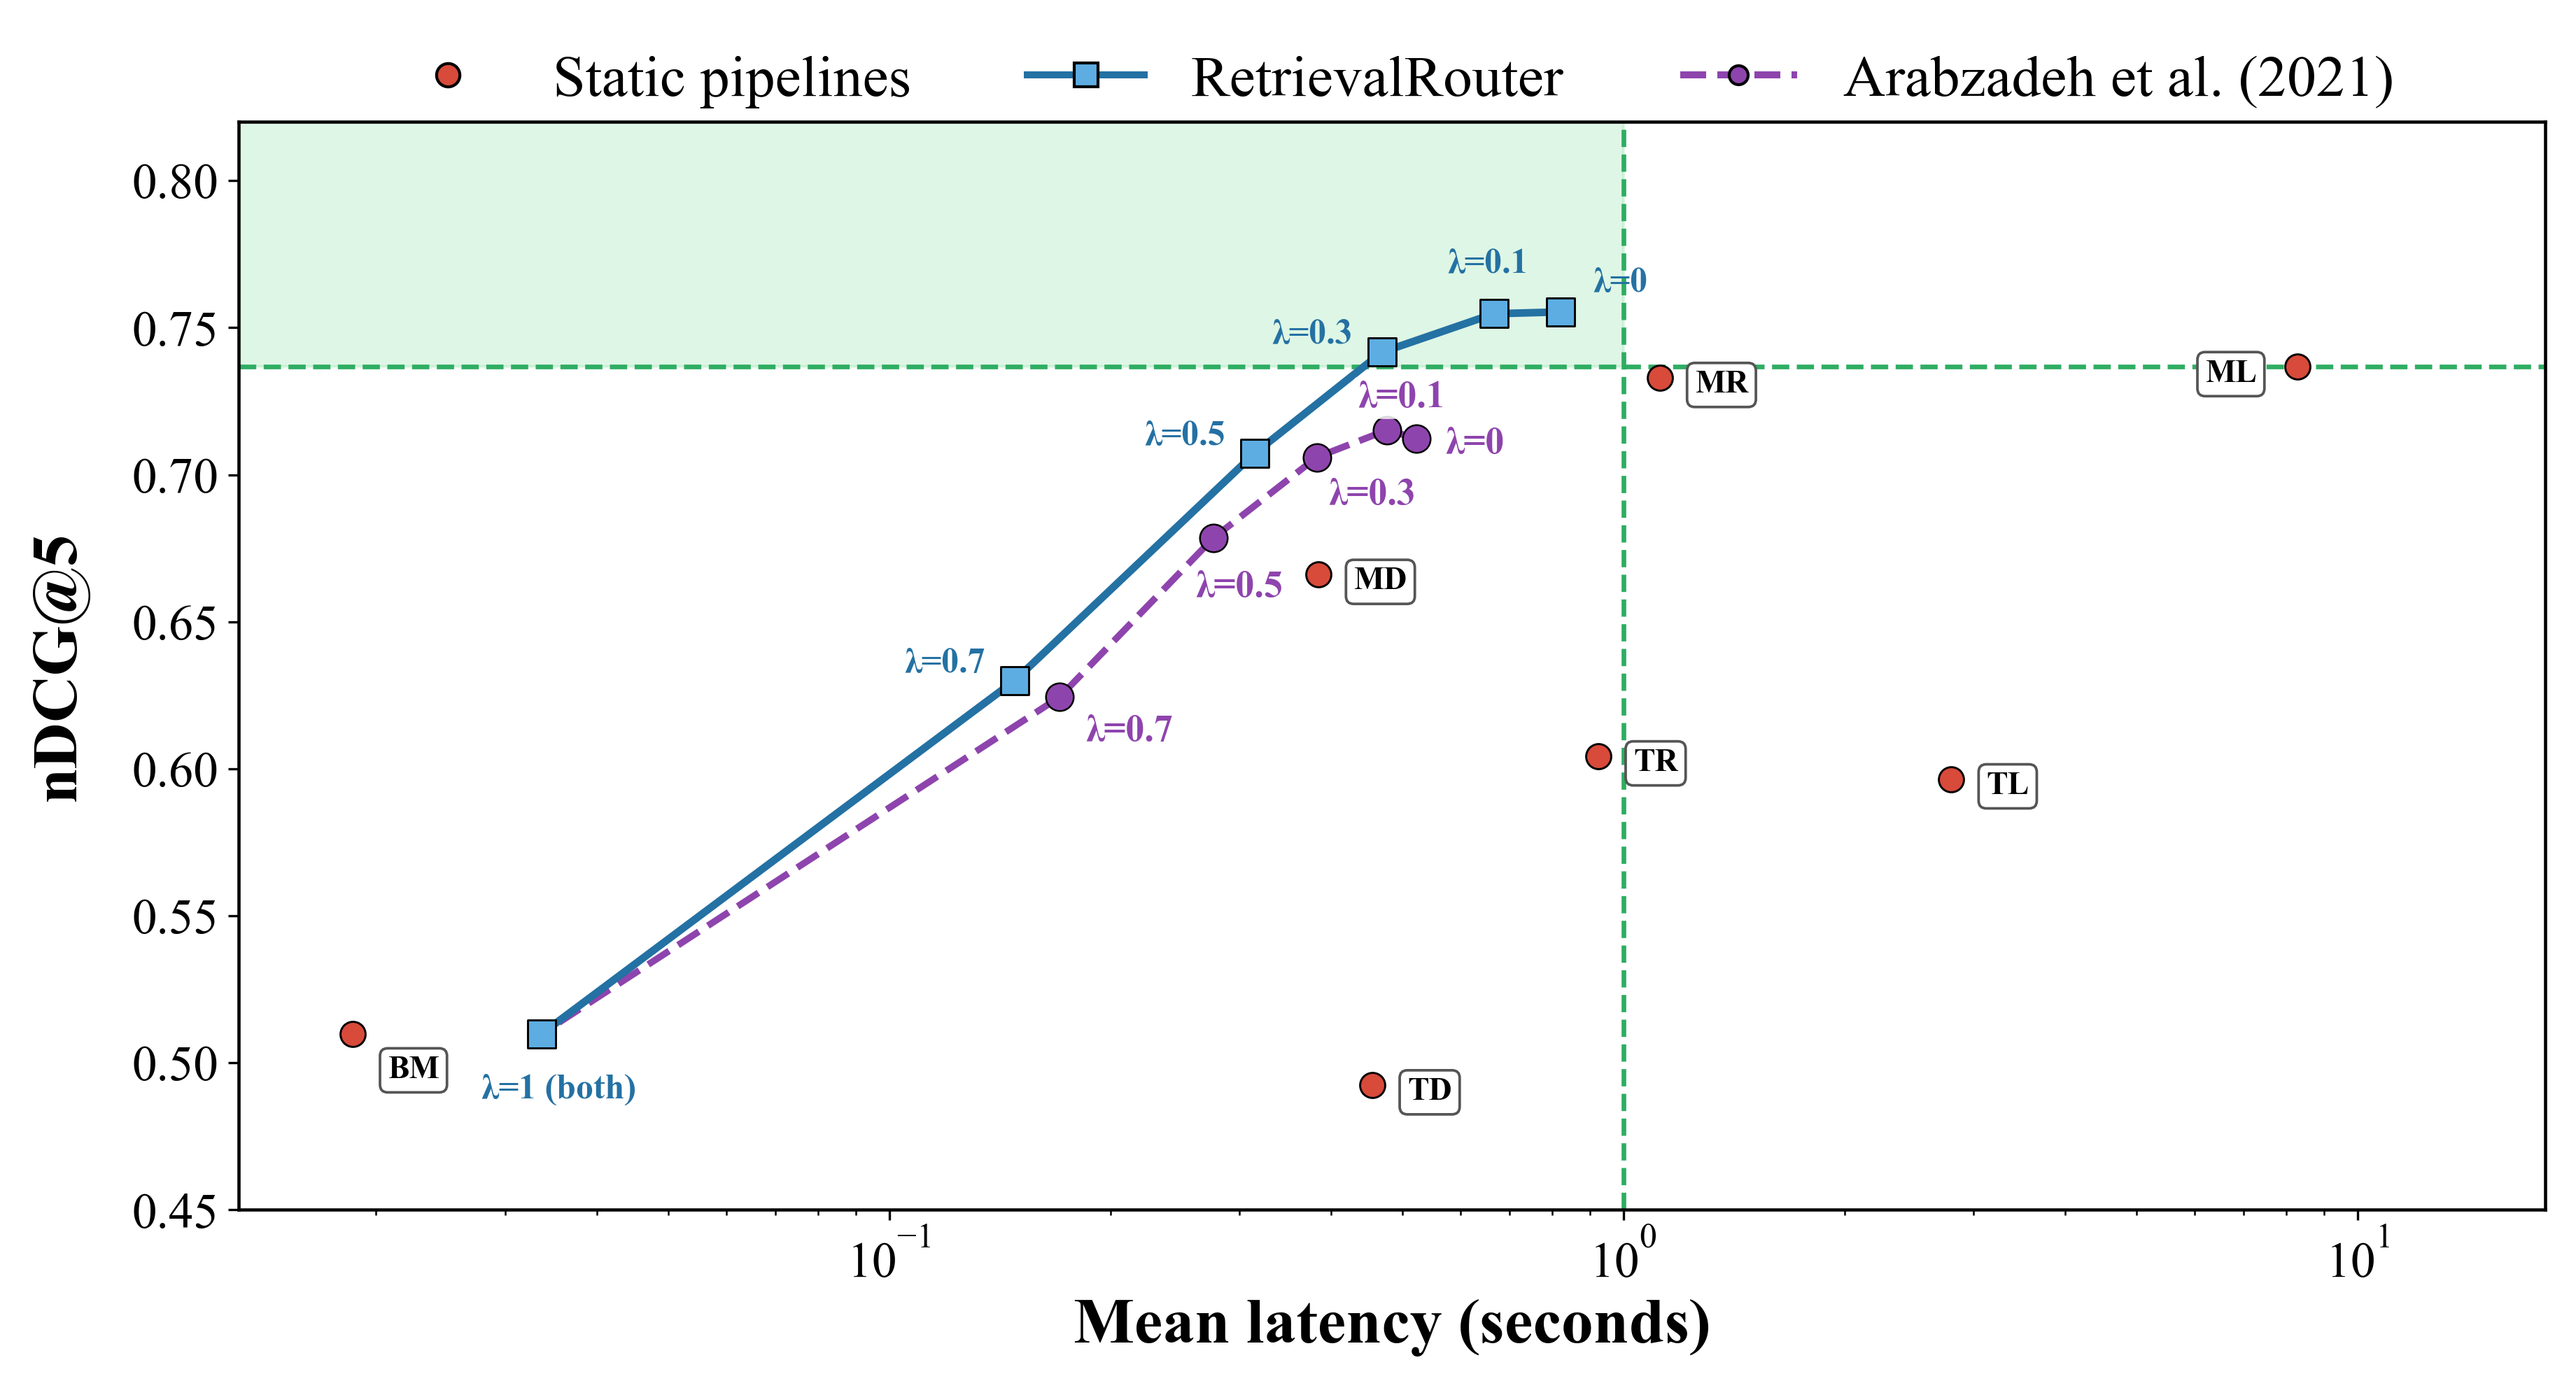 Figure 2(Section 6):比較固定管線、RetrievalRouter 不同 λ 點、既有 adaptive baseline 與 Oracle 的 nDCG@5 和平均延遲;重點是 router 提供多個前緣選擇,而 oracle 不能當成可部署結果。來源:論文 Figure 2 · 原圖。論文依 CC BY 4.0 授權,保留作者歸屬與來源,本文直接重用,未修改。

閱讀 2.5% improvement 的表述時,也要看它的參照點:作者比較 λ=0.1 的 router 0.755 與靜態最準 ML 0.737,報告相對高 2.5%;延遲 0.666 秒對 8.283 秒,約快 12.4 倍。這不是對最便宜 BM25 的比較,也不是「完整成本下降 12.4 倍」。Router 在不同操作點改變準確率與延遲,但平均 query latency 仍漏掉索引建置、索引更新、預熱、磁碟、資料同步與專用服務常駐等資源費用。
前緣內部的路由分布能檢查模型究竟學了什麼。Figure 3 顯示 λ 從品質優先走向速度優先時,各 pipeline 分配如何變化。改寫的 Arabzadeh baseline 用 hard label:「最低延遲中能把 relevant page 排第一的管線」作為答案;所以在偏品質端,它仍偏向便宜且已成功的 MD,無法表示更貴管線可能帶來額外排序提升。RetrievalRouter 的 soft target 則可同時把品質和延遲差距編碼進監督。作者還指出在 Wiki-SS 的 λ=0 點,router 將 20% 查詢送到 BM25,因為 BM25 對部分問題優於多個 neural pipelines;既有 baseline 在同一點不會選 BM25。這是資料集內的例子,不是證明 query-only policy 能找到任何領域的詞面最佳解。
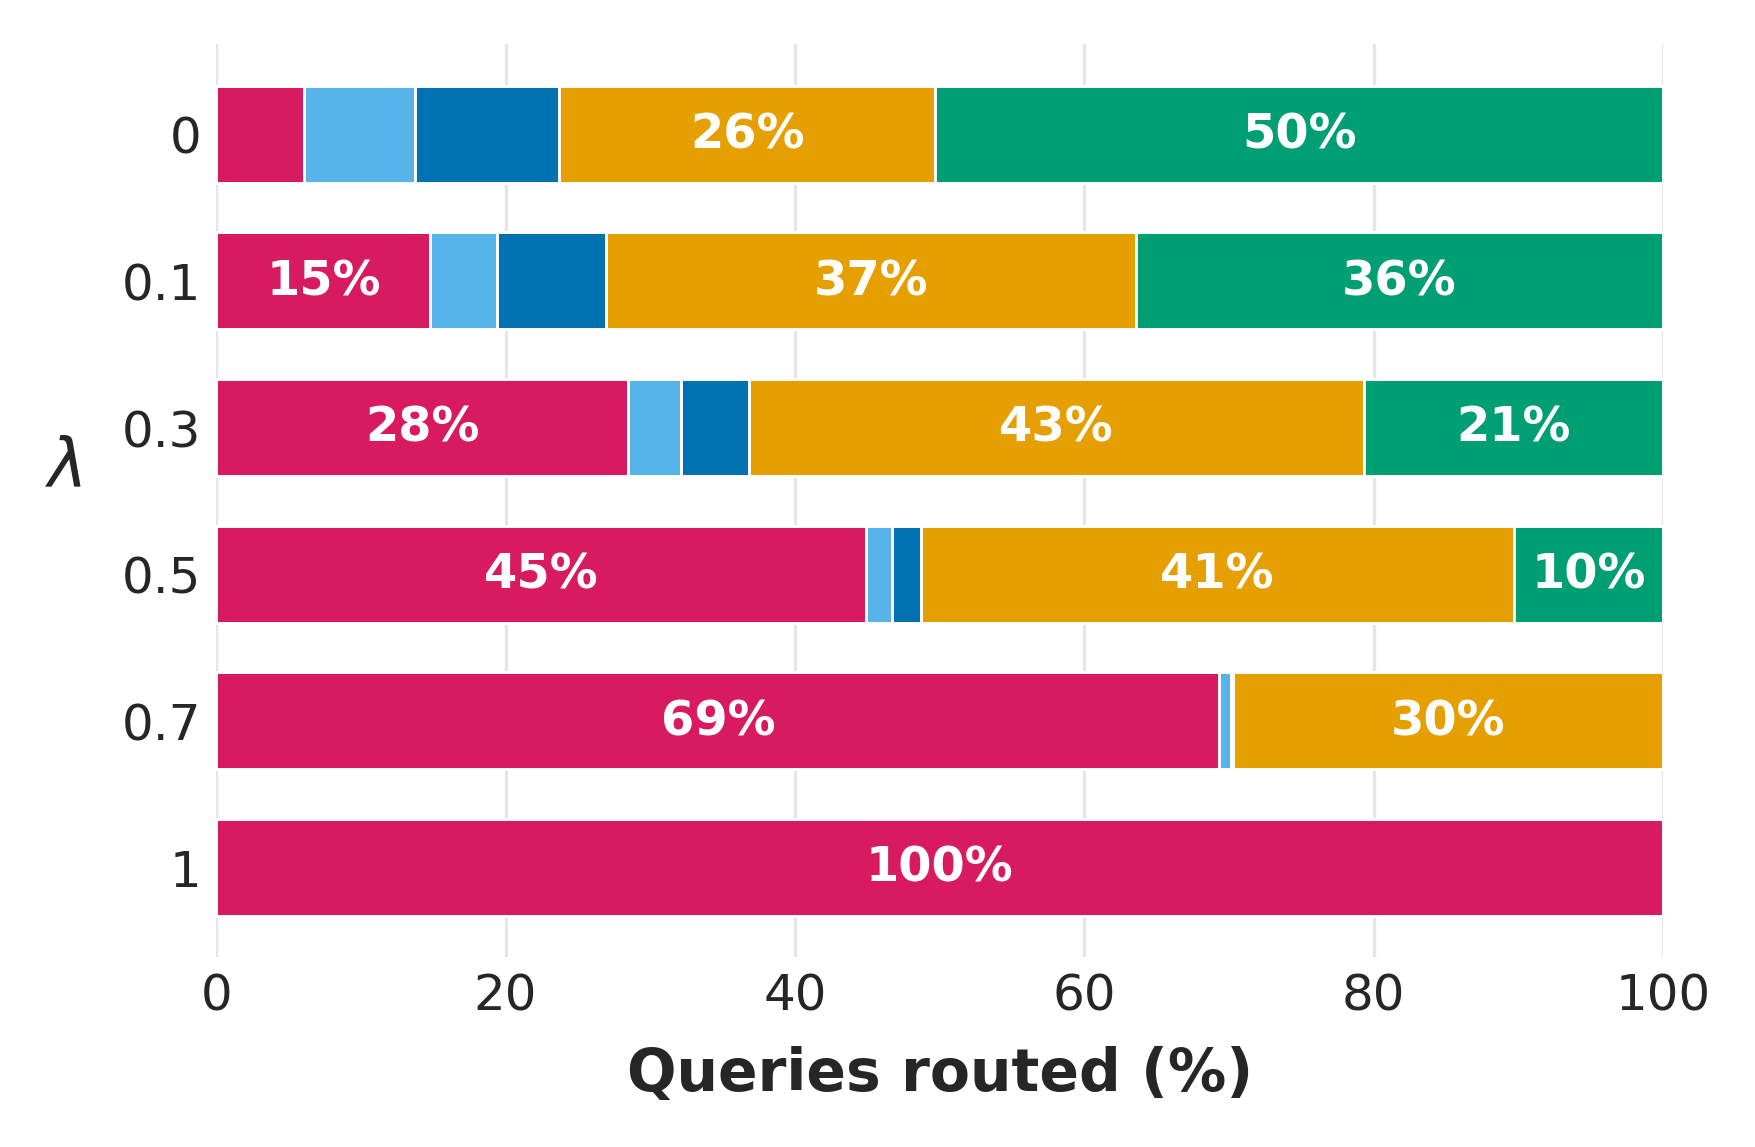
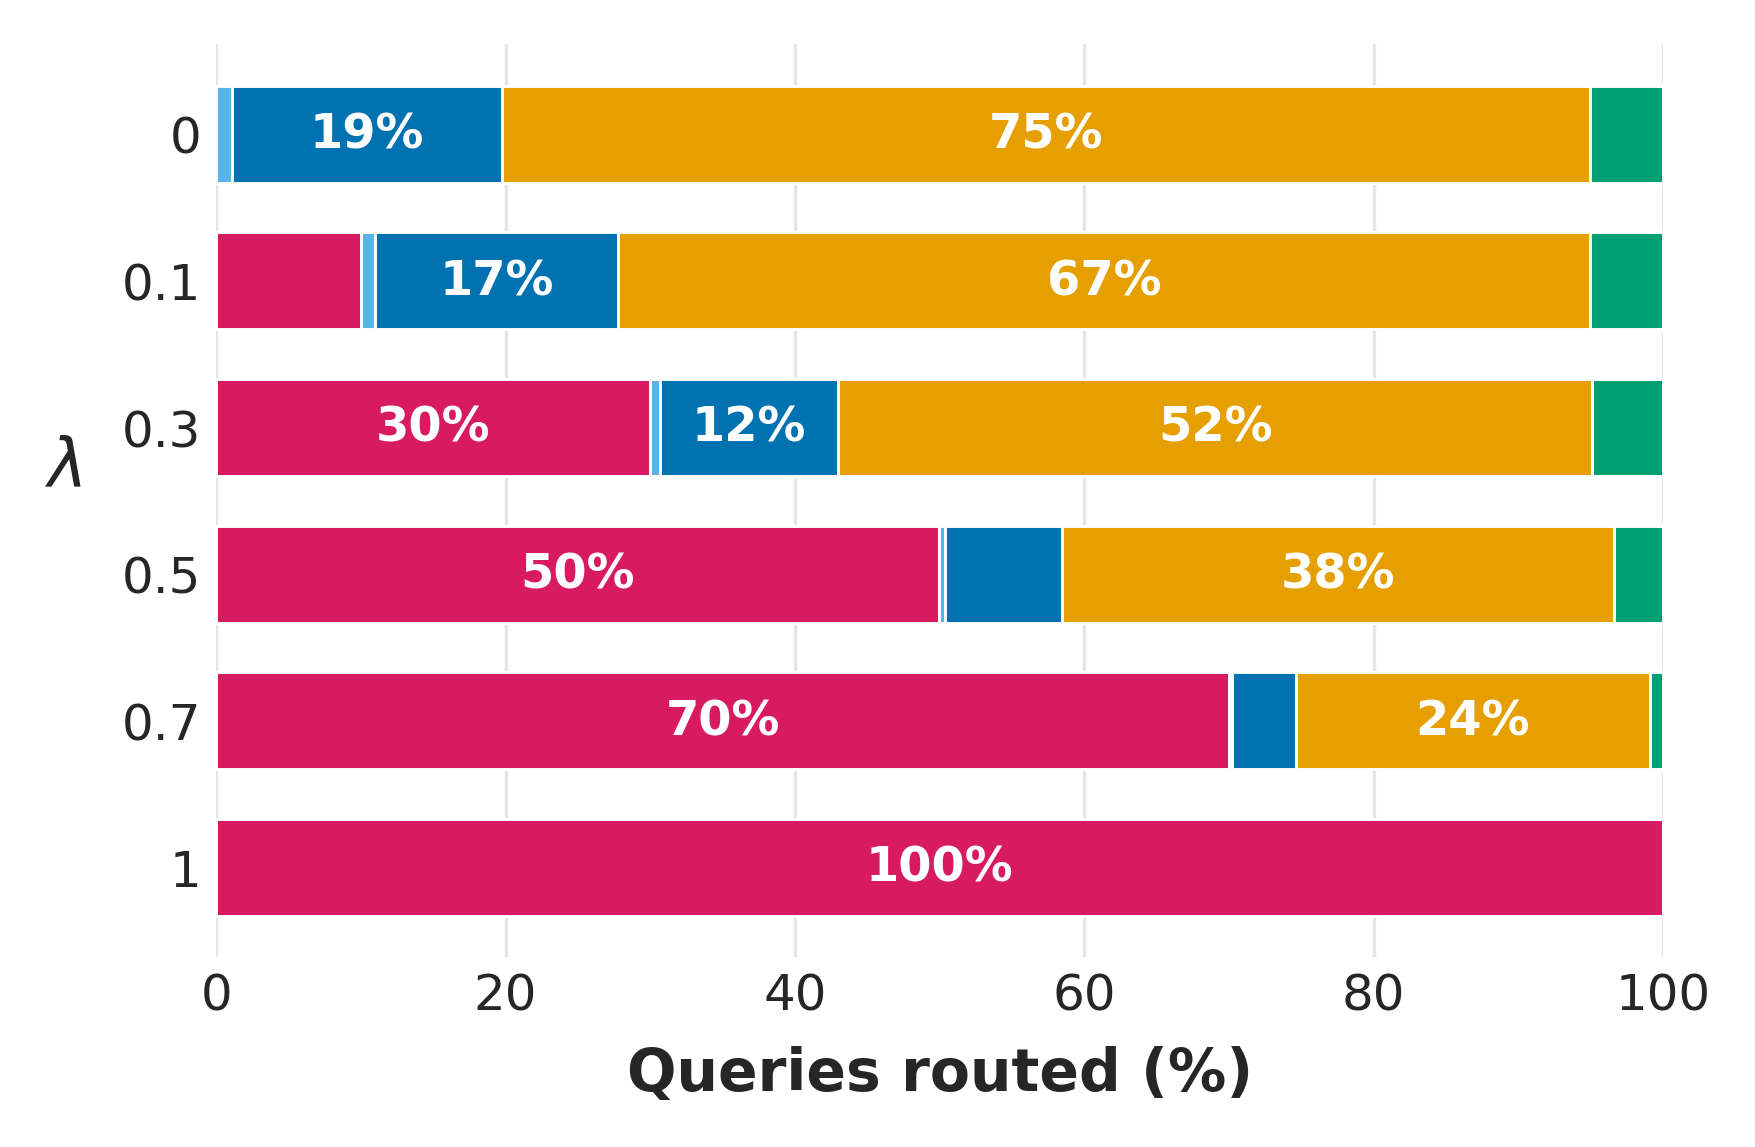 Figure 3(Section 6.1):上圖為 RetrievalRouter、下圖為改寫的策略選擇 baseline,在不同 λ 下將查詢分配給各路由臂的比例;它補充 Figure 2,說明前緣如何由動作分配改變形成,不直接展示線上負載。來源:論文 Figure 3。論文依 CC BY 4.0 授權,本文直接重用兩個原始 raster panel,保留作者歸屬與來源,未修改。
Figure 4 進一步比較 router 與 oracle 的決策品質。作者以每個選中路徑為列,檢視所選與未選 pipeline 對相同查詢的 reward。兩者都有對角優勢,表示被選中的 pipeline 在該批 query 上接近較佳 reward;這比只看整體 nDCG 更能支持「路由決策有分辨性」。但這張 heatmap 按選中路徑分組後呈現平均 reward,不能讀成每一題都選對。Oracle 選 TL 213 次、ML 39 次,而 TR 882 次、MR 1,068 次;在這組資料與 λ 下,rerank 版本吸收了大部分需要細粒度交互的查詢,純 late-interaction 仍有少數不可由 rerank 取代的情況。
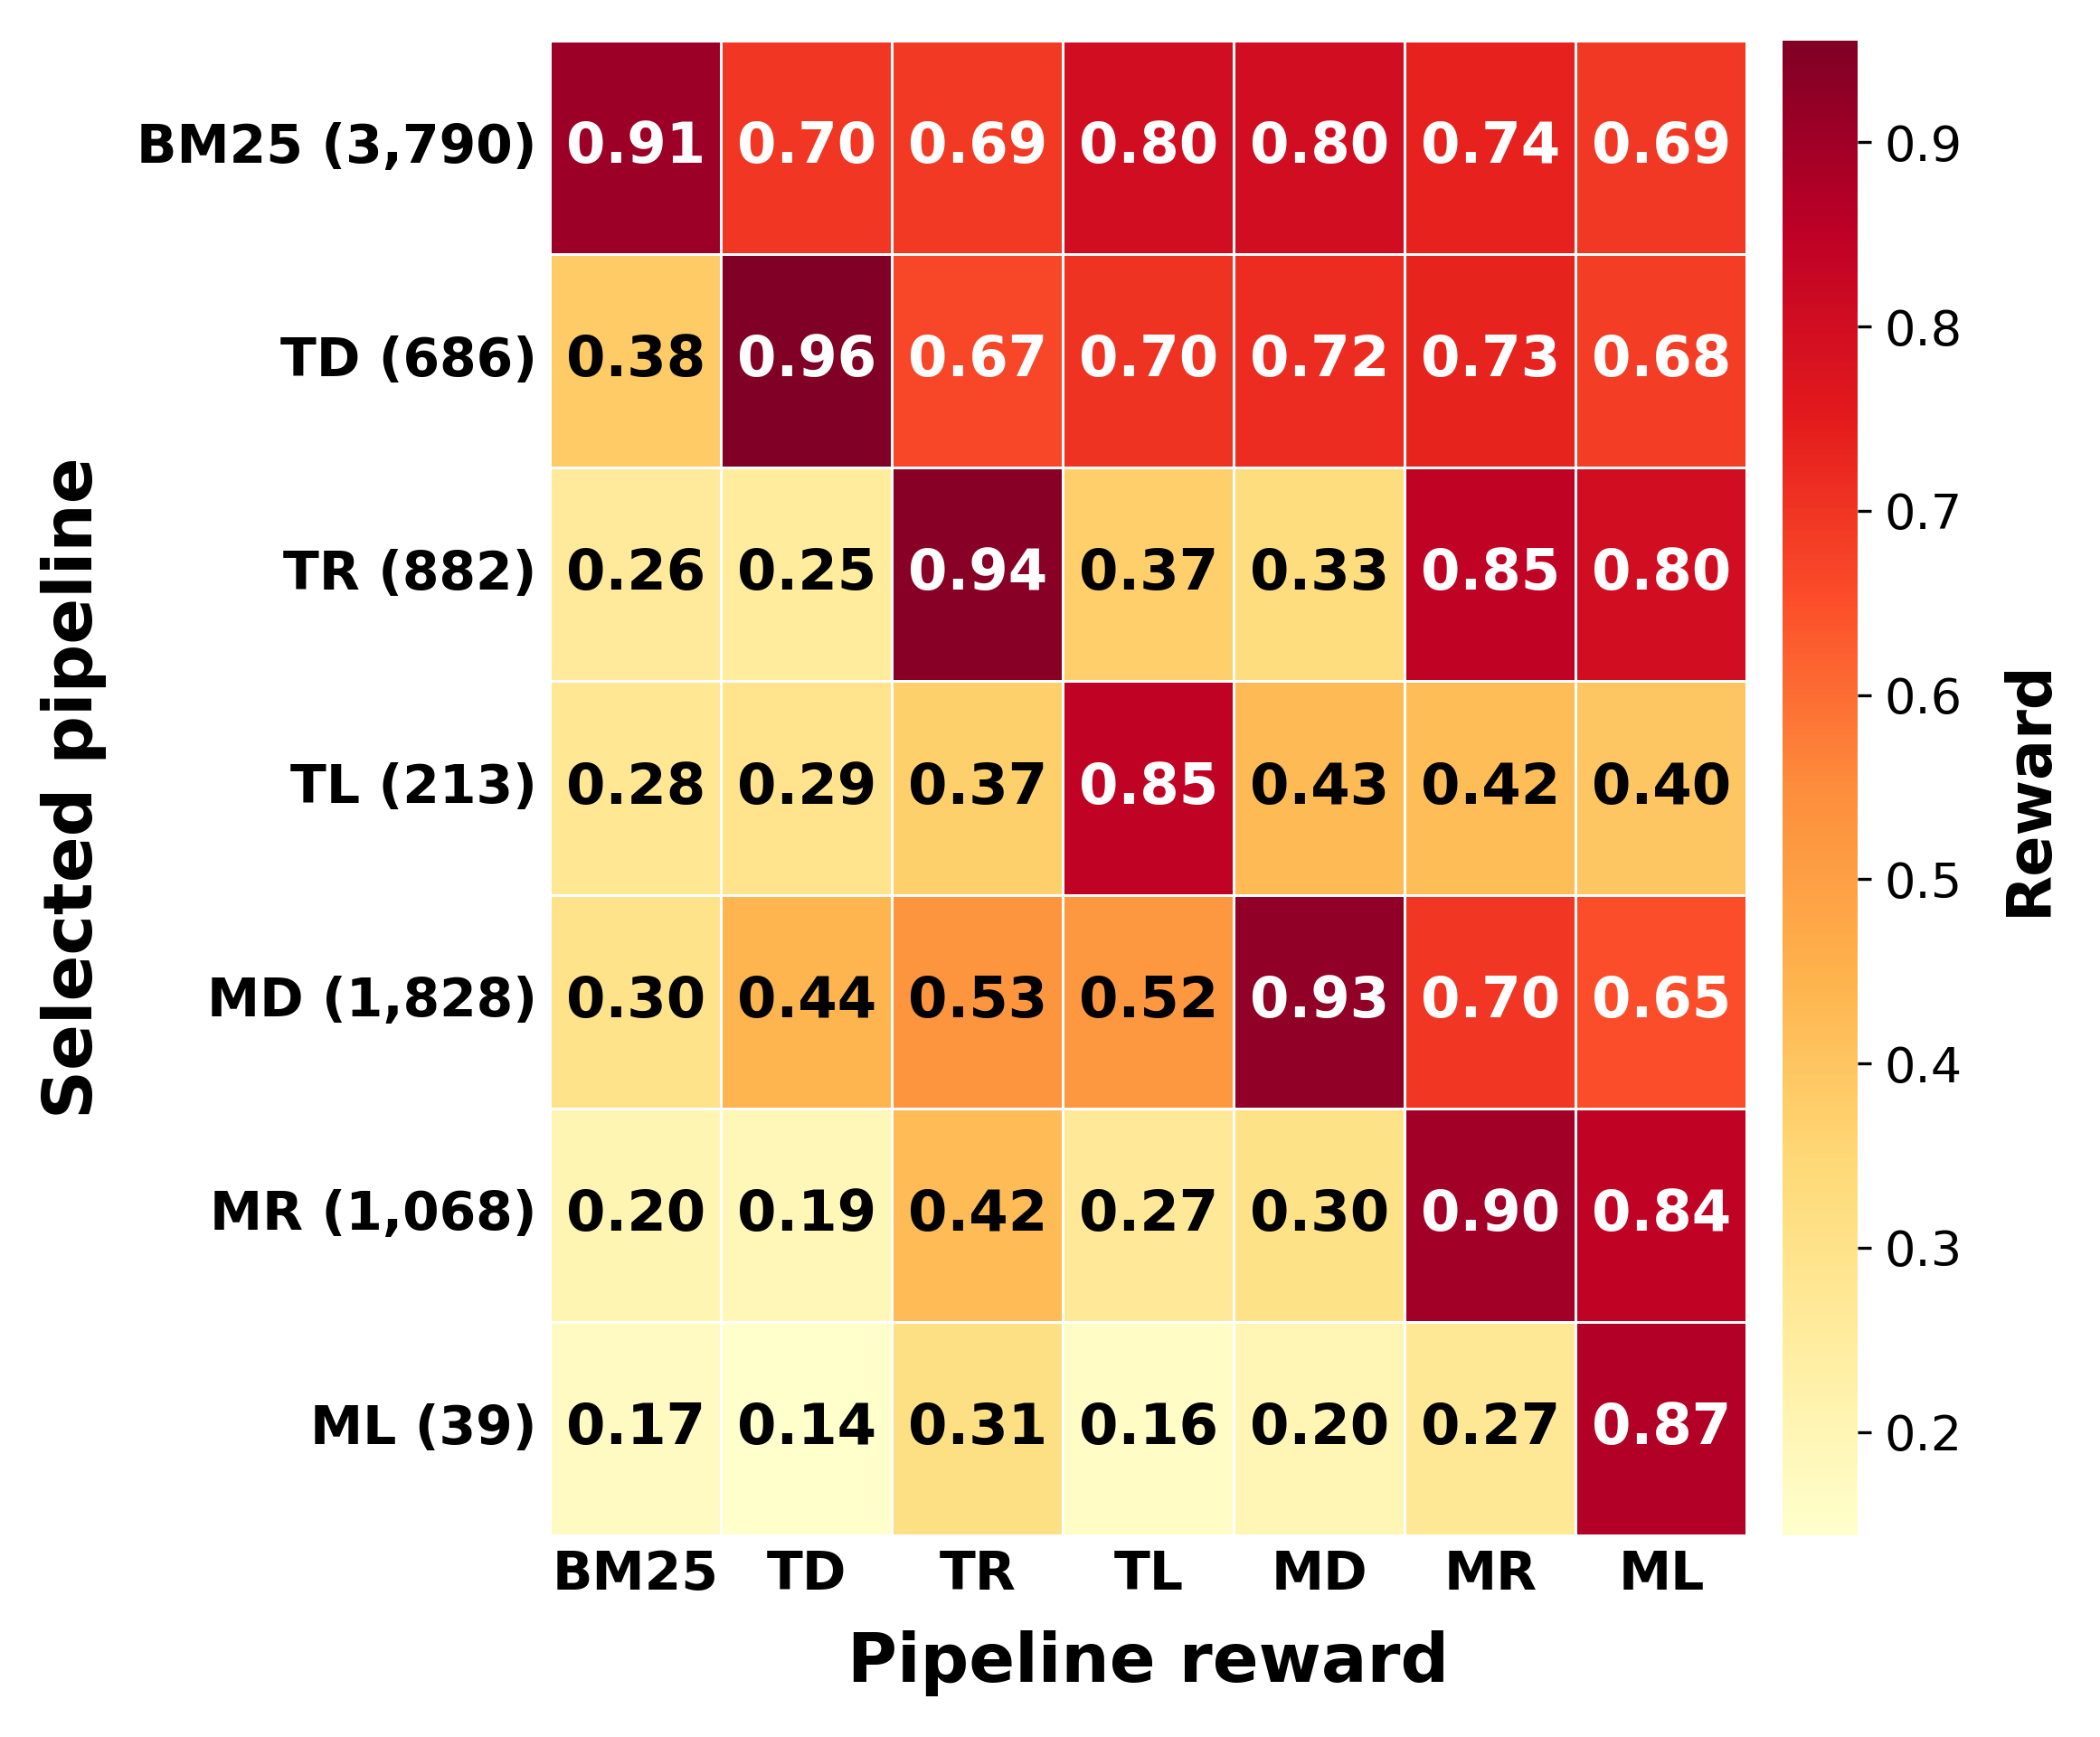
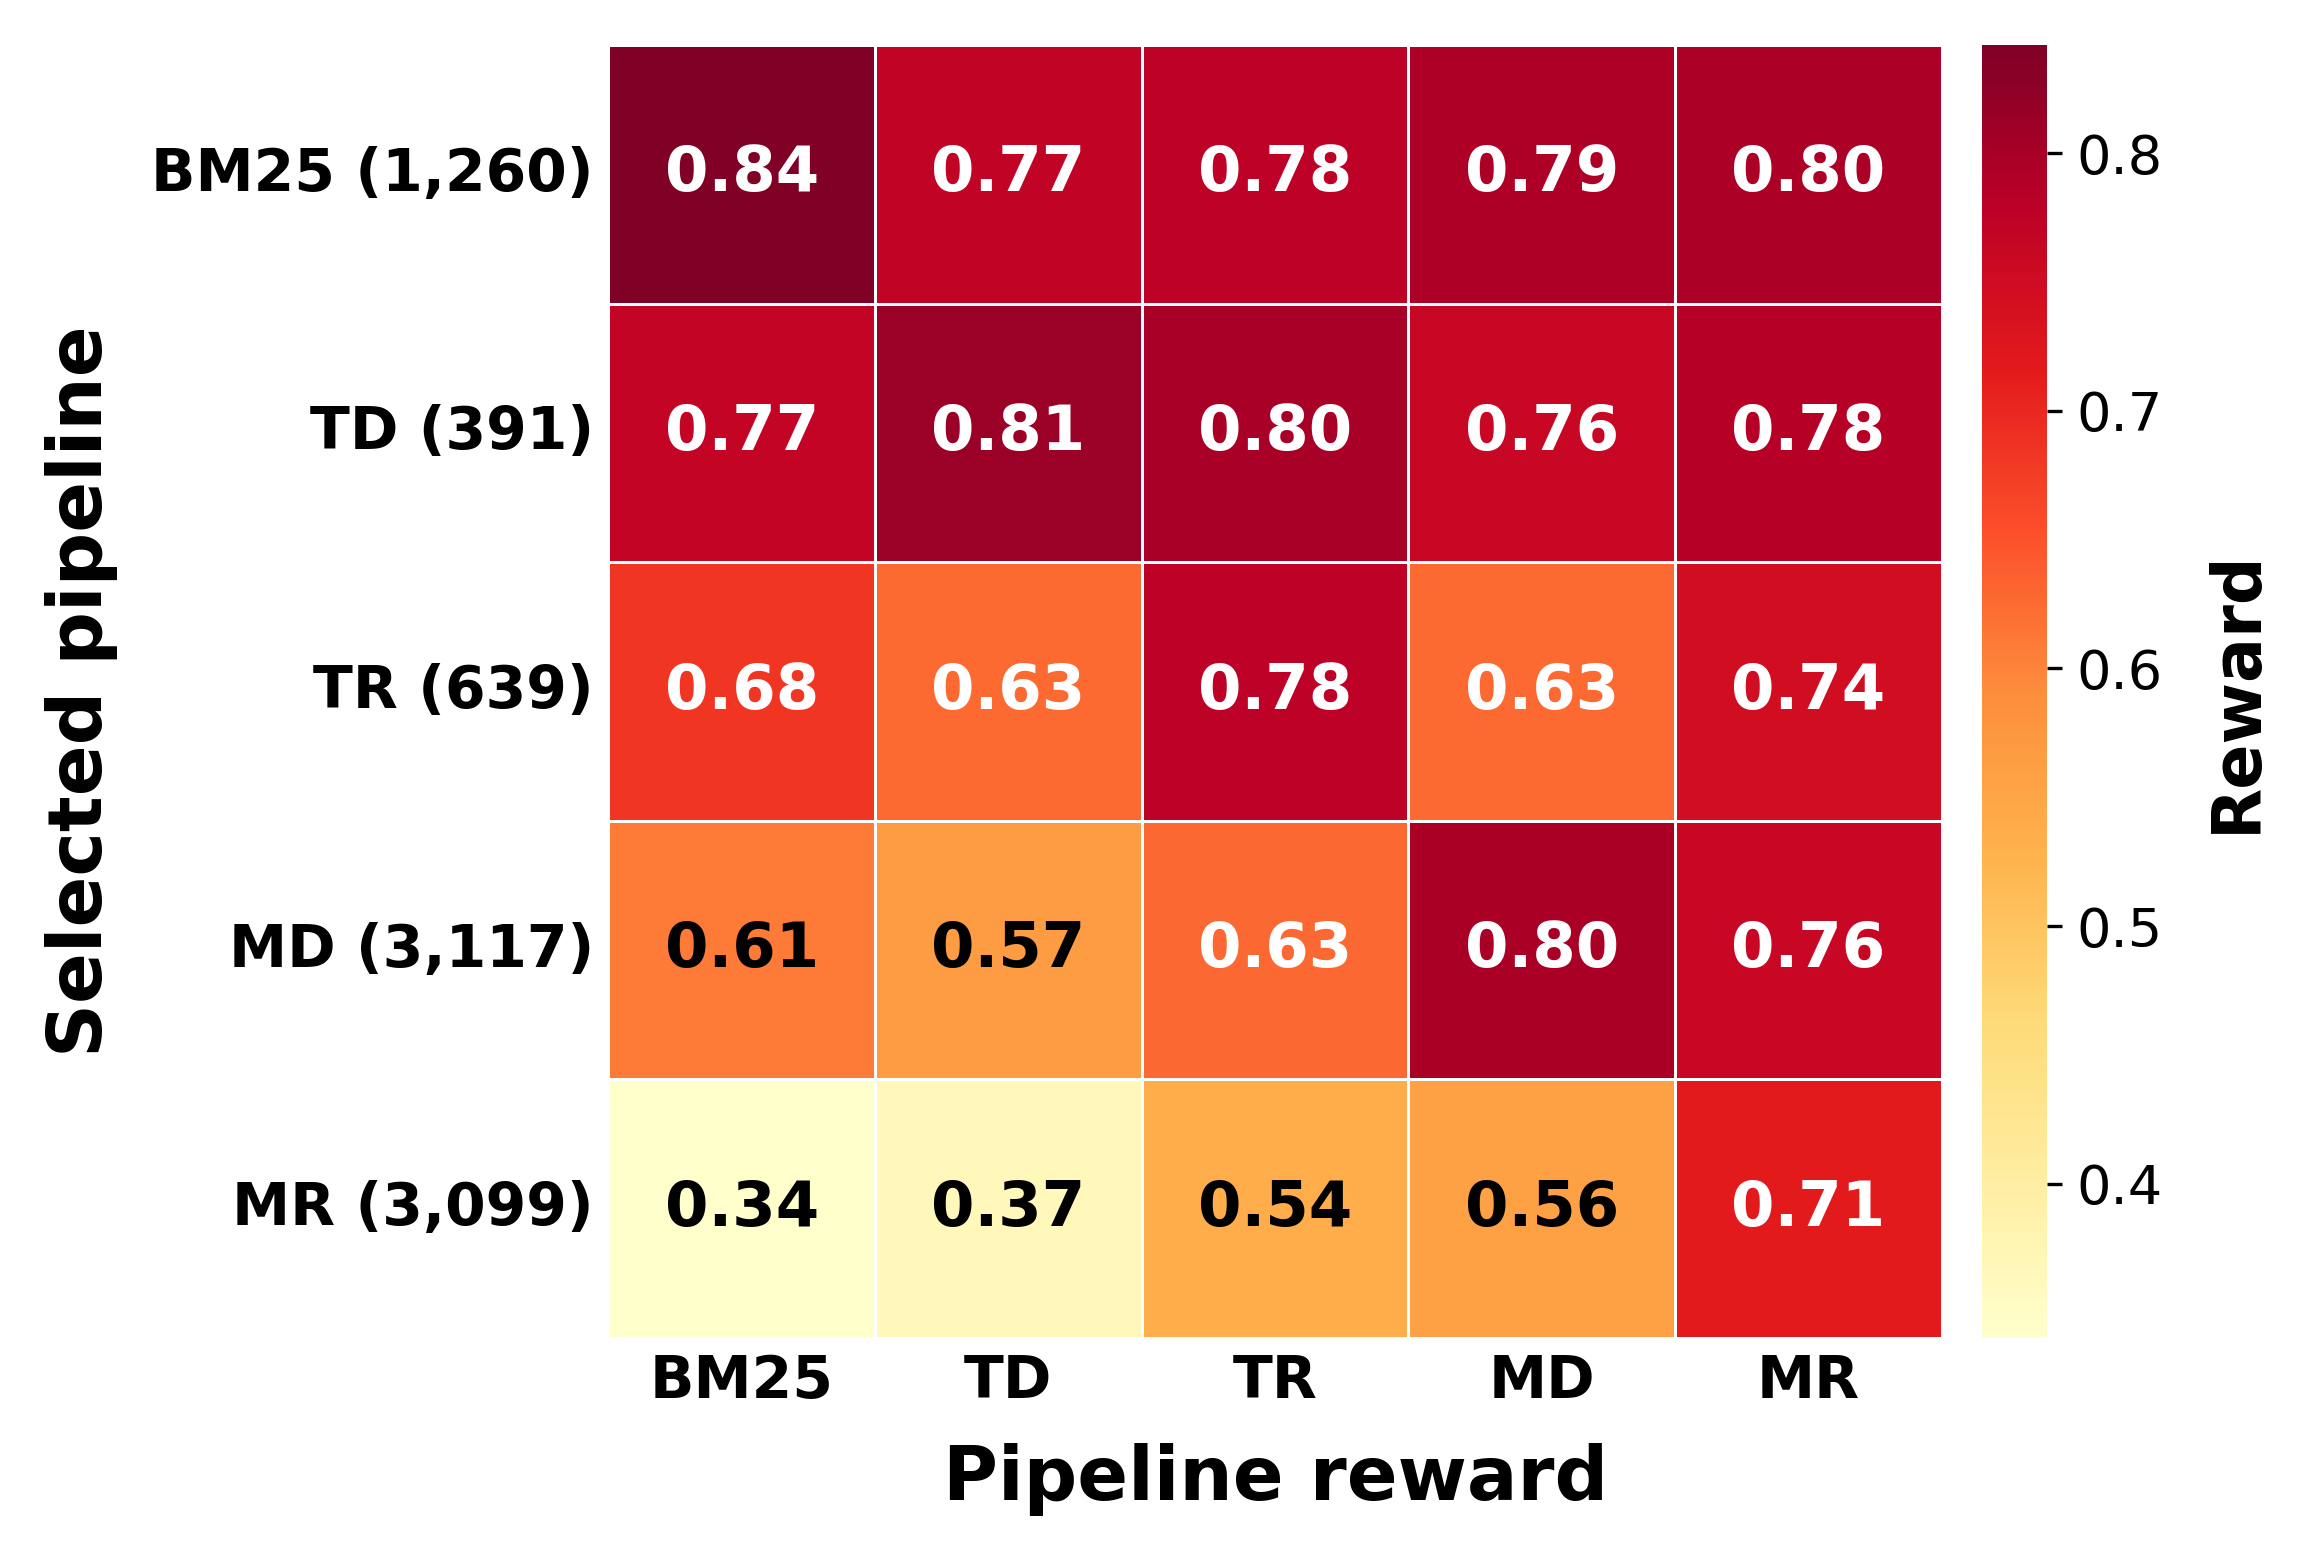 Figure 4(Section 6.2):上圖為 Oracle、下圖為 router;列依被選取的路徑分組,欄顯示同一批查詢下各路徑的 reward。對角集中表示按組平均接近高 reward,不表示逐題決策完全正確。來源:論文 Figure 4。論文依 CC BY 4.0 授權,直接重用兩個原始 panel 並保留作者與來源歸屬。
失敗型態與邊界證據:模態對不上時,平均分會掩蓋什麼
作者把頁面非文字元素所佔比例定義為 visual density,使用 DocLayout-YOLO 估計文字以外區域,再按密度區間觀察管線。Figure 5 顯示 BM25 的 nDCG@5 從最低視覺密度組的 0.593 降到最高組的 0.292;TD、TL 也隨著密度提高而下降,多模態管線相對穩定。這符合文字抽取會線性化版面、丟失表格和圖表空間關係的機制。然而,密度分組不是隨機控制實驗:不同資料集與題目也可能同時不同,所以它支持關聯性與錯誤診斷,不等於單獨證明「增加圖片元素造成某個精確下降」。
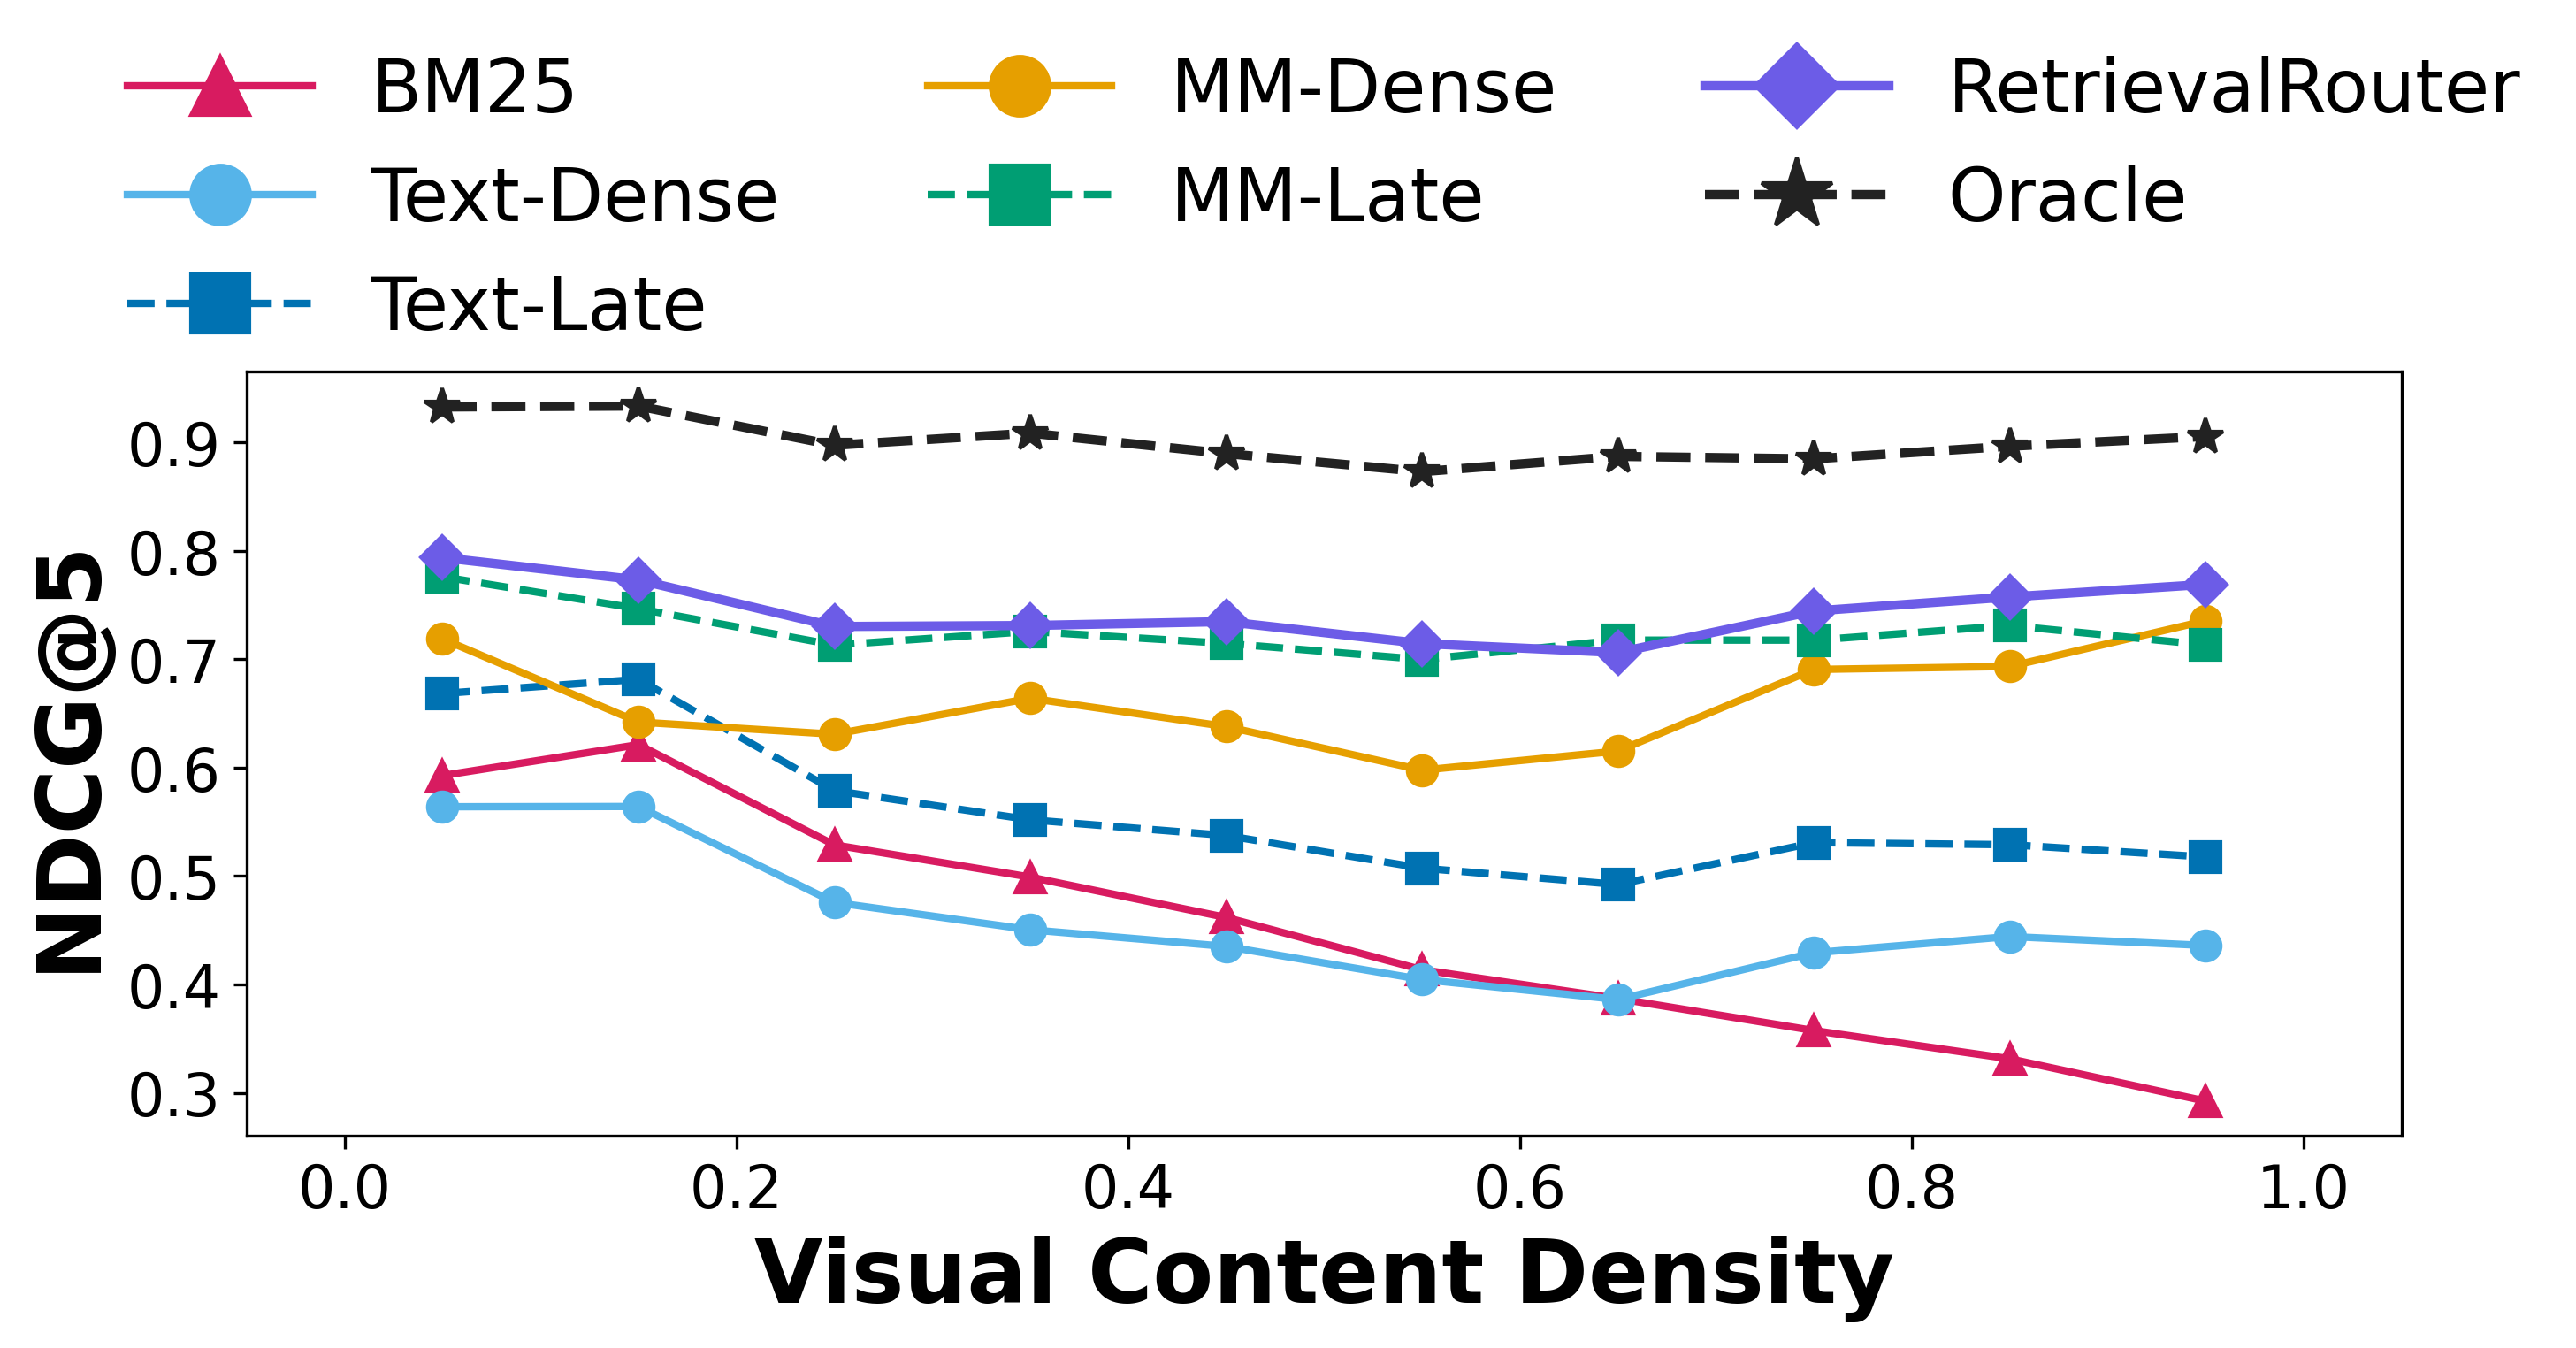 Figure 5(Section 6.3):依頁面視覺密度分組比較 nDCG@5,展示文字路徑對視覺複雜度較敏感、多模態路徑相對穩定。分組結果不是隨機化因果估計。來源:論文 Figure 5。CC BY 4.0;本文直接重用原圖,保留來源與作者歸屬。
另一個重要的反直覺結果是「較複雜的路徑不總是較好」。在 Oracle 選中 MD 的 1,828 個查詢上,MD 平均 reward 為 0.93;若同一批查詢改用多模態 rerank MR,reward 反而降到 0.70。換句話說, reranker 並非沒有價值,而是對某些 query 只增加成本甚至令排序變差。相反地,整體平均 nDCG 不高的 MD 仍可在適合自己的子群當最佳路徑。這也是固定比較和 query-level 比較會導向不同工程決策的理由。
作者以每 query 的 nDCG、MRR 和 Recall 作 effectiveness,搭配平均與 P95 latency,讓讀者不只看 headline nDCG。儘管如此,論文沒有提供線上 A/B、服務併發、佇列等待、尾端延遲 under load、快取命中率或 index refresh 的評估。P95 是此實驗執行條件下每查詢延遲分布,不等於高併發服務的 SLO。模型的 router overhead 是 15 ms;當全走 BM25 時,總延遲從 0.019 秒變 0.034 秒,顯示最便宜路徑上的決策稅反而相對顯著。
限制與效度威脅:離線前緣尚未等於線上成本
資料與訓練變異:資料只涵蓋英文金融、科學和開放領域語料;作者提醒部署到其他分布時要用代表性 query 驗證(Bias and Generalization)。各 lambda checkpoint 都以 seed 42 訓練單次,沒有跨初始化的變異估計(Appendix A)。Table 2 的 paired significance 檢定比較的是同一批 held-out query 上各系統輸出,無法補上訓練隨機性或新語料的外部效度。
硬體和完整成本:結果來自一張 H100 80GB。雖然作者測了 query latency 並在 Appendix A 討論 router overhead,實際系統需保留四個 neural vector index 和獨立 BM25 index。作者在 Limitations、Table 3 報告,合併語料的 multimodal-late index 約 39 GB,text-dense 約 3 GB,前者超過 13 倍;這還未把資料更新、索引建置時間、索引一致性、不同硬體的吞吐與 serving capacity 納入一個完整 TCO 模型。
線上泛化與決策邊界:作者沒有在線上負載下量測併發、排隊、cache、索引更新或 query drift。更重要的是,不同 corpus 上的 query wording、文件版面和最相關頁面分布可能改變 route reward;text-only router 看不到實際文件,也不會發現一次檢索結果缺證。論文末段建議超出英文訓練分布時做 in-domain evaluation,這應視為採用的前置工作,而非可選的後續調校。
在語言型子集上,多模態也有明確短板:Wiki-SS 的 text late-interaction TL 達 0.784 nDCG@5,高於 ML 的 0.743 和 MR 的 0.732;BM25 也達 0.745(Table 5)。router 在此資料集 λ=0 時將 94% 查詢送往文字路徑,其中 20% 送 BM25(Appendix B)。這提醒路由政策不能把「文件是多模態」直接當成「查詢需要視覺檢索」。
證據地圖:作者聲稱、實驗支持與尚未回答
論文主張:單一 query-only router 能在五種異質路徑間選擇,提供優於固定 neural pipeline 的準確率—延遲 operating point,並改善既有策略選擇 baseline 的品質導向表現。
實驗直接支持:作者在 11 個 benchmark dataset 的 85,103 個 query 上建立 per-query 多路徑結果,以 8,506 個 unique test queries 做最後預測比較;Table 1、Table 2、Figures 2–5 呈現固定管線、路由前緣、路徑分配、每組 reward 和視覺密度敏感性。每個 λ 只使用 seed 42 訓練一次,作者沒有報告跨 seed 變異(Appendix A);成對統計檢定支持特定比較的顯著性,但不能消除單次訓練、benchmark 選擇、硬體條件或外部效度問題。
Bloss0m 的解讀:這篇工作最實用的貢獻不是「多模態檢索一定更快」,而是把每個 query 適合哪個成本—能力組合,明確建成可監測的系統政策。若產品有 query 類型與文件模態都固定、且單一路徑已有足夠品質,路由器可能是多出的依賴;若不同 query 的錯誤模式明顯不同,才值得用自己的資料重建前緣並做流量實驗。
| 可以採用的結論 | 不能直接延伸的結論 |
|---|---|
| 在作者的 H100 benchmark 和候選管線上,router 可提供多個有用前緣點 | 任何語料、硬體或向量資料庫上都能同時提升準確率並降低總成本 |
| 各路徑的 per-query reward 不同,query-conditioned selection 有資料支持 | 查詢文字足以代表所有模態、文件版本、使用者意圖與即時負載 |
| 文字與多模態路徑在視覺密度子組呈現不同敏感性 | 所有圖表任務都應走多模態;或密度分組已證明因果關係 |
| 該 repo 的預測檔能重算論文 aggregate metrics | 公開檔案已在新環境端到端重現索引建置和 latency 結果 |
Artifact 與可重現性
截至 2026 年 10 月 20 日,作者的 MIT licensed GitHub repository 公開訓練程式、檢索與評估程式、checkpoint 入口、資料說明和預測檔案;README 列出 11 個資料集共 85,103 個查詢,並提供 8,506 個 unique test queries 的 router 和 baseline prediction spreadsheets。README 的 quick start 可由已發布預測檔重算 aggregate nDCG@5 和平均延遲,範例結果為 0.754739 和 0.665978 秒。prediction spreadsheets 可在不執行整套檢索服務的情況下重算 aggregate 指標,但只有在重建各路徑 index 與服務環境後,才能重新量測端到端檢索延遲;本文的性能數字仍是作者報告結果。作者的 Hugging Face collection 目前列出六個 RetrievalRouter lambda checkpoint、一個 baseline checkpoint,以及 11 個資料集的 viewer。Repository 採 MIT 授權,但依賴模型、資料集各自的使用條款仍需分別遵守。
若要重算表格,作者提供 evaluation script 和預測檔,這比只有論文圖表更便於檢視 paired query-level 結果。要端到端重建檢索延遲,還需建立文字與多模態 index,準備獨立環境及相應的模型、資料庫和硬體;README 的軟體步驟不意味任意 GPU 上的結果必須相同。作為工程驗證,可先在自有語料抽取具代表性的查詢,對每個候選路徑量測同一套相關性指標及實際服務成本,再留一個時間或客戶切分做分布轉移檢查。
Bloss0m 工程判斷:採用前,先把完整成本放進前緣
Bloss0m 工程判斷:若一個產品同時服務詞面 lookup、語意改寫、視覺文件理解和跨段落搜尋,且它們在本地資料上有可重複的 per-query 成效差異,query-level policy 值得做成一個實驗分支。建議在固定語料和 serving topology 下,記錄路由選擇、每路結果品質、平均與 P95 延遲、索引記憶體/儲存、建置時間與更新延遲;政策未經資料與負載驗證前,不把它放在唯一生產路徑。必要時採可回退設計:先記錄建議路徑,再與固定基準 shadow compare,最後才逐步切流。
不適合直接採用的情境包括:所有查詢本來都由同一條便宜路徑充分解決;各 retrieval arm 會造成重複或不同新鮮度的 index,卻沒有清楚的同步規則;對高風險檢索任務無法容忍路由漏選;或者查詢分布常變,但沒有持續標註和漂移監測。將文件從文字抽取切換到視覺模型,也會改變錯誤來源和隱私處理邊界,不能只以一次 nDCG 上升決定採用。
決策時要分開三個量:第一是檢索品質改善,依產品的相關性或證據完整性需求定義;第二是線上延遲與資源占用,需在部署硬體及負載下量;第三是完整生命周期成本,包括多份 index 的建立、儲存、增量更新、模型服務與觀測。本文主要證明第一項與第二項的一組離線 operating points,第三項仍由部署者自行量測。作者的 15 ms router overhead 是決策頭本身的估計,不包括訓練/標註及所有 pipeline 的資料生命周期。
讀完後的三個記憶點
- 技術想法:RetrievalRouter 以 query-only policy 從 BM25、文字 dense、文字 rerank、多模態 dense、多模態 rerank 五條路徑中選一條;訓練用 soft reward targets,避免強迫相近方案只留一個硬標籤。
- 證據:在 11 個資料集、85,103 個查詢、單張 H100 的作者實驗中,λ=0.1 報告 nDCG@5 0.755、平均延遲 0.666 秒;比較對象和指標條件不可省略。
- 邊界:離線前緣不是總擁有成本,也不保證換語料、語言、硬體、負載或 index 更新方式後仍有效;上線前需用自有資料重新量測。
Primary sources
- Kuru, Emre, Mehmet Onur Keskin, Reza Farahbakhsh, and Noel Crespi. “RetrievalRouter: Joint Modality and Architecture Selection for Document Retrieval.” arXiv:2608.25625v1, submitted August 26, 2026. See Sections 3–6, Tables 1–2, Figures 1–6, Appendix A–B. The paper is licensed under CC BY 4.0.
- Official RetrievalRouter repository, MIT license; code, datasets, checkpoints, training data and prediction spreadsheets.
- REAL-MM-RAG, T2-RAGBench, and MMDocRAG benchmark sources as cited by the paper.