論文精讀
TRACE 精讀:數位典藏中的可追溯來源探索
原文:TRACE: Accountable Agentic Retrieval for Source Discovery in Digital Archives
90 秒掌握論文
- 問題:歷史檔案的 OCR 文字可能錯字很多,報紙、議會紀錄等子語料的格式與詞彙也不同。一個問題還可能需要跨文件、跨語料找證據。只報生成答案的正確率,讀者仍不知道系統是否找到相關來源、遺漏了哪份文件,以及哪些檢索判斷值得人工覆核。
- 核心洞見:把目標定成「來源探索」而不是只產生答案。TRACE 將問題拆到特定子語料,混合 BM25、語意與日期搜尋,以 accept、reject、hold 記錄 chunk 判斷,讓暫時不確定的材料等後續證據補足,再依多個子問題的共同確認排序。
- 最強證據:在 1,752 題 HistoriQA-ThirdRepublic 上,TRACE 的 DeepSeek-V4-Flash 設定達到 R@10 0.856、MRR 0.653;Table 2 的比較涵蓋 BM25、dense retrieval、HippoRAG 2、LinearRAG、A-RAG 與 MA-RAG。Table 3 的累積式消融則顯示拆題與 warm start 是最大的整體增量來源。
- 主要邊界:這是單一年份、法語、三種 1887 年歷史文獻的檢索基準;測量的是文件召回與排序,不是答案事實正確、專家更信任系統或查核工時下降。可用程式和資料也尚未形成與論文 1,752 題相同的固定版本。
TRACE 的出發點是歷史研究中的檢索本身就是一項學術工作:研究者需要找到文件、查看它為何出現,並沿著搜尋線索回到來源。作者先把跨語料問題拆成不同搜尋方向,再在每個方向上進行檢索、判斷與必要時重新規劃,最後讓多條探索路徑的接受紀錄共同影響排名。它在特定 benchmark 上勝過幾種基線,支持「語料感知的檢索編排值得評估」;但分數本身不證明 TRACE 的來源說明一定改善歷史學者的信任或工作效率。
本文以 arXiv v1 為主。該版本標示 2026 年 9 月 17 日提交,並在註記中稱正式版本已獲 CIKM ’26 接受;這是論文版本中的出版狀態聲明。本文將實驗數字視為作者報告,並把它們和目前公開程式、資料版本以及作者描述的 DECIDON 內部使用情況分開閱讀。
為什麼歷史檔案需要來源探索
一般 RAG 經常把 retrieval 當作回答前的內部步驟:找幾段文字、交給生成器,最後以答案的 Exact Match、F1 或模型評分判斷品質。TRACE 關心的情境更窄。若一個問題同時涉及法國第三共和時期的議會發言與不同立場報紙,研究者可能真正想知道的是「哪些資料呈現了這段政治論述的流通」,而不只是一句濃縮答案。若 OCR 把專有名詞切錯,稀有詞的字面搜尋會漏掉;若問題需要先在議會找到一個人物,再到報紙追蹤其觀點,單一 top-k 檢索也可能只覆蓋其中一邊。
作者因此把問題設定成對異質典藏找出有次序的文件 ID。設整體語料為 ,其中每個 是一種子語料。對問題 ,參考文件集合 可能跨越多個子語料;只從問題文字未必能預先知道完整答案路徑。主要評估的是 Recall@k,因為任務核心在於是否把可用來源帶回給研究者,而非模型能不能寫出漂亮摘要(論文 §3.1、§4.2)。
這個設定也回應既有方法的兩個限制。許多 Agentic RAG 以答案生成分數評估系統,因而可能把模型本身記得的知識與檢索到的來源證據混在一起;圖式 RAG 則先抽取實體、建立關係圖,但 OCR 錯字會使實體抽取出錯,圖建構也可能把原始文件做成有損的中間表示。作者因此主張直接在含噪文本上做 retrieval-first 的來源探索,並把檢索品質獨立測量(§2.1)。這個設定也說明 TRACE 的「accountable」應如何理解。每份接受文件可以連回尋找它的子問題、哪個搜尋動作找到了它,以及 Agent 留下的簡短接受理由。這比只在生成答案尾端附上引用多了一層可觀察的檢索過程;但它仍不是完整的來源治理規格。論文沒有把每個生成答案主張映射到可引用的原始頁面,也沒有評估引用是否涵蓋文件語境或是否足以支持解釋。因此它主張的是「檢索路徑較可檢視」,不是「答案已完成來源查證」。
核心直覺:延後定案,讓後來的脈絡修正早期判斷
一般混合檢索可把 BM25 和向量搜尋的結果合併,常用 reciprocal-rank fusion(RRF)避免不同搜尋通道的分數尺度不一致。但它通常只產生初始候選名單,後續若把每段候選文字立即二分成相關或不相關,早期看到的局部片段就可能決定文件命運。歷史問題尤其容易遇到這種情況:單看一則報紙報導可能不明顯,等看到議會辯論或第二份報紙之後才知道其價值。
TRACE 在判斷階段保留三種狀態。accept 表示這個 chunk 對原始問題提供證據,系統記錄最多 120 字元的理由並接受父文件;reject 只排除該 chunk,不會一併封鎖同一長文件的其他 chunk;hold 表示目前脈絡不足,先把 chunk 放進有上限的暫存池,待累積更多材料後重新評估。Agent 每次先搜尋再覆核候選,兩種動作嚴格交替,讓剛找到的材料能影響下一個搜尋方向(論文 §3.4–§3.5)。
這套設計不是「所有不確定資料都永久保留」。hold pool 有界,Agent 有步數上限,結尾還有一次集中再評估。它用明確狀態管理短期不確定性,在查詢成本、候選噪音與太早丟棄證據之間取捨。評估中 hold-and-re-evaluation 的整體增量只有 0.5 個百分點,但其預期用途是救回少量需靠後續脈絡才看得懂的材料,不能只用整體平均來概括這種設計價值(論文 Table 3、§5.3)。
用一個例子走完整個方法:從跨語料問題到排序後的來源
以下用一個抽象但遵循論文機制的例子,說明一次跨來源搜尋。這是為了教學而寫的 TRACE 流程示意,並非 HistoriQA 的原題,也不代表 benchmark 中特定問題的結果。
假設研究者想找出 1887 年某項議會辯論的主張如何進入兩家政治立場不同的巴黎報紙。這不是單一文件能完整回答的查詢,並且 OCR 可能讓人名、地名或當時拼法出現變體。
- 拆解問題:Planner 以一次 LLM 呼叫建立涵蓋原意的子問題,例如「在議會逐字紀錄中找到該議題與人物」以及「分別搜尋兩家報紙對同一事件的報導」。每個子問題指向一個子語料,實體名稱維持原文形式,以免翻譯增加 OCR 字串不匹配。子問題可以先作為候選分流提示;之後 Agent 仍可跨出原定語料搜尋(§3.2)。
- 取得初始候選:每個方向分別用 BM25、dense semantic 和可用的日期搜尋取回候選,再透過 RRF 合併。各通道先按父文件聚合 chunk 分數,避免同一篇長文件只因切成較多段就佔滿名額。語料目標也限制候選上限在各自子語料內計算,減少大語料擠掉小語料來源的情況(§3.3)。
- 交替搜尋與覆核:Agent 查看原始問題、當前子問題和候選 chunk,決定接受、排除或暫緩。若它找到一份報紙線索,記錄的摘要可能提示另一個日期、議員或概念;它可以用下一次搜尋測試這些線索。reject 只針對片段,避免同一文件中的後續發言因此無法再被看見。
- 補足並重新規劃:該子問題結束後,第二次 LLM 呼叫把已接受文件、階段記憶和 held chunk 一起交給再評估器。系統生成含摘要、確認事實、日期、實體、剩餘缺口與搜尋提示的 briefing。下一個子問題啟動前,replanner 可調整剩餘問題或增加新的探索方向,但總數仍受上限限制(§3.5)。
- 整合排序:完成所有子問題後,同一份文件被多少條獨立子問題路徑接受,形成確認次數。先按次數由高至低分組;同次數群組內再以 Agent 自己留下的接受理由進行 LLM 排序,單一文件群組則不增加 tie-break 呼叫(§3.6)。
這個例子中的「多個路徑接受同一份來源」是作者稱為收斂證據的操作性訊號。各子問題不共享彼此接受集合,因此重複接受較不容易只是共享清單造成;但它仍不等同獨立史料互相印證。若 Planner 把原題拆錯、兩個子問題實際依賴同一段錯誤 OCR,或不同來源本來就互相抄錄,確認次數不會自動判別來源偏差。排序提供的是檢索線索,不是歷史學上的證據可信度判決。
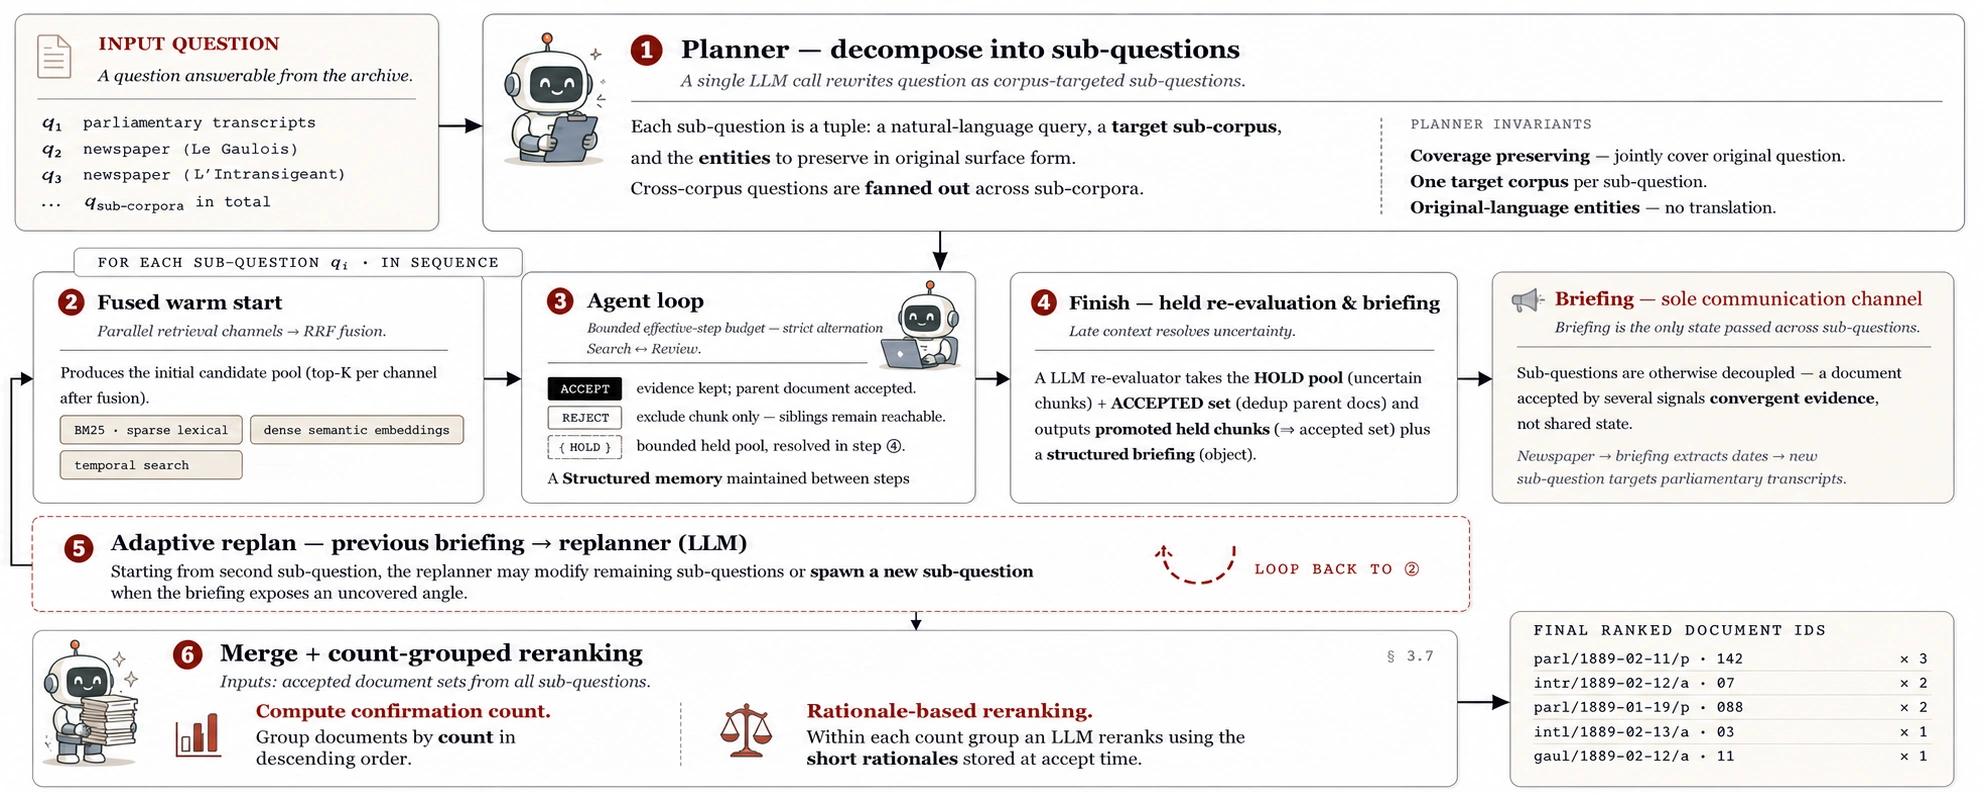
原論文 Figure 1、§3.1–§3.6。圖中呈現問題拆解、融合 warm start、Agent 搜尋/覆核迴圈、hold 再評估與 briefing、依 briefing 調整後續問題,以及最後的合併排序。原圖來自 arXiv v1 Figure 1;版權/重用狀態:原頁將此作者版本標示為個人與非商業用途;本文以非商業評論用途重製並保留來源。圖中的機器人插圖屬原論文圖像元素,不代表本文封面或 TRACE 產品介面。
方法如何把檢索變成可追蹤流程
1. corpus-targeted decomposition
Planner 將原題 轉成最多 個子問題 。設計要求子問題合起來不遺漏、也不擴張原始意義;每個子問題只指定一個子語料;專名則保留原文形式。這種拆分先改變候選分配,不會永久限制 Agent:若證據指出跨語料關係,後續搜尋仍可越界。這個區別很關鍵,因為「目標語料」是檢索起點,不是對來源可能性的排他判定(§3.2)。
2. fused warm start
對每個子問題,Phase 1 先用 BM25、dense semantic embedding 與日期通道(在日期可解析時)建立候選。BM25 對 OCR 後仍保留的專名與領域詞有用;向量搜尋可補充改寫或近義詞;時間分數讓具有明確日期的查詢不必只靠文字匹配。論文設定 RRF 的 ,並按每份父文件的最佳 chunk 分數聚合,避免段落數量支配檢索量。
作者回放實際拆出的子問題後,BM25 與 dense top-20 名單的平均 Jaccard 重疊僅 0.19;融合結果可取回 78.9% gold 文件,最佳單一通道則為 70.1%。作者用此結果支持兩個通道在此語料中具有互補性。這些數字是作者的通道分析,並不表示任意 OCR 語料都會有相同重疊率或增益(§3.3)。
3. accept、reject、hold 與有限記憶
Phase 2 讓搜尋和覆核交替,避免 Agent 連續送出未吸收結果的搜尋。Agent 每一步看到原問題與當前子問題:後者協助集中方向,前者仍是相關性判斷的基準,以免狹窄分解把跨題證據排除。系統以五格記憶保存前次發現、問題分析、已收證據、待補缺口和下一步;每次以替換方式更新,而不是不斷累加歷史對話。另有有效步數計數器,重複查詢、解析失敗、空結果不消耗有效步數,連續兩次相同搜尋則停止迴圈(§3.4)。
時間搜尋有一個細節:系統會把 Agent 指定日期的上下界各外擴一天,但不讓 Agent 知道擴大的範圍,以免它被額外日期錨定;這種邊界擴展取得的結果一律先 hold,待後續再評估。這是針對日期歧義的保守處理方式,不是泛用的時間校準或資料正規化保證(§3.4)。
4. briefing、replan 與 count-grouped reranking
每個子問題完成後,briefing 是它與下一個子問題之間唯一的溝通介面,傳遞敘事摘要、確認事實、日期、實體、缺口與搜尋提示。後續 replanner 可以因新線索修正未執行的問題,或在原拆解沒有涵蓋某個缺口時生成新問題;總數上限控制成本。由於不同子問題的接受集合彼此分離,最後把同一文件被接受的子問題數 當作收斂訊號,再由高至低排列。只有同次數的群組需要 LLM 根據短理由排序;計算量隨需要打破平手的群組增加,而非對所有候選文件重新讀一遍全文(§3.5–§3.6)。
這讓「為什麼它排在前面」至少有一條可讀路徑:哪個子問題搜尋到它、執行了什麼查詢、Agent 為何接受,以及多少條子問題路徑給它支持。不過理由是 LLM 撰寫的短文字,不會自行成為校驗過的史料摘要。若實際部署需要可稽核性,仍要保存原始文件 ID、來源館藏、影像頁碼、OCR 版本、搜尋設定、模型與 prompt 版本、人工更正與資料授權狀態。
實驗設計:一個年份、多種問題、相同資料轉換
HistoriQA-ThirdRepublic 在 TRACE v1 的描述中包含 3,386 份法語文件,來自 1887 年的議會辯論逐字紀錄與兩家巴黎報紙 Le Gaulois、L’Intransigeant。來源文本來自法國國家圖書館(BnF)的數位化館藏,具有 OCR 錯誤、版面不規則和不同文類的詞彙。文件切為 5,664 個句界 chunk,最多 1,000 個空白分詞 token,沒有 chunk overlap。benchmark 有 1,752 題:單跳 889、多跳泛型 529、橋接實體 142、比較型 192;問題由領域歷史學者協助驗證(論文 §4.1)。
比較對象分成基本檢索(BM25、dense retrieval)、圖式 RAG(HippoRAG 2、LinearRAG)和 Agentic RAG(A-RAG、MA-RAG)。作者將基線調整到法文語料,包含翻譯提示與抽取模板、把圖系統使用的 spaCy pipeline 換成法文版本;所有系統共用相同文件轉換、chunking、文件 ID 和適用時的 embedding/LLM backbone,並固定 retrieval depth。這些控制旨在減少「換了模型或資料切法」造成的混淆,仍不能消除不同系統原始介面的所有適配差異(§4.2)。
主要排序指標 R@k 是前 k 份文件中找回多少比例的 gold 文件。該論文的多 gold MRR 對每一份 gold 文件計算 reciprocal rank,再在 gold 文件集合內平均,因此如果只把最容易的一份排前面、其他 gold 文件排得很後面,MRR 會受到懲罰。對 Agent 系統,作者也單獨報告 accepted set 的 precision 和 recall,讓讀者能區分「排序後有沒有把來源排前面」與「Agent 接受文件的取捨品質」(§4.2)。
結果一:主設定與基線比較回答不同問題
Table 1 對照 DeepSeek-V3.2 和 DeepSeek-V4-Flash 兩個 backbone。V4-Flash 的整體 R@10 為 0.856、MRR 為 0.653,accepted-set precision 為 0.393、recall 為 0.879,平均接受 7.0 份文件。V3.2 的 R@10 反而較高(0.884)、accepted-set recall 也較高(0.915),但 precision 降至 0.238,平均接受 10.4 份。這不是簡單的「新模型所有指標都更好」:V4-Flash 在此設定較精選,接受集合的 precision 較高,卻略少找回 gold 文件。若研究者偏好較短人工閱讀佇列,這種操作點可能更合適;若漏掉來源的代價更高,precision 與 recall 必須依工作流程一起考量。
不同題型的困難程度也不一樣。V4-Flash 在單跳題 R@10 為 0.893;多跳泛型為 0.889,但 MRR 降至 0.560;橋接實體題為 0.750/0.472;比較題則為 0.674/0.396。換句話說,找回至少一部分來源與把多份分散來源一起排好是不同難題。Table 1 也顯示 accepted-set recall 大致追隨最後 R@10,提示主要損失多發生在 Agent loop,而非最後的 tie-break 排序(§5.1)。
Table 2 的對照把 TRACE(V4-Flash 設定)與六種基線放在一起。整體上,BM25 是 0.643/0.467,dense retrieval 0.734/0.535,HippoRAG 2 為 0.737/0.453,LinearRAG 為 0.727/0.513,A-RAG 為 0.385/0.211,MA-RAG 為 0.586/0.356;TRACE 為 0.856/0.653(R@10/MRR)。多跳比較題上差距更醒目:TRACE R@10 0.674、MRR 0.396,dense retrieval 為 0.302/0.129。這支持 TRACE 在這個法語、特定歷史年份 benchmark 上把跨來源文件帶回排序前段的能力較強,而不是它在一般 RAG 中必然更好。
比較兩個 Agentic RAG 基線時,還有不對稱的排序規則。A-RAG 與 MA-RAG 沒有輸出一份明確的排序文件清單,而是依完整檢索軌跡生成答案;作者依發現先後排序候選,並把任何曾在軌跡中遇到的相關文件都算進來。這對它們有利之處是即使文件最後沒進答案仍可計入;不利之處是發現順序未必是相關性排序,而 TRACE 有刻意 rerank。因此 Table 2 可供比較系統端到端檢索表現,但不同輸出形式使 R@10 解讀需保留這個程序差異。accepted-set precision/recall 的 Panel (b) 不依靠排序,則提供另一個觀察角度(§5.2)。
結果二:累積消融中的拆題增量最大
Table 3 使用累積式 ablation:從只有 Agent loop 的 baseline 開始,逐次加上拆題、記憶與重規劃、Phase 1 warm start,最後加 hold-and-re-evaluation。整體 R@10 由 0.688 依序升至 0.777(+8.9 個百分點)、0.801(+2.4)、0.851(+5.0)和 0.856(+0.5)。其中拆題主要改善多跳類型;記憶與 replan 對橋接實體題提升明顯;warm start 提高各類題的起始候選品質;hold 再評估則以小幅整體增益保留「後來才看懂」的邊界案例。
讀這張表時要保留「累積」二字。元件按作者選定次序疊加,下一個增量建立在前面已加入的設計上,而且方法元件彼此互動;這不是每次刪除一個元件、固定其餘設定的 leave-one-out 實驗。+8.9 或 +5.0 反映這條配置路徑上的差值,不能拆成跨系統通用的獨立因果效果。更合適的工程讀法是:作者的結果把 corpus-aware decomposition 和有品質的初始候選列為優先待驗證的機制,而不是直接照表抄出每項元件的普遍貢獻。
錯誤分類也把瓶頸定位到檢索迴圈。V4-Flash run 中,作者把所有漏掉的 gold 文件逐一歸因:82.6% 的 miss 發生在 loop 內,17.4% 則是 Agent 已接受、但最終掉到 rank 10 之後。loop 內 36.8% 是資料曾被搜尋到卻被判不相關,36.5% 是任何通道都未找到,另有 9.3% 曾 hold 但最終未升格。這意味著只繼續調整最後排名器,無法處理最大一組問題;相反地,也不能假設純提升搜尋覆蓋率即可解決判斷錯誤(§5.1)。
成本、延遲與人類使用:三種不同證據
作者以實驗當時的託管推理 API 價格估算成本:V4-Flash 約消耗 177.6 million input tokens 與 39.7 million output tokens,總成本約 36 美元;V3.2 約 93 美元。以 1,752 題估算,V4-Flash 約為每題 0.02 美元。這是 benchmark 評估的作者成本估算,不等於 DECIDON 內部服務的已查帳成本,也未涵蓋專家閱讀時間、資料整理、維護、API 價格變動或機構部署支出(§5.1)。
延遲樣本另有分母:200 題定時測試平均每題 33.8 次 LLM 呼叫、169 秒模型時間;作者估計 97.8% 的單題 wall-clock 時間花在等託管模型,框架運算約四秒。八題併發時同一工作負載約 22 秒/題。這說明實際回應時間高度受服務端與併發策略影響;它不是使用者每題固定等待 22 秒的 SLA。費用和延遲都依賴所用模型、token 使用、價格與執行方式,不能搬成對其他館藏的保證(§5.1)。
論文也描述 DECIDON 專案內部 prototype 自 2026 年 3 月起供 24 位研究者、六個合作機構使用,已支援數百個探索查詢。作者稱它仍屬早期研究服務,並非對外 BnF 服務;採用情況、工作流程影響與專家閱讀負擔的系統性評估仍留待未來研究(§6)。這些是論文的部署敘述;目前沒有獨立證據確認帳號數、查詢量或研究者工作時間,因此不能和 benchmark 分數合併成外部採用成效證據。
證據地圖:哪些是量到的,哪些仍待驗證
| 問題 | 作者報告的證據 | 可以支持的解讀 | 尚未回答的問題 |
|---|---|---|---|
| 找回來源的能力如何? | HistoriQA-ThirdRepublic 1,752 題;Table 1、Table 2 的 R@10、MRR 與 accepted-set P/R | 在這組文獻及設定下,TRACE 比所列基線找回並排序更多 gold 文件 | 是否能正確總結每份來源、是否保持每個答案主張的引用忠實度、是否遷移到別的年份或語言 |
| 哪些機制帶來增量? | Table 3 累積式 ablation | 拆題與 warm start 在作者的堆疊路徑上有較大的 R@10 增量 | 元件互相作用下的獨立因果效果;不同元件順序或另一語料的增量 |
| Agent 為何漏掉文件? | §5.1 將 miss 分成 loop 中遺漏、已接受但排序靠後、未找回、錯誤拒絕與未升格 hold | 主要錯誤發生在接受判斷和候選探索階段,適合優先檢查 loop 診斷 | 自動生成的理由是否忠實描述原文;每個錯誤類別的獨立修正成本 |
| 對研究者有何價值? | §6 描述 DECIDON 內部使用及數百次探索性 query | 有一個與真實研究問題相連的內部 prototype 情境 | 是否提升專家信任、降低閱讀時間、改善研究結論或已在生產環境部署 |
| 每題要花多少? | §5.1 報告 36 美元總模型 API 費用、約 0.02 美元/題,以及另外的 latency 樣本 | 可作為該模型和價格條件下的作者估算 | 其他年份價格、實際內部部署總成本、專家人力或可承諾的服務等級 |
這張地圖裡的證據不是同一種。benchmark 表格支持檢索品質比較;消融表支持在特定累積順序下的增量觀察;失敗歸因與案例提出可能機制;部署段落則由作者敘述實際使用情境。把它們合併成一句「TRACE 已證明典藏 Agent 更可靠、成本低且受研究者採用」,會把不同的證據強度與不同分母混為一談。
邊界與不適用條件
第一,資料只涵蓋 1887 年法國第三共和的法語議會辯論與兩份巴黎報紙。OCR 錯誤、語料種類、事件關聯與專名保留規則都具體依賴這組典藏。另一種語言、跨數百年材料、手稿、檔案 metadata、期刊或掃描版面可能需要重新調整索引與 Planner prompt。作者也指出 step/subquestion budgets、記憶大小和日期外擴範圍是在這套資料上固定,最佳值可能隨語料而變(§6)。
第二,Planner 的拆題錯誤有高代價。作者表示約 98% 的多跳問題被拆成兩個以上子問題,但 18 題被縮成一題,其中 13 題失敗,失敗率為 72%,相較約 20% 的基準。即使少見,拆題塌縮會讓 replan 沒機會補出缺少的探索路徑。這提示部署者應把原題覆蓋度與 subquestion 數量納入 trace 檢視,而不要只看最終文件排名(§6)。
第三,檢索排名不是史料解釋的完整驗證。兩個不同子問題都接受同一文件,可能只是兩個檢索視角重疊,不足以證明該文件為真或具獨立佐證性;不同檔案也可能抄錄同一來源。OCR 校正、文件來源鏈、版本、上下文完整性與 historian judgment 仍需獨立處理。使用者若需要可引用的研究結果,還要將 retrieved document ID 回連到穩定的館藏 ID、影像、頁碼與授權。
第四,論文沒有量測「accountability」帶來的下游效果。它提議 TRACE 每份回傳文件都帶有可追溯路徑,但測試指標仍是檢索成效。專家是否更快確認來源、是否更能發現 Agent 的錯誤、是否更信任解釋、是否增加閱讀負擔,作者留待後續 user study。可以說系統設計提供可檢視線索,不能說已證明提高專家信任或減少查核工作(§6)。
第五,基線比較仍有介面差異。作者為法語調整 prompt 與抽取工具,並讓大家使用相同資料切分與 backbone;但對 A-RAG/MA-RAG 以發現順序構造排序、而 TRACE 自帶排序,說明共同指標下依然存在輸出型態差異。任何比較都要看部署系統原生的任務接口與公平適配程度,不能只摘錄全體平均排名(§4.2、§5.2)。
Artifact 與可重現性:可檢視程式和語料,論文快照仍不完整
截至 2026 年 10 月 7 日,TRACE GitHub repository 公開並標示 MIT。其 main HEAD 為 295d99c,最後提交日期為 2026 年 5 月 24 日,早於 arXiv v1 的 2026 年 9 月 17 日;repository 包含 planner、agent、retrieval、metrics 等程式,但 README 要求使用者自行準備 doc_id/text_original 格式的 corpus JSONL 和問題 JSONL。它沒有在目前可見的 main tree 中附上該 benchmark 的輸入檔或論文實驗的固定 provider/model/prompt 配置。
HistoriQA-ThirdRepublic 的公開 repository 提供 corpus 與 question JSONL,README 標示 CC BY 4.0;不過目前 README 列 1,782 題(897 單跳、541 泛型、152 橋接、192 比較),而 TRACE v1 報告使用 1,752 題(889、529、142、192)。現有公開程式要求 doc_id、text_original 等欄位;資料集目前展示的欄位為 collection、id、document 等,需進行資料格式轉換。TRACE 論文稱 conversion/adaptation scripts 隨系統公開,但目前公開 main 沒有呈現論文所述的專用資料轉換程式;可檢視核心流程,不代表已有與表格完全一致的凍結資料快照和實驗設定。
本篇沒有完整 benchmark 的獨立重跑;列出的分數、約 0.02 美元成本與 24 位研究者/六個機構的使用描述均為作者報告,而非現場驗證。公開程式與資料確實降低檢視門檻,但精確重現還需要釐清兩份資料計數差異、取得與 v1 相同的 1,752 題切片、確認轉檔、固定提示與模型版本,再按相同指標重新執行。
Bloss0m 工程判斷:把檢索軌跡納入驗收
以下是 Bloss0m 工程綜合,不是作者提出並驗證過的部署規格。若要把這類方法用於典藏搜尋,可先決定每筆返回結果要能回答哪些審查問題:由哪個原題和哪個子問題觸發、用了哪個 retrieval channel、命中了哪個原始文件及頁碼、OCR/索引版本是什麼、Agent 為何接受或暫緩,以及後續由誰覆核。這會將 TRACE 的可追溯路徑延伸到具體館藏,而不是只留下 LLM 自述的一行理由。
第二,驗收資料要同時看召回、排序和判斷品質。多 gold 問題上建議保留逐題 gold 文件集合,分題型報 R@k 和多 gold MRR,並檢視 accepted-set precision/recall;對比較型與橋接型查詢尤其要逐一看是否只取回一側來源。平均數之外,還要保存 miss 原因:根本沒搜尋到、被錯誤拒絕、曾 hold 但沒有升格,或已接受卻排到 top-k 外。這種分解可以決定要修 index、Planner、review prompt 還是 reranker。
第三,把 Planner 覆蓋度、原始來源版本與資料轉換列為 benchmark 固定項。跨語料查詢應檢查子問題是否共同覆蓋原題、每個子問題是否指定可用 corpus,以及重要專名有無被翻譯或改寫。部署前將 corpus schema、source IDs、chunking、OCR 版本、embedding 模型與 prompt 版本固定;如果替換了資料集版本,就重新計算分母與子群指標,而不要繼續引用舊的論文分數。
第四,hold pool 的運作應有可見上限和人工處理方式。過多暫緩會把噪音移入後續佇列;過早拒絕又可能丟掉晚到脈絡才相關的段落。以人工標註的邊界案例調整候選數、等待再評估條件和佇列上限,並記錄哪些 chunk 被升格或放棄。論文的 +0.5 個百分點是一次累積消融的整體觀察,不足以指定其他館藏的 hold 政策。
最後,如果目標是給出研究答案,應在 TRACE 類來源探索之後加上 claim-to-source 對應與人工或規則式查核。讓每一個敘述附上來源文件、頁碼、上下文片段和證據狀態;遇到來源間互相矛盾、OCR 低可信或只有單一來源時,回答應保留不確定性。這是從可追溯檢索延伸出的系統設計建議,並非這篇 paper 已測過的答案品質功能。
若要比較其他檢索路徑,可接著讀 DocMemo 的記憶引導長文件證據探索,它討論跨回合狀態如何協助找回長文件頁面;Agentic RAG 的因果失敗歸因則提供另一個觀察搜尋與生成失敗位置的評估視角。兩篇任務和資料均不同,不能替 TRACE 的 benchmark 或使用者研究補上缺少證據。
讀完後的三個記憶點
- 把檢索當成研究對象:TRACE 衡量來源文件有沒有被找回與排對順序;可追溯的搜尋線索有助於檢視,但不等於答案主張已被史料證實。
- 拆題與融合是主增量,hold 是保留邊界證據的機制:Table 3 的增量依累積順序而來,不能當成每個元件互相獨立的因果量。
- 版本與部署陳述要分開看:論文 benchmark 是 1,752 題,公開資料 README 是 1,782 題;24 位研究者、六個機構和單題成本是作者報告的內部使用及估算,與可公開檢視的程式/資料不是同一種證據。
Primary sources
- Bian, Donghan, Marie Puren, and Florian Cafiero. TRACE: Accountable Agentic Retrieval for Source Discovery in Digital Archives, arXiv:2609.19897v1, 2026-09-17. 本文主要定位依據:Figure 1、Tables 1–3、§§3–6。
- TRACE source repository, MIT license; public code for the retrieval pipeline.
- HistoriQA-ThirdRepublic dataset repository, CC BY 4.0 as stated in its README; current public dataset README reports 1,782 questions.
- Pellet, Aurélien, Julien Perez, and Marie Puren. HistoriQA-ThirdRepublic: Multi-Hop Question Answering Corpus for Historical Research, 2026.