90 秒掌握論文
- 問題:只看 RAG 的 final answer 對不對,無法知道系統是否在沒有證據時猜中、是否在有證據時不必要地拒答,也無法知道答案品質如何隨 retrieval state 改變。The RAT 問的是:能否用一個機率模型保留這些互相依賴的行為,而不是把它們壓成單一平均分?
- 核心洞見:作者以三個二元變數描述 retrieval 、abstention 、task success ,再按 pipeline 資訊流分解聯合分布 。之後把符合指定政策的 generator success 定義成 的確定性函數,並以 Bayesian posterior 傳播不確定性。
- 最強證據:在 27 組資料集 × retriever × generator 組合中,Natural Questions(NQ)+ dense retrieval 的三個 generator task success 僅為 0.239、0.242、0.243;同一組的 卻是 0.164、0.414、0.496。這顯示在該操作化政策與資料設定下,邊際 task score 相近不等於 generator 對 retrieval failure 的處理相近。
- 主要邊界: 依賴作者選定的「retrieval 失敗就 abstain;retrieval 成功就答對」政策,並非通用安全或品質真值。研究只測三個 KILT 任務、三個 retriever、三個 8–12B open-weight generator、受限 retrieve-then-generate 單輪流程;主模型的 retrieval 判斷也是全有或全無的二元值。
本文判斷:The RAT 的價值不在於宣稱找出錯誤答案的因果根因,而在於讓評估者能把「答對」與「依目前可用證據做出合宜回應」分開量化,並把有限標註預算投到所關心的 estimand。若政策、標註或 judge calibration 不合使用情境,posterior 再精確也只是在精確回答錯的問題。
論文版本、問題與說法邊界
本文閱讀的是 The RAT: A Unified Bayesian Model for RAG Evaluation 的 arXiv v1。arXiv 紀錄列出 Pius von Däniken、Felix Matthias Saaro、Mark Cieliebak、Jan Milan Deriu,於 2026-08-25 提交至 cs.CL;截至 2026-09-24,它是預印本,不把它寫成已通過同儕審查的成果。研讀範圍涵蓋 v1 完整 HTML、固定 v1 的 PDF、本文引用的 Sections 1–6、Appendices A–G、Tables 1–11 與 Figures 1–3。arXiv v1 頁面標示 CC BY 4.0;下文三張原圖保留原圖內容,圖說附版本、section anchor 和授權。作者在論文中連結的 vodezhaw/rat repository 也另行檢查:截至 2026-09-24,GitHub 只列一個 README,內容為 “Under construction…”,未見程式、資料、release 或可重跑指令。因此「論文可讀」和「方法可重現」是兩個不同狀態。
這是一篇以評估方法和實證比較為主的 Bayesian model paper。讀者要回答的問題不是「哪個 retriever 或模型是世界第一」,而是:同樣拿到差不多的答案正確率時,系統是否以相同方式使用 evidence、選擇 abstain,並在資料不足時避免不受支持的回答? 作者指出 component-level benchmark、end-to-end accuracy 與多維度但分開報告的評測,未必保留 retrieval、abstention、correctness 之間的統計依賴。The RAT 的貢獻是建立一個依其 pipeline 假設分解的聯合分布,從同一 posterior 估計邊際量、條件量與政策遵循量。
| 說法層次 | 本篇採用的界線 |
|---|---|
| 論文直接提出 | Section 3 的二元變數、聯合分布 factorization、確定性的 定義、五個基本機率參數與 noisy-judge extension。 |
| 作者報告的證據 | Section 4–5 的 27 組評估、條件機率表、500 次 annotation subsampling、資訊增益分析、HotpotQA judge calibration;Appendix C 對 partial retrieval 的三值補充分析。 |
| 證據尚未建立 | 所有 RAG 場景的通用政策、正式環境的改善、因果根因、跨領域有效性、完整可重現性,或 judge labels 可取代人工標註。 |
| Bloss0m 工程判斷 | 可把 當作一個可檢查的 evaluation schema 範例;導入時須重定義 retrieval success、response policy、labels 和 judge calibration,並保留 production-specific failure dimensions。 |
Paper Essence Contract
- 問題:RAG 最終答案分數把 evidence 是否存在、generator 是否遵循 evidence-conditioned policy,以及回答是否正確壓在一起,造成診斷上的歧義。
- 既有方法的不足:單獨量 retrieval 或 answer correctness,不能描述一個生成器如何依 retrieval state 改變行為;相同 task score 可以來自不同的 abstention policy。
- 核心想法:以 Bayesian joint model 表達 的依賴關係,並由預先寫定的 policy 定義衍生 ;對部分未觀測 labels 邊際化,而非丟掉樣本。
- 端到端機制:對固定 query × retriever × generator 記錄 retrieval 是否成功、模型是否 abstain、答案是否符合 reference;模型依 conditional factorization 擬合 posterior,從每個 posterior draw 計算 ,再比較條件機率、區間或 annotation strategy。
- 支持證據:27 組實驗中,marginal task score 相近而 差距可大;HotpotQA + hybrid 的 subsampling 與 information-gain 分析呈現, 對預先定義的 較有資訊, 對 task success 較有資訊;Table 4–5 也顯示研究設定下的 LLM judge false-positive 問題。
- 採用邊界:政策定義若不符合產品, 不能作決策真值;二元與 all-or-nothing retrieval、closed Wikipedia-derived pool、single-turn、exact-string abstention、少量較小模型和未能重跑的 artifact 都限制外推。
核心直覺:答案對錯與行為合不合宜是兩個問題
想像兩套 RAG 都在 100 題中答對 60 題。系統甲可能在文件找不到時坦白說不知道,找到資料後也能正確作答;系統乙很少拒答,有時在資料不足時靠猜答對,另一些有證據的題目反而答錯。若只列 task success,兩套系統同分;但它們在 evidence-sensitive behavior 上不同。這個例子是解釋用的假想情境,不是論文實驗。
The RAT 先把要觀察的隨機變數定義清楚: 表示 retrieval state; 表示模型是否 abstain; 表示答案是否正確。再由 policy 定義 。Bayesian model 的用途是讓估計帶著 posterior uncertainty,並能在 labels 不齊時對未觀測變數積分,而不是把缺 label 的紀錄全部丟掉。這是一種建模選擇;機率因子順序雖借用 RAG 資訊流來安排,不因此證明 對 或 的因果效果。觀察到 不等於做過介入;資料集、prompt、模型、query 和 evaluator 的其他差異也可能影響觀察分布。
概念地圖:retrieval、abstention、answer 與 policy success
| 符號 | 論文中的操作定義 | 不應混成什麼 |
|---|---|---|
| 1 代表 retrieved context 含有回答所需的全部 information-bearing documents;主分析是二元。 | 不等於「有找到任何相關段落」,也不等於可直接觀察的語意充分性。 | |
| 1 代表 generator 以規定的明確字串拒答;實驗靠 exact string matching。 | 不等於所有自然語言的保留、保守回答或表達不確定。 | |
| task outcome 是否符合 reference answer。實驗把 abstain 狀態視作 。 | 不等於有證據支持;在 仍可能猜對。 | |
| 按作者的 deterministic policy, 時應 abstain; 時應回答且正確。 | 不等於因果歸因、校準度、通用 helpfulness 或安全性。 |
這幾個差異很重要。例如 不代表模型依 retrieved context 作答:它可能碰巧猜中。相反,retrieval 成功而 generator 仍拒答會讓 ,也會讓這個固定政策的 。指標是在評量「相對於指定 policy 的 generator behavior」,不是單純把答對率改名。模型也不替使用者判斷政策是否合理;政策錯了,估計正確仍會給出誤導性的好分數。
方法機制:從 joint distribution 到衍生的 G
作者依 pipeline 資訊流寫成:
讀法是:先有一個 retrieval outcome;在該狀態下看 abstention 機率;最後在 retrieval 和 abstention 已知時描述 task success。這是對 joint distribution 的 factorization,並非 RAG runtime 必須依序執行三個 Bayesian 模組,也不是結構因果模型。它的好處是參數容易對應到行為:
- :此 configuration 的 retrieval success 機率。
- :retrieval failure 時拒答的機率。
- :已取得所需文件仍拒答的機率。
- :無完整 retrieval 卻作答時答對的機率。
- :有完整 retrieval 並作答時答對的機率。
依作者的政策,generator success 是:
四種 組合裡, 代表「找不到就拒答」, 代表缺 evidence 仍回答, 代表有證據卻拒答;只有 還要檢查 是否正確。此定義把正確行為組合成一個可推導機率,但它仍是 policy adherence 指標,而非從資料自動發現出的規範。
作者對五個基本機率使用 independent uniform priors,judge extension 對 conditional judge outcomes 使用 Dirichlet prior;以 Stan 的 Hamiltonian Monte Carlo / NUTS 推論,每項 experiment 用五條 chain、2,000 warmup iterations、每條收集 10,000 posterior samples。對每個 posterior draw 都可以計算 等衍生量,於是區間會反映有限標註和 model assumptions 帶來的不確定性。先驗、似然、labels 與變數操作化若不合資料,較多 samples 並不會自動修正錯誤的 construct。
用一題走完整個方法:明確標示的示例
以下是Bloss0m 編寫的說明例,非論文觀察案例。假設一位使用者問:「這項採購今年是否已完成安全審查?」retriever 回傳的文件缺少審查結果;產品 policy 規定缺少完整依據時要拒答。模型執行過程可按論文的變數讀成:
- 輸入:固定的 query、retriever、generator 和資料快照;這裡是上面那個採購問題。
- 中間狀態 :評測標註檢查所有被定義為必要的 evidence 是否出現在 retrieved context。若缺少必要結果,主分析記為 ;「部分找到一些相關文字」不改變這個 all-or-nothing label。
- 模型決策 :若輸出與精確 abstention string 一致,記 ;其他輸出記 。自由格式的「我不太確定,但可能已完成」在該評測 protocol 下未必會被當成 abstention。
- 結果 :非拒答時,和 reference answer 對照;答案字面正確就可記 。這仍不代表答案有 retrieved evidence 支持。
- 衍生 :如 ,該樣本符合此 policy;若 ,即使碰巧答對 , 仍為 0;若 ,則要 才算 。
- 可能失敗點:gold retrieval label 是否真的代表可充分作答?使用者政策是否容許部分回答?精確字串是否漏掉了更自然的 abstention?任何一處錯標都會影響 posterior 對行為的詮釋。
這個走讀說明一筆樣本如何進入模型。它沒有把觀察到的 conditional association 解讀成「retrieval failure 造成了拒答」;也不表示 可替代產品自己的政策、安全審查或人類判斷。
論文 Figure 1:變數依賴,而不是因果證明
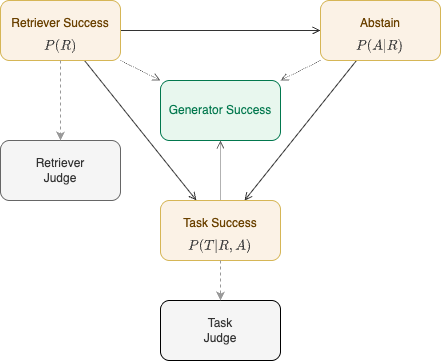
Figure 1,取自 arXiv v1 Figure 1,位於 Section 1。閱讀時注意 如何用來分條件、 如何由 retrieval state、abstention 和 task outcome 推出;這是論文評估構念的依賴圖,不是因果 DAG,也不是系統必須照著執行的架構圖。原圖依 arXiv v1 頁面所示 CC BY 4.0 重用;本地圖檔未重繪或裁切。
實驗如何建構:27 個 configuration 的控制比較
作者使用 KILT 中的 FEVER、HotpotQA(HQA)與 Natural Questions(NQ),每個 task 各抽 10,000 個 query。將這些 query 相關文件合併成 1,720,160 段的 shared Wikipedia-derived knowledge base。FEVER 多數問題只有一個 relevant paragraph,且回答選項是 SUPPORTS、REFUTES 或 NOT ENOUGH INFO;HQA 每題設有兩個 relevant paragraphs,需要 multi-hop;NQ 使用 short-answer annotation,作者也定義每題有一個相關 paragraph。這讓三種 evidence burden 可比較,但仍是受控而非 production corpus。
retriever 有三種:以 BM25 為主的 sparse、以 embedding + HNSW/FAISS 搜尋的 dense、以及透過 Reciprocal Rank Fusion 結合的 hybrid;全部取 top-5。generator 有 Apertus 8B、Gemma3 12B 和 Qwen3.5 9B,形成 3 datasets × 3 retrievers × 3 generators = 27 configurations。輸出受 prompt 限制為短答案或精確拒答字串,方便標註,但也使結果依賴這套窄化的 answer format。
論文 Figure 2:有限預算時,要標註哪個變數?
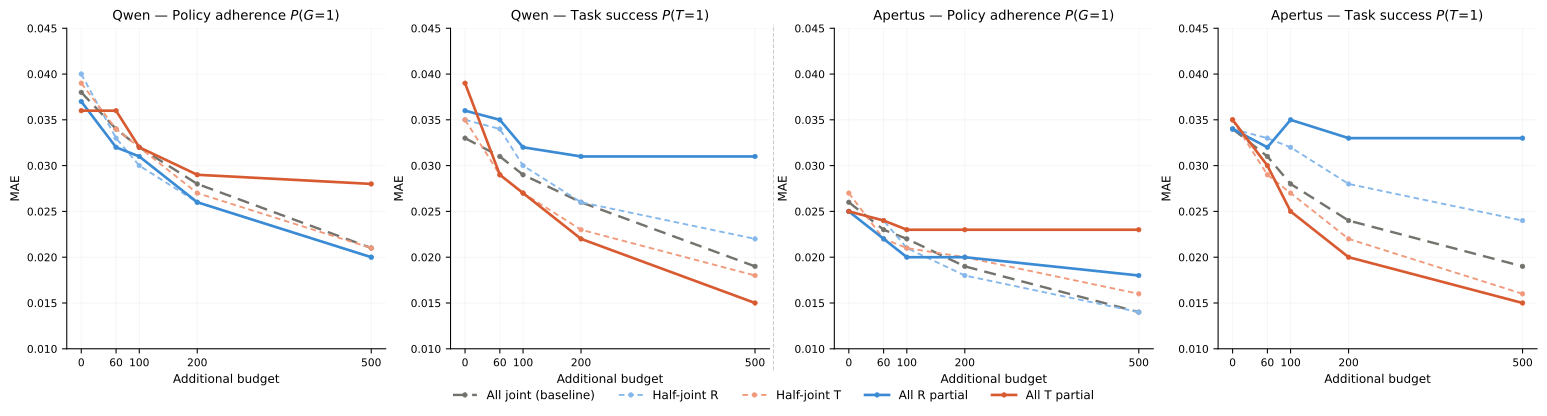
Figure 2,取自 arXiv v1 Figure 2,位於 Section 5.3。它比較 Qwen 與 Apertus 在 HotpotQA + hybrid retrieval、100 筆完整 baseline labels、不同追加 budget、abstention 以字串觀察且 500 次 subsampling 下的 MAE;重點是 與 的最佳標註方向不同,不是「只標 retrieval 永遠更好」。原圖依 v1 頁面 CC BY 4.0 重用;SVG 以原始圖檔提供,沒有改動資料或軸。
每次 annotation experiment 的起點為 100 筆同時具有 retrieval 和 task labels 的 base samples;abstention 假設可由輸出字串直接觀察。追加 60、100、200 或 500 筆資料,分配成 all-joint、half-joint-R、half-joint-T、all-R 或 all-T 五種策略。作者從各 10,000 筆任務資料中重抽 500 次,對完整資料 point estimate 計算 MAE 和 95% credible interval width;該子實驗只用 HQA、hybrid retriever、Apertus 和 Qwen,而不是全部 27 組模型設定。
在這個固定 target 下,估計 policy adherence 時,偏 retrieval labels 的策略通常比只追加 task labels 更快降低 MAE;估計 時,方向相反,task labels 最直接。all-joint 在兩種 estimand 上都相對穩健,因為事前不知道最終要估哪個指標時,它沒有依賴只對特定 target 有利的省略資訊。這是標註設計線索,不是宣稱 retrieval annotation 普遍比 task annotation 便宜或更有價值。
為什麼 retrieval label 對 G 比較有資訊?
Table 3 與 Appendix F 給了結構性解釋。在 已觀察時,四種 格子中,三格已由 決定 :retrieval 失敗且 abstain 是成功;retrieval 失敗卻回答是失敗;retrieval 成功卻 abstain 也是失敗。只有 retrieval 成功且回答時,還要知道 。因此,額外觀察 能直接決定較多樣本的 policy label;額外觀察 只直接解決部分情形。
在 HQA + hybrid 設定,Qwen 的 conditional information gain per sample 是 all-joint 0.526、half-joint-R 0.436、all-R 0.345、half-joint-T 0.340、all-T 0.154;Apertus 分別為 0.490、0.387、0.284、0.345、0.200。這些是 Appendix F 基於該配置和估計機率算出的信息增益,並非跨模型、跨 policy 可照搬的 annotation ROI。作者也指出 Qwen 的 all-R 在較大 budget 時 empirically 可略勝 all-joint,儘管單樣本資訊增益比較低;因為起初 100 筆 joint samples 已約束唯一需要 的模糊格,之後追加 joint labels 的邊際收益會下降。這個差異很適合提醒讀者:information-theoretic ranking 不能代替完整的 finite-sample behavior。
論文 Figure 3:誤差之外,也要看 posterior interval
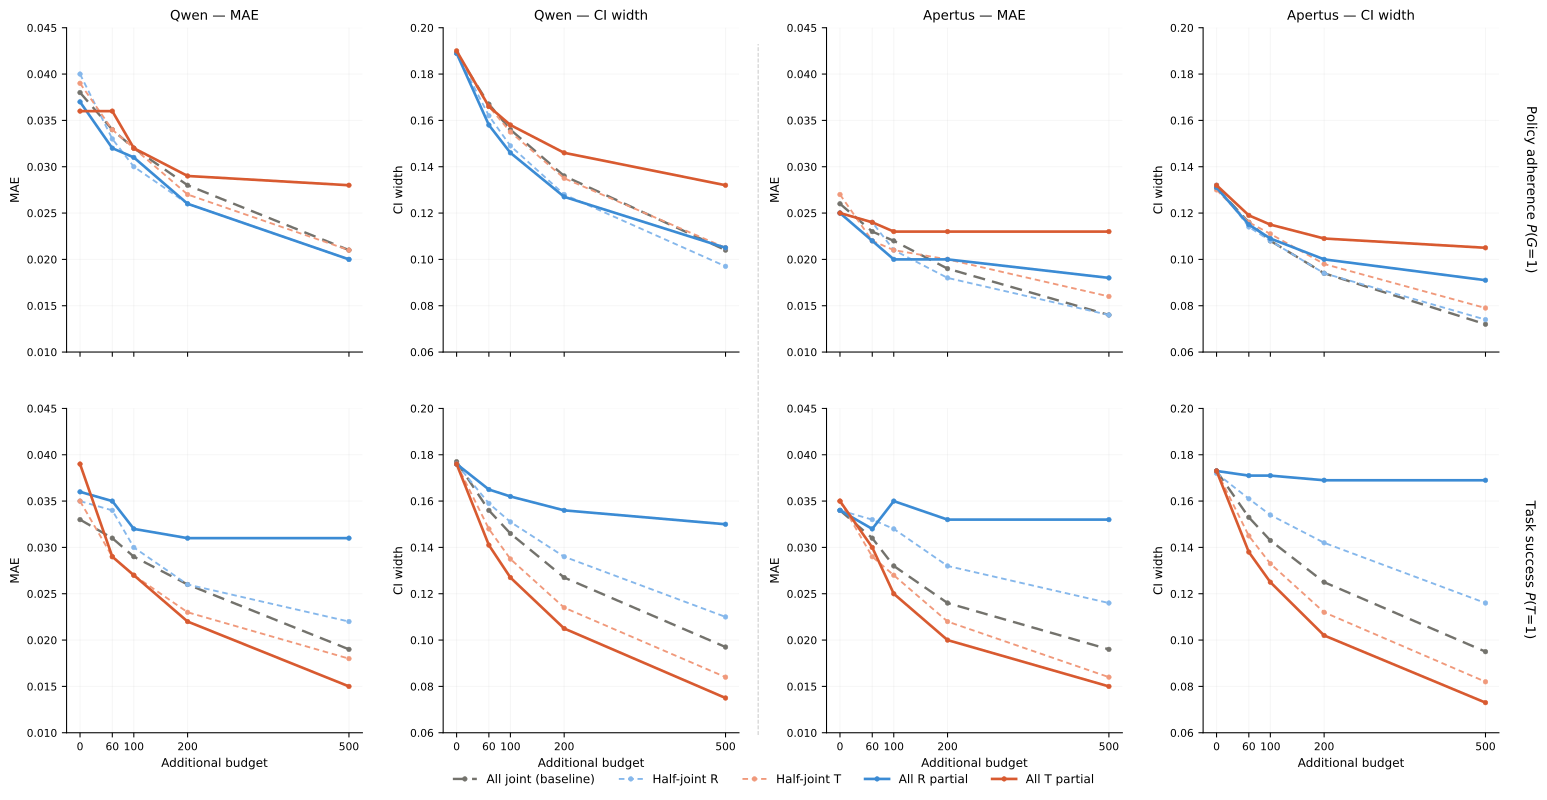
Figure 3,取自 arXiv v1 Figure 3,位於 Appendix E。上排為 、下排為 ,同時呈現 MAE 與 95% credible interval width;在 budget 500 的 Qwen 例子中, 的 all-R interval width 為 0.105、all-T 為 0.132,而 的 all-T 為 0.075、all-R 為 0.150。這圖補足 Figure 2 只有 MAE 的主文結果,也讓 target-dependent reversal 可視化。原圖依 arXiv v1 頁面 CC BY 4.0 重用;SVG 原檔未改。
在相同 500-budget 例子中,作者報告各策略的 coverage 接近 nominal 95%;all-joint 對兩個 target 都維持窄 interval。讀圖時不要將 credible interval 誤認為 query-to-query variability 或多個 production deployment 的不確定性:它是此 Bayesian model、資料與抽樣設計下的 posterior interval。可靠的 uncertainty quantification 仍依變數定義、先驗與 observation model 是否合宜。
最醒目的對比:task success 近似,不代表政策行為近似
論文 Table 1 展示 marginal 概況;Table 2 再拆 conditional probability。最容易看出差異的案例是 NQ + dense:Apertus、Gemma3、Qwen3.5 的 分別為 0.239、0.242、0.243,幾乎重疊; 卻分別為 0.164、0.414、0.496。Table 2 顯示其中與 retrieval failure 相關的 abstention estimates 亦不同:三者 為 0.039、0.382、0.513。這不是說 Qwen3.5 在所有真實 RAG 上「更安全」,只說作者定義的 policy 下,這三個模型在該資料、retriever 和 prompt 組合中的估計行為有差異。
HQA + hybrid 的 conditional values 也使同一點更具體:Apertus 在 時的 abstention 是 0.039、在 時是 0.005;Gemma3 分別 0.270 和 0.021;Qwen3.5 分別 0.463 和 0.036。正確讀法是「觀察到各模型對 retrieval state 的 abstention 機率不同」,不是「R 造成了模型拒答」。論文沒有做隨機化 retriever intervention 來識別因果效應,而是用條件分布更完整地描述同一實驗架構內的行為。
另有 dataset-dependent trade-off:hybrid 在 FEVER 和 NQ 取得最高 marginal retrieval success,sparse 在 HQA 最好;FEVER 的 answer label 空間只有三種,且每題多為單文件,task success 自然較高。這提醒工程團隊不要把一個 retrieval leaderboard 直接等同下游 answer win,也不要把不同 dataset 的 raw success rate 當成同難度比較。RAT 能讓這些維度同時可見,但不能替團隊設定 utility function。
LLM-as-a-judge:把 noisy labels 放進模型,不會讓它們變成 gold
作者用 GPT-4o-mini 估計 retrieval 與 task labels,分別引入 和 作為 ground truth 的 noisy observation,並從 Table 4 的 TPR/FPR 建立 calibration likelihood。這個 extension 的目的,是讓人工 labels 和 judge labels 可共存並傳播校準誤差;不是宣稱 judge 能自我校正成真值。judge 的判斷仍依 prompt、benchmark 和 calibration sample。
在 HQA,retrieval judge 的 TPR 為 0.77,FPR 依 retriever 為 0.17–0.19;task judge 的 TPR 為 0.88–0.94,FPR 卻達 0.32–0.43。由於真實 task success 約 0.21,較高的 false-positive rate 會把 judge-observed success 明顯推高:Table 4 的 0.21 對應 約 0.52–0.57。這是 base-rate-sensitive 的重要實務點:只報 judge accuracy 或 TPR 會漏看低 prevalence 下的 false positives。
Table 5 進一步只以 200 筆完整人工 labels 作 baseline,再加入 0、500、5,000 個自動 judge annotations。對 HQA + hybrid + Apertus, 的 95% interval width 從 0.0941 降至 0.0802,MAE 則約維持 0.017; 的 interval width 從 0.1246 到 0.1150,MAE 約為 0.023。五千筆 noisy annotations 有些區間變窄,卻沒有帶來相應的明顯 MAE 改善。這是單一 judge 和校準設定的作者實驗,不等於所有 judge 都無用;它支持的工程問題是:先量 calibration 和 false-positive behavior,再決定擴大自動標註。
Appendix C 的重要補充:partial retrieval 被主模型折成 failure
The RAT 主模型把 retrieval success 定義為「所有必要文件都在 context」,所以部分取得必要文件也被二元化成 。作者知道這個處理可能隱藏 multi-hop evidence,於 Appendix C 另外將 設為 fail / partial / success 三值。HotpotQA 每題有兩個 relevant paragraphs,partial retrieval 比率在 dense、hybrid、sparse 下分別是 47.24%、56.47%、52.33%;FEVER 為 3.00%–4.53%;NQ 是 0%,因為每題只有一個 relevant paragraph。
這項 appendix analysis 看見 HQA 中 abstention 隨 retrieval quality 增加而下降、task success 上升,和主文方向一致。但它沒有把三值版本發展成全套的新 policy model,也沒有解決 relevance labels 未能表達「哪些 passages 個別足夠、哪些必須合用」的問題。因此 partial retrieval 是主模型 external validity 的警訊與補充切片,不應被當成已完成的細粒度 retrieval quality solution。
實驗設定與證據地圖
| 問題 | 控制與量測 | 本文中的定位與限制 |
|---|---|---|
| 27 組配置的邊際表現如何? | 3 KILT datasets × 3 retrievers × 3 generators;retriever top-5;report 、、、。 | Table 1 給整體;因 shared query-derived Wikipedia corpus 和 task answer format 受控,非 open-web production benchmark。 |
| 相近 task score 是否藏有不同 conditional behavior? | 以各配置分開 Bayesian fit,估計 和 。 | Table 2 支持配置內的 conditional differences;不是因果 attribution,也不代表可跨 domain 外推。 |
| 標註預算如何分配? | 100 joint base labels + 60/100/200/500 additions、五種 allocation、500 subsamples,HQA hybrid 上測 Qwen/Apertus。 | Figures 2–3、Table 3、Appendices E–F 呈現 target-dependent error / uncertainty。 |
| noisy judge labels 是否帶來改善? | GPT-4o-mini judge、以人工 labels 校準 TPR/FPR、0/500/5000 additions;主要報告 HQA hybrid Apertus。 | Tables 4–5 顯示研究設定下高 FPR 和有限增益;judge/model 範圍有限。 |
| binary 漏掉什麼? | Appendix C 對 fail/partial/success 作三值分析。 | Tables 8–9 展示 partial retrieval 集中於 HQA;仍受 relevance annotation 和 policy simplification 限制。 |
Paper 直接支持:上述變數定義、27 個配置、模型估計、條件表、annotation subsampling、judge calibration、partial retrieval 表格,以及各自的數字與設定。作者的解釋:條件分解使近似的 marginal task success 可呈現不同 policy adherence;觀察 對估計 在該設計較具資訊;judge FPR 會限制 noisy labels 的邊際價值。尚未建立:RAT 會提升 production answer quality、它識別出因果根因、固定政策適用所有產品、judge 可以取代人工,或資料足以重現全部結果。Bloss0m 判斷:在內部評估卡上分列 outcome 與 policy behavior 很有用,但 必須與業務風險、允許的部分答案、成本和人工 escalation policy 一起審查。
失敗模式與採用限制
- 二元化會丟掉梯度:相關文件可能找到一部分、只提供弱支持,或彼此矛盾;主模型只用 fail/success。傳統 IR 常見的 MRR、MAP 等 continuous/ranking view 不會自然落進目前的 binary construct。
- 把政策選擇寫進分數:本文固定「retrieval fail 就 abstain;retrieval success 就正確回答」。允許帶有明確不確定性的部分回答、不同 abstention threshold 或任務風險差異時,都需改寫 policy;不可直接套用舊 排系統。
- retrieval success 本身依賴 gold definition:作者以所有 relevant documents 均被取回為成功。對可由單一文件回答但資料集標了多個 relevant passages 的題,這個定義可能把其實可答的 context 判失敗;反向也可能存在 evidence sufficient 但未被 gold list 收錄。
- abstention 用 exact string:這適用於嚴格的 single-answer prompt,無法識別 free-form hedge、部分拒答或委婉提醒;生產中若改用 classifier,就又引入一個需要校準的 noisy measurement。
- 任務、模型與 pipeline 範圍窄:三個 benchmark、三個 8–12B generator、retrieve-then-generate、single-turn。沒有包含 query reformulation、reranker、chunk filtering、iterative retrieval、multi-turn memory 等其他 decision points;要擴充就需要新變數與重新驗證 factorization。
- shared corpus 使絕對 retrieval 成績偏樂觀:資料庫由被選 query 的相關文件構成,較完全 open-domain corpus 更受控。作者也指出這可能提高 absolute retrieval success,不能把表格數字當作部署召回率預測。
- posterior uncertainty 不等於 model uncertainty 全包:credible interval 傳達模型內的不確定性;若 annotation validity、prior sensitivity、資料漂移或變數漏建沒有進模型,區間不會自動吸收它們。
- repo 未達可執行狀態:論文雖連到 GitHub,但實際頁面只有 placeholder README。現階段無法核對 requirements、code/data completeness、license、release/tag 或 reproduce commands;不應稱為 reproducible artifact。
Bloss0m 工程判斷與不適用條件
以下是 Bloss0m 工程化整理,不是論文提出的產品架構或官方 checklist。若團隊想採用類 RAT 的拆分,先寫一份 evaluation contract,再看模型分數:
- 決定決策政策:哪些 evidence state 下允許作答、部分回答、拒答或升級人工?為每種結果先定義 policy success,不要沿用論文的 當預設真值。
- 把標籤定義成可重複規則:描述 relevant evidence 是「至少一份足夠」還是「全部標註文件必須取回」;處理 partial / conflicting support,並以 blind double annotation 或 adjudication 測 construct validity。
- 拆開 estimand:至少同時報告 task correctness、retrieval state、abstention/policy behavior,並標示 denominator 與 conditional slice。不能只報綜合分,也不能因多列一個指標就聲稱有 root-cause observability。
- 配置標註預算前先指定 target:如果決策目標是 policy adherence,可測 retrieval labels 的 marginal information;若看 answer quality,task labels 是直接觀察。用 pilot subsampling 比較 MAE、interval coverage 與人工成本,勿單憑 Table 3 搬用 allocation ranking。
- 校準 automated judge:保留人工 gold slice,分 retrieval/judge task 測 confusion matrix、TPR/FPR 和不同資料切片;遇到低 prevalence 指標時特別看 false positives。若 calibration drift,停止把 judge volume 當成有效樣本量。
- 把不同 failure path 分欄:RAT 是一個 minimal schema,不含安全政策違規、faithfulness、引用正確性、資料權限、延遲、成本、多輪記憶或工具副作用;production dashboard 需要另加這些與實際風險相符的維度。
適合嘗試的情況是:有穩定 reference、能一致標 evidence sufficiency、明確 policy,且需要把 end-to-end score 拆成條件行為。先別直接使用的情況則包括:自由格式對話的拒答語意未定、partial evidence 常見但未定義如何評分、ground truth 缺失、judge 尚未校準、或業務 policy 允許 abstain 和 partial answer 的 trade-off 需要 risk-sensitive utility。RAT 讓問題可見,但不會代替團隊做這些規範決策。
Artifact 與可重現性(截至 2026-09-24)
- Primary paper:arXiv v1 PDF、HTML 與 source endpoint 可直接開啟;v1 日期為 2026-08-25,頁面標示 CC BY 4.0。本文固定使用 v1,沒有混入後續版本。
- 程式碼:作者連結的
vodezhaw/rat是 public GitHub repo,但其檔案清單只含一個 README,正文為 “Under construction…”。截至查核日沒有可執行 implementation、dataset、release、dependency lockfile 或 reproduction instructions;狀態是 placeholder / not currently runnable,不是「有公開程式」。 - 資料與輸出:論文描述 KILT subsets、shared 1,720,160-paragraph corpus 與模型條件,但這次可直接核查的作者 repository 沒有對應資料、生成輸出或 environment manifest;完整流程是否能從官方 artifact 重建,尚未證實。
- 最小重現方向(條件式):若日後程式、必要 KILT inputs 與 model endpoints 可用,可先固定一個 dataset × retriever × generator,按 Section 3 定義 labels,重跑 five-chain NUTS fit 並比對 posterior summary;接著用 500 resamples 重做 HQA allocation experiment。現況下這只是根據論文方法描述的規劃,不能宣稱已成功重現。
- 待確認事項:public code 何時補齊;資料預處理及 shared corpus manifest;模型確切 checkpoint / decoding settings;先驗與 judge calibration data;鏈收斂診斷、計算成本與 seed sensitivity;在 partial/soft policy、多輪和 open-corpus 設定下是否仍適用。
讀完後的三個記憶點
- 技術想法:RAT 把 的依賴放進 Bayesian joint model,再依明確政策導出 ;條件化能補充單一 task score,但因子化不是因果證明。
- 證據:NQ + dense 的三個 generator task success 幾乎相同, 卻不同;HQA 子實驗說明 retrieval labels 對估 、task labels 對估 的相對價值,judge false positives 則提醒自動標註須校準。
- 採用邊界:先驗、標註和 binary policy 決定模型在回答什麼問題。論文 GitHub repo 在查核日仍是 placeholder,故目前可評讀方法,不能把它當成現成可執行套件。
延伸閱讀可接 Causal Failure Attribution in Agentic RAG:它把介入式因果歸因和一般 failure diagnosis 分開,剛好補足本篇不可將 conditional dependency 說成 root cause 的界線;再讀 Predicting Partial Answer Quality in Agentic RAG 可比較另一種把逐輪品質與停止決策連起來的評估問題。兩者是不同方法,不是 RAT 已驗證的 extension。
Primary sources
- von Däniken, P., Saaro, F. M., Cieliebak, M., & Deriu, J. (2026). The RAT: A Unified Bayesian Model for RAG Evaluation, arXiv v1. DOI: 10.48550/arXiv.2608.24753.
- Full HTML, version 1(Figures 1–3、Tables 1–11、Appendices A–G)。
- Author-linked RAT repository(截至 2026-09-24 僅有 placeholder README)。