在開發具備自主代理能力(Agentic AI)的系統時,70M 至 500M 參數級別的小型語言模型(SLM)因其極低的推論延遲與邊緣運算(On-Device)適應性,成為業界的熱門選擇。然而,相較於千億參數的巨型模型,要在這個微量級距中利用 PPO(Proximal Policy Optimization) 進行人類偏好對齊(RLHF)一直被視為極度不穩定的玄學。
近期發表的論文《Towards Robust Reinforcement Learning for Small-Scale Language Model Agents》針對此現象進行了系統性的大規模實證,透過 15 組 (模型, 語料庫) 的交叉實驗,成功拆解了 SLM 規模下 PPO 常見的三大崩潰模式,並提出了極具實務價值的「能力空間假說(Capacity-Headroom Hypothesis)」。
實驗設定與模型矩陣
為確保結果具有普適性,研究團隊選擇了兩個不同架構的開源 SLM 家族:
- Pythia 系列:包含 70M、160M、410M 三種尺寸,基於 GPT-NeoX 架構。
- SmolLM2 系列:包含 135M、360M 兩種尺寸,基於 Llama 架構(包含 RoPE 與 SwiGLU)。
這些模型分別在三個難度不同的語料庫(TinyStories、CNN/DailyMail、Wikitext-103)上進行了完整的 SFT -> Reward Model -> PPO 訓練循環。
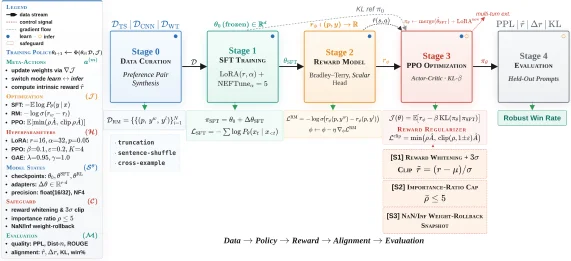 圖一:小型語言模型代理的端到端 RLHF 流程。包含資料處理、SFT 訓練、獎勵模型訓練,以及最終具備三層安全機制的 PPO 穩定微調。
為什麼 SLM 的 PPO 那麼容易崩潰?三大實務地雷
許多開發者在對 500M 以下的 SLM 進行 PPO 訓練時,常會遇到梯度爆炸或模型完全講出亂碼的情況。論文總結了三個在底層架構上最常被忽略的「靜默殺手」:
1. 梯度流動受阻(Gradient Flow Obstruction in PEFT)
在使用 TRL 框架結合 LoRA 進行參數量化微調(PEFT)時,系統可能會因為實作上的漏洞,靜默地將 LoRA 參數凍結(Non-trainable)。這會導致 Policy 模型雖然能不斷生成 Roll-outs 並計算 Loss,但底層權重根本沒有被更新。 解決方案:採用 Merge-and-Reinitialize 技巧。先將 SFT 的 LoRA 權重合併至 Base Model(並將此視為 Reference Model),接著掛載一個全新(Zero-initialized)的 LoRA 進行 PPO 更新,確保梯度流暢。
2. bf16 降精度帶來的數值溢出(Numerical Instability in bfloat16)
在 PPO 演算法中,計算重要性比率(Importance Ratios, )時需要計算兩個對數機率(log-probabilities)的差值。由於 bfloat16 僅有 7-bit 的尾數精度(Mantissa),在小於 200M 參數的模型中,這極易導致「災難性抵消(Catastrophic Cancellation)」。在訓練的最初幾步,比率值甚至會飆升超過 ,引發硬體層級的 NaN/Inf 異常。
解決方案:在 PPO 的核心迴圈中(包含 Policy、Reference Model、Value Head 與 Reward Model),強制將所有張量運算切換回 float32 精度。
3. 分布崩潰(Distributional Collapse)
長尾的獎勵分佈若搭配未設限的 KL 散度懲罰(KL Penalty),會促使 Optimizer 將 Policy 推向 Reference Model 認定極低機率的極端區域,最終產生完全無意義的亂碼。 解決方案:實作三層控制系統:
- Reward Whitening 與 截斷:限制 Advantage 估計的極端值。
- Importance-ratio 門檻保護:當 Batch 的平均重要性比率超過 5 時,直接跳過該 Mini-batch 更新。
- 權重回滾(Weight-Rollback):一旦偵測到 NaN/Inf,立即退回前一步的 Optimizer 狀態。
PPO 與 SFT 獎勵的表現對比
論文在所有 15 組設定中比較了 PPO 訓練後的模型與原本 SFT 模型的獎勵得分。下圖展示了這個對比:
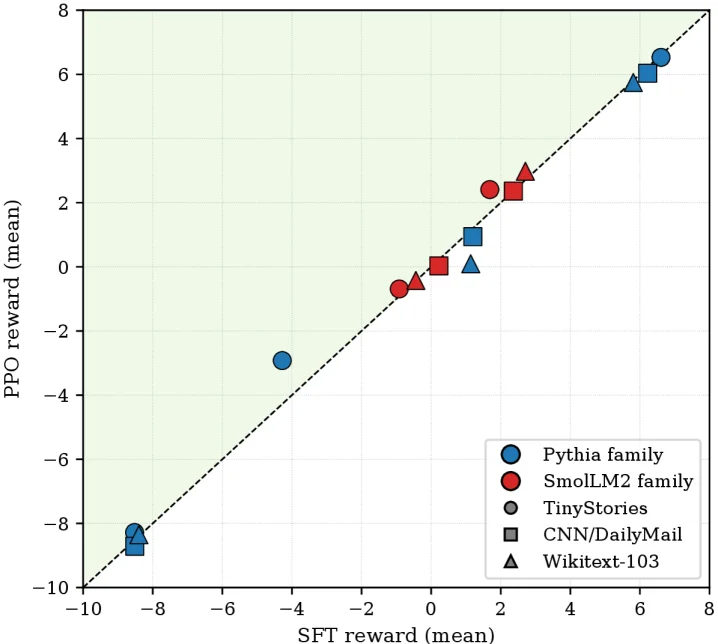 圖二:15 種設定的 SFT 與 PPO 獎勵比較。落在虛線(基準線)上方的標記代表 PPO 成功帶來了效能提升。可以看到 Pythia-410M 與 SmolLM2-360M 在 TinyStories 上有顯著的向右上方偏移。
從結果可以發現,Pythia-410M 與 SmolLM2-360M 模型在 TinyStories 資料集上取得了最大的獎勵增幅( 與 ),並且對戰勝率接近 60%。然而,70M 的極小模型則幾乎沒有提升,甚至在某些資料集上出現衰退。
能力空間假說(Capacity-Headroom Hypothesis):何時該用 PPO?
這篇論文最核心的實務貢獻,是打破了「參數越少,RL 越沒用」的迷思,並提出了清晰的判斷準則——「能力空間假說」。
研究顯示,PPO 能否在小模型上發揮作用,並不取決於模型絕對參數量的多寡,而是取決於兩個先決條件:
- 流暢的 SFT 先驗(Fluent SFT Prior)
- 具備鑑別度的獎勵訊號(Discriminative Reward Signal)
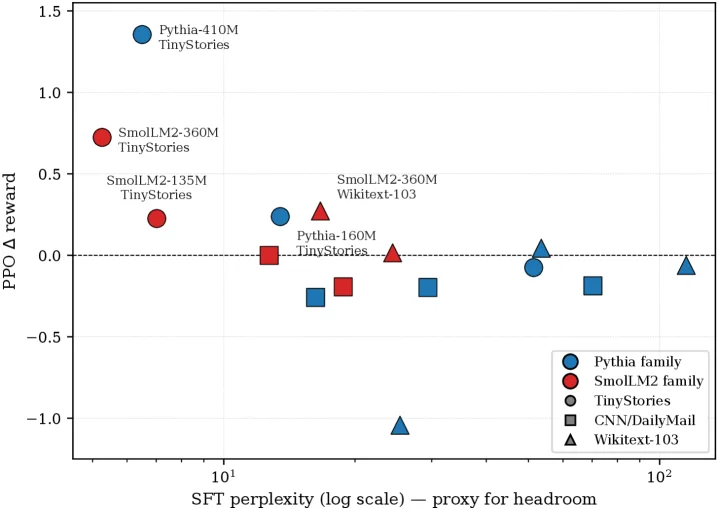 圖三:能力空間假說的實證圖。橫軸為 SFT 困惑度(對數尺度),縱軸為 PPO 帶來的獎勵增幅。當 SFT 先驗足夠流暢(PPL < 20)時,PPO 才能有效運作。
PPL < 20 的黃金交叉線
如圖三所示,SFT 模型的困惑度(Perplexity, PPL)與 PPO 能帶來的獎勵增幅呈強烈的負相關,並且在 處出現明顯的轉折點:
- :模型具備足夠的語言流暢度,能將生成的樣本維持在 Reward Model 可靠的訓練分佈內,此時 PPO 能帶來顯著的成效與獎勵提升。
- :預期增幅極其有限,甚至可能出現效能衰退(Regression)。這時的算力資源與其拿去跑 PPO,不如拿去清理 SFT 數據或是提升 LoRA Rank。
- :模型連話都說不清楚,給出的 Gradient 就像雜訊,PPO 極有可能直接崩潰。
此外,論文也透過消融實驗(Ablation Study)證明,若不加上述的三層防護機制,未經保護的 PEFT PPO(即便 PPL 達標)也會在最初的幾個 mini-batch 內發生 NaN 錯誤並宣告訓練失敗。
結論與工程啟示
《Towards Robust Reinforcement Learning for Small-Scale Language Model Agents》為終端 Edge Agent 開發團隊提供了一套極具可操作性的 PPO 實務指南。它告訴我們,在為資源受限環境打造 AI Agent 時,與其盲目擴充參數或放棄 PPO 改用 DPO,不如先審視你的 SFT PPL 是否達標,並老老實實地將浮點運算精度與防護機制(Safety Mechanisms)做好。
只有在穩固的工程腳手架之上,小巧精悍的 SLM 才能真正展現出超越體型的智慧。
延伸閱讀路徑
- 先用 AI Agent 實戰指南確認小模型只是 Agent 系統中的一層,還需要工具、記憶與評測設計。
- 讀思維鏈可控性,區分訓練後行為改善與推理過程真的可監督之間的差距。
- 再看強化學習對齊的韌性,把單一 PPO 配方放進更廣的對齊與失效脈絡。
延伸閱讀
- AI Engineering Agent 寫程式的 Self-Scaffolding:Ornith 1.0 的訓練與評測邊界 讀 Ornith 1.0 的 self-scaffolding:Agent 寫程式時自己搭鷹架解決什麼、評測能說明什麼、信任邊界在哪。Ornith 是案例,不是搜尋入口。
- AI Engineering AI Agent 論文怎麼讀:從 CoT、WebGPT 到 ReAct 用一張圖說明 CoT、WebGPT 如何匯入 ReAct,再沿工具、記憶、評測與安全等方向延伸,並與論文庫的 agent-systems 閱讀順序對齊。
- AI Engineering Holo4:一個 Agent 跨 GUI、程式與工具,授權卻不相同 拆解 H Company Holo4 的跨介面 Agent 與長流程 harness,並核對 benchmark、公開軌跡資料和兩個 checkpoint 的授權差異。