Anthropic 在 2026 年 9 月 17 日發表的 How Claude is uplifting biomolecular modeling,不是又一篇「模型排行榜更新」。它描述的是另一種 AI-assisted engineering:讓 Claude 在研究人員監督下,修改與優化超過 30 個開源生物分子模型的 inference path,然後把結果整理成可對照 stock 版本的公開 kits。
官方文章的 headline 是不到四週、平均約 4 倍加速;但真正值得工程團隊讀的不是 4x 這個數字,而是它把「模型最佳化」拆成幾個可以檢查的責任面:原始版本在哪裡、什麼叫 exact、fast 模式允許多少數值差異、顯存不足時 big 模式如何處理、權重與依賴是否固定,以及失敗時能不能回到 stock。
本文先把 Anthropic 的第一方結果與工程推論分開,再拆解 FlashPairformer、低記憶體 Big mode、protein-design 成本實驗,以及公開 repository 裡的 rollback 與 supply-chain 邊界。這不是獨立重跑,也不是在宣稱 Claude 已經取代 inference engineer。
先把 claim 分成三層
官方來源其實同時談了三種不同的成果,如果不拆開,很容易把它們混成一個過度寬泛的「AI 自動優化成功」:
| 層次 | Anthropic 報告的結果 | 讀者應該怎麼解讀 |
|---|---|---|
| 多模型 inference optimization | 超過 30 個生物分子、蛋白質與基因組模型;整體平均約 4 倍加速,精度只付出很小代價;若要求 identical outputs,整體約接近 2 倍;官方結構預測子集圖表則約為 1.6 倍 | 這是跨模型的第一方彙總,不是所有硬體、輸入與 driver 的共同 benchmark;約 2 倍與約 1.6 倍屬於不同範圍,不能混用 |
| 結構預測與 kernel | triangle attention 約 2.7–2.9 倍,triangle multiplication 約 1.7–3.2 倍,依 model configuration 而異 | 這是特定算子與設定的速度比較,不等於端到端每個模型都得到同樣倍率 |
| 蛋白設計與大分子 | 新的設計流程以更少 GPU hours 取得接近過去 campaign 的 in-silico ipSAE;Big mode 讓部分超過 10,000 tokens 的系統在單一 GPU node 上可跑 | ipSAE 是計算指標;能跑起來也不等於預測已通過 wet-lab 或所有科學驗證 |
這三層的共同點是:它們都需要一個可追蹤的 baseline。沒有 stock 版本、輸入條件、硬體、精度、模式與 downstream metric,speedup 只是一個沒有上下文的 marketing number。
真正的 pipeline:Agent 改程式,人類固定驗收
從官方文章與技術報告能還原出一條比較可信的工作流:
- 先選定一個開源模型與 pinned upstream release,保留未修改的 stock path。
- 讓 Claude 檢查模型的 inference graph、記憶體配置、重複計算與 GPU kernel 熱點。
- 先做可重用的核心 kernel,例如 FlashPairformer,再針對單一模型處理 cache、dead branch 或 layout。
- 將最佳化放進獨立 kit,明確標示 off、exact、fast 或 big mode。
- 以模型原本的 downstream task、介面接受率、輸出差異與顯存需求做驗證。
- 將 upstream version、權重 digest、環境、設定與變更理由一起留下,讓下一次執行仍能知道自己跑的是哪個版本。
Anthropic 表示 Claude 由兩位熟悉 biomolecular modeling、但沒有 kernel engineering 經驗的技術人員監督;也表示每個加速版本都檢查了 downstream task performance。這些是作者描述的流程與結果,不是外部審查結論。工程上最值得借鑑的分工是:Agent 可以提出與實作最佳化,但驗收條件、baseline 與 promotion gate 不應由 Agent 自己改寫。
為什麼 triangle operations 會成為瓶頸
蛋白質結構模型需要處理 token 之間的幾何關係。Anthropic 指出,AlphaFold3、OpenFold3、Boltz-2 等模型的結構預測路徑,很多時間與記憶體花在 triangle attention 和 triangle multiplication;這些運算的成本會隨系統大小以立方量級成長。輸入長度加倍,不只是多一倍工作,而可能同時放大中間張量與 memory pressure。
這讓優化問題不只是「把一個 Python function 寫快」:
- GPU kernel 要降低 memory movement 與不必要的 materialization;
- model path 要避免重算,可以 cache 的結果要和 seed、shape、device 一起對齊;
- fast mode 的數值誤差要對 downstream metric 可接受;
- big mode 可能改變分塊、multi-GPU 或 host memory 的路徑,不能只看 kernel throughput;
- exact mode 如果宣稱輸出一致,就必須有與 stock 對照的測試,而不是只看平均分數。
FlashPairformer:可重用 kernel 加上 model-specific patch
Anthropic 與 Claude 開發 FlashPairformer,用 custom kernels 加速 Pairformer 架構裡的 triangle attention 與 triangle multiplication。官方報告相對於 field standard 的平均結果是:triangle attention 約 2.7–2.9 倍,triangle multiplication 約 1.7–3.2 倍,實際倍率取決於 pair width 與模型設定。
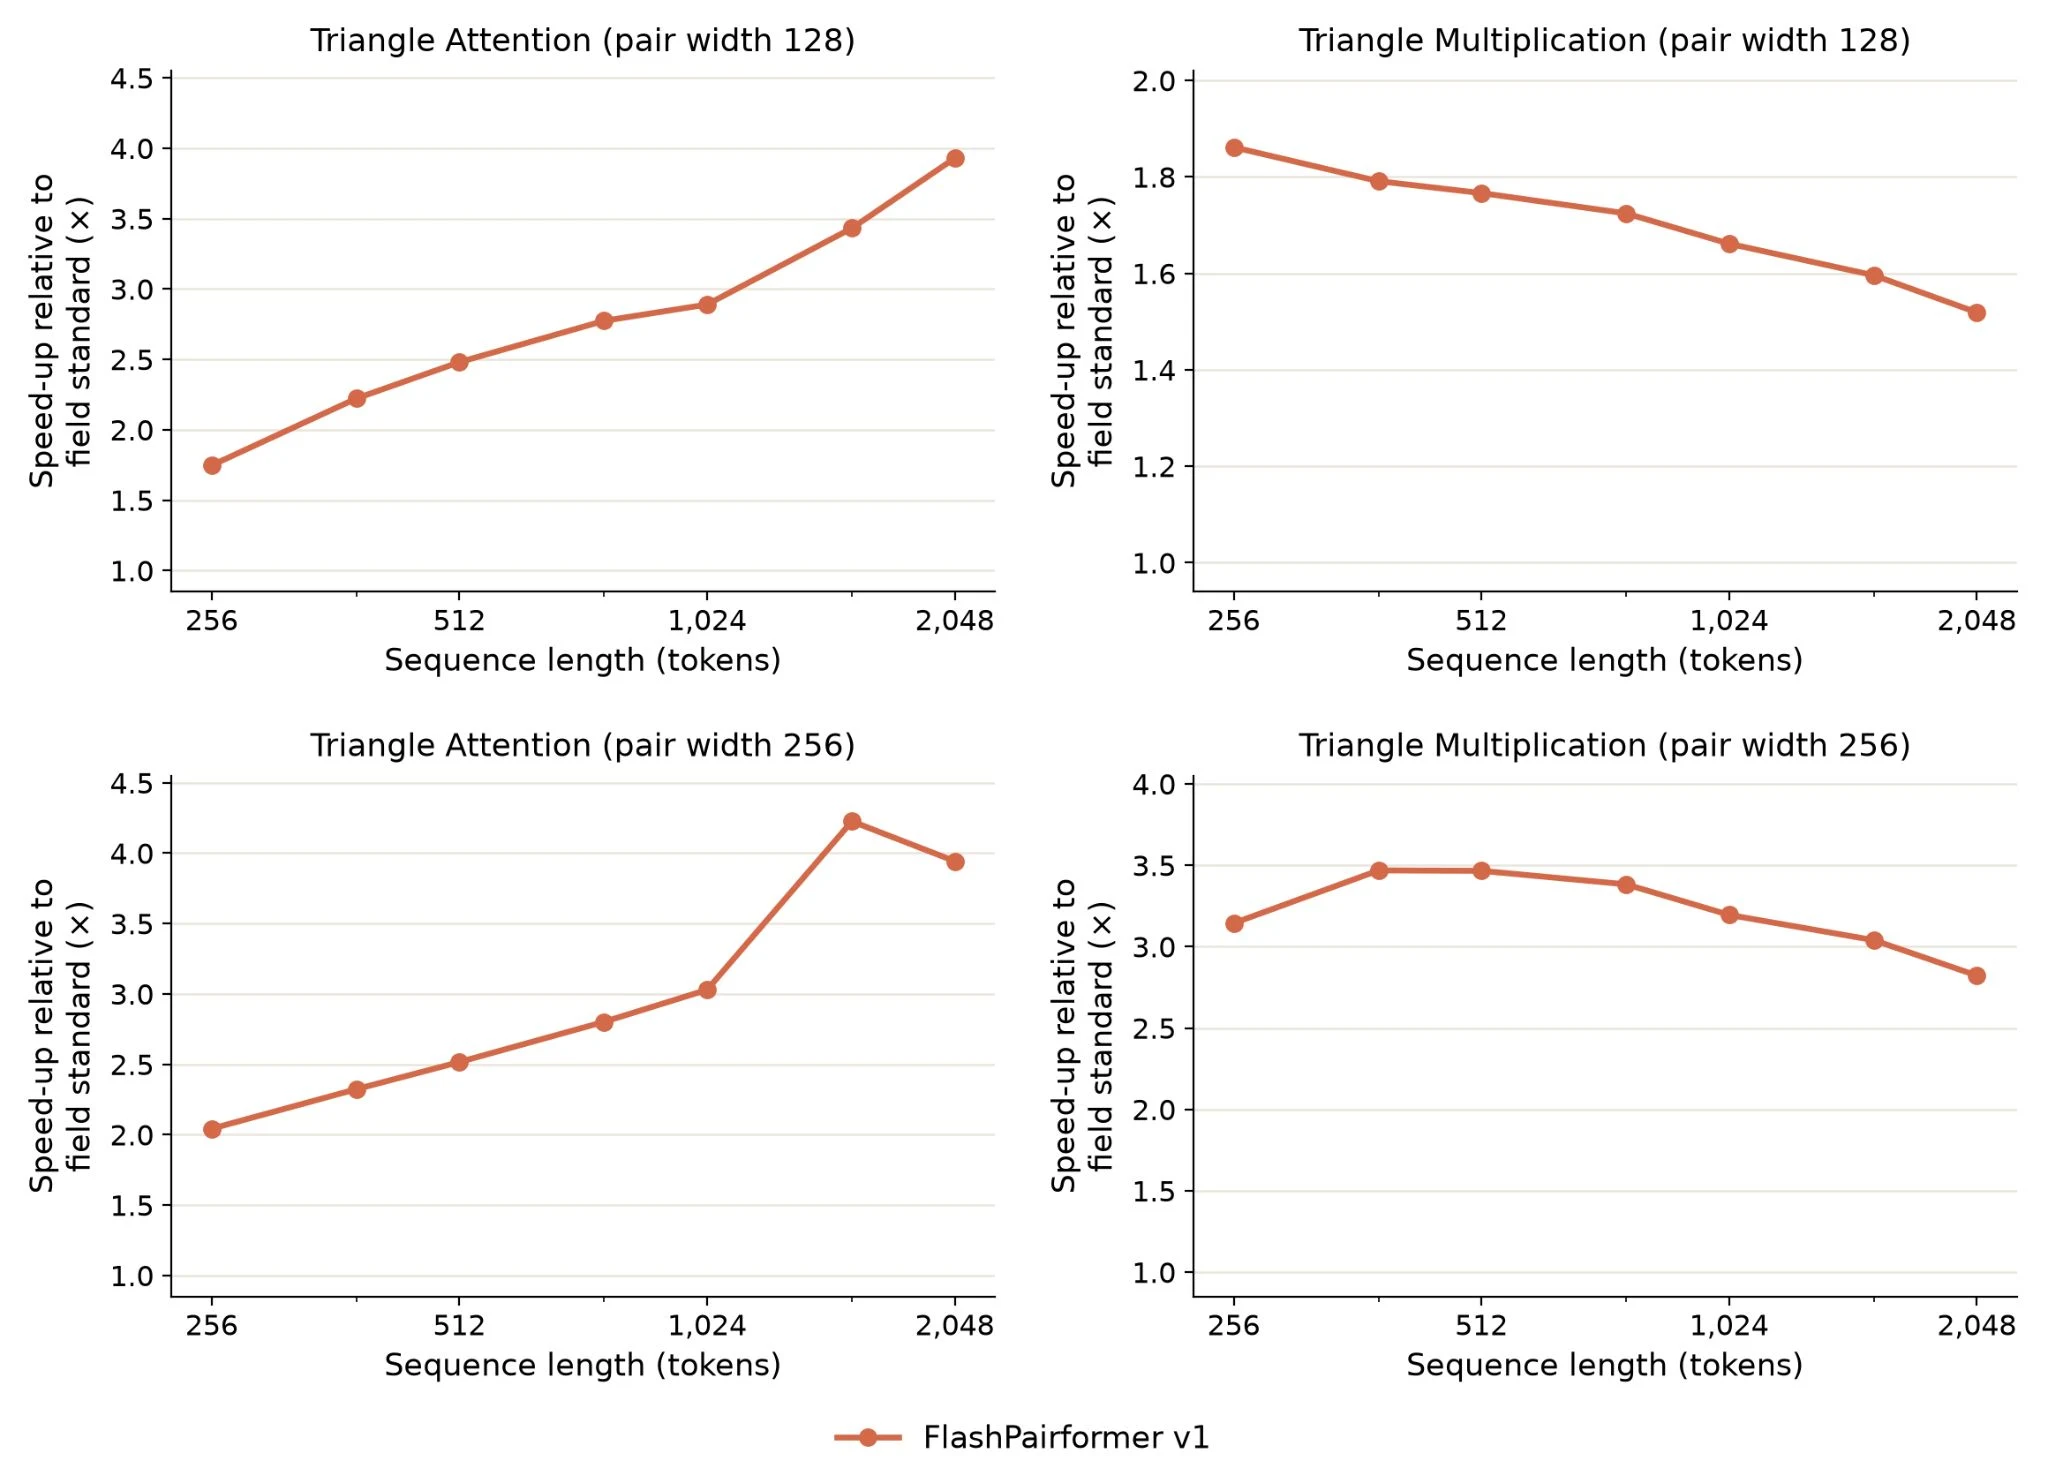
圖:Anthropic 官方 FlashPairformer benchmark,顯示 triangle attention 與 triangle multiplication 相對於 field standard 的 speed-up。來源:How Claude is uplifting biomolecular modeling。
這張圖值得注意的不是最高點,而是曲線並不平坦。不同 sequence length、pair width 與 kernel path 會改變收益;把某一組 configuration 的 3.9x 寫成「所有 inference 都 3.9x」會誤導讀者。Production benchmark 至少要固定:
| 變因 | 為什麼不能省略 |
|---|---|
| sequence length 與 pair width | 決定中間張量大小與 kernel 是否吃得到平行度 |
| GPU、driver、CUDA 與 kernel backend | memory bandwidth、編譯與 dispatch 成本會改變結果 |
| mode 與 precision | exact、fast、big 可能走不同路徑,也可能有不同數值誤差 |
| downstream metric | kernel benchmark 快,不代表結構品質、interface score 或設計成功率不變 |
FlashPairformer 只是可重用層。官方文章也描述了模型個別的優化,例如 caching redundant work、把 dead branches 簡化成 constant outputs。這表示真正的收益來自兩段:一段是可以跨模型移植的 kernel,另一段是需要讀懂每個模型 execution graph 的局部修改。
36 個 kits 的價值:不是包裝,而是 rollback contract
Anthropic 公開的 uplifting-biomolecular-modeling repository 目前包含 36 個 inference optimization kits。每個 kit 旁邊保留 pinned upstream release,並用自己的 opt、environment、configs、run scripts、STOCK.md 與 CHANGES.md 描述如何安裝與啟用。
它把執行模式拆成四種:
| Mode | 設計意義 | 應該回答的問題 |
|---|---|---|
| off | 完整回到 pinned stock release | 原始版本在同一輸入與環境下做了什麼? |
| exact | 盡量維持與 off 相同輸出,但加速 | 加速是否保持 output equivalence? |
| fast | 接受文件化、通常落在 seed-to-seed variation 內的小數值差異 | 速度收益是否值得這個誤差預算? |
| big | 以更低 peak GPU memory 執行較大輸入,部分 kit 可拆到同一 host 的多張 GPU | capacity frontier 擴大後,結果仍是否可信? |
更重要的是,README 明確寫出:某個 mode 在機器上無法啟用時,kit 會印出 NOT ACTIVE 並退出,不會悄悄退回 stock。這種 fail-closed 行為比「自動 fallback 所以比較穩」更適合研究與 production debugging,因為 operator 會知道自己到底跑了哪條路徑。
速度之外:Big mode 改變了可嘗試的問題尺寸
一般加速容易被誤讀成「同一個工作做得更快」。Big mode 的重點不同:它把部分原本因顯存而無法執行的結構預測帶到可嘗試的範圍。Anthropic 展示了 human mitochondrial complex I、TRiC chaperone complex、proteasome 與 bacterial ribosome 等超過 10,000 tokens 的系統,並表示這些在單一 NVIDIA GPU node 上成功完成預測。
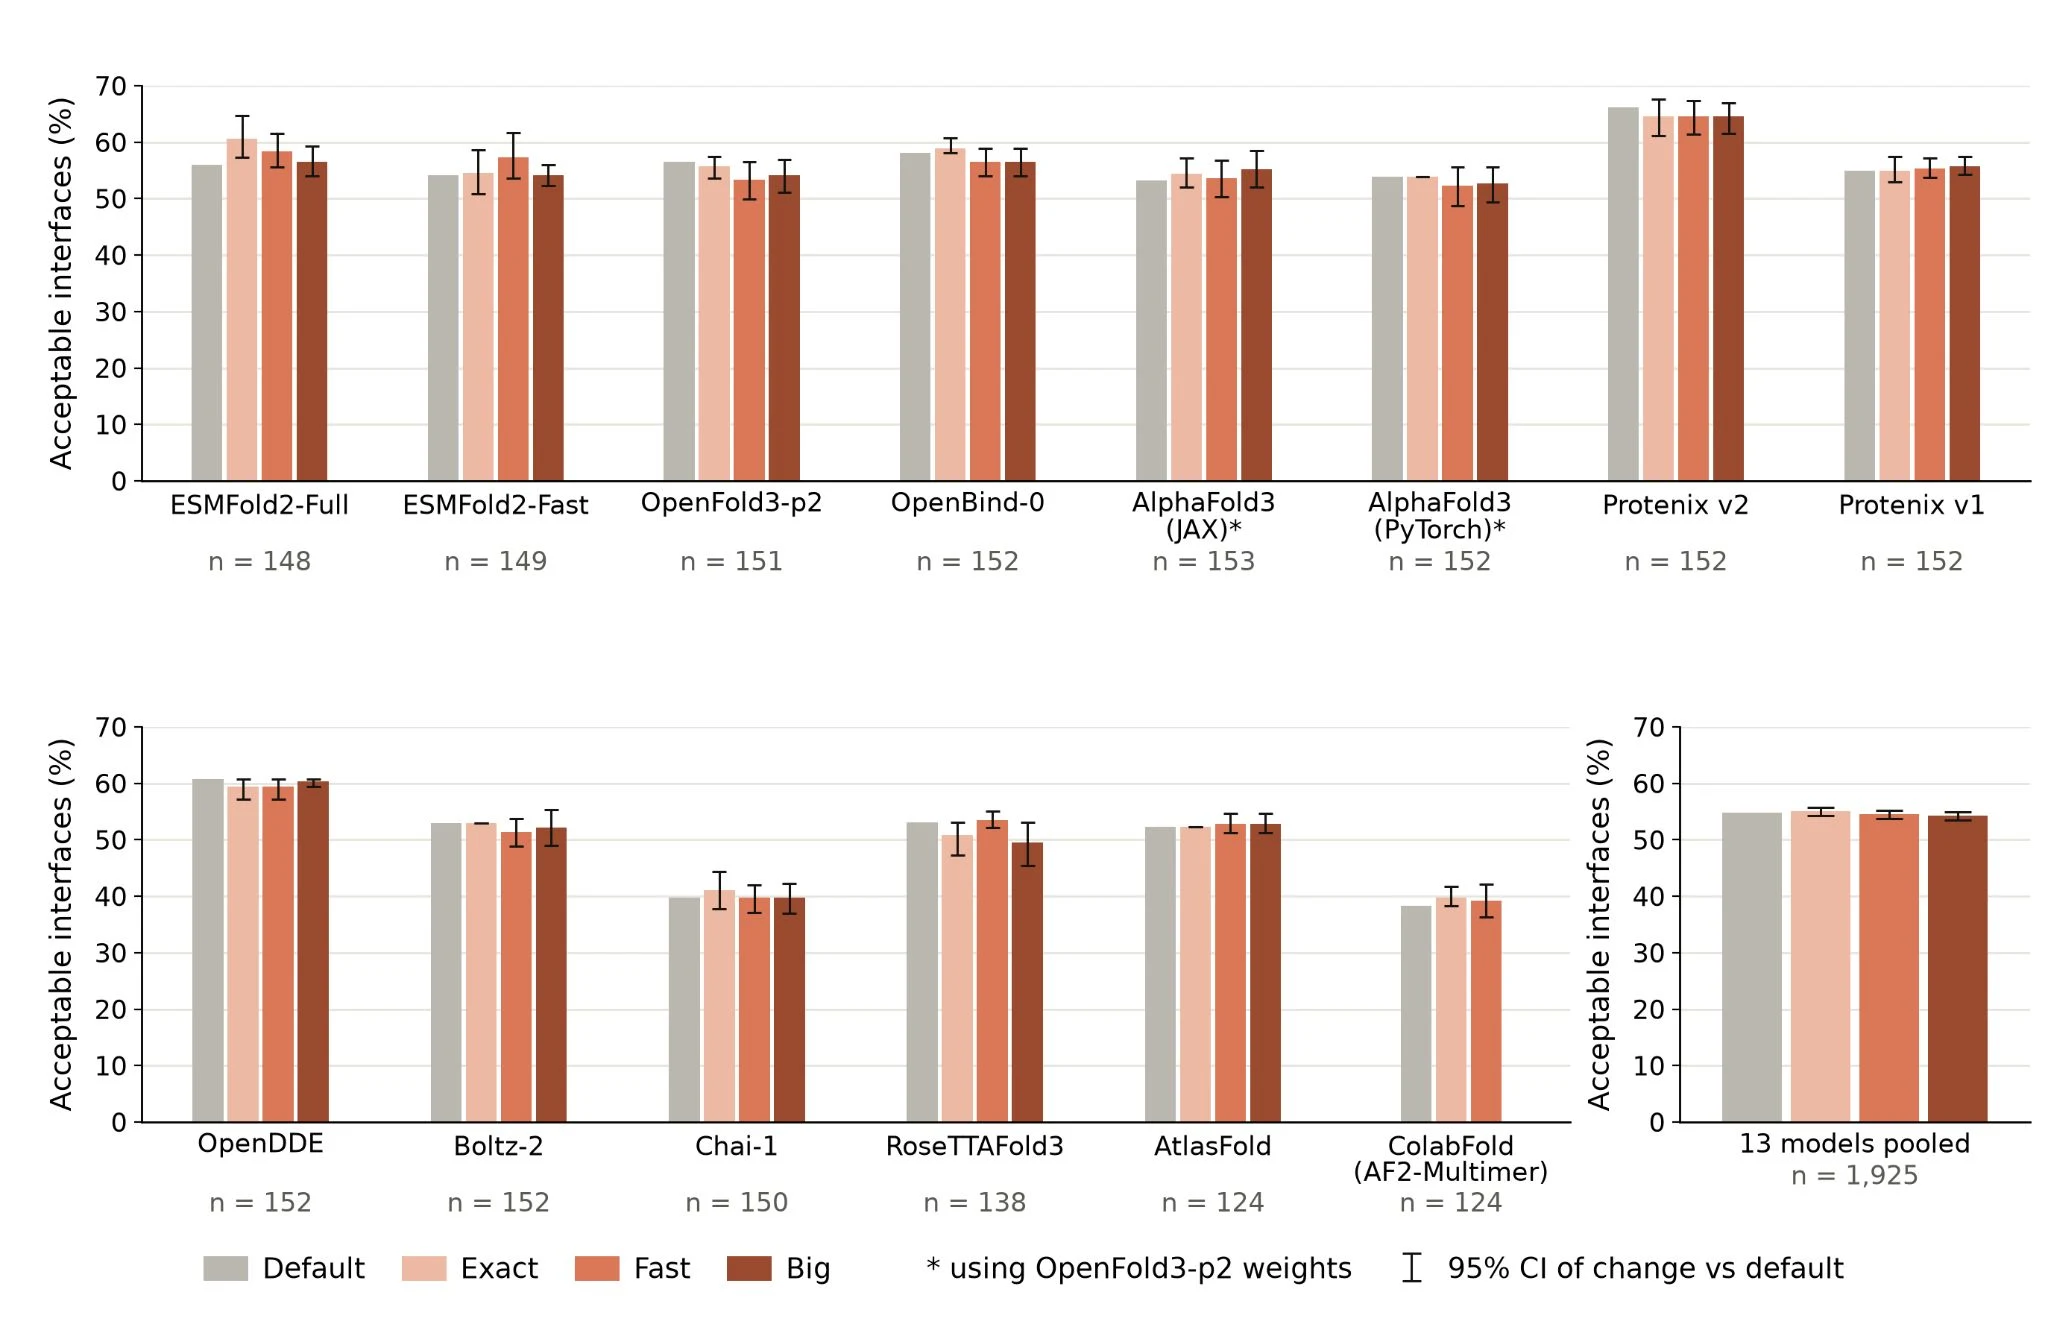
圖:Anthropic 官方圖表,展示超過 10,000 tokens 的已成功案例,以及更大 capability runs 的尺寸邊界。來源:How Claude is uplifting biomolecular modeling。
但這裡必須把「可執行」和「正確」分開。官方文章另提到,31,000 到 70,000 tokens 的 capability runs 可以在單一 8-GPU B300 node 上產生結果,但這些超出訓練 context 很多的結構並不一定正確;文章甚至直接說 predicted structures collapse。這是一個很好的 evidence boundary:
- Big mode 證明的是 memory barrier 被降低;
- 特定 10,000+ token complexes 有成功且接近實驗結構的案例;
- 更大的 capability run 主要是在探測可執行邊界,不應被當成 accuracy benchmark;
- 正式採用仍需 domain-specific validation、外部結構對照與 wet-lab confirmation。
如果平台只記錄「job completed」,就會把 capacity expansion 誤當成 scientific validity。至少要把 mode、token count、GPU topology、recycles、reference structure、quality metric 與 confidence 一起留在 provenance record。
成本結果很有吸引力,但它是 in-silico evidence
這篇文章的另一個亮點,是把 inference optimization 接到蛋白設計的資源曲線。Anthropic 回顧先前 campaign:每個 target 最多可花 USD 10,000,約等於 2,500 張 H100 GPU hours。新的實驗讓單一 Claude model 使用一張 H200、24 小時、約 1,100 字 prompt、不使用 sub-agents,也沒有人工 steering;三個 Claude models 在 16 個 targets 上執行。
官方表示,新流程在 median 與 highest-scoring designs 的 ipSAE 上,平均接近先前 Mythos 5.1 campaign,同時 GPU hours 少了約兩個數量級;GPU 與 token 合計成本約 USD 150。這個結果很值得看,但必須保留三個限定:
- ipSAE 是 in-silico binding score,不是已經在 wet lab 證明的 binding result。
- 這是 16 targets、特定 model、特定 hardware 與特定 tool stack 的研究實驗,不是通用成本保證。
- 新的 protein design competition 承諾超過 5,000 個 designs 的 wet-lab validation,那是後續驗證計畫,不應和目前的計算結果混寫。
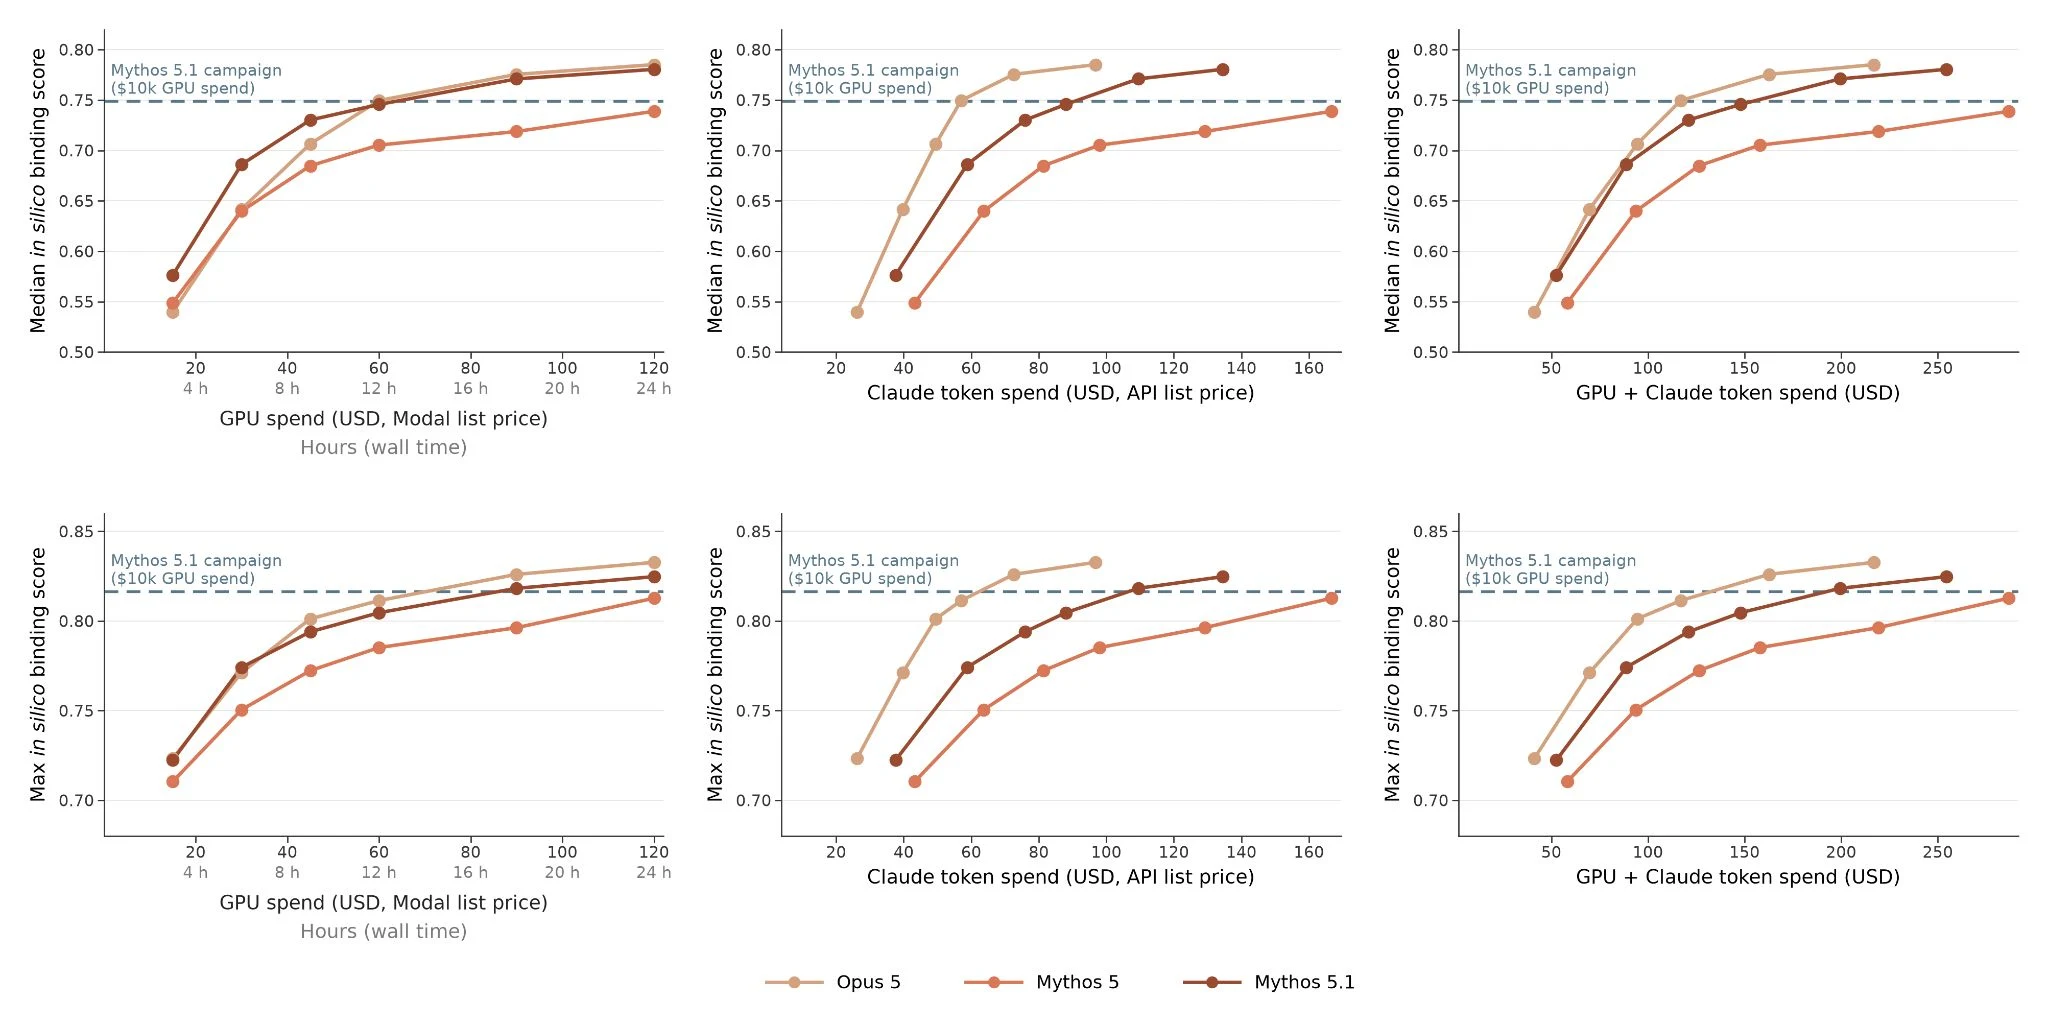
圖:Anthropic 官方 cost/score frontier,將 GPU spend、Claude token spend 與兩者合計放在不同軸上。來源:How Claude is uplifting biomolecular modeling。
成本曲線對工程團隊的啟示,不是「所有模型都應該由 Agent 重寫」,而是要把研究 budget 拆成可比較的單位:GPU hours、token spend、human review、rerun、failed experiment,以及最後通過外部驗證的 designs。只記 API cost,會漏掉 kernel review 與科學驗證的成本。
這個 repository 還沒有證明什麼
公開 code 是很好的 evidence,卻不等於 independent validation。採用這批 kits 前,我會把限制寫在文章與 runbook 的同一頁:
- repository 明確稱自己是 reference release、not maintained、not accepting contributions;
- 原始 code 使用 Apache-2.0,但每個 stock upstream project 仍有自己的 license;
- 部分 kit 以 interpreter hook、sitecustomize、editable install 或 upstream code execution 改變 process 行為;
- 需要釘住 GPU、driver、CUDA、Python、dependency lock、weights digest 與 cache root;
- Anthropic 的 speedup、precision、Big mode 與 protein-design 數字都是作者自己的測量,尚未看到獨立團隊在不同 hardware 上重跑;
- fast mode 的「小幅數值差異」仍需由每一個 downstream scientific metric 定義可接受範圍;
- protein design 的 ipSAE 不能替代 wet-lab validation。
這些限制不會讓成果失去價值,反而讓文章的工程結論更清楚:這是一個值得研究的 acceleration reference release,不是可以直接複製到 production 的安全或科學正確性證書。
如果要把 AI-assisted optimization 帶進團隊
我會先把採用流程做成五個 gate:
- Baseline gate:保存 upstream commit、權重 digest、輸入樣本、hardware 與 stock output。
- Equivalence gate:對 exact/fast 分別定義 byte-level、numerical、task-level 哪一種相等;不要只看 aggregate score。
- Capacity gate:big mode 要額外檢查 OOM、multi-GPU topology、recycle 次數、quality metric 與失敗輸出。
- Supply-chain gate:審查每個 stock、opt、editable install、interpreter hook、下載腳本與 cache,並記錄 licenses。
- Promotion gate:只有通過 held-out inputs、downstream metric、rollback smoke test 與人工 review,才能把 mode 從實驗升成預設。
這套 gate 也能套回一般 LLM inference optimization。模型換成語言模型,核對的可能是 logits、sampling distribution、tool-call schema、長上下文品質與服務延遲;但「stock、exact、fast、big、provenance、rollback」這組 vocabulary 仍然有用。
對 Bloss0m 讀者的下一步
如果你正在設計 Agent runtime,可以先讀 AI Agent 完整架構指南,理解 execution envelope、工具權限與 failure recovery;若團隊需要把成本放進模型選擇,可以接著看 LLM 推論成本怎麼算。硬體整合與驅動介面的邊界,則可對照 Model Hardware Standard;想看同一套 Agent 工作流如何把規劃、執行與審查拆開,則可讀 Gemini 3.8 Flash 開發心得。
這篇 Anthropic 案例最後留下的問題不是「Claude 能不能做 research」,而是:當 Agent 產生一個加速版本時,我們是否有足夠的 baseline、等價定義、科學驗證與 rollback,知道它究竟改變了什麼?
來源與延伸閱讀
- How Claude is uplifting biomolecular modeling — Anthropic 官方研究文章,包含 30 多個模型的最佳化結果、FlashPairformer、Big mode 與 protein-design 實驗。
- Uplifting biomolecular modeling repository — 36 個 inference kits、pinned stock、mode semantics、環境與安全說明。
- Technical report — 官方技術報告;本文將其視為作者提供的第一方證據,不等同獨立重現。
- NVIDIA cuEquivariance 與 BioNeMo Inference Runtime — 官方文章提到的相關 kernel/inference 工具脈絡。
延伸閱讀
- AI Engineering AI Agent 論文怎麼讀:從 CoT、WebGPT 到 ReAct 用一張圖說明 CoT、WebGPT 如何匯入 ReAct,再沿工具、記憶、評測與安全等方向延伸,並與論文庫的 agent-systems 閱讀順序對齊。
- AI Engineering AgentEscapeBench 是什麼:評測 Agent 域外工具推理 讀 AgentEscapeBench:Agent 在領域外、長鏈條工具圖上為何會崩,以及這份評測能說明什麼、不能說明什麼。
- AI Engineering Agent 寫程式的 Self-Scaffolding:Ornith 1.0 的訓練與評測邊界 讀 Ornith 1.0 的 self-scaffolding:Agent 寫程式時自己搭鷹架解決什麼、評測能說明什麼、信任邊界在哪。Ornith 是案例,不是搜尋入口。