TypeSafe AI 在 2026 年 9 月發表的 System One Models 與 Jev,提出一個很值得拆開看的方向:模型不一定要先產生一段文字,再讓應用程式解析、驗證、重試,最後才做決策。它可以直接接收一段 state 與幾個 typed questions,回傳程式能使用的選項、分數、機率與信心。
這不只是把 JSON mode 換一個名字。TypeSafe 想改的是 AI 和軟體之間的介面:從「模型寫一段人類可以讀的回答」變成「模型提供一組可組合的判斷 primitive」。第一個公開模型 Jev 目前以 early access 形式提供,官方宣稱它在 System One 任務上能以比一般 LLM 更低的延遲與成本完成結構化判斷;但這些速度、價格與準確度數字主要仍是 TypeSafe 自己的測量。
本文把產品主張拆成可檢查的工程契約,說明它和 structured outputs 的差別、workflow evals 怎麼量、哪些地方真的有價值,以及哪些地方還不能直接下結論。
它真正想改變的是 AI 的 interface
TypeSafe 將 Jev 稱為第一個 System One model,並把它和以聊天為中心的 LLM 分開。官方的對照可以整理成四個工程差異:
| 面向 | 一般聊天型 LLM | System One + Jev |
|---|---|---|
| 最終輸出 | 字串;應用程式再解析成 JSON、函式呼叫或欄位 | 預先定義的 typed values 與機率分布 |
| 取樣方式 | 逐 token 產生,後一個 token 依賴前一個 token | 官方描述為 parallel sampler,在同一次 query 中平行回答問題 |
| 訓練方向 | RLHF 或 RLVR,偏向人類偏好或可驗證輸出 | RLCD,偏向帶有校準機率的決策 |
| 軟體責任 | parser、schema validator、retry 與 policy 都要補在模型外 | schema 先定義,模型回答後由程式碼組合、分支與升級 |
這個分類不代表一般 LLM 無法做 typed output。現代模型可以用 function calling、JSON Schema 或 structured output 產生合規格式;差別在於 TypeSafe 把「要問什麼型別的問題」設成 API 的第一級 primitive,並將每題的 probability 與 confidence 一起放入回應。
Jev 的輸入輸出契約
官方文件的最小抽象是:給模型一個 state,再給一組 atomic questions。三種內建問題型別如下:
| Primitive | 它問什麼 | 程式得到什麼 |
|---|---|---|
| Choice | 從預先列出的選項中選一個,例如 billing、technical 或 other | choice、各選項 probability、confidence |
| Score | 依一個離散 rubric 評分,例如 can wait、this week、today | score、各級距 probability、confidence |
| Noul | 判斷某個命題是否成立 | 0 到 1 的 noul 值 |
TypeSafe 文件指出,三種問題可以在同一次 API call 混用;每個問題會針對相同的 state 平行且獨立評估。這個設計讓增加幾個判斷維度不必把所有內容塞進一個越來越長的 prompt,也能避免一個問題的推理過程污染其他問題的 context。
更重要的是,問題要夠 atomic。不要直接問「這張客服工單應該怎麼處理?」而是拆成:
- 這是不是 billing 問題?
- 客戶語氣是 calm、frustrated 還是 angry?
- 優先級是 can wait、this week 還是 today?
- 是否需要人工審查?
最後的動作由你的程式碼組合。這代表產品團隊要調整政策時,可能只需改變權重、閾值或 branch,而不是重寫一個含有所有業務規則的巨大 prompt。
從問題到 workflow:模型只負責判斷,程式掌握政策
TypeSafe 官方建議的 workflow 可以拆成五層:
- State envelope:把事件、文件、歷史紀錄與相關上下文整理成模型可讀的 state。
- Typed questions:把每個判斷拆成 Choice、Score 或 Noul,並固定選項與 rubric。
- Parallel evaluation:讓 Jev 同時回答彼此獨立的問題。
- Policy composition:由程式碼根據 probability、confidence 與業務規則決定 close、queue、act 或 escalate。
- Review boundary:低信心、衝突或高風險結果轉人工,而不是把所有決策都自動化。
官方 workflow evals 用安全事件、agent trace observability、發票處理與客服四個例子說明這個模式。以安全事件為例,模型不是直接生成一段處置報告,而是分別判斷是否為未授權行為、證據強度、事件狀態與應採取的動作,最後由程式碼將判斷組成關閉、通知、隔離或升級。
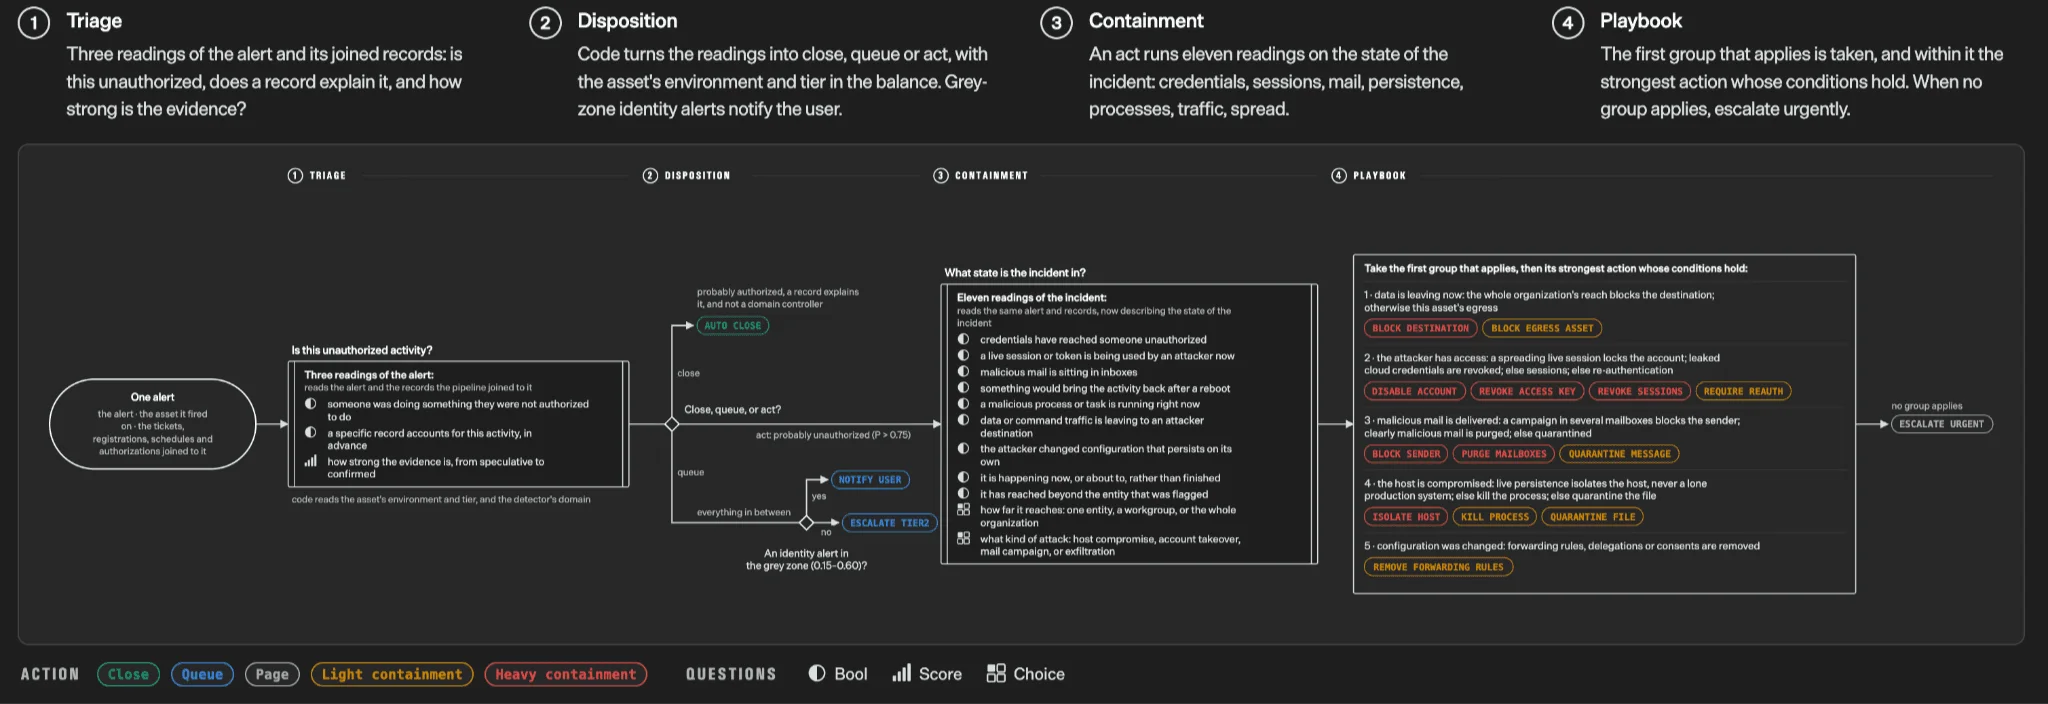
圖:TypeSafe 官方 workflow evals 的安全事件範例,顯示窄問題、程式分支與動作 playbook 如何連成一條路徑。來源:Workflow evals。
這種架構對 agent 特別有用。Agent 不必把每個工具呼叫都交給一個會寫長文的模型;可以讓模型判斷「要不要升級」、「哪一個工具適用」、「證據是否足夠」,再由 runtime 控制工具權限、交易與人工介入。
193.6 倍更快、444.6 倍更便宜:先看 measurement contract
TypeSafe 首頁目前展示 193.6x faster 與 444.6x cheaper。這些不是通用模型 benchmark,而是官方 workflow tasks 上的比較。TypeSafe 的 evals 頁面說明,圖表是四個 workflow 的平均值,每個 model configuration 以相同工作流比較 accuracy、cost 與 time;同一個工作流也會拿來和把邏輯全塞進 prompt 的版本對照。
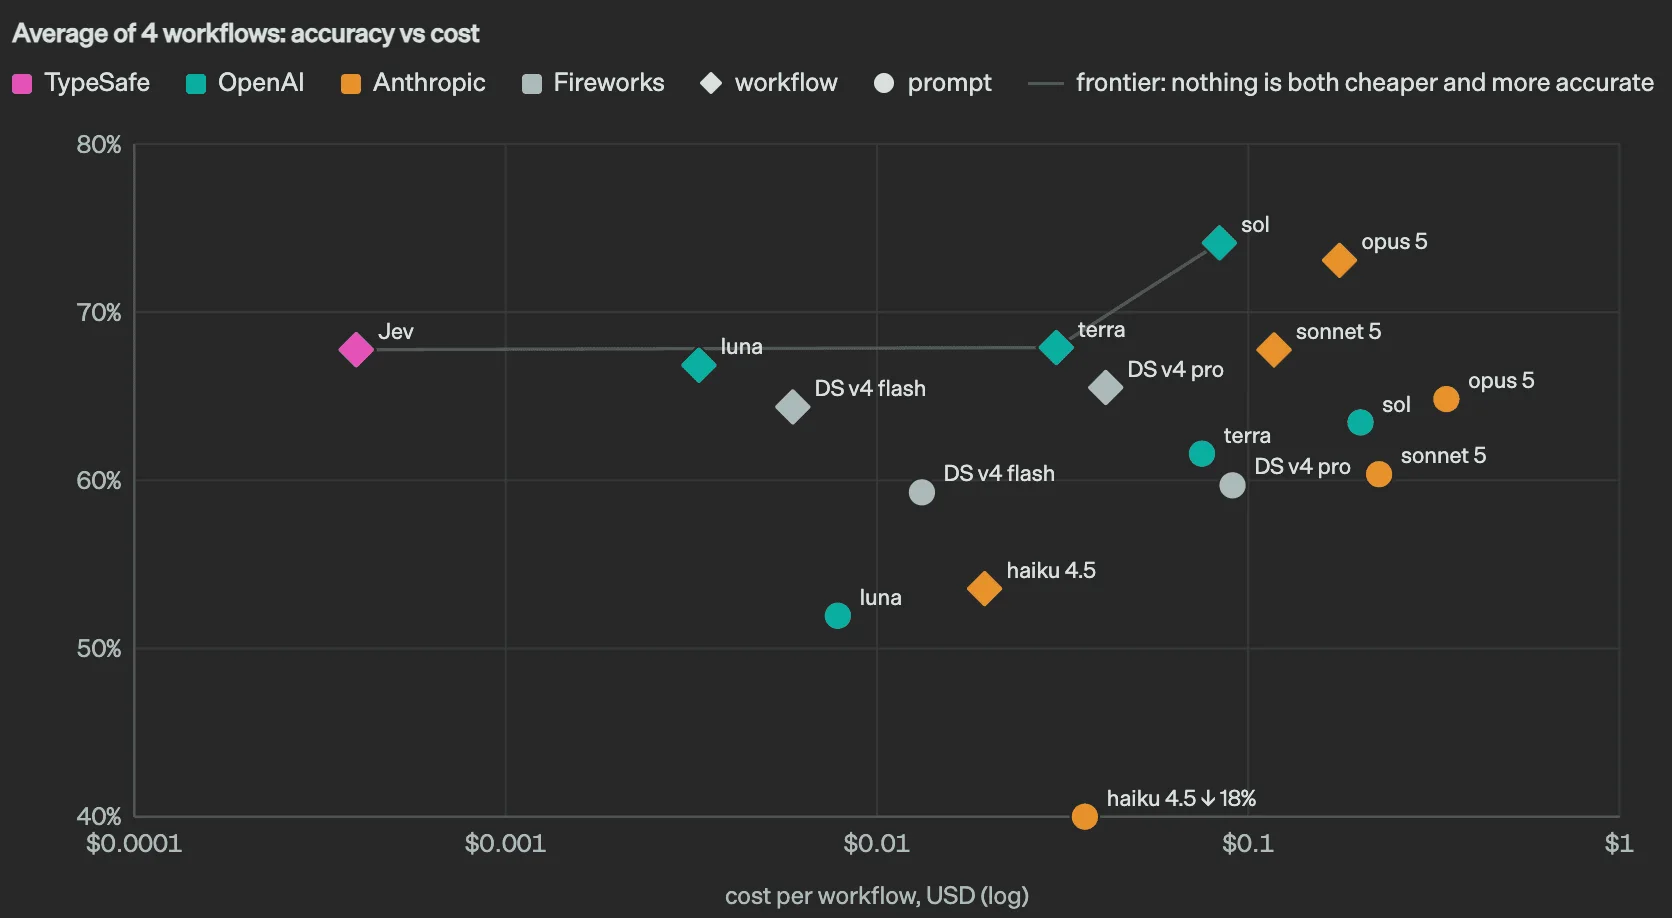
圖:TypeSafe 官方 evals 的 accuracy-versus-cost 圖;Jev 位於較低成本的一端。它是 TypeSafe 的 workflow、模型設定與 reference-label 定義下的結果,不是獨立實驗室的重現。來源:Workflow evals。
這個評估方向本身很合理,因為真實產品的成本不只取決於模型一次回答的 token 數,還取決於:
- 是否需要先產生文字再 parse;
- schema 錯誤時要重試幾次;
- 一次 workflow 要問幾個窄問題;
- 低信心結果有多少會轉人工;
- 每個模型配置在同一策略下能完成多少步。
但必須保留三個證據限制:
- workflow 與 harness 是 TypeSafe 團隊建置的,官方也承認它們由 model capabilities team 製作,可能有選擇偏差。
- reference labels 來自大型外部模型的平均,例如 GPT-6 Astra 與 Claude Fable 5.1;這有助於建立一致的參考,但也會讓比較偏向這些模型的行為。
- Jev 的數字來自特定問題、硬體、服務狀態與設定;不能直接外推成所有開放式任務都能有同樣倍率。
因此,正確的讀法不是「Jev 比所有 LLM 快 193.6 倍」,而是「在 TypeSafe 設計的 workflow 裡,typed decision primitive 可能比把整個政策寫進 prompt 更適合做低成本、自動化判斷」。
RLCD 與 parallel sampler:公開資料目前能說到哪裡
TypeSafe 將自己的訓練方式稱為 Reinforcement Learning for Calibrated Decisions,簡稱 RLCD。官方描述它和 RLHF、RLVR 的差異,在於目標不是偏好一段回答或驗證一個字串,而是讓決策的機率更接近 epistemically honest 的信心。
官方同時提到新的 model architecture 與 parallel sampler,並說明 Jev 一次可以回答多個問題。這足以支持一個工程推論:當輸出是固定型別的判斷,而不是任意長度的文字,模型可以在輸出空間、取樣策略與硬體利用率上做更專門化的設計。
但目前公開的產品資料沒有提供完整模型架構、訓練資料、RLCD 的數學定義、權重或可獨立重跑的 training recipe。本文因此把 RLCD 視為 TypeSafe 的方法主張,而不是已被外部研究證明的通用新訓練範式。
「沒有 hallucination」只在 type boundary 成立
TypeSafe 很強的產品訊息是:Jev 不產生字串,因此不會生成無法解析的文字或幻覺式 tool call。官方頁面也用 structured output error rate 與 tool call error rate 的 0% 顯示它和其他模型的差異。
但官方文章的細節已經提供重要 nuance:TypeSafe 的 0% 是因為 schema matching 被保證,屬於 type-level property,不是透過大量未知資料測出的「語意永遠正確」。相對模型的圖表資料則來自 OpenRouter,可能受到複雜問題被路由到不同模型的影響。
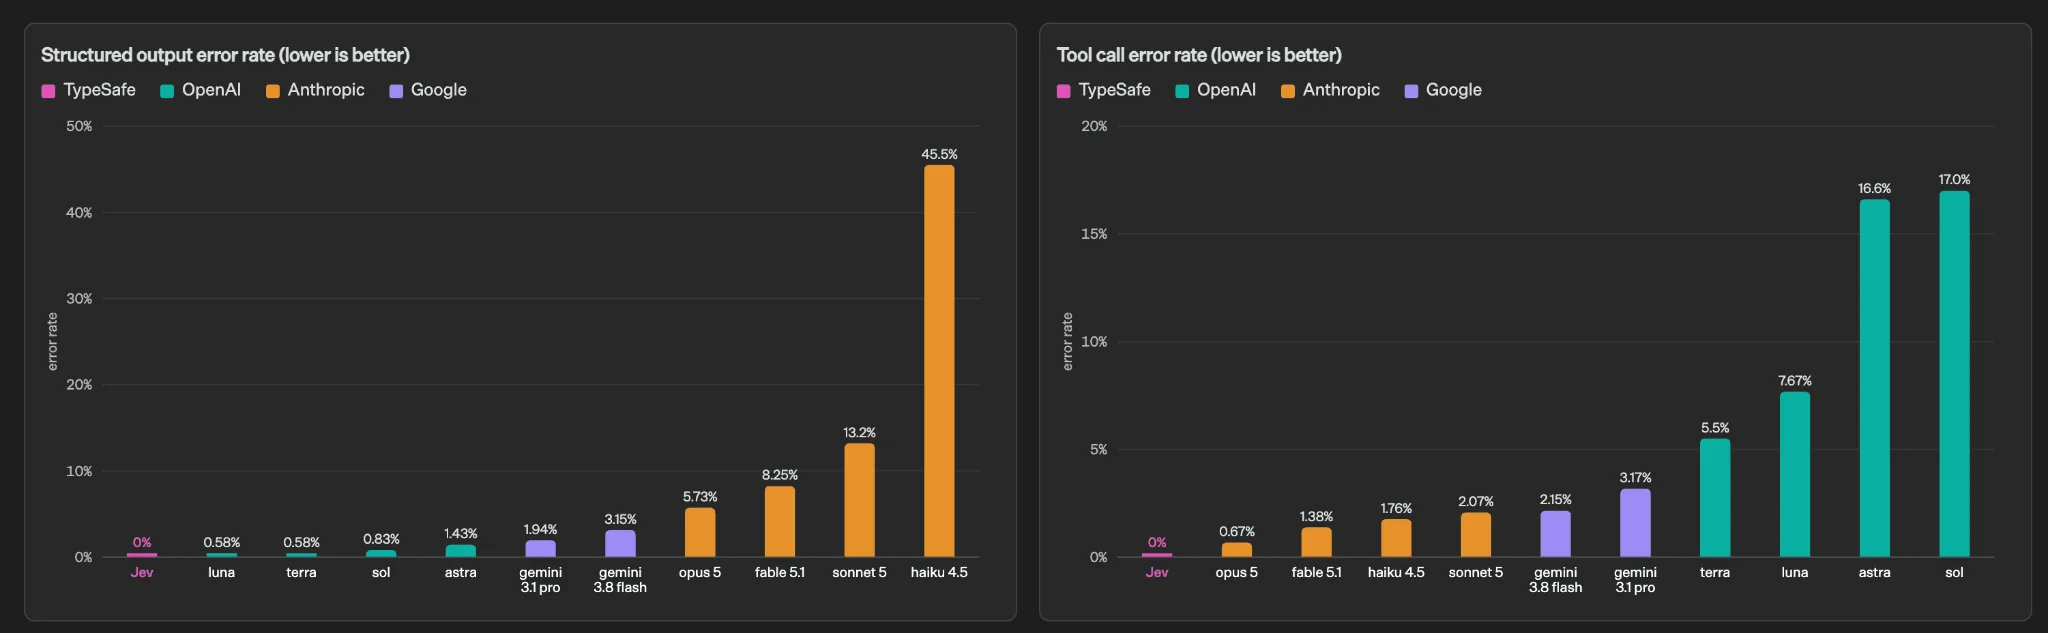
圖:TypeSafe 官方比較圖。Jev 的 0% 主要代表輸出符合已定義 schema;它不能單獨證明選擇、分數或信心都沒有語意錯誤。來源:Introducing System One Models & Jev。
這裡要把三種錯誤分開:
- Type error:回傳內容無法符合 Choice、Score 或 Noul 的 schema。TypeSafe 針對這一層做了強約束。
- Decision error:模型選錯部門、誤判發票或錯誤關閉安全事件。typed output 仍可能是錯的選項。
- Calibration error:模型很有信心,但信心沒有與實際正確率對齊。這是 production 需要持續量測的問題。
所以「不會 hallucinate」不能被轉譯成「不會犯錯」。比較準確的工程描述是:它把最難防守的自由文字與 schema 解析錯誤移出介面,讓團隊能把注意力集中在判斷品質、校準與 policy。
SDK 讓它比較像 API primitive,而不是聊天產品
TypeSafe 已公開 JavaScript/TypeScript 與 Python SDK。官方 JavaScript SDK 需要 Node.js 20 或更新版本,Python SDK 支援同步與非同步 client;兩者都把 state 與 questions 作為 System One API 的核心輸入。
從整合角度,產品團隊應把使用方式理解成一個小型決策函式:
- state 是這次判斷的完整上下文,而不是一串聊天訊息;
- questions 是穩定且可測試的 decision schema;
- response 包含 typed answer、probability、confidence 與可供程式使用的欄位;
- policy 留在自己的程式碼,負責權限、交易、人工升級與副作用。
這種分工也讓 provider comparison 更清楚。TypeSafe 的 System One Adapter 提供由 OpenAI 或 Anthropic 等 LLM API 驅動的 drop-in replacement,可以比較 structured output、prompted JSON、probability/discrete answer mode、retry 與 latency。它不會替你證明 Jev 勝出,但能幫你把同一組 questions、同一個 state 與同一條 policy 放進可重播的比較。
目前 Jev 對單次選擇的 cardinality 有限制;TypeSafe 官方文章提到超過 255 個選項時會用兩階段 scoring 再做 explicit choice,可能因此出現額外延遲。高基數分類、長文件與需要開放式解釋的工作,不應只因 API 回傳 typed values 就直接視為適合。
成本優勢的另一面:你買的是 workflow discipline
TypeSafe 官方文章列出每百萬 input tokens 約 USD 0.042、output tokens 目前不另外計費;首頁則用每十億 input tokens USD 42 的方式呈現。這個價格對高頻 routing、客服分流、agent trace triage 或批次審核很有吸引力。
但低 token 價格不會自動產生低總成本。團隊還需要計算:
- 建立與維護 workflow harness 的工程時間;
- 問題拆解後增加的 API call 或資料準備成本;
- 低信心結果送人工的 queue 成本;
- schema 與 policy 變更時的回歸測試;
- 高風險錯誤、誤拒絕與漏放行的業務代價。
換句話說,TypeSafe 的經濟價值不只是「每 token 便宜」,而是它鼓勵團隊把一個模糊的 prompt 轉成可測量的 decision graph。若產品沒有足夠穩定的規則、資料與 review boundary,便宜的推論也可能只是更快地執行錯誤政策。
哪些任務適合,哪些不適合
我會優先把 Jev 類模型放在輸出空間清楚、錯誤代價可定義、而且決策可以拆成多個窄問題的地方:
- support ticket routing 與 escalation;
- agent trace 的風險分級與人工抽查;
- invoice 或 expense claim 的分類、缺件判斷與送審;
- security alert 的 triage、containment recommendation;
- workflow 中的工具選擇、權限前置檢查與下一步 routing。
相反地,以下任務不應只因「需要 JSON」就換成 Jev:
- 需要寫長篇說明、程式碼或未知結構的生成;
- 問題邊界尚未穩定,選項會頻繁變動;
- 結果需要引用新資訊而不是只判斷 state;
- 需要跨多步自由探索、提出新假設或與人協商;
- 沒有資料可以檢查 confidence 是否真的校準。
最實際的架構通常不是 Jev 取代 LLM,而是混合:Jev 負責高頻、低延遲、需要可控分支的判斷;一般 LLM 負責解釋、摘要、開放式規劃與例外處理;程式碼負責不可委派的 policy 與副作用。
導入時的五個 gate
若要把這類 typed decision model 放進 production,我會要求:
- Schema gate:先固定 Choice、Score、Noul 的語意、選項、rubric 與版本,避免同一名稱在不同服務代表不同決策。
- Calibration gate:用 held-out data 分桶檢查 confidence 與實際正確率,另外追蹤高信心錯誤。
- Policy gate:把 probability 閾值、人工審查與高風險動作寫在程式碼裡,不讓模型自行決定自己是否可以執行副作用。
- Replay gate:保存 state、question schema、模型版本、回應與 policy decision,讓問題可以重播與審計。
- Fallback gate:為服務不可用、問題超出 cardinality、低信心或 schema 變更準備 LLM、人工或安全預設路徑。
這五個 gate 也能套回一般 structured-output LLM。真正的差異不是哪個 API 的 JSON 比較漂亮,而是你是否把「輸出格式、判斷品質、confidence、分支與 fallback」當成同一個可版本控制的介面。
對 Bloss0m 讀者的下一步
如果你正在設計 agent runtime,可以先讀 AI Agent 完整架構指南,再用 Agentic AI Platform Contract 對照 state、policy、tool 與 review boundary 如何形成平台契約。要把 Jev 與一般 LLM 放進同一張成本表,則可參考 LLM 推論成本怎麼算;若想看更完整的規劃、執行與審查分工,可延伸閱讀 Gemini 3.8 Flash 開發心得。
最後的問題不是「Jev 會不會取代 LLM」,而是:哪些判斷已經足夠穩定,可以被定義成型別、交給機率控制,並由程式碼安全地組合成 workflow?
來源與延伸閱讀
- Introducing System One Models & Jev — TypeSafe 官方發表文章,包含 System One、RLCD、workflow evals、成本與限制說明。
- TypeSafe AI Introduction — 官方文件,定義 Jev 的 state、Choice、Score、Noul 與 atomic questions。
- Workflow evals — 官方評估頁面,展示四種 automation workflow、accuracy、cost、time 與 reference labels。
- JavaScript/TypeScript SDK 與 Python SDK — 官方 SDK 與 quickstart。
- System One Adapter — 用其他 LLM API 模擬同一個 System One 介面,以便比較成本、延遲與輸出行為。
延伸閱讀
- AI Engineering Jev 實戰架構:把 Confidence-Gated Routing 放進 Agent Runtime 不再重述 Jev 的基本介紹,改從 confidence-gated routing、speculative fan-out、composite scoring 與社群實驗,拆解如何把 AI 判斷放在 Agent、工具與人工審查之間。
- AI Engineering Claude 如何把生物分子模型跑得更快:從 FlashPairformer 到可回退的 Inference Kits 拆解 Anthropic 讓 Claude 優化 30 多個生物分子與基因組模型的工程方法,從 FlashPairformer、Big mode、stock/exact/fast 契約,到 GPU 成本與可驗證性邊界。
- AI Engineering Forge v0.18.1:開源多使用者 MCP Auth 與 Agent Governance 拆解 Forge v0.18.1 如何把多使用者 MCP 的身分、OAuth 同意、租戶、政策、出口與逐次稽核串成可檢查的 Agent runtime contract,並標出尚未被獨立驗證的邊界。