專案作者兼 Jev 使用者 Christian Mathiesen,在 2026 年 9 月 25 至 26 日的直播中,讓 TypeSafe AI 的 Jev 決策模型透過他為《Pokémon Red》建置的 harness 完成遊戲:歷時 37 小時 40 分,做出 16,150 次決策。這個結果很容易被簡化成「一個 AI 自己玩完了遊戲」,但 Mathiesen 公開的程式碼呈現的是更有意思的工程問題:當模型每一步都依賴遊戲程式讀出的狀態、算好的選項和路徑時,通關成績究竟測量了哪一部分?
答案不是模型或 harness 二選一。這次紀錄衡量的是一套組合系統:Jev 在程式提供的選項中判斷要做什麼,遊戲專用程式負責把環境轉成可決策狀態、計算移動方式,並檢查目標是否真的完成。這種分工值得研究,但不能把整套系統的成果直接當成模型單獨具備的能力。
先分清楚兩場 Jev 通關
網路上有兩場相近時間、都使用 Jev 的《Pokémon Red》通關,不能把它們當成同一個實驗。Andrew Boyd 的頁面記錄 Jev 在 9 月 23 日進入名人堂,並說明由 Opus 5 監看遊戲紀錄、即時建置 harness。另一場是 Christian Mathiesen 使用 Jev、透過自己公開的遊戲專案,在 9 月 25 至 26 日直播的 run;本文討論的是這場,因為它附有公開的 GitHub 專案與詳細 README。Boyd 的專案頁和 Tom’s Hardware 的同期報導也把兩場 run 分開描述。
Mathiesen 的 README 把 Jev 說成負責選動作的 decision model,並列出 37 小時 40 分、16,150 次決策、約 3,920 萬個 input tokens、約 US$1.65 的 Jev 費用、16 次團隊全滅,以及 15 次四天王挑戰。專案頁重複列出部分統計。這些是 Mathiesen 回報的 run 數據,兩個頁面都不是獨立驗證;本文沒有重新執行這場 run,也沒有把另一場的 Opus 協助或統計挪過來。README · 專案頁
Jev 做的是選擇,程式先把遊戲整理成選項
TypeSafe 的官方文件把 Jev 描述為接收 state 與 typed question、回傳程式可使用的結構化答案的模型。Choice 類問題會從給定選項中選一個,並提供機率與信心資料;它不是靠自由文字逐字描述要按哪個按鈕。官方介紹也建議把模型判斷拆成範圍清楚的問題,再由程式組合結果。
這個遊戲專案把此介面放進一個專用 harness。程式從 Game Boy emulator 的 RAM 讀出地圖、座標、隊伍、戰鬥、道具和畫面文字;GameState 的註解明確寫著這是純觀察,不會寫入遊戲記憶體。狀態讀取程式與 README 的系統說明都能讓人檢查這個界線。
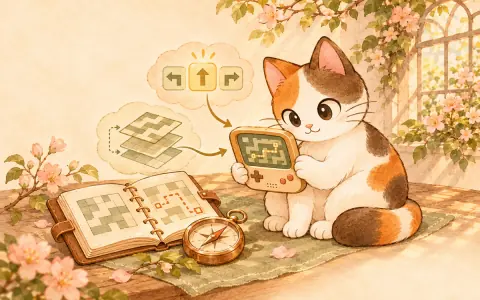
接著 harness 不是把原始 RAM 一股腦交給模型,而是產生帶有事實說明的合法動作。例如戰鬥選項會附上招式屬性、預估傷害、是否可能一擊打倒目標等資訊;野外選項則可能是走向 NPC、穿過出口、使用道具或推石頭。戰鬥程式會計算並整理部分戰鬥資訊;地圖決策程式則建立可用路徑和行動候選。
所以「Jev 選擇」和「harness 決定所有事」都不準確。Jev 仍會選擇要前進、訓練、治療、捕捉、購物或整理隊伍,也會選擇戰鬥與對話行動;但它的選項空間已經由遊戲程式解析和裁切。程式先把不少低階問題變成可選的行動,模型才在這個介面裡做判斷。
路徑、目標和完成條件都在模型之外
長流程不只要在局部情境選對招式,還要知道接下來往哪裡走、何時算完成。這個專案用 milestone 清單提供「目前要達到什麼、目標在哪個地圖」的提示;README 說明這些目標進度會依遊戲內的事件旗標確認,而非只相信模型說自己完成了。milestone 程式甚至直接說明,程式提供目標與位置資訊,但 Jev 仍選擇走哪裡、找誰對話、如何戰鬥、何時治療或訓練。
實際走格子的路徑也由程式計算。overworld.ts 使用 A* 路徑搜尋與區域圖,整理通道、障礙、可互動物件和目標距離,再把有意義的移動選項交給 Jev。這讓模型可以把判斷資源放在「該往哪個方向推進」或「現在應該補給嗎」等選擇上,不必每回合自己從座標推導一串方向鍵。
這個設計降低了問題難度,同時也是系統能力的一部分。若任務目標是建成可長時間遊玩的系統,這些程式支援並非作弊;它們正是產品的一部分。若任務是比較模型本身的視覺理解或通用導航能力,則必須把這些支援列為測試條件,不能只看最後是否通關。
失敗統計讓「通關」看起來更像系統韌性
Mathiesen 回報 16 次全隊倒下、四天王挑戰 15 次。這些數字提醒我們,成功不等於一路順利,也不只取決於單次決策品質。README 描述了失敗選項的記錄、卡住時逐步調整選項、milestone 存檔與必要時回到 checkpoint 等恢復機制;程式會累積沒有進展的決策、地圖狀態和已嘗試動作,再調整後續處理。agent 狀態追蹤程式可以看見這些恢復和進度追蹤邏輯。
從工程角度看,這場 run 的核心成果不是「模型有沒有犯錯」,而是系統能否在錯誤、重複動作與失敗戰鬥之後繼續推進。長任務的可靠度常常來自環境讀取、可行動作、外部進度檢查、記憶和恢復策略共同作用。只報通關時間或成功率,會漏掉這些機制;只報模型準確度,也無法描述整段流程是否能持續。
這場 run 支持什麼,還不能支持什麼?
它支持一個具體觀察:typed decision model 可以放進遊戲專用的狀態機與 harness,長時間從受限選項中作決策,並由程式驗證遊戲進度。公開程式碼讓人能研究責任分工,而不是只觀看終點畫面。
但它不是 Jev 脫離遊戲專用程式後仍能通關的證明,也沒有提供模型與簡化 harness 的對照基準。沒有獨立團隊重跑,這些統計仍是 Mathiesen 的自述;任務又使用特定遊戲、特定 ROM 資料、地圖邏輯和里程碑,不能直接外推到不同遊戲或未知環境。讀者可以從程式重建系統如何運作,卻不能因此把一場結果當作泛化能力測試。
若要自行查看,可以先讀 README,再追 src/game/state.ts、src/knowledge/milestones.ts 與 src/agent/。要重跑則需要 macOS 或 Linux、Node 20 以上、自己合法取得的美版或歐版《Pokémon Red》ROM,以及 AI Gateway key;這不是打開專案頁就能再次玩的線上 demo。當前專案頁主要提供 run 摘要與 highlights。
把「模型能力」改成可檢查的責任表
若你在評估自己的 agent,可以從這個案例借用一個更具體的問題清單:模型讀到的是原始環境,還是整理後的 state?哪些選項由程式排除?目標由誰拆解與追蹤?完成是由模型自述,還是由外部狀態確認?遇到同一個錯誤時,系統會重試、換策略、交給人,還是繼續循環?
這些答案比「模型打贏了遊戲」更能解釋系統做到了什麼。若想先理解 Jev 的 typed decision 介面,可接著讀 TypeSafe AI 與 Jev;若想看如何把 Jev 放進 agent runtime,則讀 confidence-gated routing 架構。本文聚焦的是另一層:一個具體長流程任務如何把狀態、模型決策、程式執行和驗證接在一起。
來源與延伸閱讀
- Jev Plays Pokémon Red — GitHub repository — 專案作者 Christian Mathiesen 提供的 harness 實作、README、測試流程與 run 統計;Jev 是 TypeSafe AI 的決策模型。
- Jev Plays Pokémon Red — project page — Mathiesen 專案整理的通關數據與 highlights。
- GameState、milestones、battle decisions、overworld decisions — 可檢視的遊戲狀態、目標、選項與路徑程式。
- TypeSafe AI Introduction — Jev 的 state、typed questions 與結構化決策介面。
- Jev plays Pokémon Red — Andrew Boyd 的另一場 run,頁面標示 Opus 5 監看遊戲紀錄並即時建置 harness。
- Tom’s Hardware:Jev beats Pokémon Red — 同期報導,區分 Boyd 與 Mathiesen 的兩場 run;並非 Mathiesen run 的獨立重跑。
延伸閱讀
- AI Engineering SWE-CC:測試通過,Agent 仍可能違反 Repo 規則 SWE-CC 將 12 個開源專案的 823 條貢獻政策轉成可執行檢查,揭示只看測試與 resolve rate 會漏掉 Agent 的流程違規。
- AI Engineering AgentEscapeBench 是什麼:評測 Agent 域外工具推理 讀 AgentEscapeBench:Agent 在領域外、長鏈條工具圖上為何會崩,以及這份評測能說明什麼、不能說明什麼。
- AI Engineering GPT-5.6 Prompting 規則清單:從精簡提示到工具編排 把 GPT-5.6 官方 prompting 收成可勾選規則:精簡、工具編排、何時不要把政策寫進 prompt。這篇是清單,不是 15% 那篇導讀。