論文精讀
Refuse, Decompose, Refresh 精讀:閉環 AI 評估的主張邊界
原文:Refuse, Decompose, Refresh: A Claim-Safe Protocol for Closed-Loop AI Evaluation
90 秒掌握論文
- 問題:閉環系統會由受測政策決定走訪哪些狀態、哪些元件有流量,以及失敗能不能留下可辨認的跡象。即使計算完全可重現,如果政策根本沒走到某個狀態,分數仍可能回答了錯的問題。
- 核心洞見:評估應像一份「主張契約」:先判斷資料是否支持這個比較;再把執行完整性、誤准入安全性、覆蓋率與各個結構假設分開;遇到相對於參考制度的漂移,就要求更新參考圖,不把警報直接當成故障證據。
- 最強證據:在作者的 aggregate-only 模擬器留出實驗中,交通暴露比被修改的元件格數更能預測穩定偵測;540 個單位-遮罩列的 cell-minus-traffic 負對數概似差為 0.1264 nats/row,20 個元件群集的 95% 區間為 [0.0593, 0.1918]。這是已准入樣本內的結構比較,不是線上 Agent 故障診斷準確率。
- 主要邊界:實驗只有 24 個政策元件、三種需求制度、兩種人工故障遮罩,且只觀察聚合軌跡。刷新測試固定使用原參考緩衝區,不能證明新資料能修好過時參考圖;作者也沒有驗證部署中的 Agent 或定位準確度。
本文依據 2026 年 9 月 17 日提交的 arXiv v1 預印本,沒有把它描述成已同儕審查的成果。研究從一個常被分數掩蓋的問題出發:當政策本身改變了資料如何生成,基準分數究竟能代表多少?作者揭露一項已撤回的最小 hitting set 與 propagation-aware greedy 比較:兩者同意,是因為 scoped probes 已先把剩餘選項縮到相同,而非證明其中一法更優。這個負結果促使作者把正式留出焦點轉到證據准入與校準,而非 MHS 優越性或定位準確度(Section 1)。作者提出 Refuse、Decompose、Refresh 三個動作,並用一個封閉迴路模擬器將支持門檻、誤准入校準、暴露變數比較和參考漂移拆成可以驗證的狀態與結果。留出實驗的數字支持這套主張邊界在該模擬器中的可執行性;它們沒有證明同一套門檻適用於真實模型、工具環境或多代理系統。
理解前需要知道什麼:分數是對某個構念的操作化
評估先選一個想知道的構念,例如可靠性、診斷能力或安全性,再用任務、可觀測變數、介入與指標把它操作化。操作化不是構念本身。指標可以被精確計算、程式可以重跑出相同結果,但若任務沒有呈現構念需要的情況,或資料根本不足以支持比較,可靠的計算仍可能支撐不可靠的主張。既有方法如多場景基準能擴大任務與指標組合,但仍不一定先回答每一筆觀測是否足以支撐指定比較。作者在 Section 2.1 把這個問題連到構念效度、基準外推與高維比較中的 overlap;本文聚焦更前面的一道門:這個案例是否有足夠可觀測支持,讓指定測量有定義?
本文的 estimand 不是治療效果,也不是政策價值。它問的是:在受測政策實際產生的流量下,對某個元件植入的介入,能不能形成穩定可觀測的差異(Section 2.1、3.1)?若政策從未造訪故障影響的區域,修改很多格也可能不改變聚合軌跡;若需求改變了流量分布,即使沒有植入故障,與舊參考分布的比較也可能失去意義。這兩種情況分別涉及介入是否可見,以及比較所用參考是否仍適用,不應用同一個「通過/失敗」欄位處理。
核心直覺:缺少證據要和沒有偵測分開
「拒絕」不是模型信心低時的預測拒答。它發生在評估器為特定比較建構訊號之前:如果乾淨參考軌跡或相配的參考-目前軌跡沒有足夠支持,該比較就不應產生診斷分數。當一個已支持的比較沒有超過訊號門檻,狀態才叫 NOT_DETECTED。所以至少有三種不同結果:沒被評估、比較成立但沒有偵測、比較成立且有穩定訊號。把前兩者壓成零分,會把「不知道」寫成「結果為零」。
「分解」針對另一種錯誤:把性質不同的端點合成一個總體 PASS。協定有執行完整性、操作安全、描述性覆蓋、結構假設和維護/刷新狀態;每一欄都回答不同問題。一次成功執行不等於研究假設成立,高覆蓋也不能抵銷誤准入,結構假設通過亦不代表覆蓋了所有元件。作者明確禁止合成一個科學總標籤(Table 1、Section 4.4)。
「刷新」則把偵測器警報的語義限定在參考比較上。受測流量若離開凍結參考,警報可以要求失效並重算參考圖;它本身不能指出元件壞了。無故障的目前資料可能有漂移,故障資料也可能仍接近參考。本文中 fault-null(沒有植入故障)與 detector-null(符合偵測器的凍結參考分布)是兩個不同概念(Section 2.3、4.5、6.4)。
用一個例子走完整個方法:某元件在高流量區遭遇介入
以下沿用論文的制度,不另造新的實驗數字。假設目標政策把某元件的一部分流量導向一組可被改動的格子;研究者以兩種遮罩挑選格子,一種均勻抽取可改動格子,另一種依乾淨流量加權抽取。比較不是先看植入了多少格,再立即輸出偵測結果,而是依次檢查可觀測性與穩定性。
- 輸入與參考圖:模擬器在需求制度 下執行目標政策,將 24 個互斥元件分別放進三個制度,形成 72 個 regime-component 單位。每個單位有 15 個分割區與聚合軌跡摘要。
- 參考支持門檻:一個乾淨分割區只有在既有支持數至少為 12 時才支持元件。15 個乾淨參考分割區中至少 14 個達標,該制度-元件單位才進參考圖;否則回傳
REFERENCE_ABSTAIN。分母不會因資料少而被默默刪去。 - 執行期配對門檻:比較參考和目前軌跡時,必須在同一分割區內兩邊都達到支持數 12,且至少 14/15 組成對符合;外向與內向介入方向都要各自通過,才能進入訊號評估。參考端 14 組、目前端另外 14 組並不足夠,因為支持可能落在不同分割區。
- 訊號與狀態:在每個相配分割區,。開發資料預先選定 的門檻,正式留出資料上不再調整。若某方向至少 14/15 分割區達標,而且兩個方向都穩定,單位才記為穩定偵測;否則可記為支持充足但未偵測。
- 輸出與容易誤讀的地方:結果另外記錄執行是否完整、誤准入安全端點是否達標、覆蓋到哪裡、各結構假設是否可估,以及是否要求刷新。零佔用的故障格另立層,不靠任意常數進行對數轉換,也不混入主要模型框架(Section 4.2)。
若一個單位沒有通過第一或第二個支持門檻,流程會在評分之前拒絕;若已通過比較支持但沒有穩定訊號,結果才是「未偵測」。這個端到端例子的可能失敗點,是支持門檻本身仍是特定模擬器的操作規則:它可以把稀少但重要的元件排除在已評估樣本之外,也可能不適合沒有乾淨參考流的系統。棄權使未知顯形,不會自動消除偏差。
實驗設計:模擬器、留出集與統計單位
作者將目標政策分別在三種需求制度擬合。每個制度有 24 個互斥政策元件,以時間季度、庫存半區和市場三分區索引。對每個元件記錄 15 個聚合軌跡分割區,不用植入的故障身份決定准入或穩定訊號(Section 3.1)。正式介入把可依方向改變的目標欄位格移動一個 action bucket;均勻遮罩用固定種子隨機順序抽樣,flow-weighted 遮罩則以乾淨佔用量作不放回加權抽樣(Section 3.2)。
作者比較兩種「故障大小」操作化。cell_fraction 是被選中格子的比例,表示元件定義有多少部分被編輯。交通暴露 ,其中 是乾淨佔用量, 是方向 下的故障格集合, 是元件。雙向交通暴露是兩個方向的平均值。後者問有多少乾淨政策流量經過被改動區域;前者問元件格子的幾何比例有多少改變。相同格數可能改到不同流量,因此這個比較是在檢查哪個量較貼近聚合訊號機會,不是證明流量本身構成普遍因果效應。
開發與正式留出採用不同種子。留出排程涵蓋五個交通目標 、兩種遮罩、三個需求制度、兩個方向與 15 個分割區,共 1,440 個案例、21,600 個分割列和 3,456,000 個模擬 episode。episode 是 Monte Carlo 軌跡,不是獨立統計樣本。覆蓋先從 72 個制度-元件單位計算;安全端點和群集 bootstrap 以 20 個有代表性的實體元件為單位;主要結構模型的 540 列是 54 個執行期准入單位 × 5 個交通目標 × 2 種遮罩,並巢套於這些元件群集(Section 5)。這些分母不可互換。
對結構假設,作者預先設定三個判準:交通模型須比 cell-fraction 模型有較低的負對數概似,且兩側 95% 群集區間的下界高於零;加入遮罩家族及其與交通的交互作用後,log-loss 改善的一側 95% 上限需小於每 unit-arm row 0.01 nats;兩家族的穩定偵測總數隨五個交通目標不得下降。群集重抽樣以實體元件為單位。這些是研究內預先凍結的判定條件,不是一般評估標準。
證據地圖:三張表各自支持什麼
圖 1 是本文按原論文 Table 1 重新設計的結果帳本。它不是原論文圖表的影像,也沒有額外資料;它把協定禁止互相替代的五種輸出視覺化,便於對照每個主張可用的結果欄位。
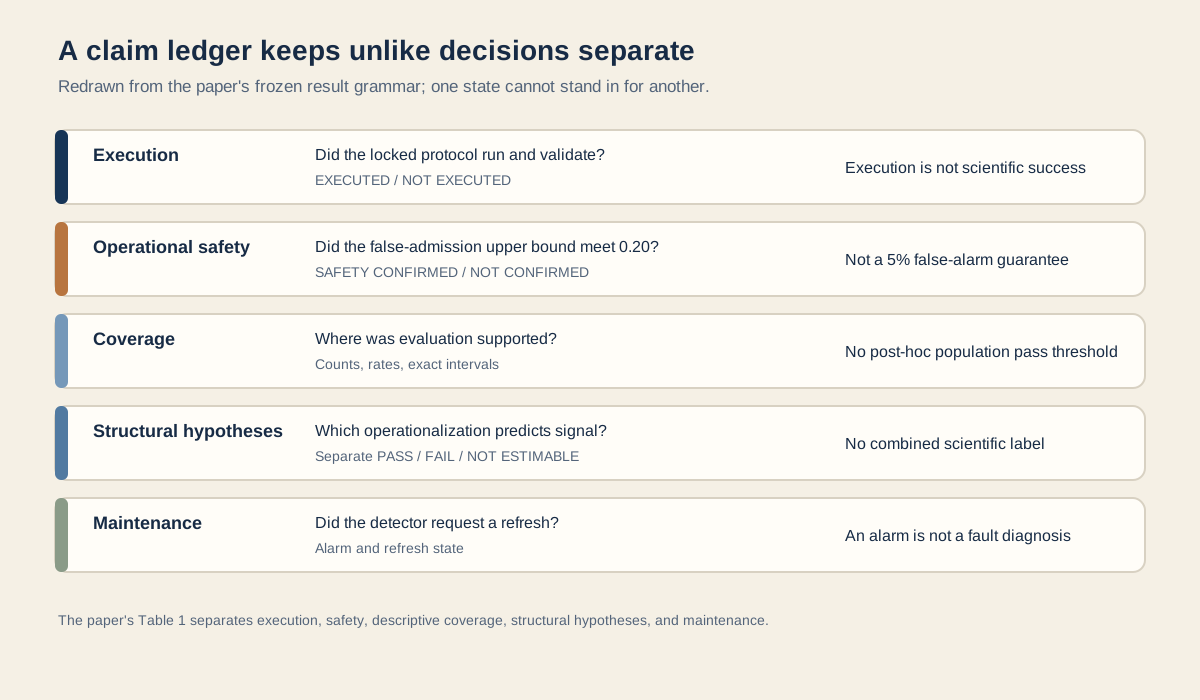
圖:Bloss0m 根據原文 Table 1(Section 4.4)重新繪製的結果帳本。執行、安全、覆蓋、結構假設、維護各有自己的問題和輸出;不應合併成單一科學 PASS/FAIL。圖中內容依據 arXiv v1 Table 1;來源頁列明 arXiv.org perpetual non-exclusive license。這是新製的資訊圖,非原論文圖表的複製品。
第一個結果是拒絕帶來的覆蓋代價。留出集的參考門檻讓 55/72 個制度-元件單位通過,代表 20/24 個實體元件;其中 54/55 單位再通過執行期兩流支持。獨立參考證據下,參考圖失效為 0/20,雙側 exact 95% 區間 [0.0%, 16.8%];執行期兩流拒絕為 1/20 個元件,區間 [0.1%, 24.9%](Section 6.1)。17 個乾淨參考棄權與 1 個執行期棄權都是結果的一部分。若把它們當成一般已評估案例,解讀就會仰賴未驗證的外推。條件式結果描述的是評估器在已准入單位上的表現;操作式結果則問排定機會中有多少最後拿到可用、受支持的結果。兩者要同時報,因為提高條件式表現可能伴隨覆蓋下降,而單看成功子集會看不見這個交換。這是作者在 Section 7.4 提出的報告原則。
作者也指出,在閉環評估中,准入分母是由政策行為共同生成的:政策走過哪些狀態,會影響哪些元件留下可觀測證據。因此不能只報過濾後的案例數,還應交代從排定案例到參考准入、執行期准入與實際評分的規則和數量(Section 7.1)。這樣才看得出覆蓋下降發生在哪一道支持門檻,也能檢查棄權是否集中在某些低流量或部署重要條件;只報條件式分數,無法回答整個評估流程有多少機會交付可用結果。
第二個結果是操作安全的上界。獨立 null arm 在 20 個實體元件上沒有任何一個跨過穩定訊號門檻,但「0 次」不能推出「風險為零」。單側 exact 95% 上界為 0.1391,低於本研究凍結的 0.20 操作容忍值,因此作者判定 SAFETY CONFIRMED。0.20 是本實驗的門檻,不是 5% 誤警率,也不是對未見元件類別或漂移 null 的保證。較細的描述性制度-元件層記為 0/54,上界 0.0540;它不是安全端點的主要統計單位(Section 4.3、6.2)。
圖 2 把兩個不同端點放在一起:通過多少支持門檻、以及安全端點的分母與上界。圖上的 55/72 和 54/55 是覆蓋流向;0/20 是另一個元件層安全抽樣,不能沿著同一條流向當成後續分母。
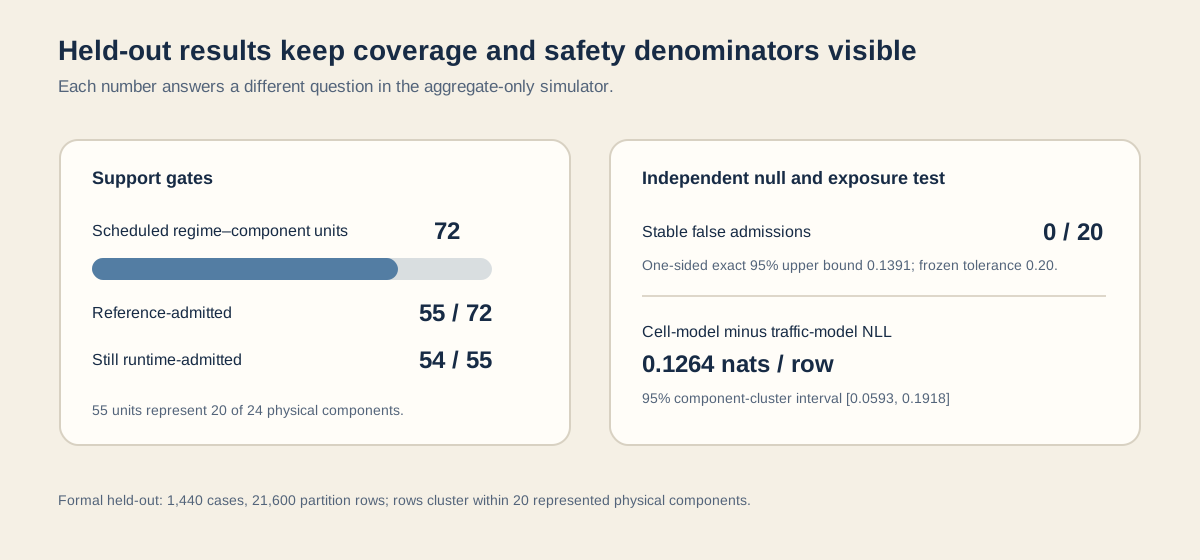
圖:Bloss0m 根據原文 Table 2 與 Sections 6.1–6.3 重新設計的留出證據圖。55/72 與 54/55 描述支持門檻的覆蓋,0/20 及其上界是另一個實體元件層安全端點,0.1264 則來自 540 個巢套列的模型比較。圖中呈現作者報告值而非新計算;來源為 arXiv v1 Table 2,原文頁列明 arXiv.org perpetual non-exclusive license;本圖為 Bloss0m 原創重繪。
主要結構結果支持交通暴露比 cell fraction 更能預測穩定偵測:cell 模型減 traffic 模型的 NLL 差為 0.1264 nats/row,20 個實體元件群集的 95% 區間 [0.0593, 0.1918],區間完全高於零(Table 2、Section 6.3)。同一交通目標下,flow-weighted 遮罩往往用較少格子;在交通條件下加入家族與交互作用,log loss 平均只改善 0.0015 nats/row,一側 95% 上界 0.0066,低於凍結的 0.01 門檻。這只支持「在兩種遮罩家族範圍內,交通量對該端點已具實務充分性」的條件式判定。
這個充分性結果需要保留它的脆弱處。0.01 門檻距觀察上界只有 0.0034 nats,而且 bootstrap 只有 20 個代表元件群集;有限群集造成的區間低估可能有利於通過。另一個 traffic-plus-family 係數的區間為 [-0.8617, 0.0367],對應 odds-ratio 區間 [0.42, 1.04],下界低於預設 [0.5, 2.0] 實務等價範圍。因此論文沒有建立係數層級的等價性;通過的只限於 log-loss 充分性端點(Section 6.3)。
穩定偵測的彙總數也隨交通目標單調不減:uniform 遮罩為 0、17、37、52、54;flow-weighted 為 0、13、35、49、54。這通過了預先凍結的 aggregate monotonicity 假設,但只涵蓋准入單位、三種制度、兩種遮罩和這項故障建構;不是適用所有故障的因果定律。這個結果和 traffic 對 cell-fraction 的預測比較彼此相關、但並非同一個端點。
失敗型態與參考漂移:為何「乾淨」不是單一虛無狀態
作者另用一份漂移日誌檢查參考相對性的問題。固定參考統計量來自開發資料的 制度。45 個目前分割區都沒有植入故障,每種制度 15 個;若忽略參考定義,把它們合併會得到 29/45 個警報,看起來像 64% 誤警率。逐制度拆開後, 的需求漂移制度為 15/15,匹配參考的 為 0/15, 漂移制度為 14/15(Table 3、Section 6.4)。
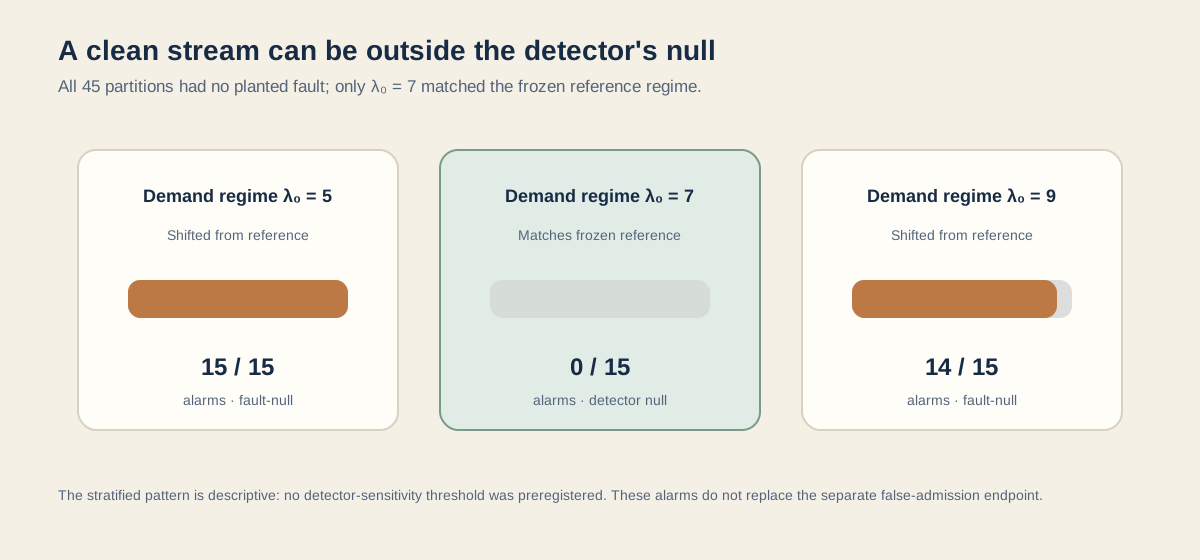
圖:Bloss0m 依原文 Table 3(Section 6.4)繪製三制度的警報數。三列皆為 fault-null,但只有 符合偵測器的凍結參考。來源:arXiv v1 Table 3;原論文頁列明 arXiv.org perpetual non-exclusive license;這是依據已報告數字重新製作的圖,不是原圖翻製。
兩個外側制度沒有植入故障,卻不屬於偵測器的參考 null。它們的警報符合「目前狀態不像凍結參考,應要求重算地圖」這種維護用途,但研究沒有預註冊偵測靈敏度門檻,所以 15/15、0/15、14/15 只能視為描述性制度切片,不是確認性靈敏度結論。相對地,Section 6.2 的穩定誤准入端點才是預先設定的操作誤報量。警報和故障准入分別回答維護與診斷問題,不能將 29/45 代替 0/20 的安全結果。
刷新端點也很窄:偵測器提出更新要求後,協定以原先鎖定的參考緩衝區重算並檢查 map hash 是否回到預期值。因為參考資料沒有換新,這只能測控制流程和 hash 不變條件;它不可能在這項設計下證明真實漂移後的新資料會修復過時參考圖(Section 4.5、9)。
證據地圖:作者主張、留出證據與仍未知之處
| 問題 | 論文與證據 | 留出結果能支持 | 仍不能支持 |
|---|---|---|---|
| 比較資料是否足夠? | Section 4.1、6.1 | 在凍結門檻下,55/72 參考單位及 54/55 執行期單位准入;拒絕率必須與覆蓋一起報告。 | 所有制度與元件都有支持,或門檻能套用其他系統。 |
| 誤准入是否低於本研究容忍值? | Section 4.3、6.2 | 20 個代表元件上的 0 個穩定誤准入,對應單側 95% 上界 0.1391,低於 0.20。 | 零風險、對未見群集有效,或等於 5% 誤警保證。 |
| 哪個暴露變數貼近穩定偵測? | Section 5、6.3;Table 2 | 已准入的 540 列中,traffic 模型預測優於 cell-fraction 模型;兩個指定遮罩家族中,加入家族的 log-loss 改善符合 0.01 規則。 | 元件格數在所有環境都無用,或家族效果在係數尺度上等價。 |
| 無故障警報如何解讀? | Section 6.4;Table 3 | 警報應依目前制度是否符合凍結偵測參考分層解讀。 | 已確認的漂移靈敏度、部署級誤警率,或故障定位。 |
| 刷新是否真的適應變化? | Section 4.5、9 | 原緩衝區上的流程與 map-hash 不變條件可被檢查。 | 新資料能修復過時參考圖。 |
證據地圖的重點是「每個數字各自能說到哪裡」。56/56 個獨立驗證檢查通過,支持凍結執行可被獨立驗證的作者報告;它不讓安全、覆蓋或結構端點自動變成通過。交通變數比較有強於零的區間證據,但它依賴已准入資料和 20 個元件群集。漂移日誌看似警報很多,恢復參考制度後才知道外側兩列是 fault-null、非 detector-null。刷新本身則只有控制流程驗證。這四種證據不應互相借用。
限制與不能從本文推論的事
第一,整個案例只在 aggregate-only 的閉環政策模擬器中進行。模擬器有 24 個政策元件、三種需求制度和兩種反事實遮罩,沒有模型本身的生成決策、真實工具呼叫、部署事件或多代理互動。它也不包含那些能決定現場可觀測性的完整執行堆疊。因此可以把它當作評估協定的可執行案例,不能稱為已證明 Agent 在真實部署中有效或安全。
第二,閾值是在一個模擬器中開發。沒有乾淨參考流的系統需要另一種設計;將 12/15 支持數、14/15 配對門檻、0.20 誤准入容忍值或訊號 cutoff 原封不動搬到另一個工作負載,並沒有論文證據支持。低流量或稀少元件可能更常被拒絕,因此覆蓋和棄權仍應按部署重要分層檢查。相同的「棄權」機制既可避免無支持評分,也可能讓少數條件持續沒有結果。
第三,留出集沒有驗證故障定位精度。它檢查聚合比較能否得到支持,以及人工植入介入是否會隨交通暴露提高而產生穩定訊號。它沒有證明系統能指出是哪個元件導致差異,也沒有為漂移偵測器設定並確認靈敏度規格。三種制度與兩種遮罩也不能代表其他轉移機制。
第四,統計不確定性不能只看 episode 數。3,456,000 個 episode 是 Monte Carlo 軌跡,非獨立推論單位;結構比較和安全上界使用約 20 個實體元件群集。尤其家族充分性的上界只比 0.01 門檻低 0.0034 nats,作者明確指出百分位 cluster bootstrap 在有限群集數下可能低估不確定性。係數尺度的等價性也未成立。這些限制要求讀者保留端點級結論,而不是只記得有一項「PASS」。
第五,刷新測試使用原本凍結的參考緩衝區,資料不能讓映射本身改變。它證明 state machine 會執行並維持雜湊預期值,沒有提供更新後參考能修復陳舊地圖的經驗證據。此外,對真實操作紀錄公開佔用圖或細粒度軌跡可能暴露敏感行為;釋出的模擬資料沒有個人資料,並不代表真實部署已處理隱私、公平或安全風險(Section 8–9)。
Artifact 與可重現性
論文將匿名 4open.science README 列為重現套件入口,並稱套件含凍結協定、設定、軌跡產生器、獨立驗證器、匯入的模擬器原始碼、參考/遮罩/案例/分割資料列與匿名化雜湊對照。論文描述在解壓根目錄執行 python3 verify.py,可以重建 56 項驗證、exact bounds、模型擬合、2,000 次決定性元件群集 bootstrap 及決策標籤(Section 5.1)。截至 2026-10-07,這個匿名 README 端點回傳 HTTP 403,本文因此無法直接確認檔案內容或重跑驗證;以上套件內容與重現步驟是作者在 v1 中的說明,數值結果在此均為作者報告,並非本文獨立重現。沒有可宣稱的公開 GitHub 專案或線上 Agent 部署。
所依據的 v1 共八頁,內文提到 Appendix A、Appendix Table 5 和 Appendix Figures 8–9,但已發布的 HTML 與 PDF 在參考文獻後即結束,沒有附上這些材料;因此本文只採用主文能直接支持的實驗設定和診斷,不把未提供的附錄內容當成已核實證據。
Bloss0m 工程判斷:把主張邊界也當成結果
以下是 Bloss0m 工程化整理,不是作者在論文中定義的一套通用上線規格。若把這個協定理念用於自己的評估,我會讓報表同時保留四層:排定的評估機會、參考支持准入、執行期配對准入,以及最後進入特定端點的統計單位;再把 execution、false admission、coverage、各結構假設和 refresh 分成欄位。每個欄位標明使用的母體與分母,並把未估計和拒絕保持為明確狀態。這樣讀者才能區分「沒有信號」與「沒有資格產生信號」。
若目標系統沒有可維護的乾淨參考,或政策產生的聚合摘要無法保留評估所需的暴露資訊,這項設計不能直接套用。即使能用,也要先在新環境重估支持門檻、null 參考、抽樣群集與實際行動成本,再把警報接到任何修復或人員處置。研究把刷新要求與故障診斷分開,正是為避免把偵測到變化的事實直接升格為故障結論。
這篇文章和 Agents Are Systems, Not Models 的評估單位問題相接,也可延伸閱讀 MAGS:自動形式化與安全邊界。前者提醒 Agent 是模型、工具和執行政策構成的系統;本文再追問系統若讓證據不可見,評估器應如何拒絕超出資料支持的主張。
讀完後的三個記憶點
- 方法:先以參考支持和成對執行期支持決定比較是否可評估;通過後的穩定訊號,才有意義稱為偵測或未偵測。
- 證據:作者在模擬器留出集發現交通暴露比元件格數更能預測訊號;0/20 穩定誤准入也只支持上界 0.1391、低於本研究 0.20 門檻的限定結論。
- 界線:無故障但偏離參考的制度仍觸發警報,refresh 只檢查原參考緩衝區上的流程與 hash;這不是線上 Agent 有效性、漂移靈敏度或自動修復能力的證據。
Primary sources
- Zhu, Peiying, and Sidi Chang. Refuse, Decompose, Refresh: A Claim-Safe Protocol for Closed-Loop AI Evaluation (arXiv:2609.20538v1), submitted 2026-09-17. Preprint; peer-review status not established.
- Full v1 HTML · PDF · Author-listed anonymous artifact README.