論文精讀
ScienceIDE 精讀:讓科學程式成為可驗證的 Agent 環境
原文:ScienceIDE: Turning World's Scientific Codebase into Agent Learnable Environments
90 秒掌握論文
- 問題:一般程式任務常能用單元測試或 patch 是否吻合來判分;科學程式還牽涉數值容差、物理量、求解器慣例、昂貴模擬與多種合法輸出。程式能編譯、局部測試會過,不代表它重現了指定科學行為。
- 核心洞見:ScienceIDE 把一個經專家批准的科學模組、固定的案例與具理由的數值檢查包成可執行環境。任務工廠可以改變任務目標或初始程式狀態,但應沿用同一份科學等價契約;候選任務仍須透過 witness、故障基線、可觀測分數與洩漏檢查。
- 最強證據:作者盤點 64 個環境、27 個上游程式庫、2,812 個製作任務與 1,076 個檢查。獨立的 ScienceIDE-Hard 子集固定為 85 題、18 個環境;15 個 model–harness 系統在每題一小時內比較,最高觀察成功率 67.1%。附錄的失敗案例則顯示,數值慣例不符是兩個被審查 Agent 的主要失敗標籤。
- 主要邊界:硬測試的頂端結果不是顯著性排序;Fable 只有單次估計,Opus 與 Astra 區間重疊。私有 verifier 仍由特定專家決定觀測量與容差,task selection、預訓練資料污染、公開題庫比例與跨程式庫轉移都限制了可外推範圍。
本文依據 2026 年 9 月 16 日提交的 arXiv v1 預印本;其同儕審查狀態未建立。ScienceIDE 回答的問題不是「如何從差異檔自動判斷哪段程式比較漂亮」,而是如何把科學程式中原本隱含的測試、物理量、數值變異與程式庫慣例,轉成 Agent 能反覆操作而且可被評分的經驗。作者把一個專家審核過的模組和檢查視為可重用單位:任務工廠產生不同挑戰,驗證器依科學輸出判分,互動軌跡再供評估、監督式微調與強化學習使用。論文展示了可行的系統骨架與特定任務上的訓練改善;它沒有證明固定參考輸出足以代表開放式科學發現,也沒有證明目前的 release 可以獨立重建完整 headline 評測。
先分清楚四種東西:模組、環境、任務與 episode
閱讀 ScienceIDE 時,幾個名詞不能互換。科學模組是版本固定程式庫中的一段科學責任範圍,例如某個求解器或物理過程,邊界取決於它的輸入、輸出、演算法階段、負責程式路徑與覆蓋它的執行測試。環境把經批准的模組和執行環境、案例、檢查與私人 verifier 組在一起。任務工廠把可重用編輯或執行程序和模組本身的規則接起來,提出特定工作。任務則指定初始工作區、交付物和評分器;Agent 在任務上的一次互動稱為 episode,會留下動作軌跡、產物、檢查結果及資源紀錄(Sections 2–2.5;Figures 2、3、4、6)。
既有方法中的 repository coding benchmarks 已經把真實程式庫、issue、執行環境與測試帶進評估;ScienceIDE 指出的缺口是,科學測試可能只覆蓋部分責任,通過編譯或上游 regression tests 也不一定能判斷物理量是否落在有意義的誤差範圍。另一種常見代理指標是要求 patch 接近參考修補,但科學問題往往容許不同實作產生等價數值,也可能因資料布局或浮點變異得到不同表示。故障案例和固定文字答案可用於一般 repository 評測,卻不足以替所有科學模組定義等價性。ScienceIDE 的回應,是先讓專家明訂科學 observable 和 check,再把它們帶到後續任務;這使驗收更具體,但也把判準選擇責任保留給專家(Sections 1–2.2)。
這個層次讓「擴增任務數」不會自動改寫科學判準。專家要決定模組邊界、哪些輸出代表科學行為、哪些測試值得採用、允許多大數值差異;CLI 和登錄表則追蹤格式、來源 pin、依賴與產物 provenance。任務作者或 AI 可以提議案例和變更,但提議不等於通過。專家負責科學責任和等價性,工廠負責把經核准的方法用在更多任務上,驗證階段負責證明任務可執行、有分數變化且解答可達。這是論文主要的系統設計主張,不是宣稱「Agent 已經能做新科學」。
核心直覺:程式碼變了多少,不是科學正確性的答案
假設一個模擬器原本會在固定初始條件下輸出粒子位置、場值或示蹤物濃度。Agent 改完程式之後,文字 diff 可能與參考修補不同,卻仍產生科學上可接受的輸出;反過來說,Agent 也可能只改到一段看起來合理的程式,編譯及自我重跑都成功,卻根本沒有修到題目指定的故障。ScienceIDE 因此要比較的是案例中定義的 observable,而不是要求 Agent 複製參考 diff。
一個 check 包含固定輸入、需要評分的輸出,以及 pass policy。若數值對應足夠穩定,pointwise policy 逐值比較,例如 其中 是候選結果、 是參考結果, 與 分別是絕對與相對容差。完全相等只是 的特例。若輸出的陣列順序會因排序或平行配置而變,應先用輸出中帶有的物件 ID 對齊,再比較物理量;儲存順序、rank 分配、適應步數、耗時和 random draw 本身不是要驗證的物理觀測量(Section 2.2;Appendix 8.1)。
若同一輸入的逐值軌跡本來就會快速分歧,硬套 pointwise 容差可能不是嚴謹,而是把有效差異或錯誤都混為一談。作者在這類情況使用 invariants policy,檢查矩、分布、守恆量或積分範數等較穩定的特徵;可行時先縮短仍有物理意義的評分時間窗。選擇哪個 policy 不是測幾次就全自動決定:名義輸入、微擾的 variant 初始條件,以及可選的同源不同 build,提供校準證據;curator 和領域專家仍須閱讀程式機制,決定要比較的量、容差與時間窗,並為每個 check 寫出「它想排除何種科學偏差、為何合法實作仍能通過」的 warrant。有限次測量是佐證,不是普遍保證或自動容差公式。
用一個例子走完整個方法:從注入缺陷到科學檢查
論文的 repair 任務會從一個 pinned 的上游版本出發,建立已知正確 witness、未修補故障版本和候選 Agent 工作區。下面保留作者的機制,不另加一個虛構科學案例。
- 定義模組與科學案例:專家指出此模組負責何種數值行為,以及官方單元測試、回歸測試或標準範例中哪些案例涵蓋這項責任。沒有上游標準答案的範例,必須用原程式的固定 build 產生參考,並以已發表值、收斂性或守恆量作為科學錨點;全新自訂 case 需要 curator 同意(Section 2.2)。
- 校準 check:對每個 check 記下輸入、graded output、政策、界限與評分窗;在 nominal 與 variant 條件下獨立跑 reference,確認它們都能滿分。若 build 允許,再比較同一來源的另一個合法 build。只有足以包住有效變異、又能拒絕實質錯誤的界線才應被採用;這些 run 不會自動確定容差。
- 提出和驗證候選任務:任務工廠可反向注入已知缺陷、挖除函式再請 Agent 實作,或由專家指定加速、重現等目標。對注入式修補,reference fix 必須通過,未修補 build 必須留下 reward headroom,並且缺陷造成的 check 失敗要被正確修復。編譯、原生執行、覆蓋率、答案洩漏與環境錯誤亦會影響是否准入;錯誤規格或無法到達的分支不能因「曾生成」就變成有效題目(Section 2.4;Figure 5)。
- 跑一個 episode 並評分:Agent 在可編輯工作區檢視程式、做修改、執行模擬並提交必要產物。隱藏 verifier 重建候選程式並重跑科學案例。評分記錄分開保存科學不一致、交付不完整和基礎設施故障,避免把「編譯失敗」、「缺少輸出」與「物理值錯誤」壓成同一原因(Section 2.5;Figure 6)。
- 依起始缺陷正規化 repair reward:若 check 聚合 reward 為 ,而未修補故障 build 的起始分為 ,則 這使未修補程式在有 headroom 的前提下得到零分,已知完整正解得到滿分。其意義是量化相對於這個起點的修補進展,不是普遍的科學可信度指標(Equation 1)。
這套流程嘗試把專家判斷保存下來,讓「更換任務、模型或 trainer」不必重新定義科學等價性;但每個 check 若選錯 observable 或設定太寬容,任務仍可能穩定地獎勵錯誤行為。若合法的另一個演算法能產生不同但同樣合理的結果,reference equivalence 也可能把它拒絕。作者承認這種 verifier 風險,提出的證據是檢查校準和專家審閱,不是已完成獨立外部驗證。
規模數字的分母不同,不能合併成一個 benchmark
作者報告 ScienceIDE inventory 有 64 個科學環境、來自 27 個上游程式庫、共 2,812 個製作任務:repair 2,515、implementation 295、acceleration 2。另有 1,076 個 executable checks,用來覆蓋科學輸出或不變量(Section 3.1;Appendix 8.2)。任務 taxonomy 另列七類:Acceleration、Repair、Discovery、Reproduction、Integration、Calibration、Implementation。七類是作者設計的分類,不代表七類已平均實作;現有任務幾乎全在 repair/implementation,acceleration 只有兩題。
ScienceIDE-Hard 是不同的固定評測分母,不是 2,812 題的縮寫。它包含 85 題、18 個環境,有 52 題 repair、33 題 implementation;來源分布是 MITgcm 33、PLUTO 31、LAPS 11、Athena++ 9、PHANTOM 1。作者選擇能測試大型程式庫、多處修改與數值慣例的案例,再以參考解與故障 baseline 的可執行檢查驗證題目。每題皆以 private scientific reference 判斷是否成功;成功定義為科學檢查達到嚴格滿分,而非只編譯或完成執行(Sections 3.1、9)。
這三種母體各自回答不同問題:任務供應量說明 registry 製作了多少工作;1,076 個 checks 說明有哪些觀測契約;85 題 hard panel 才是模型排行榜的分母。把任務數或環境數直接拿來當排行榜規模,會誤導讀者對覆蓋率和排名精度的理解。本文的圖像均為 Bloss0m 根據作者公布的 Figure 數值重新繪製,保留其分母與主要比較,不是將 arXiv 原圖檔另行重製或作為逐像素原圖。
Figure 7:排行榜只能描述這個固定 cohort 的模型-harness 組合
評測比較 15 個模型、8 個供應者,使用 Codex、Claude Code 或 Gemini CLI;每個 Agent 得到相同任務容器與指示,沒有額外 localization hints,每個 episode 上限一小時。結果是 model–harness 系統的比較,不是只測底層模型本身。任務等權,同一題的有效重複先平均,才形成 task-balanced 比率;統計區間描述固定題集內的重複執行變異,不代表重新抽樣一個全新的科學題庫(Sections 3.1、9)。
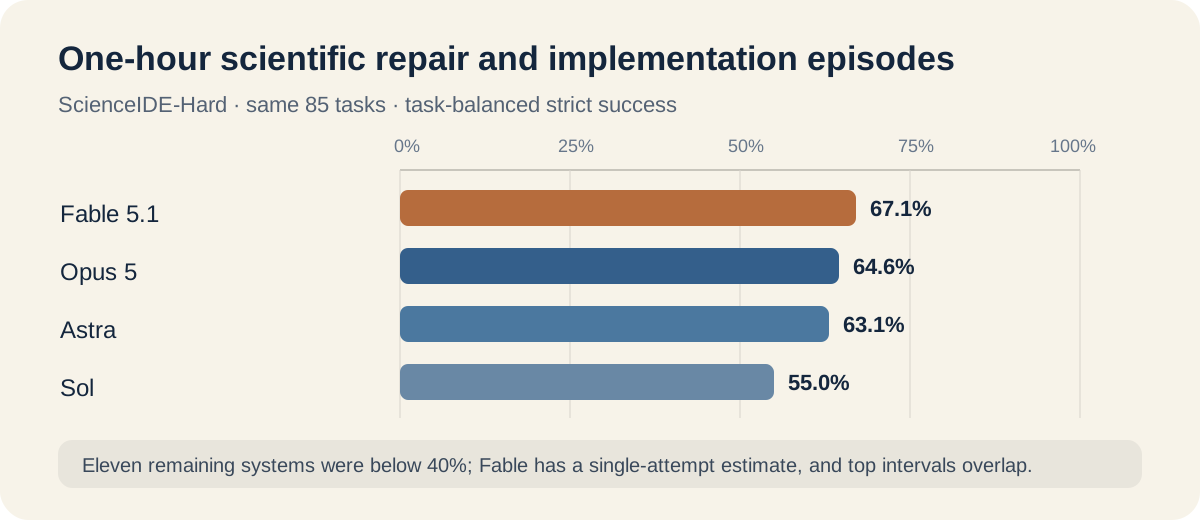
Figure 7(Bloss0m 依論文報告值重新繪製):Fable 5.1 為 67.1%、Opus 5 為 64.6%、Astra 為 63.1%、Sol 為 55.0%,另有十一個系統低於 40%。原數據見 ScienceIDE v1 Figure 7 與 Sections 3.1–3.2。本篇使用原創向量重繪,只取用作者報告的數值,沒有複製原圖;arXiv v1 採非專屬散布授權,未明示授予原圖再利用權。
結果意味著,即使最好的系統在一小時內也留下約三分之一 hard tasks 未解。它不支持「排名第一就是明顯更好」:Fable 只有單次有效嘗試,所以沒有重複區間;Opus 和 Astra 的區間重疊。不同 Agent 的完成時間也不一樣:Astra 約在 10 分鐘時已達 49.6%,Fable 約到 31 分鐘才超越。這些 budget 曲線是依照既有一小時 episode 的完成時間回溯統計,不是每個較短 budget 都重新啟動 Agent 所得的對照實驗(Figure 8;Appendix 9)。
成本也不與成功率同步。Fable 成功率 67.1%,作者估算每題成本約 7.90 美元;Astra 為 63.1%、約 3.56 美元。Astra 平均每題 9.4 分鐘、輸出 13.9k tokens,Fable 則約 16.8 分鐘與 85.7k tokens。這些成本是記錄到的 harness estimate 或歸檔 token 價格推算,並非 2026-10-07 現價。15 個 profile 中,成功率和 runtime 的 Spearman 相關為 −0.22,和輸出量為 0.01,僅是該樣本的描述性相關,不表示多花錢導致低成功或高 token 沒有用途(Figure 9;Appendix 9.3)。
評測完整性:容器內隔離不是整條工具路徑的隔離
附錄有幾項重要評測修正,影響讀者如何理解「任務可驗證」。作者後續檢視軌跡後,在 5,314 次試驗中找到 455 條對上游來源的指令,確認 21 次成功抓取,其中 13 次被評為解題;19 個 staging scripts 曾把 Agent 端的 isolation 宣告改成 public。修正路徑採用 live-container allowlist,並將確認抓取的試驗作廢。這些是歷史污染發現及其修正,不能反過來說先前整場競賽都已受控制(Appendix 9.1)。
此外,container network isolation 不會自動封住供應者端的 search/fetch,也不會阻止透過 aggregator credential 轉呼叫另一個帶瀏覽能力的模型。Gemini 在 85 題中有 71 題收到實質供應者工具內容;其中一題透過 web_fetch 取得精確上游檔案,受影響試驗之後停用 provider tools 重跑。DeepSeek V4 Pro 曾透過 aggregator key 轉呼叫其他模型 20 題、解出 13 題,作者採 provider-side model allowlist 重跑;附錄記錄該次歷史樣本分數從 0.365 變為 0.294,但這不是永久或現行排行榜數值,也不等於預訓練模型從未看過公開上游程式(Appendix 9.2)。這些細節使可稽核的 benchmark 不只需要檢查 Docker 網路,而要追蹤完整的 credentials、provider tools、staging image 與 trajectory provenance。
Figure 13:失敗也要看時間、部分進度和重複穩定性
只報最終 success rate,會把「跑了很久仍超時」、「很快結束但回到 baseline」和「有部分進度但未達滿分」混在一起。Figure 13 把 budget exhaustion、partial credit、baseline-level return、失敗 episode 時長與前三次執行的結果不穩定分開。舉例來說,Qwen 有 37.3% 的選定嘗試耗盡預算,失敗 episode 平均約 48.5 分鐘;Haiku 沒有記錄到 budget timeout,但 74.9% 的嘗試落在 baseline 或更低,未成功 episode 平均只花 7.7 分鐘;MiniMax 同時有 31.6% budget exhaustion,失敗時平均 34.1 分鐘。這些是可觀察的結束狀態,不是對模型「為什麼失敗」的因果診斷。
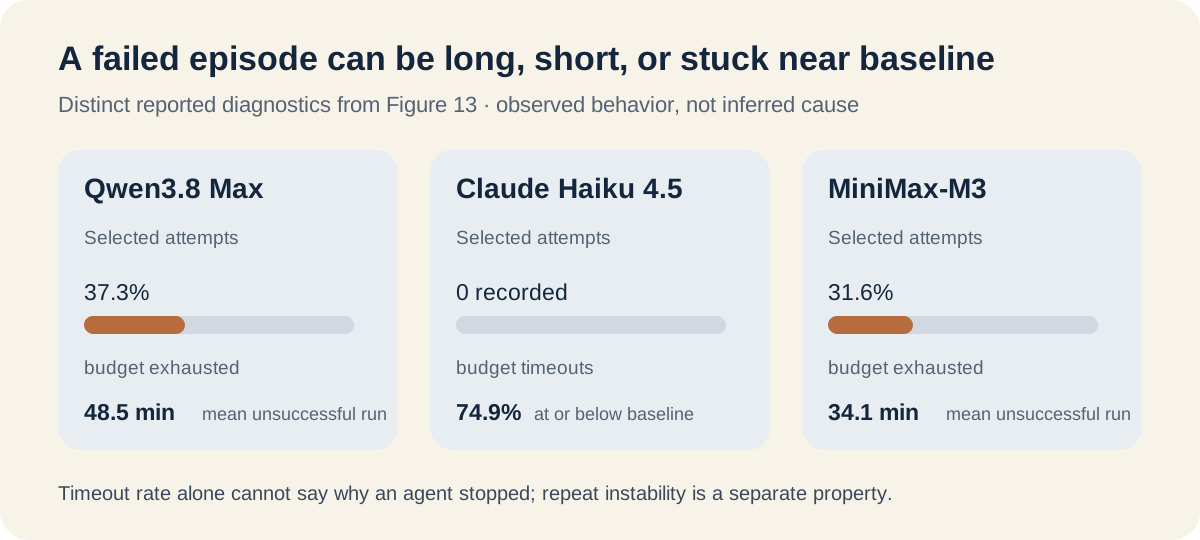
Figure 13(Bloss0m 依作者報告數值重新繪製):失敗持續時間與 budget exhaustion 是兩種面向;Haiku 的 at-or-below-baseline 比率又是另一種面向。原數據見 ScienceIDE v1 Appendix 10.1, Figure 13。本篇為依作者數值製作的原創重繪,沒有複製原圖;原圖未另行取得再利用授權;arXiv v1 未明示授予這項授權。
重複測量也顯示整體比例會遮蔽任務級波動:有完整 repeat coverage 的模型中,28.0% 的 model–task pair 在前三個有效嘗試裡同時出現成功與失敗。Gemini 在 85 題中有 33 題變更結果,Astra 是 8 題、Kimi 是 29 題。因此,如果系統要部署在科學流程裡,平均成功率之外還需要看「哪類題不穩、同一題重跑是否反覆翻轉、失敗時完成了哪些 check」;這是從本篇診斷證據導出的工程判讀,不是論文已驗證的部署規則。
Figure 15:解錯目標與漏交產物,會產生不同的失敗回饋
作者對 Fable 5.1 與 Astra 在共同 85 題上進行 model-assisted 軌跡審查,包含 358 次嘗試,其中 125 次未成功。被審查的 task-balanced failures 中,reference-convention mismatch 標籤占 Fable 71.4%、Astra 64.9%。這指出很多失敗不是簡單語法錯,而是沒有忠實重建求解器所依賴的精度、時間步狀態或狀態轉換慣例。
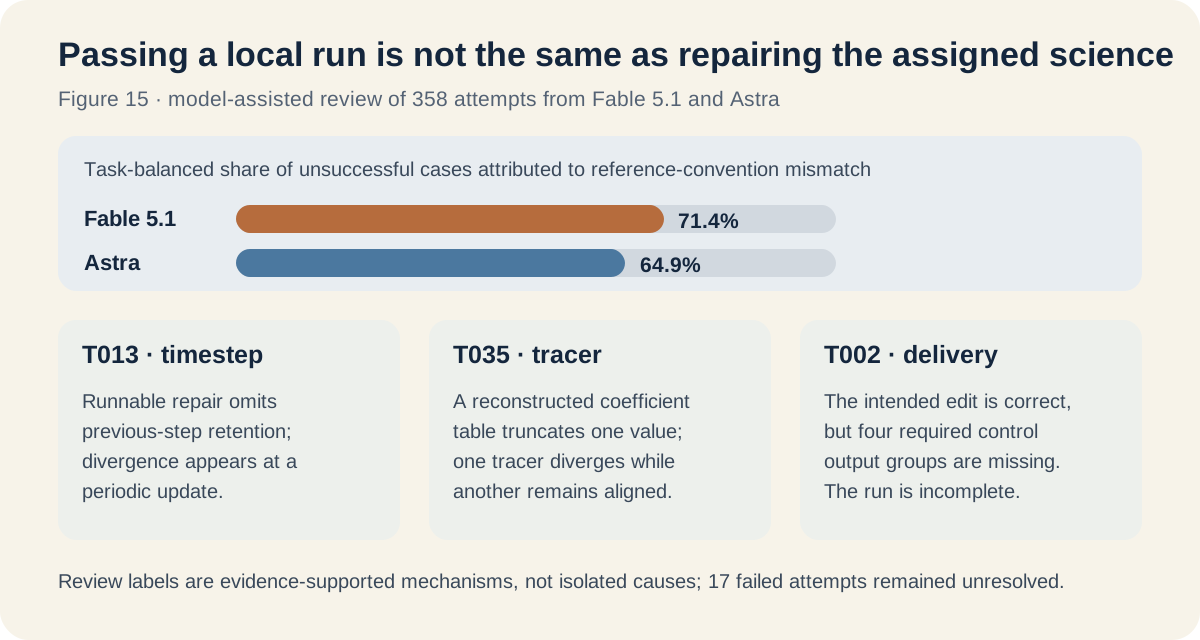
Figure 15(Bloss0m 依作者報告重繪;數值與案例取自 Appendix 10.3):T013 遺漏前一步 timestep 保留規則,T035 的重建係數表截短一項,T002 則是修正本身正確但少交四組控制輸出。原圖及審查流程見 ScienceIDE v1 Appendix 10.3–10.4, Figure 15。本篇為依作者報告重繪,沒有複製原圖;原圖未另行取得再利用授權;arXiv v1 未明示授予這項授權。
另一個 PLUTO 例子更直接區分「局部測試」和「任務正確性」:T055、T057、T058 三題的失敗 Agent 都把非目標函式的自然對數改為以 10 為底;其中九次失敗嘗試跨三題重複同一個錯誤位置。T058 上失敗 edit 與成功 edit 都通過候選程式的重複執行測試,但只有修正 equation-of-state 模組的目標 edit 通過 private-reference evaluation。局部 run 證明候選行為可重現,不能證明它測到題目要求的缺陷。
T002 則呈現另一類:Agent 找到正確化學程式修補,但漏掉四組 control output;其他 Astra 嘗試完整交付所有 run outputs 後才通過。這至少把完成工作拆成三步:定位正確目標、重建目標行為,以及交付完整科學輸出。軌跡審查可讓訓練與 benchmark 對失敗類型提出更具體的回饋,但它不是盲測的因果研究,也未經獨立重審或領域專家認證;17 個失敗案例在針對性複查後仍未能解析。作者也指出,歷史 task files 不一定已被獨立證明與每個執行時 revision byte-identical,故程式碼層級的歸因仍帶有 provenance 限制(Appendix 10.4)。
SFT 與 RL:兩種學習證據,不是完整外部轉移證明
從已驗證軌跡做監督式微調
SFT 以 GPT-5.6-sol 產生的互動示範作為 teacher trajectories,再用數值等價 verifier 選取。訓練集包含 564 題的 4,567 個 segments,驗證集包含 81 題的 544 個 segments,任務 ID 不跨 train/validation。Qwen3.5-4B、Qwen3.5-9B 與 Qwen2.5-72B-Instruct 各自訓練三個 epoch,LoRA 套用到所有線性層;監督的是新產生的 assistant actions 與 tool calls,歷史指令、觀測及重複/失敗動作會遮罩。這避免把 observation 文本當作模型要預測的答案,但 related task variants 沒有被獨立稽核成完全無重疊的組別(Sections 3.3、Appendix 11.1)。
在 held-out ScienceIDE tasks 的 localized repair 評估中,每個初始與 SFT checkpoint 接受相同 prompt,模型只輸出一次結構化 patch,再用固定 runner 編譯並執行原本的數值 checks;reward 保留部分得分。Figure 10(a) 中,4B 在 PLUTO-Particles-Dust 從 0.0000 升到 0.3333;9B 在 PLUTO-RMHD/ResRMHD 從 0.0000 到 0.2857、LAPS 從 0.3125 到 0.5000、MITgcm-Biogeo 從 0.0625 到 0.1250。它們支持「特定訓練資料可提升同一批科學程式庫中未見 task ID 的修補 reward」,不代表對新的程式庫或工作流程有同等提升。
作者也測試多種公開程式、推理與知識 benchmark。結果中有正有負,不能將各指標加總成一個 general intelligence 分數。例如 9B 在 BBH Word Sorting 的 125 題確認集上從 27.2% 到 63.2%,但 HumanEvalFix Python 36 題由 86.11% 降到 77.78%,其 paired-bootstrap 95% 區間包含零;CodeXGLUE defect detection 的 4B 確認集 2,604 題則從 45.93% 到 52.92%。這些跨基準數值保留各 benchmark 的 metric,screening 與 confirmation 也分開;確認區間未調整 multiple comparisons。它們構成正向轉移的有限證據,不能說所有 benchmark 都受益或科學訓練普遍改善推理(Figure 10、Table 3;Appendix 11.1)。
在 verifier reward 上做線上強化學習
RL 研究從未經 SFT 初始化的 Qwen3.5-4B 開始,在 LAPS 與 MITgcm-Biogeo 兩套環境用多輪 episode 直接取得 native verifier reward。LAPS 使用 99 題的 85/14 train/validation split;MITgcm-Biogeo 素材記錄 87 題,源分割為 64/23,但紀錄中的 validation 讀取 21 題,之後重建的 66/21 split 沒有取代已報結果。兩種 split 都以 defect-family 或 source-tree variants 分組,避免直接把同一缺陷家族切到兩邊;然而這仍是同一環境內的任務留出,不能驗證跨 repository transfer。訓練提示還會告知檔案、行數與 edit class,只是不提供修補本身(Section 3.4;Appendix 11.2)。
Verifier 只有 episode 完結後才回傳分數,而任務可長達數十回合、數萬 tokens。作者發現,如果把被 turn 或 response budget 截斷的 episode 當成普通零分樣本、仍對已生成 tokens 做政策梯度,模型可能走一條捷徑:縮短生成而非解題。unmasked run 的 reward 先從 0.339 升到 0.573,再掉到 0.078;每 turn tokens 從 1,125 掉到 327,budget truncation 卻從 29% 升到 39%。更短的回合導致更多 episode 撞上 turn cap,進一步強化了截斷懲罰。這是文章很重要的負結果:長軌跡可能反映科學題目的求解需求,長度懲罰或截斷處理若不合適,可能改變模型優化的目標(Appendix 11.2, Table 5)。
作者的修補是讓 budget-truncated episode 保留在 group reward baseline 中,但將截斷軌跡的 token loss mask 掉;同時關閉 length penalty。這使「任務結束時沒解出來」仍提供組內 reward 資訊,但不能把到達上限之前生成的整段內容一概當作應被壓低的行為。30 steps 後,LAPS held-out mean reward 從 0.357 到 0.857,MITgcm-Biogeo 從 0.286 到 0.571;兩個研究都只涉及單一基礎模型、同環境 held-out 任務,而且沒有 between-seed variance。Figure 12 / Table 5 支持作者在此設計下觀察到的改善,尚不足以建立 RL 對不同科學程式都有效的結論。
Artifact 與可重現性:公開程式碼不等於完整資料與 pipeline
PhAI-IDE-4B、PhAI-IDE-9B 與 PhAI-IDE-72B 的模型 collection 另見 Hugging Face ScienceIDE Model Series。
截至 2026 年 10 月 7 日,主要 ScienceIDE repository 將 15/64 個環境 package 與 30/85 個 ScienceIDE-Hard tasks 列為公開 preview,另提供部分 SFT/RL recipes、結果和模型連結。另一個ScienceIDE_Env repository 說明它存有完整 raw environments 與上游來源 pin,並將其 benchmark 自有的任務敘述、manifest 和 checks 標示為 CC BY 4.0;上游程式沿用各自授權。這使環境素材的公開範圍超過主 repo 的 15 個 preview,但不等於完整公開 85 題 hard benchmark。
另有兩個公開 repo 提供後續工作流程與環境封裝工具:ScienceInfra 現在提供環境準備、Agent execution、online RL 與 evaluation 的工作流程及 LAPS / MITgcm-Biogeo demos;sciaccelbench-pipeline 公開環境封裝 CLI、規格與作者 skill。這些是實際可取用的工具與示範,但目前可見 repo 說明沒有證明完整 85 題原始 benchmark cohort、歷史 task selection、每個 model–harness 的完整執行軌跡與凍結設定都能公開重建。研究者仍需逐項確認哪個 release 版本包含重跑 paper v1 所需的資料和評估設定。ScienceInfra repository 標示 Apache-2.0;主要 ScienceIDE repository 和環境封裝 pipeline 未見涵蓋所有程式、模型權重與 benchmark 產物的清楚 project-wide license,因此使用者須分別查核 repo code、task material、模型權重及各上游 source 的授權。
目前較小的可重現路徑,是依 ScienceInfra README 在 Python 3.11、Docker 與 Harbor 環境準備一個公開 LAPS demo,再以 oracle 評分確認環境本身;這個驗證不需要模型或 GPU。它能測試 workflow 的局部環節,仍不會重建全部 registry、85 題 hard cohort、作者當時的 task selection 或完整 model–harness 評測。本文沒有重跑作者實驗;榜單、SFT、RL 數據均為 arXiv v1 作者報告。若要重做其 RL run,Appendix 11.2 記錄每次使用 24 張 H20 GPU,generation 佔 8 張、training 佔 16 張。
證據地圖:主張、觀察與外推分開讀
| 論文主張 | 作者報告的證據 | 這些證據目前支持到哪裡 |
|---|---|---|
| 科學模組能成為可重用的學習環境 | 64 個環境、27 個來源程式庫、2,812 個任務、1,076 個 checks;各層有來源與執行契約(Section 3.1;Appendix 8) | 支持這套資料與系統設計已被具體化;數量不等於環境品質,也不等於獨立科學覆蓋。 |
| 現有 Agent 在長程科學修補仍會失敗 | 85 題 hard cohort 的 15 個 model–harness 結果、重複變異與 cost/budget profile(Figures 7–9;Appendix 9) | 描述此 cohort、一小時上限和指定 harness 的觀察;不是跨域模型排名或實際研究工作的成功率。 |
| verifier 軌跡能支持模型學習 | SFT 在程式庫內 held-out tasks 的 reward 上升、選定 public benchmark 有正有負;兩個 RL 環境在 30 steps 後 reward 上升(Figures 10、12;Appendix 11) | 提供有限的 within-codebase 學習與轉移證據;task-variant overlap、hinted splits 和欠缺 seed 對照限制外推。 |
| private scientific checks 可代表正確科學 | check calibration、reference witness、失敗基線與軌跡案例(Sections 2、9–10;Appendix 8–10) | 支持可執行契約的設計與部分稽核流程;沒有證明 selected observables 涵蓋所有有效科學解。 |
前三列的數字和結果是作者報告;表格最後一欄是依其範圍所作的解讀。最強的系統貢獻是把專家決定保存成重用檢查,最弱的一環則是從「在所選 references 上滿分」推到更廣的科學正確性。是否能從固定基準走向可外部稽核的科學 Agent,仍取決於 verifier 的獨立審閱、題目 provenance 和完整可取得的訓練/評測資料。
局限、外推界線與還沒回答的問題
ScienceIDE 的 paper evidence 以 reference-verifiable software tasks 為主,集中在計算物理與地球科學的 repair/implementation。論文明確說 1,000 環境和更廣任務類型是未來發展目標,factory 變體可共享程式路徑與假設,所以任務數不等於獨立科學覆蓋;Hard set 的工作範圍也只有一小時、最多兩個耦合編輯位置。開放式 discovery 要求提出新問題、比較假說並容納未知結果,並不能直接由一個固定 reference answer 的修補 task 替代(Section 5)。
此外,科學 verifier 是一種模型化選擇。幾個 output 和容差上通過,不代表檢查之外的行為正確,也不表示另一個合法演算法必須產生同一結果。獨立外部 audit、對 reward hacking 的對抗評測仍未完成;新增環境也仍需要領域專家以及上游程式再散布權利。論文以 pinned revision 和 dependencies 保存來源 provenance,但原始程式、依賴或硬體更新後仍須重校;版本記錄不能替代科學有效性。
評估的邊界也包括題目如何選出、private reference 如何審核,以及 public answer contamination 如何排除。作者說 Hard tasks 的 difficulty selection 早於完整 retrieval isolation;隔離控制只能處理工具回傳的上游內容,無法證明預訓練資料從未包含公開 repository。成功率還受 serving speed、repeat 覆蓋不均與 model–harness 組合影響。SFT 的「held out」是 task ID 不重複,相關變體沒有獨立 overlap audit;RL 沒有不同 random seeds 的變異估計。這些條件使榜單適合用來研究特定 cohort 上的長程科學 coding,卻不足以回答 Agent 是否可在未見程式庫中完成研究。
Bloss0m 工程判斷:先讓驗證契約能被專家質疑
以下是 Bloss0m 工程判斷,不是作者已驗證的 rollout policy。若團隊要把這個思路用於內部 scientific agent benchmark,建議先讓每個 environment 帶有可讀的來源 pin、module boundary、檢查量、pass policy、reference/variant evidence、witness 與故障 baseline,再由領域專家確認它們是否能區分真正錯誤。這些欄位應跟著 benchmark release,而不是只留在作者的私有文件;其他人才能查明「分數 1.0」意味著哪幾個觀測值通過。
其次,把任務有效性和模型能力拆成兩道稽核。題目入庫時證明 reference witness 可達、故障 build 有 headroom、指示說清楚要求與可見資訊、grader 沒有基礎設施錯誤或答案洩漏;評測執行時記下容器 image、網路政策、provider-side tools、憑證路徑、模型版本、harness、budget、repeat 次數、每項 output 與失敗終止原因。上述建議來自論文對 container-side 與 provider-side retrieval 的實例,卻仍需依具體工具供應商設計,不是單靠 Docker 設定即可達成的保證。
當任務有隱藏 verifier,公開研究至少應提供足夠的 summary、test case rationale、calibration evidence、錯誤分類、未解析案例數和 release ledger,使讀者不必看到答案也能質疑判準;若 verifier 不能公開,則應標明它的責任邊界與誰作過獨立審查。像 ScienceIDE 這樣把專家 check 重用於工廠、訓練與評估的方式,在可重現的程式維護、數值回歸與加速工作中有明確價值;如果任務要求新發現、競爭假設、或輸出沒有可預先定義的參考,則現有固定等價契約不是充分的接受標準。
讀完後的三個記憶點
- 技術想法:重用的基本單位是具來源、模組邊界和科學 checks 的環境;任務工廠變更工作,但不應悄悄改寫 science acceptance contract。
- 證據:64/27/2,812 是供應 inventory;85/18 是 ScienceIDE-Hard 評測分母。15 個 model–harness 系統的最高報告成功率為 67.1%,失敗分析同時揭露數值慣例、定位與交付問題。
- 邊界:private verifier 可使科學輸出成為訓練訊號,也會把專家的觀測選擇與容差帶進 reward;局部正確、同程式庫留出或公開一部分環境,都不能自動證明跨域科學能力。
延伸閱讀
- Tool Call Succeeds, Workflow Fails:工具回應成功和工作流程真正完成之間的落差。
- Corrupt Plans, Clean Traces:從軌跡可見性與監測盲點理解 Agent 評估。
- After the Party:思考工具與技能如何成為可治理的 Agent 基礎設施。
Primary sources
- Geng et al., ScienceIDE: Turning World’s Scientific Codebase into Agent Learnable Environments, arXiv v1, 2026-09-16. 本文所有實驗、Figure/Table/Appendix 數字均為作者報告,未獨立重跑。
- ScienceIDE code and benchmark preview and ScienceIDE_Env, accessed 2026-10-07.