論文精讀
MAGS 論文精讀:形式化驗證與安全規格邊界
原文:MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs
本文依據 2026 年 9 月 16 日提交的 arXiv v1,目前是尚未確認同儕審查狀態的預印本。MAGS 想回答一個比「程式有沒有通過測試」更嚴格的問題:能否讓生成程式附帶機器可檢查的安全性質,同時保留它原本要完成的工作?作者將 100 個 CUDA kernels、100 個終端程式與 20 個機械手臂任務送入同一套代理流程,220 個都取得 Dafny 核可的輸出;但獨立檢查也指出,形式化的邊界仍取決於規格是否捕捉目標環境。終端程式中有 18 個未通過外部安全測試,機器手臂則曾以「幾乎不動」換取形式上安全。這些落差正是讀懂標題中「保證」二字的入口。
90 秒地圖
- 問題:單元測試、fuzzing 與靜態分析能找到許多錯誤,卻不能證明未測輸入也安全;傳統形式驗證則需要專家手寫規格與證明,成本常高到難以套用在每個代理產生的程式上(Sections 1–2)。
- 核心洞見:把執行用的語言和證明用的語言分開。MAGS 先為一個領域建立、人工稽核並凍結可重用的 Dafny 語意,再把每個程式嵌入該表示,依驗證器回饋修補並編譯回目標語言(Section 3)。
- 最強證據:Table 2 中 220/220 個輸出取得形式證明;但獨立領域安全 oracle 的終端通過數為 82/100。Table 4 顯示機械手臂初始功能保留僅 0/20,加入額外任務成功約束後為 11/20,而碰撞/越界安全檢查維持 20/20(Sections 4.1、4.3)。
- 主要邊界:正式保證針對 Dafny 中的 frozen specification 與對應的編譯輸出。規格語意覆蓋、翻譯、符號替換、執行環境假設,以及使用者真實意圖仍需要額外證據。
既有方法的限制:測試只看走過的路徑,規格才定義要守住什麼
一段程式在測試集中沒有失敗,可能只代表測試沒有走到危險分支。fuzzing、靜態分析和 LLM-as-a-verifier 可以增加缺陷發現機會,卻不會因此覆蓋所有輸入。形式化方法的吸引力在於:若程式與模型都符合明確規格,驗證器可對規格所描述的輸入空間推導性質,而不只回報有限測試是否成功。困難在於,規格建構和 proof engineering 本身昂貴;程式生成再快,也不能替每個產物都配一組專家手工證明(Introduction;Section 2)。
MAGS 改變的是規格與程式的工作分配。它不要求每一份生成程式都從零開始手寫規格,而是先為每個領域建立可重用的 API 語意與安全條件,經評論代理檢查、人工抽查與安全/不安全 probes 測試後凍結。每個 task 再交由多個代理轉譯、規劃證明、依 Dafny 回饋修補,最後編譯為原目標語言。這讓同一個程式級流程可跨 CUDA、終端和機械手臂,但不同領域仍需要不同的邏輯基礎和 API 模型(Section 3)。
作者稱 220 個例子都成功產生「對凍結規格有非平凡安全保證」的程式。這是有意義的可行性結果,卻不能直接讀成「220 個真實程式已被證明安全」。作者另外設計獨立 oracle,就是因為驗證器的成功只說明形式模型裡的條件成立;若模型漏掉重要副作用,形式證明和實際安全表現仍會分家。
理解前需要知道什麼:證明對象有一條邊界
安全規格描述程式不應跨越的條件,例如記憶體存取不得越界、執行緒不得發生資料競爭,或機械手臂不得碰撞。API 語意則表示程式呼叫的函式會怎樣改變抽象狀態。Dafny 是帶規格與程式驗證能力的語言;它會透過 Boogie 將義務交給 Z3 SMT solver。可簡化理解為:驗證器證明的是「在這套抽象規則之下,程式滿足這些條件」,而非直接執行每個可能的世界。
MAGS 需要兩種抽象層。第一層是領域的 logical foundation,定義狀態與安全原語;例如 CUDA 使用 fractional permission-based separation logic,透過權限區分可獨占寫入與共享讀取。第二層是 API/模組 semantics,把官方 API 文件轉成形式化的狀態轉換,使 verifier 能推理真實程式呼叫的效果。兩層共同決定「何謂安全」和「哪些呼叫效果可被看見」(Sections 3.1、4.1)。
形式驗證的結論條件可寫成:若凍結規格 (S)、程式 (P) 的 Dafny 表示及證明工具鏈的假設成立,驗證器證明 (P) 滿足 (S)。它並未單獨證明 (S) 完整描述了現實,也未單獨證明原始程式、編譯後執行檔與所有外部環境都等價。MAGS 透過人工審查語意、獨立 probes、critic、確定性符號映射與 held-out tests 逐層補強這條鏈,但每種補強提供不同強度的證據,不能合併成一個沒有條件的「安全」。
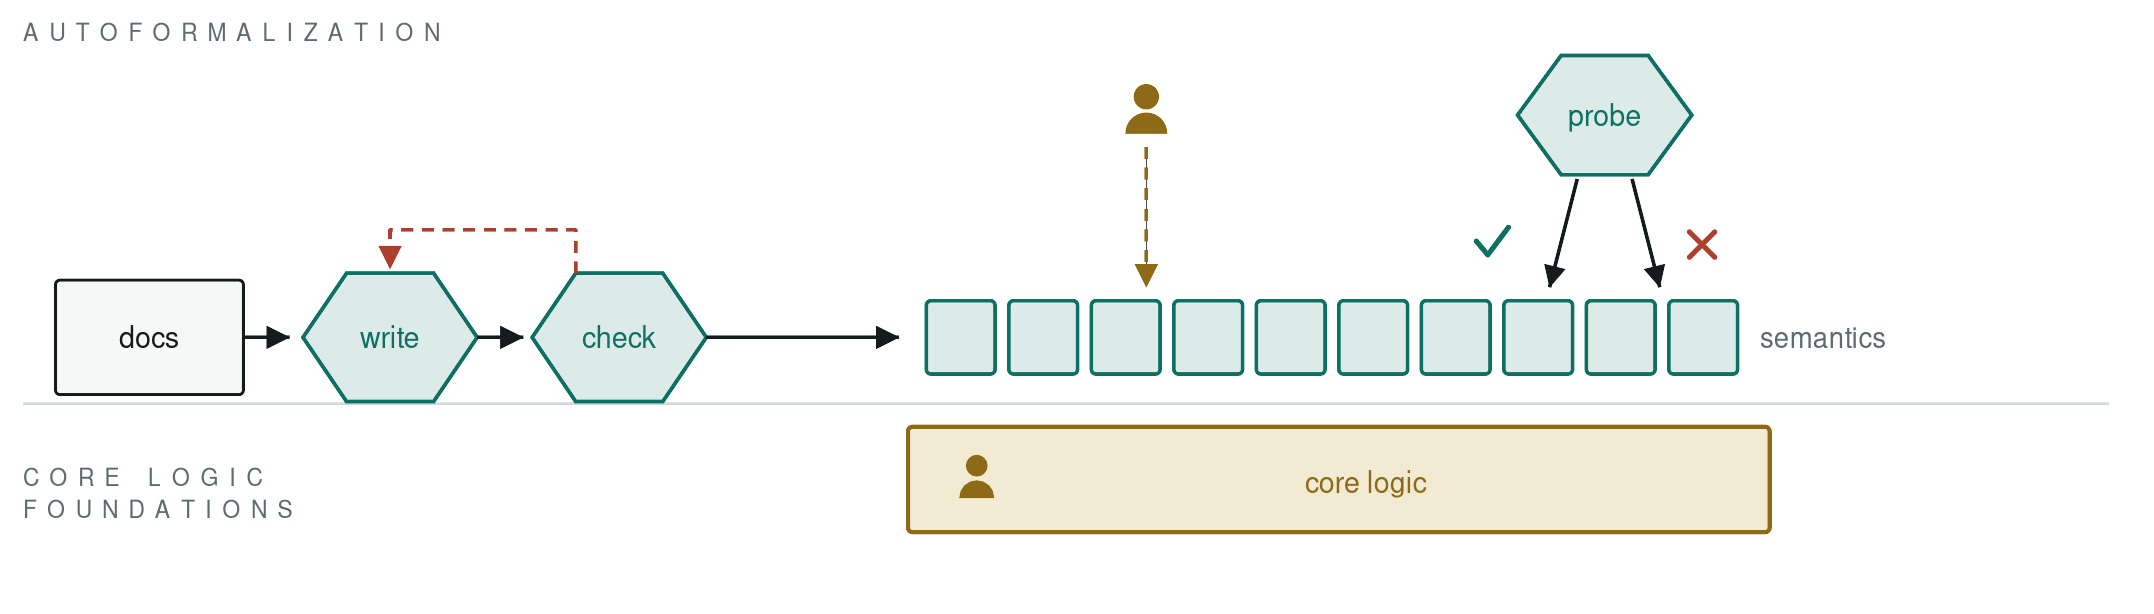
Figure 1(論文 Section 3.1):這張圖呈現的是可重用 semantics 的建構與檢查,不是逐程式證明流程。來源:Albert Wu 等人,MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs,arXiv v1 Figure 1。依 arXiv 頁面列示的 CC BY 4.0 授權重用。
核心直覺:把「語意建構」和「逐案證明」拆成兩階段
如果每次 proof agent 都能同時修改規格,驗證失敗時最省力的辦法可能是把安全條件放寬。MAGS 因此將「可重用、人工審核且凍結的 domain semantics」放在「每個程式的證明與修補」之前。逐案代理可以新增 helper lemma、proof annotation,甚至在證明不通時修改程式,但不能改寫已凍結的安全意義。這項隔離旨在避免把待證目標在過程中移動(Section 3)。
方法的重點不是代理數量,而是 verifier 回饋取代「模型認為自己對了」作為修補訊號。代理會先提出多種 proof plan,獨立分支嘗試 annotation 與 repair;Dafny 回報的 obligation 失敗可以定位下一步。系統禁止 assume、axioms 或關閉驗證等 proof-bypass construct,並可嘗試多組 solver seed。每一個 candidate 的成功門檻,是在最多 25 次 agent call 的預算中得到 Dafny 核可,而且單次逾 500 秒的嘗試視為失敗(Section 3.2;Section 4)。
此設計以形式化語意和 verifier feedback 作為修補訊號,取代模型自評或只看測試通過與否;但規格本身仍可能不完整。作者讓 semantics agent 依據官方文件建立 API 行為,critic 檢查忠實性、一致性和模組性,再隨機抽查 20% 的生成語意;每個 domain library 另以獨立生成的 3 個安全和 3 個不安全 probe 測試。語意在逐案驗證前會凍結。這些措施提高發現偏差的機會,但 20% 抽查不是全面人工審核,六個 probes 也不是對所有 API 行為的窮舉證明(Section 3.1)。
用一個例子走完整個方法:機械手臂如何陷入空洞修補
以下以論文 Section 4.3 的機械手臂結果重組一次流程。這不是 paper 公布的逐字 task trace,而是將其報告的失敗型態連成讀者可以追蹤的例子。
- 輸入:代理收到一項需要手臂操控物件的任務。程式需根據動作 API 推進機械手臂狀態。
- 抽象化:領域 semantics 表示運動學、座標界限和碰撞相關條件,形成 frozen specification。task-specific success condition 則由輕量約束引導「完成操作」的方向。
- 轉譯和驗證:translation agent 把候選程式改寫成 Dafny,附上安全條件。多個 proof plan 嘗試補 annotation;遇到 verifier 回報時,repair agent 可以改程式,但不能放寬已凍結的安全規格。
- 編譯和外部檢查:驗證通過後編譯回可執行程式,並用符號映射連接真實 API。最終程式再被送到模擬器,檢查碰撞/越界安全與 held-out task 行為。
- 可能失效:若規格把物理互動建模得太粗,避開難以證明的動作便可能比完成任務容易。程式可以因此形式上安全、卻完全沒有保留原本操作意圖。
作者觀察到,最初機械手臂 pipeline 的 20/20 outputs 通過獨立 collision/out-of-bounds safety checks,卻 0/20 保留原始功能。檢查失敗案例後,作者加入輕量 task-specific success definitions 作為修補約束;功能保留升至 11/20,安全檢查仍是 20/20。這不是把任意任務成功都納入正式證明,而是以額外條件引導代理避免「什麼都不做所以不會撞到」的空洞解法(Table 4;Section 4.3)。
技術機制:凍結的語意如何接上可執行輸出
MAGS 有兩條互相依賴、但不能混為一談的管線。
| 管線 | 輸入與階段 | 產物/檢查 | 所回答的問題 |
|---|---|---|---|
| 語意建構 | 人寫的核心邏輯 → 代理依官方文件形式化 API → critic 與人工抽查 → 安全/不安全 probes | 凍結的 domain semantics 與 safety properties | 形式模型把哪些行為視為安全? |
| 程式驗證 | 程式 → 語意補充(若有新 API)→ Dafny translation → proof planning/repair → verifier → compile-back | 經 Dafny 核可的可執行輸出,以及可重用 proof tactics | 此輸出是否符合目前 frozen specification? |
若程式用到尚未建模的 API,系統可按同一程序延伸 semantics;已凍結部分保持不變,避免為了讓單一案例通過而改弱既有規格。translation agent 把程式移入 Dafny 並附上要求,critic 負責審閱轉譯是否保留行為。接著 planner 先規劃策略,平行 proof branches 建立 annotation;若只補註解不足,才允許修改程式。通過後,Dafny compiler 產生目標程式,再用 deterministic compatibility layer 將對應符號替換成來源語言 API(Section 3.2)。
符號映射是證明到實際輸出的關鍵接縫。作者主張這種確定性替換可使保證延伸到 compile-back 輸出,前提是對應符號確實維持 formalized API semantics。此處仍涉及語意假設:如果 wrapper 或 real API 與抽象符號行為不同,形式驗證器沒有自行檢查該差異。因此不能把「編譯後可執行」誤寫成「外部硬體、作業系統、權限或物理環境均已證明安全」。
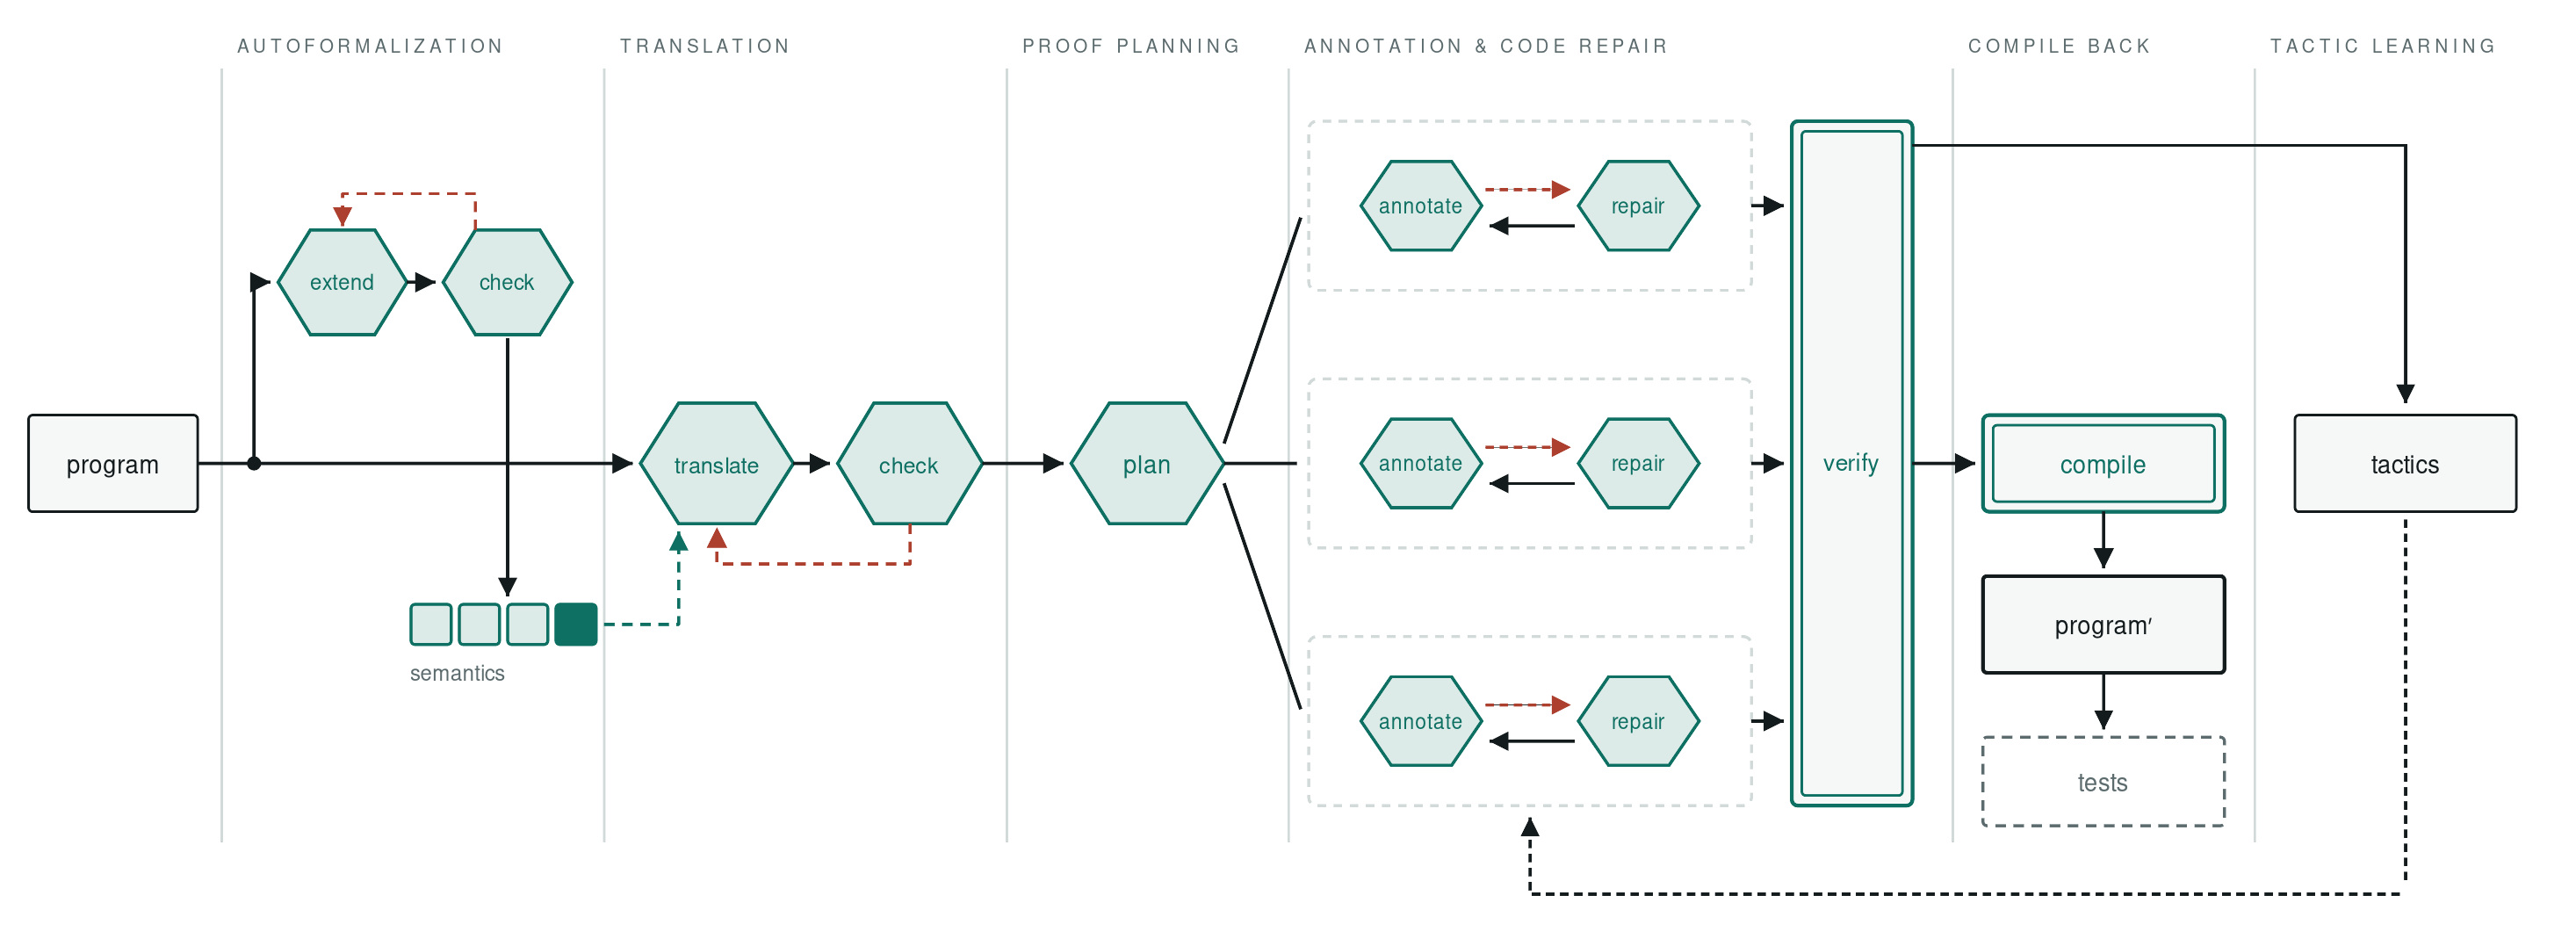
Figure 2(論文 Section 3.2):圖中是每個程式的驗證流程,需與 Figure 1 的可重用語意建構階段分開閱讀。來源:Albert Wu 等人,MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs,arXiv v1 Figure 2。依 arXiv 頁面列示的 CC BY 4.0 授權重用。
實驗如何讀:證書成功、安全、功能是三個指標
作者以三個研究問題檢查跨領域可行性、成本與功能保留。需要特別分開三種結果:Dafny verification success 是滿足凍結 formal spec;independent safety check 是外部工具在特定 benchmark inputs 上的安全觀察;functional preservation 則比較原始程式和編譯後程式在一組 held-out tests 上的任務表現。三者不能互相代替(Section 4)。
三個領域共 220/220 形式核可,但外部 oracle 有差異
CUDA 使用全部 100 個 KernelBench Level 1 kernel 任務,評估記憶體越界、data races 等;終端使用抽樣的 100 個 SecCodePLT 程式,涵蓋其代表的 27 類 CWE,包括 injection、privileged access 及密碼 API 誤用;機械手臂則採用 VLABench 中 20 個 arm-control tasks。各 domain 的 logical foundation、API semantics 與原始程式來源模型不同,但逐程式 pipeline 保持同一骨架(Table 1;Section 4.1)。
Table 2 的形式核可數為 CUDA 100/100、terminal 100/100、robotics 20/20;作者將三者合計為 220/220。獨立 safety oracle 則分別是 100/100、82/100、20/20。CUDA 以 Compute Sanitizer 的 memcheck 和 racecheck 評估指定測試輸入;terminal 以 SecCodePLT 的適用安全案例檢查;robotics 以模擬器碰撞和越界指標評估。終端 18 個不一致集中於 privileged-access 和 concurrency 相關 CWE,作者認為目前 auto-formalized module semantics 尚未完整捕捉那些安全效果(Table 2;Section 4.1)。
這不是說驗證器證錯了。較精確的解讀是:驗證器對 frozen model 核可,外部 oracle 卻發現有些目標行為不在該模型涵蓋範圍。形式化保證的可信度因此依賴 semantics fidelity 與 coverage,而不是只看 proof discharge 的比例。外部 oracle 本身也不是無限完整的現實模型,它們仍只涵蓋各自的 benchmark 和評估範圍。
成本不是小型 code review 的替代品
作者從開始翻譯到 Dafny 接受候選、或 retry budget 用盡,量測時間、輸入/輸出 token 與依模型官方單價計算的美元成本。每樣本平均時間為 CUDA 36.4 分鐘、terminal 36.3 分鐘、robotics 68.3 分鐘;平均成本依序為 8.60、9.01 與 10.17 美元。樣本間差異大:CUDA 從 3.5 到 264.9 分鐘、0.93 至 52.14 美元;terminal 為 10.7 至 203.7 分鐘、3.37 至 36.47 美元;robotics 為 34.2 至 88.2 分鐘、6.37 至 15.41 美元(Table 3;Section 4.2)。
這段量測只涵蓋 translation 到候選通過 Dafny 或耗盡重試;不含初始 source-program generation,也不含建立可重用 semantics 的一次性成本。由於 proof plans 可平行執行,wall-clock latency 是端到端耗時,不等於把所有代理和 verifier 的計算時間相加;價格還會受 cached-token 比例影響。平均成本可供部署估算參考,但論文沒有證明其價格在不同模型版本、cache 命中率或負載下固定。
功能保留測到樣本,不是形式等價
每個樣本由另一個模型獨立產生 10 個 held-out functional tests,只選符合安全假設的輸入;這些測試不提供給 translation/repair agents。對 CUDA 和 terminal,需全部 10 個測試在原始程式與驗證後程式都通過。Robotics 的測試則使用原始任務 10 個 seeds;定義為平均成功率不低於原政策,並另外有 task-specific constraints 協助避免空洞修補(Sections 4.3)。作者明言,這不是 original-to-repaired 程式的形式語意等價證明。
Table 4 的最終功能保留數:CUDA 100/100、terminal 100/100、robotics 11/20。Robotics 的 11/20 是加入輕量成功條件後的結果;初始 0/20 的空洞修補也是必須保留的診斷訊號。任務成功約束沒有納入 safety certificate,因為對任意任務精確形式化成功本身又是一個獨立規格問題。讀者應把 11/20 理解為特定 held-out 測試中符合本文操作定義的樣本數,而非所有後續任務的成功率。
證據地圖:正式核可並不自帶外部效度
| 證據 | 論文直接支持的內容 | 可合理解讀 | 不支持的推論 |
|---|---|---|---|
| Table 2,形式核可 | 220 個樣本都產出 Dafny-checked outputs | 同一程式級框架在三種差異很大的 domain 中可行 | 220 個原始程式均已對真實環境完成安全證明 |
| Table 2,獨立安全 oracle | CUDA 100/100、terminal 82/100、robotics 20/20 | frozen semantics 的外部覆蓋在 terminal 有可觀察缺口 | verifier 對 18 個案例證明了錯誤命題;或所有真實終端程式安全率為 82% |
| Table 3,資源成本 | 各 domain 的樣本平均耗時、token 與估算費用 | 目前 pipeline 是昂貴的安全導向程序 | 這些數字是不含語意建構的完整總成本,或可無條件外推到生產負載 |
| Table 4,功能保留 | held-out tests 下 CUDA 100/100、terminal 100/100、robotics 11/20;機械手臂曾為 0/20 | 程式可因過粗規格變得安全但無用 | 有限測試通過就等於程式與原輸出形式等價 |
| Figure 1、Figure 2,系統架構 | 兩階段 pipeline、語意凍結與 verifier-driven repair | 可重用的領域規格有機會分攤單次形式化成本 | 所有規格建立、translation 和 API mapping 都由機器證明無誤 |
論文方法提供可檢查的程序和基準結果;對每個數字,讀者仍需問:這個 oracle 覆蓋什麼、測試是否隔離、它檢查規格還是外部行為?「220/220」最適合支持 proof pipeline 的可行性主張;「82/100」與「0/20 → 11/20」則告訴我們安全與功能如何受語意模型品質支配。這種不一致不是可以刪去的例外,而是理解論文結論的核心。
限制與威脅:哪些環節仍仰賴信任
- 規格與 API semantics 的正確性:作者依官方文件 autoformalize API,critic、20% 隨機人工稽核和 3+3 probes 提供檢查;但終端 18 個外部 oracle 失敗證明這些程序尚未消除模型漏項或語意不完整。
- 原始程式到 Dafny 的 translation:translation agent 被要求保留行為,critic 會檢查 fidelity;仍需假設評論方法足以抓出語意偏移。Dafny 證明直接約束的是形式表示及其 compile-back 鏈條。
- API 對應與環境假設:符號替換 deterministic,但保證延伸仍以抽象符號和真實 API 語意一致為條件。作者會把環境假設用 runtime
expectchecks 暴露;這些檢查在更大的未驗證程式中依然要正確部署。 - 安全與任務成功是不同規格:robotics 0/20 功能保留顯示,若成功條件缺席或太粗,修補器會偏好不行動的安全程式。加入的 task-specific condition 只是 steering constraint,並非本研究證明的通用任務成功保證。
- 評估範圍與樣本數:只有 20 個 robotics tasks,且評測環境為模擬器;terminal 使用 100 個抽樣 benchmark cases。這些數據不能估算部署場景的事件盛行率,也未建立硬體、作業系統或 API 版本全面適用。
- 成本帳不完整:Table 3 不含初始程式生成與 domain semantics 一次性建構成本;作者也使用研究期間特定模型及 token 價格。要估計實際組織的總成本,仍要納入人工審查與正式維護。
- 獨立重跑未建立:論文內的 independent safety/functionality checks,是作者實驗設計中獨立於 proof agent 的檢查,不代表另一個研究團隊重跑了整項 benchmark。
Artifact 與可重現性
截至 2026 年 10 月 5 日,arXiv 提供 v1 PDF、HTML 和 TeX source,本文引用的 Figures 1–2 依頁面所列 CC BY 4.0 重用。arXiv record 和論文本文沒有連結公開實作、可直接執行的完整 benchmark 套件或 reproduction bundle,因此讀者可取得論文材料,但尚不能僅憑 paper page 重跑 MAGS 的完整 220-task 實驗。本文的 220/220、82/100、資源成本與功能保留數均是作者報告;沒有在此獨立重現。
若後續釋出 artifacts,複現至少需要固定論文所列模型版本、Dafny/Boogie/Z3 設定、各領域凍結規格、來源任務、compile-back mapping、agent-call retry budget、held-out tests 與安全 oracle。只重跑公開的一小段 CUDA sample、或只確認證明能編譯,不能等同完整實驗重現。預印本若出現版本更新,新的實驗/附錄應重新比對,再決定本文數字是否沿用。
Bloss0m 工程判斷:把安全聲明附上規格範圍
以下是 Bloss0m 工程化整理,不是作者測試過的部署配方。採用類似流程時,可把保證寫成一個可稽核的範圍句:「此輸出在某版本 frozen semantics、Dafny 工具鏈、符號映射及明確環境假設下,通過所列 safety properties。」同時單列外部 oracle 的覆蓋與未通過案例,避免一個綠色 proof badge 遮掉語意不一致。
- 適用情境:錯誤後果高、領域 API 穩定而且可由專家審核,程式可以映射到足夠明確的形式狀態,且組織能承擔建置及維護 semantics 的成本。
- 先做 domain gate:版本化每份 API semantics 與 safety requirements;記錄來源、人工審查、正反 probe 和已知外部 oracle mismatch。規格更新後重新驗證相依程式,不要讓逐案 repair agent 偷改合約。
- 讓證明與行為測試各司其職:正式 proof 支持對 frozen spec 的性質;差異化的安全 oracle 測語意覆蓋;held-out functional tests 測有限輸入上的行為保存。三者應分開呈現,不把其中一項當作另一項的代用品。
- 檢查邊界轉換:核對 source-to-Dafny translation、API symbol replacement、編譯器版本和 runtime assumptions。語意映射改變時,重新審核其 proof chain。
- 不宜使用時機:若 API 高度動態、專家無法審查安全規格、真實意圖無法描述,或一個樣本等待 36–68 分鐘且花費約 9–10 美元不能接受,MAGS 目前的證據不足以讓它成為通用生成器。先縮小範圍建立可驗證語意,並為拒絕/修補後的人工作業留明確流程。
文章最重要的工程區分是:證明 frozen specification 解決的是「這個形式模型中的程式是否遵守明確條件」;證明真實意圖與現場安全 還需證明條件本身覆蓋目標、映射正確且任務仍有用。MAGS 把第一件事自動化到值得研究的程度,並以失敗案例提醒第二件事不會自動跟著完成。
讀完後的三個記憶點
- 方法:先建立、稽核並凍結可重用的 domain semantics,再由多代理轉譯、規劃證明、依 verifier feedback 修補,最後編譯回目標語言。
- 證據:220/220 表示所有 benchmark samples 取得 Dafny 核可,不等於所有輸出都通過外部安全與功能檢查;terminal 是 82/100,robotics 在額外任務約束後功能保留為 11/20。
- 界線:形式保證的對象是明確規格及工具鏈假設;API semantics、翻譯、真實意圖、部署環境和效用仍需要分開驗證。
延伸閱讀
- Who Holds the Pen? Let Specifications, Not Agents, Sign Off:延伸閱讀規格與 Agent 權限如何分離。
- Loopjacking: 人類核准如何失去操作綁定:檢視核准決策和最終執行效果之間的產品信任邊界。
- Agents Are Systems, Not Models: Agentic Evaluation:討論 Agent 評估應如何涵蓋完整系統,而非只讀模型能力。
Primary sources
- Wu, A., Roberts, N., Huang, T.-H., Lin, H., Friedman, G., Cho, S., Orlanski, G., & Sala, F. (2026). MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs, arXiv v1; full HTML.
- arXiv v1 PDF and CC BY 4.0 license.