論文精讀
Agents Are Systems, Not Models 精讀:Agent 評測不能只看模型分數
原文:Agents are systems, not models: Rethinking agentic evaluation
90 秒掌握論文
- 問題:Agent benchmark 常把系統當成固定的一個模型設定,報一個成功率就結束;但實際上,任務資訊、模型、工具、推理狀態、時間和驗證方式都會改變 Agent 行為,而且同一設定重跑也可能不同。
- 核心洞見:評估單位應是可配置的 Agent 系統。作者在四個 AI4Science 任務中控制五個設定軸,並把「有沒有完成」、「完成後是否高於最低有效門檻」、「離專家模型表現多遠」、「花多少成本」和「是否知道自己做得如何」分開觀察。
- 最強證據:在三個可定義 gap-closed 的任務裡,給 Agent 更多具體任務資訊是效果最大的設定軸,且排名在 bootstrap 樣本中至少 99% 居首;主實驗每個任務 432 組設定、每組重跑五次,共 8,640 次。
- 主要邊界:約 54% 的分數變異是同一設定的有效重跑差異,說明單次分數很不穩;但實驗只涵蓋天文學與基因體學中的四個 specialist-model 使用任務,並不涵蓋一般 agent benchmark、長期多 Agent 協作或產業工作流程。
這篇論文不是在比較「哪個模型最強」,而是在問:要讓一個模型操作科學專家模型,究竟應該改模型、補資訊、留住推理、要求驗證,還是給它更多時間?作者固定任務與工具環境,系統地改變五個設定軸,再看完成率、分數、波動、成本與自我評估如何一起變化。結果最反直覺的部分,是資訊提供的影響普遍大於換大模型或延長時間;而同一設定重跑的噪音又大到足以讓一次 benchmark 成績誤導人。
本文依據 2026 年 10 月 1 日提交的 arXiv v1 預印本。作者在論文中承諾釋出程式、benchmark 與 18,240 條軌跡;截至 2026 年 10 月 3 日,公開 GitHub README 仍寫著完整程式與 benchmark 即將釋出,並連到軌跡資料集。因此以下實驗數字仍是作者報告結果,不是本站獨立重跑或外部驗證。
問題從哪裡來:固定模型分數掩蓋了可配置系統
模型 benchmark 常在固定 prompt、固定工具或單次執行下比較模型。這種方式有其用途:若問題是純文字問答、上下文和推理設定已經固定,模型間分數差異可以是一個清楚訊號。但 Agent 不只是模型輸入與輸出的映射。它會循環讀取狀態、呼叫工具、觀察結果,再決定下一步;執行迴圈由 harness 控制,包含工具介面、上下文處理、記憶、政策與資源限制。只換 backbone,或只報一次任務成功率,很容易把其他設定造成的差異算到模型頭上。
作者要補的不是一個萬用「Agent 智商分數」,而是較窄也較能控制的問題:當 Agent 必須找到並正確操作一個已發表的 specialist model 時,哪些設定會改變它的效果和可靠度?專家模型有公開論文與參考表現,研究者可以將 Agent 的輸出和這個基準比較;同時 Agent 還得自行找資料、準備輸入、寫程式與執行模型,讓工具操作失誤也能被觀察。
這個選擇也定義了論文的外推邊界。它接近研究程式碼重現與工具操作評測,不是讓 Agent 自由提出假說、設計新實驗或完成整個研究專案。論文的貢獻是把設定差異拆開測,而不是證明目前 AI 已能自主做科學。
核心直覺:Agent 是模型、harness 與可變設定共同構成的系統
論文用「model」指 backbone 本身:沒有跨呼叫記憶,也不會自行採取動作。Agent 則將模型包在反覆行動的 loop 中:讀取當前狀態、選擇動作、執行工具、讀取結果,然後繼續或提交答案。Harness 是承載這個 loop 的執行基礎設施,負責派送工具呼叫、管理每一步模型看到的上下文,並可包含記憶或壓縮邏輯。因此真正被評估的對象不是孤立的模型,而是某個模型在一組 harness 與設定之下的系統。
論文把可配置性拆成五軸:
| 設定軸 | 實驗中改變什麼 | 工程上代表的問題 |
|---|---|---|
| Information | 從不額外提示、只說 specialist 身分、補上介面,到提供完整任務 protocol | Agent 是不知道有工具、找不到怎麼載入,還是缺少解題步驟? |
| Reasoning | 不顯示推理、每步推理但不保留、保留跨步推理(ReAct) | 中間計畫留在上下文,對後續行動有沒有幫助? |
| Verification | 不提驗證、口頭要求檢查、回報預期分數及證據、明確要求通過檢查才提交 | 只改指令能否改變實際驗證行為? |
| Budget | 5、10、20 分鐘的牆鐘時間 | 多給時間會讓 Agent 深入推理,還是只多跑無效工具? |
| Model | 三種不同規模的 Qwen3.5 backbone | 換大模型帶來的提升,是否大過補足資訊或調整執行方式? |
Information 和 Verification 是累加式層級:例如 interface 會在 identity 之上,再提供如何載入及呼叫 specialist;protocol 再加入特定任務的完整操作配方。Reasoning 也不是「推理越多越好」的單軸:act-only 完全不產生推理,think-act 每步產生但不把舊推理留到下一步,ReAct 則把推理保留在上下文。這些層級讓讀者可以問的問題更精確:究竟是知道工具名稱、知道使用方法,還是得到可直接操作的程序,造成了結果差異?
用 redshift-estimation 走完整個方法
想像 Agent 收到 20 張星系影像,要預測它們的 cosmological redshift。Benchmark 允許它讀取檔案、抓取網頁、執行 terminal 命令、寫程式,環境裡放著 AstroCLIP 等 specialist model 的權重和預建環境。模型不是一個可以直接呼叫的「答案 API」;Agent 得辨認專家模型、準備影像輸入、載入模型、執行程式,最後輸出連續預測值。評分用 與光譜觀測值比較。
完整流程是:
- 輸入任務:相同任務敘述與輸出格式交給不同設定的 Agent。Information 軸決定它額外知道多少 specialist 使用資訊。
- 選擇路徑:Agent 要決定是否使用 AstroCLIP、要不要先讀 README、如何將影像轉成模型要求的形式。
- 執行並觀察:它以檔案與命令工具操作模型;錯誤輸出會回到上下文,Agent 可修正程式或輸入。
- 提交預測:Agent 在時間預算內呼叫 finish 工具提交答案;逾時則未完成,不能把它當成普通的零分答案混為一談。
- 比對並分類:評分器將預測與任務資料的參考值、專家模型結果和簡單基線比較;另判斷該次輸出是否比 trivial score 高出任務特定 margin,算作有意義的嘗試。
- 跨設定重跑:相同設定重跑五次,再和其他 Information、Reasoning、Verification、Budget、Model 組合比較。
最可能的失敗點不只有數學或模型精度。若 Agent 沒先把影像預處理成正確格式、下載錯誤模型、寫錯呼叫程式,或在預算耗盡前沒提交,整條流程仍會失敗。論文的重跑分析也發現 redshift 任務尤其不穩:主設定中完成率為 76.3%,但已完成執行裡有 53.8% 未通過有效嘗試門檻。這使「完成」、「做得比 trivial baseline 好」和「接近 specialist」三種狀態不能被一個分數混成一類。
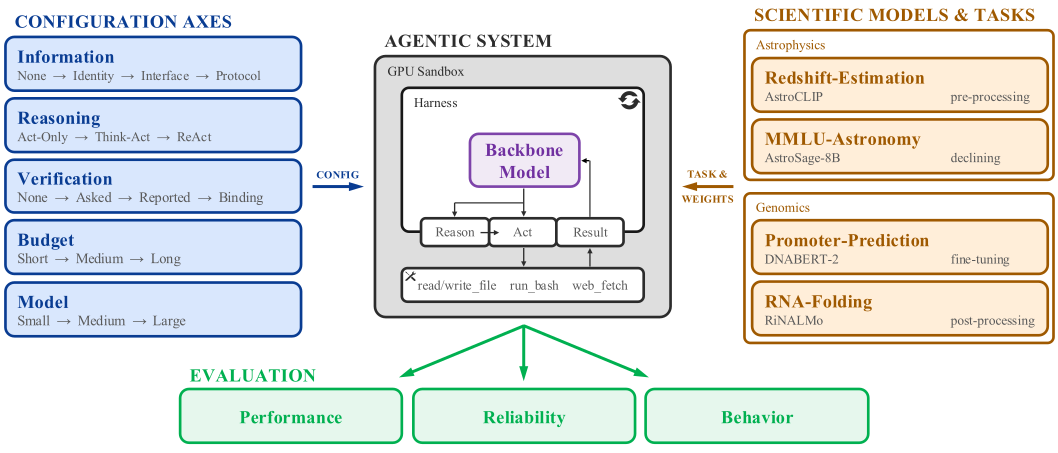
原論文 Figure 1,依 CC BY 4.0 重用。圖中是作者的 benchmark 架構;它支持「哪些元件受控、Agent 要操作什麼」的理解,不代表每個任務都使用相同 specialist 或每次都能完成。來源:arXiv v1, Figure 1。
指標在回答不同問題:完成、有效嘗試與 gap closed
理解結果前,先把論文三個分數分開。令 為 backbone 不經 Agent loop、直接回答任務時的分數; 是作者在 benchmark 環境重現的 specialist model 參考分數; 是 Agent 的分數。對 specialist 明顯強於 backbone 的 gap-positive 任務,作者定義 gap closed:
若 ,代表沒有比 backbone 本身更好;若 ,代表追上 specialist 參考分數。超過 1 則表示超過該參考,負值表示比 backbone 還差。這個正規化只在 gap-positive 任務上有意義。mmlu-astronomy 是 gap-negative:一般 backbone 其實比 AstroSage 強,所以該任務要量的是 Agent 是否能拒用較弱 specialist,不能硬套 gap-closed 公式。
此外,finish 工具被呼叫以前若時間用盡,這次 run 是 incomplete;完成後也不保證有實質進展。因此論文再設 hurdle :輸出必須超過 trivial score 加上一個任務專屬 margin,才算 genuine attempt。hurdle failure rate 的分母是已完成 runs,不是全部排程 runs。如此才能區分「沒交答案」、「交了但只是 trivial」和「至少有有效嘗試」,再分析有效嘗試的分數與波動。
方法與實驗設計:432 組設定乘上重跑,而不只挑一個好看的最佳值
在三個 Qwen3.5 backbone 上,主實驗每個任務完整遍歷 4 種 Information × 3 種 Reasoning × 4 種 Verification × 3 種 Budget × 3 種 Model,共 432 個 cells;每個 cell 重跑五次,單一任務 2,160 次,四個任務共 8,640 次。這是主實驗,不是論文全部的 18,240 筆軌跡。其餘來自另一個開放權重 Step-3.7-Flash grid、Claude Sonnet 5 對照,以及兩組提供 oracle 的完整設定。論文 Appendix Table 4 將總數拆成 8,640 + 1,920 + 2,880 + 2,880 + 1,920 = 18,240。
這套規模仍有成本。附錄指出開放權重模型在 H100 GPU 上以 vLLM、FP8 量化執行,規模不同會配置 1、2 或 8 張 GPU;Claude Sonnet 5 透過 API 使用。論文報告每次 run 的估計 API/運算成本、牆鐘時間、工具呼叫和錯誤,但這些不是任一團隊都會付出的固定費率。把它當作成本量測框架,比把某個美元數字直接套進自己的環境更合理。
四項任務涵蓋兩個領域、三個 gap-positive 專家任務和一個 gap-negative 選擇任務:
| 任務 | 領域/資料 | Specialist | 指標 | 關鍵操作或判斷 |
|---|---|---|---|---|
| redshift-estimation | 天文;20 張星系影像 cutouts | AstroCLIP | 影像前處理後預測連續 redshift | |
| mmlu-astronomy | 天文;152 道選擇題 | AstroSage-8B | Accuracy | specialist 已弱於 backbone,Agent 應考慮直接作答 |
| promoter-prediction | 基因體;613 條人類 DNA 序列 | DNABERT-2 | Matthews correlation coefficient(MCC) | 定位、前處理、fine-tune,再操作模型 |
| rna-folding | 基因體;300 條 RNA 序列 | RiNALMo | 結構層級 pairing F1 | 預測接觸後處理成有效二級結構 |
同一固定策略不可能適用所有任務:有些任務應找更強的專家,有些要 fine-tune;另一些情況下,正確行為反而是不要使用已落後的專家。這也是為什麼這組 benchmark 不只比模型輸出,而是把 Agent 找模型、理解介面和操作模型的過程納入評估。
結果一:同一設定重跑的噪音,足以淹沒設定差異
Figure 2 將 cell 內重跑差異與 cell 間設定差異分開。若只把所有已完成 run 放進方差分解,跨設定差異解釋約 39.4% 的變異;但一些 run 雖有提交,實際上沒有高過 trivial hurdle,少數差勁輸出會大幅放大 cell 內變異。作者因此也單獨看通過 hurdle 的 genuine attempts:這時設定差異解釋 46.1%,剩餘約 53.9%(論文摘要取整為約 54%)仍是同一設定重跑的差異。
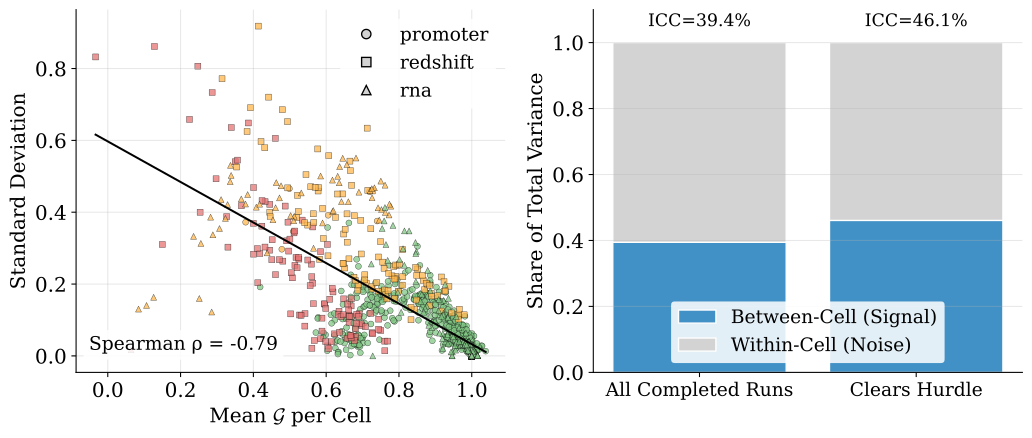
原論文 Figure 2,依 CC BY 4.0 重用。右圖的 54% 是三個 gap-positive 任務去除任務平均後、限於 hurdle-clearing runs 的方差分解;不能讀成所有 Agent 任務恰好有 54%「天生隨機」。左圖顯示高分 cell 的標準差較小,意味表現與穩定度也可能一起變化。來源:arXiv v1, Figure 2 and Appendix A.3。
另一個容易忽略的細節是完成本身也有波動。四個任務共 80.7% runs 完成、19.3% 因時間用盡沒有提交。主實驗裡,RNA folding 完成率只有 61.7%,redshift 為 76.3%;在某些組合中,五次重跑可能全部完成、只完成一部分,或一次都沒完成。Appendix Figure 5 將每個 cell 完成數及 95% 信賴區間半寬畫出來,提醒「每組只跑一次」沒有能力估計穩定度;但即使五次,部分 cell 的區間仍寬。
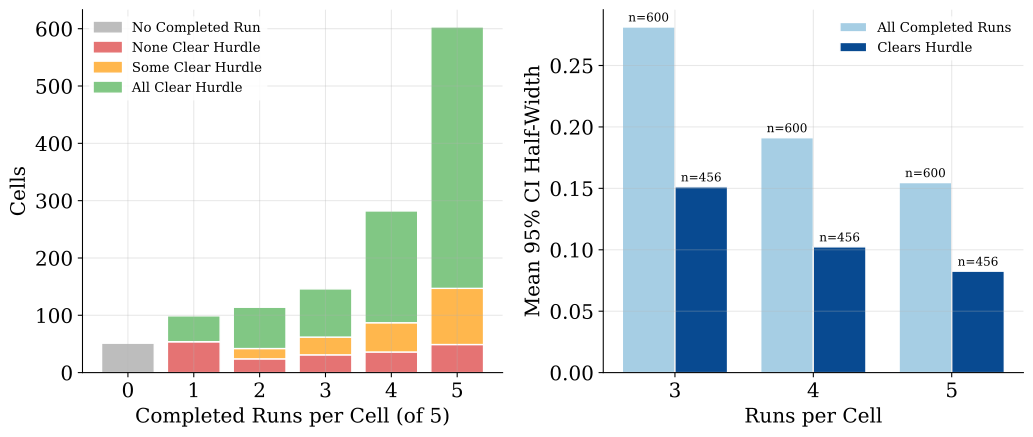
原論文 Appendix Figure 5,依 CC BY 4.0 重用。左圖統計三個 gap-positive 任務每個 cell 五次執行中完成的次數;右圖比較有無 hurdle 篩選時,均值 95% CI 半寬。這張圖支持的不是「五次就足夠」,而是 completion rate 與不確定性應和分數一起報告。來源:arXiv v1, Appendix A.4, Figure 5。
看數字時最重要的對照
| 問題 | 論文觀察 | 解讀邊界 |
|---|---|---|
| Agent 有沒有交答案? | 四任務完成率約 61.7%–95.3%;整體 80.7% | 完成不等於高於簡單基線,也不等於專家水準 |
| 有效嘗試是否一致? | 三個 gap-positive 任務合併後,hurdle-clearing runs 仍有約 54% 分數變異來自同 cell 重跑 | 不是單次分數比較就能判斷設定 A 必然勝過設定 B |
| 哪些任務特別不穩? | redshift 完成後的 hurdle failure 約 53.8%,outcome consistency 約 0.727;promoter-prediction failure 約 0.5%,consistency 約 0.986 | 可靠度依任務而異,不能把平均值套給每個工作負載 |
| 五次是否足以穩定估計? | 有些 cell 的 95% CI 仍寬,且 redshift 仍有顯著重跑差異 | 應依決策風險與預期效應規劃更多重跑和區間,而非把五次當通用標準 |
作者對 run-to-run noise 的處理相對嚴謹,但 54% 也不是跨 benchmark 的通則。它依賴任務、hurdle 定義、所選配置與作者的 pooled 分析方式。有效門檻會影響哪些 run 被納入,研究附錄也做 margin 敏感度分析;讀者若要比較自己的 Agent,應保留未完成與未通過 hurdle 的紀錄,而不是只挑能產生漂亮數字的 run。
結果二:資訊比「再換大一點模型」更常是首要槓桿
作者把每個設定軸對 的影響定義為該軸不同層級的平均分數範圍,再以 cell 內標準差標準化;這是 effect-size 排名,不是因果識別,也不是所有任務共用的百分點增益。Table 3 中,在三個 gap-positive 任務,Information 都排第一;其平均名次 1.00,而 Model 平均名次 2.67,Reasoning 3.00,Budget 3.33,Verification 5.00。以 1,000 次 bootstrap 重抽樣,Information 在至少 99% 抽樣中仍居首。
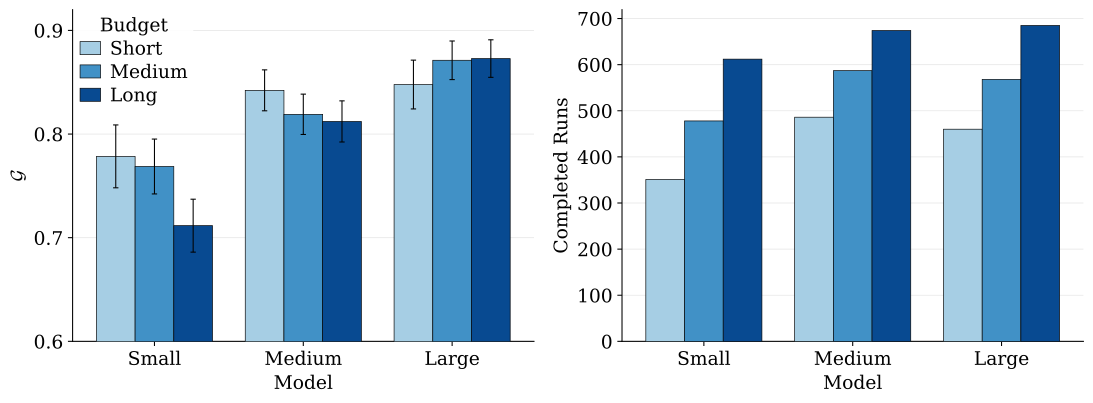
原論文 Figure 3(a),依 CC BY 4.0 重用。此處比較的是 gap-closed 與不同 Model × Budget 組合的完成數,誤差線為 95% CI;它顯示交互作用,而非「時間完全無用」。來源:arXiv v1, Figure 3(a), Section 4.2。
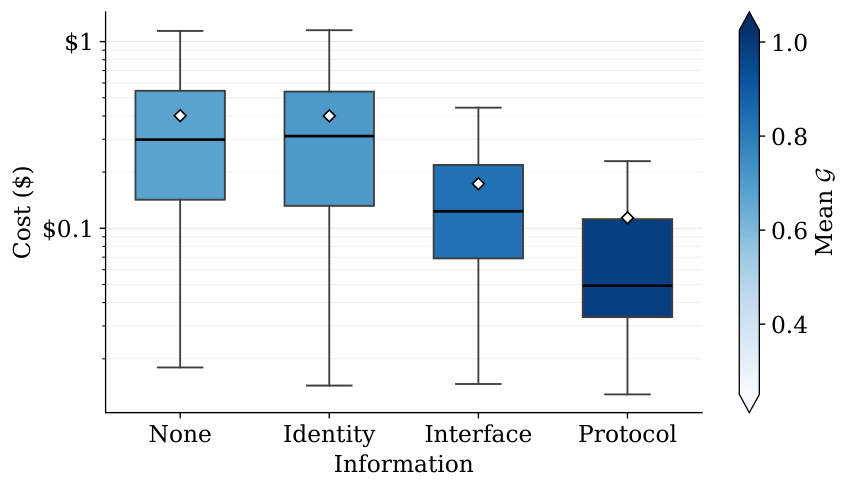
原論文 Figure 3(b),依 CC BY 4.0 重用。圖將 Information 各層級的成本分布和平均 放在一起;成本採作者的估算,硬體、模型費率、prompt caching 與部署條件不同會改變實際金額。來源:arXiv v1, Figure 3(b)。
Information 軸的排序值得注意,因它不是把論文全文一口氣塞進 prompt。四級資訊逐層增加:知道任務所屬 specialist 的 identity;再得知如何載入和呼叫它的 interface;最後才拿到 task-specific protocol,也就是操作這個任務的完整配方。這讓 benchmark 能分辨 Agent 的瓶頸是「不知道存在這個模型」、「知道模型卻不會用」,還是「有 API 但缺正確資料前處理及任務程序」。在 Figure 3(b),更多資訊和較高平均 同時伴隨較低成本;作者另報告 protocol 層級也降低 runtime 和校準誤差。這並不代表每一種資訊都免費或所有任務都可先驗寫成 protocol,而是說用無效探索讓 Agent 自己摸索,可能比給它足夠上下文更慢、更貴、結果也更差。
時間不是免費的能力倍增器
Figure 3(a) 最好的工程讀法不是「小模型沒有必要給時間」,而是「時間只會放大系統已經具備的方向」。在三個 gap-positive 任務合併分析裡,更多預算對 large backbone 可以同時提高完成與 gap-closed;對 small 和 medium model,較長時間可能只增加完成次數,平均 反而降低。附錄的 redshift × Information × Budget 分析更明確:資訊為 none 時,從短預算加到長預算,平均 由 -0.429 降到 -0.713;資訊到 protocol 時,三種預算平均 都是 0.753。這是此 benchmark 的數據,不宜解讀為 20 分鐘普遍比 5 分鐘差;它指出了「沒有知道下一步做什麼,只延長執行」可能讓 Agent 延續低效策略。
資訊與 backbone 的作用也有交互:給大模型更多時間可能值得,但小模型延長預算不一定;提供介面或完整步驟,則可能讓時間轉成有用行動。工程上要測 interaction,不要拿五個單因子平均排名就決定 production 配置。若要做快速迭代,可以先記錄在固定硬體與版本下的 completion、有效門檻、答案品質、token/API 成本、牆鐘時間與重跑方差,再以同一工作負載比較配置。
結果三:要求 Agent「自己驗證」,不等於系統真的驗證
Verification 軸在五個設定因素中的 score effect 排名最後。當作者只用 prompt 從「不檢查」一路強化到「直到自己相信為止才提交」,reference-based verification 的比例只從 19% 升到 22%;大約四分之三 run 只檢查輸出格式,而非把答案和外部標準比較。若 Agent 被問「你檢查了嗎」,它可能檢查的是 JSON 欄位、格式或自己重讀一遍,而不是答案是否正確。
作者接著提供一個 system-level oracle tool:Agent 可隨時把目前提交內容送去和 benchmark 參考解比對。這個工具會讓兩種測試 backbone 在所有任務的分數提高,並明顯降低 calibration error;參照式驗證比例約增加至原先三倍。這也有代價:Agent 多呼叫工具,成本和 runtime 每個對照情況都上升。作者另檢查 Agent 是否反覆呼叫 oracle 逐步猜出正解;這種 hill-climbing 出現在 4.4% runs,排除後結果差異很小。
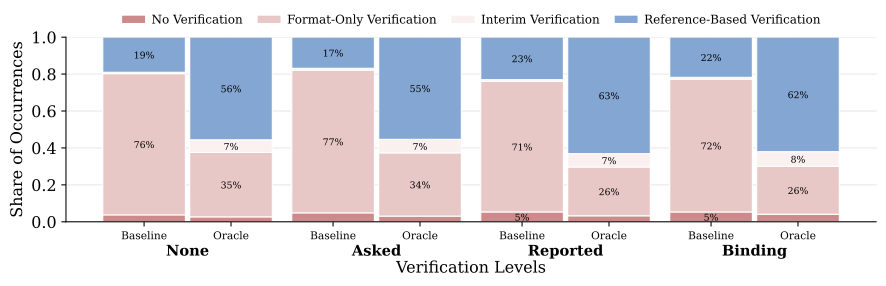
原論文 Figure 4,依 CC BY 4.0 重用。分類由軌跡分析而來;加入 oracle 時,部分增加自然來自 oracle 呼叫本身,不能全解讀為 Agent 形成了內在審慎。來源:arXiv v1, Figure 4, Section 4.3–5。
這個結果支撐的是一個有限但很有用的設計建議:如果正確性很重要,不要只在 system prompt 裡說「請小心檢查」。提供可查證的測試、reference sample、schema、沙盒或任務專屬 verifier,讓正確行為成為可呼叫的系統能力。可是 paper 只直接測了 oracle 對「驗證」這一種行為,不能直接推出所有行為(像安全、拒答、引用或偏好遵循)都能靠系統工具解決。
一個重要反例:Agent 不一定會拒絕較差的 specialist
mmlu-astronomy 是 gap-negative 任務。這裡的 AstroSage-8B 參考 accuracy 為 0.671,backbone 自己答題的 accuracy 為 0.967;理性策略應該是不要依賴較弱的專家。然而 99.8% runs 還是使用 AstroSage,平均 accuracy 0.685,接近 specialist 而遠低於 backbone。即使有 oracle,整體表現也沒有大幅改善。
作者提出的可能原因包括:Agent 將「專家模型」視為一定比較好,或探索不夠、從未拿 backbone 自己作答來比較。這只是可供後續研究的解釋,不是論文明確識別出的因果機制。它仍揭示 benchmark 設計上的一個重要點:工具被列出、能成功呼叫,不代表使用工具就是好選擇。評測應同時包含適合使用專家模型、需要 fine-tuning 的任務,以及專家落後時必須拒用的任務,否則 Agent 可能只學到「找到模型就呼叫」的表面流程。
額外診斷:模型家族與設定不可直接互換
作者用 Step-3.7-Flash 增加另一個開放權重模型家族,並以 Claude Sonnet 5 作為閉源 API 對照。兩個開放權重模型都將 Information 排第一;但 Claude Sonnet 5 的排序不同,Budget 成為最強的設定軸,Information 居次。這表示「資訊比預算重要」是主實驗及特定跨模型對照中的總體發現,不是所有 backbone 的固定規則。部署者應在實際模型與工具環境下重測。
Sonnet 5 的工具呼叫次數少於 Qwen-397B-A17B,工具錯誤約為五分之一、校準也較佳,但按論文 list price 計算成本更高,pooled 反而較低。這組結果再次說明,效率、錯誤數、單次任務成本和任務品質是不同維度,不能用一個「模型比較聰明」的敘述涵蓋。價格會隨快取、費率與硬體而變;表中的估算只適合解讀該實驗條件,不是採購報價。
論文也對 18,240 條軌跡做行為分類。流程先由 DeepSeek-V4-Flash-0731 judge 逐條描述六個面向(整體結果、根因錯誤、專家模型使用、驗證、規劃探索、執行品質),再用 Sentence-BERT 與 HDBSCAN 聚類,最後由 judge 協助命名及合併類別。這有助於從得分追問 Agent 怎麼失敗,但仍是以模型 judge 為中心的軌跡分析,不等同人工專家逐筆建立的真值標籤;分類結果適合找模式,不應被當成無誤差的心理狀態診斷。
證據地圖:哪些主張被支持,哪些還是開放問題
| 主張 | 論文證據 | 可以支持的結論 | 仍不能支持的結論 |
|---|---|---|---|
| 單次 Agent 結果常不穩 | Figure 2、Appendix Figure 5;同一 cell 五次重跑、hurdle 與方差分解 | 這四任務需要回報重跑波動、完成和區間,單次 run 不足以可靠排序 | 所有實際 Agent 工作都會有 54% 方差,或 5 次重跑已經普遍充分 |
| 交付更多任務資訊有用 | Table 3 與 bootstrap;三個 gap-positive 任務 Information 居首 | 在該 benchmark 中,任務 protocol、模型介面等資訊是比調大 backbone 更值得先測的設定 | 資訊永遠比模型能力更重要;各類資訊在任何領域都同樣有效 |
| 時間和模型能力會交互 | Figure 3(a)、Appendix Figure 6、Table 9 | 預算是否有用,取決於 Agent 是否知道怎麼做以及模型能否利用時間 | 無資訊時加時間必定降低品質,或長時間執行在任何情況都無效 |
| 系統提供 verifier 勝過只靠提醒 | Figure 4、Section 4.3、Appendix Table 12 | 在兩個模型和這些任務中,oracle 改變了參照式檢查與分數;代價是更多工具呼叫、時間與成本 | 任一自動 verifier 都能解決 correctness,或驗證行為已被普遍證明可由系統層解決 |
| Agent 未必知道何時不要用工具 | mmlu-astronomy 的 specialist accuracy、backbone accuracy 與 99.8% 使用率 | 這個 benchmark 中,多數 run 沒拒絕較弱 specialist | Agent 一般都會盲從專家,或結果證明某一種 authority bias 是原因 |
Artifact 與可重現性:軌跡可追,完整 runner 尚待補齊
截至 2026 年 10 月 3 日,arXiv v1 可公開讀取,GitHub repository 存在,但 README 表示完整程式碼和 benchmark 即將釋出;README 同時連到 Hugging Face 上的 agentic-science-trajectories。論文稱釋出 18,240 條 trajectory 及產生的 artifacts,但資料連結與完整 benchmark runner 是不同交付物。讀者目前可從論文、README 和連結資料探索研究,不應因此假設已能一鍵重建所有模型環境、專家模型安裝、GPU 設定、oracle 實驗與每項分析。
本篇未安裝模型、執行 benchmark 或重新分析全部軌跡。文章內的結果均為作者報告;沒有獨立團隊重跑的證據。論文宣稱完整程式與使用說明將釋出,若讀者準備重現,應先確認 repo 後續是否補齊 runner、基準任務、資料處理腳本、依賴版本、硬體說明和 oracle 配置,再把重現範圍逐項記錄。軌跡可用來重新分析部分行為,不等於可以從頭重跑實驗。
主要限制與可能的替代解釋
- 任務外部效度有限:只有四項任務、兩個科學領域,而且重點是操作既有 specialist model。結果是否適用於一般 coding agent、RAG、browser agent、長期記憶、多代理協作或真實研究者工作流程,尚未測試。
- 設定與任務程序被研究者設計:各任務、information protocol、hurdle margin、reference score 都需要明確化。換成另一種任務設計、資料難度或 specialist 品質,可能改變各軸排序。
- 完成與分數是兩層選擇:只有提交的 run 才有 score;gap-closed 只定義在 specialist 強於 backbone 的任務;有效嘗試又以 hurdle 篩選。這些分母必須保留,不可把不同子集的數字直接比較。
- 重跑次數仍有限:每一設定五次,作者同時指出部分 cell 的信賴區間仍寬。54% 的估計會依 pooling、hurdle 和可完成的樣本而變。
- 設定排名會受模型家族改變:開放權重 Qwen/Step 與 Claude Sonnet 的排序不同。這提醒我們將跨模型結果當成重新測試的起點,而非固定最佳實務。
- 行為分類不是完整因果解釋:以 LLM judge + clustering 分析 trace,可擴大可讀資料量,卻也可能受抽取 prompt、embedding 和聚類標籤影響;作者沒有聲稱其分類是人工校準後的普遍心理 taxonomy。
- 資料可用不等於計算可負擔:多個大型模型、GPU、每個 grid 的 API 費率和 specialist 環境,會限制獨立複製的速度與成本;公開軌跡降低行為分析門檻,不能替代原始 runner。
Bloss0m 工程判斷:把穩定性和「何時不該用 Agent」列進驗收
這篇研究最值得採用的不是「每個 Agent 都要把 protocol 全寫進 prompt」,而是它揭示評估應同時量哪些層次。若團隊只把原先單次成功率改成另一個單次成功率,仍沒有解決重跑雜訊。對有風險或昂貴的工作,建議在固定任務、模型版本和資源限制下至少追蹤:
- completion rate 與 timeout,而非將未提交工作默認當成普通答錯;
- 超過 trivial baseline 或任務 acceptance gate 的比例;
- 品質分數與可信區間/多次重跑變異;
- verifier 覆蓋率、參照式檢查率及誤放行/誤拒絕;
- 平均成本、長尾成本、牆鐘時間、工具呼叫與工具錯誤;
- Agent 拒用低品質 specialist、fallback 到 backbone 或升級人工的能力。
這是一套從本文證據推出的部署建議,不是作者已在企業系統驗證的完整標準。不適用條件也應寫清楚:若任務無可信驗收答案、輸入分布每天變動、oracle 會洩漏真實答案、或任務涉及模型沒有資格判斷的高風險決策,論文中的量測方式不能直接照搬。尤其 oracle 在實驗中能看見 benchmark reference,生產系統常只有不完整 validation set;較弱的 verifier 不應被包裝成相同程度的保證。
如果要把研究轉成團隊實驗,可以選一項已有可接受參考答案的任務,固定資料、工具版本、硬體和預算,先重複基準配置,再單獨改 Information 或 Verification,最後加入預算 × 模型的交互條件。開始前先定義 completion、最低可接受分數與失敗分類;結果同時報告分子、分母、區間與資源耗用。若新設定只提升完成率,卻沒有提升品質;或有較高均分、但重跑失敗更常見,決策者就能看見真正的 trade-off,而不是被最高分吸引。
讀完後的三個記憶點
- 技術概念:Agent 能力是 backbone、harness、任務資訊、工具與資源設定的組合;benchmark 應測系統,而不只測模型名稱。
- 證據結果:在這四個 AI4Science 任務中,資訊提供的 effect ranking 居首;同一配置有效重跑仍有約 54% 分數變異,提示式自我驗證只小幅增加 reference checking。
- 採用邊界:上述結果是四項受控 specialist-model 工作流的作者報告,不是普遍 Agent 定律;完整 benchmark runner 尚未釋出,也沒有獨立重跑。
Primary sources
- Wiedmann, Luis; Girrbach, Leander; Schmid, Cordelia; Akata, Zeynep. “Agents are systems, not models: Rethinking agentic evaluation”, arXiv:2610.01618v1, submitted 2026-10-01. Full text and Figures 1–5, licensed CC BY 4.0.
- Authors’ public repository and linked agentic-science-trajectories dataset. Repository README’s stated release status is summarized as of 2026-10-03.