論文精讀
Stale-Document Poisoning 精讀:RAG 如何辨識已失效的證據
原文:Stale-Document Poisoning: When Outdated Retrieval Overrides Correct Model Answers
本文依據 2026-09-25 提交的 arXiv v1;來源標示 CC BY 4.0,peer-review 狀態未由來源確認。論文 v1 問的不是「模型會不會受錯誤文件影響」這個一般問題,而是更貼近長期 RAG 維運的問題:模型本來答對時,一份真實、曾經正確、但已不再適用的檢索文件,能否把答案翻錯?
90 秒掌握論文
- 問題:檢索能補上模型過時的知識,但知識庫本身也會過時。若舊文件仍然相關、來源可信,而且內容曾經成立,模型是否會在沒有辨識有效期的情況下照著舊建議回答?
- 核心洞見:作者把「文件說了什麼」與「文件何時仍適用」分開操弄。一般 poisoning 實驗只計入模型先在無檢索條件答對、之後被舊文件帶錯的項目;時間適用性控制則固定同一份歷史證據,只改問題所處日期。
- 最強證據:跨域開放模型測試的條件式 poisoning 為 17%–91%,但這不是所有問題的錯誤盛行率。50 題控制顯示,日期本身的適用性差距在四個模型上只有 0.04–0.14;加入清楚的有效期間後,兩個大型模型差距升至 0.94–1.00。Figure 2 與 Figure 3 呈現這兩種不同證據。
- 主要邊界:大型模型可在提示直接給出有效邊界時切換答案,不等於它們能從任意真實文件自動推導正確的法律、醫療或軟體適用期間。reranker 的收益也以可信日期為條件。
論文故事:既有 RAG 評估常把外部證據視為補充模型的資訊;但一份具權威來源的舊指引會同時保有高相關性與歷史可信度。作者建立帶有官方來源與有效期線索的知識反轉集合,先量模型是否被舊文件推翻,再用固定證據的日期配對排除內容差異,最後以 activation patching 測試有效性資訊是否能因果影響答案。結果顯示,模型容易服從當前證據,卻不會穩定地把「文件日期」轉成「此刻是否適用」;錯誤日期也能破壞檢索端補救。這把 RAG 的問題從找出相關材料推進到判定它今天是否仍有權威性。
先分清三種不同的失敗
論文把 stale-document poisoning 定義成一種 retrieval-induced failure:項目 i 的 timely answer 是目前有效答案,舊證據 dᵢ 支持曾經正確但已被取代的答案;只有當同一模型在沒有檢索時答對、加入舊證據後卻不再給出 timely answer,這個項目才算 poisoned(Section 2,Equation 1)。因此它不是單純問答錯誤,也不是只要檢索到舊文件就自動算一次失敗。
它也不同於 adversarial poisoning 或 indirect prompt injection。那些設定通常著重攻擊者如何製造、放置或操縱內容;本研究的核心文件可以是官方、真實而且曾經適用的材料,不需要攻擊者、不需要偽造,也不必包含指令。危險來自適用條件改變後,系統仍把舊內容當成現在的依據(Section 1)。這個區分不表示真實文件一定安全:真實性回答「來源是不是它所聲稱的來源」,時間適用性回答「這條主張現在是否仍支配此問題」,兩者是不同屬性。
第三種也要分開:模型權重可能尚未學到新事實,這是 outdated parametric knowledge;本文的主指標卻刻意排除無檢索時已答錯的題目,觀察外部舊證據如何覆蓋同模型原來的正確答案。作者另外比較 medical settled 與 recent reversals,發現 recent 題較難,但兩組是不同問題,因此仍可能有題目難度差異。這只能支持「近期反轉較難」,不能完全識別純粹時間效應(Figure 2a、Appendix D)。
既有方法為什麼不夠:發布日期不等於適用期間
只依相關度排序,可能找到與問題高度匹配、但已不再支配目前問題的文件。發布日期表示文字何時出現,不會自動給出建議的生效或撤回時間。這個缺口正是論文設計 validity-controlled comparison 的理由;它不表示應該一律丟棄較舊文件。
核心直覺與概念骨架:相關性、日期、適用性不是同一欄
這篇論文的概念核心不是發明時間推理演算法,而是把三個容易混成一團的問題分開:檢索到的文件是否與問題相關、文件何時發布,以及文件中的建議在問題所問的時間是否有效。第一個是檢索匹配;第二個是文件屬性;第三個需要來源、規則與時間共同支持。若某項政策在 2022 年發布、於 2024 年修訂,單看「2022」既無法證明它今天仍有效,也不能告訴我們它何時失效。
Section 2 以兩個量化對象表達這個差異。對模型 m,Eₘ 是它在沒有 retrieved context 時答對的題目集合;poisoning rate Pₘ 的分母是 |Eₘ|,分子是其中在舊文件加入後不再回答 timely answer 的題目。時間適用性子集另以 Rₘ(v) 表示舊答案率,其中 v=1 代表文件仍在已驗證的有效期間,v=0 代表已 superseded;applicability gap Gₘ=Rₘ(1)-Rₘ(0) 越大,表示同一證據在有效與失效兩個時間點之間,模型越能調整對它的依賴。
這兩個量不能互換。Pₘ 衡量檢索造成多少既有正確答案翻轉;Gₘ 則以固定的歷史文件配對不同評估日期,衡量同一內容何時應該被信任。前者建立問題確實存在,後者把內容變動從時間適用性中隔離。作者把這類行為連到 selective epistemic trust;本文將它譯作「選擇性證據信任」,是解釋性概念,不是一個已實作的通用模組。
Figure 1 的簡化示意指出,模型無檢索時已有正確的 timely prior;過時文件進入後,輸出端對 timely answer 的 margin 才明顯下滑。即使中途出現 instruction directive,neutral retrieval 下也觀察到 poisoning;加上 follow directive 會再提高風險。與此相對,matched current document 在這組醫療實驗中有 97%–100% 被採用。這個對照說明結果不是「模型不會用檢索」,而是模型的服從尚未可靠地依照證據是否仍適用來選擇。
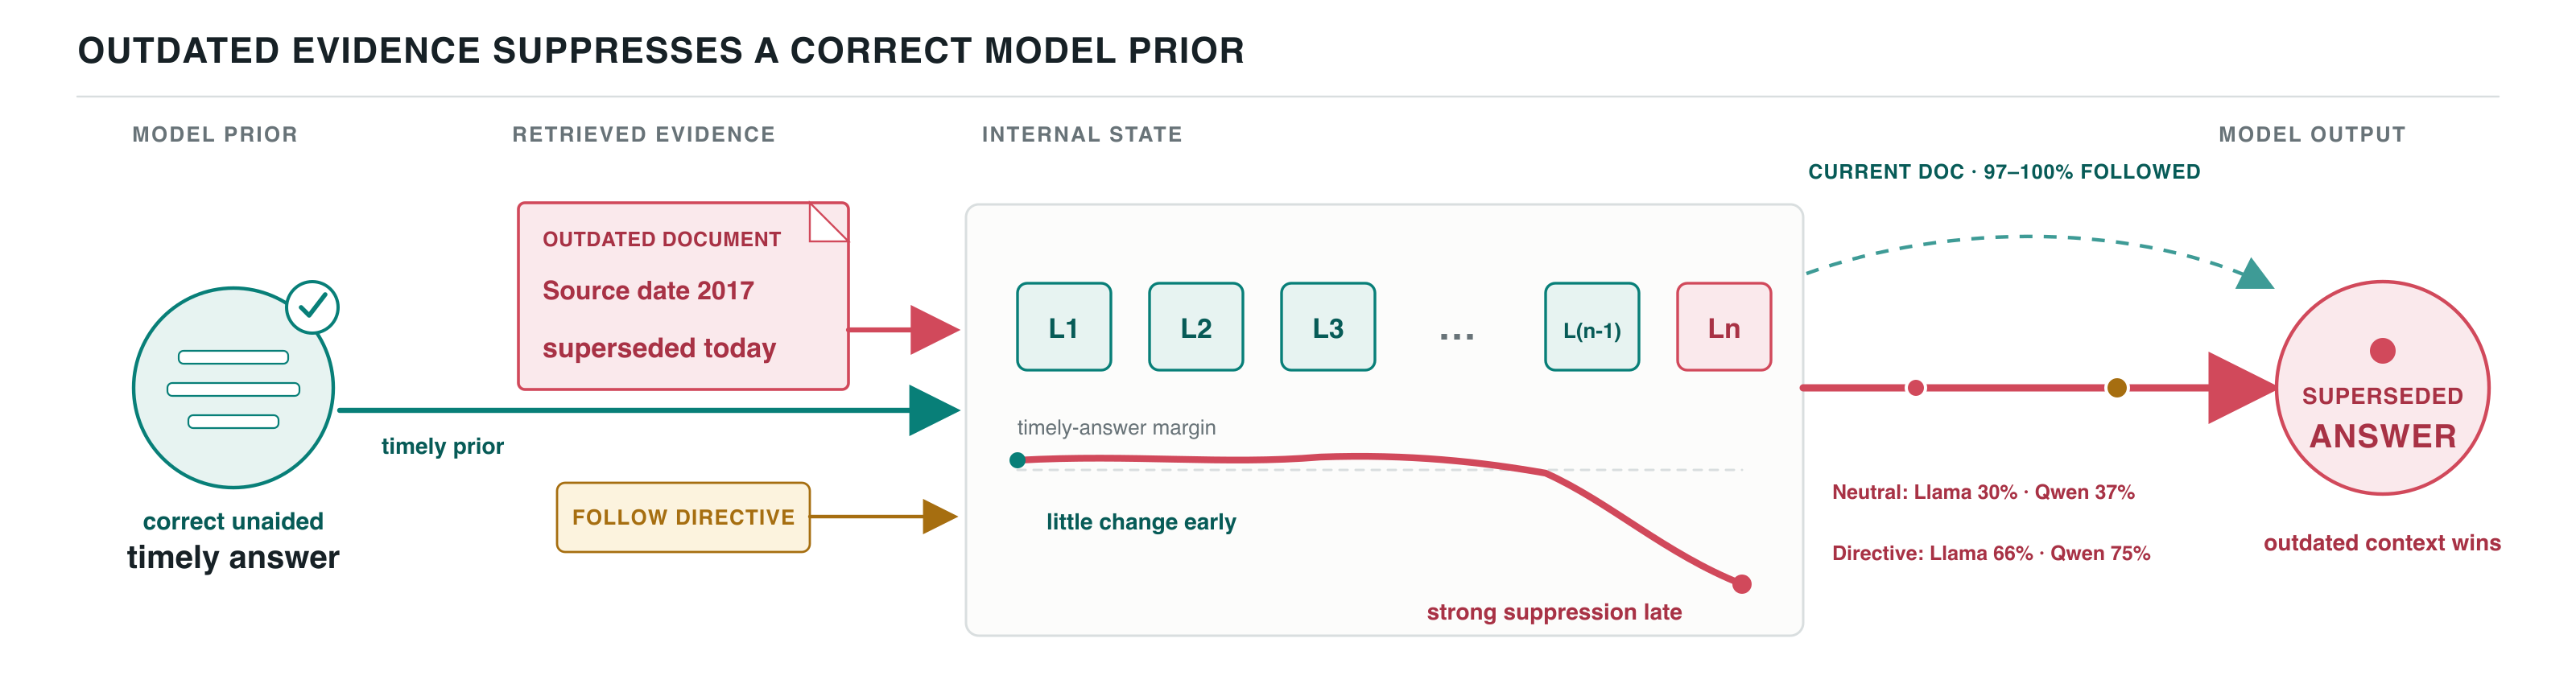
Figure 1(Section 1,概念圖):注意 timely prior 保持到較後層才被明顯壓低,neutral retrieval 已足以改變答案,而 follow directive 會放大問題;matched current evidence 則是重要對照。原圖連結:arXiv v1 Figure 1。原作者圖像,依論文頁標示 CC BY 4.0 重用。
端到端逐步例子:從一個反轉題走完整個測量與方法流程
可以把論文的一個 benchmark item 抽象成「某項官方建議從舊答案改成新答案」;實際題目依官方來源及領域建立,這裡只描述測量結構,不虛構未核實案例。
- 建立反轉對:研究者記錄問題
qᵢ、目前 timely answeryᵢ*、過去曾成立的yᵢold,並各自連到支持它的日期化官方來源。舊文件和更新文件格式相同,主要差異在建議內容及其效力是否已被取代(Section 2、Appendix A)。 - 先測無檢索基準:模型先回答問題,不給外部文件。只有答對
yᵢ*的題目進入Eₘ。若模型本來就答錯,後續不能把它記為「檢索把正確答案害錯」;該題不進 poisoning 分母。 - 加入舊證據:讓同模型看見支持
yᵢold的真實歷史文件,再以固定參考答案把回覆判成 timely、superseded 或 unclear。任何未判成 timely 的回覆都納入主 poisoning outcome;補充分析也另檢查排除 unclear 後的結果(Appendices C、J)。 - 配對當前證據:在醫療 87 題上改放 matched up-to-date document。這一條件幫忙確認模型不是全面拒絕檢索:四個模型在 87 題全部給 timely answer,Qwen-7B 與 Llama-8B 各為 86/87;對無檢索時原本答錯的子集合,更新證據恢復率為 97%–100%(Appendix E)。
- 隔離時間因素:在 50 題有清楚官方有效邊界的子集中,保留同一問題、選項、指令與歷史文件,只改 evaluation date,一次放在證據仍有效時、一次放在已失效後。再比較只有日期、明示文字邊界、明示表格邊界三種呈現(Section 2、Appendix F)。
- 測試內部因果影響:在行為上符合預期的最多 20 題/大型模型子集中,把有效日期提示位置的 internal state 複製到配對 prompt,並做反向、self-patch 與 unchanged source-date 對照;這用來測資訊能否改變答案傾向,不是部署中的生成介入(Appendices G–H)。
可能的失敗點也沿著這條鏈發生:官方來源頁面可能無法完整封存;外部發布日期可能和建議生效日期不同;判斷 supersession 需要解讀上下文;模型可能只在明確的二選一格式下切換;retriever 即使找對內容,仍可能把錯誤時間欄位當排序訊號。基準的來源驗證降低部分不確定性,卻沒有讓這些維運問題消失。
基準與判定方式
Knowledge reversal benchmark 共 317 題:醫療 87、法律 100、軟體/API 60、平台政策 70。每題有官方來源 URL,固定版 benchmark 讓後續結果不會因資料集改版而暗中改變;未來更新可加入新版本,但不改動本文凍結的 evaluation snapshot(Section 2)。論文以 12 個模型做醫療 recent-versus-settled 分析:六個 API 模型與六個開放權重模型,規模約 4B–72B;跨四領域的主要 poisoning grid 則用 Qwen2.5 與 Llama 3.1 的 7B/8B 和 70B/72B 版本。Figure 2 的 (a) 與 (b) 不是同一組題目,也不是 pooled rate。
自由文字回答由自動 judge 依固定 timely、superseded、unclear 標籤分類。作者以兩條方式檢查 judge:不同模型家族的第二個 judge 對七個模型的 840 份醫療回答重判,Cohen’s κ 為 0.93;另有四領域分層抽樣的 200 份回答,由兩位外部 PhD 學生盲標,48 個初始分歧再交由另一位盲化 adjudicator 裁決。自動 judge 對最終人類標籤的 accuracy 是 92.5%(95% CI 88.9%–95.9%),macro-F1 是 0.894(95% CI 0.836–0.941);區間以 152 個底層 benchmark items 群集 bootstrap 估計(Appendix C)。這讓自動標註有可量化的校驗,但仍有分類誤差,不應把 benchmark 標籤當成逐項無誤的人類真值。
醫療頁面中只有 39/87 個官方頁面成功自動封存;其餘仍保留來源 URL 與 capture status。非醫療 460 份 snapshots 通過作者報告的來源、時間有效性、重複與封存完整性檢查(Section 2、Appendix A)。這些是 artifact audit 的結果,不等同於外部專家已重新判讀每項臨床或法律內容。
結果一:近期反轉更難,舊文件能推翻原本正確答案
Figure 2a 比較模型在 settled 與 recent medical reversals 上的無檢索表現。十二個模型在多年以前已定型的項目多接近天花板,近期反轉則下降;例如 Qwen-7B 為 0.61、Llama-8B 為 0.64、GPT-4o 為 0.76、Claude-Opus-4.5 為 0.87。多重比較校正後 10/12 個模型仍有顯著差距。不過兩組題目本身不同,作者承認殘留難度差異無法排除,而且分析限於醫療(Figure 2a、Appendix D)。這是模型知識更新困難的背景證據,不是 stale-document poisoning 主指標。
Figure 2b 的跨域 poisoning 結果只計入每個模型各自無檢索答對的項目。指示模型跟隨文件時,四個模型的逐領域比例介於 0.167 和 0.906。例子包括 Llama-3.1-70B 在醫療 58/64(0.906),Qwen2.5-72B 在醫療 47/55(0.855);相較之下,軟體/API 格最低可到 7/42(Llama 70B)。法律、政策格也不是低風險的常數:Qwen-7B 法律是 34/55(0.618),政策是 20/37(0.541)。這些分母因模型無檢索正確率而變動,故 17%–91% 描述的是所測模型、所測條件下的條件式比例,不是所有 RAG 查詢的估計盛行率(Appendix E,Table 5)。
中性「已檢索文件」設定下,醫療比較中的 Llama 與 Qwen poisoning 為 30% 與 37%;當 prompt 明確要求遇到衝突時 follow 文件時,升至 66% 與 75%。在四格 factorial 中,使用 neutral header 時 follow 指令讓 Qwen 的比例從 0.37 升至 0.75(n=51,OR 4.92,95% CI 2.59–9.34),Llama 從 0.30 升至 0.66(n=53,OR 4.50,95% CI 2.46–8.23);兩個模型各有 19 題變錯、沒有題目改善(精確 McNemar p=3.8×10⁻⁶)。加上 follow 指令後,僅把 header 稱為「most current」未再帶來可檢出的效果(Section 3.4、Appendix K)。這支持指令壓力會放大本實驗的服從,不代表所有產品 prompt 都有同等效應。
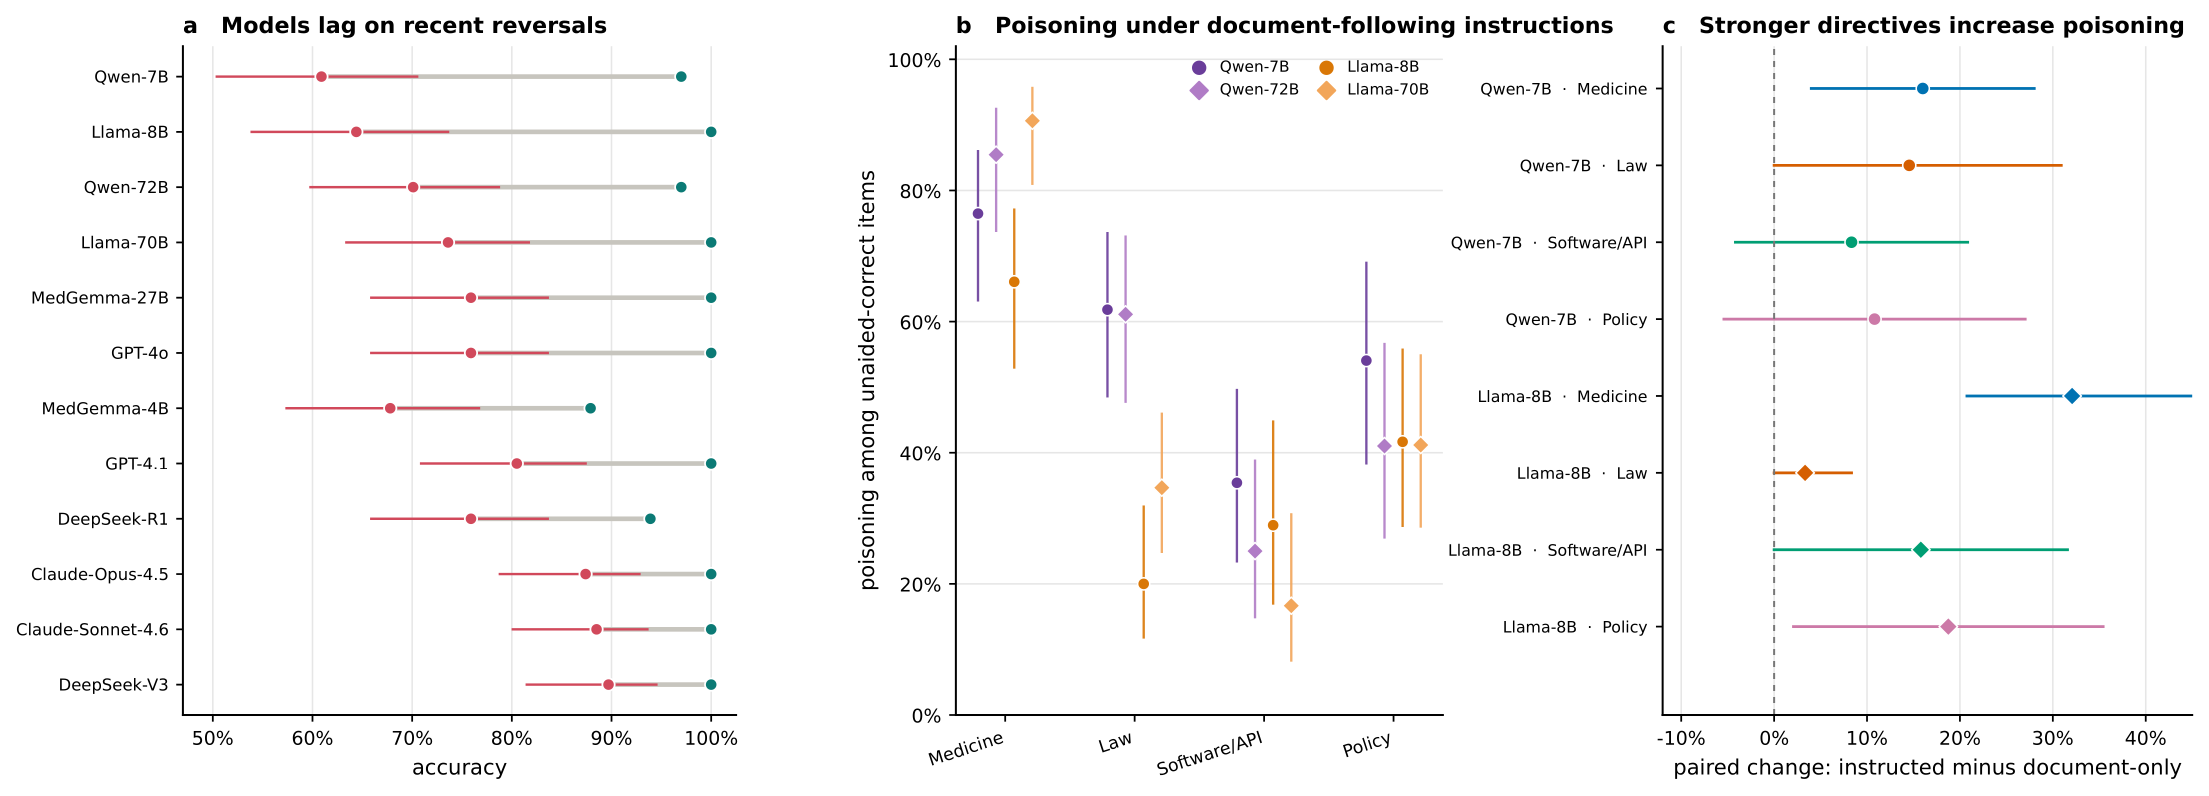
Figure 2(Section 3.1,行為結果):(a) 醫療 settled/recent 無檢索正確率;(b) 四領域 poisoned rate;(c) instruct 減 document-only 的配對變化。讀圖時要保留每格不同的 eligible denominator,不能將右兩個 panel 概括成普遍 prevalence。原圖連結:arXiv v1 Figure 2。原作者圖像,依論文頁標示 CC BY 4.0 重用。
結果二:日期不是有效期間
若 Figure 2 的 current 與 outdated 文件分別支持不同建議,還可能是內容差異讓答案翻轉,而不是模型真的理解「何時適用」。Figure 3 及 Appendix F 專門處理這個混淆:50 個由來源驗證、具有明確適用界線的反轉項目中,同一份歷史證據、問題、選項與指令在有效日期和 superseded 日期重複呈現,只有 evaluation date 改變。再把日期資訊用三種格式提供:date-only、明示 prose validity boundary、表格 validity boundary。這 50 題含 21 題 frozen set、12 題 replication、17 題 extension;四模型各跑 600 個條件格,主分析採 neutral instruction,使用固定 parser,不依賴自由文字 judge(Appendix F)。
Date-only 的 applicability gap 在 Qwen-7B、Llama-8B、Qwen-72B、Llama-70B 依序是 0.06、0.04、0.12、0.14;大型模型略高,但差距仍有限。明示有效邊界後,Qwen-72B 在 prose 與 table 都有 50/50 次舊答案到新答案的必要轉換;Llama-70B 在 prose 為 47/50,在 table 為 50/50。相同兩個模型的 date-only 相應計數只有 6/50 與 7/50。依 gap 定義,四模型的 prose/table 邊界在大型模型為 0.94–1.00,小型模型則中度改善:Qwen-7B 0.18/0.42,Llama-8B 0.30/0.28;區間採 item-clustered bootstrap(Figure 3、Appendix F,Table 7)。
這組結果更像「明確規則能讓部分模型套用比較能力」,而不是「模型具有可靠的時間感」。提示直接告訴模型舊建議在哪天停止適用,遠比只放來源日期提供更強條件;真實工作系統仍需要人或程序先從權威來源辨認這個邊界,並保證 metadata 正確。Figure 3 左側的 Windows support 例子用來展示控制格式,不代表所有政策文件。
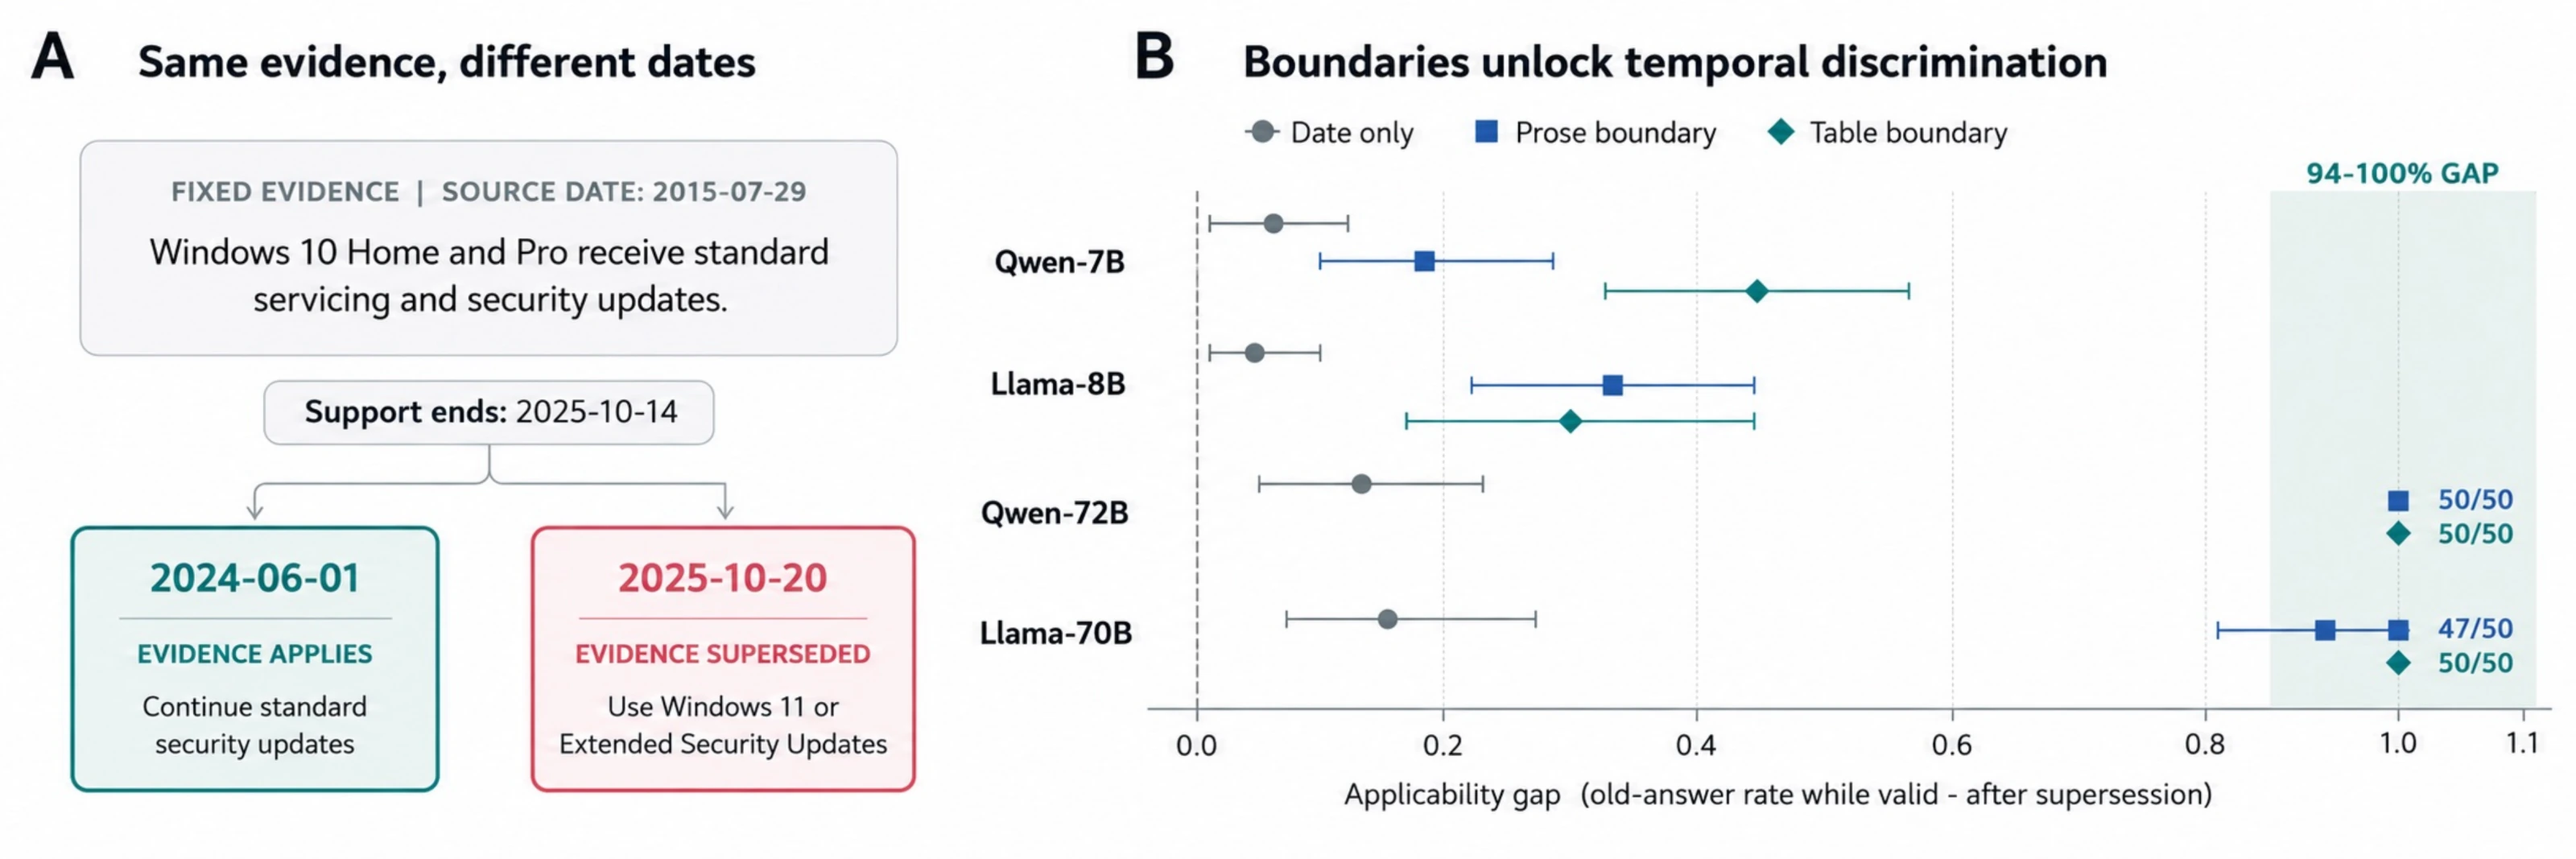
Figure 3(Section 3.2、Appendix F,temporal-applicability control):左側固定歷史內容、只改評估日期;右側對照 date-only 與 prose/table 邊界的 applicability gap。重點是明示「support ends」與僅列日期不是同一訊號。原圖連結:arXiv v1 Figure 3。原作者圖像,依論文頁標示 CC BY 4.0 重用。
結果三:有效性資訊會到達決策,但沒有證明專屬時間電路
作者在 Qwen-72B 與 Llama-70B 上做雙向 activation patching:把 valid-date prompt 在 evaluation-date span 的 internal state 移入 stale prompt,再反向交換;另外對 unchanged source date 和 self-patch 做控制。每模型最多 20 題,且限於先呈現預期 logit preference 的行為合格項目,因此估計的是具資格題目上的機制效果,不是所有 50 題或自由生成任務的平均行為(Section 2、Appendix G)。
在第一層的完整 residual state 交換,Qwen-72B 的答案偏好移動 23.08 logits(95% cluster-bootstrap CI 21.06–25.53),Llama-70B 移動 7.82(6.92–8.65);反向 patch 會把偏好往相反方向帶。patch 到不變的 source-date 位置只有 0.04 和 0.03,self-patch 幾乎為零。沿層追蹤時,效應在後段逐漸進入決策表徵;作者報告 attention 是早期較明顯貢獻者,候選 heads 先在 10 題 discovery set 挑選,再凍結到另一個 10 題 confirmation set 測試(Appendices G–H)。
重要的負面界線是:這些 heads 也參與一般日期比較與非時間數值門檻任務。作者因此不主張它們是專屬 temporal circuit;較有支持的解讀是,共用的比較—決策路徑包含與 temporal validity 有關的部分。confirmation set 只有每模型 10 題,因果介入也使用明確選項與 logit margin;它不能直接證明 production RAG 自由生成時模型會以相同路徑運作。這項機制證據回答「明示的有效性資訊能否直接影響答案」,沒有回答「模型能否自行找到可信的有效期來源」。
診斷分析:失敗模式、子群與檢索成本
Section 3.5 和 Appendix N 評估一個固定、沒有依測試結果調權的 hybrid reranker。每個 retrieval set 有一份 current 與兩份 outdated 文件;dense retriever 先取 top four,再依下式排序:
其中 cos(d,q) 是語意相似度,r(d) 是該索引內 document year 的 min–max 正規化,I_sup 在文件明示 supersession 時為 1。這是論文測試的固定 heuristic,不是可普遍辨認 validity 的完整模型。Dense baseline 使用 all-MiniLM-L6-v2;下游生成的 poisoning 比較集中於醫療和法律的 Qwen-7B、GPT-4o(Appendix N)。
日期正確時,四個 downstream cell 都下降 4.6–10.0 個百分點,但只有三格精確配對檢定達 p<0.05:法律 Qwen 0.640→0.540(p=.0129)、法律 GPT-4o 0.700→0.610(p=.0225)、醫療 GPT-4o 0.621→0.529(p=.0215);醫療 Qwen 0.609→0.563(p=.125)。日期缺漏時,三格改善只有 1.0–4.0 點且皆未顯著,另一格反而惡化 1.1 點。更值得留意的是,日期錯誤時 reranker 在四個領域挑中 current document 的比例都降到零,低於 dense baseline;排序規則會被錯誤時間訊號反向帶走(Appendix N)。
附錄先展示一個理想化 proof-of-principle:正確 metadata 下,簡單 recency rule 可把 GPT-4o 的 16/66 與 Claude 的 27/77 poisoning 降到零。但作者明確指出這不是較真實的防禦估計,不能取代具缺失或雜訊日期的後續檢驗(Appendix N)。工程問題不是「要不要加 recency」,而是索引年份、實際生效日、撤回日及 supersession link 由誰維護、錯誤率如何量測,以及何時停止使用不可信欄位。
證據地圖:哪些結論被支持,哪些仍是推論
| 論文中的觀察 | 支持的結論 | 仍不能推出 |
|---|---|---|
| 無檢索先答對的項目在舊文件加入後轉錯;current 文件在醫療對照中被 97%–100% 採用(Section 3.1、Appendix E) | 所測設定下,模型不是普遍不會用 retrieval;舊證據會選擇性破壞已正確回答 | 所有 RAG 查詢中有相同比例,或所有 current 文件都安全 |
| 317 題跨四領域;各模型分母依無檢索正確題數改變(Appendix E) | 此失敗跨所測四個領域與兩個開放模型家族出現 | 17%–91% 是真實世界 prevalence,或領域間可不加條件直接排名 |
| 50 題固定歷史 evidence、只改 evaluation date;日期與顯式 validity boundary 表現差距大(Figure 3、Appendix F) | 日期資訊與明示適用規則不是同一種輸入;提示明確規則能改善控制任務中的時間區辨 | 模型能獨立從未整理文件正確推導有效區間 |
| 雙向 activation patch 有效果,matched controls 接近零;選出的 heads 也支援一般比較(Appendices G–H) | 在有限、具資格的選項任務中,evaluation-date state 對答案選擇有因果影響 | 已找到專屬 temporal module,或自由生成部署行為已被定位 |
| 正確日期的固定 reranker 小幅降低四格 poisoning;缺漏與錯誤日期不同(Appendix N) | 可信時間欄位可幫助 retrieval-side filtering | 排序較新文件就足以防止失效證據,或 metadata 可以被假設正確 |
主要推論由作者明確連回 selective epistemic trust:只依相關度把內容交給模型,沒有處理內容何時仍適用。本文的工程化解讀是,RAG 評估至少要同時測「有效的新證據能否修正模型」與「已失效的舊證據會否傷害原本答對的模型」。這是根據本文兩種對照整理出的測試方向,不是已被 benchmark 驗證的完整上線檢查表。
限制與外推邊界
- benchmark 的外部效度有限:317 項是來源核實的知識反轉,不是從任意企業語料隨機抽出的過時文件。領域內題目及反轉類型不代表真實比例;醫療指引、判例、API 與平台政策的失效方式也不同。
- 分母不是固定 317:poisoning 的分母
Eₘ依模型與領域的 no-retrieval correctness 改變。四領域 grid 各格列出的 39/51、47/55、58/64 等,才是比例的實際分母;不能把比例解讀為全部 item 的錯誤率。 - 近期與 settled medical 對照仍有題目差異:兩組題目不同,雖然每個模型可作自身對照,難度差異仍可能殘留(Section 2、Appendix D)。
- judge 不是無誤標註:92.5% accuracy 與 0.894 macro-F1 是對 200 筆經裁決的人類標籤估計,區間以底層 152 題群集;κ=0.93 則是第二模型 judge 的一致度。兩種驗證回答不同問題,都不能把自動 judge 變成完整人工真值(Appendix C)。
- 時間控制是小而清楚的子集:50 題以明確有效期間篩選,使用 Qwen/Llama 四模型及二選一輸出。它告訴我們被明示的 boundary 能改變回答,不代表任意自然語言文件都帶有可解析 boundary。
- 機制樣本再窄一層:causal analysis 每個大型模型最多 20 個合格題目;head selection 的 confirmation set 每模型 10 題。這是控制任務的局部機制證據,不是完整 circuit map 或部署因果效應。
- reranker 靠 metadata:錯誤日期令 current-document selection 在所有領域降到零;研究沒有證明自動抽取的效期欄位在 production 能有足夠準確率,也沒有替臨床或法律適用性做外部審核。
- 重現條件仍不透明:Appendix P 列出環境檔、腳本、資料、per-run outputs、固定模型 revision 等,並記載主要 open-weight runs 用兩張 B200 GPU;但論文頁面和 arXiv 原始碼封裝沒有給出可直接取得該 release 的公開 repository/download URL 或 artifact license。來源 tarball 可下載,卻只包含論文 LaTeX 與圖檔,不等於實驗資料與程式 bundle。本文數值仍採作者報告結果,這篇閱讀沒有獨立重跑 benchmark。
可重現性與讀者可取得的材料
截至 2026-09-29,arXiv v1 HTML、PDF 與 source archive 可公開取得,論文頁標示 CC BY 4.0;使用的三張圖都在 source archive 中,Figure 1 是 PNG,Figure 2–3 是論文附帶的 PDF 圖檔,本文僅做格式轉換並保留原圖內容與出處。Appendix P 聲稱 release 含 benchmark items、官方來源 provenance、封存 snapshots、poisoning corpora、程式、每次 run 的 outputs、figure scripts 與模型 revision;然而未找到該實驗 bundle 的直接下載頁或授權條款,因此不能把它稱為已核實可下載或已獲授權的 dataset/code release。論文中的 requirement manifests 和硬體描述也不是 release endpoint。
本閱讀未重跑作者實驗。若 bundle 後續可取得,一個小型重現可以先選少量帶官方 supersession 邊界的配對,固定 query 與歷史文件,分別測 date-only、明示 validity interval,以及有/無 retrieval 的回答;保存每題的 eligibility denominator、檢索順位和判定標籤,並在計算 poisoning rate 前先報告 no-retrieval 正確題數。醫療、法律或政策建議的有效期間仍需獨立於模型 judge 的來源審查。
Bloss0m 工程判斷:把「適用性」變成資料治理責任
作者在 Discussion 建議儲存 explicit effective dates、supersession relations 或 validity intervals,並在 retrieval evaluation 同時測有效證據的修正價值與過時證據造成的傷害(Section 5)。以下是 Bloss0m 工程化整理,是把上述方向轉成系統問題,並非論文已測過的完整架構:
- 保存時間欄位的語義:區分發布時間、更新時間、生效時間、截止時間與撤銷時間。只要來源無法支持欄位,就保留未知或來源範圍,不要以文件年份填補。
- 記錄取代關係:讓新舊記錄可以互相追溯,保留歷史文件以支援「當時的規則是什麼」,但在回答現在問題時要能定位當前生效項目。存在新版本不代表取代關係已核准。
- 讓回答帶著時間條件:對會變動的指引,retrieval result 應可提供來源時間、適用範圍與有效邊界;回答可說明使用的生效版本,以及何時需要額外查證。
- 讓 reranker 具備 metadata quality gate:當日期缺失、互相衝突或來源信任不足時,不應假裝 recency score 是可靠訊號。本文固定打分式只證明正確日期下有小幅收益,日期錯誤能反轉排序方向。
- 雙向測試,不單向追求採用檢索結果:除測試 current evidence 能否救回 stale model knowledge,也測試舊 evidence 能否讓原本答對的模型改錯;同時報告 no-retrieval eligibility count、錯答與 unclear response。
何時不該直接採用:若語料沒有可靠的有效期與 supersession provenance,先做來源盤點與更新流程,不能只部署「越新越可信」的排序。若任務正確性依賴個案時間、司法管轄區、產品版本或政策適用對象,通用 publication date 不能取代這些條件。對高風險建議,本文結果能提醒系統設計時間有效性測試,不能當成臨床或法律建議,也沒有證明該 reranker 足以降低實務風險。
可延伸閱讀 Learning When to Trust 對選擇性信任的討論,再與 When Stale Constraints Go Unchecked 對照:後者關注 agent 如何從有限記憶驗證預算漏掉更新路徑;本篇直接操弄檢索到的歷史證據效期。兩者都涉及「舊資訊」,卻分別落在 memory verification allocation 和 retrieval evidence applicability,不應合併成一種機制。也可參考 RAG-Sieve 了解檢索內容投毒偵測;惡意注入的威脅模型與本文真實過時文件不同。
讀完後的三個記憶點
- 失敗定義:只有模型先在無檢索時答對、再被舊文件帶離 timely answer 才算本文的 poisoning;各模型分母因此不同。
- 主要區分:文件日期告訴系統何時發布;validity boundary 告訴系統建議何時適用。50 題配對控制顯示,明示後者遠比只呈現前者有效。
- 部署邊界:time-aware reranking 在日期正確時有小幅收益,日期缺漏時效果有限,錯誤日期會把結果反轉;時間 metadata 的品質本身是系統責任。
Primary sources
- Ahmed, Poech, and Röttger, Stale-Document Poisoning: When Outdated Retrieval Overrides Correct Model Answers, arXiv v1, submitted 2026-09-25. Main text Sections 1–6; benchmark and source capture in Appendix A; model revisions in B; judge protocol and validation in C; per-model and cross-domain outcomes in D–E; temporal applicability and causal interventions in F–H; prompt and status analyses in J–K; retrieval gate and stress test in N; frontier-model cells in O; reproducibility description in P.
- Full HTML · PDF · arXiv source archive