論文精讀
GameLogicBench 精讀:讓遊戲邏輯 Agent 經得起逐步執行
原文:GameLogicBench: Evaluating Coding Agents on Runtime Game Logic with Tick-Level State Assertions
90 秒掌握論文
- 問題:遊戲邏輯可能在某一刻違規、後來又回到看似正確的終態。只看能否編譯、固定示範影片或單一最後狀態,會漏掉執行途中發生的錯誤;由另一個語言模型評分,又會帶來判斷成本與重跑差異。
- 核心洞見:把正確性寫成可觀測遊戲狀態與事件歷史的逐 tick 斷言,再讓固定 judge 在多個評測者選定的場景及種子下重播。評測目標是可見行為,不要求 Agent 複製某份參考程式。
- 最強證據:72 個 Godot 遊戲邏輯任務含 403 個場景與 1,451 個測試案例;作者以正確解、保行為替代解、常見錯解與單一能力 mutant 校準 judge。移除終態以外的檢查或只測公開預覽場景,都會讓大量 mutant 通過。
- 主要邊界:最佳模型—scaffold 設定在一次封網評測中解出 52.78% 任務;這不是通用能力分數。研究限制於 Godot/GDScript、可確定判定的遊戲邏輯,不測美術、遊戲體驗、網路同步,也沒有證明與真實軟體專案成功率的外部效度。
作者從一個常見錯覺出發:程式能跑,不代表規則一路成立。GameLogicBench 將 Agent 寫出的機制放進 Godot 執行,再於每個模擬 tick 檢查其狀態是否符合契約;同一契約會在多個手工場景、種子變化及不同呼叫時序下反覆測試。作者的主要發現不是哪個模型「通關」,而是多數失敗提交其實能跑,只是沒有維持要求的遊戲行為;若 benchmark 少了逐步觀察、情境變化或 mutant 校準,分數就可能把錯誤解答算成成功。這提供一種嚴格評估執行中行為的設計,但仍是範圍明確的遊戲 benchmark。
本文依據 2026 年 9 月 21 日更新的 arXiv v2 預印本;論文目前未標示已通過同儕審查。以下數字均為作者報告,本文沒有獨立重跑。v2 沿用 v1 的 benchmark 主張與核心結果,並以目前版本標題及補充的限制說明為準。
從可執行到行為正確,中間還隔著整段時間
遊戲規則往往是狀態隨時間演進的約束。例如角色可跨越不高於指定高度的階梯,但不應把更高障礙當成階梯;碰撞、冷卻、跳躍與資源守恆也會牽涉多個物件及連續更新。若 Agent 只實作一段能編譯的程式,或只讓一個簡單預覽場景成功,評測未必知道它是否在不同方向、輸入順序、物件排列或同步呼叫中仍遵守規則。
論文將這個 gap 與幾種既有遊戲 benchmark 的設計作比較(§1、Table 1):有些使用固定測例或終態測試,有些以影片或視覺語言模型判分,另一些依賴 Agent judge 在互動後評分。作者指出這些方法未必同時具備三件事:多個評測者選擇的情境、每個任務都可檢查執行中的狀態,以及不含語言模型的確定 verdict。這是作者對 benchmark 設計空缺的定位;不等於證明其他測試方法都無效,或本文的組合已適用任何軟體領域。
GameLogicBench 把任務按整合範圍分三層,而不是簡單按「容易/困難」切級別:
| 任務層 | 工作內容 | 會增加的整合負荷 |
|---|---|---|
| Atom | 在專為 benchmark 建立的小遊戲裡實作一種機制 | 聚焦單一行為機制,作為能力測量的基本單位 |
| Combo | 在小遊戲中組合數種機制 | 規則要跨時間、空間與並行呼叫共同成立 |
| Repo | 在既有 Godot 專案中改動機制 | 必須理解異質子系統,並維持共享狀態上的全遊戲不變式 |
例如 Repo 任務要求重建角色移動控制器,同時保留其他元件依賴的介面。公開預覽只讓角色從 方向接近一階階梯;評測場景可能改為從 接近,並在階梯後安排一個高於允許上限的牆。規格沒有變,布局和輸入序列改了。只硬編碼預覽路徑的解答看起來能動,卻不是真正實作了「任何方向都能跨過允許高度、但不能把高牆當階梯」的規則(§2.1、Appendix F)。
核心直覺:檢查狀態軌跡,而不是猜作者採用了哪段程式
一個遊戲在離散模擬 tick 中更新狀態。GameLogicBench 的 judge 會在固定時間步運行遊戲,對狀態與事件歷史套用行為斷言。可把一次執行想成軌跡 ,其中 是第 個 tick 可觀察到的遊戲狀態。每個場景的契約不是指定唯一程式,而是要求軌跡中某些值、事件順序或守恆量滿足條件。評測器因此可以接受實作不同、可觀察行為相同的正確解,也可拒絕雖然能跑、卻違反契約的版本。
Agent 得到任務簡報與 Godot 專案,簡報說明行為和介面要求,也列出可修改檔案。它能執行遊戲、查看預覽並重播公開場景;但簡報不會列出所有計分情境或 judge 內部實作。評測者用同一介面,對多場景、多種子與合法呼叫排程執行提交解答。排程變體包括併發呼叫、重入與不同時間基準;它們改變執行情況,不改變必須遵守的行為(§2.1、§3.1)。
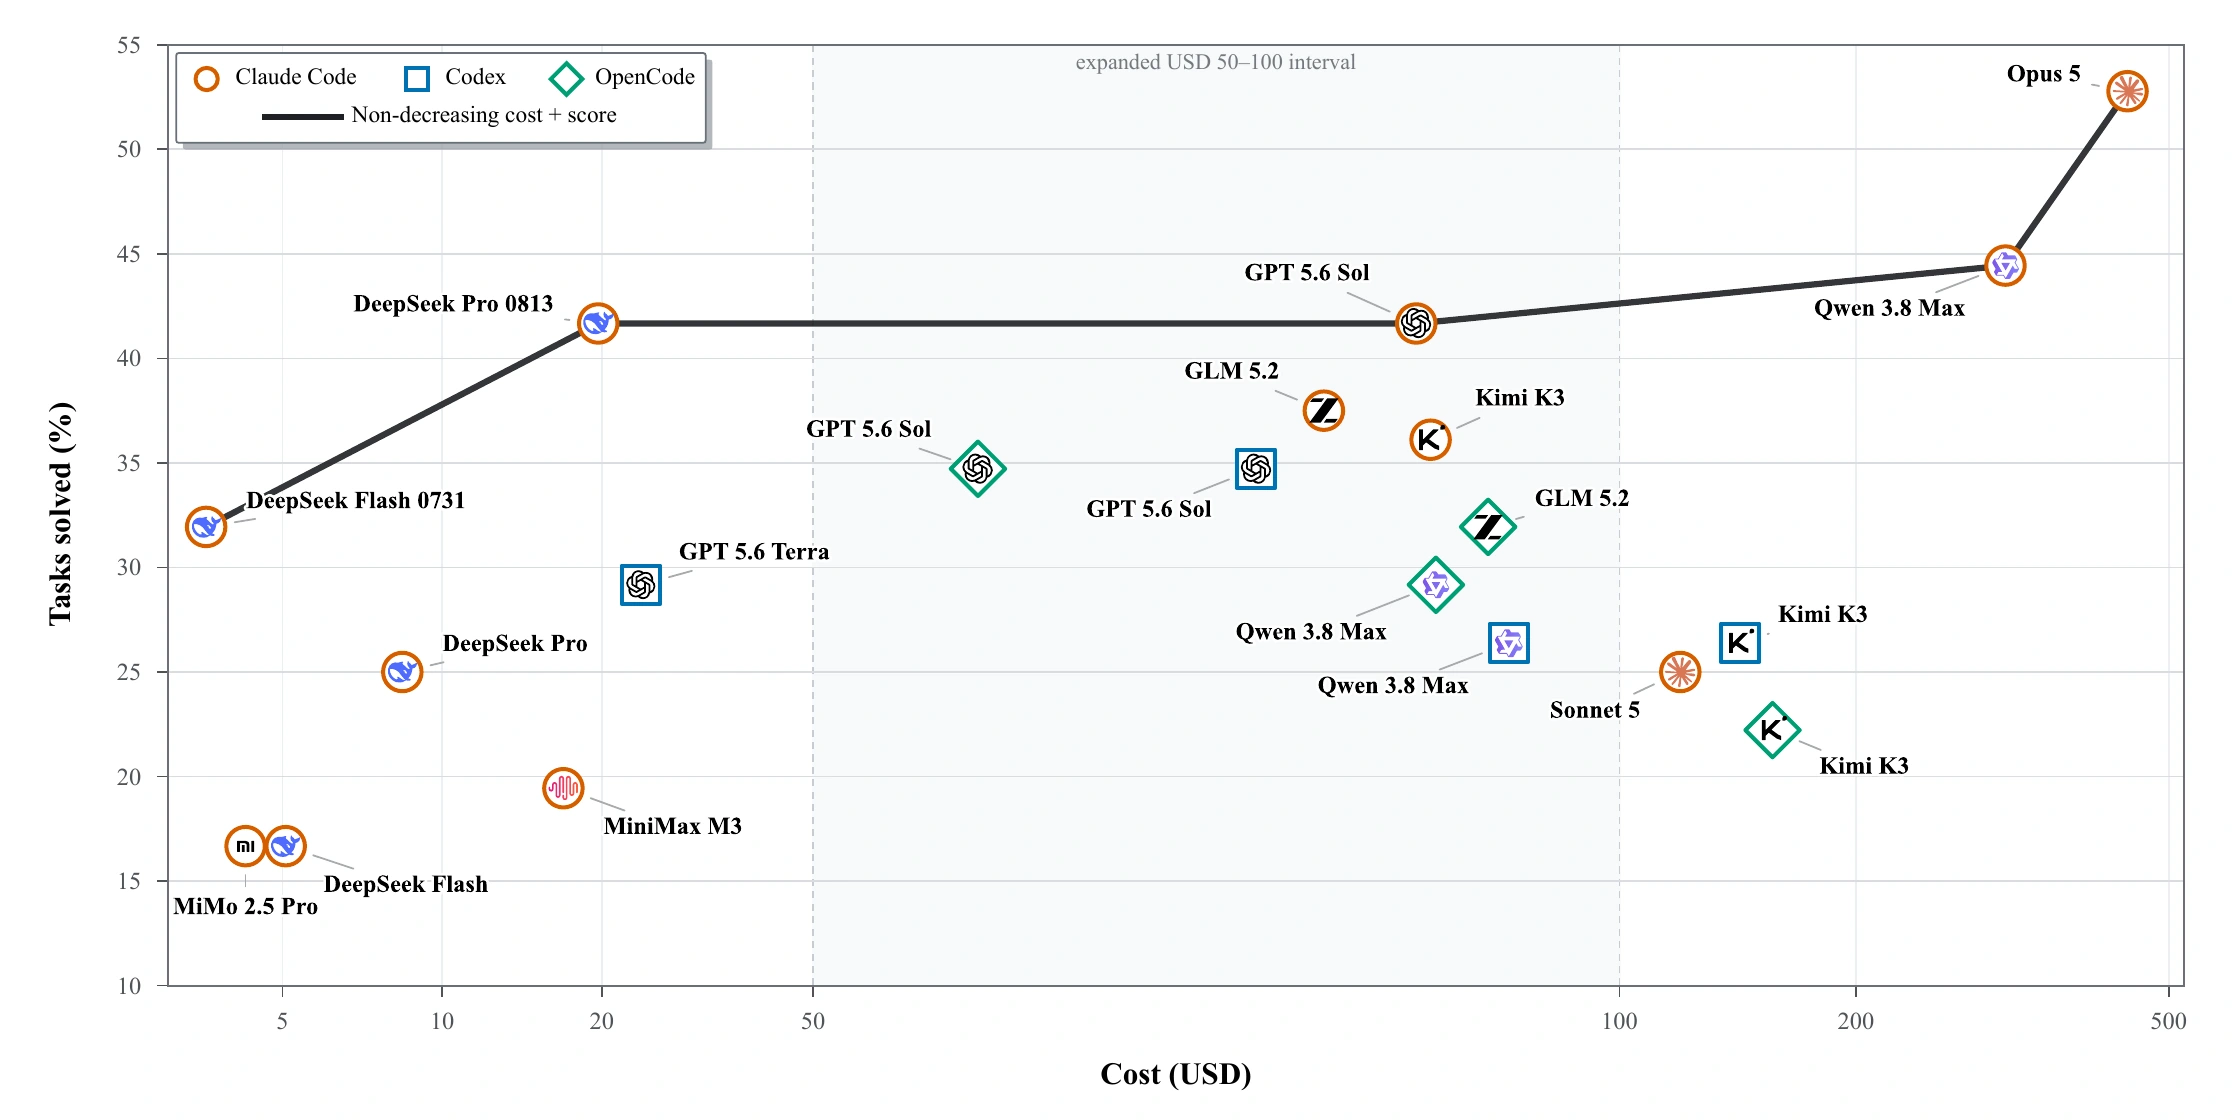
原論文 Figure 1(§4.1),圖檔依 CC BY 4.0 轉為 WebP,保留原圖資訊。散點呈現每個模型—scaffold 設定的觀察成功率與整批任務總成本;前緣是描述性結果,不是新的排名規則。圖不能證明成本造成成功率差異。來源:arXiv v2, Figure 1。
用跨階梯任務走完整個方法
用上面的角色移動任務來看完整流程:
- 讀入規格與專案:Agent 得知可修改哪些檔案、控制器介面及階梯高度規則;它能在公開預覽裡觀察從 方向跨一階的例子。
- 形成實作:Agent 修改控制器,可能加入碰撞查詢、移動狀態或跨幀的高度檢查。Benchmark 不要求它採用參考解的內部程式結構。
- 本地試跑:Agent 可重播公開預覽、呼叫 Godot 引擎或撰寫自己的腳本協助除錯。論文報告 99.0% session 至少啟動過引擎,但這表示發生過工具呼叫,不表示本地測試涵蓋所有規則。
- 封存提交:作者的主表分數來自 egress 封閉的測試運行;評測者拿到提交的工作區副本,使用凍結的 judge 檔案執行每個計分場景與種子。
- 改變條件但保留契約:一個場景可能從反方向接近階梯、改變距離或在路徑中放入更高牆;種子會變更場景參數。judge 同時在逐 tick 狀態和事件歷史上檢查規則。
- 輸出可重播 verdict:同一提交、場景、種子和固定 judge 組合會得到相同判定,因評分路徑不呼叫語言模型。通過代表在本 benchmark 所測情境遵守斷言,不等同於已證明任意遊戲狀態都正確。
關鍵失敗點是在第三步誤把「公開預覽成功」當成「規則已完成」。例如控制器只支援從右側上階,或跨過階梯後仍錯把超高牆當作可跨障礙,Agent 仍可能讓預覽看起來正常。只有評測情境真的改變方向、布局或輸入,並觀察執行中狀態,這類硬編碼才會暴露。另一種可能是評測本身有漏洞,所以作者不能只拿 Agent 輸出來驗收 benchmark;他們還要校準 judge 本身。
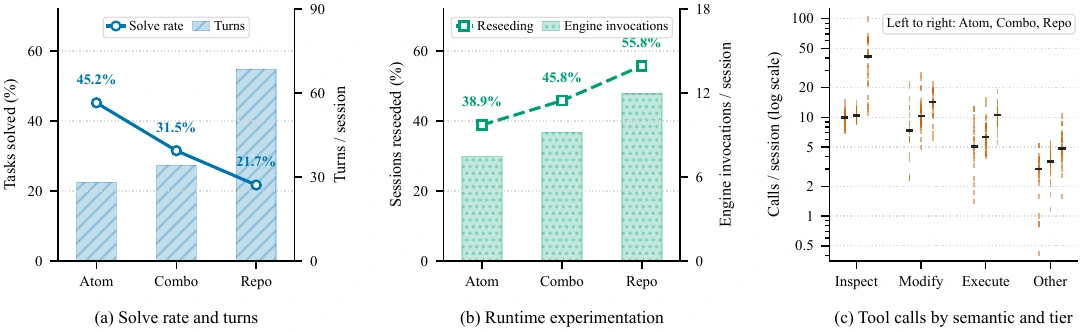
原論文 Figure 5,圖檔依 CC BY 4.0 轉為 WebP。左圖為 Claude Code scaffold 下的成功率與 turns,中圖為重播預覽和啟動引擎的比例,右圖為工具呼叫類型;右圖刻度為對數尺度。這是 Agent 在不同任務層的觀察差異,不足以單獨證明 Repo 整合範圍是性能下降的唯一原因。來源:arXiv v2, §4.2, Figure 5。
方法骨架:人工作篩選,Agent 協助造題,mutant 檢查測試是否有辨識力
benchmark 建構不是把遊戲需求直接交給生成式 Agent 再拿它產生的測試打分。Figure 3 所示流程在頭尾保留人工把關,中段以 Agent 協助原型、藍圖、實作和檢查(§2.2–2.3):
- 來源與篩選:候選機制來自開源 Godot 專案、已發行遊戲與功能能力分類。三名人工標註者先判斷機制能否用唯一狀態值、合法事件順序或守恆量確定判定,並排除依賴美術或主觀體驗的題目。
- 原型階段:建構 Agent 對比適當實作和天真的實作,在多種參數下試跑;若關鍵機制沒有清楚可重複的差異,題目不進入後續建構。
- 藍圖階段:Blueprint agent 規劃任務、行為介面與場景,嘗試執行驗證。若題目可以直接照簡報、不必理解執行期互動就完成,作者會捨棄它。
- 實作與校準:Implementation agent 建立專案和 judge,並準備 proper solution、naive solution、移除單一能力的 mutants,以及保留同一行為的替代解 control。
- 獨立 Agent 複核與人工裁定:另一個 review agent 重跑每個場景和種子,檢查 calibration 結果及資訊邊界;三名標註者最後確認題目是否測到預期機制、範圍是否合理以及能力覆蓋是否有增益。
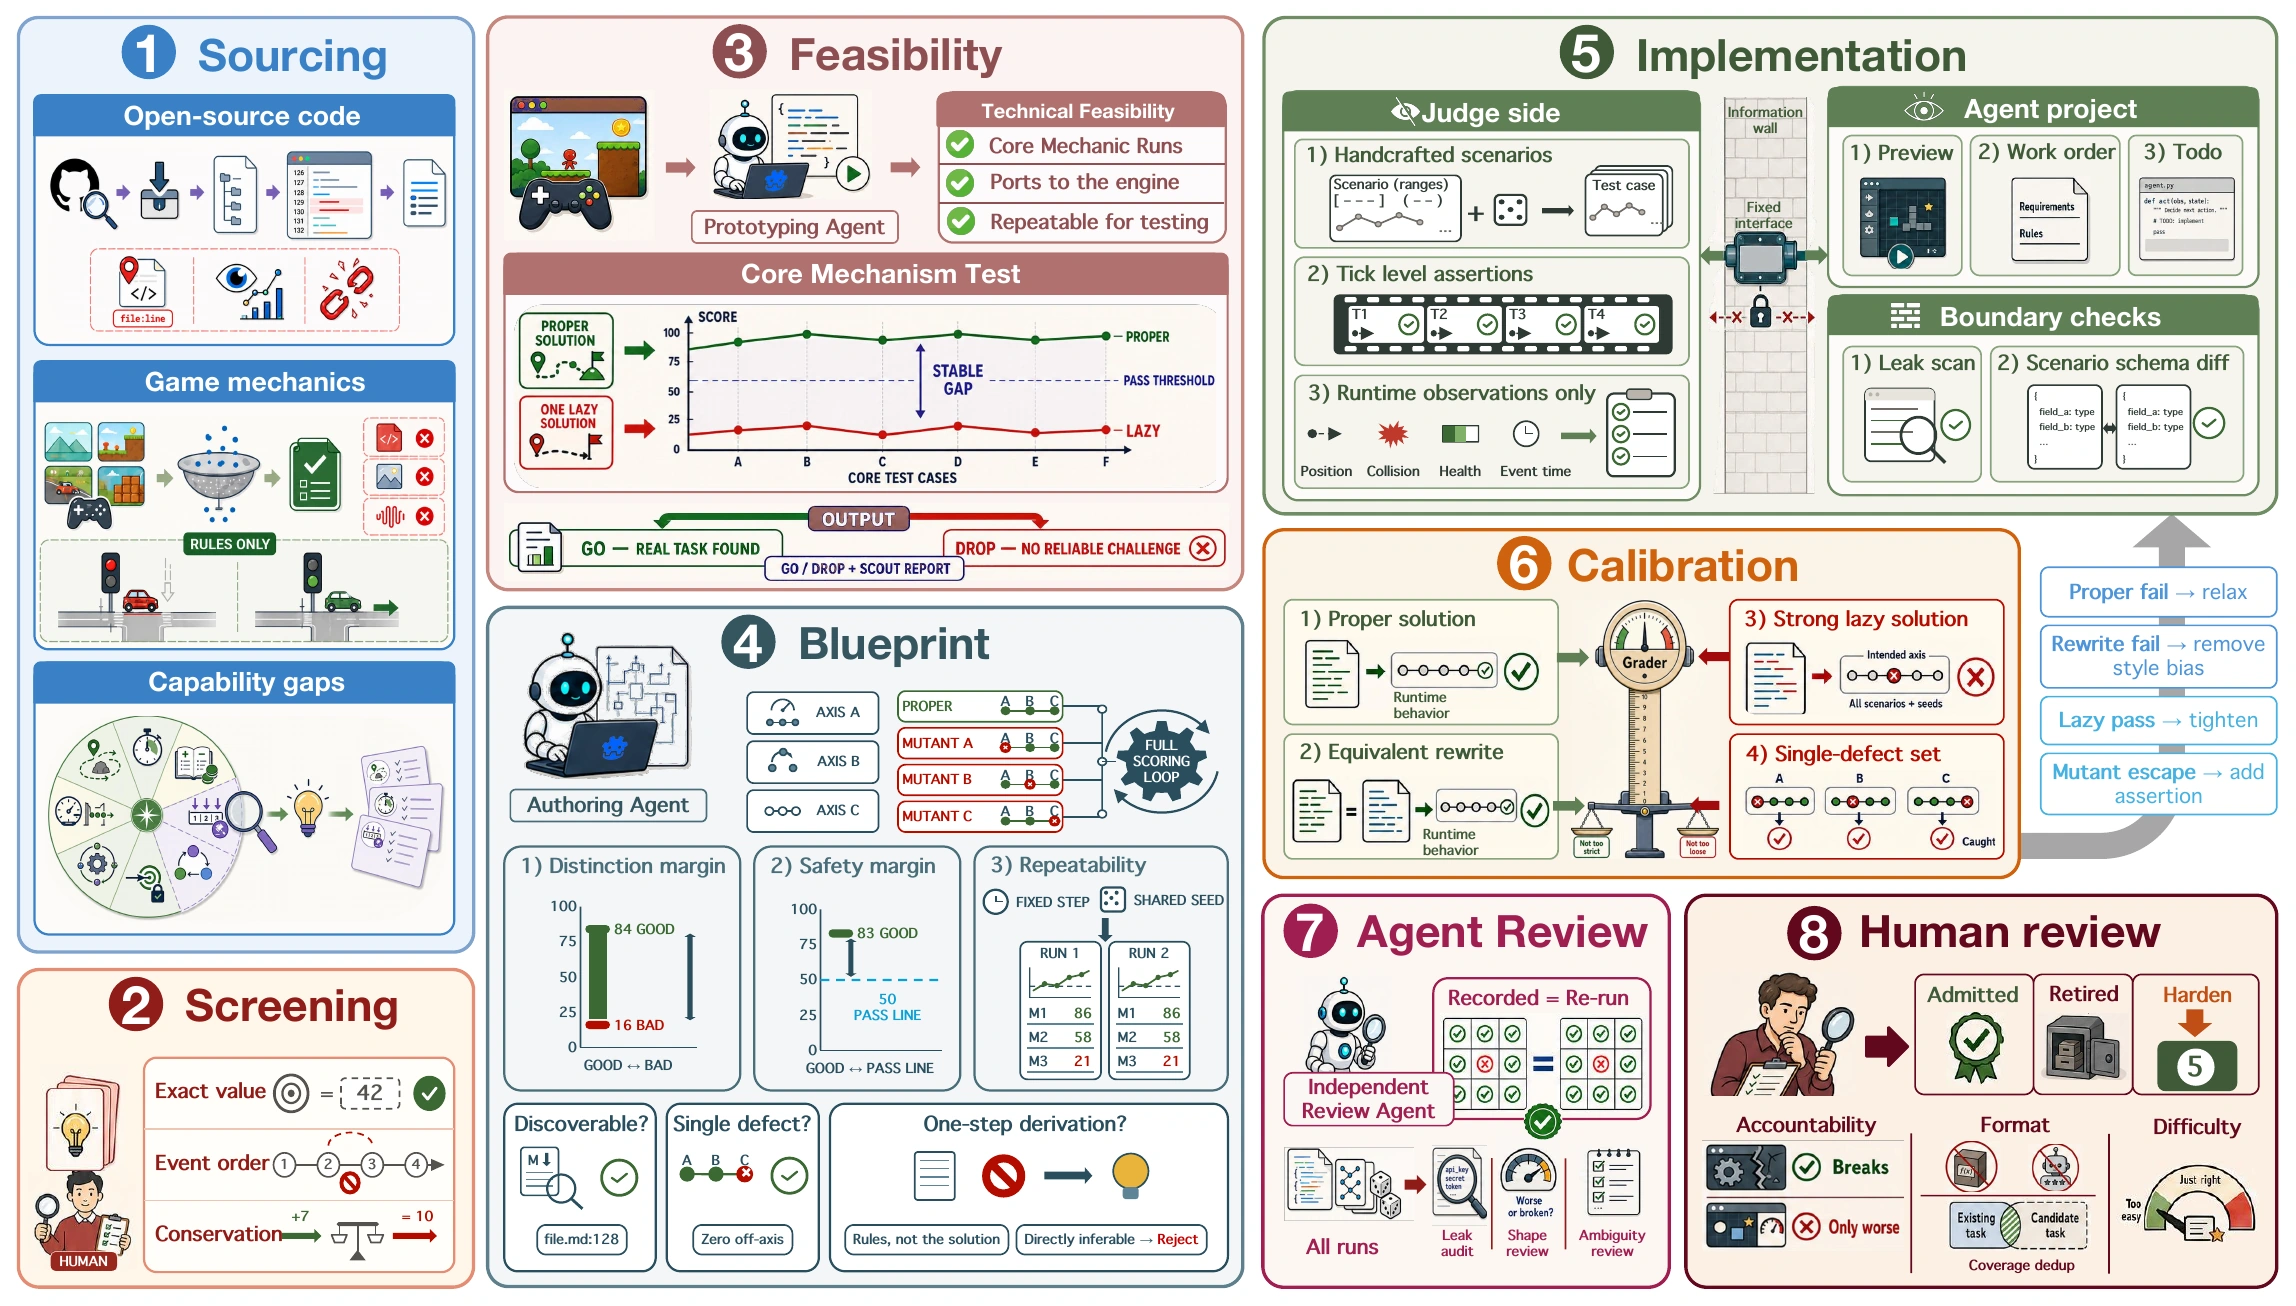
原論文 Figure 3,圖檔依 CC BY 4.0 轉為 WebP。它呈現任務建構與驗收流程,不代表流程本身已由外部團隊重複驗證。來源:arXiv v2, §2.2–2.3, Figure 3。
作者約從 200 個構想開始,122 個完成建構、校準和 Agent review,72 個最終納入。此漏斗讓 benchmark 的「題目數」帶有篩選條件:它不是對所有遊戲機制的隨機抽樣,而是留下了能確定判定、能完整跑完並能辨別正誤的機制集合。這提高了測量的可操作性,卻也預先界定哪些問題會被納入。
校準中的四類程式各自回答不同問題:
| 校準項目 | 它應該做什麼 | 如果結果不符,代表什麼 |
|---|---|---|
| Proper solution | 每個場景、種子皆通過,且離容差邊界保有餘裕 | 規則或斷言可能太嚴、環境不穩或參考實作不完整 |
| Behavior-preserving control | 用另一種實作保留相同可觀察行為,仍要通過 | judge 可能偏好某個內部寫法,而非指定行為 |
| Naive solution | 帶有常見邏輯錯誤,應被抓出 | 測例未必能辨識明顯不正確的策略 |
| Single-capability mutants | 一次移除一種指定能力,至少有一個場景應能偵測 | 所聲稱測量的能力可能沒有對應的有效檢查 |
這裡的核心不是「測試越多越好」,而是以正確替代解驗證接受面、以 mutant 驗證拒絕面。只確認正確答案會過,不能說明錯誤答案不會漏過;反過來,只讓某個錯解失敗,也不能保證 judge 沒有錯殺不同但正確的解答。
實驗設定:任務、場景、模型與 scaffold
72 個任務包含 Atom 21 個、Combo 28 個、Repo 23 個;它們來自 12 種遊戲類型,總計 403 個人工作設計情境和 1,451 個測試案例。每個任務有 2–12 個場景與 10–38 個案例;每個場景可由多個種子生成帶數值變化的案例。Repo 任務平均含 209 個遊戲檔案及 17,599 行程式,規模範圍很大(Table 2、Figure 4)。
主評測將 20 種模型—scaffold 配置各跑一次。三種 scaffold 是 Claude Code 2.1.177、Codex 0.144.1 與 OpenCode 1.17.18;所有執行使用 Godot 4.4,session 設定為 effort=high,最長 3,600 秒。代理求解容器封鎖除模型 API 以外的外連;judge 則在沒有網路的獨立容器內執行。這是一次觀察型比較,不是每個配置都做大量重複的主表實驗。
| 結果切面 | 作者報告 | 解讀時的範圍 |
|---|---|---|
| 整體最佳配置 | Claude-Opus-5 配 Claude Code,平均解題率 52.78%;Atom 61.90%、Combo 53.57%、Repo 43.48%(Table 3) | 單次封網執行、這 72 題與該版本 scaffold;不是模型本身脫離 scaffold 的能力 |
| 範圍梯度 | 幾乎所有配置在 Atom 到 Combo 再到 Repo 下降 | 方向一致但幅度依配置而異,三種任務層同時改變整合要求 |
| 模型與 scaffold | Qwen-3.8-Max 解題率在三種 scaffold 間從 26.39% 到 44.44% | 對照單位應是模型—scaffold 組合,不宜將觀察差異全歸因於模型 |
| 成本差異 | 相同解題率的配置成本最高相差 25 倍;成本前緣的兩端成功率 31.94% 與 52.78%,總成本相差 123 倍 | 作者以模型供應商費率及全部任務推算,價格與快取使用會影響外推 |
| 互動與工具 | 99.0% session 至少啟動一次引擎;39.2% 執行自寫 Godot 測試腳本 | 呼叫工具代表採取過行動,並不等於用有效測試證明規格 |
Figure 1 的成本—成功率散點提醒「更貴」和「更強」不是同一排序:一些同分設定成本差異顯著;最佳點也有高成本。這些美元數字依作者列出的供應商價格計算,適合解讀此實驗的效率權衡,不宜直接複製成不同日期或部署的預算結論。Table 3 也只給每種配置一個主表觀察值,因此不能從中估計每個模型—scaffold 組合的重跑波動。
最重要的診斷:大多數失敗仍然是「能跑,但行為錯」
跨 20 個配置與各任務層,74.3% 的失敗情境屬於機制失敗:提交能跑、可由 judge 評分,但違反行為契約。另有 17.2% 沒有可評分解答,8.5% 是不可行的計算。這個比例的分母是失敗情境;它不是「74.3% 所有提交都錯」,也不是生產環境缺陷率(§4.5)。工程訊息在於:提高成功率的瓶頸,不能只從語法、啟動或產生程式碼著手,還得觀察整段執行是否維持規則。
作者預先定義七個能力類別,像是 Engine contract、Commitment、Spatial、Timing 等;一個情境可能屬於多類。對能力類別的嚴格 pass,只有該情境所有種子都通過才算通過。Figure 8 顯示 Engine contract 在 20 個設定中的 19 個排名最高,合併嚴格通過率為 88.75%;Commitment、Spatial、Timing 在多數設定裡表現較低,合併通過率約 53.4%–58.57%。依作者解釋,熟悉 Godot 時鐘、solver 與 time base 通常不是最主要瓶頸,難點更多在承諾狀態、空間關係和時間規則的維持。
Appendix B 的七類是評測用的能力分類,不是作者宣稱的完整遊戲智慧理論。Intention commitment 涵蓋跨多個 frame 維持決定、避免反覆改變;Resource accounting 檢查共享有限資源、分配與守恆;Spatial navigation and steering 包括位置、方向、可達性、避障與接觸判別;State machine 關注狀態轉移、生命週期和轉移後沿用的狀態;Timing 涵蓋 frame/秒級窗口、冷卻、節奏及時間不變式;Arbitration 處理同時競爭時的優先順序、讓步和去重;Engine contract 則檢查是否正確使用引擎時鐘、solver、time base 及子系統語意(Table 7)。分類有重疊,因此不能把某個任務只塞進單一能力欄位,再將該欄的分數當成互斥技能排行榜。
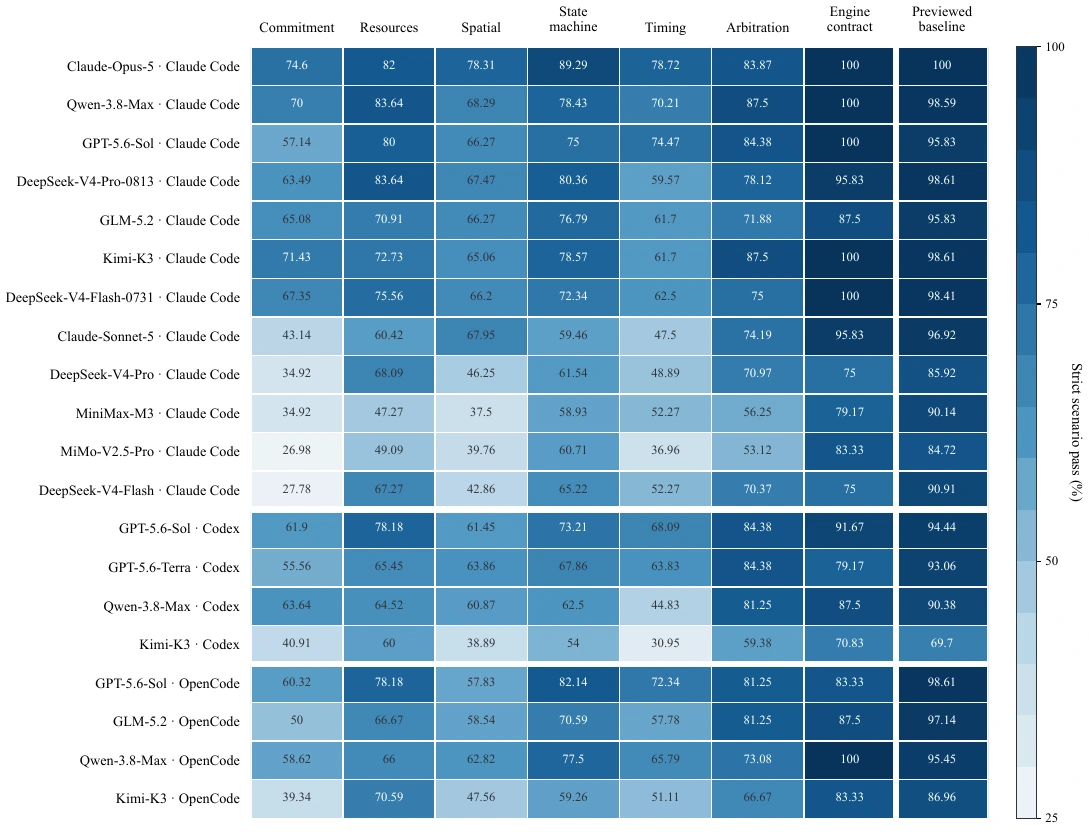
原論文 Figure 8(Appendix B),圖檔依 CC BY 4.0 轉為 WebP。嚴格通過需同一場景的所有種子成功;類別可以重疊,圖上的預覽基線另行呈現。它定位 benchmark 中的弱項,不表示所有程式工作都同樣受 Commitment、Spatial 或 Timing 限制。來源:arXiv v2, Appendix B, Figure 8。
Judge 設計的兩組消融,直接測試錯誤答案會不會溜過
作者在同一個 36 任務稽核集合上保留提交解答與任務不變,只改變評測者看得到的證據(Table 5)。Terminal-only 保留全部場景及種子,但只看終態斷言;Preview-only 保留完整逐 tick 規則,卻只測公開預覽場景。
| 評測設定 | 漏過的 mutants | 有漏過的任務 | 被錯誤改判為 PASS 的解答 | 平均解題率變化 |
|---|---|---|---|---|
| Terminal-only | 236 / 666(35.4%) | 34 / 36 | 64 / 488(13.1%) | +8.9% |
| Preview-only | 508 / 666(76.3%) | 36 / 36 | 418 / 488(85.7%) | +58.1% |
這組控制比較支撐兩個不同判斷。其一,只看最後狀態,即使仍測多場景和種子,也會漏掉執行中一度違規、終態卻恢復正常的 mutant。其二,只測公開預覽,即使檢查每個 tick,也未必能區分真正學會規則和針對示範輸入硬編碼的解答。這些差異是作者在既有任務及提交上的評測器設計消融,不是新模型訓練的提升,也不能推論每種程式測試都會出現相同幅度。
另一組建構校準比較正確解與 mutants。無 mutant 驗證的原始準則下,666 個 mutants 中有 127 個通過,揭露 36 題裡 19 題缺少 24 項檢查;補上驗證後,在 9 個模型、2 個 scaffold 的對照中,3 個任務結果由 PASS 變成 FAIL,正確解和保行為替代解仍可通過(§4.6)。它說明 mutant gate 在這組 benchmark 建構流程中改變了實際計分,但沒有量出其他組織加入同一套流程所需的成本。
開放網路帶來另一種評測污染
Repo 任務源自公開專案,研究者另以五種配置比較封網和開放網路的 Repo 成績。他們檢查軌跡中的 URL、查詢與 shell 命令,並人工查看回傳內容;四種配置確實取回上游程式碼,審閱到的軌跡裡有直接重用。所有四種設定的開網 Repo 成績均高於封網版本(§4.7、Figure 7)。作者據此提醒:Repo benchmark 分數不只取決於測試拒絕什麼,也取決於 Agent 能否從外部取回題目來源程式。
這是對特定上游衍生任務與五種測試配置的觀察,不應解讀為所有外網存取都是作弊,也不能把開放網路時的分數當成單純「能力變好」。研究者必須明確記錄網路政策、任務來源和可存取資料;若真實工作本來就允許查詢來源,則需把可用網路視為任務條件,而不是假裝它不存在。
證據地圖:何者被量到,何者仍是外推
| 論文主張 | 支持它的證據 | 可以說到哪裡 | 尚未支持什麼 |
|---|---|---|---|
| 確定性逐 tick 多情境 judge 可偵測某些執行中違規 | Table 5 對同一 36 題集合的 Terminal-only、Preview-only 與完整評估比較 | 在這組任務、mutant 與提交上,刪掉檢查會放過更多錯誤 | 一般軟體測試、其他引擎或生產故障是否有相同效果 |
| 執行中行為錯誤是本 benchmark 的常見失敗類型 | 20 配置中失敗情境分類,74.3% 為可執行但違反機制 | 在本文分母與 benchmark 內,這是最大失敗類型 | 真實遊戲團隊或全部 coding agent 的故障比例 |
| 任務整合範圍增加時,解題較困難 | Table 3 的分層結果、Figure 5 的 turns/工具使用 | 幾乎所有本文配置中 Repo 比 Atom 更難 | 因果效果完全來自任務範圍;每層題目內容和專案不同 |
| 模型不能脫離 scaffold 單獨排名 | Qwen-3.8-Max 等模型在不同工具 scaffold 下解題率不同,Table 3 | 測得的是具體模型—scaffold 組合 | scaffold 對所有模型、工作與版本的普遍排序 |
| 公開來源可造成 Repo 分數的取回污染 | 五個配置中四個取回上游程式碼,且其開網 Repo 成績增加 | 這批軌跡展示網路政策會改變評測條件 | 網路存取必然造成失效,或開源來源一律該封鎖 |
最核心的證據類型是受控 benchmark 內的觀察、對固定題集重算評分的消融,以及作者人工審閱的工具軌跡。它不是跨機構獨立複現,也沒有產業部署追蹤或不同遊戲引擎的轉移實驗。作者以 20 組模型—scaffold 設定擴大比較範圍,但主表每個設定僅一次執行;因此成功率的細小差異不應視為穩定統計排名。三個配置另有三次重跑,Table 4 的 pass@3 和 worst@3 相差 26.39–36.11 個百分點,凸顯重跑問題,卻仍不足以替全部模型配置建立穩定度估計。
研究邊界與容易過度解讀之處
第一,測量對象是「能否按可確定規則維持遊戲機制」,而不是完整遊戲品質。主觀的美術、敘事、內容深度和玩家體驗刻意不在斷言範圍內;未來工作提到可加入更長互動和其他 runtime 訊號,但這是後續方向,不是當前已驗證能力(§6、Limitations)。
第二,benchmark 只用 Godot 4.4 與 GDScript,Repo 題的來源與類型受可取得、可執行的開源 Godot 專案影響,也未在單容器 harness 測網路同步。這些限制會影響外部效度;不能把 52.78% 改寫成「頂尖 coding agent 對真實軟體專案也只成功一半」。
第三,評測確定性不等於題目代表性或斷言完備性。固定 judge 可讓相同輸入得到可重播結果,但如果被選情境漏掉一種關鍵狀態,它仍會一致地漏測。多場景、種子、正確替代解、naive 解與單一能力 mutants,是作者降低這種風險的校準方法;它們不構成形式化證明,不能保證沒有未知的錯誤解答。
第四,模型比較混有 scaffold、工具操作、費率、版本與模型選擇的影響。論文中的供應商價格由作者依評測期價目表記錄,成本前緣只是該組配置的描述;最新模型發布、快取策略、API 折扣或執行硬體改變後,美元結論可能不同。更不能把一次結果當成模型能力的永久排序。
第五,作者把 Repo 外網取回視作可能膨脹得分的污染因素,這在封網評估中合理;但對實際開發工作,查詢公開文件與上游程式可能就是明確允許的工具。benchmark 必須對照要回答的問題設定網路政策,並披露 Agent 得到哪些外部資訊。
Artifact 與可重現性
截至 2026 年 10 月 4 日,benchmark 程式庫與72 題任務庫皆可公開瀏覽;當日查核到的 main revisions 分別是 d9854d6 與 18c54e6。任務庫 README 說明每題含 Godot 4.4 專案、凍結 judge 與參考解;Repo 層的上游專案各自附授權與來源變更說明。查核時,程式庫與任務庫根目錄均未提供單一總授權檔;程式碼可看不等於整體重用授權已明確。評測需要 Docker、Godot 任務環境及模型供應商或可替代的模型存取;要重現作者成本,還需對應模型/scaffold 版本、價格條件與封網設定。
本文未安裝環境或重跑 benchmark,數據均是作者在 arXiv v2 中報告的結果。公開 repository 的目前主分支可以用作探索入口,但要重現論文結果,應先固定與論文相符的程式及任務提交版本,檢查各 Repo 題所帶上游授權,再依 README 設定 Docker、Godot、模型 API 和網路隔離;目前文章沒有宣稱目前 main 分支與論文實驗完全一致。即使得到相近數字,也只會是相同設定下的再現證據,不代表 benchmark 已能預測真實產品可靠度。
Bloss0m 工程判斷:把「會跑」和「守規則」分開評估
以下是 Bloss0m 工程解讀,不是作者提出的普遍標準:若你的 Agent 會控制有狀態流程,評測可以先問三個層次。第一,結果是否可見且由規格定義?若正確性主要取決於美感或使用者感受,確定性狀態斷言就不夠。第二,重要不變式是否可能在過程中破壞、而在終態前被掩蓋?若會,就應記錄執行軌跡或關鍵事件,而不只斷言最後狀態。第三,測試集合能否打破只針對預覽輸入的硬編碼?增加合法的方向、參數、排列、呼叫時序或種子,並用錯誤變體驗證斷言是否真的有辨識力。
這不代表每個系統都要複製 GameLogicBench 的 1,451 個案例或採用遊戲引擎。先從高風險行為挑選小型代表測例,比盲目擴大情境數更能控制成本;對 API、資料庫、權限或協作流程,需把測試物件換成適當的服務邊界與副作用,不能直接將遊戲的 tick 語意套過去。若只需檢查靜態轉換或輸入輸出函式,傳統單元測試也許更合適;若規則不可觀測、主觀或測試環境無法穩定重建,這種確定性判分就不應被當作完整驗收。
這篇論文最值得工程團隊帶走的是「把 judge 也當成待驗證軟體」:一套測試不只要讓正確解通過,還要能抓到針對性錯解,並容許不同但保行為的實作。若沒有這些校準,更多測例也可能只是更多次地確認測試自己的假設。
讀完後的三個記憶點
- 技術想法:以固定 Godot 時間步觀察狀態和事件歷史,讓同一行為契約跨多個情境與種子接受逐步檢查。
- 證據:72 題、403 場景、1,451 案例和 mutant 校準支撐 benchmark 內的失敗分析;74.3% 是失敗情境中仍可執行但違反行為的比例,最佳 52.78% 是一組模型—scaffold 的單次觀察。
- 採用邊界:可借鏡評測設計和 judge 校準,但不能把 Godot 遊戲邏輯結果外推為一般程式 Agent 的實際可靠率。
延伸閱讀
- Agents are systems, not models: Rethinking agentic evaluation:從模型、工具 scaffold、任務資訊和重跑波動看 Agent 評測單位。
- When Is Complex Chunking Worth It?:另一個把實驗條件、成本與採用邊界拆開讀的系統評估案例。
- Interleaved Tool Use: Mid-Tool Reasoning:延伸思考工具呼叫契約、外部狀態與執行後果的測量方式。
Primary sources
- Che et al., GameLogicBench: Evaluating Coding Agents on Runtime Game Logic with Tick-Level State Assertions, arXiv v2, 2026-09-21. 圖表定位:HTML 全文、PDF。
- Benchmark code repository · Task library。
- 論文授權:CC BY 4.0。