論文精讀
RAG 文件切塊論文精讀:複雜 Chunking 方法何時值得使用?
原文:When Is Complex Chunking Worth It? A Multi-Objective Evaluation of Chunking Methods at Scale
90 秒掌握論文
- 問題:長文件可能超出 embedding model 可處理的長度;切成較小片段會改變可檢索的內容粒度,也可能增加向量數、索引時間、查詢工作與記憶體。既有方法比較多只看檢索分數,較少同時呈現這些系統成本。
- 核心洞見:作者將八種切塊策略放進同一個多目標評估,跨兩個語料、三種 embedding model 和多種 corpus size,同時衡量 retrieval effectiveness 與 indexing/serving 成本。
- 最強證據:Figure 1 的顯著勝率矩陣會隨 NDCG@10 或 Recall@100 改變;Table 2 的分數又會隨模型、資料和規模移動;Figure 2 顯示品質相近的方法,吞吐與記憶體仍可能差很多。
- 主要邊界:這是 dense retrieval 評估,不是生成答案或完整 RAG 系統的品質測試。部分昂貴策略沒有跑到最大語料;runtime 也只代表指定實作與硬體設定。
核心工程判斷:這篇文章沒有證明「簡單切塊永遠最好」,而是指出昂貴方法未能穩定勝過簡單方法。切分方案應由服務階段、目標指標和建置預算共同決定;論文結果適合用來設計自己的比較,不適合直接當成生產排名表。
來源版本與論文地位
本文依據 arXiv v1,版本日期為 2026 年 8 月 17 日。作者為 Laura Caspari、Kanishka Ghosh Dastidar、Michael Dinzinger、Jelena Mitrović 與 Michael Granitzer。v1 註腳表示論文已獲 ACM CIKM 2026 接受;截至 2026 年 9 月 26 日,會議仍預定於 11 月 7–11 日舉行,因此這裡將它描述為「已接受」,不寫成 proceedings 已出版。
論文把 chunking 問題從「哪種分段方式最能拉高 retrieval score」擴大成一個系統選擇:片段表示會改變檢索品質,也會改變索引大小、建立速度、查詢速度和尖峰記憶體。作者的主要發現是,額外計算昂貴的策略很少能在所有設定中穩定勝過簡單方法;結果會隨 embedding model、dataset、corpus size 和目標指標變化。
核心直覺:切分會改變檢索單位,也會改變成本
Dense retrieval 會將 query 和可檢索內容編成向量,再依相似度找候選。若把一整份長文件壓成單一向量,超出模型長度的文字可能被截斷,不同主題也可能混在同一個表示裡。切成多個 chunk 能讓局部段落成為獨立檢索單位,卻可能讓每份文件產生更多向量。片段越多,索引可能越大;若還要逐片生成脈絡,建置時間也會再增加。
想像一份包含「帳號復原」與「雙因素驗證重設」兩個章節的長手冊。固定 token window 可能在標題和步驟中間切開;sentence chunking 避免句中斷裂,卻不一定知道句子屬於哪個章節。每個 chunk 加上文件標題,可能讓局部文字多一個主題線索;加上整份文件摘要則補入文件層級資訊,但需要先產生摘要。Contextual 方法進一步為每個 chunk 產生與全文相關的局部說明。這些處理改變的是索引裡每一個單位的內容和數量,並不只是在同一份文字上換一個分隔符號。
論文比較的八種策略各自改變不同環節,不能簡單排成「從簡單到聰明」的階梯。
| 方法 | 論文中的操作 | 額外工作與閱讀時要留意的地方 |
|---|---|---|
| Token | 以固定 token window 切分,可重疊 | 建置直接、通常較快;邊界可能切在句中。 |
| Sentence | 調整 token window,使片段在句子邊界結束 | 保留完整句子,但句長差異會影響吞吐;句界不等於語意或章節界線。 |
| Late | 先編碼整份文件,再切分尚未 pooling 的 token embeddings,最後聚合成 chunk 向量 | 利用全文編碼脈絡;建置時要暫留中間表示,記憶體可能較高。 |
| Enriched (Title) | 將文件標題加在每個 chunk 前 | 不需額外 LLM 生成;效果仰賴標題是否提供有效線索。 |
| Enriched (Summary) | 將文件層級摘要加在每個 chunk 前 | 摘要生成增加建置工作,讓局部片段帶有全文概覽。 |
| Contextual | 為每個 chunk 生成與全文相關的脈絡,再加回該片段 | 需要逐片生成,吞吐和成本會受生成服務影響。 |
| Summary | 以生成的文件摘要作為整份文件的檢索表示 | 每份文件只建一個表示,查詢時索引較小;局部細節可能不易找回。 |
| Semantic | 以句向量相似度將句子分組,據此決定 chunk 邊界 | 邊界取決於 embedding model 與相似度門檻,還需額外編碼句子。 |
實驗中的 Token、Sentence、Late、兩種 Enriched 與 Contextual 使用 512-token chunk、25-token overlap,再依方法加入 metadata 或生成脈絡。Semantic 用同一個 retrieval embedder 編碼句子,當相似度低於第 95 百分位門檻時開始新 chunk。Summary 與 Contextual 的生成使用本機 8-bit 量化 Qwen3-Next-80B-A3B-Instruct;生成結果在適用時會跨 embedding model 重用。這些是作者的比較設定,不是對所有產品的最佳參數建議。
用一筆查詢走完整個方法
以下「如何重設這本手冊的雙因素驗證?」是Bloss0m 的說明例子,用來解釋論文流程;它不是作者實際測試的 query。
- 準備輸入:固定一組文件、query 與 relevance judgments。每種方法都使用同一批資料,才有可比較的檢索分數。
- 產生檢索單位:八種 chunker 各自切分或補上 metadata。Token 用固定窗口;Enriched (Title) 加文件標題;Summary 和 Contextual 先產生摘要或片段脈絡;Semantic 以句向量相似度找切分點。
- 編碼與建索引:用指定 embedding model 將各方法輸出的單位轉成向量,放入 FAISS。不同策略會產生不同數量的向量,因此索引工作量和 query 要比對的項目也不同。
- 取回並評分:系統取回排名靠前的 chunks,再把 chunk-level 分數映回文件層級。NDCG@10 關注前十名的排序;Recall@100 關注前一百名候選中是否找得到相關文件。
- 比較差異並判讀:作者在每個固定設定內做方法間的 query-level 比較,將顯著勝出的比例彙整成 Figure 1;再把品質分數和建置吞吐、查詢吞吐、記憶體一起閱讀。評估到此仍是檢索,不會告訴我們生成器最後是否引用正確或回答有幫助。
方法流程與評估設計:兩種品質指標與三類系統成本
實驗的比較單位由 dataset、corpus size、embedding model 和 chunking method 組成。語料是 CoRE 與搭配 Natural Questions 查詢和相關性標註的 KILT。CoRE 的 chunking 實驗做到 1M documents;作者指出不同策略在這個規模已會產生約 5M embeddings。KILT 從 10K、100K、1M 擴展到約 6M documents。三種 embedding model 都低於 1B 參數:Qwen-0.6B、EmbeddingGemma-300M 和 Snowflake-L V2。
檢索側分開報兩個問題。NDCG@10 衡量最前面十個結果的排序品質;Recall@100 衡量較大的第一階段候選集合覆蓋了多少相關文件。若後面接 reranker,Recall@100 有助於觀察正確文件是否進入候選池;若直接呈現搜尋結果,前段排序可能更貼近使用者看到的品質。兩個指標反映不同階段,不能把其中一個當成另一個的替代品,更不能直接當作最終 RAG answer quality。
成本側分別量 indexing 時每秒處理的文件數、query throughput 和建索引期間 peak memory。作者沒有將品質和成本加權成單一總分;這使讀者必須根據自己的 latency、更新週期、記憶體上限與生成費用來判斷取捨。顯著性檢定以每個固定設定中的 query-level scores 為單位,使用 10,000 次 Fisher randomization permutations,並對八種方法的 28 組兩兩比較做 Bonferroni correction。
證據地圖:三個問題如何連起來
| 問題 | 主要證據 | 這些證據能支持什麼 |
|---|---|---|
| 複雜方法是否穩定改善檢索? | Figure 1 的顯著勝率、Table 2 的 Recall@100 切片 | 方法排名會隨指標、模型、資料和規模變動,沒有跨設定通用的品質冠軍。 |
| 品質差異是否值得額外成本? | Figure 2 的單一 runtime 切片、Table 3 的生成吞吐估算 | 檢索分數相近時,索引、查詢和記憶體成本仍不同;成本數字必須保留其實驗條件。 |
| 結果如何轉成採用選擇? | 作者的 Practical Implications 與本文的工程綜合 | 簡單方法適合作為比較起點;是否升級要用目標工作負載驗證。 |
證據一:Figure 1 的勝率會隨檢索指標改變
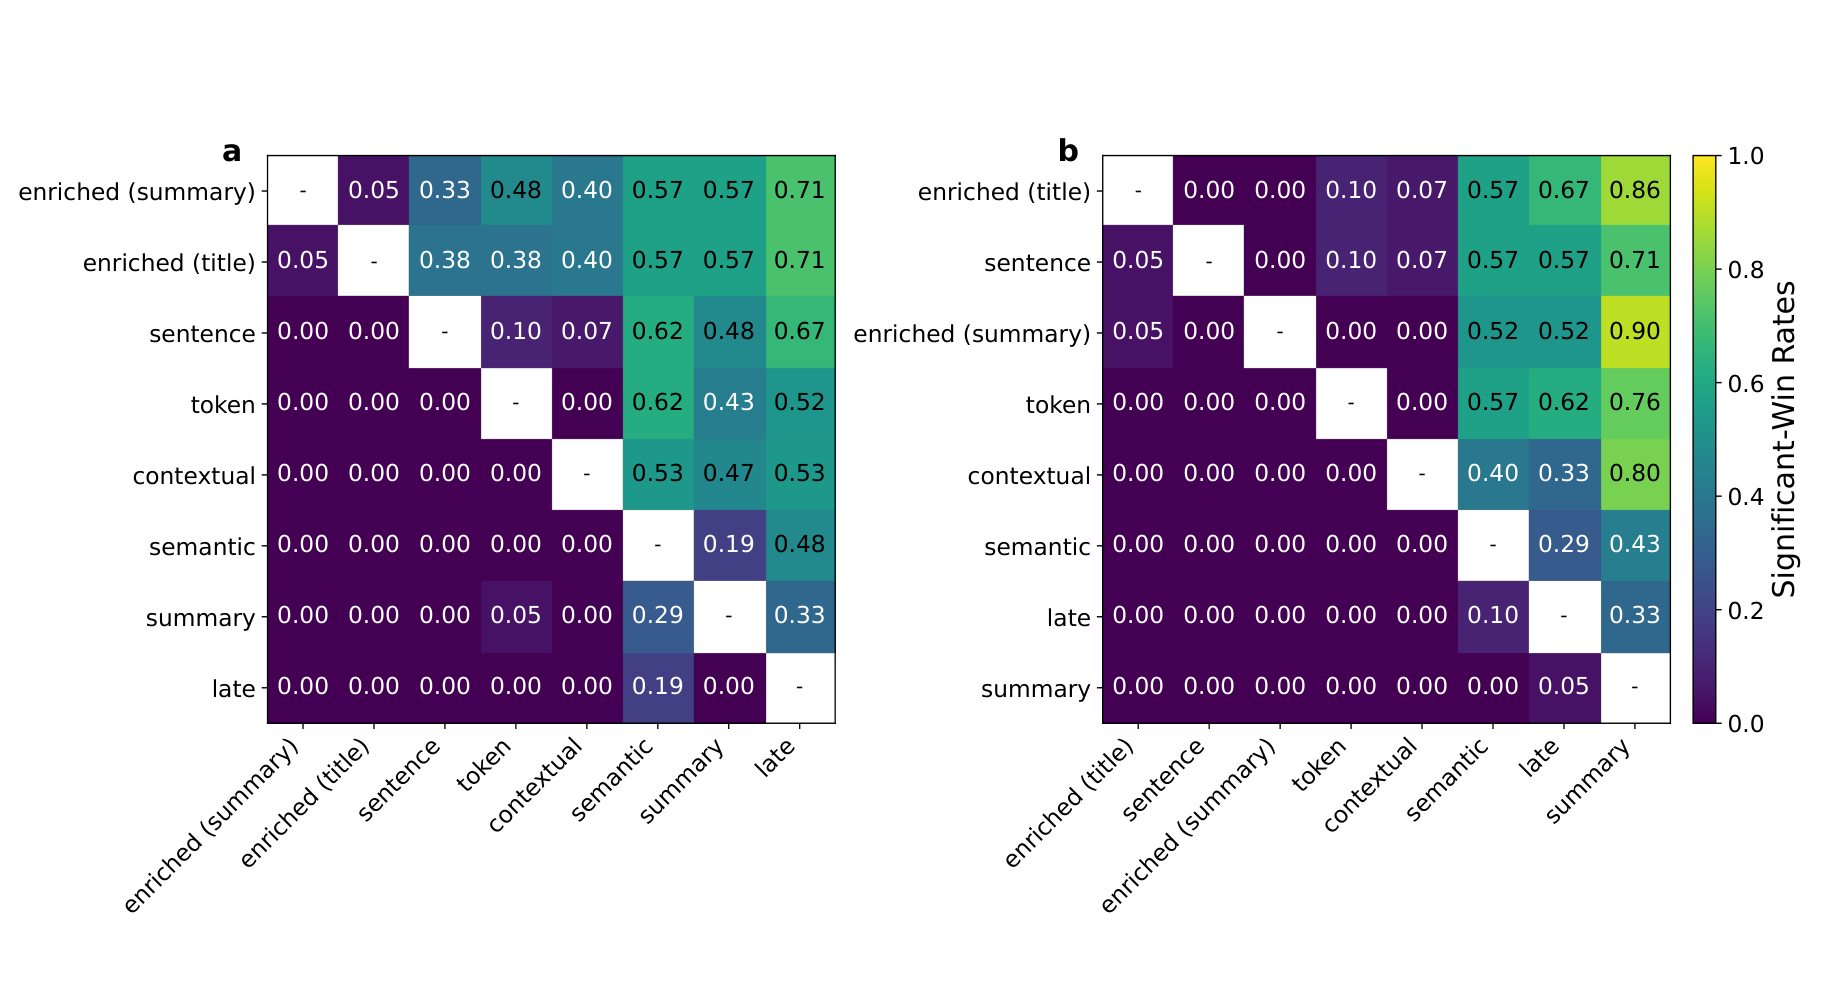
Figure 1(Methods §3.2,原圖錨點 S3.F1):上下兩個 panel 分別是 NDCG@10 與 Recall@100;每格表示跨報告設定中,列方法顯著勝過欄方法的比例。NDCG panel 的 0.71 代表 Enriched (Summary) 在 71% 的設定中顯著勝過 Late,不是品質提高 71 個百分點,也不是新 query 有 71% 機率獲益。這是 Caspari et al. 的 arXiv v1 原圖,依 CC BY 4.0 重用;保留原始圖檔,未裁切或重繪。
這張矩陣回答的是「跨多少比較設定觀察到顯著勝出」,不是哪個方法在所有流量上的絕對勝率。Enriched (Summary) 在 NDCG@10 對多種方法較有利,顯示文件層級脈絡有時能改善前段排序;但它很少勝過 Enriched (Title),換成 Recall@100 後優勢也較弱。Token 與 Sentence 因而在第一階段候選檢索中仍有競爭力。
這些差異也說明,chunking 的排名必須連同服務階段閱讀。如果 reranker 接手前一百個候選,前段排序小幅領先未必比候選覆蓋重要;如果搜尋頁直接展示前十名,NDCG@10 可能更切題。這是依指標定義做的工程解讀,不是論文證明哪種架構必須使用哪個指標。
證據二:Table 2 是條件式結果,不是總排行榜
Results §4 的 Table 2 列出不同模型、語料和部分規模下的 Recall@100。以下取 CoRE 的幾個切片;分數方向是越高越好,數字用來讀出設定依賴,不能單獨代表統計顯著性。
| 模型與規模 | Token | Sentence | Enriched (Title) | Enriched (Summary) |
|---|---|---|---|---|
| Gemma × CoRE,10K | 82.73 | 82.55 | 82.55 | 82.36 |
| Gemma × CoRE,1M | 57.09 | 56.00 | 57.27 | 55.64 |
| Qwen × CoRE,10K | 76.73 | 76.18 | 78.00 | 77.45 |
| Snowflake × CoRE,10K | 77.64 | 79.09 | 78.18 | 78.91 |
Gemma × CoRE 從 10K 增至 1M 後,Token 與 Enriched (Title) 的相對位置改變;Snowflake 在 10K 則由 Sentence 領先。這些只是 Table 2 的部分設定,卻足以說明沒有一個固定方法能在每種 embedding model 和資料規模下領先。Table 2 的表格標示最高與次高分數,但成績表的名次本身不是 pairwise significance test;跨設定的顯著比較應和 Figure 1 一起看。
作者另觀察到,語料變大時方法之間的顯著差異通常增加,但趨勢不是單調:KILT 最大的約 6M 設定,顯著差異數比 1M 設定少。這提醒我們,放大 corpus 不等於每一種策略差距都按比例放大;模型、資料切片和 query 樣本仍會影響結果。更完整的表格由作者整理在評估程式庫的 results.md。
證據三:Figure 2 同時呈現建置、查詢與記憶體成本
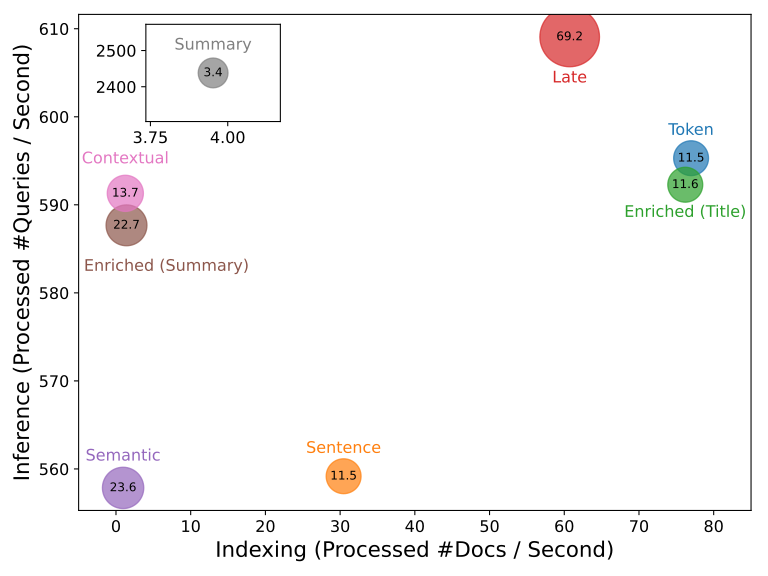
Figure 2(Results §4,原圖錨點 S4.F2):此圖只涵蓋 Gemma × KILT 10K。橫軸是 indexing 每秒處理的文件數,縱軸是每秒可處理的 query 數,圓圈大小代表建索引期間的 RAM。Summary-only 置於內嵌圖,因其 query throughput 較高,若與其他點共用尺度會壓縮差異。這是 Caspari et al. 的 arXiv v1 原始 SVG,依 CC BY 4.0 重用,未裁切或重繪。
在這一組設定中,Token 有較高的 indexing throughput 與較低的記憶體;Sentence 雖然概念上接近簡單基線,實測建置速度仍較慢。Semantic、Contextual 和 summary 類方法需要額外句向量、摘要或脈絡生成,索引較慢。Summary-only 每份文件只留一個摘要表示,query throughput 高,但檢索效果較弱且文件處理成本高。Late 在形成最終 chunk 向量前暫留未 pooling 的 token representations,因此這個設定中的建置 RAM 較高。
Figure 2 是單一 runtime 切片,並非八種方法在不同硬體上的通用成本曲線。更換 embedder、batch size、FAISS index、硬體或生成服務,都可能改變絕對數字與相對成本。它最適合用來提醒團隊同時記錄三種成本,而不是抄一個 throughput 數字去估算雲端帳單。
Results §4 的 Table 3 則把 Contextual 與 Summary 的文件處理速度表示成生成吞吐的函數:若 LLM 平均生成 100、200、500、2,000 tokens/s,Contextual 對應約 0.26、0.53、1.31、5.26 documents/s;Summary 約為 0.77、1.57、3.93、15.74 documents/s。這是依平均輸出速度推算的文件吞吐,不是多家生成服務的實測基準。論文另外以當時 OpenRouter 價格估計,Contextual 在 KILT 10K 的生成成本約為 US$9.60–14.73,依 provider 而異;這是論文寫作時的例子,不是今日報價,更不能線性外推到更大的語料。
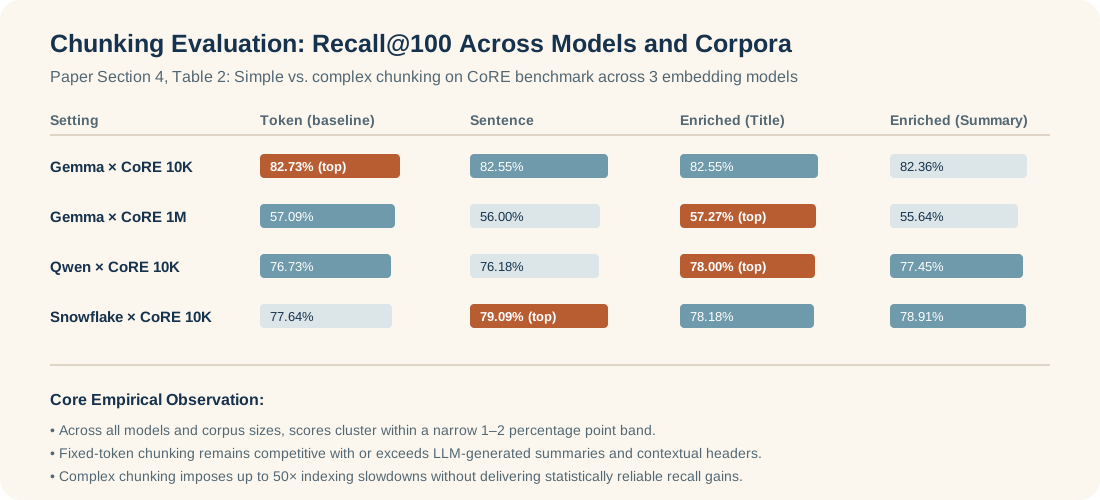
Figure 3,依據論文 Section 4、Table 2 數據整理之 Recall@100 跨模型分佈示意:呈現各切分策略分數高度密集於 1–2 個百分點區間,簡單 Token 策略在多個設定中勝出或持平複雜生成式摘要,顯示昂貴策略缺乏穩定的召回優勢。原論文 Table 2 anchor。依 CC BY 4.0 重用與整理公開數據。
Bloss0m 工程判斷與不適用條件
論文結果:在作者測試的範圍內,昂貴方法很少穩定改善簡單 chunking;不同方法可能在相似 retrieval score 下消耗不同的索引吞吐、查詢吞吐和記憶體。作者將 Token 視為許多大型檢索設定的強基線,Sentence 可在保留句界較重要時作為替代;若文件標題有資訊量,Enriched (Title) 是值得比較的低成本選項。Enriched (Summary) 在部分 NDCG@10 結果有優勢,但作者建議先和更便宜的 Title 版本對照。Semantic、Contextual、Late 與 Summary-only 比較適合被當成特定需求下的候選,而不是預設升級路徑。
Bloss0m 工程綜合:把 chunker 當成一組設計點來比較,比替方法排一條複雜度排行榜更符合這篇論文的證據。可以依以下順序設計小型本地 benchmark:
- 先定服務階段與目標。說明索引要支援直接前十名排序、reranker 前的候選覆蓋,還是其他任務,再選主要品質指標。保留必要的次要指標,避免單一分數遮住取捨。
- 固定資料與 query,再比較簡單基線。先跑 Token、Sentence、Enriched (Title),再加入一種有明確理由的高成本候選。若要比較不同 embedding model,分開呈現各模型結果,不用跨模型平均掩蓋交互作用。
- 把品質和成本記在同一張表。至少記錄 NDCG/Recall、文件索引吞吐、查詢延遲或吞吐、峰值記憶體、向量數、生成 tokens 和重建頻率。Figure 2 只覆蓋一個小型設定,自己的工作負載必須重新量。
- 要求增量價值足以支付增量成本。只有當品質提升在重跑後仍穩定,而且符合更新、延遲與資源預算,才把較昂貴的方法升成預設。若把多個目標加總成一個分數,權重應來自產品需求,而非默認由論文替團隊選擇。
這份流程是 Bloss0m 的工程綜合,不是作者提出的正式演算法或效用函數。對有硬性延遲 SLA 的服務,吞吐可能只是門檻而不是可交換的分數;對頻繁更新的語料,重建時間可能比一次性的索引速度更重要。這些限制需要用實際 pipeline 的負載補上。
限制與證據邊界
第一,runtime 和 memory 依賴作者的實作、硬體、batching 與 FAISS 設定,適合做同一環境內的比較,不能當跨平台成本常數。第二,研究使用 CoRE 與 KILT/NQ 這兩類語料和特定 query/relevance judgments,涵蓋範圍不等於企業內部文件、多語資料、程式碼、含大量表格的 PDF 或權限過濾檢索。第三,Contextual 僅擴展到 CoRE 100K 與 KILT 1M;不能從已測規模推算它在完整大型語料的品質或成本。第四,作者固定部分 chunking 參數以便比較,並未對每種策略全面搜尋最佳超參數,因此結果不是每種方法可達上限的競賽。
實驗量的是檢索,不是 generator 最後的答案正確性、引用品質或使用者任務成功率。作者報告某方法改善 NDCG@10,不能直接改寫成整體 RAG 品質提高;Summary-only 的查詢速度較快,也不能單獨證明它更適合特定產品。若內部文件的標題品質差、更新頻率高、語言和標註方式不同,必須用目標資料重新驗證,不能把 benchmark 平均結果視為外部效度保證。
Artifact 與可重現性
截至 2026 年 9 月 26 日,作者的 chunking-eval 程式庫可公開瀏覽,README 提供環境安裝與評估命令;GitHub repository metadata 沒有宣告程式授權。作者連結的 KILT-NQ 與 CoRE Hugging Face 頁面目前為 public、非 gated,並列出 corpus、queries 和 qrels 等檔案;API metadata 未列出明確 dataset license。EmbeddingGemma 依 repository 說明需先接受其模型授權條款。端點可見不代表每份大型檔案已下載,也不等於所有資料和程式都採相同授權。
本文呈現的是作者報告的實驗數據,沒有把它描述成獨立重現。讀者可由 README 的 uv 安裝方式與 CLI 範例開始,但應先檢查所選 corpus split、模型條款、磁碟與運算資源,再決定是否跑較大規模。若要核對 Table 2 或 Figure 2,還要記下 repository、dataset、model revision、chunk 設定、FAISS 參數和硬體;缺少這些條件,重跑結果不一定能逐數字相同。
三個記憶點
- 技術想法:chunking 同時改變檢索單位、向量數和系統成本,不只是文字前處理。
- 核心證據:Figure 1 揭示 NDCG@10 與 Recall@100 的方法排序會變;Table 2 和 Figure 2 則展示資料設定與成本維度如何影響選擇。
- 採用邊界:簡單方法是合理起點,昂貴方法要在自己的資料、目標指標和建置預算上證明增量價值。
延伸閱讀與主要來源
- RAG-ANYTHING:多模態知識庫能否使用單一檢索方法?:檢索單位從純文字擴展到多模態資料時的設計取捨。
- RAG-MCP:如何縮減工具選擇所需的上下文?:比較檢索對象換成工具描述時的索引與召回問題。
- 論文 v1 HTML · v1 PDF · arXiv 摘要與版本記錄
- 作者的 evaluation code · KILT-NQ dataset · CoRE dataset